4 Sauvegarder nos Clusters
4/ Sauvegarder nos Clusters
Les méthodes de sauvegarde de ce chapitre s’appuient sur les ressources CloudNativePG du chapitre 2 et préparent la politique détaillée du chapitre 5.
Le texte ci-dessous reprend intégralement le PDF complet, révision 26.10, pages 165-204. Les travaux pratiques et les solutions sont conservés dans leur ordre original.
4.1 INTRODUCTION
- Sauvegardes de nos Clusters
- Politique de sauvegarde
Le présent module va vous présenter les différentes méthodes pour sauvegarder nos instances PostgreSQL. Si la mise en place de sauvegardes est essentielle, elles doivent suivre une politique de sauvegarde bien définie. Il en sera question en fin de module.
4.2 AU MENU
- Rappel
- Journalisation
- Sauvegardes PostgreSQL
- Logique
- Physique
- PITR
- Méthodes de sauvegarde de CloudNativePG
- Plugin
- VolumeSnapshot
- Politique de sauvegarde
- RTO, RPO
CloudNativePG propose et supporte de nouveaux mécanismes pour sauvegarder vos instances. Avant de découvrir en quoi elles consistent, prenons le temps de rappeler quels sont les différents types de sauvegarde dans PostgreSQL.
Connaître les différences entre sauvegardes logiques et physiques est essentiel, tout comme la différence entre sauvegarde à chaud et à froid.
Nous verrons ensuite comment CloudNativePG met en œuvre, ou non, ces types de sauvegardes et quels sont les prérequis.
4.2.1 Principe de la journalisation
4.2.2 Intégrité & durabilité
- Intégrité: la base reste cohérente malgré:
- arrêt brutal des processus
- crash machine -…
- Durabilité garantie si COMMIT
- Écriture des modifications dans un journal avant les fichiers de données
- WAL: Write Ahead Logging
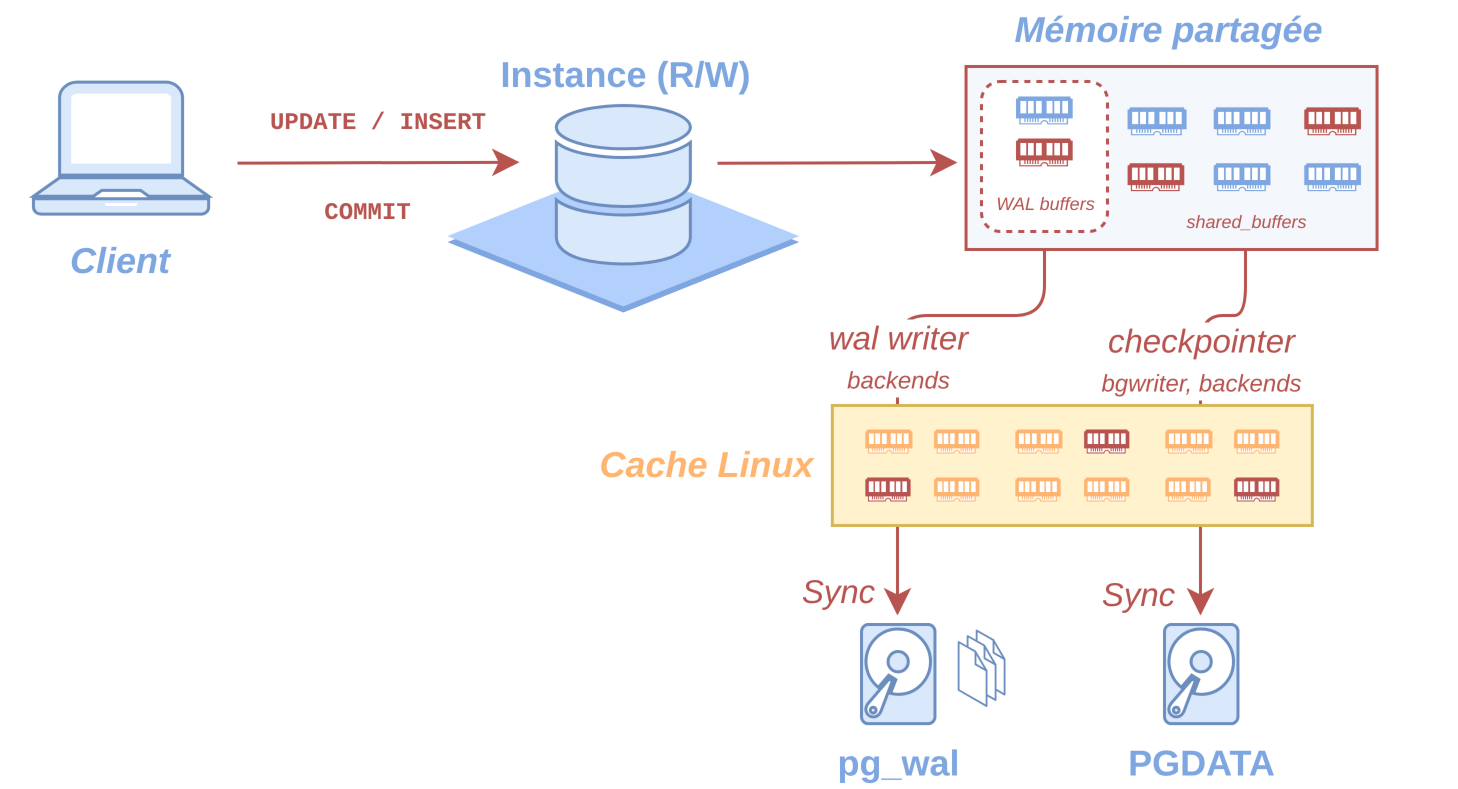
La journalisation, sous PostgreSQL, permet de garantir l’intégrité des fichiers, et la durabilité des opérations:
- l’intégrité: la base reste cohérente quoi qu’il arrive; un arrêt d’urgence ne corrompra pas la base.
- la durabilité: toute donnée validée ( COMMIT) est écrite physiquement, et un arrêt brutal immédiatement après ne va pas la faire disparaître (excepté la perte de tous les disques de stockage et réplicas, bien sûr).
Pour cela, le mécanisme est relativement simple: toute modification affectant un fichier sera d’abord écrite dans le journal. Les modifications affectant les vrais fichiers de données ne sont écrites qu’en mémoire, dans les shared buffers.
Les écritures dans le journal, bien que synchrones, sont relativement performantes puisqu’elles sont séquentielles (moins de déplacement de têtes pour les disques magnétiques). Il n’y a que le fichier en cours à synchroniser à chaque COMMIT. Ce n’est généralement que bien plus tard que les modifications seront écrites de façon asynchrone, soit par un processus recherchant un buffer libre, soit par le background writer, soit par le checkpointer. Ce dernier processus sait étaler la charge en écriture dans les fichiers de données sur plusieurs minutes, et dans l’idéal il est seul à s’en charger. Il existe plusieurs configurations et astuces pour arbitrer entre le niveau de durabilité des données exigé et les contraintes de performances: secondaire en réplication synchrone pour une sécurité maximale, désactivation partielle du mécanisme d’enregistrement synchrone des journaux dans une session, tables de travail non journalisées (unlogged), regroupement des insertions pour réduire l’impact des COMMIT… Aucune ne remet en cause l’intégrité définie dans les modèles de données.
4.2.3 Journaux de transactions (rappels)
Essentiellement:
- pg_wal/: journaux de transactions
- sous-répertoire archive_status
- nom: timeline, journal, segment
- ex: 00000002 00000142 000000FF
- pg_xact/: état des transactions
- Ces fichiers sont vitaux!
- Utiles pour le PITR
Rappelons que les journaux de transactions sont des fichiers de 16 Mo par défaut, stockés dans PGDATA/pg_wal, dont les noms comportent le numéro de timeline, un numéro de journal de 4 Go et un numéro de segment, en hexadécimal.
Le sous-répertoire archive_status est lié à l’archivage.
D’autres plus petits répertoires comme pg_xact, qui contient les statuts des transactions passées, ou pg_commit_ts, pg_multixact, pg_serial, pg_snapshots, pg_subtrans ou encore pg_twophase sont également impliqués.
Tous ces répertoires sont critiques, gérés par PostgreSQL, et ne doivent pas être modifiés! Les journaux de transactions sont nécessaires pour les sauvegardes de type PITR.
4.3 SAUVEGARDES POSTGRESQL
- Deux types, complémentaires
- Logiques
- Physiques
- PITR
- Outils différents
- Cas d’usage différents
- Complexités différentes
Choisir celle qui convient à votre besoin.
Il existe deux types de sauvegardes dans PostgreSQL: les sauvegardes dites logiques et celles dites physiques. Chacune d’entre elles a ses spécificités et chacune d’entre elles répond à un besoin spécifique. Ces deux types de sauvegardes sont, la plupart du temps, complémentaires.
4.3.1 Sauvegardes logiques
- Sauvegarde d’une base, d’un schéma, d’une table…
- À chaud et cohérente
- Pas d’impact sur les lecteurs / écrivains
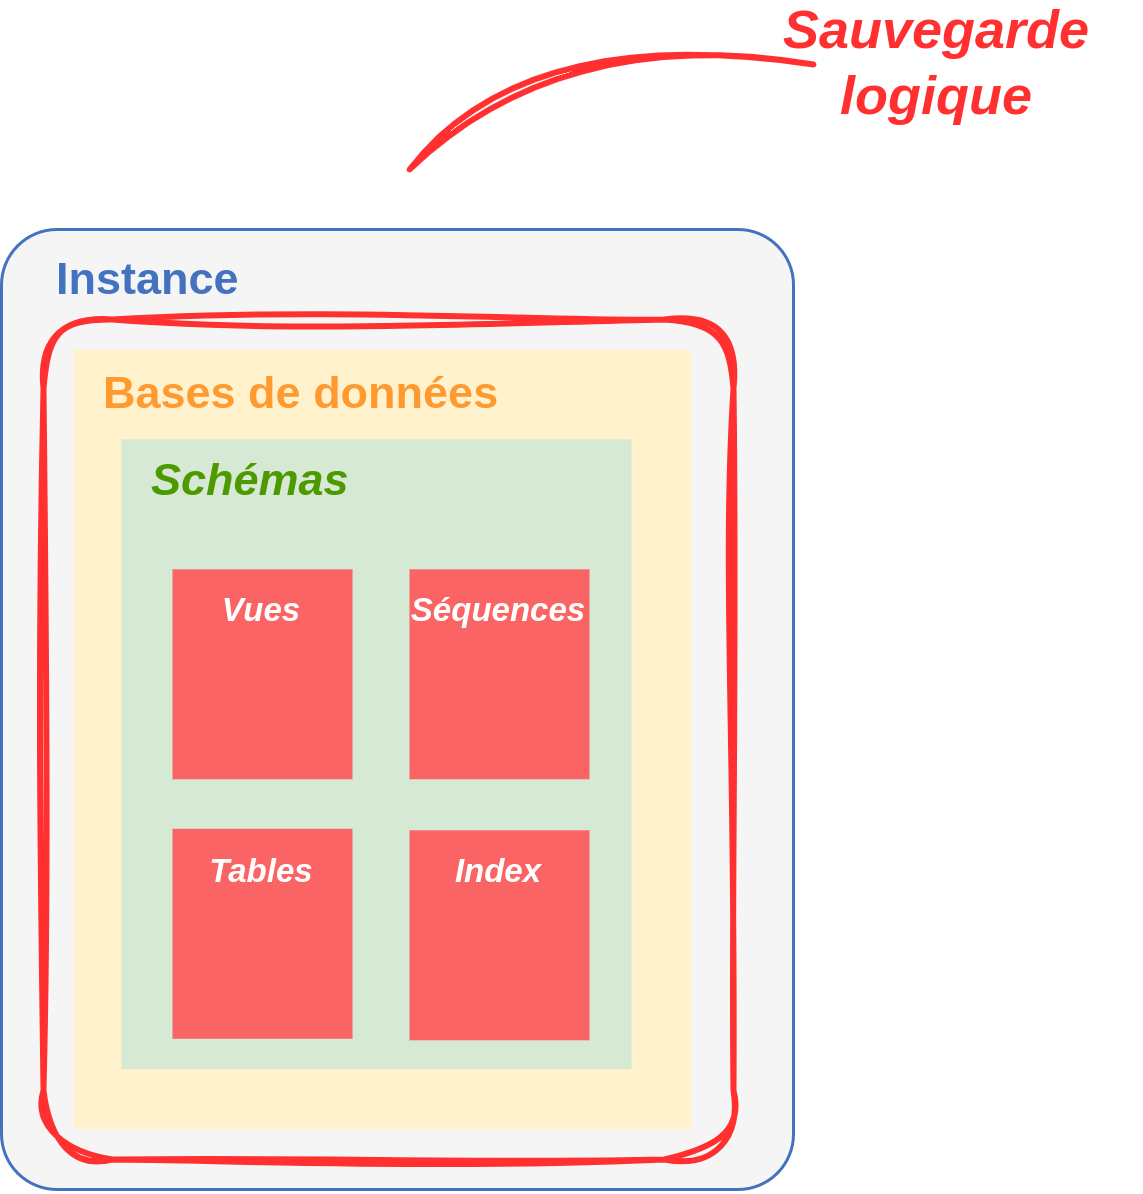
La sauvegarde logique nécessite que le serveur soit en cours d’exécution. Un outil se connecte à la base et récupère la déclaration des différents objets ainsi que les données des tables. La technique alors utilisée permet de s’assurer de la cohérence des données: lors de la sauvegarde, l’outil ne voit pas les modifications faites par les autres utilisateurs. Pour cela, quand il se connecte à la base à sauvegarder, il commence une transaction pour que sa vision des enregistrements de l’ensemble des tables soit cohérente. Cela empêche le recyclage des enregistrements par VACUUM pour les enregistrements dont il pourrait avoir besoin. Par conséquent, que la sauvegarde dure 10 minutes ou 10 heures, le résultat correspondra au contenu de la base telle qu’elle était au début de la transaction. Des verrous sont placés sur chaque table, mais leur niveau est très faible (Access Share). Ils visent juste à éviter la suppression des tables pendant la sauvegarde, ou la modification de leur structure. Les opérations habituelles sont toutes permises en lecture ou écriture, sauf quand elles réclament un verrou très invasif, comme TRUNCATE, REPACK ( VACUUM FULL avant PostgreSQL 19) ou certains LOCK TABLE. Les verrous ne sont relâchés qu’à la fin de la sauvegarde.
Par ailleurs, pour assurer une vision cohérente de la base durant toute la durée de son export, cette transaction de longue durée est de type REPEATABLE READ, et non de type READ COMMITTED, celui utilisé par défaut.
- 2 outils (contrib)
- pg_dump
- pg_dumpall
- Jamais inclus:
- tables systèmes
- fichiers de configuration
Il existe deux outils pour la sauvegarde logique dans la distribution officielle de PostgreSQL:
- pg_dump, pour sauvegarder uniquement des bases de l’instance, complètement ou partiellement, avec de nombreuses options et formats;
- pg_dumpall pour sauvegarder toutes les définitions et données des bases en un seul script SQL, ainsi que les objets globaux (rôles, tablespaces).
Pour la restauration:
- psql exécute les ordres SQL contenus dans des dumps (sauvegardes) au format texte;
- pg_restore traite uniquement les dumps au format binaire, et produit le SQL qui permet de restaurer les données.
Il est important de bien comprendre que ces outils n’échappent pas au fonctionnement client-serveur de PostgreSQL. Ils « dialoguent » avec l’instance PostgreSQL uniquement en SQL, aussi bien pour la sauvegarde que la restauration.
Comme ce type d’outil n’a besoin que d’une connexion standard à la base de données, il peut se connecter en local comme à distance. Cela implique qu’il doit aussi respecter les autorisations de connexion configurées dans le fichier pg_hba.conf.
L’export ne concerne que les données des utilisateurs: les tables systèmes ne sont jamais concernées, il n’y a pas de risque de les écraser lors d’un import. En effet, les schémas systèmes pg_catalog et information_schema et leurs objets sont gérés uniquement par PostgreSQL. Vous n’êtes d’ailleurs pas censé modifier leur contenu, ni y ajouter ou y effacer quoi que ce soit!
La configuration du serveur (fichiers postgresql.conf, pg_hba.conf…) n’est jamais incluse et doit être sauvegardée à part. Un export logique ne concerne que des données et structures.
Les extensions ne posent pas de problème non plus: la sauvegarde contiendra une mention de l’extension, et les données des éventuelles tables gérées par cette extension. Mais à la restauration, il faudra que les binaires de l’extension soient installés sur le système cible.
4.3.2 Sauvegardes physiques
- Sauvegarde de l’instance complète
- À chaud ou à froid
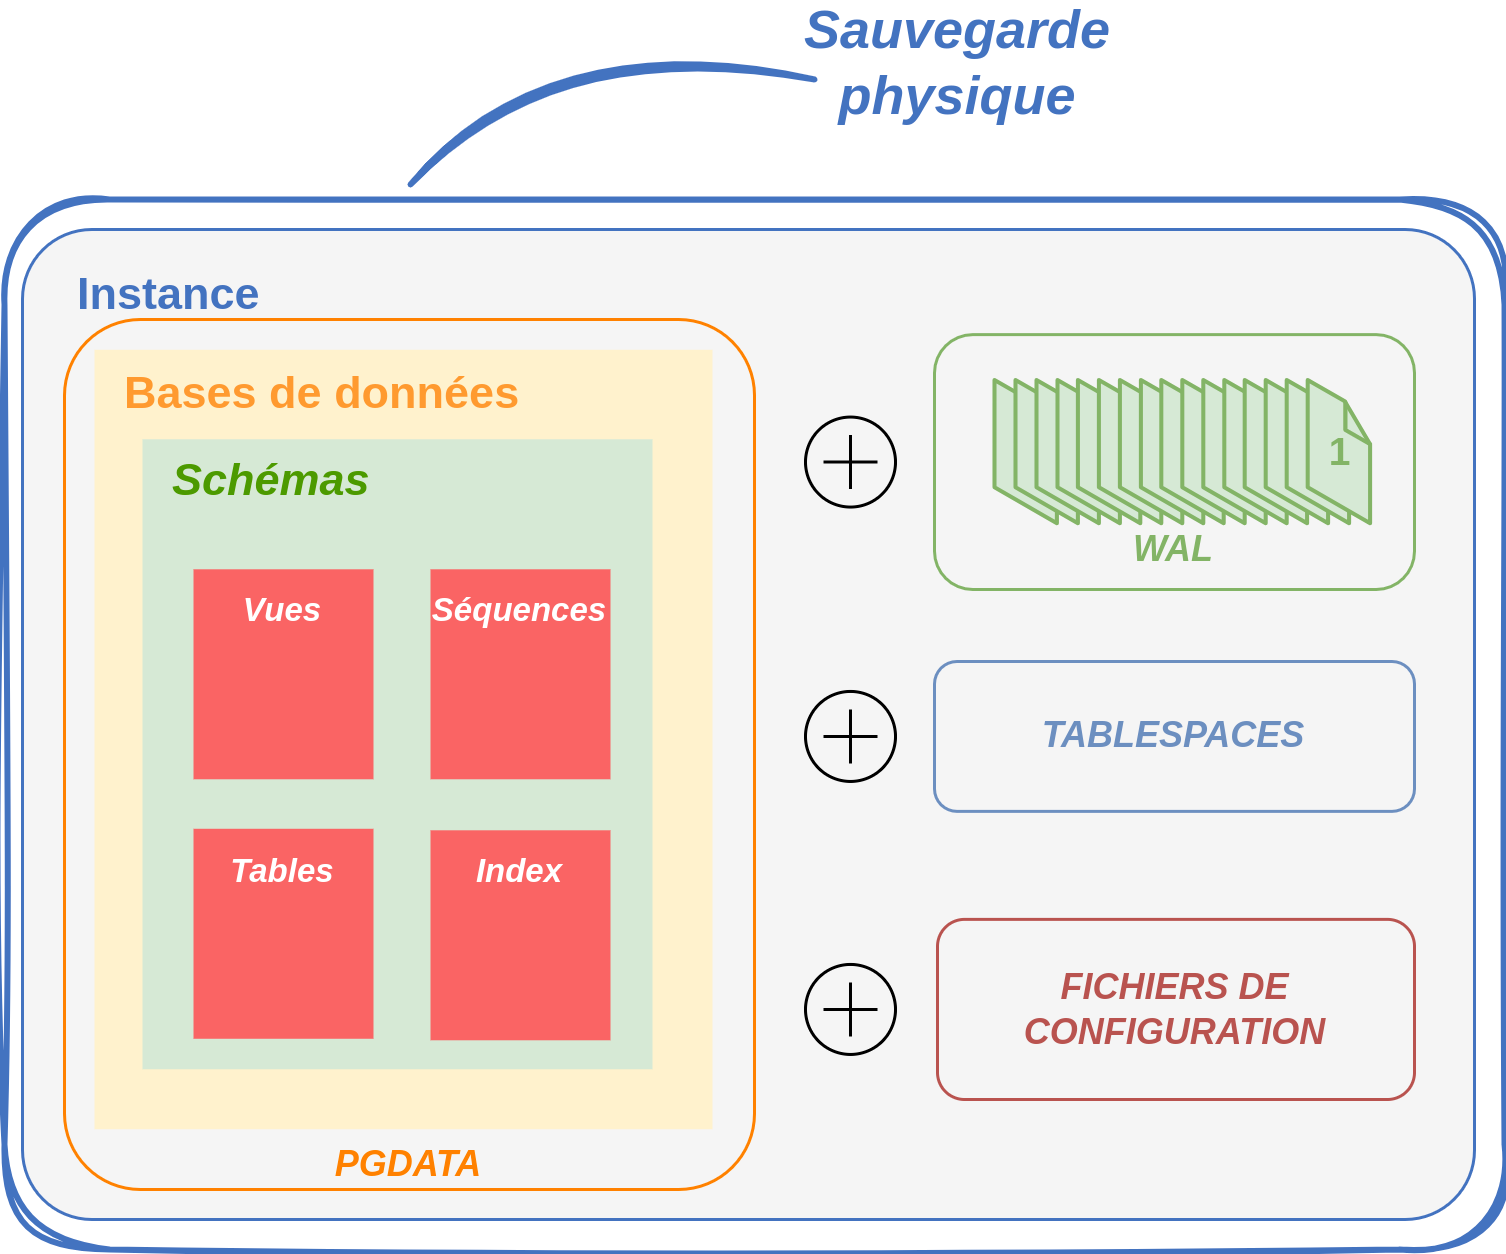
Toutes les données d’une instance PostgreSQL se trouvent dans des fichiers. Donc sauvegarder les fichiers permet de sauvegarder une instance. Cependant, cela ne peut pas se faire aussi simplement que ça.
Lorsque PostgreSQL est en cours d’exécution, il modifie certains fichiers du fait de l’activité des utilisateurs ou des processus (internes ou non) de maintenances diverses.
- Attention à la cohérence des données
- Ne pas oublier
- Les fichiers de configuration
- Les Tablespaces
- Les journaux de transactions
Pour garantir la cohérence des données, la seule solution serait de sauvegarder tous les fichiers lorsque l’instance est arrêtée (sauvegarde à froid), ce qui n’est concrètement envisageable que dans très peu de cas. Alors comment faire? La solution est d’effectuer des sauvegardes physiques à chaud et en continu en se reposant sur le mécanisme de PITR. PITR est l’acronyme de Point In Time Recovery, autrement dit restauration à un point dans le temps. C’est une sauvegarde à chaud et surtout en continu. Là où une sauvegarde logique du type pg_dump se fait par exemple une fois toutes les 24h, la sauvegarde PITR se fait en continu grâce à l’archivage des journaux de transactions. De ce fait, ce type de sauvegarde diminue très fortement la fenêtre de perte de données. Bien qu’elle se fasse à chaud, la sauvegarde reste cohérente grâce aux journaux de transactions qui contiennent toutes les modifications opérées sur les fichiers pendant la durée de la sauvegarde. Ce type de sauvegarde est possible avec des outils spécifiques de l’écosystème PostgreSQL comme
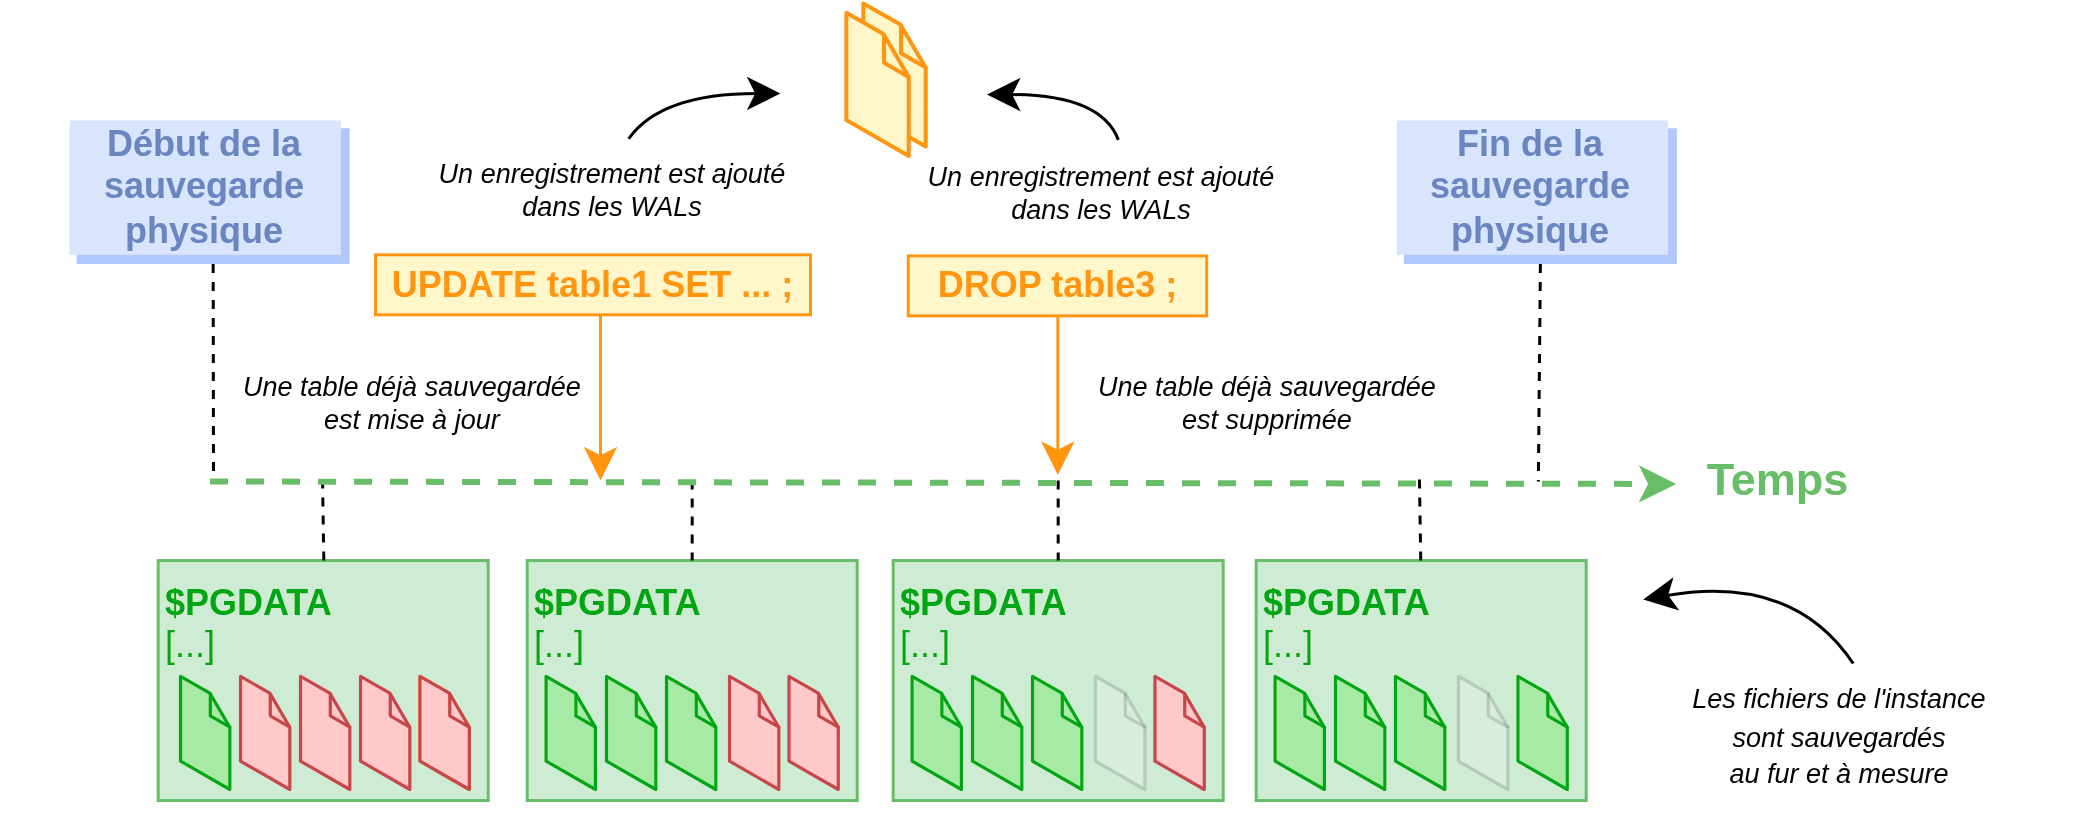
La cohérence est garantie grâce aux WAL
4.4 SAUVEGARDER AVEC CLOUDNATIVEPG
- De manière déclarative
- Sauvegarde physique uniquement
- Nouvelles CRD Backup et ScheduledBackup
- 2 méthodes
- Object Storage (avec un Plugin)
- Volume Snapshot
- Configuration spec.backup d’un objet Cluster
L’opérateur sait gérer pour vous des sauvegardes dites physiques. C’est le seul type de sauvegarde que vous allez pouvoir déclencher via l’opérateur. Autrement dit, il existe de nouvelles ressources dans Kubernetes, appelées Backup et ScheduledBackup qui correspondent à une sauvegarde physique d’un Cluster PostgreSQL.
Les sauvegardes logiques (faites avec pg_dump ou pg_dumpall par exemple) pourront toujours se faire avec ces outils dès lors que votre instance est accessible. À date, ce type de sauvegarde n’est pas déclenchable de manière déclarative via CloudNativePG.
Plusieurs méthodes de sauvegarde physiques existent. Quelle que soit la méthode, la configuration se fait dans l’objet Cluster correspondant à vos instances, par exemple, quel plugin doit être utilisé.
Certains paramètres peuvent également être renseignés dans les objets Backup ou ScheduledBackup. C’est ce que nous allons découvrir par la suite.
Aussi, vous pourrez effectuer ces sauvegardes à partir des instances secondaires pour décharger les instances primaires, et ce, quelle que soit la méthode choisie. Des points d’attention sont à avoir notamment lors de l’exécution de sauvegarde à froid.
4.4.1 Première méthode - Sauvegarde sur stockage objets
- Méthode dépendante d’un plugin de sauvegarde
- Nécessite un stockage objets (S3, Azure Blob…)
- Sauvegarde à chaud, PITR
La première méthode consiste à effectuer les sauvegardes sur un stockage objet de type S3, Azure Blob Storage ou Google Cloud Storage. Cette méthode se repose sur un plugin de sauvegarde indépendant qui doit être installé dans le cluster Kubernetes. À l’heure actuelle, le seul plugin proposé est le plugin Barman Cloud. D’autres initiatives ont vu le jour, notamment au sein de Dalibo, pour proposer pgBackRest comme alternative de plugin. Le plugin est généralement utilisé pour l’archivage des journaux de transactions ( isWALArchiver). Couplé avec l’archivage des journaux de transactions, vous obtenez une sauvegarde PITR fonctionnelle pour votre instance.
4.4.2 Plugin Barman Cloud - ObjectStore
- Installation propre
- Nouvelle CRD ObjectStore
- Emplacement de stockage
- Informations de connexion
- Stockage objet
- Amazon S3 (ou compatible S3), Google Cloud Storage, Azure Blob Storage
- Réutilisable
Cette ressource est fournie par Barman Cloud Plugin. Elle représente un emplacement de stockage objet.
Sources du PDF (page 177) :
Trois providers sont supportés: Amazon S3, Microsoft Azure Blob Storage ou encore Google Cloud Storage. Des services compatibles S3 peuvent être également utilisés comme MinIO ou encore Scaleway Object Storage. D’un fournisseur de stockage à un autre, les champs destinationPath et endpointURL peuvent changer. En plus de la connaissance du point d’entrée de votre solution de stockage, vous devez renseigner les informations de connexion dans la section s3Credentials. Ces informations doivent être enregistrées dans un objet Secret (objet Kubernetes). Dans l’exemple, le nom de ce Secret est scaleway-api-secret. Voici ce à quoi il pourrait ressembler.
Les valeurs de chacun des trois champs data doivent être encodées en BASE64.
4.4.3 Deuxième méthode - Volume Snapshot Kubernetes
- Fonctionnalité Kubernetes (API)
- spec.backup.method: volumeSnapshot
- Dépend de
- StorageClass
- Container Storage Interface
- Sauvegarde à chaud ou à froid
La seconde méthode utilise quant à elle un mécanisme propre à l’API de Kubernetes, le Volume Snapshot. C’est une fonctionnalité qui doit être supportée par la Storage Class (et donc in fine par le CSI) avec laquelle les volumes de votre instance ont été créés. Cette méthode va créer un objet Volume Snapshot dans votre cluster Kubernetes qui contiendra un instantané du Persistent Volume ciblé. Cette sauvegarde sera donc locale à votre système de stockage et non plus envoyée sur un stockage objet. Un snapshot sera créé pour chaque volume de votre instance ( storage et walStorage). Des mécanismes plus complexes comme les sauvegardes incrémentales ou différentielles sont possibles si la Storage Class le permet. Couplé avec l’archivage des journaux de transactions, vous obtenez une sauvegarde PITR fonctionnelle pour votre instance. Les journaux de transactions sont quant à eux stockés sur un stockage objet
et nécessitent toujours l’utilisation du plugin d’archivage.
4.4.4 Ressource Backup
- Custom Resource Definition
- Définit l’exécution d’une sauvegarde
Voici un exemple d’un objet Backup qui, une fois créé dans le cluster Kubernetes, déclenchera une sauvegarde physique du Cluster nommé postgresql. Si le champ method n’est pas mentionné, la sauvegarde se fera sur un stockage objet.
Il existe d’autres paramètres de configuration, comme:
- target: qui indique à partir de quelle instance doit être faite la sauvegarde;
- prefer-standby: pour demander à la faire depuis un secondaire;
- primary: pour demander à la faire depuis le primaire.
- method: permet de définir par quel moyen la sauvegarde physique doit être faite;
- volumeSnapshot: en se basant sur la fonctionnalité de Volume Snapshot. Votre CSI doit supporter cette fonctionnalité pour utiliser cette méthode;
- plugin: si la sauvegarde se fait à partir d’un plugin autre que vous aurez déployé au préalable. Fonctionnalité encore en test.
Pour les sauvegardes qui utilisent la méthode plugin, les informations sur l’emplacement de stockage seront reprises de la configuration de l’objet spécifique du plugin. Selon le plugin utilisé, il devrait exister deux dossiers, un contenant les journaux archivés, un contenant les sauvegardes.
Pour les sauvegardes qui utilisent la méthode volumeSnapshot, la configuration sera récupérée depuis spec.backup.volumeSnapshot.
Par défaut, les sauvegardes se font à chaud. Seule la méthode par Volume Snapshot permet de faire des sauvegardes à froid (c’est-à-dire instance arrêtée).
4.4.5 Ressource ScheduledBackup
- Custom Resource Definition
- Définit la planification de sauvegardes
- Une ressource Backup créée à chaque exécution
Il existe une deuxième ressource appelée ScheduledBackup qui, comme son nom l’indique, permet de déclencher une sauvegarde régulièrement. L’exemple donné correspond au déclenchement d’une sauvegarde quotidienne à 20h00:00. Quelques paramètres de configuration sont spécifiques à cet objet, comme:
- schedule: moment où la sauvegarde sera déclenchée. Il y a bien six arguments, correspondant aux secondes, minutes, heures, jours du mois, mois et jour de la semaine;
- backupOwnerReference: indique à quelle ressource sera rattachée cette sauvegarde;
- self: au ScheduledBackup qui a déclenché cette sauvegarde;
- cluster: au Cluster mentionné;
- none: à aucune ressource.
D’autres paramètres comme method ou target peuvent être renseignés dans un ScheduledBackup.
Le paramètre backupOwnerReference a un impact sur la manière dont sont conservés les objets Kubernetes Backup. Dans l’exemple ci-dessus, si l’objet ScheduledBackup masauvegardequotidienne est supprimé, tous les objets Backup qui auraient été créés par la sauvegarde planifiée seront supprimés. Dans le cas où backupOwnerReference est configuré à cluster, les objets Backup seront supprimés si l’objet Cluster est supprimé. À none ils seront tout le temps conservés. Notez qu’il s’agit bien des objets Kubernetes. Les sauvegardes qui se trouvent sur le stockage S3 par exemple, ne seront pas supprimées. Il est tout à fait possible de combiner ces deux types de déclenchements (manuel ou régulier) de sauvegardes.
4.5 ARCHIVAGE
- Activé par défaut ( archive_mode à on)
- archive_command:
- /controller/manager wal-archive…
- Non modifiable
- Nécessite un stockage de type S3, object storage
- Utilisé pour les sauvegardes PITR
- Se repose sur le plugin ( isWALArchiver)
L’archivage des journaux de transactions est fortement conseillé lorsqu’il est question de sauvegarde physique. Cet archivage est à la base des sauvegardes dites PITR (Point In Time Recovery) (voir notre module I2). CloudNativePG supporte ce mécanisme par défaut. L’archivage des journaux se fait via l’intermédiaire d’un plugin. Le choix du plugin reste libre. L’opérateur va même automatiquement activer ce mécanisme pour que vous n’ayez pas à le faire plus tard ( archive_mode à on). Si aucun plugin de sauvegarde n’est mentionné pour archiver les journaux, aucun archivage ne sera fait. Le processus archiver sera bien démarré et exécutera la commande de archive_command, mais renverra toujours un code retour valide à cette demande d’archivage. L’archive ne peut se faire que sur un stockage de type objet (type S3, Google Cloud Storage, Azure Blob Storage ou MinIO). C’est le cas quelle que soit la méthode de sauvegarde utilisée. Il est nécessaire de créer une ressource ObjectStore au sein du cluster Kubernetes qui sera réutilisée plus tard par les objets Cluster PostgreSQL. Pour configurer l’archivage sur un Cluster, il est demandé de renseigner spec.plugins avec le nom du plugin, s’il a la capacité d’archiver des journaux ( isWALArchiver) et l’ ObjectStore sur lequel seront envoyés les journaux. Par exemple:
[…]
4.5.1 Travaux pratiques
- Mise en place d’une sauvegarde PITR
Sources du PDF (page 181) :
4.6 RESTAURATION
- Création d’une nouvelle instance
- Pas de restauration In-Place
- À partir d’une sauvegarde physique
- spec.bootstrap.recovery
- barmanObjectStore
- volumeSnapshots
- spec.bootstrap.recovery
- PITR supporté
- Indiquer le plugin à utiliser
La première chose à noter est qu’une restauration d’une instance avec CloudNativePG se fera toujours par la création d’une nouvelle instance. Autrement dit, il n’est pas possible de faire une restauration sur une instance déjà déployée. La restauration in-place n’est pas possible. CloudNativePG se base sur une sauvegarde physique pour créer cette nouvelle instance. Le paramètre de configuration spec.bootstrap.recovery permet de configurer cette restauration. Lorsque ce paramètre est utilisé dans le fichier YAML, CloudNativePG comprend qu’il doit créer ( bootstrap) une instance à partir d’une sauvegarde. Comme l’ archive_command, le paramètre restore_command est déjà positionné par l’opérateur et utilise l’ instance-manager. Cette fois-ci c’est la commande wal-restore qui est utilisée.
La source utilisée pour la restauration peut être de nature différente selon la méthode ( method) de la sauvegarde.
- Si vous repartez d’une sauvegarde faite sur un stockage objets, utilisez le paramètre
contiendra alors toutes les informations du stockage objets où se trouve la sauvegarde. Par exemple:
[…]
[…]
- Si vous repartez d’un Volume Snapshot, vous devrez utiliser
bootstrap.recovery.volumeSnapshots.storage. Dans le cas où le snapshot a été fait depuis une instance ayant deux espaces de stockage (storageetwalStorage), vous devez également le renseigner. Quelques éléments supplémentaires sont à prendre en compte. Tout d’abord, CloudNativePG part du principe que la baseappexiste dans la sauvegarde et qu’elle a pour propriétaireapp. Si vous utilisez d’autres noms, vous devez le renseigner dans la partierecovery. Aussi, si vous souhaitez conserver un mot de passe en particulier pour le rôle par défaut, vous devez renseigner leSecretà utiliser. Autrement, CloudNativePG se chargera d’en générer un aléatoirement. Par défaut, la restauration se fera en rejouant l’intégralité des journaux de transactions disponibles sur la dernière timeline. Il est possible de faire une restauration de type Point In Time Recovery en renseignant le champbootstrap.recovery.recoveryTarget. Par exemple:
[…]
D’autres cibles de restauration existent, comme:
- targetTime: l’horodatage auquel vous souhaitez restaurer votre instance;
- targetXID: l’ID de transaction jusqu’auquel vous souhaitez restaurer votre instance;
- targetName: le nom du point de restauration que vous aurez créé au préalable avec
- targetLSN: la position dans les journaux de transactions à laquelle arrêter la restauration;
- targetImmediate: indique si la restauration doit s’arrêter dès qu’un état cohérent est atteint.
4.6.1 Travaux pratiques
- Procéder à une restauration PITR
4.7 QUESTIONS
N’hésitez pas, c’est le moment!
4.8 TRAVAUX PRATIQUES
La version en ligne des solutions de ces TP est disponible sur https://dali.bo/k3_solutions.
4.8.1 Mise en place d’une sauvegarde PITR
But: Mettre en place une sauvegarde PITR sur un stockage S3 (archivage et sauvegarde complète).
Comme vous le savez certainement, il existe le concept de sauvegarde physique PITR comme mécanisme de sauvegarde d’une instance. Pour mettre en place cela, il est d’abord nécessaire de faire une sauvegarde physique de l’arborescence de l’instance. Ceci peut être fait à chaud. Le second élément essentiel est l’archivage des journaux de transactions (WAL) qui seront rejoués après une restauration pour rétablir un état cohérent. En déployant une instance avec CloudNativePG, la seule solution de sauvegarde PITR utilisable est Barman Cloud. Très connu dans l’écosystème PostgreSQL, cet outil nous permet de faire la sauvegarde physique et l’archivage des journaux de transactions. Les commandes passées pour la mettre en place le seront de manière automatique mais une configuration doit être rajoutée dans le fichier YAML de notre Cluster.
La page de documentation du projet Barman Cloud CNPG-I plugin peut vous aider.
4.8.1.1 Installation
La mise en place d’une solution de sauvegarde nécessite, depuis la version 1.26, l’installation d’un plugin dédié aux sauvegardes. Le projet CloudNativePG met à disposition le plugin Barman Cloud CNPG-I. Nous allons donc l’installer sur notre cluster Kubernetes. Aussi, l’outil cert-manager doit être présent dans le cluster Kubernetes. Il est utilisé pour la génération de certificats pour la communication entre l’opérateur et le plugin de sauvegarde.
Installer cert-manager avec la commande suivante.
Patienter quelques minutes, le temps que cert-manager s’installe, puis installer le plugin avec la commande suivante.
Vérifier que le plugin est bien installé dans le Namespace cnpg-system.
Sources du PDF (page 186) :
- https://cloudnative-pg.io/plugin-barman-cloud/docs/intro/
- https://cloudnative-pg.io/plugin-barman-cloud/
4.8.1.2 Configuration
Créer le fichier ~/s3-creds.yaml avec le contenu suivant.
Les paramètres ACCESS_* doivent contenir l’information encodée en BASE64. Si vous utilisez la commande echo, n’oubliez pas l’option -n qui empêche la prise en compte du saut de ligne. Les informations vous seront données par le formateur.
Créer le Secret dans votre cluster Kubernetes avec la commande kubectl apply -f ~/s3-creds.yaml.
Pour cette partie du TP, nous allons créer une autre instance PostgreSQL ( postgresql-with-backup-demo), donc un objet de type Cluster et un nouveau nom.
Créer le fichier ~/postgresql-with-backup-demo.yaml avec le contenu suivant.
La partie plugins indique quel plugin de sauvegarde utiliser, ici Barman Cloud. Il est également indiqué que c’est ce plugin qui sera en charge de l’archivage des journaux de transactions grâce au paramètre isWALArchiver à true.
Créer le fichier ~/objectstore-demo.yaml pour créer l’ ObjectStore qui sera utilisé par le nouveau Cluster. Ne pas oublier de modifier CHANGEME dans le destinationPath en gardant bien le dernier / (mettre quelque chose de reconnaissable et unique).
Créer l’ ObjectStore avec la commande:
Créer le nouveau Cluster PostgreSQL avec la commande:
Vérifier que l’archivage se passe correctement directement dans la vue pg_stat_archiver.
Nous demander de vous montrer, sur l’interface Scaleway, le Bucket et le dossier que vous avez utilisé.
C’est un super point de départ. Mais pour le moment, il n’est pas possible de faire une quelconque restauration puisqu’il nous manque une sauvegarde complète de l’instance.
4.8.1.3 Sauvegarde complète de l’instance
Créer le fichier ~/letsbackup.yaml avec le contenu suivant:
Créer cette ressource avec kubectl.
Vérifier le statut de l’objet Backup.
Chercher dans les traces du Pod une preuve que la sauvegarde complète s’est bien déroulée.
Nous demander de vous montrer, sur l’interface Scaleway, le Bucket et le dossier que vous avez utilisé.
4.8.1.4 Générer de la donnée
Se connecter à l’instance. Créer une table et insérer quelques données.
Forcer la création d’un nouveau journal de transactions avec SELECT pg_switch_wal();.
4.8.2 Procéder à une restauration PITR
But: Restaurer notre instance depuis la sauvegarde PITR existante.
Les restaurations se font obligatoirement dans une nouvelle instance PostgreSQL. Le principe de restauration in-place n’est donc pas possible. Attention donc si vous souhaitez conserver le nom du Cluster, vous devrez détruire le précédent Cluster qui porterait ce nom.
Maintenant qu’une instance est déployée et qu’une sauvegarde a été faite, attardons-nous sur les manières qui existent pour restaurer une instance.
Aussi, c’est l’occasion de faire un petit rappel! N’oubliez pas de tester vos procédures de restauration fréquemment!
Simuler un crash. Détruire l’instance postgresql-with-backup-demo (nous sommes bien évidemment ici dans un exercice de destruction maîtrisé par des professionnels).
Créer un nouveau fichier ~/postgresql-restored-demo.yaml avec le contenu suivant. L’idée est de créer une nouvelle instance postgresql-restored-demo et d’indiquer avec la section bootstrap qu’elle doit démarrer à partir d’une sauvegarde.
Créer votre nouvelle instance avec kubectl apply -f ~/postgresql-restored-demo.yaml.
Lorsque l’instance est prête, s’y connecter et vérifier que les données s’y trouvent bien.
Supprimer les instances postgresql-demo qui ne vont plus nous servir par la suite.
4.8.3 Exercices optionnels
But: Découvrir des fonctionnalités plus complexes.
4.8.3.1 Mise en place de sauvegardes programmées
Il est possible de programmer des sauvegardes régulières avec la ressource ScheduledBackup.
Voici un exemple de définition qui permet de déclencher une sauvegarde appelée backup-every-day tous les jours à 18h42 pour le cluster postgresql-restored-demo:
Attention, l’option schedule prend bien six paramètres (le premier étant les secondes), contrairement au CronJob dans Kubernetes ou aux lignes de /etc/crontab qui n’en prennent que cinq.
Créer le fichier ~/backup-every-day.yaml avec le contenu ci-dessus en modifiant l’heure d’exécution pour que la sauvegarde s’exécute dans 5 à 10 minutes.
Créer l’objet ScheduledBackup avec kubectl.
Suivre les traces de l’opérateur avec kubectl logs -n cnpg-system cnpg-controller-manager-6b9f78f594-h Vous devriez voir le déclenchement de la sauvegarde.
4.9 TRAVAUX PRATIQUES (SOLUTIONS)
4.9.1 Mise en place d’une sauvegarde PITR
But: Mettre en place une sauvegarde PITR sur un stockage S3 (archivage et sauvegarde complète).
Comme vous le savez certainement, il existe le concept de sauvegarde physique PITR comme mécanisme de sauvegarde d’une instance. Pour mettre en place cela, il est d’abord nécessaire de faire une sauvegarde physique de l’arborescence de l’instance. Ceci peut être fait à chaud. Le second élément essentiel est l’archivage des journaux de transactions (WAL) qui seront rejoués après une restauration pour rétablir un état cohérent. En déployant une instance avec CloudNativePG, la seule solution de sauvegarde PITR utilisable est Barman Cloud. Très connu dans l’écosystème PostgreSQL, cet outil nous permet de faire la sauvegarde physique et l’archivage des journaux de transactions. Les commandes passées pour la mettre en place le seront de manière automatique mais une configuration doit être rajoutée dans le fichier YAML de définition.
4.9.1.1 Installation
La mise en place d’une solution de sauvegarde nécessite, depuis la version 1.26, l’installation d’un plugin dédié aux sauvegardes. Le projet CloudNativePG met à disposition le plugin Barman Cloud CNPG-I. Nous allons donc l’installer sur notre cluster Kubernetes. Aussi, l’outil cert-manager doit être présent dans le cluster Kubernetes. Il est utilisé pour la génération de certificats pour la communication entre l’opérateur et le plugin de sauvegarde.
Installer cert-manager avec la commande suivante.
Patienter quelques minutes, le temps que cert-manager s’installe, puis installer le plugin avec la commande suivante.
Vérifier que le plugin est bien installé dans le Namespace cnpg-system.
Sources du PDF (page 193) :
4.9.1.2 Configuration
Créer le fichier ~/s3-creds.yaml avec le contenu suivant.
Les paramètres ACCESS_* doivent contenir l’information encodée en BASE64. Si vous utilisez la commande echo, n’oubliez pas l’option -n qui empêche la prise en compte du saut de ligne. Les informations vous seront données par le formateur.
Créer le Secret dans votre cluster Kubernetes avec la commande kubectl apply -f ~/s3-creds.yaml.
Ce Secret contient les informations de la clé API qui permettra de s’authentifier au Bucket S3 et de déposer les WAL et les sauvegardes.
Pour cette partie du TP, nous allons créer une autre instance PostgreSQL ( postgresql-with-backup-demo), donc un objet de type Cluster et un nouveau nom.
Créer le fichier ~/postgresql-with-backup-demo.yaml avec le contenu suivant.
La partie plugins indique quel plugin de sauvegarde utiliser, ici Barman Cloud. Il est également indiqué que c’est ce plugin qui sera en charge de l’archivage des journaux de transactions grâce au paramètre isWALArchiver à true.
Créer le fichier ~/objectstore-demo.yaml pour créer l’ ObjectStore qui sera utilisé par le nouveau Cluster. Ne pas oublier de modifier CHANGEME dans le destinationPath en gardant bien le dernier / (mettre quelque chose de reconnaissable et unique).
La configuration des paramètres endpointURL et destinationPath devra être adaptée selon votre fournisseur de stockage S3. Les paramètres ci-dessus fonctionnent bien avec Scaleway. Faites vraiment attention, vous risquez de perdre beaucoup de temps… vraiment:-).
Créer l’ ObjectStore avec la commande:
Créer le nouveau Cluster PostgreSQL avec la commande:
Vérifier que l’archivage se passe correctement directement dans la vue pg_stat_archiver.
Nous demander de vous montrer, sur l’interface Scaleway, le Bucket et le dossier que vous avez utilisé.
Pour ce TP, nous sommes passés par la solution Object Storage de Scaleway compatible S3. Voici un exemple de ce qui sera créé dans le Bucket.
Le dossier pierrick est bien créé dans le Bucket.
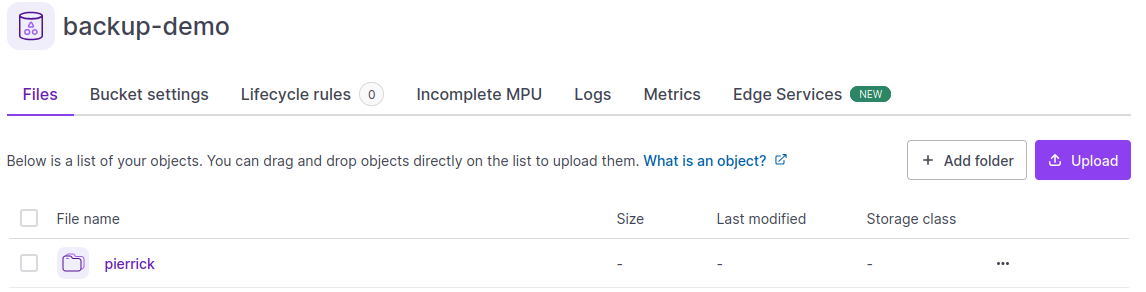
On y retrouve un dossier avec le nom du cluster PostgreSQL…
…qui contient lui-même un dossier wals.
Les journaux (WAL) sont enregistrés dans des dossiers qui reprennent la timeline de l’instance.
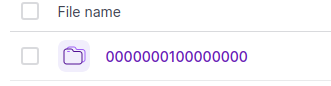
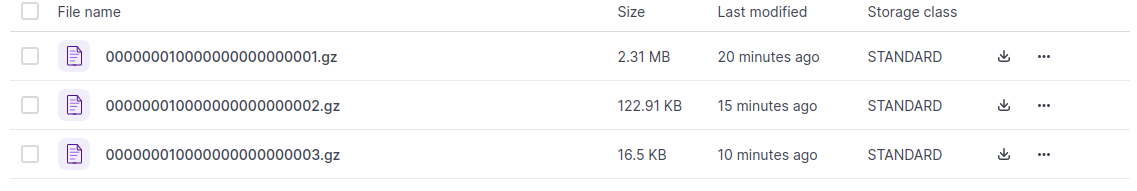
Et enfin, dans ce dernier dossier, se trouvent les journaux de transactions compressés. C’est un super point de départ. Mais pour le moment, il n’est pas possible de faire une quelconque restauration puisqu’il nous manque une sauvegarde complète de l’instance.
4.9.2 Sauvegarde complète de l’instance
Créer le fichier ~/letsbackup.yaml avec le contenu suivant:
Il faut donner un nom à cet objet Backup et le nom du cluster PostgreSQL que l’on souhaite sauvegarder ainsi qu’avec quelle méthode de sauvegarde cela va être fait, ici via le plugin Barman Cloud.
Créer cette ressource avec kubectl.
Vérifier le statut de l’objet Backup:
Chercher dans les traces du Pod une preuve que la sauvegarde complète s’est bien déroulée.
Au niveau de l’interface Scaleway, un nouveau dossier base est apparu à côté de wals.
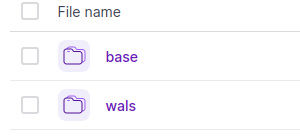
Il contient toutes les sauvegardes faites jusqu’à présent.
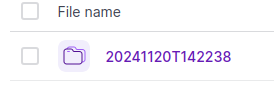
La sauvegarde physique se trouve dans ce dossier et comporte un fichier d’informations et une archive tar.
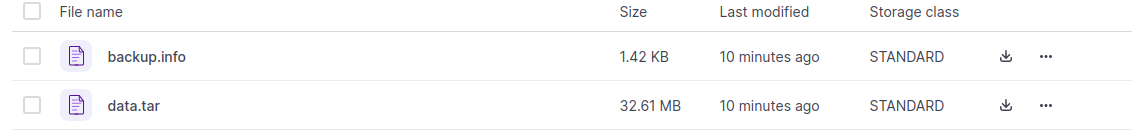
Incroyable! Nous avons une sauvegarde et un archivage des journaux de transactions qui semblent se dérouler correctement. Mais, qu’est-ce qui se cache derrière cela? La première chose que nous pouvons chercher à savoir par exemple, est quel outil est utilisé pour archiver les journaux. Le paramètre archive_command nous donne un début de réponse.
Un outil appelé manager présent dans le conteneur est utilisé avec l’option wal-archive suivie de plusieurs paramètres.%p est un placeholder qui permet d’indiquer le WAL courant.
4.9.3 Générer de la donnée
Se connecter à l’instance. Créer une table et insérer quelques données.
ou, via le plugin:
Ne pas oublier d’exécuter l’ordre CHECKPOINT qui permettra de forcer la synchronisation des données sur disque et la création d’un point de cohérence sans attendre l’expiration de checkpoint_timeout.
Forcer la création d’un nouveau journal de transactions avec SELECT pg_switch_wal();.
Il devrait apparaitre dans votre Bucket S3.
4.10 PROCÉDER À UNE RESTAURATION PITR
But: Restaurer notre instance depuis la sauvegarde PITR existante.
Les restaurations se font obligatoirement dans une nouvelle instance PostgreSQL. Le principe de restauration in-place n’est donc pas possible. Attention donc si vous souhaitez conserver le nom du Cluster, vous devrez détruire le précédent Cluster qui porterait ce nom.
Maintenant qu’une instance est déployée et qu’une sauvegarde a été faite, attardons-nous sur les manières qui existent pour restaurer une instance. Aussi, c’est l’occasion de faire un petit rappel! N’oubliez pas de tester vos procédures de restauration fréquemment!
Simuler un crash. Détruire l’instance postgresql-with-backup-demo (nous sommes bien évidemment ici dans un exercice de destruction maîtrisé par des professionnels).
Créer un nouveau fichier ~/postgresql-restored-demo.yaml avec le contenu suivant. L’idée est de créer une nouvelle instance postgresql-restored-demo et d’indiquer avec la section bootstrap qu’elle doit démarrer à partir d’une sauvegarde.
L’emplacement de la sauvegarde est indiqué dans l’attribut source de la section bootstrap.recovery. Il fait référence à un externalClusters qui contient les informations de l’ ObjectStore utilisé et présent dans le cluster Kubernetes.
Créer votre nouvelle instance avec kubectl apply -f ~/postgresql-restored-demo.yaml.
Lorsque l’instance est prête, s’y connecter et vérifier que les données s’y trouvent bien.
La méthode que nous venons de suivre suppose que vous ayez accès à l’objet ObjectStore créé dans le cluster Kubernetes. Mais qu’en est-il si c’est tout le cluster Kubernetes qui est en panne et doit être recréé? Dans ce cas-là, l’objet ObjectStore n’existe plus. Soit vous le recréez, soit vous renseignez directement les informations de connexion au stockage S3. Du côté du Bucket S3, un nouveau dossier est automatiquement créé avec le nom du nouvel objet Cluster. Cela est dû à la partie plugins dans laquelle nous avons indiqué de réutiliser l’ ObjectStore précédent. Dans cet exemple, la restauration s’est faite sur le même cluster Kubernetes. Dans le cas où vous devez la faire ailleurs, n’oubliez pas de recréer le Secret qui contient les informations de l’API Key nécessaire à l’accès au stockage S3.
Supprimer les instances postgresql-demo qui ne vont plus nous servir par la suite.
Il ne doit rester que le cluster PostgreSQL postgresql-restored-demo.
4.10.1 Exercices optionnels
But: Découvrir des fonctionnalités plus complexes.
4.10.1.1 Mise en place de sauvegardes programmées
Il est possible de programmer des sauvegardes régulières avec la ressource ScheduledBackup.
Voici un exemple de définition qui permet de déclencher une sauvegarde appelée backup-every-day tous les jours à 18h42 pour le cluster postgresql-restored-demo:
Attention, l’option schedule prend bien six paramètres (le premier étant les secondes), contrairement au CronJob dans Kubernetes ou aux lignes de /etc/crontab qui n’en prennent que cinq.
Créer le fichier ~/backup-every-day.yaml avec le contenu ci-dessus en modifiant l’heure d’exécution pour que la sauvegarde s’exécute dans 5 à 10 minutes.
Créer l’objet ScheduledBackup avec kubectl.
Suivre les traces de l’opérateur avec
Vous devriez voir le déclenchement de la sauvegarde.
Vous verrez alors la sauvegarde sur votre emplacement de stockage S3.
4.11 QUIZ
Sources du PDF (page 204) :