6 Supervision et Troubleshooting
6/ Supervision et Troubleshooting
La supervision s’appuie sur les clusters et les sauvegardes présentés aux chapitres précédents.
Le texte ci-dessous reprend intégralement le PDF complet, révision 26.10, pages 219-279. Les travaux pratiques et les solutions sont conservés dans leur ordre original.
6.1 INTRODUCTION
- Deux types de supervision
- occasionnelle
- automatique
- Superviser PostgreSQL et le système
- Superviser l’opérateur
Superviser une instance PostgreSQL consiste à superviser l’instance elle-même, mais aussi le système d’exploitation et le matériel. Ces deux derniers sont importants pour connaître la charge système, l’utilisation des disques ou du réseau, qui pourraient expliquer des lenteurs au niveau des bases. PostgreSQL propose lui aussi des informations qu’il est important de surveiller pour détecter des problèmes au niveau de son utilisation. L’opérateur CloudNativePG met à disposition un certain nombre de métriques et d’outils pour les exploiter (Exporter Prometheus, dashboard). D’autres outils complémentaires peuvent vous aider. La supervision occasionnelle permet de répondre à un problème ponctuel là où la surveillance automatique vous permet de suivre l’évolution de votre instance et d’être alertés, selon les outils que vous utilisez. Ce module a pour but de montrer les outils existant dans l’écosystème PostgreSQL et CloudNativePG. Certains points d’attention seront détaillés. La supervision d’éléments système, comme la RAM ou le CPU, sera également évoquée. La supervision, et notamment le suivi des traces, nous aide en cas de problème et de recherche de solution (troubleshooting). C’est le dernier thème qui sera abordé dans ce module.
6.2 AU MENU
- Supervision PostgreSQL
- Informations internes
- Traces
- Sondes externes
- check_pgactivity
- Outils CloudNativePG
- Exporter Prometheus
- Dashboard Grafana
- Troubleshooting
- Commandes à connaître
6.3 INFORMATIONS INTERNES
- PostgreSQL propose:
- de nombreuses statistiques d’activité
- de nombreuses informations dans les traces
- de nombreuses vues -… mais rien pour les historiser
- CloudNativePG… non plus!
PostgreSQL embarque de nombreuses tables système contenant des métriques intéressantes à surveiller. PostgreSQL fournit également des vues combinant des informations puisées dans différentes tables système, ce qui simplifie le suivi de l’activité de l’instance. C’est ce que l’on peut regrouper sous le terme de “statistiques d’activité”.
Ces statistiques peuvent être récupérées avec de simples requêtes SQL. Par exemple, la requête suivante permet de récupérer le nombre de connexions par base:
Ou encore celle-ci qui permet de savoir la taille des bases.
Ces vues sont là et ces informations sont facilement récupérables. Conserver ces informations pour voir leur évolution dans le temps est essentiel. Rien n’existe dans PostgreSQL pour les historiser. Un outil supplémentaire est nécessaire.
CloudNativePG rend ces informations facilement accessibles dans un contexte Kubernetes, avec notamment un Exporter Prometheus, nous allons le voir. Malheureusement, l’opérateur ne propose, lui non plus, aucun mécanisme de conservation. C’est à vous et à vos équipes DevOps de déployer et maintenir cette autre solution.
Parcourons ensemble quelques vues importantes de PostgreSQL.
6.3.1 pg_stat_activity
- Tracer l’activité:
- track_activities = on (défaut)
- pg_stat_activity affiche
- les requêtes
- les processus
- les Wait Event
- les Backend Type
- Nombreuses informations
cherche. Elle donne la liste des processus en cours sur l’instance, en incluant entre autres:
- le numéro de processus sur le serveur ( pid);
- la base de données, le nom d’utilisateur, l’adresse et le port du client;
- les dates de début d’ordre, de transaction ou de session;
- son statut (active ou non);
- la requête en cours, ou la dernière requête si la session ne fait rien;
- le nom de l’application s’il a été renseigné avec le paramètre application_name;
- le type de processus: session d’un utilisateur (client backend), processus interne…
Les textes des requêtes sont tronqués à 1024 caractères: c’est un problème courant. Il est conseillé de monter le paramètre track_activity_query_size à plusieurs kilooctets. Cette vue fournit aussi les wait events, qui indiquent ce qu’une session est en train d’attendre. Cela peut être très divers et inclut la levée d’un verrou sur un objet, celle d’un verrou interne, la fin d’une entrée-sortie… L’absence de wait event indique que la requête s’exécute. À noter qu’une session avec un wait event peut rester en statut active.
Les détails sur les champs wait_event_type (type d’événement en attente) et wait_event (nom de l’événement en attente) sont disponibles dans le tableau des événements d’attente de la documentation. À partir de PostgreSQL 17, la vue pg_wait_events peut être directement jointe à pg_stat_activity, et son champ description évite d’aller voir la documentation:
Sources du PDF (page 225) :
Le processus de la ligne 2 attend une synchronisation sur disque du journal de transactions (WAL), et les deux suivants une lecture d’un fichier de données. Pour entrer dans le détail des champs liés aux connexions:
- backend_type est le type de processus: on filtrera généralement sur client backend, mais on y trouvera aussi des processus de tâche de fond comme checkpointer, walwriter, autovacuum launcher et autres processus de PostgreSQL, ou encore des workers lancés par des extensions;
- datname est le nom de la base à laquelle la session est connectée, et datid est son identifiant (OID);
- pid est le processus du backend, c’est-à-dire du processus PostgreSQL chargé de discuter avec le client, qui durera le temps de la session (sauf parallélisation);
- usename est le nom de l’utilisateur connecté, et usesysid est son OID dans pg_roles;
- application_name est un nom facultatif, et il est recommandé que l’application cliente le renseigne autant que possible avec SET application_name TO ’nom_outil_client';
- client_addr est l’adresse IP du client connecté ( NULL si connexion sur socket Unix), et client_hostname est le nom associé à cette IP, renseigné uniquement si log_hostname a été passé à on (cela peut ralentir les connexions à cause de la résolution DNS);
- client_port est le numéro de port sur lequel le client est connecté, toujours s’il s’agit d’une connexion IP.
Une requête parallélisée occupe plusieurs processus, et apparaîtra sur plusieurs lignes de pid différents. Le champ leader_pid indique le processus principal. Les autres processus disparaîtront dès la requête terminée. Pour les champs liés aux durées de session, transactions et requêtes:
- backend_start est le timestamp de l’établissement de la session;
- xact_start est le timestamp de début de la transaction;
- query_start est le timestamp de début de la requête en cours, ou de la dernière requête exécutée;
- state vaut soit active, soit idle (la session ne fait rien), soit idle in transaction (en attente pendant une transaction);
- backend_xid est l’identifiant de la transaction en cours, s’il y en a une;
- backend_xmin est l’horizon des transactions visibles, et dépend aussi des autres transactions en cours.
Rappelons qu’une session durablement en statut idle in transaction bloque le fonctionnement de l’autovacuum puisque backend_xmin est bloqué. Cela peut mener à des tables fragmentées et du gaspillage de place disque.
(dépouillée des valeurs de paramètres). Il faut que le paramètre compute_query_id soit à on ou auto (le défaut, et alors une extension peut l’activer). Ce champ est utile pour retrouver une requête dans la vue de l’extension pg_stat_statements, par exemple.
Certains champs de cette vue ne sont renseignés que si le paramètre track_activities est à on (valeur par défaut, qu’il est conseillé de laisser ainsi).
À noter qu’il ne faut pas interroger pg_stat_activity au sein d’une transaction, son contenu pourrait sembler figé.
6.3.2 pg_stat_archiver
- Compteur d’activité de l’ archiver
- S’assurer du bon fonctionnement
- Diagnostiquer
Il est essentiel de vérifier que le processus d’archivage fonctionne correctement. Dans un contexte de déploiement avec CloudNativePG, un problème peut survenir à plusieurs niveaux:
- le processus PostgreSQL archiver lui-même;
- l’opérateur qui est l’intermédiaire entre PostgreSQL et le plugin;
- le plugin d’archivage utilisé;
- ou le système de stockage S3 cible.
La vue pg_stat_archiver permet de connaître le nombre de journaux de transactions correctement archivés ( archived_count), ou ayant eu un problème lors de leur archivage ( failed_count).
Les informations d’horodatage last_archived_time et last_failed_time sont très pratiques, notamment pour trouver la cause d’une saturation d’espace par exemple.
Les données de cette vue sont essentielles à suivre.
6.3.3 pg_stat_user_tables
- Compteur d’utilisation d’une table
- seq_scan, idx_scan
- Statistique sur le contenu
- n_live_tup, n_dead_tup, n_tup_ins, n_tup_upd, n_tup_del
- Utile pour l’autovacuum
- Horodatage
- last_seq_scan, last_idx_scan
- last_vacuum, last_autovacuum, last_analyze, last_autoanalyze
PostgreSQL intègre une vue permettant de suivre l’utilisation des tables, notamment avec les compteurs d’utilisation seq_scan et idx_scan qui indiquent, respectivement, combien de fois la table a été parcourue avec une lecture séquentielle ou via l’utilisation d’un index. Des statistiques sur le contenu sont également présentes avec par exemple des informations sur le nombre de lignes vivantes ( n_live_tup) et le nombre de lignes mortes ( n_dead_tup). Ces informations sont notamment utilisées par le processus autovacuum launcher pour déclencher ou non un nettoyage des lignes ( VACUUM) ainsi que le calcul des statistiques ( ANALYZE).
Ces dernières opérations sont d’ailleurs tracées dans d’autres colonnes: last_vacuum, last_autovacuum, last_analyze, last_autoanalyze. Elles contiennent l’horodatage du dernier passage de l’opération, qu’elle soit manuelle ou automatique. Le suivi des indicateurs peut vous aider à identifier des tables qui n’auraient pas leurs statistiques à jour ou les raisons d’une fragmentation trop importante.
6.3.4 pg_stats
- Statistiques sur les données des
- Tables
- Vues matérialisées
- Statistiques utilisées par le planificateur
- Utile pour diagnostiquer des problèmes de planification
Les statistiques sont collectées dans la table pg_statistic. La vue pg_stats affiche le contenu de cette table système de façon plus accessible. Les statistiques sont collectées sur:
- chaque colonne de chaque table;
- les index fonctionnels.
Le recueil des statistiques s’effectue quand on lance un ordre ANALYZE sur une table, ou que l’ autovacuum le lance de son propre chef. Les statistiques sont calculées sur un échantillon égal à 300 fois le paramètre STATISTICS de la colonne (ou, s’il n’est pas précisé, du paramètre default_statistics_target, 100 par défaut). La vue pg_stats affiche les statistiques collectées:
- inherited: la statistique concerne-t-elle un objet utilisant l’héritage (table parente, dont héritent plusieurs tables);
- null_frac: fraction d’enregistrements dont la colonne vaut NULL;
- avg_width: taille moyenne de cet attribut dans l’échantillon collecté;
- n_distinct: si positif, c’est le nombre de valeurs distinctes; si négatif, c’est la fraction de valeurs distinctes pour cette colonne dans la table. Il est possible de forcer la valeur de ce champ s’il est constaté que la collecte des statistiques le calcule mal. Par exemple, pour indiquer à l’optimiseur que chaque valeur apparaît statistiquement deux fois:
- most_common_vals et most_common_freqs: les valeurs les plus fréquentes de la table, et leur fréquence. Le nombre de valeurs collectées est au maximum celui indiqué par le paramètre STATISTICS de la colonne, ou à défaut par default_statistics_target. Le défaut de 100 échantillons sur 30 000 lignes peut être modifié comme ci-après (sachant que le temps de planification augmente exponentiellement avec ce paramètre, et qu’il vaut mieux ne pas dépasser la valeur 1000):
- histogram_bounds: les limites d’histogramme sur la colonne. Les histogrammes permettent d’évaluer la sélectivité d’un filtre par rapport à sa valeur précise. Ils permettent par exemple à
l’optimiseur de déterminer que 4,3% des enregistrements d’une colonne noms commencent par un A, ou 0,2% par AL. Le principe est de regrouper les enregistrements triés dans des groupes de tailles approximativement identiques, et de stocker les limites de ces groupes (on ignore les most_common_vals, pour lesquelles il y a déjà une mesure plus précise). Le nombre d’ histogram_bounds est calculé de la même façon que les most_common_vals;
- correlation: le facteur de corrélation statistique entre l’ordre physique et l’ordre logique des enregistrements de la colonne. Il vaudra par exemple 1 si les enregistrements sont physiquement stockés dans l’ordre croissant, -1 s’ils sont dans l’ordre décroissant, ou 0 s’ils sont totalement aléatoirement répartis. Ceci sert à affiner le coût d’accès aux enregistrements;
- most_common_elems et most_common_elem_freqs: les valeurs les plus fréquentes si la colonne est un tableau (NULL dans les autres cas), et leur fréquence. Le nombre de valeurs collectées est au maximum celui indiqué par le paramètre STATISTICS de la colonne, ou à défaut par default_statistics_target;
- elem_count_histogram: les limites d’histogramme sur la colonne si elle est de type tableau.
Parfois, il est intéressant de calculer des statistiques sur un ensemble de colonnes ou d’expressions. Dans ce cas, il faut créer un objet statistique en indiquant les colonnes et/ou expressions à traiter et le type de statistiques à calculer (voir la documentation de CREATE STATISTICS).
6.3.5 La liste des vues est longue
- pg_statio_user_tables
- pg_stat_database
- pg_stat_user_indexes
- pg_stat_wal_receiver
- pg_stat_checkpointer
- pg_stat_database_conflicts -…
Il existe de très nombreuses vues qui permettent de retrouver des informations sur à peu près tous les composants de PostgreSQL, que ce soit des conflits de réplication entre une instance primaire et un secondaire avec pg_stat_database_conflicts, sur la réception des journaux de transactions avec
Ayez en tête que l’information que vous cherchez est très probablement présente au sein de PostgreSQL.
6.4 TRACES POSTGRESQL
- Contient des informations précieuses
- si correctement configurées
- Traces des requêtes
- durée, fichiers temporaires
- Traces d’évènements
- erreurs, redémarrages, verrous
- Une vraie mine d’or à exploiter
Les traces d’une instance PostgreSQL sont par défaut peu fournies mais peuvent devenir, lorsque bien configurées, une vraie mine d’or. Bien suivies et bien exploitées elles vous permettront de trouver différents éléments, comme:
- la durée des requêtes ou des opérations de maintenance;
- la génération de fichiers temporaires;
- la présence de verrous;
- ou des évènements exceptionnels (crash, rechargement de configuration).
Voyons quels sont les paramètres de configuration qui sont essentiels à connaître et à configurer!
6.4.1 Rappels
- CloudNativePG fixe certains paramètres
- log_destination, log_directory, log_file_mode, log_filename, etc.
- Format JSON sur la sortie standard
- Aucun paramètre sur le contenu des traces n’est modifié par défaut
Nous l’avons vu dans le module K1 de cette formation, la gestion des traces est déléguée à l’opérateur. Les paramètres qui gèrent les traces (emplacement, format JSON, etc.) sont fixés par l’opérateur. Cependant aucun paramètre PostgreSQL modifiant le contenu des traces n’est modifié. C’est bien à nous, à vous, de le faire.
6.4.2 Niveau des traces
- log_min_messages
- défaut: panic / fatal / log / error / warning
- log_min_error_statement
- défaut: error (ou warning)
log_min_messages est le paramètre à configurer pour avoir plus ou moins de traces. Par défaut, PostgreSQL enregistre tous les messages de niveau panic, fatal, log, error et warning. Cela peut sembler beaucoup mais, dans les faits, c’est assez discret. Cependant, il est possible de descendre le niveau ou de l’augmenter. À partir de la version 19, il est même possible d’indiquer le niveau de traces pour chaque type de processus. Par exemple, si vous êtes satisfait avec le niveau par défaut de ce paramètre, mais que vous voulez un niveau DEBUG1 pour le processus d’archivage (ce qui permet de tracer un archivage réussi d’un journal), vous pouvez le configurer ainsi:
log_min_error_statement indique à partir de quel niveau la requête est elle aussi tracée. Par défaut, la requête n’est tracée que si une erreur est détectée. Généralement, ce paramètre n’est pas modifié, sauf dans un cas précis. Les messages d’avertissement (niveau warning) n’indiquent pas la requête qui a généré l’affichage du message. Cela est assez important, notamment dans le cadre de l’utilisation d’antislash dans les chaînes de caractères. On verra donc parfois un abaissement au niveau warning pour cette raison.
6.4.3 Tracer les requêtes et leur durée
- Toutes les requêtes:
- log_min_duration_statement (ex: 1s)
- ou log_statement + log_duration
- Extrait aléatoire:
- log_transaction_sample_rate
- log_statement_sample_rate + log_min_duration_sample
Pour repérer les problèmes de performances, il est intéressant de pouvoir tracer les requêtes et leur durée d’exécution. PostgreSQL propose deux solutions à cela. log_statement & log_duration: La première solution disponible concerne les paramètres log_statement et log_duration. Le premier permet de tracer toute requête exécutée si la requête correspond au filtre indiqué par le paramètre:
Le paramètre log_duration est un simple booléen. S’il vaut true ou on, chaque requête exécutée envoie en plus un message dans les traces indiquant la durée d’exécution de la requête. Évidemment, il vaut mieux alors configurer log_statement à all, ou il sera impossible de dire à quelles requêtes les temps correspondent. Donc pour tracer toutes les requêtes et leur durée d’exécution, une solution serait de réaliser la configuration suivante:
Une requête générera deux entrées dans les traces. Par exemple, pour la simple requête SELECT 1;, nous obtenons ces deux records JSON. Au passage, notons le réel surcoût en termes de lignes entre une trace PostgreSQL pure et une trace PostgreSQL gérée par CloudNativePG.
Cette méthode n’est pas recommandée puisqu’elle va générer des lignes pour toutes les requêtes. Or, le système de Readiness Probe utilise l’utilitaire pg_isready qui va se connecter très fréquemment pour s’assurer que le Pod est toujours en vie. log_min_duration_statement: Il est préférable de désactiver ces deux paramètres et de configurer log_min_duration_statement. Son but est d’abord de cibler les requêtes lentes, par exemple celles qui prennent plus de deux secondes à s’exécuter:
La requête et la durée d’exécution seront alors tracées dans le champ message:
En plus de la trace par log_min_duration_statement, rien n’interdit de tracer des requêtes sensibles, notamment le DDL:
Échantillonnage:
Quelle que soit la méthode, tracer toutes les requêtes peut poser problème pour de simples raisons de volumétrie du fichier de traces. Même s’il est possible de configurer finement la durée à partir de laquelle une requête est tracée, il faut bien comprendre que plus la durée minimale est importante, plus la vision des performances est partielle. Passeront ainsi « sous le radar » des requêtes relativement rapides mais très nombreuses qui, ensemble, peuvent représenter l’essentiel de la charge.
Cela étant dit, laisser 0 en permanence n’est pas recommandé. Il est préférable de configurer ce paramètre à une valeur plus importante en temps normal pour détecter seulement les requêtes longues et, lorsqu’un audit de la plateforme est nécessaire, passer temporairement ce paramètre à une valeur très basse (0 étant le mieux).
Une nouvelle fonctionnalité a donc été ajoutée: tracer une certaine proportion des requêtes ou des transactions.
log_transaction_sample_rate indique une proportion de transactions à tracer. Par exemple, en le configurant à 0.01, toutes les requêtes d’un centième des transactions, choisies au hasard, seront tracées.
De manière similaire, log_statement_sample_rate indique la proportion de requêtes à tracer, parmi celles durant plus d’une certaine durée, à indiquer dans log_min_duration_sample:
Évidemment, une requête dépassant la durée de log_min_duration_statement sera toujours tracée.
6.4.4 Configuration : tracer certains comportements
- log_connections + log_disconnections
- log_autovacuum_min_duration
- log_checkpoints
- time ou wal?
- log_lock_waits (mini 1s)
- verrous en attente
En dehors des erreurs et des durées des requêtes, il est aussi possible de tracer certaines activités ou comportements. Le paramétrage par défaut est peu bavard, et beaucoup de paramètres sont à off. Il est généralement conseillé d’activer tous ceux qui suivent. Dates de (dé)connexion: log_connections et son pendant log_disconnections, avec la valeur on, permettent de suivre qui se (dé)connecte, depuis où, et durant combien de temps. Exemple de traces d’une connexion sur une instance en version 18. Les quatre étapes de connexions sont visibles ( connection received, connection authenticated, connection authorized, connection received):
Et la trace de déconnexion de cette même session:
Depuis PostgreSQL 18, log_connections connaît d’autres valeurs que on suivant les phases de la connexion à tracer:
- receipt pour noter la réception de la demande de connexion;
- authentication pour l’authentification (utilisateur original et non l’utilisateur connu de PostgreSQL qui peut différer);
- authorization pour l’autorisation (avant finalisation du backend);
- setup_durations (nouveauté PostgreSQL 18) pour la durée de tout le processus.
Pour la compatibilité, la valeur on est équivalente aux trois premières valeurs ensemble. Il est conseillé de tout tracer:
mais pour réduire le volume de traces, on peut se limiter à certaines valeurs:
Durée des autovacuums:
log_autovacuum_min_duration équivaut à log_min_duration_statement, mais pour le démon autovacuum. Le but est de tracer son activité, au-delà d’une certaine durée, pour vérifier qu’il passe suffisamment fréquemment et rapidement, et sur quelles tables.
Checkpoints:
Un checkpoint est l’opération périodique qui nettoie le cache de PostgreSQL, synchronise sur disque les fichiers de la base, invalide les slots de réplication inutilisés et recycle les journaux de transactions. log_checkpoints = on trace son début, sa fin, et quelques statistiques:
Le message indique aussi le nombre de blocs écrits sur disque, le nombre de journaux de transactions ajoutés, supprimés et recyclés. Il est rare que des journaux soient ajoutés, ils sont plutôt recyclés. Des journaux sont supprimés quand il y a eu une très grosse activité qui a généré plus de journaux que d’habitude. Les statistiques incluent aussi la durée des écritures, de la synchronisation sur disque, la durée totale, etc. Le plus important est de pouvoir vérifier que l’écriture des checkpoints est généralement régulière (par défaut toutes les 5 minutes), comme l’indique ici checkpoint starting: time. Une mention de checkpoint starting: wal indique un déclenchement forcé par l’écriture de nombreux journaux lors d’une grosse activité. Repérer les attentes sur verrous: log_lock_waits à on permet de tracer les attentes de verrous. Ce peuvent être un UPDATE bloqué par un autre UPDATE, un SELECT bloqué par un TRUNCATE, ou encore par un REPACK ( VACUUM FULL avant PostgreSQL 19), etc… log_lock_waits est à on par défaut à partir de PostgreSQL 19, activez-le sur les versions précédentes. Lorsque l’attente dépasse la durée indiquée par le paramètre deadlock_timeout (1 seconde par défaut), un message d’information est enregistré, comme dans cet exemple:
Ici, un DROP TABLE attend depuis 1 seconde de pouvoir poser un verrou exclusif sur une relation. L’opération n’est pas interrompue, et, en général, finira par s’exécuter, avec le retard lié à ce verrou.
Plus ce type de message apparaît dans les traces, plus des contentions ont lieu sur certains objets, ce qui peut diminuer fortement les performances. Ces messages peuvent permettre d’analyser la cause première d’une accumulation de verrous, à condition que les requêtes soient tracées.
6.4.5 Repérer les fichiers temporaires
- Exemple:
- log_temp_files: à activer!
- Cause: tris, agrégats, jointures…
- Alerte: problème potentiel de performances
Quand PostgreSQL ne peut effectuer une opération en mémoire, il le fait sur disque dans un fichier temporaire, ce qui est beaucoup plus lent qu’en mémoire, même avec un SSD.
Typiquement, les fichiers temporaires apparaissent lors de tris de données ( ORDER BY), certains agrégats, les déduplications ( DISTINCT), les jointures par hachage (hash join), les CTE matérialisées ( WITH… AS…)…, quand la valeur du paramètre work_mem est insuffisante pour travailler en mémoire. Le passage par des fichiers temporaires n’est pas forcément gênant pour de grosses requêtes ponctuelles. Ils sont parfois inévitables quand on brasse beaucoup de données. Cependant, des fichiers temporaires trop fréquents et trop gros peuvent avoir un impact sur la performance du système. Dans le pire des cas, ils peuvent saturer les I/O, voire le disque de l’instance.
Être averti lors de la création de ce type de fichiers peut être intéressant, mais ils sont parfois trop fréquents pour que ce soit réaliste. Il est préférable de faire analyser après coup un fichier de traces pour savoir combien de fichiers temporaires ont été créés, et de quelles tailles. Cela peut mener à vérifier les requêtes exécutées, les optimiser, vérifier la configuration, réviser la valeur de work_mem…
Le paramètre log_temp_files à 0 permet de tracer toutes les créations de fichiers temporaires.
Pour le même tri, il peut y avoir de nombreux fichiers temporaires. De plus, la requête est aussi tracée, et si elle est longue et fréquente, le volume de traces peut être conséquent.
6.4.6 Cas particulier : log_line_prefix
log_line_prefix- Fréquemment modifié
- Permet d’ajouter des informations
- Habituellement conseillé :
%t [%p]: [%l-1] user=%u,db=%d,app=%a,client=%h
- Inutile avec CloudNativePG
log_destinationàcsvlog
- Transformation CSV en JSON
Le paramètre log_line_prefix permet d’ajouter un préfixe à une trace. Vous l’avez peut-être déjà modifié sur des instances installées sur machine virtuelle. Le défaut ( ‘%m [%p] ‘, soit horodatage et numéro de processus) est généralement insuffisant. On conseille généralement de le modifier avec la valeur présentée dans le slide. Il est à noter que ce paramètre n’est PAS pris en compte lorsque log_destination de PostgreSQL est positionné à csvlog (ou jsonlog). Ces destinations n’ont pas besoin de préfixe puisque leur structure est fixe et contient toutes les informations nécessaires. Or le paramètre log_destination fait partie de la liste des paramètres fixés par CloudNativePG (voir https://cloudnative-pg.io/docs/1.30/postgresql_conf#fixed-parameters). Sa valeur est à csvlog. PostgreSQL exporte les traces dans ce format qui seront par la suite récupérées et transformées au format JSON par l’opérateur.
6.5 SONDES EXTERNES
- Permet des vérifications
- plus précises
- propres au métier
- check_pgactivity
- script de monitoring PostgreSQL pour Nagios-like
- utilisable indépendamment de CloudNativePG
- Développé initialement par Dalibo
- https://github.com/OPMDG/check_pgactivity
Une autre manière de surveiller vos instances est d’utiliser des outils ou scripts externes aux instances. Ils se basent sur les informations contenues dans l’instance pour nous alerter sur tel ou tel évènement. Ces vérifications peuvent notamment être très précises (vont plus loin que les métriques de base remontées par CloudNativePG) ou alors adaptées au métier utilisant la base si l’on définit nos propres requêtes. Pour n’en citer qu’un, le script de monitoring check_pgactivity permet d’intégrer la supervision de bases de données PostgreSQL dans un système de supervision piloté par un outil tel que Nagios. Dès lors que votre instance est accessible, ce script peut être utilisé. Dalibo a conçu check_pgactivity dans le cadre de sa R&D. Pour les besoins les plus simples, le script peut être utilisé de façon autonome, sans nécessité d’installer toute l’infrastructure d’un outil comme Nagios, Icinga ou Grafana. La supervision d’un serveur PostgreSQL passe par la surveillance de sa disponibilité, des indicateurs sur son activité, l’identification des besoins de maintenance, et le suivi de la réplication le cas échéant. Ci-dessous figurent les sondes check_pgactivity à mettre en place sur ces différents aspects. Le site du projet contient toute la documentation de chaque sonde. Disponibilité:
- connection: réalise un test de connexion pour vérifier que le serveur est accessible;
- backends: compte le nombre de connexions au serveur comparé au paramètre max_connections;
- backends_status: permet d’obtenir des statistiques plus précises sur l’état des connexions clientes et d’être alerté lorsqu’un certain nombre de connexions clientes sont dans un état donné (waiting, idle in transaction…);
- uptime: détecte un redémarrage du serveur ou un rechargement de la configuration.
Vacuum:
- autovacuum: suit le fonctionnement de l’autovacuum et des tâches en cours ( VACUUM, ANALYZE, FREEZE…);
- table_bloat: vérifie le volume de données « mortes » et la fragmentation des tables;
- btree_bloat: vérifie le volume de données « mortes » et la fragmentation des index - par rapport à check_postgres, le calcul est séparé entre tables et index;
- last_analyze: vérifie si le dernier analyze (relevé des statistiques relatives aux calculs des plans d’exécution) est trop ancien;
- last_vacuum: vérifie si le dernier vacuum (relevé des espaces réutilisables dans les tables) est trop ancien.
Activité:
- locks: permet d’obtenir des statistiques plus détaillées sur les verrous obtenus et tient notamment compte des spécificités des predicate locks du niveau d’isolation SERIALIZABLE;
- wal_files: compte le nombre de segments du journal de transactions présents dans le répertoire pg_wal;
- longest_query: permet d’être alerté si une requête est en cours d’exécution depuis plus d’un certain temps;
- oldest_xact: permet d’être alerté si une transaction est ouverte depuis un certain temps sans être utilisée;
- oldest_2pc: calcule l’âge de la plus ancienne transaction préparée (two-phase commit transaction);
- oldest_xmin: repère la plus ancienne transaction de chaque base, et ce à quoi elle est liée (requête, slot…);
- bgwriter: permet de collecter des données de performance des différents processus d’écritures de PostgreSQL;
- hit_ratio: calcule le hit ratio (utilisation du cache de PostgreSQL);
- commit_ratio: calcule la proportion de COMMIT et ROLLBACK;
- checksum_errors: détecte l’apparition d’erreurs de sommes de contrôle (à partir de PostgreSQL 12);
- database_size: suit la volumétrie des bases et leurs variations;
- max_freeze_age: calcule l’âge des plus vieilles lignes stockées dans chaque base pour suivre le bon passage des VACUUM FREEZE;
- stat_snapshot_age: calcule l’âge des statistiques d’activité pour repérer un blocage du collecteur;
- temp_files: suivi des fichiers temporaires.
Configuration:
- configuration: permet de vérifier que les principaux paramètres mémoire n’ont pas leur valeur par défaut;
- minor_version: détecte les instances n’ayant pas la dernière version mineure;
- settings: repère un changement des paramètres;
- invalid_indexes: repère tout index invalide;
- pgdata_permission: vérifie les droits sur PGDATA pour éviter un blocage au redémarrage;
- table_unlogged: remonte le nombre de tables unlogged;
- extensions_versions: détecte les extensions à mettre à jour.
Réplication & archivage:
- archiver: compte le nombre de segments du journal de transactions en attente d’archivage;
- archive_folder: vérifie qu’il n’y a pas de journal manquant dans les archives de sauvegarde PITR;
- hot_standby_delta: calcule le délai de réplication entre un serveur primaire et un serveur secondaire;
- is_master / is_hot_standby: vérifie que l’instance est bien démarrée en lecture/écriture, ou une instance secondaire;
- is_replay_paused: vérifie si la réplication est en pause;
- replication_slots: calcule la volumétrie conservée pour chaque slot de réplication.
Sauvegarde physique et logique:
- backup_label_age: calcule l’âge du fichier backup_label (sauvegardes PITR exclusives);
- pg_dump_backup: contrôle l’âge et la variation de taille des sauvegardes logiques.
6.6 OUTILS CLOUDNATIVEPG
- Exporte des métriques prédéfinies, format Prometheus
- Sur l’opérateur
- Sur PostgreSQL
- ConfigMap par défaut cnpg-default-monitoring
- Métriques PostgreSQL, métriques Golang
- Permet de définir des métriques maison
- S’intègre facilement avec Grafana
CloudNativePG propose plusieurs outils vous permettant de suivre ce qu’il se passe sur vos instances, avec notamment, un exporter Prometheus. Un ensemble de métriques sont prédéfinies et sont exploitables dès la création des instances. Elles peuvent être retrouvées dans le ConfigMap cnpg-default-monitoring.
Un mécanisme de métriques personnalisées est disponible pour nous permettre d’étendre ces relevés. En plus des métriques sur les instances PostgreSQL, des métriques de l’opérateur sont également disponibles. Un dashboard Grafana est disponible et permet d’exploiter les données remontées par l’exporter. Voyons cela plus en détail.
6.6.1 Métriques prédéfinies
- Pod PostgreSQL
- curl http://127.0.0.1:9187/metrics
- Métriques PostgreSQL
- Métriques Golang
- Pod de l’opérateur
- curl http://127.0.0.1:8080/metrics
- ConfigMap cnpg-default-monitoring
- Mise en cache de 30s
Un ensemble de métriques PostgreSQL est automatiquement exposé sur le port 9187 du Pod PostgreSQL. C’est un exporter compatible avec Prometheus. Elles sont récupérables sur le point de terminaison /metrics. Toutes les métriques prédéfinies peuvent être retrouvées dans la ressource ConfigMap qui est nommée par défaut cnpg-default-monitoring. La commande suivante vous permet de retrouver sa définition.
D’autres métriques peuvent être présentes, c’est notamment le cas pour des métriques concernant les sauvegardes ou encore le suivi de consommation d’une application Golang. Rappelez-vous que l’opérateur est écrit en Golang. Les métriques:
- préfixées par cnpg_* concernent des informations de PostgreSQL;
- préfixées par go_* concernent des informations applicatives de Golang.
L’export de métriques de l’opérateur est également présent, cette fois-ci sur le port 8080 du Pod de l’opérateur. Les métriques relevées peuvent aider lors d’une recherche de bug ou de diagnostic avancé, mais très peu dans le quotidien. Les requêtes exécutées sur les instances PostgreSQL le sont avec le ROLE pg_monitor. Elles ciblent la base de données indiquée par la méthode bootstrap (donc la base app par défaut). Cela peut être surchargé par l’option target_databases pour des métriques maison.
Elles sont exécutées à chaque fois qu’une requête sur /metrics est faite. Pour éviter que des exécutions trop fréquentes des requêtes ne soient faites, un système de cache est mis en place. Par défaut, le résultat est mis en cache pendant 30 secondes. Ce temps peut être modifié par le paramètre cluster.spec.monitoring.metricsQueriesTTL. Autrement dit, la fréquence de récupération via votre système de monitoring ne peut pas, par défaut, avoir un suivi plus précis que 30 secondes.
6.6.2 Métriques personnalisées
- Besoins spécifiques
- ConfigMap
- spec.monitoring du Cluster
- Attention à la complexité des requêtes!
Selon vos besoins, il est possible que ce jeu de métriques ne soit pas suffisant. Vous avez la possibilité de rajouter vos propres métriques personnalisées, qui seront exposées via l’Exporter Prometheus. Pour cela, il est nécessaire de créer une ressource ConfigMap qui contiendra la définition de la métrique ainsi que la requête à exécuter. Voici un exemple simpliste qui permet de remonter le nombre de lignes d’une table foo grâce à count(*):
À noter que le label cnpg.io/reload: "" permet de prendre en compte les nouvelles requêtes de manière automatique. Ce ConfigMap doit ensuite être mentionné dans la partie spec.monitoring de votre Cluster pour que les métriques personnalisées soient elles aussi exportées sur le point de terminaison /metrics.
[…]
Comme indiqué plus haut, les requêtes vont être exécutées dès lors que /metrics est accédé. Attention donc à vos requêtes personnalisées qui, si elles sont trop compliquées et mettent du temps à s’exécuter, risquent d’impacter durablement l’instance, et ce même avec le système de cache.
6.6.3 Dashboard Grafana
- Collecter les données
- À vous de le faire
- Les afficher
- À vous de le faire
- Un dashboard Grafana ( #20417) existe!
- Le compléter avec vos propres graphiques
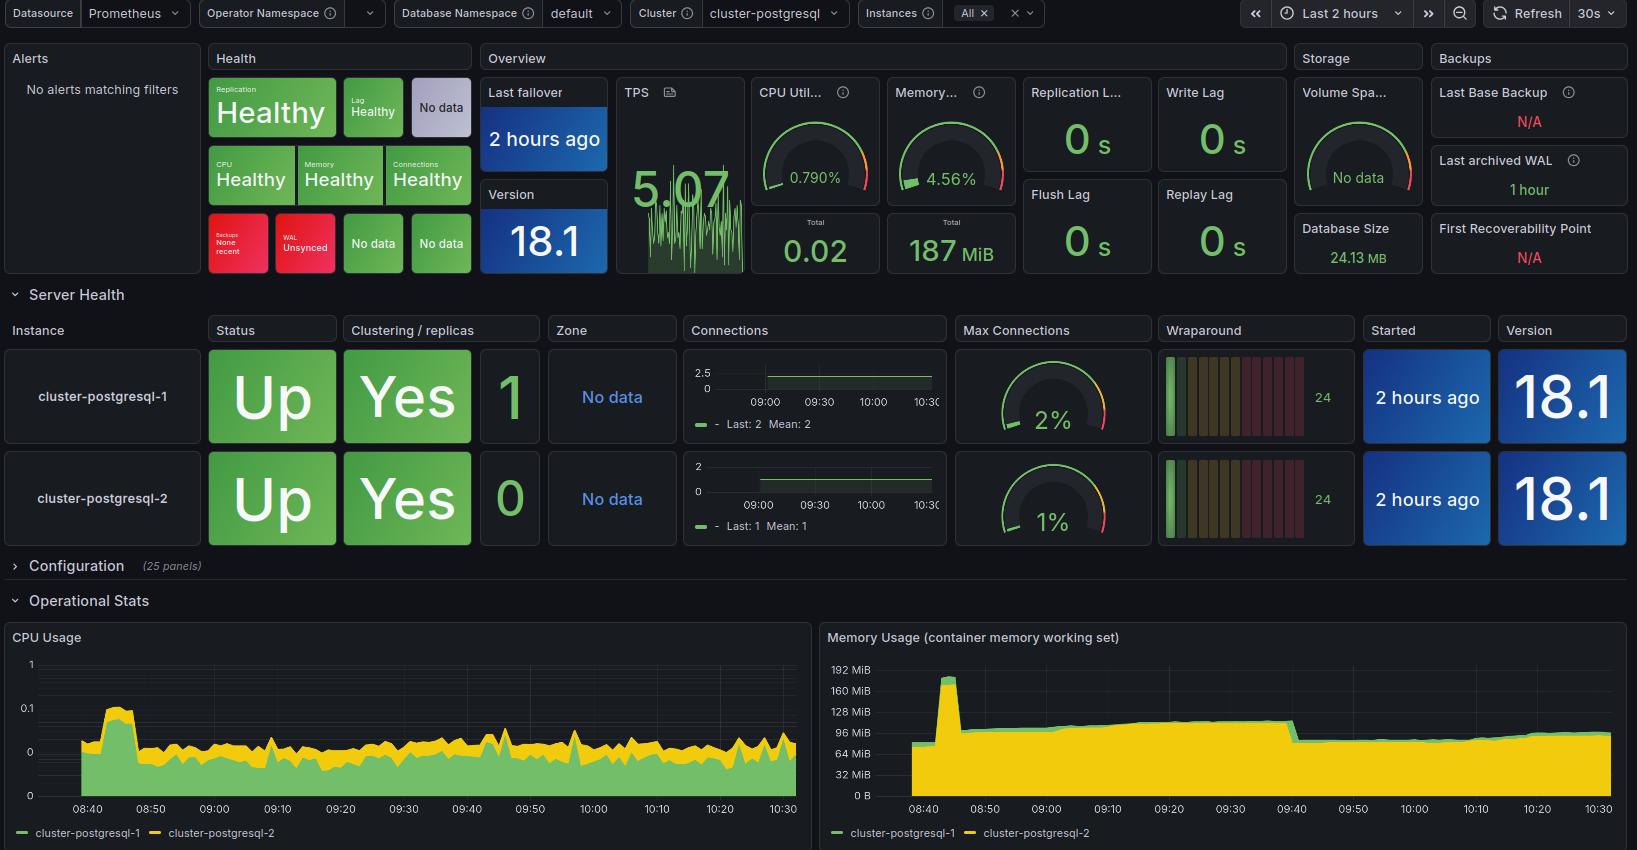
Ces métriques doivent être collectées. C’est à vous ou à votre équipe en charge de l’exploitation de Kubernetes de mettre en place une solution de collecte et de stockage. La documentation du projet propose dans la partie Quick Start un exemple de déploiement de la stack Prometheus - Grafana. Si vous utilisez Prometheus, une ressource PodMonitor doit être créée pour lui indiquer quel Cluster doit être pris en compte dans la collecte.
Une fois toutes ces métriques collectées, il vous restera à les exploiter.
Sources du PDF (page 248) :
Dans l’écosystème Kubernetes, l’outil Grafana est très réputé. CloudNativePG et la communauté maintiennent un dashboard Grafana, rendant l’exploitation des métriques aisée. De nombreux graphiques existent déjà. Ils concernent soit des métriques système, soit des métriques PostgreSQL. Ces derniers sont alimentés par les valeurs récupérées de l’Exporter Prometheus vu précédemment. Toutes les métriques remontées ne sont pas présentées dans des graphiques. À vous de les rajouter.
Sources du PDF (page 249) :
6.7 TROUBLESHOOTING
- PostgreSQL et CloudNativePG
- Quelques commandes
- Cas typiques
Le troubleshooting est une étape que l’on n’apprécie guère devoir faire. Pourtant, il est bien nécessaire de connaître quelques astuces pour y parvenir, que ce soit sur PostgreSQL ou CloudNativePG. Ces quelques slides se veulent être une introduction à ce sujet, tant les problèmes peuvent être variés. Couvrir l’intégralité des thèmes est impossible. Ceci est d’autant plus vrai que le monde Kubernetes apporte lui aussi sa dose de complexité.
6.7.1 Quelques commandes - CloudNativePG
- Plugin cnpg pour kubectl
- Permet d’interagir avec un Cluster
- De nombreuses sous-commandes
Le plugin cnpg pour kubectl devrait être installé sur les postes des administrateurs à qui revient la gestion des instances PostgreSQL. Il intègre un ensemble de commandes permettant de récupérer des informations sur les Clusters ainsi que de lancer des opérations de maintenance. Il est mis à jour à chaque nouvelle version de l’opérateur.
6.7.2 Commande status
- État connu du Cluster
- Primaire, secondaire, réplication, lag, etc.
- Bon point de départ
La première commande à connaître est status. Elle donne un aperçu du Cluster d’instances ciblé. Par exemple:
La section Cluster Summary indique notamment quelle est l’instance primaire ( Primary instance) et depuis quand elle l’est ( Primary promotion time), leur état de santé ( Status) ou encore à quel LSN se trouve l’instance primaire ( Current Write LSN).
La section Backup donne des informations sur la sauvegarde et l’archivage qui serait en place. Si ce n’est pas le cas, le message suivant est indiqué:
La section Streaming Replication status donne beaucoup d’informations et indique notamment quel est l’état de la réplication avec la colonne State. Cette valeur est récupérée depuis la vue pg_stat_wal_receiver du secondaire. Les colonnes Lag sont quant à elles retrouvées depuis la vue pg_stat_replication de l’instance primaire. Ici il n’est question que de la Streaming Replication.
Enfin, la dernière partie concerne les instances elles-mêmes. Elle mélange des informations PostgreSQL (colonne Current LSN), et des informations Kubernetes (colonnes QoS et Node).
Sources du PDF (page 251) :
- https://www.postgresql.org/docs/current/monitoring-stats.html#MONITORING-PG-STAT-WAL-RECEIVER-VIEW
- https://www.postgresql.org/docs/current/monitoring-stats.html#MONITORING-PG-STAT-REPLICATION-VIEW
6.7.3 Commande report
- Crée une archive (.zip) d’un Cluster ou de l’opérateur
- définitions YAML (manifests)
- traces des Pods (logs)
- Pratique à envoyer à un support
La collecte d’informations est une étape importante pour mener un diagnostic. Le plugin intègre la commande report qui permet de générer des archives contenant la définition des ressources Kubernetes de l’objet ciblé ( Cluster PostgreSQL ou opérateur) ainsi que les traces des Pods associés.
6.7.4 Commande fencing
- Arrête le service postmaster
- Pod toujours en cours d’exécution
- Pas de failover si l’instance primaire est fenced
Il existe un moyen d’arrêter le processus postmaster de PostgreSQL sans pour autant arrêter les Pods. C’est le mécanisme de fencing de CloudNativePG qui permet de faire cela.
En arrêtant un processus postmaster, on s’assure qu’aucune modification dans les fichiers de données PostgreSQL ne sera faite. Cela permet de diagnostiquer des problèmes sur le Pod ou le système de fichiers. Par conséquent, les connexions en cours sur la ou les instances ciblées par ce fencing seront toutes interrompues. Si le Pod de l’instance primaire est fenced, aucun mécanisme de failover ne sera déclenché.
Il existe la commande inverse kubectl cnpg fencing off pour redémarrer un postmaster arrêté dans un Pod.
6.7.5 show
- Retourne la valeur du paramètre
- Utile pour s’assurer de la valeur prise en compte
De nombreux paramètres sont modifiables, que ce soit de manière globale ( postgresql.conf), dans une session, ou encore au sein même d’une transaction. Des surcharges peuvent également être faites au niveau d’un rôle ou d’une base de données. Pour s’assurer de la valeur prise par tel ou tel paramètre, la commande SHOW est à connaître et à utiliser.
6.7.6 pg_is_in_recovery
- Savoir si l’instance est en recovery
- true ou false
- Déduire le type d’instance (primaire, secondaire)
Il vous sera peut-être donné uniquement un accès SQL aux instances. Dans ce cas, si vous souhaitez savoir si votre instance est une instance primaire ou instance secondaire, la fonction
Elle indique si l’instance est en mode recovery ou si elle ne l’est pas. Une instance est dans ce mode si elle est en train de rejouer des journaux de transactions. C’est donc forcément le cas d’une instance secondaire. Attention, il existe un cas où une instance dite primaire peut être en mode recovery: lorsqu’elle redémarre et qu’elle rejoue ses journaux localement avant d’atteindre un point de consistance.
6.7.7 pg_cancel_backend
- Annuler une requête
- Fermer une connexion
Dans divers cas (accumulation de verrous, requête particulièrement lente, etc.), il peut être nécessaire d’arrêter l’exécution d’une requête, ou forcer la déconnexion d’une session. PostgreSQL intègre différentes fonctions pour y parvenir avec notamment pg_cancel_backend(pid) et
L’utilisation de pg_terminate_backend() et pg_cancel_backend() n’est disponible que pour les utilisateurs appartenant au même rôle que l’utilisateur à déconnecter, les utilisateurs membres du rôle pg_signal_backend et bien sûr les superutilisateurs.
6.7.8 pg_ls_dir et pg_ls_waldir
- Dossier quelconque
- Dossier pg_wal
- Utiles sans accès au système de fichiers
L’accès au système de fichiers n’est pas systématique dans un environnement conteneurisé, et si cela reste possible, il n’est pas forcément aisé d’y accéder. Il vous sera parfois nécessaire de trouver, lister,
les fichiers présents dans tel ou tel dossier. PostgreSQL vous permet cela avec la fonction pg_ls_dir() en renseignant le chemin du dossier. Bien qu’intéressante, cette fonction n’est certainement pas la plus utilisée, au contraire de pg_ls_waldir(), qui permet de lister les fichiers présents dans le dossier pg_wal du PGDATA.
6.8 CAS TYPIQUES
- Incidents classiques
- Des problèmes déjà rencontrés
Quand un incident survient sur une instance PostgreSQL, il y de grandes chances que celui-ci ait déjà été rencontré par d’autres personnes. Notre expérience au support nous le confirme tous les jours. Ces schémas se répètent et les préconisations associées ne changent que rarement. Prenons le temps d’étudier quelques cas typiques d’incidents pouvant être rencontrés, et comment y remédier.
6.8.1 Saturation de l’espace disque
- Système de fichiers saturé
- pg_wal saturé:
- Blocage de l’instance
- Le volume doit être agrandi
Un problème couramment rencontré est la saturation du système de fichiers. PostgreSQL ne pouvant plus écrire sur disque, par mesure de précaution, l’instance est bloquée. Il faut distinguer deux types de blocages:
- Il n’est plus possible d’écrire des données mais l’instance reste accessible en lecture seule.
Dans ce cas de figure, le système de fichiers où se trouvent les fichiers de données ( PGDATA) n’a plus de place. PostgreSQL accepte de répondre aux requêtes en lecture, mais les requêtes en écriture sont impossibles. Le diagnostic est assez simple: les données présentes dans les bases (tables, index, etc.) n’ont cessé de grossir, et comme elles sont utiles, il faut agrandir l’espace.
- Le processus postmaster est complètement arrêté.
Dans ce second cas, il n’est même plus possible de se connecter à l’instance. L’arrêt du processus principal a été opéré afin de garantir qu’aucune modification ne soit faite sans qu’elle ne soit répercutée dans les journaux de transactions. Autrement dit PostgreSQL n’a plus pu écrire dans pg_wal. Les raisons peuvent être variées. Dans tous les cas, si le répertoire pg_wal commence à grossir fortement, c’est que PostgreSQL n’arrive plus à recycler ses journaux de transactions. Plusieurs choses peuvent expliquer un mauvais recyclage:
- la commande d’archivage n’arrive pas à faire son travail pour une raison ou une autre: indisponibilité du stockage S3, lenteurs, bug;
- les journaux de transactions sont conservés puisqu’ils sont encore utiles à une réplication physique ou logique;
- une mauvaise configuration wal_keep_size ou max_slot_wal_keep_size;
- une augmentation de la charge qui génère trop de journaux de transactions.
Dans l’un ou l’autre des cas présentés, il est nécessaire de trouver de la place en augmentant la taille des Persistent Volumes. Dans notre contexte, modifier spec.storage.size est nécessaire.
Aussi, il est recommandé de créer deux volumes pour chaque Pod de notre Cluster en utilisant spec.storage et spec.walStorage, par exemple:
6.8.2 Décrochage du secondaire
- Secondaire arrêté longtemps
- Réplication en pause
- Pas de slot de réplication ou paramètre max_slot_wal_keep_size dépassé
- Redémarrage du secondaire
- Impossible de raccrocher le primaire
6.9 QUESTIONS
N’hésitez pas, c’est le moment!
6.10 TRAVAUX PRATIQUES
La version en ligne des solutions de ces TP est disponible sur https://dali.bo/k4_solutions.
But: Récupérer les métriques exportées et créer des métriques personnalisées.
6.10.1 Découverte de certaines métriques
But: Découvrir les métriques de l’Exporter Prometheus.
Créer un fichier ~/cluster.yaml qui définit un Cluster avec une seule instance dans la dernière version de PostgreSQL disponible.
Créer cette ressource.
Exposer localement le port 9187 de l’Exporter Prometheus de l’instance primaire.
Récupérer toutes les métriques disponibles à l’aide de curl -s. Elles sont accessibles sur
Retrouver le nombre de backends connectés à l’instance.
Depuis une autre fenêtre, se connecter à l’instance.
Regarder comment évolue le nombre de backends connectés à l’instance.
Retrouver le nombre de fois où un ordre CHECKPOINT a été demandé.
Vérifier que les instances du Cluster sont bien réparties sur votre cluster Kubernetes.
6.10.2 Ajout d’une nouvelle métrique
But: Créer une métrique personnalisée.
Les métriques récupérées couvrent déjà un spectre très large de notre instance PostgreSQL. Vous aurez certainement besoin d’ajouter de nouvelles métriques, qu’elles soient liées au métier ou plus techniques pour diagnostiquer des problèmes. Regardons comment faire cela. Le but est de rajouter la métrique:
- last-analyze-foo: qui renvoie la date du dernier passage d’un ANALYZE sur la table foo.
Créer d’abord la table foo dans votre instance.
Créer le fichier ~/configmap.yaml avec le contenu suivant:
Puis créer cette nouvelle ressource ConfigMap.
Ajuster la définition du Cluster en rajoutant la partie spec.monitoring suivante dans
[…]
Appliquer cette modification au Cluster.
Récupérer les nouvelles métriques sur foo avec curl et grep. Que remarquez-vous?
Exécuter un ordre ANALYZE sur la table foo.
Retrouver la valeur du last_analyze.
6.10.3 Décrochage d’un secondaire
But: Simuler un décrochage d’une instance secondaire, repérer les indices associés et enfin la reconstruire.
6.10.3.1 Situation initiale
Dans ce TP, nous allons utiliser trois instances déployées pour un même Cluster. La définition à utiliser est la suivante:
Nous reviendrons sur le paramètre max_slot_wal_keep_size plus tard dans le TP.
Créer le fichier cluster-integration.yaml et créer le Cluster à partir de la définition précédente.
Créer la table utilisateurs et ajouter quelques lignes avec les ordres suivants:
Récupérer les informations sur les réplications en place.
Les instances souffrent-elles d’un retard de réplication?
6.10.3.2 Simulation d’un décrochage
Arrêter le service postmaster de l’instance integration-3.
Retrouver la taille sur disque des journaux de transactions sur l’instance primaire.
La requête suivante peut être utilisée à cet effet:
Insérer 1 million de lignes dans la table utilisateurs.
Relever une nouvelle fois la taille sur disque des journaux de transactions sur l’instance primaire.
Cette volumétrie de WAL n’a pas été appliquée sur l’instance integration-3 puisque le processus postmaster y est arrêté. Pourquoi reste-t-elle présente sur le primaire?
Retrouver les informations du slot de réplication _cnpg_integration_3 de l’instance primaire
Insérer cette fois-ci 10 millions de lignes dans la table utilisateurs.
Relever une nouvelle fois la taille sur disque des journaux de transactions sur l’instance primaire.
Qu’en est-il du slot de réplication? Des changements ont-ils eu lieu?
Qu’est-ce que cela implique pour integration-3?
6.10.3.3 Retour à une situation normale
L’instance se trouve dans un état instable et est surtout inutilisable en cas de bascule. Dans cette situation, la seule solution envisageable est de reconstruire entièrement l’instance integration-3.
Petite précision, c’est la seule solution envisageable dans ce contexte précis. Avec un Cluster configuré pour archiver ses journaux sur un emplacement tiers, le secondaire aurait pu retrouver les journaux manquants en basculant en mode Log Shipping. Cette bascule sur ce mode de réplication est un mécanisme propre à PostgreSQL, et non à CloudNativePG.
Supprimer toutes les ressources liées à l’instance integration-3.
6.11 TRAVAUX PRATIQUES (SOLUTIONS)
But: Récupérer les métriques exportées et créer des métriques personnalisées.
6.11.1 Découverte de certaines métriques
Créer un fichier ~/cluster.yaml qui définit un Cluster avec une seule instance dans la dernière version de PostgreSQL disponible.
Créer cette ressource.
Exposer localement le port 9187 de l’Exporter Prometheus de l’instance primaire.
Récupérer toutes les métriques disponibles à l’aide de curl -s. Elles sont accessibles sur
[…]
Retrouver le nombre de backends connectés à l’instance.
La métrique qui nous intéresse est nommée cnpg_backends_total.
Il y aurait donc une seule connexion à notre instance.
Depuis une autre fenêtre, se connecter à l’instance.
Le plus simple est d’utiliser la commande suivante: kubectl cnpg psql cluster.
Regarder comment évolue le nombre de backends connectés à l’instance.
Vous devriez voir apparaître une nouvelle ligne avec le paramètre application_name à psql.
Si ce n’est pas tout de suite le cas, attendez et recommencez un tout petit peu plus tard. Comme l’indique la documentation, il y a un mécanisme de cache pour les requêtes. La durée du cache peut être modifiée. By default, the outputs of monitoring queries are cached for thirty seconds. This is done to enhance resource efficiency and to avoid PostgreSQL to run monitoring queries every time the prometheus endpoint is scraped.
Retrouver le nombre de fois où un ordre CHECKPOINT a été demandé.
La métrique cnpg_pg_stat_checkpointer_checkpoints_req vous donnera cette information.
Si vous avez toujours votre session en cours, faites le test de lancer des ordres CHECKPOINT.
Vérifier que les instances du Cluster sont bien réparties sur votre cluster Kubernetes.
La métrique cnpg_collector_nodes_used vous donnera cette information.
La description de cette métrique est assez limpide. Ici nous avons une seule instance, la valeur de 1 est donc valide. Faites le test avec plusieurs instances et regardez l’évolution de la métrique en fonction du nombre d’instances et du nombre de nœuds dans votre cluster Kubernetes.
6.11.2 Ajout d’une nouvelle métrique
Les métriques récupérées couvrent déjà un spectre très large de notre instance PostgreSQL. Vous aurez certainement besoin d’ajouter de nouvelles métriques, qu’elles soient liées au métier ou plus techniques pour diagnostiquer des problèmes. Regardons comment faire cela. Le but est de rajouter la métrique:
- last-analyze-foo: qui renvoie la date du dernier passage d’un ANALYZE sur la table foo.
Créer d’abord la table foo dans votre instance.
Créer le fichier ~/configmap.yaml avec le contenu suivant:
Puis créer cette nouvelle ressource ConfigMap.
Ajuster la définition du Cluster en rajoutant la partie spec.monitoring suivante dans
[…]
Appliquer cette modification au Cluster.
Récupérer les nouvelles métriques sur foo avec curl et grep. Que remarquez-vous?
La requête s’est bien exécutée mais aucune valeur n’est remontée ( NaN).
Exécuter un ordre ANALYZE sur la table foo.
Retrouver la valeur du last_analyze.
6.11.3 Décrochage d’un secondaire
But: Simuler un décrochage d’une instance secondaire, repérer les indices associés et enfin la reconstruire.
6.11.3.1 Situation initiale
Dans ce TP, nous allons utiliser trois instances déployées pour un même Cluster. La définition à utiliser est la suivante:
Nous reviendrons sur le paramètre max_slot_wal_keep_size plus tard dans le TP.
Créer le fichier cluster-integration.yaml et créer le Cluster à partir de la définition précédente.
Attendez que les trois instances soient à l’état Running.
Créer la table utilisateurs et ajouter quelques lignes avec les ordres suivants:
Vous pouvez vous connecter au primaire avec la ligne de commande suivante:
Récupérer les informations sur les réplications en place.
Le plus simple est de récupérer ces informations avec la commande status du plugin cnpg.
Les instances souffrent-elles d’un retard de réplication?
00:00:00 pour les deux instances.
Il est également possible de le voir avec la colonne Current LSN de la section Instances status.
6.11.3.2 Simulation d’un décrochage
Arrêter le service postmaster de l’instance integration-3.
Cette opération peut être faite avec la commande fencing. L’idée ici est de simuler un décrochage en arrêtant le service. Dans un contexte plus réel, on pourrait imaginer un problème réseau ou encore un arrêt brutal d’un Node.
Retrouver la taille sur disque des journaux de transactions sur l’instance primaire.
La requête suivante peut être utilisée à cet effet:
Insérer 1 million de lignes dans la table utilisateurs.
Relever une nouvelle fois la taille sur disque des journaux de transactions sur l’instance primaire.
Cette volumétrie de WAL n’a pas été appliquée sur l’instance integration-3 puisque le processus postmaster y est arrêté. Pourquoi reste-t-elle présente sur le primaire?
Le slot de réplication créé automatiquement par CloudNativePG explique cela. En effet, un slot de réplication est un objet PostgreSQL qui permet de conserver les journaux nécessaires à une réplication si celle-ci est arrêtée (panne réseau, arrêt d’un service). Par défaut, il n’y a aucune limite de taille sur la quantité de journaux à conserver. Dans notre exemple, le paramètre max_slot_wal_keep_size a été positionné à 1 Go. L’instance primaire conserve donc l’équivalent de 1 Go de journaux pour tous les slots de réplication. Au-delà de ce seuil, les journaux seront supprimés pour éviter que l’instance primaire ne sature.
Retrouver les informations du slot de réplication _cnpg_integration_3 de l’instance primaire
La documentation explique longuement tous les paramètres, voir https://www.postgresql.org/docs/current/view-pg-replication-slots.html. Intéressons-nous à quelques paramètres seulement:
- active: à false ( f), cela indique qu’il n’est pas utilisé.
- restart_lsn: permet de savoir à quel emplacement dans la timeline il se trouvait lorsque le slot est devenu inactif. 0/602E428 correspond bien à la valeur du current_lsn dans la sortie du plugin.
- wal_status: le mot reserved indique que tous les WAL nécessaires à ce slot de réplication se trouvent bien présents sur le primaire.
- safe_wal_size: la quantité de journaux qui peut être encore écrite sans que ce slot ne devienne inutilisable.
- inactive_since: depuis quand le slot est inutilisé. Dans notre TP, il s’agit de l’horodatage du fencing de l’instance integration-3.
Insérer cette fois-ci 10 millions de lignes dans la table utilisateurs.
Relever une nouvelle fois la taille sur disque des journaux de transactions sur l’instance primaire.
Qu’en est-il du slot de réplication? Des changements ont-ils eu lieu?
Des changements ont effectivement eu lieu avec notamment le champ restart_lsn qui n’a plus de valeur et le champ wal_status qui est passé à lost. Cela signifie que ce qui était nécessaire à ce slot (et donc à l’instance integration-3) n’est plus disponible: les journaux ont été supprimés. C’est d’ailleurs cette raison qui est indiquée dans le champ invalidation_reason. Pourquoi? Les dernières insertions de ligne ont généré un volume de journaux qui a dépassé la limite configurée. PostgreSQL a donc commencé à supprimer les journaux les plus anciens (à commencer par celui où se trouvait le segment 0/602E428), rendant le slot inopérant.
Qu’est-ce que cela implique pour integration-3?
Cette instance secondaire a décroché. Elle n’est en l’état pas capable de se reconnecter au primaire puisque des journaux vont lui manquer.
Le redémarrage de l’instance est déclenché et elle entre donc dans le mode standby.
Un premier point de consistance est trouvé. Dans le champ message, on retrouve bien le même segment que celui au moment du fencing de l’instance: 0/602E428.
Automatiquement, PostgreSQL essaye de se reconnecter au primaire avec le mécanisme de réplication par flux avec l’utilisation du slot de réplication. Il se rend malheureusement compte que le slot est invalide, en donne la raison, et boucle sur des redémarrages.
6.11.3.3 Retour à une situation normale
L’instance se trouve dans un état instable et est surtout inutilisable en cas de bascule. Dans cette situation, la seule solution envisageable est de reconstruire entièrement l’instance integration-3.
Petite précision, c’est la seule solution envisageable dans ce contexte précis. Avec un Cluster configuré pour archiver ses journaux sur un emplacement tiers, le secondaire aurait pu retrouver les journaux manquants en basculant en mode Log Shipping. Cette bascule sur ce mode de réplication est un mécanisme propre à PostgreSQL, et non à CloudNativePG.
La suppression du Pod ne changera rien puisque cette opération n’a pas d’influence sur les données associées à ce Pod. Le problème se situe bien au niveau des données de integration-3, qui ne sont plus en phase avec l’instance primaire et, de plus, le rejeu des journaux n’est plus possible puisqu’ils ont été supprimés.
Supprimer toutes les ressources liées à l’instance integration-3.
La suppression de toutes les ressources va être captée par l’opérateur et, comme le nombre d’instances (2) est maintenant différent de la demande initiale (3), un nouveau Pod va être créé en suivant le mécanisme classique, c’est-à-dire la création d’un nouveau Pod avec une étape de join où une copie des données de l’instance primaire sera effectuée.
6.12 QUIZ
Sources du PDF (page 279) :