1 Architecture & fichiers de PostgreSQL
1/ Architecture & fichiers de PostgreSQL
1.1 AU MENU
Rappels sur l’installation
Les processus - Les fichiers
Le présent module vise à donner un premier aperçu global du fonctionnement interne de PostgreSQL.
Après quelques rappels sur l’installation, nous verrons essentiellement les processus et les fichiers utilisés.
1.2 RAPPELS SUR L’INSTALLATION
Plusieurs possibilités
paquets Linux précompilés
outils externes d’installation
code source
Chacun ses avantages et inconvénients
Dalibo recommande fortement les paquets précompilés
Nous recommandons très fortement l’utilisation des paquets Linux précompilés. Dans certains cas, il ne sera pas possible de faire autrement que de passer par des outils externes, comme l’installeur d’EntrepriseDB sous Windows.
1.2.1 Paquets précompilés
Paquets Debian ou Red Hat suivant la distribution utilisée
Préférence forte pour ceux de la communauté
Installation du paquet
installation des binaires
création de l’utilisateur postgres
initialisation d’une instance (Debian seulement)
lancement du serveur (Debian seulement)
(Red Hat) Script de création de l’instance
Debian et Red Hat fournissent des paquets précompilés adaptés à leur distribution. Dalibo recommande d’installer les paquets de la communauté, ces derniers étant bien plus à jour que ceux des distributions.
L’installation d’un paquet provoque la création d’un utilisateur système nommé postgres et l’installation des binaires. Suivant les distributions, l’emplacement des binaires change. Habituellement, tout est placé dans /usr/pgsql-<version majeure> pour les distributions Red Hat et dans /usr/lib/postgresql/<version majeure> pour les distributions Debian.
Dans le cas d’une distribution Debian, une instance est immédiatement créée. Par défaut, elle se trouve dans /var/lib/postgresql/<version majeure>/main. Elle est ensuite démarrée.
Dans le cas d’une distribution Red Hat, aucune instance n’est créée automatiquement. Il faudra utiliser un script (dont le nom dépend de la version de la distribution) pour créer l’instance, puis nous pourrons utiliser le script de démarrage pour lancer le serveur.
1.2.2 Installons PostgreSQL
Prenons un moment pour
installer PostgreSQL
créer une instance
démarrer l’instance
Pas de configuration spécifique pour l’instant
L’annexe ci-dessous décrit l’installation de PostgreSQL sans configuration particulière pour suivre le reste de la formation.
1.3 PROCESSUS DE POSTGRESQL
1.3.1 Introduction
PostgreSQL est: @ or)
multiprocessus (et non multithread)
à mémoire partagée
client-serveur
L’architecture PostgreSQL est une architecture multiprocessus et non multithread.
Cela signifie que chaque processus de PostgreSQL s’exécute dans un contexte mémoire isolé, et que la communication entre ces processus repose sur des mécanismes systèmes inter-processus: sémaphores, zones de mémoire partagée, sockets. Ceci s’oppose à l’architecture multithread, où l’ensemble du moteur s’exécute dans un seul processus, avec plusieurs threads (contextes) d’exécution, où tout est partagé par défaut.
Le principal avantage de cette architecture multiprocessus est la stabilité: un processus, en cas de problème, ne corrompt que sa mémoire (ou la mémoire partagée), le plantage d’un processus n’affecte pas directement les autres. Son principal défaut est une allocation statique des ressources de mémoire partagée: elles ne sont pas redimensionnables à chaud.
Tous les processus de PostgreSQL accèdent à une zone de « mémoire partagée ». Cette zone contient les informations devant être partagées entre les clients, comme un cache de données, ou des informations sur l’état de chaque session par exemple.
PostgreSQL utilise une architecture client-serveur. Nous ne nous connectons à PostgreSQL qu’à travers d’un protocole bien défini, nous n’accédons jamais aux fichiers de données.
1.3.2 Processus d’arrière-plan
(sous Rocky Linux 8)
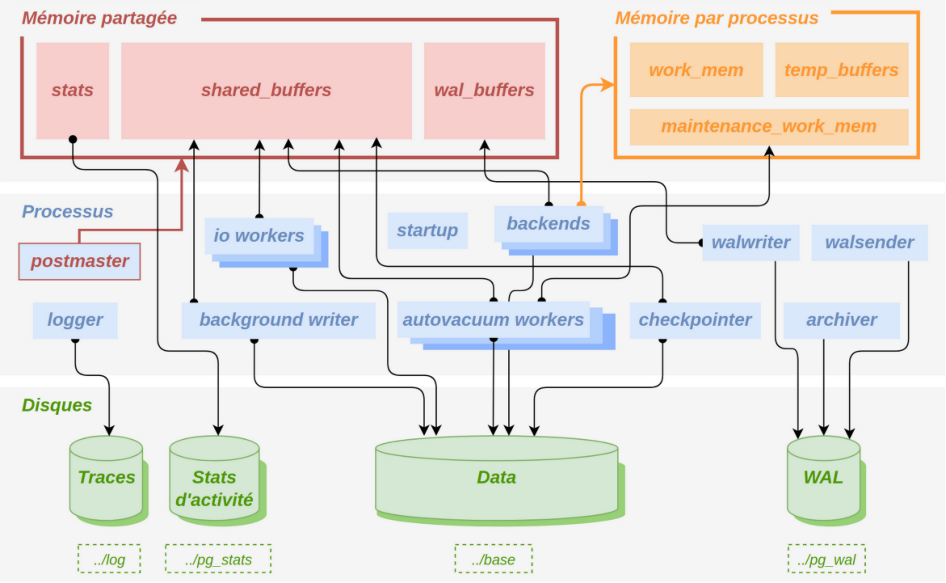
Nous constatons que plusieurs processus sont présents dès le démarrage de PostgreSQL. Nous allons les détailler.
NB: sur Debian, le postmaster est nommé postgres comme ses processus fils; sous Windows les noms des processus sont par défaut moins verbeux.
1.3.3 Processus d’arrière-plan (suite)
Les processus présents au démarrage:
Un processus père:
postmasterbackground writercheckpointerwalwriterautovacuum launcherstats collector(avant v15)io worker(à partir v18)logical replication launcheret d’autres selon la configuration et le moment:
dont les background workers: parallélisation, extensions…
Le postmaster est responsable de la supervision des autres processus, ainsi que de la prise en compte des connexions entrantes.
Le background writer et le checkpointer s’occupent d’effectuer les écritures en arrière plan, évitant ainsi aux sessions des utilisateurs de le faire.
Le walwriter écrit le journal de transactions de façon anticipée, afin de limiter le travail de l’opération COMMIT.
L’ autovacuum launcher pilote les opérations d’« autovacuum ».
Avant la version 15, le stats collector collecte les statistiques d’activité du serveur. À partir de la version 15, ces informations sont conservées en mémoire jusqu’à l’arrêt du serveur où elles sont stockées sur disque jusqu’au prochain démarrage.
À partir de la version 18, les io workers s’occupent des lectures asynchrones pour certaines opérations. Leur nombre est configurable. À priori, cette méthode est à conserver. Il reste possible de revenir à l’ancien comportement de PostgreSQL, sans io worker, ou d’utiliser l’API io_uring.
Le logical replication launcher est un processus dédié à la réplication logique.
Des processus supplémentaires peuvent apparaître, comme un walsender dans le cas où la base est le serveur primaire du cluster de réplication, un logger si PostgreSQL doit gérer lui-même les fichiers de traces (par défaut sous Red Hat, mais pas sous Debian), ou un archiver si l’instance est paramétrée pour générer des archives de ses journaux de transactions.
Ces différents processus seront étudiées en détail dans d’autres modules de formation.
Aucun de ces processus ne traite de requête pour le compte des utilisateurs. Ce sont des processus d’arrière-plan effectuant des tâches de maintenance.
Il existe aussi les background workers (processus d’arrière-plan), lancés par PostgreSQL, mais aussi par des extensions tierces. Par exemple, la parallélisation des requêtes se base sur la création temporaire de background workers épaulant le processus principal de la requête. La réplication logique utilise des background workers à plus longue durée de vie. De nombreuses extensions en utilisent pour des raisons très diverses. Le paramètre max_worker_processes régule le nombre de ces workers. Ne descendez pas en-dessous du défaut (8). Il faudra même parfois monter plus haut.
1.4 PROCESSUS PAR CLIENT (CLIENT BACKEND)
Pour chaque client, nous avons un processus:
créé à la connexion
créé à la connexion
dédié au client…
…et qui dialogue avec lui
détruit à la déconnexion
Un processus gère une requête
peut être aidé par d’autres processus
Le nombre de processus est régi par les paramètres:
max_connections(défaut: 100) - connexions réservéescompromis nombre requêtes actives/nombre cœurs/complexité/mémoire
Pour chaque nouvelle session à l’instance, le processus postmaster crée un processus fils qui s’occupe de gérer cette session. Il y a donc un processus dédié à chaque connexion cliente, et ce processus est détruit à fin de cette connexion.
Ce processus dit backend reçoit les ordres SQL, les interprète, exécute les requêtes, trie les données, et enfin retourne les résultats. Dans certains cas, il peut demander le lancement d’autres processus pour l’aider dans l’exécution d’une requête en lecture seule (parallélisme).
Le dialogue entre le client et ce processus respecte un protocole réseau bien défini. Le client n’a jamais accès aux données par un autre moyen que par ce protocole.
Le nombre maximum de connexions à l’instance simultanées, actives ou non, est limité par le paramètre max_connections. Le défaut est 100.
Certaines connexions sont réservées. Les administrateurs doivent pouvoir se connecter à l’instance même si la limite est atteinte. Quelques connexions sont donc réservées aux superutilisateurs (paramètre superuser_reserved_connections, à 3 par défaut). On peut aussi octroyer le rôle
pg_use_reserved_connections à certains utilisateurs pour leur garantir l’accès à un nombre de connexions réservées, à définir avec le paramètre reserved_connections (vide par défaut), cela à partir de PostreSQL 16.
Attention : modifier un de ces paramètres impose un redémarrage complet de l’instance, puisqu’ils ont un impact sur la taille de la mémoire partagée entre les processus PostgreSQL. Il faut donc réfléchir au bon dimensionnement avant la mise en production.
La valeur 100 pour max_connections est généralement suffisante. Il peut être intéressant de la diminuer pour se permettre de monter work_mem et autoriser plus de mémoire de tri. Il est possible de monter max_connections pour qu’un plus grand nombre de clients puisse se connecter en même temps.
Il s’agit aussi d’arbitrer entre le nombre de requêtes à exécuter à un instant t, le nombre de CPU disponibles, la complexité des requêtes, et le nombre de processus que peut gérer l’OS. Ce dimensionnement est encore compliqué par le parallélisme et la limitation de la bande passante des disques.
Intercaler un « pooler » entre les clients et l’instance peut se justifier dans certains cas:
connexions/déconnexions très fréquentes (la connexion a un coût);
centaines, voire milliers, de connexions généralement inactives.
Le plus réputé est PgBouncer, mais il est aussi souvent inclus dans des serveurs d’application (par exemple Tomcat).
1.5 GESTION DE LA MÉMOIRE
Structure de la mémoire sous PostgreSQL - Zone de mémoire partagée:
shared buffers surtout
…
Zone de chaque processus
tris en mémoire (
work_mem)…
La gestion de la mémoire dans PostgreSQL mérite un module de formation à lui tout seul.
Pour le moment, bornons-nous à la séparer en deux parties: la mémoire partagée et celle attribuée à chacun des nombreux processus.
La mémoire partagée stocke principalement le cache des données de PostgreSQL (shared buffers, paramètre shared_buffers), et d’autres zones plus petites: cache des journaux de transactions, données de sessions, les verrous, etc.
La mémoire propre à chaque processus sert notamment aux tris en mémoire (définie en premier lieu par le paramètre work_mem), au cache de tables temporaires, etc.
1.6 FICHIERS
Une instance est composée de fichiers:
Répertoire de données
Fichiers de configuration
Fichier PID
Tablespaces
Statistiques
Fichiers de trace
Une instance est composée des éléments suivants:
Le répertoire de données:
Il contient les fichiers obligatoires au bon fonctionnement de l’instance : fichiers de données, journaux de transaction….
Les fichiers de configuration:
Selon la distribution, ils sont stockés dans le répertoire de données(Red Hat et dérivés comme CentOS ou Rocky Linux), ou dans /etc/postgresql (Debian et dérivés).
Un fichier PID:
Il permet de savoir si une instance est démarrée ou non, et donc à empêcher un second jeu de processus d’y accéder.
Le paramètre external_pid_file permet d’indiquer un emplacement où PostgreSQL créera un second fichier de PID, généralement à l’extérieur de son répertoire de données.
Des tablespaces:
Ils sont totalement optionnels. Ce sont des espaces de stockage supplémentaires, stockés habituellement dans d’autres systèmes de fichiers.
Le fichier de statistiques d’exécution:
Généralement dans pg_stat_tmp/.
Les fichiers de trace:
Typiquement, des fichiers avec une variante du nom postgresql.log, souvent datés. Ils sont par défaut dans le répertoire de l’instance, sous log/. Sur Debian, ils sont redirigés vers la sortie d’erreur du système. Ils peuvent être redirigés vers un autre mécanisme du système d’exploitation (syslog sous Unix, journal des événements sous Windows),
1.6.1 Répertoire de données
- Une seule instance PostgreSQL doit y accéder!
Le répertoire de données est souvent appelé PGDATA, du nom de la variable d’environnement que l’on peut faire pointer vers lui pour simplifier l’utilisation de nombreux utilitaires PostgreSQL. Il est possible aussi de le connaître, une fois connecté à une base de l’instance, en interrogeant le paramètre data_directory.
Ce répertoire ne doit être utilisé que par une seule instance (processus) à la fois! PostgreSQL vérifie au démarrage qu’aucune autre instance du même serveur n’utilise les fichiers indiqués, mais cette protection n’est pas absolue, notamment avec des accès depuis des systèmes différents (ou depuis un conteneur comme docker). Faites donc bien attention de ne lancer PostgreSQL qu’une seule fois sur un répertoire de données.
Il est recommandé de ne jamais créer ce répertoire PGDATA à la racine d’un point de montage, quelque soit le système d’exploitation et le système de fichiers utilisé. Si un point de montage est dédié à l’utilisation de PostgreSQL, positionnez-le toujours dans un sous-répertoire, voire deux niveaux en dessous du point de montage.(par exemple <point de montage>/<version majeure>/<nom instance>).
Voir à ce propos le chapitre Use of Secondary File Systems dans la documentation officielle: https: //www.postgresql.org/docs/current/creating-cluster.html.
Vous pouvez trouver une description de tous les fichiers et répertoires dans la documentation officielle1.
1.6.2 Fichiers de configuration
postgresql.conf(+ fichiers inclus) -postgresql.auto.confpg_hba.conf(+ fichiers inclus (v16))pg_ident.conf(idem)
Les fichiers de configuration sont de simples fichiers textes. Habituellement, ce sont les suivants.
postgresql.conf contient une liste de paramètres, sous la forme paramètre=valeur. Tous les paramètres sont modifiables (et présents) dans ce fichier. Selon la configuration, il peut inclure d’autres fichiers, mais ce n’est pas le cas par défaut. Sous Debian, il est sous /etc.
postgresql.auto.conf stocke les paramètres de configuration fixés en utilisant la commande ALTER SYSTEM. Il surcharge donc postgresql.conf. Comme pour postgresql.conf, sa modification impose de recharger la configuration ou redémarrer l’instance. Il est techniquement possible, mais déconseillé, de le modifier à la main. postgresql.auto.conf est toujours dans le répertoire des données, même si postgresql.conf est ailleurs.
pg_hba.conf contient les règles d’authentification à la base selon leur identité, la base, la provenance, etc.
pg_ident.conf est plus rarement utilisé. Il complète pg_hba.conf, par exemple pour rapprocher des utilisateurs système ou propres à PostgreSQL.
Ces deux derniers fichiers peuvent eux-mêmes inclure d’autres fichiers (depuis PostgreSQL 16). Leur utilisation est décrite dans notre première formation2.
1.6.3 Autres fichiers dans PGDATA
PG_VERSION: fichier contenant la version majeure de l’instancepostmaster.pidnombreuses informations sur le processus père
fichier externe possible, paramètre
external_pid_filepostmaster.opts
PG_VERSION est un fichier. Il contient en texte lisible la version majeure devant être utilisée pour accéder au répertoire (par exemple 15). On trouve ces fichiers PG_VERSION à de nombreux endroits de l’arborescence de PostgreSQL, par exemple dans chaque répertoire de base du répertoire PGDATA/base/ ou à la racine de chaque tablespace.
Le fichier postmaster.pid est créé au démarrage de PostgreSQL. PostgreSQL y indique le PID du processus père sur la première ligne, l’emplacement du répertoire des données sur la deuxième ligne et la date et l’heure du lancement de postmaster sur la troisième ligne ainsi que beaucoup d’autres informations. Par exemple:
Le processus père de cette instance PostgreSQL a comme PID le 7771. Ce processus a bien réclamé une sémaphore d’identifiant 54919263. Cette sémaphore correspond à des segments de mémoire partagée pour un total de 56 octets. Le répertoire de données se trouve bien dans /var/lib/postgresql/15/data.
Le fichier postmaster.pid est supprimé lors de l’arrêt de PostgreSQL. Cependant, ce n’est pas le cas après un arrêt brutal. Dans ce genre de cas, PostgreSQL détecte le fichier et indique qu’il va malgré tout essayer de se lancer s’il ne trouve pas de processus en cours d’exécution avec ce PID. Un fichier supplémentaire peut être créé ailleurs grâce au paramètre external_pid_file, c’est notamment le défaut sous Debian:
Par contre, ce fichier ne contient que le PID du processus père.
Quant au fichier postmaster.opts, il contient les arguments en ligne de commande correspondant au dernier lancement de PostgreSQL. Il n’est jamais supprimé. Par exemple:
1.6.4 Fichiers de données
base/: contient les fichiers de donnéesun sous-répertoire par base de données
pgsql_tmp: fichiers temporairesglobal/: contient les objets globaux à toute l’instance
base/ contient les fichiers de données (tables, index, vues matérialisées, séquences). Il contient un sous-répertoire par base, le nom du répertoire étant l’OID de la base dans pg_database. Dans ces répertoires, nous trouvons un ou plusieurs fichiers par objet à stocker. Ils sont nommés ainsi:
Le nom de base du fichier correspond à l’attribut
relfilenodede l’objet stocké, dans la tablepg_class(une table, un index…). Il peut changer dans la vie de l’objet (par exemple lors d’unVACUUM FULL, unTRUNCATE…)Si le nom est suffixé par un «. » suivi d’un chiffre, il s’agit d’un fichier d’extension de l’objet: un objet est découpé en fichiers de 1 Go maximum.
Si le nom est suffixé par
_fsm, il s’agit du fichier stockant la Free Space Map (liste des blocs réutilisables).Si le nom est suffixé par
_vm, il s’agit du fichier stockant la Visibility Map (liste des blocs intégralement visibles, et donc ne nécessitant pas de traitement parVACUUM).
Un fichier base/1247/14356.1 est donc le second segment de l’objet ayant comme relfilenode 14356 dans le catalogue pg_class, dans la base d’OID 1247 dans la table pg_database.
Savoir identifier cette correspondance ne sert que dans des cas de récupération de base très endommagée. Vous n’aurez jamais, durant une exploitation normale, besoin d’obtenir cette correspondance. Si, par exemple, vous avez besoin de connaître la taille de la table test dans une base, il vous suffit d’exécuter la fonction pg_table_size(). En voici un exemple complet:
Depuis la ligne de commande, il existe un utilitaire nommé oid2name, dont le but est de faire la liaison entre le nom de fichier et le nom de l’objet PostgreSQL. Il a besoin de se connecter à la base:
Le répertoire base peut aussi contenir un répertoire pgsql_tmp. Ce répertoire contient des fichiers temporaires utilisés pour stocker les résultats d’un tri ou d’un hachage. La fonction pg_ls_tmpdir() affiche le contenu de ce répertoire, ce qui permet de suivre la consommation de fichiers temporaires.
Si nous demandons au sein d’une première session:
alors nous pourrons suivre les fichiers temporaires depuis une autre session:
Le répertoire global/ contient notamment les objets globaux à toute une instance, comme la table des bases de données, celle des rôles ou celle des tablespaces ainsi que leurs index.
1.6.5 Fichiers liés aux transactions
pg_wal/: journaux de transactionssous-répertoire
archive_statusnom: timeline, journal, segment
ex:
00000002 00000142 000000FFcréés, initialisés à zéro, recyclés
pg_xact/: état des transactionsmais aussi:
pg_commit_ts/,pg_multixact/,pg_serial/\pg_snapshots/,pg_subtrans/,pg_twophase/Ces fichiers sont vitaux!
Le répertoire pg_wal contient les journaux de transactions. Ces journaux garantissent la durabilité des données dans la base, en traçant toute modification devant être effectuée AVANT de l’effectuer réellement en base.
Les fichiers contenus dans pg_wal ne doivent jamais être effacés manuellement. Ces fichiers sont cruciaux au bon fonctionnement de la base. PostgreSQL gère leur création et suppression. S’ils sont toujours présents, c’est que PostgreSQL en a besoin.
Par défaut, les fichiers des journaux font tous 16 Mo. Ils ont des noms sur 24 caractères, comme par exemple:
La première partie d’un nom de fichier (ici 00000002) correspond à la timeline (« ligne de temps »),
qui ne s’incrémente que lors d’une restauration de sauvegarde ou une bascule entre serveurs primaire et secondaire. La deuxième partie (ici 00000142 puis 00000143) correspond au numéro de journal à proprement parler, soit un ensemble de fichiers représentant 4 Go. La dernière partie correspond au numéro du segment au sein de ce journal. Selon la taille du segment fixée à l’initialisation, il peut aller de 00000000 à 000000FF (256 segments de 16 Mo, configuration par défaut, soit 4 Go), à 00000FFF (4096 segments de 1 Mo), ou à 0000007F (128 segments de 32 Mo, exemple ci-dessus), etc. Une fois ce maximum atteint, le numéro de journal au centre est incrémenté et les numéros de segments reprennent à zéro.
L’ordre d’écriture des journaux est numérique (en hexadécimal), et leur archivage doit suivre cet ordre. Il ne faut pas se fier à la date des fichiers pour le tri: pour des raisons de performances, PostgreSQL recycle généralement les fichiers en les renommant. Dans l’exemple ci-dessus, le dernier journal écrit est 000000020000014300000020 et non 000000020000014300000024.
Toujours pour des raisons de performance liées aux métadata (voir cette explication d’Andres Freund3), les nouveaux journaux sont initialisés par des zéros avant d’être utilisés. Recyclage et initialisation peuvent être désactivés en passant les paramètres wal_recycle et wal_init_zero à off, ce qui n’est conseillé que sur certains systèmes de fichiers comme ZFS ou btrfs.
Dans le cadre d’un archivage PITR et/ou d’une réplication par log shipping, le sous-répertoire pg_wal/archive_status indique l’état des journaux dans le contexte de l’archivage. Les fichiers .ready indiquent les journaux restant à archiver (normalement peu nombreux), les .done ceux déjà archivés. Il est possible de connaître facilement le contenu de ce répertoire en utilisant la fonction pg_ls_archive_statusdir():
Le répertoire pg_xact contient l’état de toutes les transactions passées ou présentes sur la base (validées, annulées, en sous-transaction ou en cours), comme nous le détaillerons dans le module « Mécanique du moteur transactionnel ».
Les fichiers contenus dans le répertoire pg_xact ne doivent jamais être effacés. Ils sont cruciaux au bon fonctionnement de la base.
D’autres répertoires contiennent des fichiers essentiels à la gestion des transactions:
pg_commit_tscontient l’horodatage de la validation de chaque transaction;pg_multixactest utilisé dans l’implémentation des verrous partagés (SELECT … FOR SHARE);pg_serialest utilisé dans l’implémentation de SSI (Serializable Snapshot Isolation);pg_snapshotsest utilisé pour stocker les snapshots exportés de transactions;pg_subtransstocke l’imbrication des transactions lors de sous-transactions (lesSAVEPOINTS);pg_twophaseest utilisé pour l’implémentation du Two-Phase Commit, aussi appelétransaction préparée,2PC, ou transactionXAdans le monde Java par exemple.
Si vous mettez la main sur de très vieilles versions, il faut savoir que jusqu’en 9.6, pg_wal s’appelait pg_xlog et pg_xact s’appelait pg_clog. Le suffixe log ne veut pas dire que le contenu du dossier n’est que de la trace…
1.6.6 Fichiers liés à la réplication
pg_logical/pg_repslot/
pg_logical contient des informations sur la réplication logique.
pg_replslot contient des informations sur les slots de réplications, qui sont un moyen de fiabiliser la réplication physique ou logique.
Sans réplication en place, ces répertoires sont quasi-vides. Là encore, il ne faut pas toucher à leur contenu.
1.6.7 Répertoire des tablespaces
pg_tblspc/: tablespacessi vraiment nécessaires
liens symboliques ou points de jonction
totalement optionnels
Dans PGDATA, le sous-répertoire pg_tblspc contient les tablespaces, c’est-à-dire des espaces de stockage.
1.6.7.1 Sous Linux
Sous Linux, ce sont des liens symboliques vers un simple répertoire extérieur à PGDATA. Chaque lien symbolique a comme nom l’OID du tablespace (table système pg_tablespace). PostgreSQL y crée un répertoire lié aux versions de PostgreSQL et du catalogue, et y place les fichiers de données.
1.6.7.2 Sous Windows
Sous Windows, les liens sont à proprement parler des Reparse Points (ou Junction Points):
Par défaut, pg_tblspc/ est vide. N’existent alors que les tablespaces pg_global (sous-répertoire global/ des objets globaux à l’instance) et pg_default (soit base/).
La création d’autres tablespaces est totalement optionnelle.
Leur utilité et leur gestion seront abordés plus loin.
1.6.8 Fichiers des statistiques d’activité
Statistiques d’activité:
stats collector(≤v14) & extensionspg_stat_tmp/: temporairespg_stat/: définitif
pg_stat_tmp est, jusqu’en version 15, le répertoire par défaut de stockage des statistiques d’activité de PostgreSQL, comme les entrées-sorties ou les opérations de modifications sur les tables. Ces fichiers pouvant générer une grande quantité d’entrées-sorties, l’emplacement du répertoire peut être modifié avec le paramètre stats_temp_directory. Par exemple, Debian place ce paramètre par défaut en tmpfs:
À l’arrêt, ces statistiques sont sauvegardées dans le répertoire pg_stat/ (quelle que soit la version de PostgreSQL).
PostgreSQL gérant celles-ci en mémoire partagée à partir de la version 15, le collecteur n’existe plus, ni le paramètre stats_temp_directory. Mais un répertoire pg_stat_tmp (emplacement non configurable) est encore utilisé par des extensions comme pg_stat_statements ou pg_stat_kcache.
1.6.9 Autres répertoires
pg_dynshmem est utilisé par les extensions utilisant de la mémoire partagée dynamique.
pg_notify est utilisé par le mécanisme de gestion de notification de PostgreSQL (LISTEN et NOTIFY) qui permet de passer des messages de notification entre sessions.
1.6.10 Les fichiers de traces (journaux)
Fichiers texte traçant l’activité
Très paramétrables
Gestion des fichiers soit:
par PostgreSQL
délégués au système d’exploitation (syslog, eventlog)
Le paramétrage des journaux est très fin. Leur configuration est le sujet est évoquée dans notre première formation4.
Si logging_collector est activé, c’est-à-dire que PostgreSQL collecte lui-même ses traces, l’emplacement de ces journaux se paramètre grâce aux paramètres log_directory, le répertoire où les stocker, et log_filename, le nom de fichier à utiliser, ce nom pouvant utiliser des échappements comme %d pour le jour de la date, par exemple. Les droits attribués au fichier sont précisés par le paramètre log_file_mode.
Un exemple pour log_filename avec date et heure serait:
La liste des échappements pour le paramètre log_filename est disponible dans la page de manuel de la fonction strftime sur la plupart des plateformes de type UNIX.
1.7 RÉSUMÉ
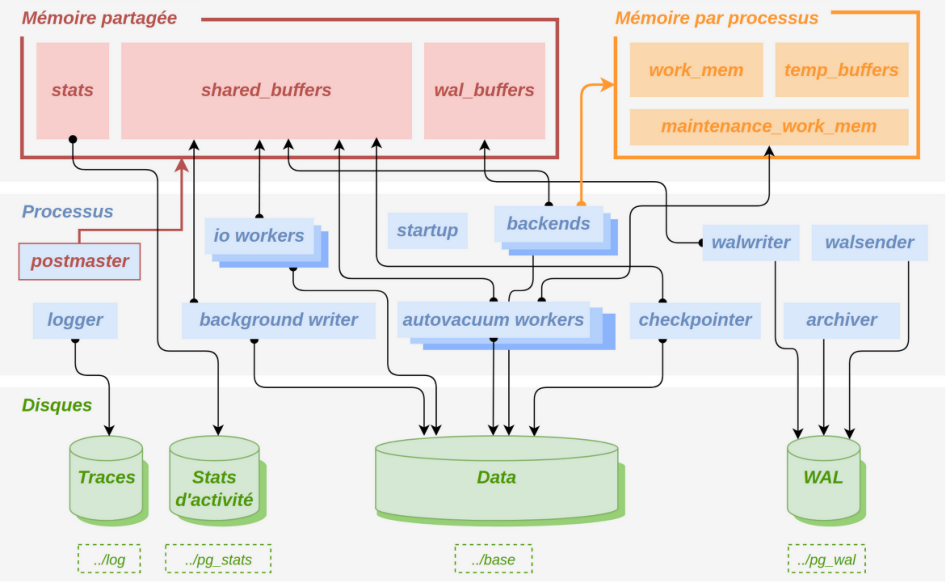
Ce schéma ne soit à présent plus avoir aucun secret pour vous.
1.8 CONCLUSION
PostgreSQL est complexe, avec de nombreux composants
Une bonne compréhension de cette architecture est la clé d’une bonne administration.
Pour aller (beaucoup) plus loin:
|
1.8.1 Questions
s.) é)| N’hésitez pas, c’est le moment!
1.9 QUIZ
1.10 INSTALLATION DE POSTGRESQL DEPUIS LES PAQUETS COMMUNAUTAIRES
L’installation est détaillée ici pour Rocky Linux 8 et 9 (similaire à Red Hat et à d’autres variantes comme Oracle Linux et Fedora), et Debian/Ubuntu.
Elle ne dure que quelques minutes.
1.10.1 Sur Rocky Linux 8, 9 ou 10
ATTENTION: Red Hat, CentOS, Rocky Linux fournissent souvent par défaut des versions de PostgreSQL qui ne sont plus supportées. Ne jamais installer les packages postgresql, postgresql-client et postgresql-server! L’utilisation des dépôts du PGDG est fortement conseillée.
Installation du dépôt communautaire:
Les dépôts de la communauté sont sur https://yum.postgresql.org/. Les commandes qui suivent sont inspirées de celles générées par l’assistant sur https://www.postgresql.org/download/linux/redhat/. Il n’y a guère que les informations de version qui diffèrent en fonction de:
la version majeure de PostgreSQL (ici la 18);
la distribution (ici Rocky Linux 9);
l’architecture (ici x86_64, la plus courante).
Les commandes sont à lancer sous root:
# dnf install -y https://download.postgresql.org/pub/repos/yum/reporpms/EL-9-x86_64/pgdg-redhat-repo-latest.noarch.rpm
Installation de PostgreSQL 18 (client, serveur, librairies, extensions):
Les outils clients et les librairies nécessaires seront automatiquement installés.
Une fonctionnalité avancée optionnelle, le JIT (Just In Time compilation), nécessite un paquet séparé.
# dnf install postgresql18-llvmjit
Création d’une première instance:
C’est optionnel, mais il est conseillé de déclarer PGSETUP_INITDB_OPTIONS, notamment pour forcer les traces en anglais. Depuis la version 18, les sommes de contrôle sont automatiquement activées.
Ce dernier fichier permet de vérifier que tout s’est bien passé et doit finir par:
Chemins:
| Objet | Chemin |
|---|---|
| Binaires | /usr/pgsql-18/bin |
| Répertoire de l’utilisateurpostgres | /var/lib/pgsql |
PGDATA par défaut | /var/lib/pgsql/18/data |
| Fichiers de configuration | dans PGDATA/ |
| Traces | dans PGDATA/log |
Configuration:
Modifier postgresql.conf est facultatif pour un premier lancement.
Commandes d’administration habituelles:
Démarrage, arrêt, statut, rechargement à chaud de la configuration, redémarrage:
# systemctl start postgresql-18# systemctl stop postgresql-18# systemctl status postgresql-18# systemctl reload postgresql-18# systemctl restart postgresql-18
Test rapide de bon fonctionnement et connexion à psql:
Démarrage de l’instance au lancement du système d’exploitation:
Ouverture du firewall pour le port 5432:
Voir si le firewall est actif:
Si c’est le cas, autoriser un accès extérieur:
# firewall-cmd --zone=public --add-port=5432/tcp --permanent# firewall-cmd --reload# firewall-cmd --list-all
(Rappelons que listen_addresses doit être également modifié dans postgresql.conf.)
Création d’autres instances:
Si des instances de versions majeures différentes doivent être installées, il faut d’abord installer les binaires pour chacune (adapter le numéro dans dnf install …) et appeler le script d’installation de chaque version. l’instance par défaut de chaque version vivra dans un sous-répertoire numéroté de /var/lib/pgsql automatiquement créé à l’installation. Il faudra juste modifier les ports dans les postgresql.conf pour que les instances puissent tourner simultanément.
Si plusieurs instances d’une même version majeure (forcément de la même version mineure) doivent cohabiter sur le même serveur, il faut les installer dans des PGDATA différents.
Ne pas utiliser de tiret dans le nom d’une instance (problèmes potentiels avec systemd).
Respecter les normes et conventions de l’OS: placer les instances dans un nouveau sousrépertoire de
/var/lib/pgsqsl/18/(ou l’équivalent pour d’autres versions majeures).
Pour créer une seconde instance, nommée par exemple infocentre:
Création du fichier service de la deuxième instance:
# cp /lib/systemd/system/postgresql-18.service \ /etc/systemd/system/postgresql-18-infocentre.serviceModification de ce dernier fichier avec le nouveau chemin:
- Option 1: création d’une nouvelle instance vierge:
Option 2: restauration d’une sauvegarde: la procédure dépend de votre outil.
Adaptation de
/var/lib/pgsql/18/infocentre/postgresql.conf(port surtout).Commandes de maintenance de cette instance:
# systemctl [start|stop|reload|status] postgresql-18-infocentre # systemctl [enable|disable] postgresql-18-infocentreOuvrir le nouveau port dans le firewall au besoin.
1.10.2 Sur Debian / Ubuntu
L’installation ne varie quasiment pas selon les versions de Debian et Ubuntu. Ce qui suit a été testé sur Debian 10 à 13 et Ubuntu LTS 22.04 et 24.04.
Sauf précision, tout est à effectuer en tant qu’utilisateur root.
Référence: https://apt.postgresql.org/
Installation du dépôt communautaire:
L’installation des dépôts du PGDG est prévue dans le paquet Debian postgresql-common:
Ce dernier ordre créera le fichier du dépôt /etc/apt/sources.list.d/pgdg.list adapté à la distribution en place.
Installation de PostgreSQL 18:
La méthode la plus propre consiste à modifier la configuration par défaut avant l’installation:
Dans /etc/postgresql-common/createcluster.conf, paramétrer au moins les traces en anglais. Depuis la version 18, les sommes de contrôle sont automatiquement activées.
Puis installer les paquets serveur et clients et leurs dépendances:
La première instance est automatiquement créée, avec un nom (main par défaut‘), déclarée comme service à lancer au démarrage du système, puis démarrée.
/var/log/postgresql/postgresql-18-main.log$ systemctl status postgresql@18-main●postgresql@18-main.service - PostgreSQL Cluster 18-main Loaded: loaded (/usr/lib/systemd/system/postgresql@.service; enabled-runtime;preset: enabled)
L’utilisateur système postgres peut y accéder immédiatement.
Chemins:
| Objet | Chemin |
|---|---|
| Binaires | /usr/lib/postgresql/18/bin/ |
| Objet | Chemin |
|---|---|
| Répertoire de l’utilisateurpostgres | /var/lib/postgresql |
| PGDATA de l’instance par défaut | /var/lib/postgresql/18/main |
| Fichiers de configuration | dans /etc/postgresql/18/main/ |
| Traces | dans /var/log/postgresql/ |
Configuration
Modifier postgresql.conf est facultatif pour un premier essai.
Démarrage/arrêt de l’instance, rechargement de configuration:
Debian fournit ses propres outils, qui demandent en paramètre la version et le nom de l’instance:
Démarrage de l’instance avec le serveur:
C’est en place par défaut, et modifiable dans /etc/postgresql/18/main/start.conf.
Ouverture du firewall:
Debian et Ubuntu n’installent pas de firewall par défaut.
Statut des instances du serveur:
/var/log/postgresql/postgresql-18-main.log
Test rapide de bon fonctionnement et connexion à psql:
Destruction d’une instance:
Création d’autres instances:
Ce qui suit est valable pour remplacer l’instance par défaut par une autre, par exemple pour activer les sommes de contrôles (checksums) avant la version v18:
- optionnellement,
/etc/postgresql-common/createcluster.confpermet de mettre en place tout d’entrée les messages en anglais, le format des traces, l’emplacement séparé pour les journaux ou les checksums pour une version inférieure à 18:
créer une instance:
# pg_createcluster 18 infocentre
Il est également possible de préciser certains paramètres du fichier postgresql.conf, voire les chemins des fichiers (il est conseillé de conserver les chemins par défaut):
# pg_createcluster 18 infocentre \--port=12345 \--datadir=/PGDATA/18/infocentre \--pgoption shared_buffers='8GB' --pgoption work_mem='50MB' \---data-checksums --waldir=/ssd/postgresql/18/infocentre/journauxadapter au besoin
/etc/postgresql/18/infocentre/postgresql.conf;démarrage:
# pg_ctlcluster 18 infocentre start
1.10.3 Accès à l’instance depuis le serveur même (toutes distributions)
Par défaut, l’instance n’est accessible que par l’utilisateur système postgres, qui n’a pas de mot de passe. Un détour par sudo est nécessaire:
Ce qui suit permet la connexion directement depuis un utilisateur du système:
Pour des tests (pas en production!), il suffit de passer à trust le type de la connexion en local dans le pg_hba.conf:
La connexion en tant qu’utilisateur postgres (ou tout autre) n’est alors plus sécurisée:
Une authentification par mot de passe est plus sécurisée:
- dans
pg_hba.conf, paramétrer une authentification par mot de passe pour les accès depuislocalhost(déjà en place sous Debian):
(Ne pas oublier de recharger la configuration en cas de modification.)
- ajouter un mot de passe à l’utilisateur
postgresde l’instance:
- Pour se connecter sans taper le mot de passe à une instance, un fichier
.pgpassdans le répertoire personnel doit contenir les informations sur cette connexion:
Ce fichier doit être protégé des autres utilisateurs:
$ chmod 600 ~/.pgpassPour n’avoir à taper que
psql, on peut définir ces variables d’environnement dans la session voire dans~/.bashrc:
Rappels:
en cas de problème, consulter les traces (dans
/var/lib/pgsql/18/data/logou/var/log/postgresql/);toute modification de
pg_hba.confoupostgresql.confimpliquant de recharger la configuration peut être réalisée par une de ces trois méthodes en fonction du système:
1.11 TRAVAUX PRATIQUES
La version en ligne des solutions de ces TP est disponible sur https://dali.bo/m1_solutions.
1.11.1 Processus
But: voir quelques processus de PostgreSQL
Si ce n’est pas déjà fait, démarrer l’instance PostgreSQL.
Lister les processus du serveur PostgreSQL. Qu’observe-t-on?
Se connecter à l’instance PostgreSQL.
Dans un autre terminal lister de nouveau les processus du serveur PostgreSQL. Qu’observe-t-on?
Créer une nouvelle base de données nommée b0.
Se connecter à la base de données b0 et créer une table t1 avec une colonne id de type integer.
Insérer 10 millions de lignes dans la table t1 avec:
Dans un autre terminal lister de nouveau les processus du serveur PostgreSQL. Qu’observe-t-on?
Configurer la valeur du paramètre max_connections à 15.
Redémarrer l’instance PostgreSQL.
Vérifier que la modification de la valeur du paramètre max_connections a été prise en compte.
Se connecter 15 fois à l’instance PostgreSQL sans fermer les sessions, par exemple en lançant plusieurs fois:
Se connecter une seizième fois à l’instance PostgreSQL. Qu’observe-t-on?
Configurer la valeur du paramètre max_connections à sa valeur initiale.
1.11.2 Fichiers
But: voir les fichiers de PostgreSQL
Aller dans le répertoire des données de l’instance PostgreSQL. Lister les fichiers.
Aller dans le répertoire base. Lister les fichiers.
À quelle base est lié chaque répertoire présent dans le répertoire base? (Voir l’oid de la base dans pg_database ou l’utilitaire en ligne de commande oid2name)
Créer une nouvelle base de données nommée b1. Qu’observe-t-on dans le répertoire base?
Se connecter à la base de données b1. Créer une table t1 avec une colonne id de type integer.
Récupérer le chemin vers le fichier correspondant à la table t1 (il existe une fonction pg_relation_filepath).
Regarder la taille du fichier correspondant à la table t1. Pourquoi est-il vide?
Insérer une ligne dans la table t1. Quelle taille fait le fichier de la table t1?
Insérer 500 lignes dans la table t1 avec generate_series. Quelle taille fait le fichier de la table t1?
Pourquoi cette taille pour simplement 501 entiers de 4 octets chacun?
1.12 TRAVAUX PRATIQUES (SOLUTIONS)
1.12.1 Processus
Si ce n’est pas déjà fait, démarrer l’instance PostgreSQL.
Sous Rocky Linux, CentOS ou Red Hat en tant qu’utilisateur root:
Lister les processus du serveur PostgreSQL. Qu’observe-t-on?
En tant qu’utilisateur postgres:
Se connecter à l’instance PostgreSQL.
Dans un autre terminal lister de nouveau les processus du serveur PostgreSQL. Qu’observe-t-on?
Il y a un nouveau processus (ici PID 28780) qui va gérer l’exécution des requêtes du client psql.
Créer une nouvelle base de données nommée b0.
Depuis le shell, en tant que postgres:
Alternativement, depuis la session déjà ouverte dans psql:
Se connecter à la base de données b0 et créer une table t1 avec une colonne id de type integer.
Pour se connecter depuis le shell:
ou depuis la session psql:
Création de la table:
Insérer 10 millions de lignes dans la table t1 avec:
Dans un autre terminal lister de nouveau les processus du serveur PostgreSQL. Qu’observe-t-on?
Le processus serveur exécute l’ INSERT, ce qui se voit au niveau du nom du processus. Seul est affiché le dernier ordre SQL (ie le mot INSERT et non pas la requête complète).
Configurer la valeur du paramètre max_connections à 15.
La première méthode est d’ouvrir le fichier de configuration postgresql.conf et de modifier la valeur du paramètre max_connections:
La seconde méthode se fait directement depuis psql en tant que superutilisateur:
ce dernier ordre fera apparaître une ligne dans le fichier /var/lib/pgsql/15/data/postgresql.auto.conf.
Dans les deux cas, la prise en compte n’est pas automatique. Pour ce paramètre, il faut redémarrer l’instance PostgreSQL.
Redémarrer l’instance PostgreSQL.
En tant qu’utilisateur root:
Vérifier que la modification de la valeur du paramètre max_connections a été prise en compte.
Se connecter 15 fois à l’instance PostgreSQL sans fermer les sessions, par exemple en lançant plusieurs fois:
Il est possible de le faire manuellement ou de l’automatiser avec ce petit script shell:
Se connecter une seizième fois à l’instance PostgreSQL. Qu’observe-t-on?
Il est impossible de se connecter une fois que le nombre de connexions a atteint sa limite configurée avec max_connections. Il faut donc attendre que les utilisateurs se déconnectent pour accéder de nouveau au serveur.
Configurer la valeur du paramètre max_connections à sa valeur initiale.
Si le fichier de configuration postgresql.conf avait été modifié, restaurer la valeur du paramètre max_connections à 100.
Si ALTER SYSTEM a été utilisée, il faudrait pouvoir entrer dans psql:
Mais cela ne fonctionne pas si toutes les connexions réservées à l’utilisateur ont été consommées (paramètre superuser_reserved_connections, par défaut à 3). Dans ce cas, il n’y a plus qu’à aller dans le fichier de configuration /var/lib/pgsql/15/data/postgresql.auto.conf, pour supprimer la ligne avec le paramètre max_connections avant de redémarrer l’instance PostgreSQL.
Il est déconseillé de modifier postgresql.auto.conf à la main, mais pour le TP, nous nous permettons quelques libertés.
Toutefois si l’instance est démarrée et qu’il est encore possible de s’y connecter, le plus propre est ceci:
Puis redémarrer PostgreSQL: toutes les connexions en cours vont être coupées.
Il est à présent possible de se reconnecter. Vérifier que cela a été pris en compte:
1.12.2 Fichiers
Aller dans le répertoire des données de l’instance PostgreSQL. Lister les fichiers.
En tant qu’utilisateur système postgres:
Aller dans le répertoire base. Lister les fichiers.
À quelle base est lié chaque répertoire présent dans le répertoire base? (Voir l’oid de la base dans pg_database ou l’utilitaire en ligne de commande oid2name)
Chaque répertoire correspond à une base de données. Le numéro indiqué est un identifiant système (OID). Il existe deux moyens pour récupérer cette information:
- directement dans le catalogue système
pg_database:
- avec l’outil
oid2name(à installer au besoin via le paquetpostgresql15-contrib):
Donc ici, le répertoire 1 correspond à la base template1, et le répertoire 5 à la base postgres (ces nombres peuvent changer suivant l’installation).
Créer une nouvelle base de données nommée b1. Qu’observe-t-on dans le répertoire base?
Un nouveau sous-répertoire est apparu, nommé 16405. Il correspond bien à la base b1 d’après oid2name.
Se connecter à la base de données b1. Créer une table t1 avec une colonne id de type integer.
Récupérer le chemin vers le fichier correspondant à la table t1 (il existe une fonction pg_relation_filepath).
La fonction a pour définition:
L’argument regclass peut être l’OID de la table, ou son nom.
L’emplacement du fichier sur le disque est donc:
Regarder la taille du fichier correspondant à la table t1. Pourquoi est-il vide?
/var/lib/pgsql/15/data/base/16405/16406
La table vient d’être créée. Aucune donnée n’a encore été ajoutée. Les métadonnées se trouvent dans d’autres tables (des catalogues systèmes). Donc il est logique que le fichier soit vide.
Insérer une ligne dans la table t1. Quelle taille fait le fichier de la table t1?
$ ls -l /var/lib/pgsql/15/data/base/16393/16398 -rw-------. 1 postgres postgres 8192 Nov 4 12:40 /var/lib/pgsql/15/data/base/16405/16406
Il fait à présent 8 ko. En fait, PostgreSQL travaille par blocs de 8 ko. Si une ligne ne peut être placée dans un espace libre d’un bloc existant, un bloc entier est ajouté à la table.
Vous pouvez consulter le fichier avec la commande hexdump -x <nom du fichier> (faites un CHECKPOINT avant pour être sûr qu’il soit écrit sur le disque).
Insérer 500 lignes dans la table t1 avec generate_series. Quelle taille fait le fichier de la table t1?
-rw-------. 1 postgres postgres 24576 Nov 4 12:41/var/lib/pgsql/15/data/base/16405/16406
Le fichier fait maintenant 24 ko, soit 3 blocs de 8 ko.
Pourquoi cette taille pour simplement 501 entiers de 4 octets chacun?
Nous avons enregistré 501 entiers dans la table. Un entier de type int4 prend 4 octets. Donc nous avons 2004 octets de données utilisateurs. Et pourtant, nous arrivons à un fichier de 24 ko.
En fait, PostgreSQL enregistre aussi dans chaque bloc des informations systèmes en plus des données utilisateurs. Chaque bloc contient un en-tête, des pointeurs, et l’ensemble des lignes du bloc. Chaque ligne contient les colonnes utilisateurs mais aussi des colonnes système. La requête suivante permet d’en savoir plus sur les colonnes présentes dans la table:
Vous pouvez voir ces colonnes système en les appelant explicitement:
L’en-tête de chaque ligne pèse 26 octets dans le cas général. Dans notre cas très particulier avec une seule petite colonne, c’est très défavorable mais ce n’est généralement pas le cas.
Avec 501 lignes de 26+4 octets, nous obtenons 15 ko. Chaque bloc possède quelques informations de maintenance: nous dépassons alors 16 ko, ce qui explique pourquoi nous en sommes à 24 ko (3 blocs).
Source : manuel complet PDF, révision 26.09, pages PDF 17-62. Les travaux pratiques et leurs solutions proviennent exclusivement de la version complète.
Pour poursuivre la lecture, voir la mécanique du moteur transactionnel et le MVCC.