2 Configuration de PostgreSQL
2/ Configuration de PostgreSQL
2.1 AU MENU
Les paramètres en lecture seule
Les différents fichiers de configuration
survol du contenu
Quelques paramétrages importants:
tablespaces
connexions
statistiques
optimiseur
2.2 PARAMÈTRES EN LECTURE SEULE
Options de compilation ou lors d’
initdbQuasiment jamais modifiés
risque d’incompatabilité des fichiers, avec les outils
Tailles de bloc ou de fichier
block_size: 8 kowal_block_size: 8 kosegment_size: 1 Gowal_segment_size: 16 Mo (option--wal-segsized’initdben v11)
Ces paramètres sont en lecture seule, mais peuvent être consultés par la commande SHOW, ou en interrogeant la vue pg_settings. Il est possible aussi d’obtenir l’information via la commande pg_controldata.
block_sizeest la taille d’un bloc de données de la base, par défaut 8192 octets;wal_block_sizeest la taille d’un bloc de journal, par défaut 8192 octets;segment_sizeest la taille maximum d’un fichier de données, par défaut 1 Go;wal_segment_sizeest la taille d’un fichier de journal de transactions (WAL), par défaut 16 Mo.
Ces paramètres sont tous fixés à la compilation, sauf wal_segment_size. initdb accepte en effet l’option --wal-segsize et l’on peut monter la taille des journaux de transactions à 1 Go. Cela n’a d’intérêt que pour des instances générant énormément de journaux.
Recompiler avec une taille de bloc de 32 ko s’est déjà vu sur de très grosses installations (comme le rapporte par exemple Christophe Pettus (San Francisco, 2023)1) avec un shared_buffers énorme, mais cette configuration est très peu testée, nous la déconseillons dans le cas général.
Un moteur compilé avec des options non standard ne pourra pas ouvrir des fichiers n’ayant pas les mêmes valeurs pour ces options.
Des tailles non standard vous exposent à rencontrer des problèmes avec des outils s’attendant à des blocs de 8 ko. (Remontez alors le bug.)
2.3 FICHIERS DE CONFIGURATION
postgresql.conf(+ fichiers inclus)postgresql.auto.confpg_hba.conf(+ fichiers inclus (v16))pg_ident.conf(idem)
Les fichiers de configuration sont habituellement les 4 suivants:
postgresql.conf: il contient une liste de paramètres, sous la formeparamètre=valeur;pg_hba.conf: il contient les règles d’authentification à la base.pg_ident.conf: il complètepg_hba.conf, quand nous déciderons de nous reposer sur unmécanisme d’authentification extérieur à la base (identification par le système ou par un annuaire par exemple);
postgresql.auto.conf: il stocke les paramètres de configuration fixés en utilisant la commandeALTER SYSTEMet surcharge doncpostgresql.conf.
2.4 POSTGRESQL.CONF
Fichier principal de configuration:
Emplacement:
défaut/Red Hat & dérivés: répertoires des données (
/var/lib/…)Debian:
/etc/postgresql/<version>/<nom>/postgresql.confFormat
clé = valeurSections, commentaires (redémarrage!)
C’est le fichier le plus important. Il contient le paramétrage de l’instance. PostgreSQL le cherche au démarrage dans le PGDATA. Par défaut, dans les versions compilées, ou depuis les paquets sur Red Hat, CentOS ou Rocky Linux, il sera dans le répertoire principal avec les données (/var/lib/pgsql/15/data/postgresql.conf par exemple). Debian le place dans /etc (/etc/postgresql/15/main/postgresql.conf pour l’instance par défaut).
Dans le doute, il est possible de consulter la valeur du paramètre config_file, ici dans la configuration par défaut sur Rocky Linux:
Ce fichier contient un paramètre par ligne, sous le format:
Les commentaires commencent par « # » (croisillon) et les chaînes de caractères doivent être encadrées de « ’ » (single quote). Par exemple:
Les valeurs de ce fichier ne seront pas forcément les valeurs actives!
Nous allons en effet voir que l’on peut les surcharger.
2.4.1 Surcharge des paramètres de postgresql.conf
- Inclusion externe: -
include,include_if_exists,include_dir- Surcharge dans cet ordre: -ALTER SYSTEM SET …(⇒postgresql.auto.conf) - paramètres depg_ctl-ALTER DATABASE | ROLE … SET paramètre = …-SET/SET LOCAL- Consulter: -SHOW, -pg_settings,pg_file_settings-\drds
Le paramétrage ne dépend pas seulement du contenu de postgresql.conf.
2.4.1.1 Surcharge par des fichiers inclus
Nous pouvons inclure d’autres fichiers depuis postgresql.conf grâce à l’une de ces directives:
Le ou les fichiers indiqués sont alors inclus à l’endroit où la directive est positionnée. S’ils sont à la fin de postgresql.conf, ils surchargent donc son contenu.
Avec include, le fichier doit exister, sinon une erreur FATAL est levée. À l’inverse, include_if_exists accepte un fichier absent. include_dir est le plus souple : il désigne un répertoire dont PostgreSQL charge les fichiers *.conf. Sur Debian, par défaut, include_dir désigne un sous-répertoire vide du répertoire de configuration, par exemple /etc/postgresql/18/main/conf.d/.
Ces directives permettent notamment des ajustements de configuration propres à plusieurs machines d’un ensemble primaire/secondaires dont le postgresql.conf de base est identique, ou de gérer la configuration hors de postgresql.conf.
Si des paramètres sont répétés dans postgresql.conf, éventuellement suite à des inclusions, la dernière occurrence écrase les précédentes. Si un paramètre est absent, la valeur par défaut s’applique.
2.4.1.2 Surcharge par postgresql.auto.conf (ALTER SYSTEM)
Les fichiers précédents peuvent être surchargés par le fichier postgresql.auto.conf. Il est toujours dans le répertoire de données (même sur Debian). Il est géré par PostgreSQL et contient le résultat des commandes ALTER SYSTEM:
postgresql.auto.conf est principalement utilisé par les administrateurs et les outils qui n’ont pas les accès système ou les droits pour modifier postgresql.conf.
À partir de PostgreSQL 17, l’utilisation de ALTER SYSTEM peut être interdite, en passant le paramètre allow_alter_system à off. Le but est d’éviter des erreurs de manipulation quand la configuration est gérée par un outil extérieur, comme Ansible ou Patroni. À noter qu’un superutilisateur malveillant saura tout de même contourner cette limite.
Choisissez une seule des méthodes pour le paramétrage permanent (postgresql.conf, include, ALTER SYSTEM SET…, ou un outil externe) et ne les mélangez pas.
2.4.1.3 Surcharge via pg_ctl
Si des options sont passées directement en arguments à pg_ctl (situation rare), elles seront prises en compte en priorité par rapport à celles de ces fichiers de configuration. Cette technique est notamment utilisée par des outils de gestion d’instance comme pg_ctlcluster, pglift, CloudNativePG, Patroni…
2.4.1.4 Surcharge d’un rôle ou d’une base
Il est possible de surcharger les options modifiables à chaud par utilisateur, par base, et par combinaison « utilisateur+base ». Par exemple:
Ces surcharges sont visibles dans la table pg_db_role_setting ou via la commande \drds de psql.
2.4.1.5 Surcharge dans une session ou une transaction
Ensuite, un utilisateur peut changer à volonté les valeurs de beaucoup de paramètres au sein d’une session:
ou même juste au sein d’une transaction:
2.4.1.6 Résumé et exemples
Au final, l’ordre des surcharges est le suivant:
-> ALTER SYSTEM SET (postgresql.auto.conf)-> option de pg_ctl / postmaster-> paramètre par base-> paramètre par rôle-> paramètre base+rôle-> paramètre dans la chaîne de connexion-> paramètre de session (SET)
À titre d’exemple, voici ce qu’il se passe en appliquant la requête suivante:
La meilleure source d’information sur les valeurs actives est la vue pg_settings:
Nous constatons par exemple que, dans la session ayant effectué la requête, la valeur du paramètre client_min_messages a été modifiée à la valeur debug2. Nous pouvons aussi voir le contexte dans lequel le paramètre est modifiable: le client_min_messages est modifiable par l’utilisateur dans sa session. Le log_checkpoints seulement par sighup, c’est-à-dire par un pg_ctl reload, et le wal_segment_size n’est pas modifiable après l’initialisation de l’instance.
De nombreuses autres colonnes sont disponibles dans pg_settings, comme une description détaillée du paramètre, l’unité de la valeur, ou le fichier et la ligne d’où provient le paramètre. Le champ pending_restart indique si un paramètre a été modifié mais attend encore un redémarrage pour être appliqué.
Il existe aussi une vue pg_file_settings, qui indique la configuration présente dans les fichiers de configuration (mais pas forcément active!). Elle peut être utile lorsque la configuration est répartie dans plusieurs fichiers. La configuration propre à une base, un rôle ou une session n’y apparaît pas.
Par exemple, suite à un ALTER SYSTEM, les paramètres sont ajoutés dans postgresql.auto.conf mais un rechargement de la configuration n’est pas forcément suffisant pour qu’ils soient pris en compte:
2.4.2 Précédence des paramètres
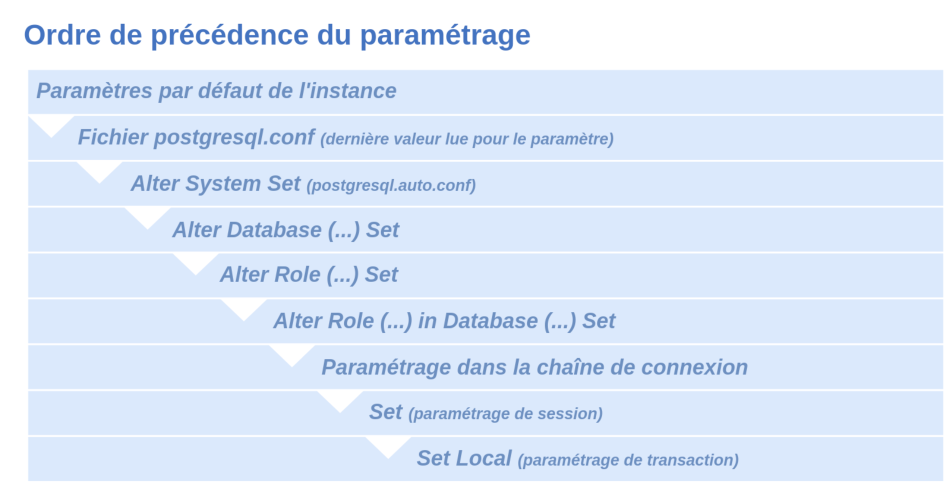
PostgreSQL offre une certaine granularité dans sa configuration, ainsi certains paramètres peuvent être surchargés par rapport au fichier postgresql.conf. Il est utile de connaître l’ordre de précédence. Par exemple, un utilisateur peut spécifier un paramètre dans sa session avec l’ordre SET, celui-ci sera prioritaire par rapport à la configuration présente dans le fichier postgresql.conf.
2.4.3 Survol de postgresql.conf
Emplacement de fichiers
Connections & authentification
Ressources (hors journaux de transactions)
Journaux de transactions
Réplication
Optimisation de requête
Traces
Statistiques d’activité
Autovacuum
Paramétrage client par défaut
Verrous
Compatibilité
postgresql.conf contient environ 300 paramètres. Il est séparé en plusieurs sections, dont les plus importantes figurent ci-dessous. Il n’est pas question de les détailler toutes.
La plupart des paramètres ne sont jamais modifiés. Les défauts sont souvent satisfaisants pour une petite installation. Les plus importants sont supposés acquis (au besoin, voir la formation DBA12).
Les principales sections sont:
Connections and authentication
S’y trouveront les classiques listen_addresses, port, max_connections, password_encryption, ainsi que les paramétrages TCP (keepalive) et SSL.
Resource usage (except WAL)
Cette partie fixe des limites à certaines consommations de ressources.
Sont normalement déjà bien connus shared_buffers, work_mem et maintenance_work_mem (qui seront couverts extensivement plus loin).
On rencontre ici aussi le paramétrage du VACUUM (pas directement de l’autovacuum!), du background writer, du parallélisme dans les requêtes.
Write-Ahead Log
Les journaux de transaction sont gérés ici. Cette partie sera également détaillée dans un autre module.
Tout est prévu pour faciliter la mise en place d’une réplication sans avoir besoin de modifier cette partie sur le primaire.
Dans la partie Archiving, l’archivage des journaux peut être activé pour une sauvegarde PITR ou une réplication par log shipping.
Tous les paramètres de restauration (qui peuvent servir à la réplication) figurent aussi dans les sections Archive Recovery et Recovery Target.
Replication
Cette partie fournit le nécessaire pour alimenter un secondaire en réplication par streaming, physique ou logique. Ici encore, l’essentiel du paramétrage nécessaire à un secondaire physique ou logique est intégré dans ce fichier.
Query tuning
Les paramètres qui peuvent influencer l’optimiseur sont à définir dans cette partie, notamment seq_page_cost et random_page_cost en fonction des disques, et éventuellement le parallélisme, le niveau de finesse des statistiques, le JIT…
Reporting and logging
Si le paramétrage par défaut des traces ne convient pas, le modifier ici. Il faudra généralement augmenter leur verbosité. Quelques paramètres log_* figurent dans d’autres sections.
Autovacuum
L’autovacuum fonctionne généralement convenablement, et des ajustements se font généralement table par table. Il arrive cependant que certains paramètres doivent être modifiés globalement.
Client connection defaults
Cette partie un peu fourre-tout définit le paramétrage au niveau d’un client: langue, fuseau horaire, extensions à précharger, tablespaces par défaut…
Lock management
Les paramètres de cette section sont rarement modifiés.
2.5 PG_HBA.CONF ET PG_IDENT.CONF
Authentification multiple:
utilisateur / base / source de connexion
Fichiers:
pg_hba.conf(Host Based Authentication)pg_ident.conf: si mécanisme externe d’authentification - paramètres:hba_fileetident_file
L’authentification est paramétrée au moyen du fichier pg_hba.conf. Dans ce fichier, pour une tentative de connexion à une base donnée, pour un utilisateur donné, pour un transport (IP, IPV6, Socket Unix, SSL ou non), et pour une source donnée, ce fichier permet de spécifier le mécanisme d’authentification attendu.
Si le mécanisme d’authentification s’appuie sur un système externe (LDAP, Kerberos, Radius…), des tables de correspondances entre utilisateur de la base et utilisateur demandant la connexion peuvent être spécifiées dans pg_ident.conf.
Ces noms de fichiers ne sont que les noms par défaut. Ils peuvent tout à fait être remplacés en spécifiant de nouvelles valeurs de hba_file et ident_file dans postgresql.conf (les installations Red Hat et Debian utilisent là aussi des emplacements différents, comme pour postgresql.conf).
Leur utilisation est décrite dans notre première formation3.
2.6 TABLESPACES
Espace de stockage physique d’objets
et non logique!
Simple répertoire (hors de PGDATA) + lien symbolique
Pour:
répartir I/O et volumétrie
quotas (par le FS, mais pas en natif)
tri sur disque séparé
Utilisation selon des droits
Par défaut, PostgreSQL se charge du placement des objets sur le disque, dans son répertoire des données, mais il est possible de créer des répertoires de stockage supplémentaires, nommés tablespaces.
2.6.0.1 Utilité des tablespaces
Un tablespace, vu de PostgreSQL, est un espace de stockage des objets (tables et index principalement). Son rôle est purement physique, il n’a pas à être utilisé pour une séparation logique des tables (c’est le rôle des bases et des schémas), encore moins pour gérer des droits.
Pour le système d’exploitation, il s’agit juste d’un répertoire, déclaré ainsi:
L’idée est de séparer physiquement les objets suivant leur utilisation. Les cas d’utilisation des tablespaces dans PostgreSQL sont:
l’ajout d’un disque après saturation de la partition du PGDATA sans possibilité de l’étendre au niveau du système (par LVM ou dans la baie de stockage, par exemple);
la répartition des entrées-sorties… si le SAN ou la virtualisation permet encore d’agir à ce niveau;
et notamment la séparation des index et des tables, pour répartir les écritures;
le déport des fichiers temporaires vers un tablespace dédié, pour la performance ou éviter qu’ils saturent le PGDATA;
la séparation entre données froides et chaudes sur des disques de performances différentes, ou encore des index et des tables;
les quotas: PostgreSQL ne disposant pas d’un système de quotas, dédier une partition entière d’une taille précise à un tablespace est un contournement; une transaction voulant étendre un fichier sera alors annulée avec l’erreur
cannot extend file.
Sans un réel besoin physique, il n’y a pas besoin de créer des tablespaces, et de complexifier l’administration.
Un tablespace n’est pas adapté à une séparation logique des objets. Si vous tenez à distinguer les fichiers de chaque base sans besoin physique, rappelez-vous que PostgreSQL crée déjà un sous-répertoire par base de données dans PGDATA/base/.
PostgreSQL ne connaît pas de notion de tablespace en lecture seule, ni de tablespace transportable entre deux bases ou deux instances.
2.6.0.2 Emplacement des tablespaces
Il y a quelques pièges à éviter à la définition d’un tablespace:
pour des raisons de sécurité et de fiabilité, le répertoire choisi ne doit pas être à la racine d’un point de montage. (Cela vaut aussi pour les répertoires PGDATA ou pg_wal).
Positionnez toujours les données dans un sous-répertoire, par exemple dans /mnt/ssd/pg plutôt que directement dans le point de montage /mnt/ssd. (Voir Utilisation de systèmes de fichiers secondaires4 dans la documentation officielle, ou le bug à l’origine de ce conseil5.)
Surtout, le tablespace doit impérativement être placé hors de pgdata. Certains outils poseraient problème sinon.
Si ce conseil n’est pas suivi, PostgreSQL crée le tablespace mais renvoie un avertissement:
Il est aussi déconseillé de mettre le numéro de version de PostgreSQL dans le chemin du tablespace. PostgreSQL le gère déjà à l’intérieur du tablespace. Cela évite des incohérences dans les noms des chemins si vous migrez plus tard avec pg_upgrade.
2.6.1 Tablespaces: mise en place
-- déclaration CREATE TABLESPACE ssd LOCATION '/mnt/ssd/pg'; -- droit pour un utilisateur GRANT CREATE ON TABLESPACE ssd TO un_utilisateur; -- pour toute une base CREATE DATABASE nomdb TABLESPACE ssd; ALTER DATABASE nomdb SET default_tablespace TO ssd; -- pour une table CREATE TABLE une_table (…) TABLESPACE ssd; ALTER TABLE une_table SET TABLESPACE ssd; -- verrou! -- pour un index (pas automatique) ALTER INDEX une_table_i_idx SET TABLESPACE ssd;
Le répertoire du tablespace doit exister et les accès ouverts et restreints à l’utilisateur système sous lequel tourne l’instance (en général postgres sous Linux, Network Service sous Windows):
Les ordres SQL plus haut permettent de:
créer un tablespace simplement en indiquant son emplacement dans le système de fichiers du serveur;
créer une base de données dont le tablespace par défaut sera celui indiqué;
modifier le tablespace par défaut d’une base;
donner le droit de créer des tables dans un tablespace à un utilisateur (c’est nécessaire avant de l’utiliser);
créer une table dans un tablespace;
déplacer une table dans un tablespace;
déplacer un index dans un tablespace.
Quelques choses à savoir:
La table ou l’index est totalement verrouillé le temps du déplacement.
Par défaut, les nouveaux index ne sont pas créés automatiquement dans le même tablespace que la table, mais en fonction de
default_tablespace.Les index existants ne « suivent » pas automatiquement une table déplacée, il faut les déplacer séparément.
Il est possible de préciser un tablespace de réindexation lors d’une réindexation (
REINDEX … TABLESPACE …).Les tablespaces des tables sont visibles dans la vue système
pg_tables, dans\d+sous psql, et danspg_indexespour les index:
2.6.2 Tablespaces: configuration
CREATE TABLESPACE ssd LOCATION '/mnt/data_ssd/'; CREATE TABLESPACE ssd_tmp1 LOCATION '/mnt/temp1'; CREATE TABLESPACE ssd_tmp2 LOCATION '/mnt/temp2'; GRANT CREATE ON TABLESPACE ssd TO dupont; GRANT CREATE ON TABLESPACE ssd_tmp1,ssd_tmp2 TO dupont; - default_tablespace default_tablespace = ssd # postgresql.conf ALTER DATABASE / ROLE nomdb SET default_tablespace = ssd; - temp_tablespaces: - tri & tables temporaires, en alternance - protéger le PGDATA ALTER ROLE etl SET temp_tablespaces = ssd_tmp1,ssd_tmp2;
2.6.2.1 Tablespaces de données
Le paramètre default_tablespace permet d’utiliser un autre tablespace que celui par défaut dans PGDATA. En plus du postgresql.conf, il peut être défini au niveau rôle, base, ou le temps d’une session:
ALTER DATABASE erp_prod SET default_tablespace TO ssd; -- base ALTER DATABASE erp_archives SET default_tablespace TO froid; -- base ALTER ROLE etl SET default_tablespace TO ssd; -- niveau rôle ALTER ROLE audit IN DATABASE erp_prod SET default_tablespace TO froid; -- niveau rôle dans une base SET default_tablespace TO ssd; -- session
2.6.2.2 Tablespaces temporaires
Les fichiers temporaires générés par certains nœuds de requête (tris, hash joins, CTE matérialisées…) ainsi que les tables temporaires peuvent être déplacés vers un ou plusieurs tablespaces dédiés grâce au paramètre temp_tablespaces. Le premier intérêt est de leur dédier une partition rapide (SSD, disque local…). Un autre est de ne plus risquer de saturer la partition du PGDATA en cas de fichiers temporaires énormes dans base/pgsql_tmp/.
Ne jamais utiliser de RAM disque (comme tmpfs) pour des tablespaces temporaires car la mémoire de la machine ne doit servir qu’aux applications et aux outils, au cache de l’OS, et aux opérations de PostgreSQL en RAM. Favorisez ces derniers en jouant sur work_mem.
En cas de redémarrage, ce tablespace ne serait d’ailleurs plus utilisable. Un RAM disque est encore plus dangereux pour les tablespaces de données, bien sûr.
Il faudra ouvrir les droits aux utilisateurs ainsi:
Plusieurs tablespaces temporaires peuvent être paramétrés. Noter que la déclaration se fait sans guillemet. Chaque transaction en choisira un de façon aléatoire à la création d’un objet temporaire, puis utilisera alternativement les autres pour chaque nouveau fichier. C’est un bon moyen de lisser la charge:
lors d’une requête, un gros fichier temporaire peut s’étaler sur plusieurs tablespaces temporaires, car il se découpe au besoin en fichiers de 1 Go, voire moins;
les différentes tables temporaires d’une même session se répartiront dans les différents tablespaces temporaires; par contre les différents fichiers d’une grosse table temporaire resteront ensemble dans le même tablespace (une table n’a qu’un tablespace), et ses index avec elle par défaut.
Si un des tablespaces temporaires sature, la requête tombe en erreur immédiatement: PostgreSQL ne regarde pas si autre tablespace temporaire a de la place libre. Il vaut donc mieux regrouper les espaces disponibles dans un même système de fichiers, et n’avoir qu’un grand tablespace temporaire.
2.6.3 Tablespaces: performance
Temps d’accès
seq_page_cost(1)random_page_cost(4)Opérations simultanées sur le disque
effective_io_concurrency(1) →16maintenance_io_concurrency(10)
Dans le cas de disques de performances différentes, il faut adapter les paramètres concernés aux caractéristiques du tablespace si la valeur par défaut ne convient pas. Ce sont des paramètres classiques qui ne seront pas décrits en détail ici:
seq_page_cost(coût d’accès à un bloc pendant un parcours, défaut 1);random_page_cost(coût d’accès à un bloc isolé, défaut 4);effective_io_concurrency(nombre d’I/O simultanées, défaut 1);maintenance_io_concurrency(idem, pour une opération de maintenance, défaut 10).
effective_io_concurrency:
effective_io_concurrency a pour but d’indiquer le nombre d’opérations disques possibles en même temps pour un client (prefetch). Il n’a d’intérêt que si un nœud Bitmap Scan a été choisi. Cela n’arrive qu’avec un certain nombre de lignes à récupérer, et est favorisé par une valeur importante de effective_cache_size et un peu de corrélation physique dans la table.
La valeur d’ effective_io_concurrency n’influe pas sur le choix du plan, mais sa valeur peut notablement accélérer l’exécution du Bitmap Heap Scan. Le temps de lecture peut fréquemment être divisé par 3 ou plus.
Les valeurs possibles d’ effective_io_concurrency vont de 0 à 1000. En principe, sur un disque magnétique seul, la valeur 1 ou 0 peut convenir. Avec du SSD, et encore plus du NVMe, il est possible de monter à plusieurs centaines, étant donné la rapidité de ce type de disque. Trouver la bonne valeur dépend de divers paramètres liés aux caractéristiques exactes des disques et de leur paramétrage noyau. Le read ahead du noyau intervient également. Le comportement de PostgreSQL sur ce point change aussi avec les versions. De plus, à partir d’un certain nombre de blocs, les I/O peuvent simplement saturer.
La valeur par défaut de 1 (jusque PostgreSQL 17) a été choisie de manière très conservatrice. Les développeurs ont décidé6 que la valeur 16 est plus intéressante, même sur de vieux disques, et que ce
sera le défaut à partir de PostgreSQL 187, qui inclut d’autres améliorations.
À l’inverse, la mauvaise latence de certains systèmes aux disques en principe performants (baies surchargées, certains stockages cloud…) peut parfois être compensée par un effective_io_concurrency plus élevé.
Il faut tester avec vos requêtes qui utilisent des Bitmap Heap Scan, et tenir compte du nombre de requêtes simultanées, mais effective_io_concurrency = 16 semble un bon point de départ, même sur une configuration modeste. Montez si vous avez de bons disques.
Une valeur excessive de effective_io_concurrency mène à un gaspillage de CPU : ne pas monter trop haut sans preuve de l’utilité, surtout sur un système très chargé.
Pour les systèmes RAID matériels, selon la documentation8, configurer ce paramètre en fonction du nombre n de disques utiles dans le RAID (n/2 s’il s’agit d’un RAID 1, n-1 s’il s’agit d’un RAID 5 ou 6, n/2 s’il s’agit d’un RAID 10).
(Avant la version 13, le principe d’ effective_io_concurrency était le même, mais la valeur exacte de ce paramètre devait être 2 à 5 fois plus basse comme le précise la formule des notes de version de la version 139.)
maintenance_io_concurrency:
maintenance_io_concurrency est similaire à effective_io_concurrency, mais pour les opérations de maintenance. Celles-ci peuvent ainsi se voir accorder plus de ressources qu’une simple requête. Il faut penser à le monter aussi si on adapte effective_io_concurrency.
Par exemple, un système paramétré pour des disques classiques aura comme paramètres par défaut:
et un tablespace sur un SSD voire un disque NVMe les surchargera ainsi:
2.7 GESTION DES CONNEXIONS
L’accès à la base se fait par un protocole réseau clairement défini:
sockets TCP (IPV4 ou IPV6)
sockets Unix (Unix uniquement)
Les demandes de connexion sont gérées par le postmaster.
Paramètres:
port,listen_adresses,unix_socket_directories,unix_socket_groupetunix_socket_permissions
Le processus postmaster est en écoute sur les différentes sockets déclarées dans la configuration. Cette déclaration se fait au moyen des paramètres suivants:
port: le port TCP. Il sera aussi utilisé dans le nom du fichier socket Unix (par exemple:/tmp/.s.PGSQL.5432ou/var/run/postgresql/.s.PGSQL.5432selon les distributions);listen_adresses: la liste des adresses IP du serveur auxquelles s’attacher;unix_socket_directories: le répertoire où sera stocké la socket Unix;unix_socket_group: le groupe (système) autorisé à accéder à la socket Unix;unix_socket_permissions: les droits d’accès à la socket Unix.
2.7.1 TCP
Pour liaisons instables/ firewalls agressifs
Paramètres de keepalive TCP
tcp_keepalives_idle = 20 tcp_keepalives_interval = 5 tcp_keepalives_count = 3Éviter les sessions fantôme sur le serveur
client_connection_check_interval = '10s'
2.7.1.1 Principe du keepalive
Il faut bien faire la distinction entre session TCP et session de PostgreSQL. Une session TCP peut servir de support à une requête longue, qui ne renvoie pas de données pendant plusieurs minutes. Un firewall peut considérer la session TCP inactive, même si côté PostgreSQL tout va bien… et la couper. Les erreurs typiques côté client ou serveur sont: server closed the connection unexpectedly, SSL SYSCALL error: EOF detected, unexpected EOF on client connection, could not receive data from client: Connection reset by peer.
Le keepalive est un mécanisme de maintien et de vérification des sessions TCP sans trafic, par l’envoi régulier de messages. Il a deux intérêts:
maintenir la session active pour éviter la coupure de la part de firewalls un peu trop zélés (beaucoup coupent une session inactive après quelques minutes, alors que la norme TCP prévoit plusieurs jours);
détecter les clients déconnectés même si ceux-ci ne notifient pas la déconnexion (plantage du système d’exploitation, fermeture de la session par un firewall…).
2.7.1.2 Mise en place dans PostgreSQL
Le plus simple est de définir ces paramètres sur l’instance PostgreSQL:
tcp_keepalives_idle(secondes): durée d’inactivité d’une session TCP avant l’envoi d’un premier message de keepalive;tcp_keepalives_interval(s): durée entre un keepalive et le suivant, en cas de non-réponse;tcp_keepalives_count: nombre maximum de paquets sans réponse avant déclaration de la connexion comme morte;
Avec les valeurs d’exemple plus haut, il faudra donc
pour qu’une session coupée soit déclarée morte. Les valeurs doivent être adaptées à votre environnement, selon les firewalls, mais sans être trop sensible à des coupures brèves.
Les valeurs par défaut sont à 0, donc reviennent à utiliser les valeurs par défaut du système d’exploitation. Un client affiche alors généralement tcp_keepalives_idle = 7200 (2 heures!).
Un piège: pour contrôler les valeurs, il faut un client qui se connecte en TCP/IP. Un client connecté par socket, typiquement une session psql directement sur le serveur, affichera 0.
2.7.1.3 Mise en place au niveau du système d’exploitation
Une autre option est de changer les défauts du keepalive au niveau de l’OS par exemple ainsi sous Linux:
Pour d’autres détails, voir cet article de Laurenz Albe10.
2.7.1.4 Détecter les clients perdus
Un client peut lancer une requête longue, et quitter la session avant de récupérer ses résultats (plantage…). Dans ce cas, le serveur continue à exécuter la requête et ne se rend compte de l’absence du client qu’au moment de renvoyer les premiers résultats, même si le mécanisme de keepalive a coupé la session. Des sessions « fantôme » côté serveur en résultent.
Si le paramètre client_connection_check_interval indique une durée, le serveur vérifie périodiquement auprès du système qu’il existe une connexion active vers le client qui attend ses résultats. Si elle est coupée, la session est coupée sur le serveur. Par défaut, client_connection_check_interval est désactivé (valeur 0).
Avec le paramétrage ci-dessus, le serveur s’aperçoit au plus tard après 30+10 s que la connexion avec le client est coupée, et arrête la requête.
2.7.2 SSL
Il existe des options pour activer SSL et le paramétrer. ssl vaut on ou off, ssl_ciphers est la liste des algorithmes de chiffrement autorisés, et ssl_renegotiation_limit le volume maximum de données échangées sur une session avant renégociation entre le client et le serveur. Le paramétrage SSL impose aussi la présence d’un certificat. Pour plus de détails, consultez la documentation officielle11.
2.8 STATISTIQUES SUR L’ACTIVITÉ
(Ne pas confondre avec statistiques sur les données!)
Statistiques consultables par des vues systèmes
Paramètres:
track_activities,track_activity_query_sizetrack_counts,track_io_timingettrack_functionsupdate_process_titlestats_temp_directory(< v15)
Les différents processus de PostgreSQL collectent des statistiques d’activité qui ont pour but de mesurer l’activité de la base. Notamment:
combien de fois cette table a-t-elle été parcourue séquentiellement?
combien de blocs ont été trouvés dans le cache pour ce parcours d’index, et combien ont dû être demandés au système d’exploitation?
Quelles sont les requêtes en cours d’exécution?
Combien de buffers ont été écrits par le processus background writer? Par les processus backend eux-mêmes? durant un checkpoint?
Il ne faut pas confondre les statistiques d’activité avec celles sur les données (taille des tables, des enregistrements, fréquences des valeurs…), qui sont à destination de l’optimiseur de requête!
Pour des raisons de performance, ces stastistiques restent en mémoire (ou dans des fichiers temporaires jusque PostgreSQL 14) et ne sont stockées durablement qu’en cas d’arrêt propre. Un arrêt brutal implique donc leur réinitialisation!
Voici les paramètres concernés par cette collecte d’informations. Leur activation est généralement conseillée:
track_activities (on par défaut) précise si les processus doivent mettre à jour leur activité dans pg_stat_activity.
track_counts (on par défaut) indique que les processus doivent collecter des informations sur leur activité. Il est vital pour le déclenchement de l’autovacuum.
track_activity_query_size est la taille maximale du texte de requête pouvant être stocké dans pg_stat_activity. 1024 caractères est un défaut souvent insuffisant, à monter vers 10 000 si les requêtes sont longues, voire plus; cette modification nécessite un redémarrage vu qu’elle touche au dimensionnement de la mémoire partagée.
compute_query_id à on permet d’activer le calcul de l’identifiant de la requête. Ce dernier sera visible dans le champ query_id de la vue pg_stat_activity, ainsi que dans les traces.
track_io_timing (off par défaut) précise si les processus doivent collecter des informations de chronométrage sur les lectures et écritures, pour compléter les champs blk_read_time et
blk_write_time des vues pg_stat_database et pg_stat_statements, ainsi que les plans d’exécutions appelés avec EXPLAIN (ANALYZE,BUFFERS) et les traces de l’autovacuum (pour un VACUUM comme un ANALYZE).
Avant d’activer track_io_timing sur une machine, vérifiez l’impact avec l’outil pg_test_timing.
pg_test_timing12 est livré avec PostgreSQL et mesure les performances de l’horloge système. Si le temps de mesure renvoyé sur la deuxième ligne n’est que de quelques dizaines de nanosecondes, la machine est suffisamment rapide pour que track_io_timing renvoie des résultats précis et sans ralentir la requête. C’est le cas sur presque toutes les machines et systèmes d’exploitation actuels, mais il y a parfois des surprises, par exemple dans certaines machines virtuelles ou selon la source de l’horloge système. Sinon, éviter d’activer track_io_timing sur un serveur de production. Sur une machine de test ou de formation, ce n’est pas un problème.
track_functions indique si les processus doivent aussi collecter des informations sur l’exécution des routines stockées. Les valeurs sont none (par défaut), pl pour ne tracer que les routines en langages procéduraux, all pour tracer aussi les routines en C et en SQL.
update_process_title permet de modifier le titre du processus, visible par exemple avec ps -ef sous Unix. Il est à on par défaut sous Unix, mais il faut le laisser à off sous Windows pour des raisons de performance.
Avant la version 15, stats_temp_directory servait à indiquer le répertoire de stockage temporaire des statistiques, avant copie dans pg_stat/ lors d’un arrêt propre. Ce répertoire peut devenir gros, est réécrit fréquemment, et peut devenir source de contention. Il est conseillé de le stocker ailleurs que dans le répertoire de l’instance PostgreSQL, par exemple sur un RAM disque ou tmpfs (c’est le défaut sous Debian).
Ce répertoire existe toujours en version 15, notamment si vous utilisez le module pg_stat_statements. Cependant, en dehors de ce module, rien d’autre ne l’utilise. Quant au paramètre stats_temp_directory, il a disparu.
2.8.1 Statistiques d’activité collectées
Accès logiques (
INSERT,SELECT…) par table et indexAccès physiques (blocs) par table, index et séquence
Activité du Background Writer
Activité par base
Liste des sessions et informations sur leur activité
2.8.2 Vues système
Supervision / métrologie
Diagnostiquer
Vues système:
pg_stat_user_*pg_statio_user_*pg_stat_activity(requêtes)pg_stat_bgwriter,pg_stat_checkpointer(v17+)pg_locksRéinitialisation des compteurs:
pg_stat_reset_shared()
PostgreSQL propose de nombreuses vues, accessibles en SQL, pour obtenir des informations sur son fonctionnement interne. Il est possible d’avoir des informations sur le fonctionnement des bases, des processus d’arrière-plan, des tables, les requêtes en cours…
Statistiques sur les objets:
Pour les statistiques sur les objets, le système fournit à chaque fois trois vues différentes:
Une pour tous les objets du type. Elle contient all dans le nom,
pg_statio_all_tablespar exemple;une pour uniquement les objets systèmes. Elle contient sys dans le nom,
pg_statio_sys_tablespar exemple;une pour uniquement les objets non-systèmes. Elle contient user dans le nom,
pg_statio_user_tablespar exemple.
Les accès logiques aux objets (tables, index et routines) figurent dans les vues pg_stat_xxx_tables,
pg_stat_xxx_indexes et pg_stat_user_functions.
les accès physiques aux objets sont visibles dans les vues pg_statio_xxx_indexes, pg_statio_xxx_tables et pg_statio_xxx_sequences. Une vision plus globale est disponible dans pg_stat_io (apparue avec PostgreSQL 16).
Des statistiques globales par base sont aussi disponibles, dans pg_stat_database: le nombre de transactions validées et annulées, quelques statistiques sur les sessions, et quelques statistiques sur les accès physiques et en cache, ainsi que sur les opérations logiques.
pg_stat_bgwriter stocke les statistiques d’écriture des buffers des background writer, et du checkpointer (jusqu’en version 16 incluse) et des sessions elles-mêmes. On peut ainsi voir si les backends écrivent beaucoup ou peu. À partir de PostgreSQL 17, apparaît pg_stat_checkpointer qui reprend les champs sur les checkpoints et en ajoute quelques-uns. Cette vue permet de vérifier que les checkpoints sont réguliers, donc peu gênants.
Exemple (version 17):
Écritures:
pg_stat_bgwriter stocke les statistiques d’écriture des buffers des Background Writer, Checkpointer et des sessions elles-mêmes.
Requêtes
pg_stat_activity est une des vues les plus utilisées et est souvent le point de départ d’une recherche. Elle donne la liste des processus en cours sur l’instance, en incluant entre autres:
- le numéro de processus sur le serveur (
pid);
la base de données, le nom dutilisateur, l’adresse et le port du client;
les dates de début d’ordre, de transaction ou de session;
son statut (active ou non);
la requête en cours, ou la dernière requête si la session ne fait rien;
le nom de l’application s’il a été renseigné avec le paramètre
application_name;le type de processus: session d’un utilisateur (client backend), processus interne…
Les textes des requêtes sont tronqués à 1024 caractères: c’est un problème courant. Il est conseillé de monter le paramètre track_activity_query_size à plusieurs kilooctets.
Cette vue fournit aussi les wait events, qui indiquent ce qu’une session est en train d’attendre. Cela peut être très divers et inclut la levée d’un verrou sur un objet, celle d’un verrou interne, la fin d’une entrée-sortie… L’absence de wait event indique que la requête s’exécute. À noter qu’une session avec un wait event peut rester en statut active.
Les détails sur les champs wait_event_type (type d’événement en attente) et wait_event (nom de l’événement en attente) sont disponibles dans le tableau des événements d’attente13. de la documentation.
À partir de PostgreSQL 17, la vue pg_wait_events peut être directement jointe à pg_stat_activity, et son champ description évite d’aller voir la documentation:
Le processus de la ligne 2 attend une synchronisation sur disque du journal de transaction (WAL), et les deux suivants une lecture d’un fichier de données.
Pour entrer dans le détail des champs liés aux connexions:
backend_typeest le type de processus: on filtrera généralement surclient backend, maison y trouvera aussi des processus de tâche de fond comme
checkpointer,walwriter,autovacuum launcheret autres processus de PostgreSQL, ou encore des workers lancés par des extensions;datnameest le nom de la base à laquelle la session est connectée, etdatidest son identifiant (OID);pidest le processus du backend, c’est-à-dire du processus postgresql chargé de discuter avec le client, qui durera le temps de la session (sauf parallélisation);usenameest le nom de l’utilisateur connecté, etusesysidest son OID danspg_roles;
application_nameest un nom facultatif, et il est recommandé que l’application cliente le renseigne autant que possible avecSET application_name TO 'nom_outil_client';client_addrest l’adresse IP du client connecté (NULLsi connexion sur socket Unix), etclient_hostnameest le nom associé à cette IP, renseigné uniquement silog_hostnameaété passé à
on(cela peut ralentir les connexions à cause de la résolution DNS);client_portest le numéro de port sur lequel le client est connecté, toujours s’il s’agit d’uneconnexion IP.
Une requête parallélisée occupe plusieurs processus, et apparaîtra sur plusieurs lignes de pid différents. Le champ leader_pid indique le processus principal. Les autres processus disparaîtront dès la requête terminée.
Pour les champs liés aux durées de session, transactions et requêtes:
backend_startest le timestamp de l’établissement de la session;xact_startest le timestamp de début de la transaction;query_startest le timestamp de début de la requête en cours, ou de la dernière requêteexécutée;
statusvaut soitactive, soitidle(la session ne fait rien) soitidle in transaction(enattente pendant une transaction);
backend_xidest l’identifiant de la transaction en cours, s’il y en a une;backend_xminest l’horizon des transactions visibles, et dépend aussi des autres transactionsen cours.
Rappelons qu’une session durablement en statut idle in transaction bloque le fonctionnement de l’autovacuum car backend_xmin est bloqué. Cela peut mener à des tables fragmentées et du gaspillage de place disque.
pg_stat_activity contient un champ query_id, c’est-à-dire un identifiant de requête normalisée (dépouillée des valeurs de paramètres). Il faut que le paramètre compute_query_id soit à on ou auto (le défaut, et alors une extension peut l’activer). Ce champ est utile pour retrouver une requête dans la vue de l’extension pg_stat_statements, par exemple.
Certains champs de cette vue ne sont renseignés que si le paramètre track_activities est à on (valeur par défaut, qu’il est conseillé de laisser ainsi).
À noter qu’il ne faut pas interroger pg_stat_activity au sein d’une transaction, son contenu pourrait sembler figé.
Verrous:
pg_locks permet de voir les verrous posés sur les objets (principalement les relations comme les tables et les index).le processus(pid)est la clé commune pour la rapprocher de pg_stat_activity.
Archivage et réplication:
pg_stat_archiver donne des informations sur l’archivage des journaux de transaction et notamment sur les erreurs d’archivage. L’exemple suivant montre un archivage en erreur:
pg_stat_replication donne des informations sur les serveurs secondaires connectés. Les statistiques sur les conflits entre application de la réplication et requêtes en lecture seule sont disponibles dans pg_stat_database_conflicts.
Si les réplications se font par des slots de réplication (optionnels en réplication physique), pg_stat_replication_slots donne des informations sur leur état et leur retard.
Autres vues:
Des vues plus spécialisées existent:
pg_stat_ssl donne des informations sur les connexions SSL: version SSL, suite de chiffrement, nombre de bits pour l’algorithme de chiffrement, compression, Distinguished Name (DN) du certificat client.
pg_stat_progress_vacuum, pg_stat_progress_analyze, pg_stat_progress_create_index, pg_stat_progress_cluster, pg_stat_progress_basebackup et pg_stat_progress_copy donnent respectivement des informations sur la progression des VACUUM, des ANALYZE, des créations d’index, des commandes de VACUUM FULL et CLUSTER, de la commande de réplication BASE BACKUP et des COPY.
pg_stat_slru permet de suivre les accès à différents petits caches internes de PostgreSQL (à partir de PostgreSQL 17).
Réinitialisation:
Ces vues contiennent des compteurs cumulatifs. L’évolution en fonction du temps est souvent gérée parles nombreux outils qui font appel à cesvues. il existe une fonction pour réinitialiser les compteurs de certaines vues (pas toutes):
2.9 STATISTIQUES SUR LES DONNÉES
Statistiques sur les données:
pg_statscollectées par échantillonnage (
default_statistics_target)ANALYZE tabletable par table (et pour certains index)
colonne par colonne
pour de meilleurs plans d’exécution
Affiner:
Échantillonnage
- Statistiques multicolonnes sur demande
Afin de calculer les plans d’exécution des requêtes au mieux, le moteur a besoin de statistiques sur les données qu’il va interroger. Il est très important pour lui de pouvoir estimer la sélectivité d’une clause WHERE, l’augmentation ou la diminution du nombre d’enregistrements entraînée par une jointure, tout cela afin de déterminer le coût approximatif d’une requête, et donc de choisir un bon plan d’exécution.
Il ne faut pas les confondre avec les statistiques d’activité, vues précédemment!
Les statistiques sont collectées dans la table pg_statistic. La vue pg_stats affiche le contenu de cette table système de façon plus accessible.
Les statistiques sont collectées sur:
chaque colonne de chaque table;
les index fonctionnels.
Le recueil des statistiques s’effectue quand on lance un ordre ANALYZE sur une table, ou que l’autovacuum le lance de son propre chef.
Les statistiques sont calculées sur un échantillon égal à 300 fois le paramètre STATISTICS de la colonne (ou, s’il n’est pas précisé, du paramètre default_statistics_target, 100 par défaut).
La vue pg_stats affiche les statistiques collectées:
inherited: la statistique concerne-t-elle un objet utilisant l’héritage (table parente, dont héritent plusieurs tables);null_frac: fraction d’enregistrements dont la colonne vaut NULL;avg_width: taille moyenne de cet attribut dans l’échantillon collecté;n_distinct: si positif, c’est le nombre de valeurs distinctes; si négatif, c’est la fraction de valeurs distinctes pour cette colonne dans la table. Il est possible de forcer la valeur de ce champ s’il est constaté que la collecte des statistiques le calcule mal. Par exemple, pour indiquer à l’optimiseur que chaque valeur apparaît statistiquement deux fois:
most_common_valsetmost_common_freqs: les valeurs les plus fréquentes de la table, et leur fréquence. Le nombre de valeurs collectées est au maximum celui indiqué par le paramètreSTATISTICSde la colonne, ou à défaut pardefault_statistics_target. Le défaut de 100 échantillons sur 30 000 lignes peut être modifié comme ci-après (sachant que le temps de planification augmente exponentiellement avec ce paramètre, et qu’il vaut mieux ne pas dépasser la valeur 1000):
histogram_bounds: les limites d’histogramme sur la colonne. Les histogrammes permettentd’évaluer la sélectivité d’un filtre par rapport à sa valeur précise. Ils permettent par exemple à l’optimiseur de déterminer que 4,3 % des enregistrements d’une colonne
nomscommencent par un A, ou 0,2 % par AL. Le principe est de regrouper les enregistrements triés dans des groupes de tailles approximativement identiques, et de stocker les limites de ces groupes (on ignore lesmost_common_vals, pour lesquelles il y a déjà une mesure plus précise). Le nombre d’histogram_boundsest calculé de la même façon que lesmost_common_vals;correlation: le facteur de corrélation statistique entre l’ordre physique et l’ordre logiquedes enregistrements de la colonne. Il vaudra par exemple
1si les enregistrements sont physiquement stockés dans l’ordre croissant,-1si ils sont dans l’ordre décroissant, ou0si ils sont totalement aléatoirement répartis. Ceci sert à affiner le coût d’accès aux enregistrements;most_common_elemsetmost_common_elems_freqs: les valeurs les plus fréquentes si la colonne est un tableau (NULL dans les autres cas), et leur fréquence. Le nombre de valeurs collectées est au maximum celui indiqué par le paramètreSTATISTICSde la colonne, ou à défaut pardefault_statistics_target;elem_count_histogram: les limites d’histogramme sur la colonne si elle est de type tableau.
Parfois, il est intéressant de calculer des statistiques sur un ensemble de colonnes ou d’expressions. Dans ce cas, il faut créer un objet statistique en indiquant les colonnes et/ou expressions à traiter et le type de statistiques à calculer (voir la documentation de CREATE STATISTICS).
2.10 OPTIMISEUR
SQL est un langage déclaratif: - décrit le résultat attendu (projection, sélection, jointure, etc.)… - …mais pas comment l’obtenir
c’est le rôle de l’optimiseur
Le langage SQL décrit le résultat souhaité. Par exemple:
Cet ordre décrit le résultat souhaité. Nous ne précisons pas au moteur comment accéder aux tables path et file (par index ou parcours complet par exemple), ni comment effectuer la jointure (PostgreSQL dispose de plusieurs méthodes). C’est à l’optimiseur de prendre la décision, en fonction des informations qu’il possède.
Les informations les plus importantes pour lui, dans le contexte de cette requête, seront:
quelle fraction de la table
pathest ramenée par le critèrepath LIKE '/usr/%’?y a-t-il un index utilisable sur cette colonne?
y a-t-il des index utilisables sur
file.pathid, surpath.pathid?quelles sont les tailles des deux tables?
La stratégie la plus efficace ne sera donc pas la même suivant les informations retournées par toutes ces questions.
Par exemple, il pourrait être intéressant de charger les deux tables séquentiellement, supprimer les enregistrements de path ne correspondant pas à la clause LIKE, trier les deux jeux d’enregistrements et fusionner les deux jeux de données triés (cette technique est un merge join). Cependant, si les tables sont assez volumineuses, et que le LIKE est très discriminant (il ramène peu d’enregistrements de la table path), la stratégie d’accès sera totalement différente: nous pourrions préférer récupérer les quelques enregistrements de path correspondant au LIKE par un index, puis pour chacun de ces enregistrements, aller chercher les informations correspondantes dans la table file (c’est un nested loop).
2.10.1 Optimisation par les coûts
L’optimiseur évalue les coûts respectifs des différents plans
Il calcule tous les plans possibles tant que c’est possible
Le coût de planification exhaustif est exponentiel par rapport au nombre de jointures de la requête
Il peut falloir d’autres stratégies
Paramètres principaux:
seq_page_cost,random_page_cost,cpu_tuple_cost,cpu_index_tuple_cost,cpu_operator_costparallel_setup_cost,parallel_tuple_costeffective_cache_size
Afin de choisir un bon plan, le moteur essaie des plans d’exécution. Il estime, pour chacun de ces plans, le coût associé. Afin d’évaluer correctement ces coûts, il utilise plusieurs informations:
Les statistiques sur les données, qui lui permettent d’estimer le nombre d’enregistrements ramenés par chaque étape du plan et le nombre d’opérations de lecture à effectuer pour chaque étape de ce plan;
Des informations de paramétrage lui permettant d’associer un coût arbitraire à chacune des opérations à effectuer. Ces informations sont les suivantes:
seq_page_cost(1 par défaut): coût de la lecture d’une page disque de façon séquentielle(au sein d’un parcours séquentiel de table par exemple);
random_page_cost(4 par défaut): coût de la lecture d’une page disque de façon aléatoire(lors d’un accès à une page d’index par exemple);
cpu_tuple_cost(0,01 par défaut): coût de traitement par le processeur d’un enregistrement de table;cpu_index_tuple_cost(0,005 par défaut): coût de traitement par le processeur d’un enregistrement d’index;cpu_operator_cost(0,0025 par défaut): coût de traitement par le processeur de l’exécution d’un opérateur.
Ce sont les coûts relatifs de ces différentes opérations qui sont importants: l’accès à une page de façon aléatoire est par défaut 4 fois plus coûteux que de façon séquentielle, du fait du déplacement des têtes de lecture sur un disque dur classique à plateaux. Ceci prend déjà en considération un potentiel effet du cache. Sur une base fortement en cache, il est donc possible d’être tenté d’abaisser le random_page_cost à 3, voire 2,5, ou des valeurs encore bien moindres dans le cas de bases totalement en mémoire.
Le cas des disques SSD est particulièrement intéressant. Ces derniers n’ont pas à proprement parler de tête de lecture. De ce fait, comme les paramètres seq_page_cost et random_page_cost sont principalement là pour différencier un accès direct et un accès après déplacement de la tête de lecture, la différence de configuration entre ces deux paramètres n’a pas lieu d’être si les index sont placés sur
des disques SSD. Dans ce cas, une configuration très basse et pratiquement identique (voire identique) de ces deux paramètres est préconisée:
effective_io_concurrency a pour but d’indiquer le nombre d’opérations disques possibles en même temps pour un client (prefetch). Il n’a d’intérêt que si un nœud Bitmap Scan a été choisi. Cela n’arrive qu’avec un certain nombre de lignes à récupérer, et est favorisé par une valeur importante de effective_cache_size et un peu de corrélation physique dans la table.
La valeur d’ effective_io_concurrency n’influe pas sur le choix du plan, mais sa valeur peut notablement accélérer l’exécution du Bitmap Heap Scan. Le temps de lecture peut fréquemment être divisé par 3 ou plus.
Les valeurs possibles d’ effective_io_concurrency vont de 0 à 1000. En principe, sur un disque magnétique seul, la valeur 1 ou 0 peut convenir. Avec du SSD, et encore plus du NVMe, il est possible de monter à plusieurs centaines, étant donné la rapidité de ce type de disque. Trouver la bonne valeur dépend de divers paramètres liés aux caractéristiques exactes des disques et de leur paramétrage noyau. Le read ahead du noyau intervient également. Le comportement de PostgreSQL sur ce point change aussi avec les versions. De plus, à partir d’un certain nombre de blocs, les I/O peuvent simplement saturer.
La valeur par défaut de 1 (jusque PostgreSQL 17) a été choisie de manière très conservatrice. Les développeurs ont décidé14 que la valeur 16 est plus intéressante, même sur de vieux disques, et que ce sera le défaut à partir de PostgreSQL 1815, qui inclut d’autres améliorations.
À l’inverse, la mauvaise latence de certains systèmes aux disques en principe performants (baies surchargées, certains stockages cloud…) peut parfois être compensée par un effective_io_concurrency plus élevé.
Il faut tester avec vos requêtes qui utilisent des Bitmap Heap Scan, et tenir compte du nombre de requêtes simultanées, mais effective_io_concurrency = 16 semble un bon point de départ, même sur une configuration modeste. Montez si vous avez de bons disques.
Une valeur excessive de effective_io_concurrency mène à un gaspillage de CPU : ne pas monter trop haut sans preuve de l’utilité, surtout sur un système très chargé.
Pour les systèmes RAID matériels, selon la documentation16, configurer ce paramètre en fonction du
nombre n de disques utiles dans le RAID (n/2 s’il s’agit d’un RAID 1, n-1 s’il s’agit d’un RAID 5 ou 6, n/2 s’il s’agit d’un RAID 10).
(Avant la version 13, le principe d’ effective_io_concurrency était le même, mais la valeur exacte de ce paramètre devait être 2 à 5 fois plus basse comme le précise la formule des notes de version de la version 1317.)
Le paramètre maintenance_io_concurrency a le même sens que effective_io_concurrency, mais pour les opérations de maintenance. Celles-ci peuvent ainsi se voir accorder plus de ressources qu’une simple requête. Le défaut est de 10, et il faut penser à le monter aussi comme effective_io_concurrency sur des disques plus rapides qu’un simple disque magnétique.
seq_page_cost, random_page_cost, effective_io_concurrency et maintenance_io_concurrency peuvent être paramétrés par tablespace, afin de refléter les caractéristiques de disques différents.
La mise en place du parallélisme dans une requête représente un coût: il faut mettre en place une mémoire partagée, lancer des processus… Ce coût est pris en compte par le planificateur à l’aide du paramètre parallel_setup_cost. Par ailleurs, le transfert d’enregistrement entre un worker et le processus principal a également un coût représenté par le paramètre parallel_tuple_cost.
Ainsi une lecture complète d’une grosse table peut être moins coûteuse sans parallélisation du fait que le nombre de lignes retournées par les workers est très important. En revanche, en filtrant les résultats, le nombre de lignes retournées peut être moins important, la répartition du filtrage entre différents processeurs devient « rentable » et le planificateur peut être amené à choisir un plan comprenant la parallélisation.
Certaines autres informations permettent de nuancer les valeurs précédentes. effective_cache_size est la taille totale du cache. Il permet à PostgreSQL de modéliser plus finement le coût réel d’une opération disque, en prenant en compte la probabilité que cette information se trouve dans le cache du système d’exploitation ou dans celui de l’instance, et soit donc moins coûteuse à accéder.
Le parcours de l’espace des solutions est un parcours exhaustif. Sa complexité est principalement liée au nombre de jointures de la requête et est de type exponentiel. Par exemple, planifier de façon exhaustive une requête à une jointure dure 200 microsecondes environ, contre 7 secondes pour 12 jointures. Une autre stratégie, l’optimiseur génétique, est donc utilisée pour éviter le parcours exhaustif quand le nombre de jointure devient trop élevé.
Pour plus de détails, voir l’article sur les coûts de planification18 issu de notre base de connaissance.
2.10.2 Nombre de tables considérées par le planificateur
PostgreSQL choisit l’ordre des jointures
uniquement pour les X premières tables
où X =
join_collapse_limit(défaut: 8)Les jointures supplémentaires sont ajoutées après
… souvent plans non optimaux
→augmenter
join_collapse_limitsi nécessaire (12-15)ainsi que
from_collapse_limit… attention au CPU
Algorithme GEQO (
geqo_threshold= 12 jointures)
En principe, le planificateur ne tient pas compte de l’ordre des tables dans la clause FROM et peut décider de commencer la requête par n’importe laquelle. Cependant, la complexité des plans d’exécution à étudier explose avec le nombre de tables et de combinaisons de jointures. À partir d’un certain nombre de tables, PostgreSQL n’en prend en compte qu’un certain nombre, et calcule un plan juste pour elles. Les tables suivantes sont jointes au premier résultat dans un deuxième temps. Le paramètre join_collapse_limit définit ce nombre de tables prises en compte dans le FROM (vision simplifiée). Par défaut, il ne vaut que 8.
Si le critère de filtrage le plus utile est sur la neuvième table, au-delà donc du premier ensemble de tables considérées, l’optimiseur n’en tiendra pas compte, et le plan peut être catastrophique!
Il existe un paramètre très voisin, from_collapse_limit, qui définit à quelle profondeur « aplatir » les sous-requêtes, c’est-à-dire remonter les tables depuis une sous-requête dans le FROM, tant qu’on ne pas dépasse pas cette valeur. On le monte habituellement à la même valeur que join_collapse_limit, et vice-versa.
Exemple:
comme exemple de plan désastreux, à cause d’un critère de filtrage sur une table non prise en compte, voir ce plan19. La requête est celle-ci (base magasin20):
le critère final(sur contacts.login)est beaucoup plus discriminant que celui sur transporteurs.nom mais il n’est pas pris en compte car c’est la neuvième table. Monter join_collapse_limit de 8 à 9 permet de prendre ce critère en compte, et le plan est alors bien meilleur21. (Pour l’exemple complet, voir https://dali.bo/j2_html#requête-avec-beaucoup-de-tables-1)
Une autre solution serait de remonter plus haut dans le FROM la jointure sur la table contacts. Son critère discriminant serait ainsi pris en compte dès le début. Mais il n’est pas toujours possible de modifier le code, qui d’ailleurs peut être dynamique.
les connus, alors qu’ils peuvent améliorer radicalement les performances si vous joignez paramètres join_collapse_limit et from_collapse_limit sont trop peu plus de huit tables.
pour éviter de se soucier de ce problème, il est fréquent de monter les valeurs de join_collapse_limit et from_collapse_limit à 10 ou 12.
Si vous avez de nombreuses requêtes avec beaucoup de tables et que vous montez join_collapse_limit, les temps de planification peuvent fortement augmenter, ainsi que la consommation CPU. Ce ne sera pas forcément contrebalancé par des requêtes toutes plus rapides. Il est donc préférable de positionner ces valeurs élevées uniquement au niveau de la session, de l’écran, ou de l’utilisateur, et s’il est montré que ces requêtes sont parfois contre-performantes.
Concrètement, pour ne changer la valeur que dans une session, utilisez SET:
ou pour un utilisateur précis, un rôle de reporting par exemple, utilisez:
Par contre, dans une base dédiée à la BI, ou un utilisateur dédié, avec peu de requêtes, qui portent sur de nombreuses tables, il ne faut pas hésiter à monter join_collapse_limit au nombre maximal de tables susceptibles d’être rencontrées. Des coûts en planification de l’ordre de la seconde ne sont pas forcément rédhibitoires dans ce contexte.
À l’inverse, descendre join_collapse_limit à 1 permet de dicter l’ordre d’exécution au planificateur dans la clause FROM (voir l’exemple de la documentation officielle22). C’est une mesure de dernier recours.
2.10.2.1 join_collapse_limit et from_collapse_limit
En principe, le planificateur ne tient pas compte de l’ordre des tables dans la clause FROM et peut décider de commencer la requête par n’importe laquelle. Cependant, la complexité des plans d’exécution à étudier explose avec le nombre de tables et de combinaisons de jointures. À partir d’un certain nombre de tables, PostgreSQL n’en prend en compte qu’un certain nombre, et calcule un plan juste pour elles. Les tables suivantes sont jointes au premier résultat dans un deuxième temps. Le paramètre join_collapse_limit définit ce nombre de tables prises en compte dans le FROM (vision simplifiée). Par défaut, il ne vaut que 8.
Si le critère de filtrage le plus utile est sur la neuvième table, au-delà donc du premier ensemble de tables considérées, l’optimiseur n’en tiendra pas compte, et le plan peut être catastrophique!
Il existe un paramètre très voisin, from_collapse_limit, qui définit à quelle profondeur « aplatir » les sous-requêtes, c’est-à-dire remonter les tables depuis une sous-requête dans le FROM, tant qu’on ne pas dépasse pas cette valeur. On le monte habituellement à la même valeur que join_collapse_limit, et vice-versa.
Exemple:
comme exemple de plan désastreux, à cause d’un critère de filtrage sur une table non prise en compte, voir ce plan23. La requête est celle-ci (base magasin24):
le critère final(sur contacts.login)est beaucoup plus discriminant que celui sur transporteurs.nom mais il n’est pas pris en compte car c’est la neuvième table. Monter join_collapse_limit de 8 à 9
permet de prendre ce critère en compte, et le plan est alors bien meilleur25. (Pour l’exemple complet, voir https://dali.bo/j2_html#requête-avec-beaucoup-de-tables-1)
Une autre solution serait de remonter plus haut dans le FROM la jointure sur la table contacts. Son critère discriminant serait ainsi pris en compte dès le début. Mais il n’est pas toujours possible de modifier le code, qui d’ailleurs peut être dynamique.
les connus, alors qu’ils peuvent améliorer radicalement les performances si vous joignez paramètres join_collapse_limit et from_collapse_limit sont trop peu plus de huit tables.
pour éviter de se soucier de ce problème, il est fréquent de monter les valeurs de join_collapse_limit et from_collapse_limit à 10 ou 12.
Si vous avez de nombreuses requêtes avec beaucoup de tables et que vous montez join_collapse_limit, les temps de planification peuvent fortement augmenter, ainsi que la consommation CPU. Ce ne sera pas forcément contrebalancé par des requêtes toutes plus rapides. Il est donc préférable de positionner ces valeurs élevées uniquement au niveau de la session, de l’écran, ou de l’utilisateur, et s’il est montré que ces requêtes sont parfois contre-performantes.
Concrètement, pour ne changer la valeur que dans une session, utilisez SET:
ou pour un utilisateur précis, un rôle de reporting par exemple, utilisez:
Par contre, dans une base dédiée à la BI, ou un utilisateur dédié, avec peu de requêtes, qui portent sur de nombreuses tables, il ne faut pas hésiter à monter join_collapse_limit au nombre maximal de tables susceptibles d’être rencontrées. Des coûts en planification de l’ordre de la seconde ne sont pas forcément rédhibitoires dans ce contexte.
À l’inverse, descendre join_collapse_limit à 1 permet de dicter l’ordre d’exécution au planificateur dans la clause FROM (voir l’exemple de la documentation officielle26). C’est une mesure de dernier recours.
2.10.2.2 GEQO, l’optimiseur génétique
Principe du GEQO:
Quand il y a beaucoup de tables, et que l’on monte join_collapse_limit, le nombre colossal de plans envisageables rend une recherche exhaustive du meilleur plan beaucoup trop lourde. PostgreSQL déclenche alors un autre mécanisme au-delà de 12 tables (valeur du paramètre geqo_threshold): l’optimiseur génétique GEQO27 (GEnetic Query Optimizer).
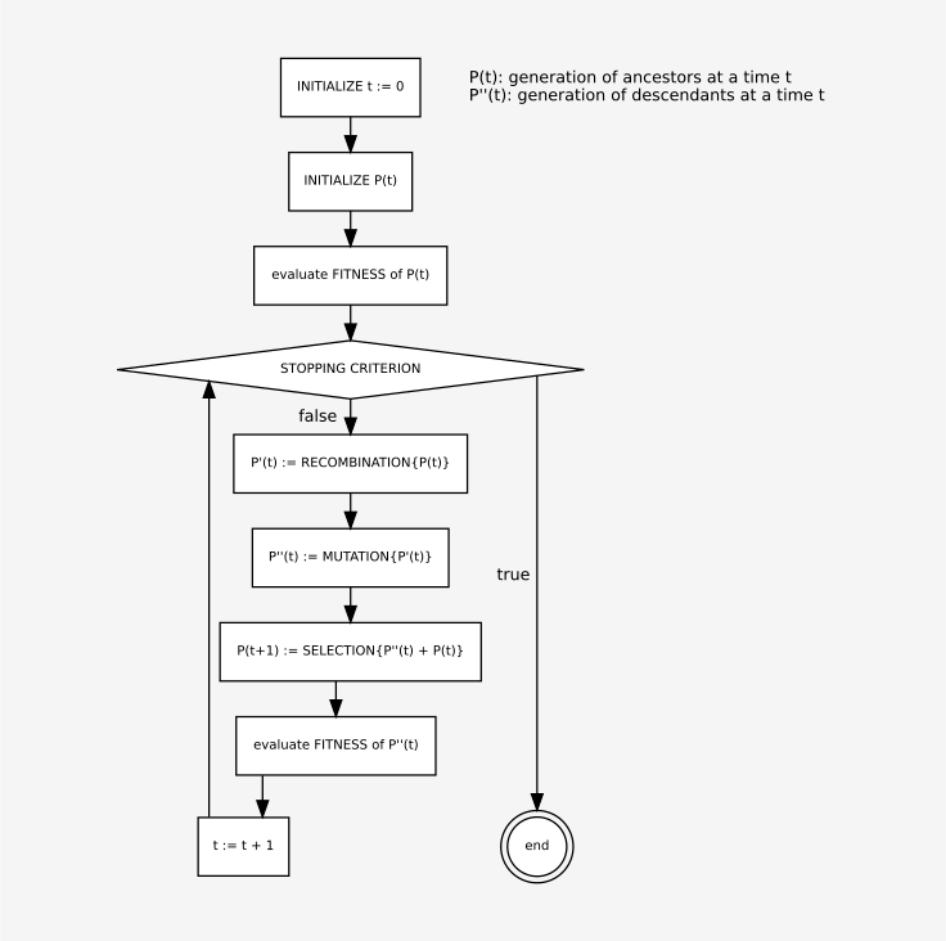
Comme tout algorithme génétique, il fonctionne par introduction de mutations aléatoires sur un état initial donné. Il permet de planifier rapidement une requête complexe, et d’obtenir un plan d’exécution dans un délai raisonnable. Ce plan là n’est pas forcément optimal, mais assez proche pour être acceptable.
Le code source de PostgreSQL28 décrit le principe, résumé aussi dans ce schéma:
Ce mécanisme est configuré par des paramètres dont les noms commencent par geqo, notamment:
geqo(par défaut àon) permet d’activer/désactiver GEQO;geqo_threshold(défaut: 12) est le nombre minimum d’éléments à joindre dans unFROMavant de déclencher le mécanisme GEQO au lieu du planificateur exhaustif;
geqo_seed(la « graine » pour la génération aléatoire, 0 par défaut) permet de forcer la recherche d’autres plans;
geqo_effort(défaut: 5) influe sur d’autres paramètres, comme la taille de l’échantillon dedépart, la sélection… qui ne seront pas évoqués ici.
Il est déconseillé de toucher à ces paramètres sans savoir ce que l’on fait.
Noter que malgré l’introduction de ces mutations aléatoires, le moteur arrive tout de même à conserver un fonctionnement déterministe29. En effet, tant que la « graine » du générateur aléatoire (geqo_seed) et les autres paramètres contrôlant GEQO restent inchangés, les plans générés seront toujours les mêmes30, toutes choses égales par ailleurs bien sûr (statistiques, paramètres…).
Paramétrage du GEQO:
Le paramétrage par défaut convient généralement.
Surtout, il est déconseillé de désactiver geqo ou de monter geqo_threshold au-delà de 12, sous peine d’explosion du temps de planification et de la consommation mémoire avec de nombreuses jointures.
Pour des requêtes dépassant ce nombre de jointures, il faudra souvent monter join_collapse_limit plus ou moins haut. Le GEQO permet d’éviter que le temps de planification augmente de manière exponentielle. Noter que si join_collapse_limit est monté entre 9 et 11, le temps de planification peut fortement augmenter car le GEQO n’intervient pas. Une fois le seuil d’intervention du GEQO dépassé, la montée du temps de planification en fonction de join_collapse_limit reste beaucoup plus maîtrisée.
Si le plan sélectionné n’est pas satisfaisant, il est possible d’en explorer d’autres en changeant le paramètre geqo_seed (voir la documentation officielle31). C’est surtout un moyen de voir si de meilleurs plans (avec un coût bien plus bas) peuvent être trouvés, car un SET geqo_seed = … n’est pas une mesure pérenne (les données changent et les requêtes sont souvent dynamiques). Dans l’idéal, le GEQO retombe toujours sur des plans de coûts voisins quelle que soit la valeur de geqo_seed.
Si ça n’est pas le cas, les plans obtenus risquent de trop varier d’un appel à l’autre. Il est alors possible de monter geqo_effort (défaut: 5) jusque 10, pour augmenter son pool de plans notamment. Le temps de planification montera au moins proportionnellement, pour un résultat normalement plus stable et plus fiable.
S’il faut en arriver là, il faut bien contrôler que le temps de planification reste tolérable. Il y a peut-être aussi besoin de vérifier la pertinence de requêtes avec des dizaines de jointures.
2.10.3 Paramètres supplémentaires de l’optimiseur
Requêtes préparées
plan_cache_modePartitionnement
constraint_exclusionenable_partition_pruningCurseurs
cursor_tuple_fractionMutualiser les entrées-sorties
synchronize_seqscans
Tous les paramètres suivants peuvent être modifiés par session.
Requêtes préparées:
Pour les requêtes préparées, par défaut l’optimiseur génère des plans personnalisés pour les cinq premières exécutions d’une requête préparée, puis il bascule sur un plan générique dès que celui-ci devient plus intéressant que la moyenne des plans personnalisés précédents. Le paramètre de configuration plan_cache_mode permet de modifier cela:
autoactive le comportement par défaut;force_custom_planforce le recalcul systématique d’un plan personnalisé pour la requête(onn’économise plus le temps de planification, mais le plan est calculé pour être optimal pour les paramètres, tout en conservant la protection contre les injections sql permise par les requêtes préparées);
force_generic_planforce l’utilisation d’un seul et même plan dès le départ.
Partitionnement:
Avant la version 10, PostgreSQL ne connaissait qu’un partitionnement par héritage, où l’on crée une table parente et des tables filles héritent de celle-ci, possédant des contraintes CHECK comme critères
de partitionnement, par exemple CHECK (date >='2011-01-01' and date < '2011-02-01') pour une table fille d’un partitionnement par mois. Afin que PostgreSQL ne parcourt que les partitions correspondant à la clause WHERE d’une requête, le paramètre constraint_exclusion doit valoir
partition (la valeur par défaut) ou on. partition est moins coûteux dans un contexte d’utilisation classique car les contraintes d’exclusion ne seront examinées que dans le cas de requêtes UNION ALL, qui sont les requêtes générées par le partitionnement.
pour le partitionnement déclaratif(à favoriser à partir de PostgreSQL10), enable_partition_pruning, activé par défaut, est le paramètre équivalent.
Curseurs:
Lors de l’utilisation de curseurs, le moteur n’a aucun moyen de connaître le nombre d’enregistrements que souhaite récupérer réellement l’utilisateur : peut-être seulement les premiers enregistrements. Si
c’est le cas, le plan d’exécution optimal ne sera plus le même. Le paramètre cursor_tuple_fraction, par défaut à 0,1, permet d’indiquer à l’optimiseur la fraction du nombre d’enregistrements qu’un curseur souhaitera vraisemblablement récupérer, et lui permettra donc de choisir un plan en conséquence. Si vous utilisez des curseurs, il vaut mieux indiquer explicitement le nombre d’enregistrements dans les requêtes avec LIMIT, et passer cursor_tuple_fraction à 1,0.
Synchronisation des parcours de table:
Quand plusieurs requêtes souhaitent accéder séquentiellement à la même table, les processus se rattachent à ceux déjà en cours de parcours, afin de profiter des entrées-sorties que ces processus effectuent, le but étant que le système se comporte comme si un seul parcours de la table était en cours, et réduise donc fortement la charge disque. Le seul problème de ce mécanisme est que les processus se rattachant ne parcourent pas la table dans son ordre physique: elles commencent leur parcours de la table à l’endroit où se trouve le processus auquel elles se rattachent, puis rebouclent sur le début de la table. Les résultats n’arrivent donc pas forcément toujours dans le même ordre, ce qui n’est normalement pas un problème (on est censé utiliser ORDER BY dans ce cas). Mais il est toujours possible de désactiver ce mécanisme en passant synchronize_seqscans à off.
2.10.4 Débogage de l’optimiseur
Permet de valider qu’on est en face d’un problème d’optimiseur.
Les paramètres sont assez grossiers:
défavoriser très fortement un type d’opération
pour du diagnostic, pas pour de la production
Gestion et affichage différents à partir de la version 18
Ces paramètres dissuadent le moteur d’utiliseruntypedenœudd’exécution.Ils permettent de vérifier ou d’invalider une erreur de l’optimiseur. Par exemple:
Le moteur a choisi un parcours séquentiel de table. Si l’on veut vérifier qu’un parcours par l’index sur la colonne a n’est pas plus rentable:
Non seulement le plan est plus coûteux, mais il est aussi (et surtout) plus lent.
Attention aux effets du cache: le parcours par index est ici relativement performant à la deuxième exécution parce que les données ont été trouvées dans le cache disque. La requête, sinon, aurait été bien plus lente. La requête initiale est donc non seulement plus rapide, mais aussi plus sûre: son temps d’exécution restera prévisible même en cas d’erreur d’estimation sur le nombre d’enregistrements.
Si nous supprimons l’index, nous constatons que le sequential scan n’a pas été désactivé. Il a juste été rendu très coûteux par ces options de débogage:
L’information Disabled: true indique qu’il avait été demandé de désactiver ce type de nœud. Cependant, avant la version 18, l’affichage ressemblait plutôt à cela:
ce plan est«très coûteux»car le coût est majoré de10milliardspourl’exécutiond’un nœud interdit.
Voici la liste des options de désactivation:
enable_bitmapscan;enable_gathermerge;enable_hashagg;enable_hashjoin;enable_incremental_sort;enable_indexonlyscan;enable_indexscan;enable_material;enable_mergejoin;enable_nestloop;enable_parallel_append;enable_parallel_hash;enable_partition_pruning;enable_partitionwise_aggregate;enable_partitionwise_join;enable_seqscan;enable_sort;enable_tidscan.
2.11 CONCLUSION
Nombreuses fonctionnalités
donc nombreux paramètres
2.11.1 Questions
N’hésitez pas, c’est le moment!
2.12 QUIZ
2.13 TRAVAUX PRATIQUES
La version en ligne des solutions de ces TP est disponible sur https://dali.bo/m2_solutions.
2.13.1 Tablespace
But: Ajouter un tablespace
Créer un tablespace nommé ts1 pointant vers /opt/ts1.
Se connecter à la base de données b1. Créer une table t_dans_ts1 avec une colonne id de type integer dans le tablespace ts1.
Récupérer le chemin du fichier correspondant à la table t_dans_ts1 avec la fonction
pg_relation_filepath.
Supprimer le tablespace ts1. Qu’observe-t-on?
2.13.2 Statistiques d’activités, tables et vues système
But: Consulter les statistiques d’activité
Créer une table t3 avec une colonne id de type integer.
Insérer 1000 lignes dans la table t3 avec generate_series.
Lire les statistiques d’activité de la table t3 à l’aide de la vue système pg_stat_user_tables.
Créer un utilisateur pgbench et créer une base pgbench lui appartenant.
Écrire une requête SQL qui affiche le nom et l’identifiant de toutes les bases de données, avec le nom du propriétaire et l’encodage. \ (Utiliser les table pg_database et pg_roles).
Comparer la requête avec celle qui est exécutée lorsque l’on tape la commande \l dans la console (penser à \set ECHO_HIDDEN).
Pour voir les sessions connectées:
dans un autre terminal, ouvrir une session
psqlsur la baseb0, qu’on n’utilisera plus;se connecter à la base
b1depuis une autre session;la vue
pg_stat_activityaffiche les sessions connectées. Qu’y trouve-t-on?
2.13.3 Statistiques sur les données
But: Consulter les statistiques sur les données
Se connecter à la base de données b1 et créer une table t4 avec une colonne id de type entier.
Empêcher l’autovacuum d’analyser automatiquement la table t4.
Insérer 1 million de lignes dans t4 avec generate_series.
Rechercher la ligne ayant comme valeur 100000 dans la colonne id et afficher le plan d’exécution.
Exécuter la commande ANALYZE sur la table t4.
Rechercher la ligne ayant comme valeur 100000 dans la colonne id et afficher le plan d’exécution.
Ajouter un index sur la colonne id de la table t4.
Rechercher la ligne ayant comme valeur 100000 dans la colonne id et afficher le plan d’exécution.
Modifier le contenu de la table t4 avec UPDATE t4 SET id = 100000;
Rechercher les lignes ayant comme valeur 100000 dans la colonne id et afficher le plan d’exécution.
Exécuter la commande ANALYZE sur la table t4.
Rechercher les lignes ayant comme valeur 100000 dans la colonne id et afficher le plan d’exécution.
2.14 TRAVAUX PRATIQUES (SOLUTIONS)
2.14.1 Tablespace
Créer un tablespace nommé ts1 pointant vers /opt/ts1.
En tant qu’utilisateur root:
En tant qu’utilisateur postgres:
Se connecter à la base de données b1. Créer une table t_dans_ts1 avec une colonne id de type integer dans le tablespace ts1.
Récupérer le chemin du fichier correspondant à la table t_dans_ts1 avec la fonction pg_relation_filepath.
Le fichier n’a pas été créé dans un sous-répertoire du répertoire base, mais dans le tablespace indiqué par la commande CREATE TABLE. /opt/ts1 n’apparaît pas ici: il y a un lien symbolique dans le chemin.
Il est à noter que ce fichier se trouve réellement dans un sous-répertoire de /opt/ts1 mais que PostgreSQL le retrouve à partir de pg_tblspc grâce à un lien symbolique.
Supprimer le tablespace ts1. Qu’observe-t-on?
La suppression échoue tant que le tablespace est utilisé. Il faut déplacer la table dans le tablespace par défaut:
2.14.2 Statistiques d’activités, tables et vues système
Créer une table t3 avec une colonne id de type integer.
Insérer 1000 lignes dans la table t3 avec generate_series.
Lire les statistiques d’activité de la table t3 à l’aide de la vue système pg_stat_user_tables.
Les statistiques indiquent bien que 1000 lignes ont été insérées.
Créer un utilisateur pgbench et créer une base pgbench lui appartenant.
Écrire une requête SQL qui affiche le nom et l’identifiant de toutes les bases de données, avec le nom du propriétaire et l’encodage. \ (Utiliser les table pg_database et pg_roles).
La liste des bases de données se trouve dans la table pg_database:
Une jointure est possible avec la table pg_roles pour déterminer le propriétaire des bases:
d’où par exemple:
L’encodage est numérique, il reste à le rendre lisible.
Comparer la requête avec celle qui est exécutée lorsque l’on tape la commande \l dans la console (penser à \set ECHO_HIDDEN).
Il est possible de positionner le paramètre \set ECHO_HIDDEN on, ou sortir de la console et la lancer de nouveau psql avec l’option -E:
Taper la commande \l. La requête envoyée par psql au serveur est affichée juste avant le résultat:
L’encodage se retrouve donc en appelant la fonction pg_encoding_to_char:
b1=# SELECT db .datname, r.rolname, db . encoding , pg_catalog.pg_encoding_to_char( db . encoding ) FROM pg_database db , pg_roles r WHERE db .datdba = r.oid;
Pour voir les sessions connectées:
dans un autre terminal, ouvrir une session
psqlsur la baseb0, qu’on n’utilisera plus; - se connecter à la baseb1depuis une autre session;la vue
pg_stat_activityaffiche les sessions connectées. Qu’y trouve-t-on?
$ psql b1
La table a de nombreux champs, affichons les plus importants:
#SELECTdatname, pid,state, usename, application_nameASappp, backend_type, queryFROMpg_stat_activity;
La session dans b1 est idle, c’est-à-dire en attente. La seule session active (au moment où elle tournait) est celle qui exécute la requête. Les autres lignes correspondent à des processus système.
Remarque: Ce n’est qu’à partir de la version 10 de PostgreSQL que la vue pg_stat_activity liste les processus d’arrière-plan (checkpointer, background writer….). Les connexions clientes peuvent s’obtenir en filtrant sur la colonne backend_type le contenu client backend.
Ce qui donnerait par exemple:
2.14.3 Statistiques sur les données
Se connecter à la base de données b1 et créer une table t4 avec une colonne id de type entier.
Empêcher l’autovacuum d’analyser automatiquement la table t4.
NB: ceci n’est à faire qu’à titre d’exercice! En production, c’est une très mauvaise idée.
Insérer 1 million de lignes dans t4 avec generate_series.
Rechercher la ligne ayant comme valeur 100000 dans la colonne id et afficher le plan d’exécution.
-> Parallel Seq Scan on t4 (cost=0.00..10301.95 rows=2351 width=4) Filter: (id = 100000)
Exécuter la commande ANALYZE sur la table t4.
Rechercher la ligne ayant comme valeur 100000 dans la colonne id et afficher le plan d’exécution.
-> Parallel Seq Scan on t4 (cost=0.00..9633.33 rows=1 width=4) Filter: (id = 100000)
les statistiques sont beaucoup plus précises.PostgreSQL sait maintenant qu’il ne va récupérer qu’une seule ligne, sur le million de lignes dans la table. C’est le cas typique où un index serait intéressant.
Ajouter un index sur la colonne id de la table t4.
Rechercher la ligne ayant comme valeur 100000 dans la colonne id et afficher le plan d’exécution.
Après création de l’index, nous constatons que PostgreSQL choisit un autre plan qui permet d’utiliser cet index.
Modifier le contenu de la table t4 avec UPDATE t4 SET id = 100000;
Toutes les lignes ont donc à présent la même valeur.
Rechercher les lignes ayant comme valeur 100000 dans la colonne id et afficher le plan d’exécution.
Là, un parcours séquentiel serait plus performant. Mais comme PostgreSQL n’a plus de statistiques à jour, il se trompe de plan et utilise toujours l’index.
Exécuter la commande ANALYZE sur la table t4.
Rechercher les lignes ayant comme valeur 100000 dans la colonne id et afficher le plan d’exécution.
Avec des statistiques à jour et malgré la présence de l’index, PostgreSQL va utiliser un parcours séquentiel qui, au final, sera plus performant.
Si l’autovacuum avait été activé, les modifications massives dans la table auraient provoqué assez rapidement la mise à jour des statistiques.
Source : manuel complet PDF, révision 26.09, pages PDF 63-126. Les travaux pratiques et leurs solutions proviennent exclusivement de la version complète.
Pour poursuivre la lecture, voir VACUUM et autovacuum.
https://doc.postgresql.fr/current/creating-cluster.html#CREATING-CLUSTER-MOUNT-POINTS ↩︎
https://www.postgresql.org/message-id/flat/CAAKRu_Z%2BJa-mwXebOoOERMMUMvJeRhzTjad4dSThxG0JLXESxw%40mail.gmail.com#c028f5b93307aafb9fe6d09d0cf3eeae ↩︎
https://git.postgresql.org/gitweb/?p=postgresql.git;a=commit;h=ff79b5b2aba02d720f9b7fff644dd50ce07b8c6e ↩︎
https://docs.postgresql.fr/current/runtime-config-resource.html#GUC-EFFECTIVE-IO-CONCURRENCY ↩︎
https://www.cybertec-postgresql.com/en/tcp-keepalive-for-a-better-postgresql-experience/ ↩︎
https://docs.postgresql.fr/current/monitoring-stats.html#WAIT-EVENT-TABLE ↩︎
https://www.postgresql.org/message-id/flat/CAAKRu_Z%2BJa-mwXebOoOERMMUMvJeRhzTjad4dSThxG0JLXESxw%40mail.gmail.com#c028f5b93307aafb9fe6d09d0cf3eeae ↩︎
https://git.postgresql.org/gitweb/?p=postgresql.git;a=commit;h=ff79b5b2aba02d720f9b7fff644dd50ce07b8c6e ↩︎
https://docs.postgresql.fr/current/runtime-config-resource.html#GUC-EFFECTIVE-IO-CONCURRENCY ↩︎
https://git.postgresql.org/gitweb/?p=postgresql.git;a=commit;h=f5bc74192d2ffb32952a06c62b3458d28ff7f98f ↩︎
https://git.postgresql.org/gitweb/?p=postgresql.git;a=commit;h=f5bc74192d2ffb32952a06c62b3458d28ff7f98f ↩︎
https://www.postgresql.org/docs/current/geqo-pg-intro.html#GEQO-PG-INTRO-GEN-POSSIBLE-PLANS ↩︎
https://www.postgresql.org/docs/current/geqo-pg-intro.html#GEQO-PG-INTRO-GEN-POSSIBLE-PLANS ↩︎