3 Mémoire et journalisation dans PostgreSQL
3/ Mémoire et journalisation dans PostgreSQL
3.1 AU MENU
La mémoire & PostgreSQL:
Mémoire partagée
Mémoire des processus
Les shared buffers & la gestion du cache
La journalisation
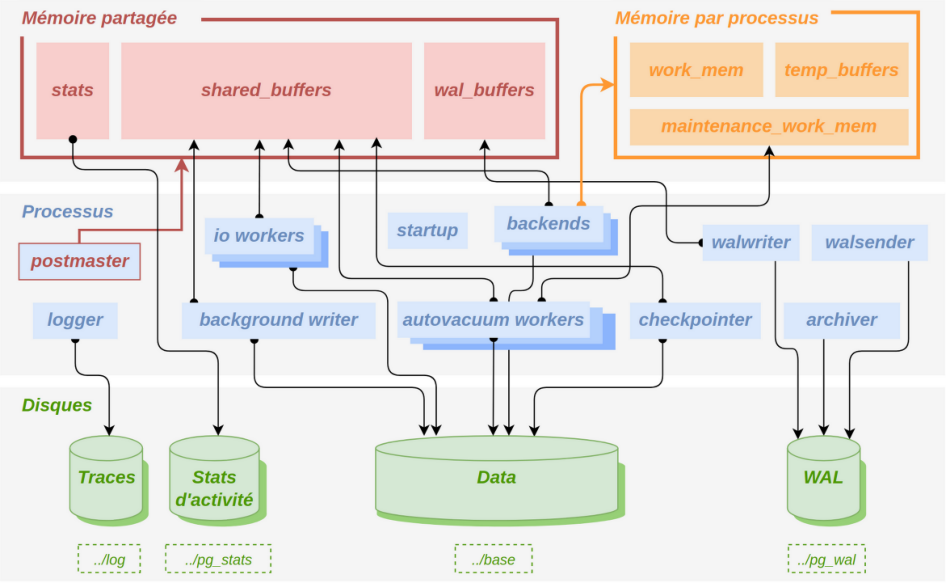
3.2 RAPPEL DE L’ARCHITECTURE DE POSTGRESQL
3.3 MÉMOIRE PARTAGÉE
3.3.1 Zones de la mémoire partagée
shared_bufferscache disque des fichiers de données
wal_bufferscache disque des journaux de transactions
max_connections100… ou plus?
track_activity_query_sizeà monter
verrous
max_connections,max_locks_per_transactionSLRU, etc…
Modification →redémarrage
La zone de mémoire partagée statique est allouée au démarrage de l’instance. Le type de mémoire partagée est configuré avec le paramètre shared_memory_type. Sous Linux, il s’agit par défaut de mmap, sachant qu’une très petite partie utilise toujours sysv (System V). (Il est en principe possible de basculer uniquement en sysv mais ceci n’est pas recommandé et nécessite un paramétrage du noyau Linux.) Sous Windows, le type est windows.
Les principales zones de mémoire partagées décrites ici sont fixes, et les tailles calculées en fonction de paramètres. Nous verrons en détail l’utilité de certaines de ces zones dans les chapitres suivants.
Shared buffers:
Les shared buffers sont le cache des fichiers de données présents sur le disque. Ils représentent de loin la volumétrie la plus importante.
Paramètre associé: shared_buffers (à adapter systématiquement)
Wal buffers:
Les wal buffers sont le cache des journaux de transaction.
Paramètre associé: wal_buffers (rarement modifié)
Données liées aux sessions:
Cet espace mémoire sert à gérer les sessions ouvertes, celles des utilisateurs, mais aussi celles ouvertes par de nombreux processus internes.
Principaux paramètres associés:
max_connections, soit le nombre de connexions simultanées possibles (défaut: 100, souventsuffisant mais à adapter);
track_activity_query_size(défaut: 1024; souvent monté à 10 000 s’il y a des requêtes degrande taille);
Verrous:
La gestion des verrous est décrite dans un autre module1. Lors des mises à jour ou suppressions dans les tables, les verrous sur les lignes sont généralement stockés dans les lignes mêmes; mais de nombreux autres verrous sont stockés en mémoire partagée. Les paramètres associés pour le dimensionnement sont surtout:
max_connectionsà nouveau;max_locks_per_transaction, soit le nombre de verrous possible pour une transaction (défaut: 64, généralement suffisant);max_pred_locks_per_relation, nombre de verrous possible pour une table si le niveau d’isolation « sérialisation » est choisi;mais encore les paramètres liés aux nombres de divers processus internes, ou de transactions préparées.
Les SLRU:
Les SLRU (Simple Least Recently Used Buffers) sont de petits caches pour certaines métadonneés de diverses natures: transactions et sous-transactions en cours, horodatage des commits, notifications par NOTIFY …
Le mécanisme a été revu en PostgreSQL 17 et, depuis, il est possible de modifier la taille des SLRU avec les paramètres commit_timestamp_buffers, multixact_member_buffers, multixact_offset_buffers, notify_buffers, serializable_buffers, subtransaction_buffers et transaction_buffers.
Les valeurs par défaut ne font parfois que 16 blocs. Les augmenter peut être intéressant si l’on repère une contention sur l’un d’eux. Un indice estla présence récurrente de wait events avec«SLRU » dans le nom. (Pour la liste des wait events, voir la table pg_wait_events, à partir de la version 17 également. Ils se voient dans pg_stat_activity. Il existe aussi une vue pg_stat_slru.)
Modification:
Toute modification des paramètres régissant la mémoire partagée imposent un redémarrage de l’instance.
3.3.2 Taille de la mémoire partagée
-- v15+ SHOW shared_memory_size; SHOW shared_memory_size_in_huge_pages;
À partir de la version 15, le paramètre shared_memory_size permet de connaître la taille complète de mémoire partagée allouée (un peu supérieure à shared_buffers en pratique). Dans le cadre de l’utilisation des HugePages, il est possible de consulter le paramètre shared_memory_size_in_huge_pages pour connaître le nombre de pages mémoires nécessaires (mais on ne peut savoir ici si elles sont utilisées):
Des zones de mémoire partagée non statiques peuvent exister: par exemple, à l’exécution d’une requête parallélisée, les processus impliqués utilisent de la mémoire partagée dynamique. Depuis PostgreSQL 14, une partie peut être pré-allouée avec le paramètre min_dynamic_shared_memory (0 par défaut).
3.4 MÉMOIRE PAR PROCESSUS
3.4.1 work_mem, maintenance_work_mem
work_mem×
hash_mem_multipliermaintenance_work_memautovacuum_work_memtemp_buffersPas de limite stricte à la consommation mémoire d’une session!
ni à la consommation totale
Augmenter prudemment & superviser
Les processus de PostgreSQL ont accès à la mémoire partagée, définie principalement par shared_buffers, mais ils ont aussi leur mémoire propre. Cette mémoire n’est utilisable que par le processus l’ayant allouée.
Le paramètre le plus important est
work_mem, qui définit la taille maximale de la mémoire de travail que peut utiliser un processus dans un nœud de requête, en particulier pour des tris (ORDER BY), certaines agrégations (par hash), certaines jointures (hash join notamment), des déduplications (DISTINCT), des CTE matérialisées (WITH … AS …)…Autre paramètre capital,
maintenance_work_memdéfinit la mémoire utilisable pour les opérations de maintenance lourdes:VACUUM,CREATE INDEX,REINDEX, ajouts de clé étrangère…
Cette mémoire liée au processus est rendue immédiatement après la fin de l’ordre concerné.
- Il existe aussi
logical_decoding_work_mem(défaut: 64 Mo), utilisable pour chacun des flux de réplication logique (s’il y en a, ils sont rarement nombreux).
Opérations de maintenance & maintenance_work_mem:
maintenance_work_mem peut être monté à 256 Mo à 1 Go, voire plus sur les machines récentes, car il concerne des opérations lourdes (indexation, nettoyage des index par VACUUM …). Leurs consommations de RAM s’additionnent, mais en pratique ces opérations sont rarement exécutées plusieurs fois simultanément.
Monter au-delà de 1 Go n’a d’intérêt que pour la création ou la réindexation de très gros index.
autovacuum_work_mem est la mémoire que s’autorise à prendre l’autovacuum pour les nettoyages d’index, et ce pour chaque worker de l’autovacuum (3 maximum par défaut). Par défaut, ce paramètre reprend maintenance_work_mem, et est généralement laissé tel quel.
Paramétrage de work_mem:
Configurer work_mem est plus compliqué.
Si work_mem est trop bas, beaucoup d’opérations ne s’effectueront pas en RAM. Par exemple, si une jointure par hachage impose d’utiliser 100 Mo en mémoire, mais que work_mem vaut 10 Mo, PostgreSQL écrira des dizaines de mégaoctets sur disque à chaque appel de la jointure. Par contre, si work_mem vaut 120 Mo, aucune écriture n’aura lieu sur disque, ce qui accélérera généralement la requête et réduira les I/O.
Trop de fichiers temporaires peuvent ralentir les opérations, voire saturer le disque. Supervisez leur présence. Mais il est illusoire de vouloir éviter tous les fichiers temporaires des grosses requêtes en montant work_mem à une valeur déraisonnable.
Un work_mem trop bas peut aussi contraindre le planificateur à choisir des plans d’exécution moins optimaux.
Si work_mem est trop haut, et que trop de requêtes le consomment simultanément, le danger est de saturer la RAM. Il n’existe en effet pas de limite à la consommation des sessions de PostgreSQL, ni globalement ni par session!
Or le paramétrage de l’ overcommit sous Linux est par défaut très permissif, et le noyau ne bloque rien. La première conséquence de la saturation de mémoire est l’assèchement du cache système (complémentaire de celui de PostgreSQL), et la dégradation des performances. Puis le système se met à swapper, avec à la clé un ralentissement général et durable. Enfin le noyau, à court de mémoire, est amené à tuer un processus de PostgreSQL. Cela mène à l’arrêt de l’instance, ou plus fréquemment à son redémarrage brutal avec coupure de toutes les connexions et requêtes en cours.
Toutefois, si l’administrateur désactive l’ overcommit, Linux refuse d’allouer une RAM qu’il n’a pas, et la requête tombe en erreur. Le cache système est préservé, et PostgreSQL ne tombe pas.
(Pour la mise en place de l’ overcommit sous Linux, voir le module J12, ou la base de connaissance Dalibo3.)
Suivant la complexité des requêtes, il est possible qu’un processus utilise plusieurs fois work_mem (par exemple si une requête fait une jointure et un tri, ou qu’un nœud est parallélisé). À l’inverse, beaucoup de requêtes ne nécessitent aucune mémoire de travail.
La valeur de work_mem dépend donc beaucoup de la mémoire disponible, des requêtes et du nombre de connexions actives.
Si le nombre de requêtes simultanées est important, work_mem devra être faible. Avec peu de requêtes simultanées, work_mem pourra être augmenté sans risque.
Il n’y a pas de formule de calcul miracle. Une première estimation courante, bien que très conservatrice, peut être:
work_mem = mémoire / max_connections
On obtient alors, sur un serveur dédié avec 16 Go de RAM et 200 connexions autorisées:
Mais max_connections est fréquemment surdimensionné, et beaucoup de sessions sont inactives. work_mem est alors sous-dimensionné.
Plus finement, Christophe Pettus propose en première intention4:
work_mem = 4 × mémoire libre / max_connections
Soit, pour une machine dédiée avec 16 Go de RAM, donc 4 Go de shared buffers, et 200 connections:
Dans l’idéal, si l’on a le temps pour une étude, il faudra vérifier les requêtes générant la plupart des fichiers (optimisation, indexation…). Puis on peut monter progressivement et prudemment work_mem jusqu’à voir disparaître l’essentiel des fichiers temporaires dans les traces, à condition de rester loin de saturer la RAM lors des pics de charge.
En pratique, le défaut de 4 Mo est très conservateur, souvent insuffisant. Généralement, la valeur varie entre 10 et 100 Mo.
Au-delà de 100 Mo, il y a souvent un problème ailleurs: des tris sur de trop gros volumes de données, une mémoire insuffisante, un manque d’index (utilisés pour les tris), etc. Des valeurs vraiment grandes ne sont valables que sur des systèmes d’infocentre.
Augmenter globalement la valeur du work_mem peut parfois mener à une consommation excessive de mémoire. Il est possible de ne la modifier que le temps d’une session pour les besoins d’une requête ou d’un traitement particulier:
hash_mem_multiplier:
hash_mem_multiplier est un paramètre multiplicateur, qui peut s’appliquer à certaines opérations (le hachage, lors de jointures ou agrégations). Par défaut, il vaut 1 en versions 13 et 14, et 2 à partir de la 15. Le seuil de consommation fixé par work_mem est alors multiplié d’autant. Lors d’un hachage, l’optimiseur considère donc qu’il peut utiliser la mémoire jusqu’à hauteur de work_mem × hash_mem_multiplier et sinon il se rabat sur le disque. L’exécuteur comptabilise la mémoire utilisée, et en cas d’erreur d’estimation conduisant à un dépassement de cette limite de consommation de mémoire, le hachage est terminé sur le disque.
L’existence de hash_mem_multiplier permet de donner plus de RAM à ces opérations sans augmenter globalement work_mem. Il peut lui aussi être modifié dans une session.
Tables temporaires
Les tables temporaires (et leurs index) sont locales à chaque session, et disparaîtront avec elle. Elles sont tout de même écrites sur disque dans le répertoire de la base.
Le cache dédié à ces tables pour minimiser les accès est séparé des shared buffers, parce qu’il est propre à la session. Sa taille dépend du paramètre temp_buffers. La valeur par défaut (8 Mo) peut être insuffisante dans certains cas pour éviter les accès aux fichiers de la table. Elle doit être augmentée dans la session avant la création de la table temporaire.
Il ne faut pas laisser inutilement ouvertes des sessions ayant créé des tables temporaires, sinon la mémoire n’est jamais rendue.
3.5 SHARED BUFFERS
3.5.1 Utilité des shared buffers
Shared buffers ou blocs de mémoire partagée - Partage les blocs entre les processus - Cache en lecture ET écriture - Capital pour les performances!
PostgreSQL dispose de son propre mécanisme de cache (les shared buffers). L’essentiel des lectures et écritures passe par ce cache(nous laissons de côté certains accès séquentiels à base de ring buffers).Si la donnée voulue n’est pas dans le cache, le processus devant effectuer cette lecture l’y recopie avant d’y accéder dans le cache.
L’unité de travail du cache est le bloc (de 8 ko par défaut). Chaque bloc du cache correspond à un bloc d’un fichier d’un objet. Un processus charge toujours un bloc entier quand il veut lire un enregistrement.
Tous les processus accèdent à ce cache unique. C’est la zone la plus importante, par la taille, de la mémoire partagée. Toute modification de données est tracée dans le journal de transaction, puis modifiée dans ce cache.Ellen’est donc pas écrite sur le disque par le processus effectuant la modification, sauf en dernière extrémité (voir Synchronisation en arrière plan).
Tout accès à un bloc nécessite la prise de verrous. Un buffer pin, qui est un simple compteur, indique qu’un processus se sert du buffer, et qu’il n’est donc pas réutilisable. C’est un verrou potentiellement de longue durée. Il existe de nombreux autres verrous, de plus courte durée, pour obtenir le droit de modifier le contenu d’un buffer, d’un enregistrement dans un buffer, le droit de recycler un buffer… mais tous ces verrous n’apparaissent pas pas dans la table pg_locks, car ils sont soit de très courte durée, soit partagés (comme le spin lock). Il est donc très rare qu’ils soient sources de contention, mais le diagnostic d’une contention à ce niveau est difficile.
Les lectures et écritures de PostgreSQL passent toutefois aussi par le cache du système. Il n’y a pas de direct I/O comme dans certains SGBD concurrents. L’intérêt est que PostgreSQL est ainsi portable sur de nombreux systèmes, et bénéficie directement des optimisations et évolutions du noyau. Par exemple, une part de prefetch a toujours existé à ce niveau. Nous verrons les évolutions de PostgreSQL à ce sujet.
3.5.2 Dimensionnement des shared buffers
- En première intention & avant tests:
Si > 8 Go:
Huge Pages,
max_wal_size,checkpoint_timeout…Indiquer le cache PG+OS pour l’optimiseur:
Dimensionner correctement ce cache est important pour de nombreuses raisons.
Un cache trop petit:
ralentit l’accès aux données, car des données importantes risquent de ne plus s’y trouver;
force l’écriture de données sur le disque, ralentissant les sessions qui auraient pu effectuer uniquement des opérations en mémoire;
limite le regroupement d’écritures, dans le cas où un bloc viendrait à être modifié plusieurs fois.
Un cache trop grand:
limite l’efficacité du cache système en augmentant la redondance de données entre les deux caches;
peut ralentir PostgreSQL, car la gestion des
shared_buffersa un coût de traitement;réduit la mémoire disponible pour d’autres opérations (tris en mémoire notamment), et peut provoquer plus d’erreurs de saturation de la mémoire.
shared_buffers: La documentation officielle5 conseille ceci pour dimensionner
Un bon point de départ est 25 % de la mémoire vive totale. Ne pas dépasser 40 %, car le cache du système d’exploitation est aussi utilisé.
Sur une machine dédiée de 32 Go de RAM, cela donne donc:
Le défaut de 128 Mo n’est donc pas adapté à un serveur sur une machine récente.
Suivant les cas, une valeur inférieure ou supérieure à 25 % sera encore meilleure pour les performances, mais il faudra tester avec votre charge (en lecture, en écriture, et avec le bon nombre de clients).
Le cache système limite la plupart du temps l’impactd’un mauvais paramétrage de shared_buffers, et il est moins grave de sous-dimensionner un peu shared_buffers que de le sur-dimensionner.
ramétrer finement le système d’exploitation (Attention: une valeur élevée de shared_buffers Huge Pa (au-delà de 8 Go) nécessite de pa_ges_ notamment) et d’autres paramètres liés aux journaux et checkpoints comme max_wal_size. Il faut aussi s’assurer qu’il restera de la mémoire pour le reste des opérations (tri…) et donc adapter work_mem.
Modifier shared_buffers impose de redémarrer l’instance.
Un cache supplémentaire est disponible pour PostgreSQL: celui du système d’exploitation. Le paramètre dédié est effective_cache_size. Sa valeur additionne les shared buffers de PostgreSQL et la taille approximative du cache du système, ou du moins de la part du cache qu’occupent les fichiers de PostgreSQL. effective_cache_size n’a pas besoin d’être précis, car il sert juste à estimer les estimations des coûts d’accès aux index. Il ne réserve aucune mémoire. Il est paramétré habituellement et en première intention aux alentours des ⅔de la taille de la mémoire vive du système d’exploitation, pour un serveur dédié à PostgreSQL.
Par exemple pour une machine avec 32 Go de RAM, on peut paramétrer en première intention dans postgresql.conf:
Cela sera à ajuster en fonction du comportement observé de l’application.
3.5.3 Notions essentielles de gestion du cache
Buffer pin
Buffer dirty/clean
Compteur d’utilisation
Clocksweep
Les principales notions à connaître pour comprendre le mécanisme de gestion du cache de PostgreSQL sont:
Buffer pin
Un processus voulant accéder à un bloc du cache (buffer) doit d’abord épingler (to pin) ce bloc pour forcer son maintien en cache. Pour ce faire, il incrémente le compteur buffer pin, puis le décrémente quand il a fini. Un buffer dont le pin est différent de 0 est donc utilisé et ne peut être recyclé.
Buffer dirty/clean
Un buffer est dirty (sale) si son contenu a été modifié en mémoire, mais pas encore sur disque. Le fichier de données n’est donc plus à jour (mais a bien été pérennisée sur disque dans les journaux de transactions). Il faudra écrire ce bloc avant de pouvoir le supprimer du cache. Nous verrons plus loin comment.
Un buffer est clean (propre) s’il n’a pas été modifié. Le bloc peut être supprimé du cache sans nécessiter le coût d’une écriture sur disque.
Compteur d’utilisation
Cette technique vise à garder dans le cache les blocs les plus utilisés.
À chaque fois qu’un processus a fini de se servir d’un buffer (quand il enlève son pin), ce compteur est incrémenté (à hauteur de 5 dans l’implémentation actuelle). Il est décrémenté par le clocksweep évoqué plus bas.
Seul un buffer dont le compteur est à zéro peut voir son contenu remplacé par un nouveau bloc.
Clocksweep (ou algorithme de balayage)
Un processus ayant besoin de charger un bloc de données dans le cache doit trouver un buffer disponible. Soit il y a encore des buffers vides (cela arrive principalement au démarrage d’une instance), soit il faut libérer un buffer.
L’algorithme clocksweep parcourt la liste des buffers de façon cyclique à la recherche d’un buffer unpinned dont le compteur d’utilisation est à zéro. Tout buffer visité voit son compteur décrémenté de 1. Le système effectue autant de passes que nécessaire sur tous les blocs jusqu’à trouver un buffer à 0. Ce clocksweep est effectué par chaque processus, au moment où ce dernier a besoin d’un nouveau buffer.
3.5.4 Ring buffer
But: Le ring buffer permet de ne pas purger le cache à cause: - des grandes tables
des grandes tables - de certaines opérations - Seq Scan
VACUUM(écritures)COPY,CREATE TABLE AS SELECT…- etc. - À partir de PG 16:vacuum_buffer_usage_limit
Une table peut être plus grosse que les shared buffers. Sa lecture intégrale (lors d’un parcours complet ou d’une opération de maintenance) ne doit pas mener à l’éviction de tous les blocs du cache. Post- shared_buffers. greSQL utilise donc plutôt un ring buffer quand la taille de la relation dépasse ¼ de Un ring buffer est une zone de mémoire gérée à l’écart des autres blocs du cache.
Pour un parcours complet d’une table, cette zone est de 256 ko (taille choisie pour tenir dans un cache L2). Si un bloc y est modifié (UPDATE …), il est traité hors du ring buffer comme un bloc sale normal.
Pour un VACUUM ou un ANALYZE, la même technique est utilisée, mais les écritures se font dans le ring buffer. Sa taille est de 2 Mo (256 ko seulement jusque PostgreSQL 16 inclus). À partir de PostgreSQL 16, elle peut être augmentée pour accélérer les opérations avec le paramètre vacuum_buffer_usage_limit ou ponctuellement ainsi:
ou ainsi:
En montant à quelques mégaoctets, l’accélération de la vitesse du VACUUM peut être notable6. C’est aussi très intéressant pour accélérer ANALYZE.
Pour les écritures en masse (notamment COPY ou CREATE TABLE AS SELECT), une technique similaire utilise un ring buffer de 16 Mo.
Le site The Internals of PostgreSQL7 et un README8 dans le code de PostgreSQL entrent plus en détail sur tous ces sujets tout en restant lisibles.
3.5.5 Contenu du cache
2 extensions en « contrib »:
pg_buffercachepg_prewarm
Deux extensions sont livrées dans les contribs de PostgreSQL qui impactent le cache.
pg_buffercache permet de consulter le contenu du cache (à utiliser de manière très ponctuelle). La requête suivante indique les objets non système de la base en cours, présents dans le cache et s’ils sont dirty ou pas:
relname | isdirty | blocs | taille |
|---|---|---|---|
pgbench_accounts | f | 8398 | 66 MB |
pgbench_accounts | t | 4622 | 36 MB |
pgbench_accounts_pkey | f | 2744 | 21 MB |
pgbench_branches | f | 14 | 112 kB |
pgbench_branches | t | 2 | 16 kB |
pgbench_branches_pkey | f | 2 | 16 kB |
pgbench_history | f | 267 | 2136 kB |
pgbench_history | t | 102 | 816 kB |
pgbench_tellers | f | 13 | 104 kB |
pgbench_tellers_pkey | f | 2 | 16 kB |
L’extension pg_prewarm permet de précharger un objet dans le cache de PostgreSQL (si le cache est assez gros, bien sûr):
Il permet même de recharger dès le démarrage le contenu du cache lors d’un arrêt (voir la documentation9).
Ces deux outils sont décrits dans le module de formation X210.
3.5.6 Synchronisation en arrière-plan
Pour synchroniser les blocs « dirty » :
- Checkpointer, essentiellement :
- lors des checkpoints (surtout périodiques) ;
- synchronise toutes les pages dirty ;
- Background writer :
- de façon anticipée, selon l’activité ;
- une portion des pages ;
- Backends :
- en dernière extrémité.
Afin de limiter les attentes des sessions interactives, PostgreSQL dispose de deux processus complémentaires, le background writer et le checkpointer. Tous deux ont pour rôle d’écrire sur le disque
les buffers dirty (« sales ») de façon asynchrone. Le but est de ne pas impacter les temps de traitement des requêtes des utilisateurs, donc que les écritures soient lissées sur de grandes plages de temps, pour ne pas saturer les disques, mais en nettoyant assez souvent le cache pour qu’il y ait toujours assez de blocs libérables en cas de besoin.
Le checkpointer écrit généralement l’essentiel des blocs dirty. Lors des checkpoints, il synchronise sur disque tous les blocs modifiés. Son rôle est de lisser cette charge sans saturer les disques.
Comme le checkpointer n’est pas censé passer très souvent, le background writer anticipe les besoins des sessions, et écrit lui-même une partie des blocs dirty.
Lors d’écritures intenses, il est possible que ces deux mécanismes soient débordés. Les processus backend ne trouvent alors plus en cache de bloc libre ou libérable, et doivent alors écrire eux-mêmes dans les fichiers de données (après les journaux de transaction, bien sûr). Cette situation est évidemment à éviter, ce qui implique généralement de rendre le background writer plus agressif.
Nous verrons plus loin les paramètres concernés.
3.5.7 Buffered IO
Double emploi partiel avec le cache du système
Pas de direct I/O
Buffered IO (lectures dans le cache de l’OS)
prefetch (lecture asynchrones) étendu en v17
IO asynchrones gérées par l’OS ou PostgreSQL (v18)
v18:
io_method = workerio_workers = 3(plus?)
Le système de maintien du cache de PostgreSQL a des inconvénients.
Tout d’abord, les caches de PostgreSQL et du système d’exploitation risquent de stocker les mêmes informations. La redondance et le gaspillage de RAM sont habituellement limités, mais il existe des cas problématiques. De plus, leurs algorithmes d’éviction sont différents.
PostgreSQL dispose de davantage d’informations sur l’utilisation des données, et le type d’accès, il semble logique qu’il serait plus performant qu’unsystèmed’exploitation«généraliste»pour gérer ses propres données. En conséquence, des travaux sont en cours pour contourner le cache du système quand cela est pertinent. Cela implique de réimplémenter certaines fonctionnalités fournies par le noyau (prefetching, read-ahead), en les optimisant pour PostgreSQL.
une première étape apparaît en version 17. PostgreSQL sait depuis longtemps lire plusieurs blocs d’un coup (fonction pread()), mais ce n’est pas très bien adapté à la nature fragmentée de son cache. Avec l’utilisation des vectored I/O11, PostgreSQL peut lire plusieurs blocs contigus sur le système de fichiers,
et les écrire à des positions disjointes en mémoire virtuelle, avec un seul appel système preadv() (voir la page de manuel12), (Avec un OS qui ne connait pas la fonction, comme Windows, PostgreSQL se contente d’appeler pread() plusieurs fois.) Avec les 128 ko par défaut d’un nouveau paramètre, io_combine_limit, et des blocs de taille standard, on a jusqu’à 16 fois moins d’appels système pour la lecture des blocs en dehors du cache PostgreSQL. En version 17, seule l’implémentation du parcours séquentiel, celle de ANALYZE, et celle de pg_prewarm utilisent cette nouvelle API. Nous conseillons de ne pas changer la valeur de ce paramètre sans tests sérieux montrant qu’un changement est bénéfique.
À partir de la version 18, PostgreSQL est capable de gérer lui-même des lectures asynchrones. Le paramètre io_method doit valoir worker (c’est devenu le défaut) ou io_uring. Pour la méthode worker, les lectures asynchrones sont exécutées par des processus io worker, dont le nombre est configurable par le paramètre io_workers (3 par défaut). La méthode sync permet de revenir au comportement des versions antérieures à la 18.
Les premiers retours d’expérience suggèrent que la méthode et que io_workers est éventuellement à monter un peu. worker est à conserver,
3.6 JOURNALISATION
3.6.1 Principe de la journalisation
3.6.2 Intégrité & durabilité
@ s.] - Intégrité: la base reste cohérente malgré:
arrêt brutal des processus
crash machine
…
Durabilité garantie si
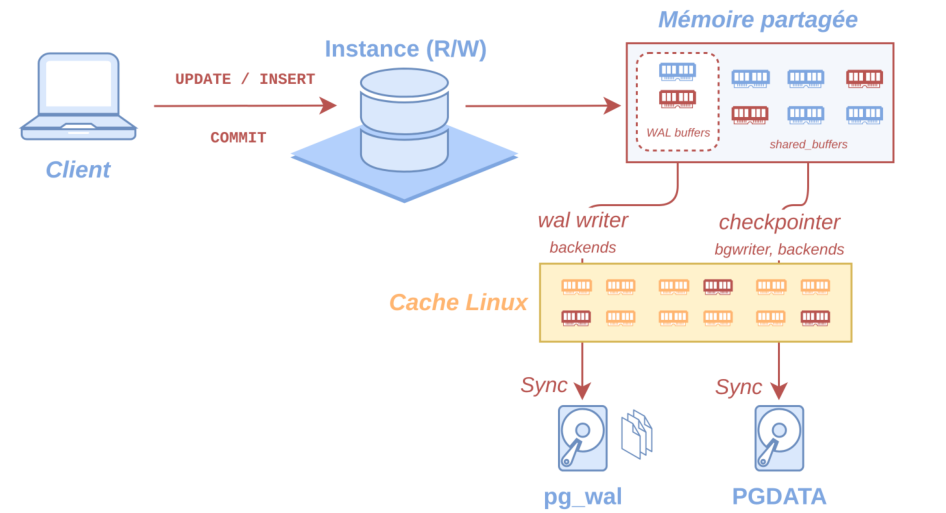
COMMITÉcriture des modifications dans un journal avant les fichiers de données
WAL: Write Ahead Logging
La journalisation, sous PostgreSQL, permet de garantir l’intégrité des fichiers, et la durabilité des opérations:
l’intégrité: la base reste cohérente quoi qu’il arrive; un arrêt d’urgence ne corrompra pas la base.
la durabilité: toute donnée validée (
COMMIT) est écrite physiquement, et un arrêt brutal immédiatement ne va pas la faire disparaître (excepté la perte de tous les disques de stockage et réplicas, bien sûr).
Pour cela, le mécanisme est relativement simple: toute modification affectant un fichier sera d’abord écrite dans le journal. Les modifications affectant les vrais fichiers de données ne sont écrites qu’en mémoire, dans les shared buffers.
Les écritures dans le journal, bien que synchrones, sont relativement performantes, car elles sont séquentielles (moins de déplacement de têtes pour les disques magnétiques). Il n’y a que le fichier en cours à synchroniser à chaque COMMIT.
Ce n’est généralement que bien plus tard que les modifications seront écrites de façon asynchrone, soit par un processus recherchant un buffer libre, soit par le background writer, soit par le checkpointer. Ce dernier processus sait étaler la charge en écriture dans les fichiers de données sur plusieurs minutes, et dans l’idéal il est seul à s’en charger.
Il existe plusieurs configurations et astuces pour arbitrer entre le niveau de durabilité des données exigé et les contraintes de performances:secondaire en réplication synchrone pour une sécurité maximale, désactivation partielle du mécanisme d’enregistrement synchrone des journaux dans une session, tables de travail non journalisées (unlogged), regroupement des insertions pour réduire l’impact des COMMIT … Aucune ne remet en cause l’intégrité définie dans les modèle de données.
3.6.3 Journaux de transaction (rappels)
Essentiellement:
Essentiellement:
pg_wal/: journaux de transactionssous-répertoire
archive_statusnom: timeline, journal, segment
ex:
00000002 00000142 000000FFpg_xact/: état des transactionsCes fichiers sont vitaux!
Rappelons que les journaux de transaction sont des fichiers de 16 Mo par défaut, stockés dans PGDATA/pg_wal, dont les noms comportent le numéro de timeline, un numéro de journal de 4 Go et un numéro de segment, en hexadécimal.
Le sous-répertoire archive_status est lié à l’archivage.
D’autres plus petits répertoires comme pg_xact, qui contient les statuts des transactions passées, ou pg_commit_ts, pg_multixact, pg_serial, pg_snapshots, pg_subtrans ou encore
pg_twophase sont également impliqués.
Tous ces répertoires sont critiques, gérés par PostgreSQL, et ne doivent pas être modifiés!
3.6.4 Que contiennent les journaux de transactions?
- Outils:
pg_waldumpoupg_walinspect
Il est peu courant de consulter le contenu des journaux, mais ce peut être utile pour chercher le moment exact d’une mauvaise manipulation au niveau applicatif, et savoir à quel moment restaurer l’instance (par exemple à cause d’une table supprimée13).
Les journaux de transactions sont des fichiers binaires. Deux outils existent pour les lire:
pg_walinspectest une extension présente depuis PostgreSQL 15, utilisable en SQL, qui nécessite qu’un journal soit encore dans lepg_wal/de PostgreSQL pour être étudié (il doit donc être récent);pg_waldumpest un outil en ligne de commande, un peu moins souple à manipuler, qui peutêtre utilisé sur tout journal qu’on a pu récupérer (dans l’archive PITR par exemple).
Exemple de résultat de pg_walinspect sur quelques lignes:
Ce petit exemple génère 80 enregistrements dans les journaux, donc seul un petit extrait figure plus haut. L’essentiel de ces lignes correspondent à des enregistrements dans diverses tables systèmes. Il n’y a que quelques enregistrements concernant directement les données insérées ou modifiées.
Noter les numéros de LSN et de transaction (xid) qui peuvent servir de point de restauration.
On trouvera par exemple 3 enregistrements de type COMMIT, avec leur heure exacte: le premier correspond à la création de la table, les deux suivants aux insertions d’une ligne validées.
De même on trouvera un enregistrement de type ABORT pour la transaction terminée par ROLLBACK.
Il y a non pas un, mais deux, enregistrements de type CREATE:
En effet, la table est accompagnée d’un index pour sa clé primaire, et le champ description stocke les chemins physiques des objets:
Dans les insertions, ce sont aussi des informations physiques qui vont apparaître, comme la relation (rel), la partie de la table (main, c’est-à-dire la partie principale), le bloc, l’offset dans le bloc…
On trouvera également un enregistrement de type UPDATE, et de nombreux enregistrements de type INSERT_LEAF correspondant à des ajouts dans les feuilles d’index. Noter que tous ces enregistrements figurent même pour la transaction annulée, celle-ci alourdit donc inutilement les journaux.
3.6.5 Checkpoint
« Point de reprise »
À partir d’où rejouer les journaux?
Données écrites au moins au niveau du checkpoint - il peut durer
Processus
checkpointer
PostgreSQL trace les modifications de données dans les journaux WAL. Ceux-ci sont générés au fur et à mesure des écritures.
Si le système ou l’instance sont arrêtés brutalement, il faut que PostgreSQL puisse appliquer le contenu des journaux non traités sur les fichiers de données. Il a donc besoin de savoir à partir d’où rejouer ces données. Ce point est ce qu’on appelle un checkpoint, ou « point de reprise ».
Les principes sont les suivants:
Tout se passe comme si toute entrée dans les journaux était idempotente, c’est-à-dire qu’elle peut être appliquée plusieurs fois, même si la récupération est interrompue. En pratique, une entrée dans les journaux est systématiquement rejouée quand c’est un bloc de8ko entier, dit aussi full page image. Une entrée de journal normale n’est appliquée que si sa position de fin (end_lsn) est postérieure au LSN de la dernière modification noté dans le bloc sur le disque (pd_lsn14).
Tout fichier de journal antérieur au dernier point de reprise valide peut être supprimé ou recyclé, car il n’est plus nécessaire à la récupération.
PostgreSQL a besoin des fichiers de données qui contiennent toutes les données jusqu’au point de reprise. Ils peuvent être plus récents et contenir des informations supplémentaires, ce n’est pas un problème.
Un checkpoint n’est pas un « instantané » cohérent de l’ensemble des fichiers. C’est simplement l’endroit à partir duquel les journaux doivent être rejoués. Il faut donc pouvoir garantir que tous les blocs modifiés dans le cache au démarrage du checkpoint auront été synchronisés sur le disque quand le checkpoint sera terminé, et marqué comme dernier checkpoint valide. Un checkpoint peut donc durer plusieurs minutes, sans que cela ne bloque l’activité.
C’est le processus checkpointer qui est responsable de l’écriture des buffers devant être synchronisés durant un checkpoint.
3.6.6 Déclenchement & comportement des checkpoints - 1
Déclenchement périodique (idéal)
checkpoint_timeoutou: Quantité de journaux
max_wal_size(pas un plafond!)ou:
CHECKPOINTÀ la fin:
sync
recyclage des journaux
Espacer les checkpoints peut réduire leur volumétrie
Plusieurs paramètres influencent le comportement des checkpoints.
Dans l’idéal les checkpoints sont périodiques. Le temps maximum entre deux checkpoints est fixé par checkpoint_timeout (par défaut 300 secondes). C’est parfois un peu court pour les instances actives.
Le checkpoint intervient aussi quand il y a beaucoup d’écritures et que le volume des journaux dépasse le seuil défini par le paramètre max_wal_size (1 Go par défaut). Un checkpoint est alors déclenché.
L’ordre CHECKPOINT déclenche aussi un checkpoint sans attendre. En fait, il sert surtout à des utilitaires.
Une fois le checkpoint terminé, les journaux sont à priori inutiles. Ils peuvent être effacés pour redescendre en-dessous de la quantité définie par max_wal_size. Ils sont généralement « recyclés », c’est-à-dire renommés, et prêt à être réécris.
Cependant, les journaux peuvent encore être retenus dans pg_wal/ si l’archivage a été activé et que certains n’ont pas été sauvegardés, ou si l’on garde des journaux pour des serveurs secondaires.
À cause de cela, le volume de l’ensemble des fichiers WAL peut largement dépasser la taille fixée par max_wal_size. Ce n’est pas une valeur plafond!
Il existe un paramètre min_wal_size (défaut: 80 Mo) qui fixe la quantité minimale de journaux à tout moment, même sans activité en écriture. Ils seront donc vides et prêts à être remplis en cas d’écriture imprévue. Bien sûr, s’il y a des grosses écritures, PostgreSQL créera au besoin des journaux supplémentaires, jusque max_wal_size, voire au-delà. Mais il lui faudra les créer et les remplir intégralement de zéros avant utilisation.
Après un gros pic d’activité suivi d’un checkpoint et d’une période calme, la quantité de journaux va très progressivement redescendre de max_wal_size à min_wal_size.
Le dimensionnement de ces paramètres est très dépendant du contexte, de l’activité habituelle, et de la régularité des écritures. Le but est d’éviter des gros pics d’écriture, et donc d’avoir des checkpoints essentiellement périodiques, même si des opérations ponctuelles peuvent y échapper (gros chargements, grosse maintenance…).
Des checkpoints espacés ont aussi pour effet de réduire la quantité totale de journaux écrits. En effet, par défaut, un bloc modifié est intégralement écrit dans les journaux à sa première modification après un checkpoint, mais par la suite seules les modifications de ce bloc sont journalisées. Espacer les checkpoints peut économiser beaucoup de place disque quand les journaux sont archivés, et du réseau s’ils sont répliqués. Par contre, un écart plus grand entre checkpoints peut allonger la restauration après un arrêt brutal, car il y aura plus de journaux à rejouer.
En pratique, une petite instance se contentera du paramétrage de base; une plus grosse montera max_wal_size à plusieurs gigaoctets.
Si checkpoint_timeout l’on monte max_wal_size, et vice-versa., par cohérence, il faudra penser à augmenter aussi
Pour min_wal_size, rien n’interdit de prendre une valeur élevée pour mieux absorber les montées d’activité brusques.
Enfin, le checkpoint comprend un sync sur disque final. Toujours pour éviter des à-coups d’écriture, PostgreSQL demande au système d’exploitation de forcer un vidage du cache quand checkpoint_flush_after a déjà été écrit (par défaut 256 ko). Avant PostgreSQL 9.6, ceci se paramétrait au niveau de Linux en abaissant les valeurs des sysctl vm.dirty_*. Il y a un intérêt à continuer de le faire, car PostgreSQL n’est pas seul à écrire de gros fichiers (exports pg_dump, copie de fichiers…).
3.6.7 Déclenchement & comportement des checkpoints - 2
Dilution des écritures
checkpoint_completion_target× durée moy. entre 2 checkpointsSurveillance:
checkpoint_warninglog_checkpointsGardez de la place! sinon crash…
Quand le checkpoint démarre, il vise à lisser au maximum le débit en écriture. La durée d’écriture des données se calcule à partir d’une fraction de checkpoint_timeout, fraction fixée par le paramètre checkpoint_completion_target. Sa valeur par défaut est celle préconisée par la documentation pour un lissage maximum, soit 0,9. Par défaut, PostgreSQL prévoit donc une durée maximale de
pour opérer son checkpoint, mais cette valeur pourra évoluer ensuite suivant la durée réelle des checkpoints précédents.
Il est possible de suivre le déroulé des checkpoints dans les traces si log_checkpoints est à on. De plus, si deux checkpoints sont rapprochés d’un intervalle de temps inférieur à checkpoint_warning (défaut: 30 secondes), un message d’avertissement sera tracé. Une répétition fréquente indique que max_wal_size est bien trop petit.
Enfin, répétons que max_wal_size n’est pas une limite en dur de la taille de pg_wal/.
La partition de pg_wal/ doit être taillée généreusement. Sa saturation entraîne l’arrêt immédiat de l’instance!
3.6.8 Paramètres du background writer
Nettoyage selon l’activité, en plus du checkpointer: - bgwriter_delay
bgwriter_delaybgwriter_lru_maxpagesbgwriter_lru_multiplierbgwriter_flush_after
Comme le checkpointer ne s’exécute pas très souvent, et ne s’occupe pas des blocs salis depuis son exécution courante, il est épaulé par le background writer. Celui-ci pour but de nettoyer une partie des blocs dirty pour faire de la place à d’autres. Il s’exécute beaucoup plus fréquemment que le checkpointer mais traite moins de blocs à chaque fois.
À intervalle régulier, le background writer synchronise un nombre de buffers proportionnel à l’activité sur l’intervalle précédent. Quatre paramètres régissent son comportement:
bgwriter_delay(défaut:200ms):la fréquence à laquelle se réveille lebackground writer;bgwriter_lru_maxpages(défaut: 100): le nombre maximum de pages pouvant être écritessurchaquetourd’activité.Ce paramètre permet d’éviter que le
background writerne veuille synchroniser trop de pages si l’activité des sessions est trop intense: dans ce cas, autant les laisser effectuer elles-mêmes les synchronisations, étant donné que la charge est forte;bgwriter_lru_multiplier(défaut: 2): le coefficient multiplicateur utilisé pour calculer lenombre de buffers à libérer par rapport aux demandes d’allocation sur la période précédente;
bgwriter_flush_after(défaut: 512 ko sous Linux, 0 ou désactivé ailleurs): à partir de quellequantité de données écrites une synchronisation sur disque est demandée.
Pour les paramètres bgwriter_lru_maxpages et bgwriter_lru_multiplier, lru signifie Least Recently Used (« moins récemment utilisé »). Ainsi le background writer synchronisera les pages du cache qui ont été utilisées le moins récemment.
Ces paramètres permettent de rendre le background writer plus agressif si la supervision montre que les processus backends écrivent trop souvent les blocs de données eux-mêmes, faute de blocs libres dans le cache, ce qui évidemment ralentit l’exécution du point de vue du client.
Évidemment, certaines écritures massives ne peuvent être absorbées par le background writer. Elles provoquent des écritures par les processus backend et des checkpoints déclenchés.
3.6.9 WAL buffers: journalisation en mémoire
Mutualiser les écritures entre transactions
Un processus d’arrière plan:
walwriterParamètres notables:
wal_bufferswal_writer_flush_afterFiabilité:
fsync=onfull_page_writes=onsinon corruption!
La journalisation s’effectue par écriture dans les journaux de transactions. Toutefois, afin de ne pas effectuer des écritures synchrones pour chaque opération dans les fichiers de journaux, les écritures sont préparées dans des tampons (buffers) en mémoire. Les processus écrivent donc leur travail de journalisation dans des buffers, ou WAL buffers. Ceux-ci sont vidés quand une session demande validation de son travail (COMMIT), qu’il n’y a plus de buffer disponible, ou que le walwriter se réveille (wal_writer_delay).
Écrire un ou plusieurs blocs séquentiels de façon synchrone sur un disque a le même coût à peu de chose près. Ce mécanisme permet donc de réduire fortement les demandes d’écriture synchrone sur le journal, et augmente donc les performances.
Afin d’éviter qu’un processus n’ait tous les buffers à écrire à l’appel de COMMIT, et que cette opération ne dure trop longtemps, un processus d’arrière-plan appelé walwriter écrit à intervalle régulier tous les buffers à synchroniser.
Ce mécanisme est géré par ces paramètres, rarement modifiés:
wal_buffers shared_buffersavec un maximum de 16 Mo (la taille d’un segment): taille des WAL buffers, soit par défaut 1/32e de 16 Mo, avec des valeurs supérieures (par exemple 128 Mo15) pouvant être intéressantes pour les très grosses charges;wal_writer_delay(défaut: 200 ms): intervalle auquel le walwriter se réveille pour écrire les buffers non synchronisés;wal_writer_flush_after(défaut: 1 Mo): au-delà de cette valeur, les journaux écrits sont synchronisés sur disque pour éviter l’accumulation dans le cache de l’OS.
Pour la fiabilité, on ne touchera pas à ceux-ci:
wal_sync_method: appel système à utiliser pour demander l’écriture synchrone (sauf très rare exception, PostgreSQL détecte tout seul le bon appel système à utiliser);full_page_writes: doit-on réécrire une image complète d’une page suite à sa première modification après un checkpoint? Sauf cas très particulier, comme un système de fichiers Copy On Write comme ZFS ou btrfs, ce paramètre doit rester àonpour éviter des corruptions de données (et il est alors conseillé d’espacer les checkpoints pour réduire la volumétrie des journaux);fsync: doit-on réellement effectuer les écritures synchrones? Le défaut estonet il est très fortement conseillé de le laisser ainsi en production. Avecoff, les performances en écritures sont certes très accélérées, mais en cas d’arrêt d’urgence de l’instance, les données seront totalement corrompues! Ce peut être intéressant pendant le chargement initial d’une nouvelle instance par exemple, sans oublier de revenir àonaprès ce chargement initial. (D’autres paramètres et techniques existent pour accélérer les écritures et sans corrompre votre instance, si vous êtes prêt à perdre certaines données non critiques:synchronous_commitàoff, les tables unlogged …)
3.6.10 Compression des journaux
wal_compressioncompression des enregistrements - moins de journaux - un peu de CPU -
off(défaut)pglz(on),lz4,zstd(v15)
wal_compression compresse les blocs complets enregistrés dans les journaux de transactions, réduisant le volume des WAL, la charge en écriture sur les disques, la volumétrie des journaux archivés des sauvegardes PITR.
Comme il y a moins de journaux, leur rejeu est aussi plus rapide, ce qui accélère la réplication et la reprise après un crash. Le prix est une augmentation de la consommation en CPU.
Les détails et un exemple figurent dans ce billet du blog Dalibo16.
Depuis PostgreSQL 15, on peut même choisir l’algorithme: pglz, lz4 ou zstd. on est le synonyme de pglz … qui est sans doute le moins bon des trois (voir ce petit test17), surtout en terme de consommation CPU.
3.6.11 Limiter le coût de la journalisation
synchronous_commitperte potentielle de données validées
commit_delay/commit_siblingsPar session
Le coût d’un fsync est parfois rédhibitoire. Avec certains sacrifices, il est parfois possible d’améliorer les performances sur ce point.
Le paramètre synchronous_commit (défaut: on) indique si la validation de la transaction en cours doit déclencher une écriture synchrone dans le journal. Le défaut permet de garantir la pérennité des données dès la fin du COMMIT.
Mais ce paramètre peut être modifié dans chaque session par une commande SET, et passé à off s’il est possible d’accepter une petite perte de données pourtant committées. La perte peut monter à 3 × wal_writer_delay (600 ms) ou wal_writer_flush_after (1 Mo) octets écrits. On accélère
ainsi notablement les flux des petites transactions. Les transactions où le paramètre reste à on continuent de profiter de la sécurité maximale. La base restera, quoi qu’il arrive, cohérente. (Ce paramètre permet aussi de régler le niveau des transactions synchrones avec des secondaires.)
Il existe aussi commit_delay (défaut: 0) et commit_siblings (défaut: 5) comme mécanisme de regroupement de transactions18. S’il y a au moins commit_siblings transactions en cours, PostgreSQL attendra jusqu’à commit_delay (en microsecondes) avant de valider une transaction pour permettre à d’autres transactions de s’y rattacher. Ce mécanisme, désactivé par défaut, accroît la latence de certaines transactions afin que plusieurs soient écrites ensembles, et n’apporte un gain de performance global qu’avec de nombreuses petites transactions en parallèle, et des disques classiques un peu lents. (En cas d’arrêt brutal, il n’y a pas à proprement parler de perte de données puisque les transactions délibérément retardées n’ont pas été signalées comme validées.)
3.7 AU-DELÀ DE LA JOURNALISATION
Sauvegarde PITR
Réplication physique - par log shipping - par streaming
Le système de journalisation de PostgreSQL étant très fiable, des fonctionnalités très intéressantes ont été bâties dessus.
3.7.1 L’archivage des journaux
Repartir à partir:
d’une vieille sauvegarde
les journaux archivés
Sauvegarde à chaud
Sauvegarde en continu
Paramètres
wal_level,archive_modearchive_commandouarchive_library
Les journaux permettent de rejouer, suite à un arrêt brutal de la base, toutes les modifications depuis le dernier checkpoint. Les journaux devenus obsolètes depuis le dernier checkpoint sont à terme recyclés ou supprimés, car ils ne sont plus nécessaires à la réparation de la base.
Le but de l’archivage est de stocker ces journaux, afin de pouvoir rejouer leur contenu, non plus depuis le dernier checkpoint, mais depuis une sauvegarde. Le mécanisme d’archivage permet de repartir d’une sauvegarde binaire de la base (c’est-à-dire des fichiers, pas un pg_dump), et de réappliquer le contenu des journaux archivés.
Il suffit de rejouer tous les journaux depuis le checkpoint précédent la sauvegarde jusqu’à la fin de la sauvegarde, ou même à un point précis dans le temps. L’application de ces journaux permet de rendre à nouveau cohérents les fichiers de données, même si ils ont été sauvegardés en cours de modification.
Ce mécanisme permet aussi de fournir une sauvegarde continue de la base, alors même que celle-ci travaille.
Tout ceci est vu dans le module Point In Time Recovery19.
Même si l’archivage n’est pas en place, il faut connaître les principaux paramètres impliqués:
wal_level:
Il vaut replica par défaut. Les journaux contiennent les informations nécessaires pour une sauvegarde PITR ou une réplication vers une instance secondaire.
Si l’on descend à minimal, les journaux ne contiennent plus que ce qui est nécessaire à une reprise après arrêt brutal sur le serveur en cours. Ce peut être intéressant pour réduire, parfois énormément, le volume des journaux générés, si l’on a bien une sauvegarde non PITR par ailleurs.
Le niveau logical est destiné à la réplication logique20.
archive_mode & archive_command / archive_library:
il faut qu’ archive_mode soità on pouractiverl’archivage.Les journaux sont alors copiés grâce à une commande shell à fournir dans archive_command ou grâce à une bibliothèque partagée indiquée dans archive_library (version 15 ou postérieure). En général on y indiquera ce qu’exige un outil de sauvegarde dédié (par exemple pgBackRest ou barman) dans sa documentation.
3.7.2 Réplication
Log shipping: fichier par fichier
Streaming: entrée par entrée (en flux continu)
Serveurs secondaires très proches de la production, en lecture
La restauration d’une sauvegarde peut se faire en continu sur un autre serveur, qui peut même être actif (bien que forcément en lecture seule). Les journaux peuvent être:
envoyés régulièrement vers le secondaire, qui les rejouera: c’est le principe de la réplication par log shipping;
envoyés par fragments vers cet autre serveur: c’est la réplication par streaming.
Ces thèmes ne seront pas développés ici. Signalons juste que la réplication par log shipping implique un archivage actif sur le primaire, et l’utilisation de restore_command (et d’autres pour affiner) sur le secondaire. Le streaming permet de se passer d’archivage, même si coupler streaming et sauvegarde PITR est une bonne idée. Sur un PostgreSQL récent, le primaire a par défaut le nécessaire activé pour se voir doté d’un secondaire: wal_level est à replica; max_wal_senders permet d’ouvrir des processus dédiés à la réplication; et l’on peut garder des journaux en paramétrant wal_keep_size pour limiter les risques de décrochage du secondaire.
Une configuration supplémentaire doit se faire sur le serveur secondaire, indiquant comment récupérer les fichiers de l’archive, et comment se connecter au primaire pour récupérer des journaux. Elle doit être placée dans postgresql.conf dans les sections évoquées plus haut, ou postgresql.auto.conf. (Jusque PostgreSQL 11 inclus existait un fichier dédié recovery.conf.)
3.8 CONCLUSION
Mémoire et journalisation: - complexe
critique
mais fiable
et le socle de nombreuses fonctionnalités évoluées
3.8.1 Questions
N’hésitez pas, c’est le moment!
3.9 QUIZ
3.10 INTRODUCTION À PGBENCH
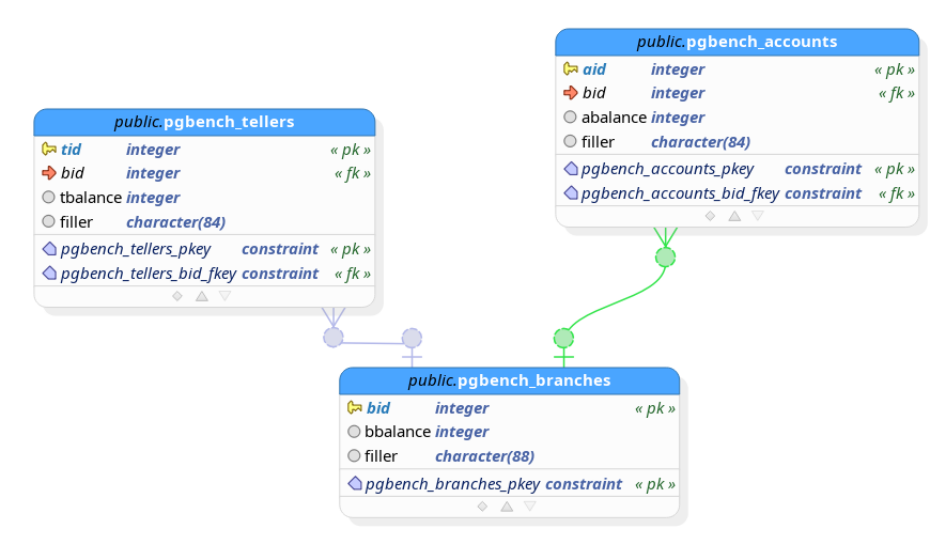
pgbench est un outil de test livré avec PostgreSQL. Son but est de faciliter la mise en place de benchmarks simples et rapides.Par défaut, il installe une base très simple, génère une activité plus oumoins intense et calcule le nombre de transactions par seconde et la latence. C’est ce qui sera fait ici dans cette introduction. On peut aussi lui fournir ses propres scripts.
La documentation complète est sur https://docs.postgresql.fr/current/pgbench.html. L’auteur principal, Fabien Coelho, a fait une présentation complète, en français, à la PG Session #9 de 201721.
3.10.1 Installation
L’outil est installé avec les paquets habituels de PostgreSQL, client ou serveur suivant la distribution.
Sur les distributions à paquets RPM (RockyLinux…), l’outil n’est pas dans le chemin par défaut, il faudra fournir le chemin complet (qui ne sera pas répété ici):
Il est préférable de créer un rôle non privilégié dédié, qui possédera la base de donnée:
Le pg_hba.conf doit éventuellement être adapté. La base par défaut s’initialise ainsi (ajouter --port et --host au besoin):
--scale permet de faire varier proportionnellement la taille de la base. À 100, la base pèsera 1,5 Go, avec 10 millions de lignes dans la table principale pgbench_accounts:
3.10.2 Générer de l’activité
Pour simuler une activité de 20 clients simultanés, répartis sur 4 processeurs, pendant 100 secondes:
Pour afficher, ajouter --debug:
À la fin, s’affichent notamment le nombre de transactions (avec et sans le temps de connexion) et la durée moyenne d’exécution du point de vue du client (latency):
Modifier le paramétrage est facile grâce à la variable d’environnement PGOPTIONS:
des exemple pour tenir compte des effets de cache, des checkpoints périodiques, etc.tests rigoureux doivent durer bien sûr beaucoup plus longtemps que 100 s, par
3.11 TRAVAUX PRATIQUES
La version en ligne des solutions de ces TP est disponible sur https://dali.bo/m3_solutions.
3.11.1 Mémoire partagée
But: constater l’effet du cache sur les accès.
Se connecter à la base de données b0 et créer une table t2 avec une colonne id de type integer.
Insérer 500 lignes dans la table t2 avec generate_series.
Pour réinitialiser les statistiques de t2:
utiliser la fonction
pg_stat_reset_single_table_countersl’OID en paramètre est dans la table des relations
pg_class, ou peut être trouvé avec't2'::regclass
Afin de vider le cache, redémarrer l’instance PostgreSQL.
Se connecter à la base de données b0 et lire les données de la table t2.
Récupérer les statistiques IO pour la table t2 dans la vue système pg_statio_user_tables. Qu’observe-t-on?
Lire de nouveau les données de la table t2 et consulter ses statistiques. Qu’observe-t-on?
Lire de nouveau les données de la table t2 et consulter ses statistiques. Qu’observe-t-on?
3.11.2 Mémoire de tri
But: constater l’influence de la mémoire de tri
Ouvrir un premier terminal et laisser défiler le fichier de traces.
Dans un second terminal, activer la trace des fichiers temporaires ainsi que l’affichage du niveau LOG pour le client (il est possible de le faire sur la session uniquement).
Insérer un million de lignes dans la table t2 avec generate_series.
Activer le chronométrage dans la session (\timing on). Lire les données de la table t2 en triant par la colonne id Qu’observe-t-on?
Configurer la valeur du paramètre work_mem à 100MB (il est possible de le faire sur la session uniquement).
Lire de nouveau les données de la table t2 en triant par la colonne id. Qu’observe-t-on?
3.11.3 Cache disque de PostgreSQL
But: constater l’effet du cache de PostgreSQL
Se connecter à la base de données b1. Installer l’extension pg_buffercache.
Créer une table t2 avec une colonne id de type integer.
Insérer un million de lignes dans la table t2 avec generate_series.
Pour vider le cache de PostgreSQL, redémarrer l’instance.
Pour vider le cache du système d’exploitation, sous root:
Se connecter à la base de données b1. En utilisant l’extension pg_buffercache, que contient le cache de PostgreSQL? (Compter les blocs pour chaque table; au besoin s’inspirer de la requête du cours.)
Activer l’affichage de la durée des requêtes. Lire les données de la table t2, en notant la durée d’exécution de la requête. Que contient le cache de PostgreSQL?
Lire de nouveau les données de la table t2. Que contient le cache de PostgreSQL?
Configurer la valeur du paramètre shared_buffers à un quart de la RAM.
Redémarrer l’instance PostgreSQL.
Se connecter à la base de données b1 et extraire de nouveau toutes les données de la table t2. Que contient le cache de PostgreSQL?
Modifier le contenu de la table t2, par exemple avec:
Que contient le cache de PostgreSQL?
Exécuter un checkpoint. Que contient le cache de PostgreSQL?
3.11.4 Journaux
But: Observer la génération de journaux
Insérer 10 millions de lignes dans la table t2 avec generate_series. Que se passe-t-il au niveau du répertoire pg_wal?
Exécuter un checkpoint. Que se passe-t-il au niveau du répertoire pg_wal?
3.12 TRAVAUX PRATIQUES (SOLUTIONS)
3.12.1 Mémoire partagée
Se connecter à la base de données b0 et créer une table t2 avec une colonne id de type integer.
Insérer 500 lignes dans la table t2 avec generate_series.
Pour réinitialiser les statistiques de t2:
utiliser la fonction
pg_stat_reset_single_table_countersl’OID en paramètre est dans la table des relations
pg_class, ou peut être trouvé avec
't2'::regclass Cette fonction attend un OID comme paramètre:
L’OID est une colonne présente dans la table pg_class:
b0=#SELECTrelname, pg_stat_reset_single_table_counters(oid)FROMpg_classWHERErelname = 't2';
Il y a cependant un raccourci à connaître:
Afin de vider le cache, redémarrer l’instance PostgreSQL.
# systemctl restart postgresql-15
Se connecter à la base de données b0 et lire les données de la table t2.
Récupérer les statistiques IO pour la table t2 dans la vue système pg_statio_user_tables. Qu’observe-t-on?
3 blocs ont été lus en dehors du cache de PostgreSQL (colonne heap_blks_read).
Lire de nouveau les données de la table t2 et consulter ses statistiques. Qu’observe-t-on?
Les 3 blocs sont maintenant lus à partir du cache de PostgreSQL (colonne heap_blks_hit).
Lire de nouveau les données de la table t2 et consulter ses statistiques. Qu’observe-t-on?
Quelle que soit la session, le cache étant partagé, tout le monde profite des données en cache.
3.12.2 Mémoire de tri
Ouvrir un premier terminal et laisser défiler le fichier de traces.
Le nom du fichier dépend de l’installation et du moment. Pour suivre tout ce qui se passe dans le fichier de traces, utiliser tail -f:
Dans un second terminal, activer la trace des fichiers temporaires ainsi que l’affichage du niveau LOG pour le client (il est possible de le faire sur la session uniquement).
Dans la session:
Les paramètres log_temp_files et client_min_messages peuvent aussi être mis en place une fois pour toutes dans postgresql.conf (recharger la configuration). En fait, c’est généralement conseillé.
Insérer un million de lignes dans la table t2 avec generate_series.
Activer le chronométrage dans la session (\timing on). Lire les données de la table t2 en triant par la colonne id Qu’observe-t-on?
Le message LOG apparaît aussi dans la trace, et en général il se trouvera là.
PostgreSQL a dû créer un fichier temporaire pour stocker le résultat temporaire du tri. Ce fichier s’appelle base/pgsql_tmp/pgsql_tmp1197.0. Il est spécifique à la session et sera détruit dès qu’il ne sera plus utile. Il fait 14 Mo.
Écrire un fichier de tri sur disque prend évidemment un certain temps, c’est généralement à éviter si le tri peut se faire en mémoire.
Configurer la valeur du paramètre work_mem à 100MB (il est possible de le faire sur la session uniquement).
Lire de nouveau les données de la table t2 en triant par la colonne id. Qu’observe-t-on?
Il n’y a plus de fichier temporaire généré. La durée d’exécution est bien moindre.
3.12.3 Cache disque de PostgreSQL
Se connecter à la base de données b1. Installer l’extension pg_buffercache.
Créer une table t2 avec une colonne id de type integer.
Insérer un million de lignes dans la table t2 avec generate_series.
Pour vider le cache de PostgreSQL, redémarrer l’instance.
Pour vider le cache du système d’exploitation, sous root:
Se connecter à la base de données b1. En utilisant l’extension pg_buffercache, que contient le cache de PostgreSQL? (Compter les blocs pour chaque table; au besoin s’inspirer de la requête du cours.)
Les valeurs exactes peuvent varier. La colonne relfilenode correspond à l’identifiant système de la table.la deuxième colonne indique le nombre de blocs.Ilyaici16181blocs non utilisés pour l’instant dans le cache (126 Mo), ce qui est logique vu que PostgreSQL vient de redémarrer. Il y a quelques blocs utilisés par des tables systèmes, mais aucune table utilisateur (on les repère par leur OID supérieur à 16384).
Activer l’affichage de la durée des requêtes. Lire les données de la table t2, en notant la durée d’exécution de la requête. Que contient le cache de PostgreSQL?
32 blocs ont été alloués pour la lecture de la table t2 (filenode 16410). Cela représente 256 ko alors que la table fait 35 Mo:
Un simple SELECT * ne suffit donc pas à maintenir la table dans le cache. Par contre, ce deuxième accès était déjà beaucoup rapide, ce qui suggère que le système d’exploitation, lui, a probablement gardé les fichiers de la table dans son propre cache.
Lire de nouveau les données de la table t2. Que contient le cache de PostgreSQL?
Il y en en a un peu plus dans le cache (en fait, 2 fois 32 ko). Plus vous exécuterez la requête, et plus le nombre de blocs présents en cache augmentera. Sur le long terme, les 4425 blocs de la table t2 peuvent se retrouver dans le cache.
Configurer la valeur du paramètre shared_buffers à un quart de la RAM.
Pour cela, il faut ouvrir le fichier de configuration postgresql.conf et modifier la valeur du paramètre shared_buffers à un quart de la mémoire. Par exemple:
Redémarrer l’instance PostgreSQL.
Se connecter à la base de données b1 et extraire de nouveau toutes les données de la table t2. Que contient le cache de PostgreSQL?
PostgreSQL se retrouve avec toute la table directement dans son cache, et ce dès la première exécution.
PostgreSQL est optimisé principalement pour une utilisation multiutilisateur. Dans ce cadre, il faut pouvoir exécuter plusieurs requêtes en même temps. Une requête ne doit donc pas monopoliser tout le cache, juste une partie. Mais plus le cache est gros, plus la partie octroyée est grosse.
Modifier le contenu de la table t2, par exemple avec:
Que contient le cache de PostgreSQL?
15 blocs ont été modifiés (isdirty est à true), le reste n’a pas bougé.
Exécuter un checkpoint. Que contient le cache de PostgreSQL?
Les blocs dirty ont tous été écrits sur le disque et sont devenus « propres ».
3.12.4 Journaux
Insérer 10 millions de lignes dans la table t2 avec generate_series. Que se passe-t-il au niveau du répertoire pg_wal?
Des journaux de transactions sont écrits lors des écritures dans la base. Leur nombre varie avec l’activité récente.
Exécuter un checkpoint. Que se passe-t-il au niveau du répertoire pg_wal?
Le nombre de journaux n’a pas forcément décru, mais le dernier journal d’avant le checkpoint est à présent le plus ancien (selon l’ordre des noms des journaux).
Ici, il n’y a ni PITR ni archivage. Les anciens journaux sont donc totalement inutiles et sont donc recyclés: renommés, il sont prêts à être remplis à nouveau. Noter que leur date de création n’a pas été mise à jour!
Source : manuel complet PDF, révision 26.09, pages PDF 127-176. Les travaux pratiques et leurs solutions proviennent exclusivement de la version complète.
Pour poursuivre la lecture, voir la sauvegarde physique et le PITR.
https://dali.bo/j1_html#configuration-de-la-surréservation-mémoire ↩︎
https://thebuild.com/blog/2023/03/13/everything-you-know-about-setting-work_mem-is-wrong/ ↩︎
https://docs.postgresql.fr/current/runtime-config-resource.html#RUNTIME-CONFIG-RESOURCE-MEMORY ↩︎
https://github.com/postgres/postgres/blob/master/src/backend/storage/buffer/README ↩︎
https://man.freebsd.org/cgi/man.cgi?query=pread&sektion=2 ↩︎
https://blog.hagander.net/locating-the-recovery-point-just-before-a-dropped-table-230/ ↩︎
https://docs.postgresql.fr/current/storage-page-layout.html#:~:text=pd_lsn ↩︎
https://www.postgresql.org/message-id/YMmlvyVyAFlxZ%2B/H%40paquier.xyz ↩︎
https://docs.postgresql.fr/current/wal-configuration.html ↩︎