# Mécanique du moteur transactionnel & MVCC
> MVCC, niveaux d’isolation, blocs, lignes, wraparound, TOAST et verrous.
---
Index LLMS : [llms.txt](/fr/llms.txt)
---
## 4/ Mécanique du moteur transactionnel & MVCC {#dba2-ch4}
**Figure p177-1.** Illustration extraite du PDF\, page 177\.
### 4.1 INTRODUCTION
PostgreSQL utilise un modèle appelé **MVCC** (_Multi-Version Concurrency Control_). - Gestion concurrente des transactions
- Excellente concurrence
- Impacts sur l’architecture
PostgreSQL s’appuie sur un modèle de gestion de transactions appelé MVCC. Nous allons expliquer cet acronyme, puis étudier en profondeur son implémentation dans le moteur.
Cette technologie a en effet un impact sur le fonctionnement et l’administration de PostgreSQL.
### 4.2 AU MENU
- Présentation de MVCC
- Niveaux d’isolation
- Implémentation de MVCC de PostgreSQL
- Les verrous
- Le mécanisme TOAST
### 4.3 PRÉSENTATION DE MVCC
#### 4.3.1 Définitions
- _MultiVersion Concurrency Control_
- Contrôle de Concurrence Multi-Version
- Plusieurs versions du même enregistrement
- Granularité: l’enregistrement (pas le champ!)
MVCC est un sigle signifiant _MultiVersion Concurrency Control_, ou « contrôle de concurrence multiversion ».
Le principe est de faciliter l’accès concurrent de plusieurs utilisateurs (sessions) à la base en disposant en permanence de plusieurs versions différentes d’un même enregistrement. Chaque session peut travailler simultanément sur la version qui s’applique à son contexte (on parle d’« instantané » ou de _snapshot_).
Par exemple, une transaction modifiant un enregistrement va créer une nouvelle version de cet enregistrement. Mais celui-ci ne devra pas être visible des autres transactions tant que le travail de modification n’est pas validé en base. Les autres transactions _verront_ donc une ancienne version de cet enregistrement. La dénomination technique est « lecture cohérente » (_consistent read_ en anglais).
Précisons que la granularité des modifications est bien l’enregistrement (ou ligne) d’une table. Modifier un champ (colonne) revient à modifier la ligne. Deux transactions ne peuvent pas modifier deux champs différents d’un même enregistrement sans entrer en conflit, et les verrous portent toujours sur des lignes entières.
#### 4.3.2 Alternative à MVCC: un seul enregistrement en base
- Verrouillage en lecture et exclusif en écriture
- Nombre de verrous?
- Contention?
- Cohérence?
- Annulation?
Avant d’expliquer en détail MVCC, voyons l’autre solution de gestion de la concurrence qui s’offre à nous, afin de comprendre le problème que MVCC essaye de résoudre.
Une table contient une liste d’enregistrements.
- Une transaction voulant consulter un enregistrement doit le verrouiller (pour s’assurer qu’il n’est pas modifié) de façon partagée, le consulter, puis le déverrouiller.
- Une transaction voulant modifier un enregistrement doit le verrouiller de façon exclusive (personne d’autre ne doit pouvoir le modifier ou le consulter), le modifier, puis le déverrouiller.
Cette solution a l’avantage de la simplicité: il suffit d’un gestionnaire de verrous pour gérer l’accès concurrent aux données. Elle a aussi l’avantage de la performance, dans le cas où les attentes de verrous sont peu nombreuses, la pénalité de verrouillage à payer étant peu coûteuse.
Elle a par contre des inconvénients:
- Les verrous sont en mémoire. Leur nombre est donc probablement limité. Que se passe-t-il si une transaction doit verrouiller 10 millions d’enregistrements? Des mécanismes de promotion de verrou sont implémentés. Les verrous lignes deviennent des verrous bloc, puis des verrous table. **Le nombre de verrous est limité, et une promotion de verrou peut avoir des conséquences dramatiques**;
- Un processus devant lire un enregistrement devra attendre la fin de la modification de celui-ci. Ceci entraîne rapidement de gros problèmes de contention. **Les écrivains bloquent les lecteurs, et les lecteurs bloquent les écrivains**. Évidemment, les écrivains se bloquent entre eux, mais cela est normal (il n’est pas possible que deux transactions modifient le même enregistrement simultanément, chacune sans conscience de ce qu’a effectué l’autre);
- Un ordre SQL (surtout s’il dure longtemps) n’a aucune garantie de voir des données cohérentes du début à la fin de son exécution : si, par exemple, durant un `SELECT` long, un écrivain modifie à la fois des données déjà lues par le `SELECT`, et des données qu’il va lire, le `SELECT` n’aura pas une vue cohérente de la table. Il pourrait y avoir un total faux sur une table comptable par exemple, le `SELECT` ayant vu seulement une partie des données validées par une nouvelle transaction;
- Comment annuler une transaction? Il faut un moyen de défaire ce qu’une transaction a effectué, au cas où elle ne se terminerait pas par une validation mais par une annulation.
#### 4.3.3 Implémentation de MVCC par _undo_
- MVCC par _undo_:
- une version de l’enregistrement dans la table
- sauvegarde des anciennes versions
- l’adresse physique d’un enregistrement ne change pas
- la lecture cohérente est complexe
- l’ _undo_ est complexe à dimensionner… et parfois insuffisant
- l’annulation est lente
- Exemple: Oracle
C’est l’implémentation d’Oracle, par exemple. Un enregistrement, quand il doit être modifié, est recopié précédemment dans le tablespace d’UNDO. La nouvelle version de l’enregistrement est ensuite écrite par-dessus. Ceci implémente le MVCC (les anciennes versions de l’enregistrement sont toujours disponibles), et présente plusieurs avantages:
- Les enregistrements ne sont pas dupliqués dans la table. Celle-ci ne grandit donc pas suite à une mise à jour (si la nouvelle version n’est pas plus grande que la version précédente);
- Les enregistrements gardent la même adresse physique dans la table. Les index correspondant à des données non modifiées de l’enregistrement n’ont donc pas à être modifiés eux-mêmes, les index permettant justement de trouver l’adresse physique d’un enregistrement par rapport à une valeur.
Elle a aussi des défauts:
- La gestion de l’ _undo_ est très complexe : comment décider ce qui peut être purgé ? Il arrive que la purge soit trop agressive, et que des transactions n’aient plus accès aux vieux enregistrements (erreur `SNAPSHOT TOO OLD` sous Oracle, par exemple);
- La lecture cohérente est complexe à mettre en œuvre : il faut, pour tout enregistrement modifié, disposer des informations permettant de retrouver l’image avant modification de l’enregistrement (et la bonne image, il pourrait y en avoir plusieurs). Il faut ensuite pouvoir le reconstituer en mémoire;
- Il est difficile de dimensionner correctement le fichier d’ _undo_. Il arrive d’ailleurs qu’il soit trop petit, déclenchant l’annulation d’une grosse transaction. Il est aussi potentiellement une source de contention entre les sessions;
- L’annulation (`ROLLBACK`) est très lente: il faut, pour toutes les modifications d’une transaction, défaire le travail, donc restaurer les images contenues dans l’ _undo_, les réappliquer aux tables (ce qui génère de nouvelles écritures). Le temps d’annulation peut être supérieur au temps de traitement initial devant être annulé.
#### 4.3.4 L’implémentation MVCC de PostgreSQL
- _Copy On Write_ (duplication à l’écriture)
- Une version d’enregistrement n’est jamais modifiée
- Toute modification entraîne une nouvelle version
- Pas d’ _undo_: pas de contention, `ROLLBACK` instantané
Dans une table PostgreSQL, un enregistrement peut être stocké dans plusieurs versions. Une modification d’un enregistrement entraîne l’écriture d’une nouvelle version de celui-ci. Une ancienne version ne peut être recyclée que lorsqu’aucune transaction ne peut plus en avoir besoin, c’est-à-dire qu’aucune transaction n’a un instantané de la base plus ancien que l’opération de modification de cet enregistrement, et que cette version est donc invisible pour tout le monde. Chaque version d’enregistrement contient bien sûr des informations permettant de déterminer s’il est visible ou non dans un contexte donné.
Les avantages de cette implémentation stockant plusieurs versions dans la table principale sont multiples:
- La lecture cohérente est très simple à mettre en œuvre: à chaque session de lire la version qui l’intéresse. La visibilité d’une version d’enregistrement est simple à déterminer;
- Il n’y a pas d’ _undo_. C’est un aspect de moins à gérer dans l’administration de la base;
- Il n’y a pas de contention possible sur l’ _undo_;
- Il n’y a pas de recopie dans l’ _undo_ avant la mise à jour d’un enregistrement. La mise à jour est donc moins coûteuse;
- L’annulation d’une transaction est instantanée: les anciens enregistrements sont toujours disponibles.
Cette implémentation a quelques défauts:
- Il faut supprimer régulièrement les versions obsolètes des enregistrements;
- Il y a davantage de maintenance d’index (mais moins de contentions sur leur mise à jour);
- Les enregistrements embarquent des informations de visibilité, qui les rendent plus volumineux.
### 4.4 NIVEAUX D’ISOLATION
#### 4.4.1 Principe des niveaux d’isolation
- Chaque transaction (et donc session) est isolée à un certain point:
- elle ne voit pas les opérations des autres
- elle s’exécute indépendamment des autres
- Le niveau d’isolation au démarrage d’une transaction peut être spécifié:
- `BEGIN ISOLATION LEVEL xxx`;
Chaque transaction, en plus d’être atomique, s’exécute séparément des autres. Le niveau de séparation demandé est un compromis entre le besoin applicatif (pouvoir ignorer sans risque ce que font les autres transactions) et les contraintes imposées au niveau de PostgreSQL (performances, risque d’échec d’une transaction). Quatre niveaux sont définis, ils ne sont pas tous implémentés par PostgreSQL.
#### 4.4.2 Niveau READ UNCOMMITTED
- Non disponible sous PostgreSQL
- si demandé, s’exécute en `READ COMMITTED`
- Lecture de données modifiées par d’autres transactions **non** validées
- Aussi appelé _dirty reads_
- Dangereux
- Pas de blocage entre les sessions
Ce niveau d’isolation n’est disponible que pour les SGBD non-MVCC. Il est très dangereux: il est possible de lire des données invalides, ou temporaires, puisque tous les enregistrements de la table sont lus, quels que soient leurs états. Il est utilisé dans certains cas où les performances sont cruciales, au détriment de la justesse des données.
Sous PostgreSQL, ce mode n’est pas disponible. Une transaction qui demande le niveau d’isolation `READ UNCOMMITTED` s’exécute en fait en `READ COMMITTED`.
#### 4.4.3 Niveau READ COMMITTED
- Niveau d’isolation par défaut
- La transaction ne lit que les données validées en base
- Un ordre SQL s’exécute dans un instantané (les tables semblent figées sur la durée de l’ordre)
- L’ordre suivant s’exécute dans un instantané différent
Ce mode est le mode par défaut, et est suffisant dans de nombreux contextes. PostgreSQL étant MVCC, les écrivains et les lecteurs ne se bloquent pas mutuellement, et chaque ordre s’exécute sur un instantané de la base (ce n’est pas un prérequis de `READ COMMITTED` dans la norme SQL). Il n’y a plus de lectures d’enregistrements non valides (_dirty reads_). Il est toutefois possible d’avoir deux problèmes majeurs d’isolation dans ce mode:
- Les lectures non-répétables (_non-repeatable reads_): une transaction peut ne pas voir les mêmes enregistrements d’une requête sur l’autre, si d’autres transactions ont validé des modifications entre temps;
- Les lectures fantômes (_phantom reads_): une transaction réexécute une requête renvoyant un ensemble de lignes satisfaisant une condition de recherche, et trouve que celui-ci a changé du fait d’une autre transaction validée entre-temps, qui a ajouté ou supprimé des lignes satisfaisant la condition.
#### 4.4.4 Niveau REPEATABLE READ
- Instantané au début de la transaction
- Ne voit donc plus les modifications des autres transactions
- Voit toujours ses propres modifications
- Peut entrer en conflit avec d’autres transactions si modification des mêmes enregistrements
Ce mode, comme son nom l’indique, permet de ne plus avoir de lectures non-répétables. Deux ordres SQL consécutifs dans la même transaction retourneront les mêmes enregistrements, dans la même version. Ceci est possible car la transaction voit une image de la base figée. L’image est figée non au démarrage de la transaction, mais à la première commande non TCL (_Transaction Control Language_) de la transaction, donc généralement au premier `SELECT` ou à la première modification.
Cette image sera utilisée pendant toute la durée de la transaction. En lecture seule, ces transactions ne peuvent pas échouer. Elles sont entre autres utilisées pour réaliser des exports des données: c’est ce que fait `pg_dump`.
Dans le standard, ce niveau d’isolation souffre toujours des lectures fantômes, c’est-à-dire de lecture d’enregistrements différents pour une même clause `WHERE` entre deux exécutions de requêtes. Cependant, PostgreSQL est plus strict et ne permet pas ces lectures fantômes en `REPEATABLE READ`. Autrement dit, un même `SELECT` renverra toujours le même résultat.
En écriture, par contre (ou `SELECT FOR UPDATE`, `FOR SHARE`), si une autre transaction a modifié les enregistrements ciblés entre temps, une transaction en `REPEATABLE READ` va échouer avec l’erreur suivante:
**Exemple p186-1.** Exemple extrait du PDF\, page 186\.
```text
ERROR: could not serialize access due to concurrent update
```
Il faut donc que l’application soit capable de la rejouer au besoin.
#### 4.4.5 Niveau SERIALIZABLE
- Niveau d’isolation le plus élevé
- Chaque transaction se croit seule sur la base
- sinon annulation d’une transaction en cours
- Avantages:
- pas de « lectures fantômes »
- évite des verrous, simplifie le développement
- Inconvénients:
- pouvoir rejouer les transactions annulées
- toutes les transactions impliquées doivent être sérialisables
PostgreSQL fournit un mode d’isolation appelé `SERIALIZABLE`:
**Exemple p186-2.** Exemple extrait du PDF\, page 186\.
```sql
BEGIN TRANSACTION ISOLATION LEVEL SERIALIZABLE ;
```
**Exemple p186-3.** Exemple extrait du PDF\, page 186\.
```sql
COMMIT / ROLLBACK ;
```
Dans ce mode, toutes les transactions déclarées comme telles s’exécutent comme si elles étaient seules sur la base, et comme si elles se déroulaient les unes à la suite des autres. Dès que cette garantie ne peut plus être apportée, PostgreSQL annule celle qui entraînera le moins de perte de données.
Le niveau `SERIALIZABLE` est utile quand le résultat d’une transaction peut être influencé par une transaction tournant en parallèle, par exemple quand des valeurs de lignes dépendent de valeurs d’autres lignes: mouvements de stocks, mouvements financiers… avec calculs de stocks. Autrement dit, si une transaction lit des lignes, elle a la garantie que leurs valeurs ne seront pas modifiées jusqu’à son `COMMIT`, y compris par les transactions qu’elle ne voit pas - ou bien elle tombera en erreur.
Au niveau `SERIALIZABLE` (comme en `REPEATABLE READ`), il est donc essentiel de pouvoir rejouer une transaction en cas d’échec. Par contre, nous simplifions énormément tous les autres points du développement. Il n’y a plus besoin de `SELECT FOR UPDATE`, solution courante mais très gênante pour les transactions concurrentes. Les triggers peuvent être utilisés sans soucis pour valider des opérations.
Ce mode doit être mis en place globalement, car toute transaction non sérialisable peut en théorie s’exécuter n’importe quand, ce qui rend inopérant le mode sérialisable sur les autres.
La sérialisation utilise le « verrouillage de prédicats ». Ces verrous sont visibles dans la vue `pg_locks` sous le nom `SIReadLock`, et ne gênent pas les opérations habituelles, du moins tant que la sérialisation est respectée. Un enregistrement qui « apparaît » ultérieurement suite à une mise à jour réalisée par une transaction concurrente déclenchera aussi une erreur de sérialisation.
Le wiki PostgreSQL[^1], et la documentation officielle[^2] donnent des exemples, et ajoutent quelques conseils pour l’utilisation de transactions sérialisables. Afin de tenter de réduire les verrous et le nombre d’échecs:
- faire des transactions les plus courtes possibles (si possible uniquement ce qui a trait à l’intégrité);
- limiter le nombre de connexions actives;
- utiliser les transactions en mode `READ ONLY` dès que possible, voire en `SERIALIZABLE READ ONLY DEFERRABLE` (au risque d’un délai au démarrage);
- augmenter certains paramètres liés aux verrous, c’est-à-dire augmenter la mémoire dédiée ; car si elle manque, des verrous de niveau ligne pourraient être regroupés en verrous plus larges et plus gênants;
- éviter les parcours de tables (_Seq Scan_), et donc privilégier les accès par index.
[^1]: https://wiki.postgresql.org/wiki/SSI/fr
[^2]: https://docs.postgresql.fr/current/transaction-iso.html#XACT-SERIALIZABLE
### 4.5 BLOCS & LIGNES
#### 4.5.1 Structure d’un bloc
**Figure p188-1.** Illustration extraite du PDF\, page 188\.
**Figure 4.1.** Répartition des lignes au sein d’un bloc\.
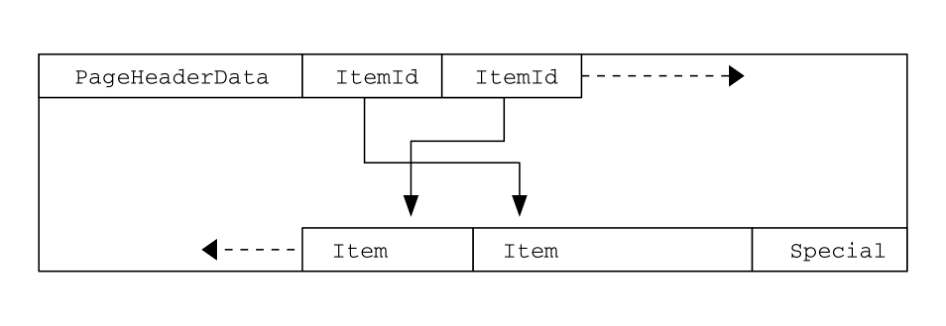
Le bloc (ou page) est l’unité de base de transfert pour les I/O, le cache mémoire… Il fait généralement 8 ko (ce qui ne peut être modifié qu’en recompilant). Les lignes y sont stockées avec des informations d’administration telles que décrites dans le schéma ci-dessus. Une ligne ne fait jamais partie que d’un seul bloc (si cela ne suffit pas, un mécanisme que nous verrons plus tard, nommé TOAST, se déclenche).
Nous distinguons dans ce bloc:
- un entête de page avec diverses informations, notamment la somme de contrôle (si activée);
- des identificateurs de 4 octets, pointant vers les emplacements des lignes au sein du bloc;
- les lignes, stockées à rebours depuis la fin du bloc;
- un espace spécial, vide pour les tables ordinaires, mais utilisé par les blocs d’index.
Le `ctid` identifie une ligne, en combinant le numéro du bloc (à partir de 0) et l’identificateur dans le bloc (à partir de 1). Comme la plupart des champs administratifs liés à une ligne, il suffit de l’inclure dans un `SELECT` pour l’afficher. L’exemple suivant affiche les premiers et derniers éléments des deux blocs d’une table et vérifie qu’il n’y a pas de troisième bloc:
**Exemple p188-1.** Exemple extrait du PDF\, page 188\.
```sql
# CREATE TABLE deuxblocs AS SELECT i, i AS j FROM generate_series(1, 452) i;
SELECT 452
```
**Exemple p189-1.** Exemple extrait du PDF\, page 189\.
```sql
# SELECT ctid, i,j FROM deuxblocs
WHERE ctid in ( '(1, 1)', '(0, 226)', '(1, 1)', '(1, 226)', '(1, 227)', '(2, 0)' );
```
**Exemple p189-2.** Exemple extrait du PDF\, page 189\.
```text
ctid | i | j
---------+-----+-----
(0,1) | 1 | 1
(0,226) | 226 | 226
(1,1) | 227 | 227
(1,226) | 452 | 452
```
Unêtre `ctid` utilisé ne doit jamais servir à désigner une ligne de manière pérenne et ne doit pasdans des requêtes! Il peut changer n’importe quand, notamment en cas d’ `UPDATE` ou de `VACUUM FULL`!
La documentation officielle[^3] contient évidemment tous les détails.
Pour observer le contenu d’un bloc, à titre pédagogique, vous pouvez utiliser l’extension pageinspect[^4].
#### 4.5.2 xmin & xmax
Table initiale:
**Tableau p189-1.** Tableau extrait du PDF\, page 189\.
|xmin|xmax|Nom|Solde|
|---|---|---|---|
|100||M. Durand|1500|
|100||Mme Martin|2200|
PostgreSQL stocke des informations de visibilité dans chaque version d’enregistrement.
- `xmin`: l’identifiant de la transaction créant cette version.
- `xmax`: l’identifiant de la transaction invalidant cette version.
Ici, les deux enregistrements ont été créés par la transaction 100. Il s’agit peut-être, par exemple, de la transaction ayant importé tous les soldes à l’initialisation de la base.
#### 4.5.3 xmin & xmax (suite)
**`BEGIN`** `;` **`UPDATE`** `soldes` **`SET`** `solde = solde - 200` **`WHERE`** `nom = 'M. Durand';`
[^3]: https://docs.postgresql.fr/current/storage-page-layout.html
[^4]: https://docs.postgresql.fr/current/pageinspect.html#PAGEINSPECT-HEAP-FUNCS
**Tableau p190-1.** Tableau extrait du PDF\, page 190\.
|xmin|xmax|Nom|Solde|
|---|---|---|---|
|100|**150**|M. Durand|1500|
|100||Mme Martin|2200|
|**150**||M. Durand|1300|
Nous décidons d’enregistrer un virement de 200 € du compte de M. Durand vers celui de Mme Martin. Ceci doit être effectué dans une seule transaction: l’opération doit être atomique, sans quoi de l’argent pourrait apparaître ou disparaître de la table.
Nous allons donc tout d’abord démarrer une transaction (ordre `SQL BEGIN`). PostgreSQL fournit donc à notre session un nouveau numéro de transaction (150 dans notre exemple). Puis nous effectuerons:
**Exemple p190-1.** Exemple extrait du PDF\, page 190\.
```sql
UPDATE soldes SET solde = solde - 200 WHERE nom = 'M. Durand';
```
#### 4.5.4 xmin & xmax (suite)
**Exemple p190-2.** Exemple extrait du PDF\, page 190\.
```sql
UPDATE soldes SET solde = solde + 200 WHERE nom = 'Mme Martin';
```
**Tableau p190-2.** Tableau extrait du PDF\, page 190\.
|xmin|xmax|Nom|Solde|
|---|---|---|---|
|100|150|M. Durand|1500|
|100|**150**|Mme Martin|2200|
|150||M. Durand|1300|
|**150**||Mme Martin|2400|
Puis nous effectuerons:
**Exemple p190-3.** Exemple extrait du PDF\, page 190\.
```sql
UPDATE soldes SET solde = solde + 200 WHERE nom = 'Mme Martin';
```
Nous avons maintenant deux versions de chaque enregistrement. Notre session ne voit bien sûr plus que les nouvelles versions de ces enregistrements, sauf si elle décidait d’annuler la transaction, auquel cas elle reverrait les anciennes données.
Pour une autre session, la version visible de ces enregistrements dépend de plusieurs critères:
- La transaction 150 a-t-elle été validée? Sinon elle est invisible;
- la transaction 150 a-t-elle été validée après le démarrage de la transaction en cours, et sommes-nous dans un niveau d’isolation (_repeatable read_ ou _serializable_) qui nous interdit de voir les modifications faites depuis le début de notre transaction?;
- La transaction 150 a-t-elle été validée après le démarrage de la requête en cours? Une requête, sous PostgreSQL, voit un instantané cohérent de la base, ce qui implique que toute transaction validée après le démarrage de la requête doit être ignorée.
Dans le cas le plus simple, 150 ayant été validée, une transaction 160 ne verra pas les premières versions: `xmax` valant 150, ces enregistrements ne sont pas visibles. Elle verra les secondes versions, puisque `xmin` = 150, et pas de `xmax`.
#### 4.5.5 xmin & xmax (suite)
**Tableau p191-1.** Tableau extrait du PDF\, page 191\.
|xmin|xmax|Nom|Solde|
|---|---|---|---|
|100|150|M. Durand|1500|
|100|**150**|Mme Martin|2200|
|150||M. Durand|1300|
|**150**||Mme Martin|2400|
- Comment est effectuée la suppression d’un enregistrement?
- Comment est effectuée l’annulation de la transaction 150?
- `xmax` dans la
- La suppression d’un enregistrement s’effectue simplement par l’écriture d’un version courante de la ligne;
- Le `COMMIT` ou le `ROLLBACK` consiste à écrire le statut de la transaction dans le CLOG (_Commit Log_), une zone mémoire dédiée au statut des transactions.
#### 4.5.6 CLOG
- Le CLOG (_Commit Log_) enregistre l’état des transactions.
- Chaque transaction occupe 2 bits de CLOG (4 statuts)
- `COMMIT` ou `ROLLBACK` très rapide
- Référence pour savoir si une ligne est visible ou pas
- Puis reporté dans les lignes (_hint bits_)
Le CLOG permet à PostgreSQL de savoir si les numéros de transaction portés par une ligne sont validés ou non. Le CLOG est stocké dans une série de fichiers de 256 ko, stockés dans le répertoire `pg_xact/` de PGDATA (répertoire racine de l’instance PostgreSQL). Chaque transaction est créée dans ce fichier dès son démarrage et est encodée sur deux bits puisqu’une transaction peut avoir quatre états:
- `TRANSACTION_STATUS_IN_PROGRESS` signifie que la transaction est en cours, c’est l’état initial;
- `TRANSACTION_STATUS_COMMITTED` signifie que la la transaction a été validée;
- `TRANSACTION_STATUS_ABORTED` signifie que la transaction a été annulée;
- `TRANSACTION_STATUS_SUB_COMMITTED` signifie que la transaction comporte des soustransactions, afin de valider l’ensemble des sous-transactions de façon atomique.
Nous avons donc un million d’états de transactions par fichier de 256 ko.
Ainsi, annuler une transaction (`ROLLBACK`) est quasiment instantané sous PostgreSQL: il suffit d’écrire `TRANSACTION_STATUS_ABORTED` dans l’entrée de CLOG correspondant à la transaction. Les lignes insérées par cette transaction seront simplement ignorées, de même que des versions de lignes créées par un `UPDATE`. Les versions de lignes marquées comme périmées par ce même `UPDATE` dans la transaction resteront visibles.
Toute modification dans le CLOG, comme toute modification d’un fichier de données (table, index, séquence, vue matérialisée), est bien sûr enregistrée tout d’abord dans les journaux de transactions (dans le répertoire `pg_wal/`).
Pour éviter de se référer au CLOG trop souvent, chaque ligne porte des _hint bits_ contenant, entre autres, le statut des numéros de transaction portés par la ligne. Mais ce n’est pas la requête qui a modifié les lignes qui les renseigne. La première requête qui lit une ligne après une modification, même un `SELECT`, lit le CLOG et met à jour ses _hint bits_, ce qui occasionne de nouvelles écritures. (Et génèrent même de nouveaux journaux si `wal_log_hints` est `on` ou si les sommes de contrôle sont activées, ce qui est recommandé.)
### 4.6 AVANTAGES & INCONVÉNIENTS DU MVCC DE POSTGRESQL
#### 4.6.1 Avantages du MVCC de PostgreSQL
- Avantages classiques de MVCC (concurrence d’accès)
- Implémentation simple et performante
- Peu de sources de contention
- Verrouillage simple d’enregistrement
- `ROLLBACK` instantané
- Données conservées aussi longtemps que nécessaire
Reprenons les avantages du MVCC tel qu’implémenté par PostgreSQL:
- Les lecteurs ne bloquent pas les écrivains, ni les écrivains les lecteurs;
- Le code gérant les instantanés est simple, ce qui est excellent pour la fiabilité, la maintenabilité et les performances;
- Les différentes sessions ne se gênent pas pour l’accès à une ressource commune (l’ _undo_);
- Un enregistrement est facilement identifiable comme étant verrouillé en écriture: il suffit qu’il ait une version ayant un `xmax` correspondant à une transaction en cours;
- L’annulation est instantanée: il suffit d’écrire le nouvel état de la transaction annulée dans la CLOG. Pas besoin de restaurer les valeurs précédentes, elles sont toujours là;
- Les anciennes versions restent en ligne aussi longtemps que nécessaire. Elles ne pourront être effacées de la base qu’une fois qu’aucune transaction ne les considérera comme visibles.
(Précisons toutefois que ceci est une vision un peu simplifiée pour les cas courants. La signification du `xmax` est parfois altérée par des bits positionnés dans des champs systèmes inaccessibles par l’utilisateur. Cela arrive, par exemple, quand des transactions insèrent des lignes portant une clé étrangère, pour verrouiller la ligne pointée par cette clé, laquelle ne doit pas disparaître pendant la durée de cette transaction.)
#### 4.6.2 Inconvénients du MVCC de PostgreSQL
- Nettoyage des enregistrements
- `VACUUM`
- automatisation: autovacuum
- Tables plus volumineuses
- Écritures amplifiées
- Pas de visibilité des lignes dans les index
- Les colonnes supprimées impliquent reconstruction
Comme toute solution complexe, l’implémentation MVCC de PostgreSQL est un compromis. Les avantages cités précédemment sont obtenus au prix de concessions. Bien sûr, divers mécanismes tentent de mitiger ces soucis.
#### 4.6.2.1 VACUUM
Il faut nettoyer les tables de leurs enregistrements morts. C’est le travail de la commande `VACUUM`. Il a un avantage sur la technique de l’ _undo_: le nettoyage n’est pas effectué par un client faisant des mises à jour (et créant donc des enregistrements morts), et le ressenti est donc meilleur.
`VACUUM` peut se lancer à la main, mais dans le cas général on s’en remet à l’autovacuum, un démon qui lance les `VACUUM` (et bien plus) en arrière-plan quand il le juge nécessaire. Tout cela sera traité en détail par la suite.
#### 4.6.2.2 Bloat
Les tables sont forcément plus volumineuses que dans l’implémentation par _undo_, pour deux raisons:
- les informations de visibilité y sont stockées, il y a donc un surcoût d’une douzaine d’octets par enregistrement;
- il y a toujours des enregistrements morts dans une table, une sorte de _fond de roulement_, qui se stabilise quand l’application est en régime stationnaire.
Ces enregistrements sont recyclés à chaque passage de `VACUUM`.
#### 4.6.2.3 Amplification des écritures
Toute écriture a tendance à en déclencher d’autres. D’abord, toute modification est écrite dans les journaux de transaction, comme le fait tout moteur de base de données relationnelle fiable, et éventuellement archivée et/ou répliquée.
Des suppressions, insertions ou mises à jour, même suivies d’un `ROLLBACK`, écrivent toujours dans les fichiers de données eux-mêmes. (Ce sont les numéros de transaction et le CLOG qui définiront la visibilité des lignes.) Le `VACUUM` nettoie les lignes, et cela genère aussi des écritures et des journaux. Nous verrons également le coût du problème de _wraparound_. La mise à jour des _hints bits_, même lors d’un `SELECT`, génère de nouvelles écritures voire des journaux.
Comme les index pointent vers un bloc et une ligne, les index sont également souvent à modifier suite à une écriture (et cela est aussi journalisé).
#### 4.6.2.4 Visibilité
Les index ne contiennent pas d’information de visibilité. Il est donc nécessaire d’aller vérifier qu’un enregistrement trouvé dans l’index est bien visible dans la table associée. Cela a un impact sur le
temps d’exécution de requêtes où l’index contient pourtant tous les champs nécessaire (par exemple un `SELECT count(*)`): dans le cas le plus défavorable, il est nécessaire d’aller visiter tous les enregistrements pour s’assurer qu’ils sont bien visibles.
Or, la _visibility map_ d’une table contient la liste des blocs aux lignes toutes visibles. Les nœuds _Index Only Scan_ l’utilisent pour s’épargner les allers-retours vers la table. Il existe également des mécanismes de nettoyage des index quand une requête rencontre des _tuples_ périmés.
#### 4.6.2.5 Colonnes supprimées
Un `VACUUM` ne s’occupe pas de l’espace libéré par des colonnes supprimées (fragmentation verticale). Un `VACUUM FULL` est nécessaire pour reconstruire la table.
### 4.7 LE WRAPAROUND
#### 4.7.1 Le wraparound (1)
- _Wraparound_: bouclage du compteur de `xmin` / `xmax` - 32 bits ~ 4 milliards &-)e |
**Figure p196-1.** Illustration extraite du PDF\, page 196\.
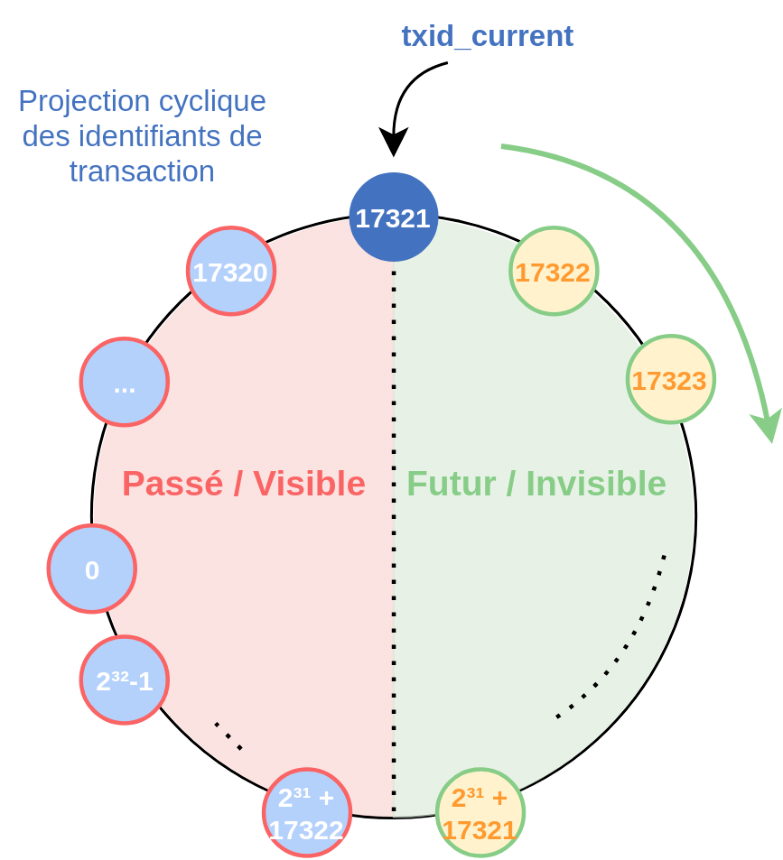
le numéro de transaction stocké sur chaque ligne est sur 32 bits, même si PostgreSQL utilise en interne 64 bits. Il y aura donc dépassement de ce compteur au bout de 4 milliards de transactions. Sur les machines actuelles, avec une activité soutenue, cela peut être atteint relativement rapidement.
En fait, ce compteur est cyclique. Cela peut se voir ainsi:
**Exemple p197-1.** Exemple extrait du PDF\, page 197\.
```sql
SELECT pg_current_xact_id(), *
FROM pg_control_checkpoint()\gx
```
**Tableau p197-1.** Tableau extrait du PDF\, page 197\.
```text
-[ RECORD 1 ]--------+-------------------------
pg_current_xact_id | 10549379902
checkpoint_lsn | 62/B902F128
redo_lsn | 62/B902F0F0
redo_wal_file | 0000000100000062000000B9
timeline_id | 1
prev_timeline_id | 1
full_page_writes | t
next_xid | 2:1959445310
next_oid | 24614
next_multixact_id | 1
next_multi_offset | 0
oldest_xid | 1809610092
oldest_xid_dbid | 16384
oldest_active_xid | 1959445310
oldest_multi_xid | 1
oldest_multi_dbid | 13431
oldest_commit_ts_xid | 0
newest_commit_ts_xid | 0
checkpoint_time | 2023-12-29 16:39:25+01
```
`pg_current_xact_id()` renvoie le numéro de transaction en cours, soit 10 549 379 902 (sur 64 bits). Le premier chiffre de la ligne `next_xid` indique qu’il y a déjà eu deux « époques », et le numéro de transaction sur 32 bits dans ce troisième cycle est 1 959 445 310. On vérifie que 10 549 379 902 = 1 959 445 310 + 2×2³².
Le nombre d’époques n’est enregistré ni dans les tables ni dans les lignes. Pour savoir quelles transactions sont visibles depuis la transaction en cours (ou exactement depuis le « _snapshot_ » de l’état de la base associé), PostgreSQL considère que les 2 milliards de numéros de transactions supérieurs à celle en cours correspondent à des transactions futures, et les 2 milliards de numéros inférieurs à des transactions dans le passé.
Si on se contentait de boucler, une fois dépassé le numéro de transaction 2³¹-1 (environ 2 milliards), de nombreux enregistrements deviendraient invisibles, car validés par des transactions à présent situées dans le futur. Il y a donc besoin d’un mécanisme supplémentaire.
#### 4.7.2 Le wraparound (2)
=|
Après 4 milliards de transactions:
**Figure p198-1.** Illustration extraite du PDF\, page 198\.
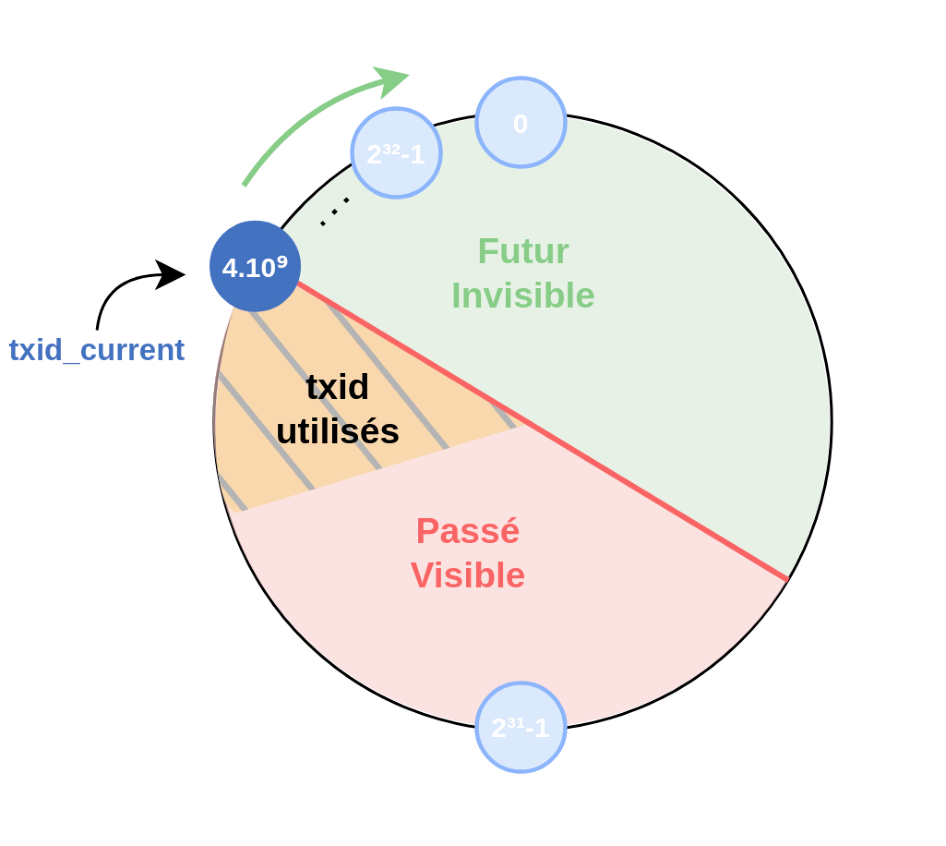
PostgreSQL se débrouille afin de ne jamais laisser dans les tables des numéros de transactions visibles situées dans ce qui serait le futur de la transaction actuelle.
En temps normal, les numéros de transaction visibles se situent tous dans des valeurs un peu inférieures à la transaction en cours. Les lignes plus vieilles sont « gelées », c’est-à-dire marquées comme assez anciennes pour qu’on ignore le numéro de transaction. (Cela implique bien sûr de réécrire la ligne sur le disque.) Il n’y a alors plus de risque de présence de numéros de transaction qui serait abusivement dans le futur de la transaction actuelle. Les numéros de transaction peuvent être réutilisés sans risque de mélange avec ceux issus du cycle précédent.
Ce cycle des numéros de transactions peut se poursuivre indéfiniment.
Ces recyclages sont visibles dans `pg_control_checkpoint()`, comme vu plus haut. La même fonction renvoie `oldest_xid`, qui est le numéro de la transaction (32 bits) la plus ancienne dans l’instance, qui est par définition celui de la base la plus vieille, ou plutôt de la ligne la plus vieille dans la base:
**Exemple p199-1.** Exemple extrait du PDF\, page 199\.
```sql
SELECT datname, datfrozenxid, age (datfrozenxid)
FROM pg_database ORDER BY 3 DESC ;
```
**Tableau p199-1.** Tableau extrait du PDF\, page 199\.
```console
datname | datfrozenxid | age
-----------+--------------+-----------
pgbench | 1809610092 | 149835222
template0 | 1957896953 | 1548361
template1 | 1959012415 | 432899
postgres | 1959445305 | 9
```
La ligne la plus ancienne dans la base **pgbench** a moins de 150 millions de transactions d’âge, il n’y a pas de confusion possible.
Un peu plus de 50 millions de transactions plus tard, la même requête renvoie:
**Tableau p199-2.** Tableau extrait du PDF\, page 199\.
```console
datname | datfrozenxid | age
-----------+--------------+-----------
pgbench | 1809610092 | 149835222
template0 | 1957896953 | 1548361
template1 | 1959012415 | 432899
postgres | 1959445305 | 9
La ligne la plus ancienne dans la base pgbench a moins de 150 millions de transactions d’âge, il n’y a
pas de confusion possible.
Un peu plus de 50 millions de transactions plus tard, la même requête renvoie :
datname | datfrozenxid | age
-----------+--------------+----------
template0 | 1957896953 | 52338522
template1 | 1959012415 | 51223060
postgres | 1959445305 | 50790170
pgbench | 1959625471 | 50610004
```
Les lignes les plus anciennes de `pgbench` semblent avoir disparu.
#### 4.7.3 Le wraparound (3)
#### Concrètement?
- Concrètement? - `VACUUM FREEZE`
- géré par l’autovacuum - au pire, d’office
- potentiellement beaucoup d’écritures
Concrètement, l’opération de « gel » des lignes qui possèdent des identifiants de transaction suffisamment anciens est appelée `VACUUM FREEZE`.
Ce dernier peut être déclenché manuellement, mais il fait aussi partie des tâches de maintenance habituellement gérées par le démon `autovacuum`, en bonne partie en même temps que les `VACUUM` habituels. Un `VACUUM FREEZE` n’est pas bloquant, mais les verrous sont parfois plus gênants que lors d’un `VACUUM` simple. Les écritures générées sont très variables, et parfois gênantes.
`VACUUM FREEZE` sur une table avec Si cela ne suffit pas, le moteur déclenche automatiquement un des lignes trop âgées, et ce, même si autovacuum est désactivé.
`autovacuum` deCes opérations suffisent dans l’immense majorité des cas. Dans le cas contraire, l’ vient de plus en plus agressif. Si le stock de transactions disponibles descend en-dessous de 40 millions, des messages d’avertissements apparaissent dans les traces.
Dans le pire des cas, après bien des messages d’avertissements, le moteur refuse toute nouvelle transaction dès que le stock de transactions disponibles se réduit à 3 millions (valeur codée en dur). Il faudra alors lancer un `VACUUM FREEZE` manuellement. Ceci ne peut arriver qu’exceptionnellement (par exemple si une transaction préparée a été oubliée depuis 2 milliards de transactions et qu’aucune supervision ne l’a détectée).
`VACUUM FREEZE` sera développé dans le module VACUUM et autovacuum[^5]. La documentation officielle[^6] contient aussi un paragraphe sur ce sujet.
[^5]: https://dali.bo/m5_html
[^6]: https://docs.postgresql.fr/current/maintenance.html
### 4.8 OPTIMISATIONS DE MVCC
- HOT
- Free Space Map - Visibility Map
Les fonctionnalités que nous allons décrire visent à mitiger les inconvénients du MVCC de PostgreSQL.
#### 4.8.1 Mise à jour jour HOT
HOT = _Heap-Only Tuples_
- Si place dans le bloc
- Si aucune colonne indexée modifiée
- Alors la mise à jour se fait dans le même bloc - gain en mise à jour des index - gain en écritures et en utilisation du cache
- Favorisée par un _fillfactor_ < 100
Le mécanisme des _Heap-Only Tuples_ (HOT) permet de stocker, sous condition, plusieurs versions du même enregistrement dans le même bloc, avec une forme de chaînage entre plusieurs versions d’une ligne dans le bloc. Ceci permet au fur et à mesure des mises à jour de supprimer automatiquement les anciennes versions, y compris le pointeur de ligne, sans attendre `VACUUM`. Cela permet surtout de ne pas toucher aux index, qui pointent donc toujours vers les mêmes tuples. Il y a donc un gain en écriture comme en utilisation du cache. Les conditions sont les suivantes:
- Aucune colonne indexée n’a été modifiée par l’opération: l’index n’a pas besoin d’être modifié et peut continuer à pointer vers le même bloc;
- Le bloc contient assez de place pour la nouvelle version (les enregistrements ne sont pas chaînés entre plusieurs blocs).
Afin que cette dernière condition ait plus de chance d’être vérifiée, il peut être utile de baisser la valeur du paramètre `fillfactor` pour une table donnée (cf documentation officielle[^7]). Par défaut, le `fillfactor` vaut 100% pour économiser la place. Sacrifier un peu d’espace en le baissant peut être rentable car le mécanisme HOT peut réduire la fragmentation.
Le nombre de mises à jour HOT sur une table peut être suivi en comparant les champs `n_tup_hot_upd` (décompte des mises à jour HOT)et `n_tup_upd` (toutes les mises à jour)dans la vue pg_stat_user_tables[^8].
[^7]: https://docs.postgresql.fr/current/sql-createtable.html#SQL-CREATETABLE-STORAGE-PARAMETERS
[^8]: https://docs.postgresql.fr/current/monitoring-stats.html#MONITORING-PG-STAT-ALL-TABLES-VIEW
Documentation officielle: Heap-Only Tuples (HOT)[^9]
#### 4.8.2 Free Space Map
- Fichier pointant les espaces libres des blocs
- Optimisation des insertions
Chaque table possède une _Free Space Map_ avec, pour chaque bloc, un entier entre 0 et 255 (un octet) qui représente sa proportion d’espace libre. Elle est organisée en arbre. PostgreSQL l’utilise pour savoir où insérer de nouvelles lignes ou versions de lignes. Elle est stockée dans les fichiers `*_fsm` associés à chaque table.
Documentation officielle: Carte des espaces libres[^10]
#### 4.8.3 Visibility Map
- Quels blocs sont intégralement visibles?
- Mise à jour par `VACUUM`
- Utilisation:
- Accélérer `VACUUM` et `VACUUM FREEZE`
- _Index Only Scan_
La _Visibility Map_ permet de savoir si tous les enregistrements d’un bloc sont visibles de toutes les sessions en cours. C’est le cas si toutes les transactions de modifications sont terminées, et si les lignes mortes ont été nettoyées. Il n’y a donc plus besoin de consulter les numéros de transaction et la CLOG pour toutes les lignes du bloc. En cas de doute, ou d’enregistrement non visible, le bloc n’est pas marqué comme totalement visible.
Cela accélère grandement le `VACUUM`: sa phase 1 ne parcourt pas toute la table, mais uniquement les enregistrements pour lesquels la _Visibility Map_ est à _faux_, car des données sont potentiellement obsolètes dans le bloc. Les blocs intégralement visibles peuvent être ignorés. Après nettoyage d’un bloc, `VACUUM` positionne sa réference dans la _Visibility Map_ à _vrai_, si toutes les lignes sont bien visibles pour toutes les sessions.
À l’inverse, un _Index Only Scan_ (parcours d’index seuls) utilise cette _Visibility Map_ pour savoir si les données de l’index suffisent ou s’il faut aller vérifier la visibilité de la ligne dans la table. Dans ce dernier cas, le plan indique des _Heap Fetches_, qui dégradent les performances. Un `VACUUM` fréquent améliore
[^9]: https://docs.postgresql.fr/current/storage-hot.html
[^10]: https://docs.postgresql.fr/current/storage-fsm.html
donc les performances si des _Index Only Scans_ sont utilisés. (Les _Index Scans_ ou _Bitmap Scans_ ne sont pas concernés.)
La même _Visibility Map_ sert aussi à noter les bloc entièrement « gelés » pour accélérer les `VACUUM FREEZE`, là encore pour ne pas avoir à les relire.
Documentation officielle: Carte de visibilité[^11]
[^11]: https://docs.postgresql.fr/current/storage-vm.html#STORAGE-VM
### 4.9 VERROUS
#### 4.9.1 Verrouillage et MVCC
La gestion des verrous est liée à l’implémentation de MVCC - Verrouillage d’objets en mémoire - Verrouillage d’objets sur disque - Paramètres
#### 4.9.2 Le gestionnaire de verrous
PostgreSQL possède un gestionnaire de verrous - Verrous d’objet - Niveaux de verrouillage - Empilement des verrous - _Deadlock_ - Vue `pg_locks`
Le gestionnaire de verrous de PostgreSQL est capable de gérer des verrous sur des tables, sur des enregistrements, sur des ressources virtuelles. De nombreux types de verrous sont disponibles, chacun entrant en conflit avec d’autres.
Chaque opération doit tout d’abord prendre un verrou sur les objets à manipuler. Si le verrou ne peut être obtenu immédiatement, par défaut PostgreSQL attendra indéfiniment qu’il soit libéré.
Ce verrou en attente peut lui-même imposer une attente à d’autres sessions qui s’intéresseront au même objet. Si ce verrou en attente est bloquant (cas extrême: un `VACUUM FULL` sans `SKIP_LOCKED` lui-même bloqué par une session qui tarde à faire un `COMMIT`), il est possible d’assister à un phénomène d’empilement de verrous en attente.
Les noms des verrous peuvent prêter à confusion: `ROW SHARE` par exemple est un verrou de table, pas un verrou d’enregistrement. Il signifie qu’on a pris un verrou sur une table pour y faire des `SELECT FOR UPDATE` par exemple. Ce verrou est en conflit avec les verrous pris pour un `DROP TABLE`, ou pour un `LOCK TABLE`.
Le gestionnaire de verrous détecte tout verrou mortel (_deadlock_) entre deux sessions. Un _deadlock_ est la suite de prise de verrous entraînant le blocage mutuel d’au moins deux sessions, chacune étant en attente d’un des verrous acquis par l’autre.
Il est possible d’accéder aux verrous actuellement utilisés sur une instance par la vue `pg_locks`.
#### 4.9.3 Verrous sur enregistrement
- Le gestionnaire de verrous possèdes des verrous sur enregistrements
- transitoires
- le temps de poser le `xmax`
- Utilisation de verrous sur disque
- pas de risque de pénurie
- Les verrous entre transaction se font sur leurs ID
Le gestionnaire de verrous fournit des verrous sur enregistrement. Ceux-ci sont utilisés pour verrouiller un enregistrement le temps d’y écrire un `xmax`, puis libérés immédiatement.
Le verrouillage réel est implémenté comme suit:
- D’abord, chaque transaction verrouille son objet « identifiant de transaction » de façon exclusive.
- Une transaction voulant mettre à jour un enregistrement consulte le `xmax`. Si ce `xmax` est celui d’une transaction en cours, elle demande un verrou exclusif sur l’objet « identifiant de transaction » de cette transaction, qui ne lui est naturellement pas accordé. La transaction est donc placée en attente.
- Enfin, quand l’autre transaction possédant le verrou se termine (`COMMIT` ou `ROLLBACK`), son verrou sur l’objet « identifiant de transaction » est libéré, débloquant ainsi l’autre transaction, qui peut reprendre son travail.
Ce mécanisme ne nécessite pas un nombre de verrous mémoire proportionnel au nombre d’enregistrements à verrouiller, et simplifie le travail du gestionnaire de verrous, celui-ci ayant un nombre bien plus faible de verrous à gérer.
Le mécanisme exposé ici est évidemment simplifié.
#### 4.9.4 La vue pg_locks
- `pg_locks`:
- visualisation des verrous en place - tous types de verrous sur objets
- Complexe à interpréter:
- verrous sur enregistrements pas directement visibles
C’est une vue globale à l’instance.
**Exemple p205-1.** Exemple extrait du PDF\, page 205\.
```text
# \d pg_locks
```
**Tableau p206-1.** Tableau extrait du PDF\, page 206\.
```text
Vue « pg_catalog.pg_locks »
Colonne | Type | Collationnement | NULL-able | …
--------------------+--------------------------+-----------------+-----------+-
locktype | text | | |
database | oid | | |
relation | oid | | |
page | integer | | |
tuple | smallint | | |
virtualxid | text | | |
transactionid | xid | | |
classid | oid | | |
objid | oid | | |
objsubid | smallint | | |
virtualtransaction | text | | |
pid | integer | | |
mode | text | | |
granted | boolean | | |
fastpath | boolean | | |
waitstart | timestamp with time zone | | |
```
- `locktype` est le type de verrou, les plus fréquents étant `relation` (table ou index), `transactionid` (transaction), `virtualxid` (transaction virtuelle, utilisée tant qu’une
- transaction n’a pas eu à modifier de données, donc à stocker des identifiants de transaction dans des enregistrements);
- `database` est la base dans laquelle ce verrou est pris;
- `relation` est l’OID de la relation cible si locktype vaut `relation` (ou `page` ou `tuple`);
- `page` est le numéro de la page dans une relation (pour un verrou de type `page` ou `tuple`)
- cible;
- `tuple` est le numéro de l’enregistrement cible (quand verrou de type `tuple`);
- `virtualxid` est le numéro de la transaction virtuelle cible (quand verrou de type `virtualxid`);
- `transactionid` est le numéro de la transaction cible;
- `classid` est le numéro d’OID de la classe de l’objet verrouillé (autre que relation) dans `pg_class`. Indique le catalogue système, donc le type d’objet, concerné. Aussi utilisé pour
- les advisory locks;
- `objid` est l’OID de l’objet dans le catalogue système pointé par `classid`;
- `objsubid` correspond à l’ID de la colonne de l’objet `objid` concerné par le verrou;
- `virtualtransaction` est le numéro de transaction virtuelle possédant le verrou (ou tentant
- de l’acquérir si `granted` vaut `f`);
- `pid` est le PID (l’identifiant de processus système) de la session possédant le verrou;
- `mode` est le niveau de verrouillage demandé;
- `granted` signifie si le verrou est acquis ou non (donc en attente);
- `fastpath` correspond à une information utilisée surtout pour le débogage (_fastpath_ est le mécanisme d’acquisition des verrous les plus faibles);
- `waitstart` indique depuis quand le verrou est en attente.
La plupart des verrous sont de type relation, `transactionid` ou `virtualxid`. Une transaction qui démarre prend un verrou virtualxid sur son propre `virtualxid`. Elle acquiert des verrous faibles (`ACCESS SHARE`) sur tous les objets sur lesquels elle fait des `SELECT`, afin de garantir que leur structure n’est pas modifiée sur la durée de la transaction. Dès qu’une modification doit être faite, la transaction acquiert un verrou exclusif sur le numéro de transaction qui vient de lui être affecté. Tout objet modifié (table) sera verrouillé avec `ROW EXCLUSIVE`, afin d’éviter les `CREATE INDEX` non concurrents, et empêcher aussi les verrouillages manuels de la table en entier (`SHARE ROW EXCLUSIVE`).
#### 4.9.5 Verrous - Paramètres
- Nombre:
- `max_locks_per_transaction` (+ paramètres pour la sérialisation) - Durée:
- `lock_timeout` (éviter l’empilement des verrous) - `deadlock_timeout` (défaut 1 s) - Trace:
- `log_lock_waits` (1s)
- `log_lock_failures` (’SELECT …FOR UPDATE NOWAIT‘)
#### Nombre de verrous:
`max_locks_per_transaction` sert à dimensionner un espace en mémoire partagée destinée aux verrous sur des objets (notamment les tables). Le nombre de verrous est:
**Exemple p207-1.** Exemple extrait du PDF\, page 207\.
```text
max_locks_per_transaction × max_connections
```
Si les transactions préparées (liées aux transactions en deux phases[^12]) sont activées, en montant `max_prepared_transactions` au-delà de 0, le nombre de verrous devient:
**Exemple p207-2.** Exemple extrait du PDF\, page 207\.
```text
max_locks_per_transaction × (max_connections + max_prepared_transactions)
```
La valeur par défaut de 64 est largement suffisante la plupart du temps. Il peut arriver qu’il faille le monter, par exemple si l’on utilise énormément de partitions, mais le message d’erreur est explicite.
Le nombre maximum de verrous d’une session n’est pas limité à `max_locks_per_transaction`. C’est une valeur moyenne. Une session peut acquérir autant de verrous qu’elle le souhaite pourvu qu’au total la table de hachage interne soit assez grande. Les verrous de lignes sont stockés sur les lignes et donc potentiellement en nombre infini.
Pour la sérialisation, les verrous de prédicat possèdent des paramètres spécifiques. Pour économiser la mémoire, les verrous peuvent être regroupés par bloc ou relation (voir `pg_locks` pour le niveau de verrouillage). Les paramètres respectifs sont:
- `max_pred_locks_per_transaction` (64 par défaut);
[^12]: https://docs.postgresql.fr/current/two-phase.html
- `max_pred_locks_per_page` (par défaut 2, donc 2 lignes verrouillées entraînent le verrouillage
- de tout le bloc, du moins pour la sérialisation);
- `max_pred_locks_per_relation` (voir la documentation[^13] pour les détails).
#### Durées maximales de verrou:
Si une session attend un verrou depuis plus longtemps que `lock_timeout`, la requête est annulée. Il est courant de poser cela avant un ordre assez intrusif, même bref, sur une base utilisée. Par exemple, il faut éviter qu’un `VACUUM FULL`, s’il est bloqué par une transaction un peu longue, ne bloque luimême toutes les transactions suivantes (phénomène d’empilement des verrous):
**Exemple p208-1.** Exemple extrait du PDF\, page 208\.
```console
postgres=# SET lock_timeout TO '3s' ;
SET
postgres=# VACUUM FULL t_grosse_table ;
ERROR: canceling statement due to lock timeout
```
Il faudra bien sûr retenter le `VACUUM FULL` plus tard, mais la production n’est pas bloquée plus de 3 secondes.
PostgreSQL recherche périodiquement les _deadlocks_ entre transactions en cours. La périodicité par défaut est de 1 s (paramètre `deadlock_timeout`), ce qui est largement suffisant la plupart du temps: les _deadlocks_ sont assez rares, alors que la vérification est quelque chose de coûteux. L’une des transactions est alors arrêtée et annulée, pour que les autres puissent continuer:
**Exemple p208-2.** Exemple extrait du PDF\, page 208\.
```console
postgres=*# DELETE FROM t_centmille_int WHERE i < 50000;
```
**Exemple p208-3.** Exemple extrait du PDF\, page 208\.
```text
ERROR: deadlock detected
DÉTAIL : Process 453259 waits for ShareLock on transaction 3010357;
blocked by process 453125.
Process 453125 waits for ShareLock on transaction 3010360;
blocked by process 453259.
ASTUCE : See server log for query details.
CONTEXTE : while deleting tuple (0,1) in relation "t_centmille_int"
```
#### Trace des verrous:
pour tracer les attentes de verrous un peu longue, il est fortement conseillé de passer `log_lock_waits` à `on` (le défaut est `off`).
Le seuil est également défini par `deadlock_timeout` (1 s par défaut) Ainsi, une session toujours en attente de verrou au-delà de cette durée apparaîtra dans les traces:
**Exemple p208-4.** Exemple extrait du PDF\, page 208\.
```text
LOG: process 457051 still waiting for ShareLock on transaction 35373775
after 1000.121 ms
DETAIL: Process holding the lock: 457061. Wait queue: 457051.
CONTEXT: while deleting tuple (221,55) in relation "t_centmille_int"
STATEMENT: DELETE FROM t_centmille_int ;
```
Ce n’est qu’une information. S’il ne s’agit pas d’un _deadlock_, la transaction continuera, et le moment où elle obtiendra son verrou sera également tracé:
[^13]: https://docs.postgresql.fr/current/runtime-config-locks.html#GUC-MAX-PRED-LOCKS-PER-RELATION
**Exemple p209-1.** Exemple extrait du PDF\, page 209\.
```text
LOG: process 457051 acquired ShareLock on transaction 35373775 after
18131.402 ms
CONTEXT: while deleting tuple (221,55) in relation "t_centmille_int"
STATEMENT: DELETE FROM t_centmille_int ;
LOG: duration: 18203.059 ms statement: DELETE FROM t_centmille_int
```
**Exemple p209-2.** Exemple extrait du PDF\, page 209\.
```text
STATEMENT: DELETE FROM t_centmille_int ;
```
Pour tracer les échecs d’obtention de verrous par un `SELECT … FOR UPDATE NOWAIT`, il faut configurer à `on` le paramètre `log_lock_failures` (à partir de PostgreSQL 18).
### 4.10 DURÉES DE SESSIONS, TRANSACTIONS & ORDRES
#### 4.10.1 Quelle durée pour les sessions & transactions?
Divers seuils possibles, jamais globalement.
Divers seuils possibles, jamais globalement. **`SET`** `…_timeout` **`TO`** `'5s';` **`ALTER ROLE`** `…` **`IN DATABASE`** `…` **`SET`** `..._timeout` **`TO`** `'…s'`
**Tableau p210-1.** Tableau extrait du PDF\, page 210\.
|Paramètre|Cible du seuil|
|---|---|
|`lock_timeout`|Attente de verrou|
|`statement_timeout`|Ordre en cours|
|`idle_session_timeout`|Session inactive|
|`idle_in_transaction_session_timeout`|Transaction en cours, inactive|
|`transaction_timeout` (v17)|Transaction en cours|
PostgreSQL possède divers seuils pour éviter des ordres, transactions ou sessions trop longues. Le dépassement d’un seuil provoque la fin et l’annulation de l’ordre, transaction ou session. Par défaut, aucun n’est activé.
Ne définissez jamais des paramètres globalement, les ordres de maintenance ou les batchs de nuit seraient aussi concernés, tout comme les superutilisateurs. Utilisez un ordre `SET` dans la session, ou `ALTER ROLE … IN DATABASE … SET …`.
Il est important que l’application sache gérer l’arrêt de connexion ou l’annulation d’un ordre ou d’une transaction et réagir en conséquence (nouvelle tentative, abandon avec erreur…). Dans le cas contraire, l’application pourrait rester déconnectée, et suivant les cas des données pourraient être perdues.
`lock_timeout` permet d’interrompre une requête qui mettrait trop de temps à acquérir son verrou. Il faut l’activer par précaution avant une opération lourde (un `VACUUM FULL` notamment) pour éviter un « empilement des verrous ». En effet, si l’ordre ne peut pas s’exécuter immédiatement, il bloque toutes les autres requêtes sur la table.
`statement_timeout` est la durée maximale d’un ordre. Défini au niveau d’un utilisateur ou d’une session, cet ordre permet d’éviter que des requêtes aberrantes chargent la base pendant des heures
ou des jours; ou encore que des requêtes « s’empilent » sur une base totalement saturée ou avec trop de contention. Autre exemple: les utilisateurs de supervision et autres utilisateurs non critiques.
À noter: l’extrait suivant d’une sauvegarde par `pg_dump` montre que l’outil inhibe ces paramètres par précaution, afin que la restauration n’échoue pas.
**Exemple p211-1.** Exemple extrait du PDF\, page 211\.
```text
-- Dumped from database version 17.2 (Debian 17.2-1.pgdg120+1)
```
**Exemple p211-2.** Exemple extrait du PDF\, page 211\.
```text
-- Dumped by pg_dump version 17.2 (Debian 17.2-1.pgdg120+1)
```
**Exemple p211-3.** Exemple extrait du PDF\, page 211\.
```text
SETstatement_timeout=0;
SETlock_timeout=0;
SETidle_in_transaction_session_timeout=0;
SETtransaction_timeout=0;
…
```
L’idée peut être reprise pour des scripts batchs, par exemple.
#### 4.10.2 Quelle durée pour une session?
- Courte
- coût & temps des connexions
- pooler?
- Longue
- risque de saturation du nombre de connexions
- (rare) gaspillage mémoire par les backends
Il est généralement conseillé d’utiliser des sessions assez longues, car la création d’une connexion à PostgreSQL est une opération lourde. Si l’applicatif ne cesse de se connecter/déconnecter, il faudra penser à un pooler (pgBouncer, ou côté applicatif).
Des sessions très longues et inactives ne sont en général pas un souci. Un pooler garde justement ses sessions longtemps. Mais si les sessions ne se ferment jamais, le nombre maximal de sessions (`max_connections`) peut être atteint, et de nouvelles connexions refusées.
De plus, pour les performances, il n’est pas très bon qu’il y ait des milliers de sessions ouvertes, malgré les progrès des versions récentes de PostgreSQL. Enfin, si la consommation mémoire du _backend_ associé à une session est raisonnable, il arrive, exceptionnellement, qu’il se mette à occuper durablement de la mémoire (par exemple en cas d’accès à des milliers de tables et index durant son existence).
la durée maximale des sessions peut être réglée par `idle_session_timeout`, ou au niveau du pooler s’il y en a un.
#### 4.10.3 Quelle durée pour une transaction?
- Courte - synchronisation fréquente coûteuse
- Longue - verrous bloquants
Les transactions ouvertes et figées durablement sans faire de `COMMIT` ou `ROLLBACK` sont un problème sérieux, car l’autovacuum ne pourra pas nettoyer de ligne que cette session pourrait encore voir. Si l’applicatif ne peut être corrigé, ou si des utilisateurs ouvrent un outil quelconque sans le refermer, une solution est de définir `idle_in_transaction_session_timeout`, par exemple à une ou plusieurs heures.
Pour les performances, il faut éviter les sessions trop courtes car le coût de la synchronisation sur disque des journaux lors d’un `COMMIT` est coûteux (sauf table _unlogged_ ou `synchronous_commit`). Typiquement, un traitement de batch ou de chargement regroupera de nombreuses opérations en une seule transaction.
D’un autre côté, chaque transaction maintient ses verrous jusqu’à sa fin, et peut donc bloquer d’autres transactions et ralentir toute l’application. En utilisation transactionnelle, il vaut donc mieux que les transactions soient courtes et n’en fassent pas plus que ce qui est dicté par le besoin fonctionnel, et si possible le plus tard possible dans la transaction.
`transaction_timeout` (à partir de PostgreSQL 17) peut alors servir comme sécurité en cas de problème. À noter que cette limite ne concerne pas les transactions préparées, liées au transactions en deux phases[^14], et dont la longueur est parfois un souci.
[^14]: https://docs.postgresql.fr/current/two-phase.html
### 4.11 TOAST
#### 4.11.1 Mécanisme TOAST
TOAST: _The Oversized-Attribute Storage Technique_ Que faire si une ligne dépasse d’un bloc?
- Compresser
- Déporter dans une table
- Ou les deux
- Inutile de le faire dans l’applicatif
- Politique par champ
- `PLAIN` / `MAIN` / `EXTERNAL` / `EXTENDED`
#### Principe:
Une ligne ne peut déborder d’un bloc, et un bloc fait 8 ko par défaut. Cela ne suffit pas pour certains champs qui peuvent être beaucoup plus longs, comme certains textes, mais aussi des types composés (`json`, `jsonb`, `hstore`), ou binaires (`bytea`), et même `numeric`.
Le mécanisme TOAST consiste en deux mécanismes. Le premier compresse le contenu des champs, mais ça ne suffit pas forcément. Le second consiste à découper les champs trop longs et à déporter les morceaux dans une autre table associée à la table principale, table gérée de manière transparente pour l’utilisateur. La combinaison des deux mécanismes est possible. Ces deux mécanismes permettent au final d’éviter qu’un enregistrement ne dépasse la taille d’un bloc.
#### Politiques de stockage:
Chaque champ possède une propriété de stockage:
**Exemple p213-1.** Exemple extrait du PDF\, page 213\.
```sql
CREATE TABLE demotoast (i int, t text, png bytea, j jsonb);
```
**Exemple p213-2.** Exemple extrait du PDF\, page 213\.
```text
# \d+ unetable
```
**Exemple p213-3.** Exemple extrait du PDF\, page 213\.
```text
Table«public.demotoast»
Colonne|Type|Col…|NULL-able|Pardéfaut|Stockage|…
---------+---------+--------+-----------+------------+----------+--
i|integer||||plain|
t|text||||extended|
png|bytea||||extended|
j|jsonb||||extended|
Méthoded’accès:heap
```
Les différentes politiques de stockage sont:
- `PLAIN`: stockage uniquement dans la table, sans compression (champs numériques ou dates
- notamment);
- `MAIN`: stockage dans la table autant que possible, éventuellement compressé (politique rarement utilisée);
- `EXTERNAL`: stockage au besoin dans la table TOAST, sans chercher à compresser;
- `EXTENDED`: stockage au besoin dans la table TOAST, éventuellement compressé (cas général
- des champs texte ou binaire).
Il est rare d’avoir à modifier ce paramétrage, mais cela arrive. Par exemple, certains longs champs (souvent binaires, par exemple du JPEG, des PNG, des PDF…) sont déjà compressés et il ne vaut pas la peine de gaspiller du CPU dans cette tâche. Dans le cas extrême où le champ compressé est plus grand que l’original, PostgreSQL revient à la valeur originale, mais du CPU a été consommé inutilement. Il peut alors être intéressant de passer de `EXTENDED` à `EXTERNAL`, pour un gain de temps parfois non négligeable:
**Exemple p214-1.** Exemple extrait du PDF\, page 214\.
```sql
ALTER TABLE demotoast ALTER COLUMN png SET STORAGE EXTERNAL ;
```
Lors d’un changement de mode de stockage, les données existantes ne sont pas modifiées. Il faut modifier les champs d’une manière ou d’une autre pour forcer le changement.
**Performances**:
Le découpage et la compression restent des opérations coûteuses. Il reste déconseillé de stocker des données binaires de grande taille dans une base de données! De plus, cela surcharge les journaux de transaction et les sauvegardes.
Il faut rappeler qu’accéder aux champs « toastés » sans en avoir besoin est une mauvaise pratique:
**Exemple p214-2.** Exemple extrait du PDF\, page 214\.
```sql
INSERT INTO demotoast
```
**Exemple p214-3.** Exemple extrait du PDF\, page 214\.
```sql
SELECT i, rpad('0',100000,'0') AS t,
pg_read_binary_file ('/tmp/slonik.png'),
(SELECT jsonb_agg(to_json(rq)) FROM (SELECT * FROM pg_stat_all_tables) AS rq)
FROM generate_series (1,1000) i;
```
**Exemple p214-4.** Exemple extrait du PDF\, page 214\.
```sql
EXPLAIN (ANALYZE,VERBOSE,BUFFERS,SERIALIZE) SELECT i FROM demotoast ;
```
```text
QUERY PLAN
----------------------------------------------------------------------
Seq Scan on public.demotoast (cost=0.00..177.00 rows=1000 width=4) (actual
time=0.008..0.178 rows=1000 loops=1)
Output: i
Buffers: shared hit=167
Query Identifier: -2257406617252911738
Planning Time: 0.029 ms
Serialization: time=0.073 ms output=9kB format=text
Execution Time: 0.321 ms
```
**Exemple p214-5.** Exemple extrait du PDF\, page 214\.
```sql
EXPLAIN (ANALYZE,VERBOSE,BUFFERS,SERIALIZE) SELECT * FROM demotoast ;
```
```text
QUERY PLAN
----------------------------------------------------------------------
Seq Scan on public.demotoast (cost=0.00..177.00 rows=1000 width=1196) (actual
time=0.012..0.182 rows=1000 loops=1)
Output: i, t, png, j
Buffers: shared hit=167
Query Identifier: 698565989149231362
Planning Time: 0.055 ms
Serialization: time=397.480 ms output=307084kB format=text
Buffers: shared hit=14500
Execution Time: 397.776 ms
```
`SELECT *` L’effet du est ici désastreux, avec 14 500 blocs lus supplémentaires. (Noter que l’effet n’est visible dans `EXPLAIN (ANALYZE)` qu’avec l’option `SERIALIZE`, qui n’est disponible qu’à partir de PostgreSQL 17. Sans cette option, `EXPLAIN(ANALYZE)` affiche un résultat trompeur par rapport aux requêtes réelles!)
#### 4.11.2 TOAST & table de débordement
- Table de débordement `pg_toast_XXX`
- masquée, transparente
- Jusqu’à 1 Go par champ (déconseillé)
- texte, JSON, binaire…
- compression optionnelle
- Une raison de plus d’éviter les `SELECT *`
#### Principe des tables de débordement:
Le débordement dans des tables séparées de la table principale a d’autres intérêts:
- la partie principale d’une table ayant des champs très longs est moins grosse, alors que les « gros champs » ont moins de chance d’être accédés systématiquement par le code applicatif;
- ces champs peuvent aussi être compressés de façon transparente, avec souvent de gros gains en place;
- si un `UPDATE` ne modifie pas un de ces champs « toastés », la table TOAST n’est pas mise à jour: le pointeur vers l’enregistrement de cette table est juste « cloné » dans la nouvelle version de l’enregistrement.
#### Les tables pg_toast_XXX:
À chaque table utilisateur se voit associée une table TOAST, et ce dès sa création si la table possède un champ « toastable ». Les enregistrements y sont stockés en morceaux (_chunks_) d’un peu moins de 2 ko. Tous les champs « toastés » d’une table se retrouvent dans la même table `pg_toast_XXX`, dans un espace de nommage séparé nommé `pg_toast`.
Pour l’utilisateur, les tables TOAST sont totalement transparentes. Un développeur doit juste savoir qu’il n’a pas besoin de déporter des champs texte (ou JSON, ou binaires…) imposants dans une table séparée pour des raisons de volumétrie de la table principale: PostgreSQL le fait déjà, et de manière efficace! Il est donc souvent inutile de se donner la peine de compresser les données au niveau applicatif juste pour réduire le stockage.
La présence de ces tables n’apparaît guère que dans `pg_class`, par exemple ainsi:
**Exemple p215-1.** Exemple extrait du PDF\, page 215\.
```sql
SELECT * FROM pg_class c
WHERE c.relname = 'demotoast'
OR c.oid = (SELECT reltoastrelid FROM pg_class
WHERE relname = 'demotoast');
```
**Tableau p216-1.** Tableau extrait du PDF\, page 216\.
```text
-[ RECORD 1 ]-------+-----------------
oid | 1315757
relname | pg_toast_1315754
relnamespace | 99
reltype | 0
reloftype | 0
relowner | 10
relam | 2
relfilenode | 1315757
reltablespace | 0
relpages | 9500
reltuples | 38000
relallvisible | 9500
reltoastrelid | 0
relhasindex | t
…
-[ RECORD 2 ]-------+-----------------
oid | 1315754
relname | demotoast
relnamespace | 2200
reltype | 1315756
reloftype | 0
relowner | 10
relam | 2
relfilenode | 1315754
reltablespace | 0
relpages | 167
reltuples | 1000
relallvisible | 0
reltoastrelid | 1315757
relhasindex | f
```
La partie TOAST est une table à part entière, avec une clé primaire. On ne peut ni ne doit y toucher!
**Exemple p216-1.** Exemple extrait du PDF\, page 216\.
```text
\d+ pg_toast.pg_toast_1315754
```
**Exemple p216-2.** Exemple extrait du PDF\, page 216\.
```sql
Table TOAST « pg_toast.pg_toast_1315754 »
```
**Tableau p216-2.** Tableau extrait du PDF\, page 216\.
```text
Colonne | Type | Stockage
------------+---------+----------
chunk_id | oid | plain
chunk_seq | integer | plain
chunk_data | bytea | plain
Table propriétaire : « public.demotoast »
Index :
"pg_toast_1315754_index" PRIMARY KEY, btree (chunk_id, chunk_seq)
Méthode d'accès : heap
```
**Exemple p216-3.** Exemple extrait du PDF\, page 216\.
```text
"pg_toast_1315754_index" PRIMARY KEY, btree (chunk_id, chunk_seq)
Méthode d'accès : heap
```
L’index de la table TOAST est toujours utilisé pour accéder aux _chunks_.
La volumétrie des différents éléments (partie principale, TOAST, index éventuels) peut se calculer grâce à cette requête dérivée du wiki[^15]:
```sql
SELECT
```
**Exemple p216-4.** Exemple extrait du PDF\, page 216\.
```text
oid AS table_oid,
```
[^15]: https://wiki.postgresql.org/wiki/Disk_Usage
**Exemple p217-1.** Exemple extrait du PDF\, page 217\.
```text
c.relnamespace::regnamespace || '.' || relname AS TABLE,
reltoastrelid,
reltoastrelid::regclass::text AS table_toast,
reltuples AS nb_lignes_estimees,
pg_size_pretty(pg_table_size(c.oid)) AS " Table (dont TOAST)",
pg_size_pretty(pg_relation_size(c.oid)) AS " Heap",
pg_size_pretty(pg_relation_size(reltoastrelid)) AS " Toast",
pg_size_pretty(pg_indexes_size(reltoastrelid)) AS " Toast (PK)",
pg_size_pretty(pg_indexes_size(c.oid)) AS " Index",
pg_size_pretty(pg_total_relation_size(c.oid)) AS "Total"
FROM pg_class c
WHERE relkind = 'r'
AND relname = 'demotoast'
\gx
```
**Exemple p217-2.** Exemple extrait du PDF\, page 217\.
```text
-[ RECORD 1 ]-------+--------------------------
table_oid | 1315754
table | public.demotoast
reltoastrelid | 1315757
table_toast | pg_toast.pg_toast_1315754
nb_lignes_estimees | 1000
Table (dont TOAST) | 76 MB
Heap | 1336 kB
Toast | 74 MB
Toast (PK) | 816 kB
Index | 0 bytes
Total | 76 MB
```
On constate que la plus grande partie de la volumétrie de la table est en fait dans la partie TOAST.
La taille des éventuels index sur les champs susceptibles d’être toastés est comptabilisée avec tous les index de la table (la clé primaire de la table TOAST est à part).
#### Détails du mécanisme TOAST:
Les détails techniques du mécanisme TOAST sont dans la documentation officielle[^16]. En résumé, le mécanisme TOAST est déclenché sur un enregistrement quand la taille d’un enregistrement dépasse 2 ko. Les champs « toastables » peuvent alors être compressés pour que la taille de l’enregistrement redescende en-dessous de 2 ko. Si cela ne suffit pas, des champs sont alors découpés et déportés vers la table TOAST. Dans ces champs de la table principale, l’enregistrement ne contient plus qu’un pointeur vers la table TOAST associée.
Un champ MAIN peut tout de même être stocké dans la table TOAST, si l’enregistrement, même compressé, dépasse 2 ko: mieux vaut « toaster » que d’empêcher l’insertion.
Cette valeur de 2 ko convient généralement. Au besoin, on peut l’augmenter en utilisant le paramètre de stockage `toast_tuple_target` ainsi:
**Exemple p217-3.** Exemple extrait du PDF\, page 217\.
```sql
ALTER TABLE demotoast SET (toast_tuple_target = 3000);
```
mais cela est rarement utile.
Le mécanisme peut différer entre deux lignes pour un même champ, en fonction de la taille réelle de celui-ci sur la ligne.
[^16]: https://doc.postgresql.fr/current/storage-toast.html
Il est possible d’avoir le détail champ par champ:
**Exemple p218-1.** Exemple extrait du PDF\, page 218\.
```text
SELECT i,
pg_column_compression (png) AS png_c,
pg_column_toast_chunk_id (png) AS ck_png,
pg_column_size(png) AS png_size,
pg_column_compression (j) AS j_c,
pg_column_toast_chunk_id (j) AS ck_j,
pg_column_size (j) AS j_size
FROM demotoast
LIMIT 3 ;
```
**Exemple p218-2.** Exemple extrait du PDF\, page 218\.
```text
i | png_c | ck_png | png_size | j_c | ck_j | j_size
---+-------+---------+----------+------+---------+--------
1 | | 1315760 | 58635 | pglz | 1315759 | 14418
2 | | 1315762 | 58635 | pglz | 1315761 | 14418
3 | | 1315764 | 58635 | pglz | 1315763 | 14418
```
(La fonction `pg_column_compression()` existe depuis PostgreSQL 14 et indique l’algorithme de compression éventuel (voir plus bas), et `pg_column_toast_chunk_id()` depuis PostgreSQL 17.)
On constate que le champ `png` n’est pas compressé (puisqu’on l’a défini comme `EXTERNAL`), et que le champ de `j` de type `jsonb` est compressé avec l’algorithme indiqué. Chaque champ de chaque ligne a son `chunk_id` propre qui permet de compter le nombre de _chunks_
**Exemple p218-3.** Exemple extrait du PDF\, page 218\.
```sql
SELECT chunk_id, count(*)
FROM pg_toast.pg_toast_1315754
WHERE chunk_id IN ( 1315760, 1315759 )
GROUP BY 1;
```
**Exemple p218-4.** Exemple extrait du PDF\, page 218\.
```text
chunk_id | count
----------+-------
1315759 | 8
1315760 | 30
```
En multipliant par 2 ko, on retrouve à peu près les tailles sur disque (compressées ou pas) renvoyées par `pg_column_size()`.
#### Administration des tables TOAST:
Les tables TOAST restent forcément dans le même tablespace que la table principale. Leur maintenance (notamment le nettoyage par `autovacuum`) s’effectue en même temps que la table principale, comme le montre un `VACUUM (VERBOSE)`. Une variante de l’ordre permet d’ailleurs de passer outre le nettoyage d’une table TOAST pour accélérer un nettoyage urgent (depuis PostgreSQL 14):
**Exemple p218-5.** Exemple extrait du PDF\, page 218\.
```sql
VACUUM (VERBOSE, PROCESS_TOAST off) longs_textes ;
```
#### 4.11.3 TOAST & compression
- `pglz` (`zlib`): défaut
- `lz4`: à préférer - généralement plus rapide - compression équivalente (à vérifier) - Mise en place:
**Exemple p219-1.** Exemple extrait du PDF\, page 219\.
```ini
default_toast_compression = lz4
```
ou:
**Exemple p219-2.** Exemple extrait du PDF\, page 219\.
```sql
ALTER TABLE t1 ALTER COLUMN c2 SET COMPRESSION lz4 ;
```
Il est possible de modifier l’algorithme de compression. Ceci est défini par le nouveau paramètre `default_toast_compression` dont la valeur par défaut est:
**Exemple p219-3.** Exemple extrait du PDF\, page 219\.
```sql
SHOW default_toast_compression ;
```
**Exemple p219-4.** Exemple extrait du PDF\, page 219\.
```text
default_toast_compression
---------------------------
pglz
```
c’est-à-dire que PostgreSQL utilise ici la zlib.
Un autre algorithme, `lz4`, est disponible (et intégré dans les paquets distribués par le PGDG).
De manière générale, l’algorithme `lz4` ne compresse pas mieux les données courantes que `pglz`, mais cela dépend des usages. Surtout, `lz4` est **beaucoup** plus rapide à compresser, et parfois à décompresser.
Nous conseillons d’utiliser `lz4` pour la compression de vos TOAST, même si, en toute rigueur, l’arbitrage entre consommations CPU en écriture ou lecture et place disque ne peut se faire qu’en testant soigneusement avec les données réelles.
Pour changer l’algorithme, vous pouvez:
- soit changer la valeur par défaut dans `postgresql.conf`:
**Exemple p219-5.** Exemple extrait du PDF\, page 219\.
```ini
default_toast_compression = lz4
```
- soit déclarer la méthode de compression à la création de la table:
**Exemple p219-6.** Exemple extrait du PDF\, page 219\.
```sql
CREATE TABLE t1 (
```
**Exemple p219-7.** Exemple extrait du PDF\, page 219\.
```text
c1 bigint GENERATED ALWAYS AS identity,
c2 text COMPRESSION lz4
) ;
```
- soit après création:
**Exemple p220-1.** Exemple extrait du PDF\, page 220\.
```sql
ALTER TABLE t1 ALTER COLUMN c2 SET COMPRESSION lz4 ;
```
`lz4` accélère aussi les restaurations logiques comportant beaucoup de données toastées et compressées. Si `lz4` n’a pas été activé par défaut, il peut être utilisé dès le chargement:
**Exemple p220-2.** Exemple extrait du PDF\, page 220\.
```text
$PGOPTIONS='-cdefault_toast_compression=lz4'pg_restore…
```
Des lignes d’une même table peuvent être compressées de manières différentes. En effet, l’utilisation de `SET COMPRESSION` sur une colonne préexistante ne recompresse pas les données de la table TOAST associée. De plus, des données toastées lues par une requête, puis réinsérées sans être modifiées, sont recopiées vers les champs cibles telles quelles, sans étapes de décompression/recompression, et ce même si la compression de la cible est différente, même s’il s’agit d’une autre table. Même un `VACUUM FULL` sur la table principale réécrit la table TOAST, en recopiant simplement les champs compressés tels quels.
Pour forcer la recompression de toutes les données d’une colonne, il faut modifier leur contenu. Et en fait, c’est peu intéressant car l’écart de volumétrie est généralement faible. Noter qu’il existe une fonction `pg_column_compression (nom_champ)`[^17] pour consulter la compression d’un champ sur chaque ligne concernée.
#### Pour aller plus loin:
- Blog Dalibo: Les mains dans le cambouis #2 - Le mécanisme de TOAST[^18] (2024)
- Blog Fujitsu PostgreSQL: What is the new LZ4 TOAST compression in PostgreSQL 14, and how fast is it?[^19] (2021), avec notamment un benchmark montrant l’intérêt de la compression `lz4`.
[^17]: https://docs.postgresql.fr/current/functions-admin.html#FUNCTIONS-ADMIN-DBOBJECT
[^18]: https://blog.dalibo.com/2024/02/27/toast.html
[^19]: https://www.postgresql.fastware.com/blog/what-is-the-new-lz4-toast-compression-in-postgresql-14
### 4.12 CONCLUSION
- PostgreSQL dispose d’une implémentation MVCC complète, permettant:
- que les lecteurs ne bloquent pas les écrivains
- que les écrivains ne bloquent pas les lecteurs
- que les verrous en mémoire soient d’un nombre limité
- Cela impose par contre une mécanique un peu complexe, dont les parties visibles sont la commande `VACUUM` et le processus d’arrière-plan autovacuum.
#### 4.12.1 Questions
N’hésitez pas, c’est le moment!
### 4.13 QUIZ
**https://dali.bo/m4_quiz**
### 4.14 TRAVAUX PRATIQUES
La version en ligne des solutions de ces TP est disponible sur https://dali.bo/m4_solutions.
#### 4.14.1 Niveaux d’isolation READ COMMITTED et REPEATABLE READ
**But**: Découvrir les niveaux d’isolation
Créer une nouvelle base de données nommée **b2**.
Dans la base de données **b2**, créer une table `t1` avec deux colonnes `c1` de type integer et `c2` de type `text`.
Insérer 5 lignes dans table `t1` avec des valeurs de `(1, 'un')` à `(5, 'cinq')`.
Ouvrir une transaction.
Lire les données de la table `t1`.
Depuis une autre session, mettre en majuscules le texte de la troisième ligne de la table `t1`.
Revenir à la première session et lire de nouveau toute la table `t1`.
Fermer la transaction et ouvrir une nouvelle transaction, cette fois-ci en `REPEATABLE READ`.
Lire les données de la table `t1`.
Depuis une autre session, mettre en majuscules le texte de la quatrième ligne de la table `t1`.
Revenir à la première session et lire de nouveau les données de la table `t1`. Que s’est-il passé?
#### 4.14.2 Niveau d’isolation SERIALIZABLE (Optionnel)
**But**: Découvrir le niveau d’isolation _serializable_
Une table de comptes bancaires contient 1000 clients, chacun avec 3 lignes de crédit et 600 € au total:
**Exemple p224-1.** Exemple extrait du PDF\, page 224\.
```text
CREATE TABLE mouvements_comptes
(client int,
mouvement numeric NOT NULL DEFAULT 0
);
```
**Exemple p224-2.** Exemple extrait du PDF\, page 224\.
```sql
CREATE INDEX on mouvements_comptes (client) ;
```
**Exemple p224-3.** Exemple extrait du PDF\, page 224\.
```sql
-- 3 clients, 3 lignes de +100, +200, +300 €
INSERT INTO mouvements_comptes (client, mouvement)
SELECT i, j * 100
FROM generate_series(1, 1000) i
CROSS JOIN generate_series(1, 3) j ;
```
Chaque mouvement donne lieu à une ligne de crédit ou de débit. Une ligne de crédit correspondra à l’insertion d’une ligne avec une valeur `mouvement` positive. Une ligne de débit correspondra à l’insertion d’une ligne avec une valeur `mouvement` négative. **Nous exigeons que le client ait toujours un solde positif**. Chaque opération bancaire se déroulera donc dans une transaction, qui se terminera par l’appel à cette procédure de test:
```sql
CREATE PROCEDURE verifie_solde_positif (p_client int)
LANGUAGE plpgsql
AS $$
DECLARE
solde numeric ;
BEGIN
SELECT round(sum (mouvement), 0)
INTO solde
FROM mouvements_comptes
WHERE client = p_client ;
IF solde < 0 THEN
-- Erreur fatale
RAISE EXCEPTION 'Client % - Solde négatif : % !', p_client, solde ;
ELSE
-- Simple message
RAISE NOTICE 'Client % - Solde positif : %', p_client, solde ;
END IF ;
END ;
$$ ;
```
Au sein de trois transactions successives:
- insérer successivement 3 mouvements de **débit** de 300 € pour le client **1**
- chaque transaction doit finir par `CALL verifie_solde_positif (1);` avant le `COMMIT`
- la sécurité fonctionne-t-elle?
Pour le client **2**, ouvrir deux transactions en parallèle:
- dans chacune, procéder à retrait de 500 €;
- dans chacune, appeler `CALL verifie_solde_positif (2)`;
- dans chacune, valider la transaction;
- la règle du solde positif est-elle respectée?
- Reproduire avec le client **3** le même scénario de deux débits parallèles de 500 €, mais avec des transactions sérialisables: (`BEGIN TRANSACTION ISOLATION LEVEL SERIALIZABLE`).
- Avant chaque `COMMIT`, consulter la vue `pg_locks` pour la table `mouvements_comptes`:
**`SELECT`** `locktype,` **`mode`** `, pid, granted` **`FROM`** `pg_locks` **`WHERE`** `relation = (` **`SELECT oid FROM`** `pg_class` **`WHERE`** `relname = 'mouvements_comptes')` `;`
#### 4.14.3 Effets de MVCC
**But**: Voir l’effet du MVCC dans les lignes
Créer une nouvelle table `t2` avec deux colonnes: un entier et un texte.
Insérer 5 lignes dans la table `t2`, de `(1, 'un')` à `(5, 'cinq')`.
Lire les données de la table `t2`.
Commencer une transaction. Mettre en majuscules le texte de la troisième ligne de la table `t2`.
Lire les données de la table `t2`. Que faut-il remarquer?
Ouvrir une autre session et lire les données de la table `t2`. Que faut-il observer?
Afficher `xmin` et `xmax` lors de la lecture des données de la table `t2`, dans chaque session.
Récupérer maintenant en plus le `ctid` lors de la lecture des données de la table `t2`, dans chaque session.
Valider la transaction.
Installer l’extension `pageinspect`.
La documentation[^a] indique comment décoder le contenu du bloc 0 de la table `t2`:
**Exemple p226-1.** Exemple extrait du PDF\, page 226\.
```sql
SELECT * FROM heap_page_items(get_raw_page('t2', 0)) ;
```
Que faut-il remarquer?
[^a]: https://docs.postgresql.fr/current/pageinspect.html
- Lancer `VACUUM` sur `t2`.
- Relancer la requête avec `pageinspect`.
- Comment est réorganisé le bloc?
Pourquoi l’autovacuum n’a-t-il pas nettoyé encore la table?
#### 4.14.4 Verrous
**But**: Trouver des verrous
Ouvrir une transaction et lire les données de la table `t1`. Ne pas terminer la transaction.
Ouvrir une autre transaction, et tenter de supprimer la table `t1`.
Lister les processus du serveur PostgreSQL. Que faut-il remarquer?
Depuis une troisième session, récupérer la liste des sessions en attente avec la vue `pg_stat_activity`.
Récupérer la liste des verrous en attente pour la requête bloquée.
Récupérer le nom de l’objet dont le verrou n’est pas récupéré.
Récupérer la liste des verrous sur cet objet. Quel processus a verrouillé la table `t1`?
Retrouver les informations sur la session bloquante.
Retrouver cette information avec la fonction `pg_blocking_pids`.
Détruire la session bloquant le `DROP TABLE`.
Pour créer un verrou, effectuer un `LOCK TABLE` dans une transaction qu’il faudra laisser ouverte.
Construire une vue `pg_show_locks` basée sur `pg_stat_activity`, `pg_locks`, `pg_class` qui permette de connaître à tout moment l’état des verrous en cours sur la base: processus, nom de l’utilisateur, âge de la transaction, table verrouillée, type de verrou.
### 4.15 TRAVAUX PRATIQUES (SOLUTIONS)
#### 4.15.1 Niveaux d’isolation READ COMMITTED et REPEATABLE READ
Créer une nouvelle base de données nommée **b2**.
**Exemple p228-1.** Exemple extrait du PDF\, page 228\.
```text
$ createdb b2
```
Dans la base de données **b2**, créer une table `t1` avec deux colonnes `c1` de type integer et `c2` de type `text`.
**Exemple p228-2.** Exemple extrait du PDF\, page 228\.
```sql
CREATE TABLE t1 (c1 integer, c2 text);
```
```text
CREATE TABLE
```
Insérer 5 lignes dans table `t1` avec des valeurs de `(1, 'un')` à `(5, 'cinq')`.
**Exemple p228-3.** Exemple extrait du PDF\, page 228\.
```sql
INSERT INTO t1 (c1, c2) VALUES
```
**Exemple p228-4.** Exemple extrait du PDF\, page 228\.
```text
(1, 'un'), (2, 'deux'), (3, 'trois'), (4, 'quatre'), (5, 'cinq');
```
**Exemple p228-5.** Exemple extrait du PDF\, page 228\.
```sql
INSERT 0 5
```
Ouvrir une transaction.
**Exemple p228-6.** Exemple extrait du PDF\, page 228\.
```text
BEGIN;
```
**Exemple p228-7.** Exemple extrait du PDF\, page 228\.
```sql
BEGIN
```
Lire les données de la table `t1`.
```sql
SELECT * FROM t1;
```
**Exemple p228-8.** Exemple extrait du PDF\, page 228\.
```text
c1 | c2
----+--------
1 | un
2 | deux
3 | trois
4 | quatre
5 | cinq
```
Depuis une autre session, mettre en majuscules le texte de la troisième ligne de la table `t1`.
**Exemple p228-9.** Exemple extrait du PDF\, page 228\.
```sql
UPDATE t1 SET c2 = upper(c2) WHERE c1 = 3;
```
```text
UPDATE 1
```
Revenir à la première session et lire de nouveau toute la table `t1`.
**Exemple p228-10.** Exemple extrait du PDF\, page 228\.
```sql
SELECT * FROM t1;
```
**Exemple p229-1.** Exemple extrait du PDF\, page 229\.
```text
c1 | c2
----+--------
```
**Exemple p229-2.** Exemple extrait du PDF\, page 229\.
```text
1 | un
2 | deux
```
**Exemple p229-3.** Exemple extrait du PDF\, page 229\.
```text
4 | quatre
5 | cinq
```
**Exemple p229-4.** Exemple extrait du PDF\, page 229\.
```text
3|TROIS
```
Les modifications réalisées par la deuxième transaction sont immédiatement visibles par la première transaction. C’est le cas des transactions en niveau d’isolation READ COMMITED.
Fermer la transaction et ouvrir une nouvelle transaction, cette fois-ci en `REPEATABLE READ`.
**Exemple p229-5.** Exemple extrait du PDF\, page 229\.
```text
ROLLBACK;
```
**Exemple p229-6.** Exemple extrait du PDF\, page 229\.
```text
ROLLBACK;
```
**Exemple p229-7.** Exemple extrait du PDF\, page 229\.
```sql
BEGIN ISOLATION LEVEL REPEATABLE READ;
```
```sql
BEGIN
```
Lire les données de la table `t1`.
```sql
SELECT * FROM t1;
```
**Exemple p229-8.** Exemple extrait du PDF\, page 229\.
```text
c1 | c2
----+--------
1 | un
2 | deux
4 | quatre
5 | cinq
3 | TROIS
```
Depuis une autre session, mettre en majuscules le texte de la quatrième ligne de la table `t1`.
**Exemple p229-9.** Exemple extrait du PDF\, page 229\.
```sql
UPDATE t1 SET c2 = upper(c2) WHERE c1 = 4;
```
**Exemple p229-10.** Exemple extrait du PDF\, page 229\.
```text
UPDATE1
```
Revenir à la première session et lire de nouveau les données de la table `t1`. Que s’est-il passé?
```sql
SELECT * FROM t1;
```
**Exemple p229-11.** Exemple extrait du PDF\, page 229\.
```text
c1 | c2
----+--------
1 | un
2 | deux
4 | quatre
5 | cinq
```
**Exemple p229-12.** Exemple extrait du PDF\, page 229\.
```text
3|TROIS
```
En niveau d’isolation `REPEATABLE READ`, la transaction est certaine de ne pas voir les modifications réalisées par d’autres transactions (à partir de la première lecture de la table).
#### 4.15.2 Niveau d’isolation SERIALIZABLE (Optionnel)
Une table de comptes bancaires contient 1000 clients, chacun avec 3 lignes de crédit et 600 € au total:
**Exemple p230-1.** Exemple extrait du PDF\, page 230\.
```sql
CREATE TABLE mouvements_comptes
(client int,
mouvement numeric NOT NULL DEFAULT 0
);
CREATE INDEX on mouvements_comptes (client) ;
-- 3 clients, 3 lignes de +100, +200, +300 €
INSERT INTO mouvements_comptes (client, mouvement)
SELECT i, j * 100
FROM generate_series(1, 1000) i
CROSS JOIN generate_series(1, 3) j ;
```
Chaque mouvement donne lieu à une ligne de crédit ou de débit. Une ligne de crédit correspondra à l’insertion d’une ligne avec une valeur `mouvement` positive. Une ligne de débit correspondra à l’insertion d’une ligne avec une valeur `mouvement` négative. **Nous exigeons que le client ait toujours un solde positif**. Chaque opération bancaire se déroulera donc dans une transaction, qui se terminera par l’appel à cette procédure de test:
```sql
CREATE PROCEDURE verifie_solde_positif (p_client int)
LANGUAGE plpgsql
AS $$
DECLARE
solde numeric ;
BEGIN
SELECT round(sum (mouvement), 0)
INTO solde
FROM mouvements_comptes
WHERE client = p_client ;
IF solde < 0 THEN
-- Erreur fatale
RAISE EXCEPTION 'Client % - Solde négatif : % !', p_client, solde ;
ELSE
-- Simple message
RAISE NOTICE 'Client % - Solde positif : %', p_client, solde ;
END IF ;
END ;
$$ ;
```
Au sein de trois transactions successives:
- insérer successivement 3 mouvements de **débit** de 300 € pour le client **1**
- chaque transaction doit finir par `CALL verifie_solde_positif (1);` avant le `COMMIT`
- la sécurité fonctionne-t-elle?
Ce client a bien 600 €:
**Exemple p230-2.** Exemple extrait du PDF\, page 230\.
```sql
SELECT * FROM mouvements_comptes WHERE client = 1 ;
client | mouvement
```
**Exemple p231-1.** Exemple extrait du PDF\, page 231\.
```text
--------+-----------
1 | 100
1 | 200
1 | 300
```
#### Première transaction:
**Exemple p231-2.** Exemple extrait du PDF\, page 231\.
```text
BEGIN;
```
**Exemple p231-3.** Exemple extrait du PDF\, page 231\.
```sql
INSERT INTO mouvements_comptes(client, mouvement) VALUES (1, -300) ;
CALL verifie_solde_positif (1) ;
```
**Exemple p231-4.** Exemple extrait du PDF\, page 231\.
```sql
NOTICE: Client 1 - Solde positif : 300
CALL
```
**Exemple p231-5.** Exemple extrait du PDF\, page 231\.
```text
COMMIT;
```
Lors d’une seconde transaction: les mêmes ordres renvoient:
**Exemple p231-6.** Exemple extrait du PDF\, page 231\.
```text
NOTICE: Client 1 - Solde positif : 0
```
#### Avec le troisième débit:
```sql
BEGIN ;
```
**Exemple p231-7.** Exemple extrait du PDF\, page 231\.
```sql
INSERT INTO mouvements_comptes(client, mouvement) VALUES (1, -300) ;
CALL verifie_solde_positif (1) ;
```
**Exemple p231-8.** Exemple extrait du PDF\, page 231\.
```text
ERROR: Client 1 - Solde négatif : -300 !
CONTEXTE : PL/pgSQL function verifie_solde_positif(integer) line 11 at RAISE
```
La transaction est annulée: il est interdit de retirer plus d’argent qu’il n’y en a.
Pour le client **2**, ouvrir deux transactions en parallèle: - dans chacune, procéder à retrait de 500 €; - dans chacune, appeler `CALL verifie_solde_positif (2)`; - dans chacune, valider la transaction;
- la règle du solde positif est-elle respectée?
#### Chaque transaction va donc se dérouler dans une session différente.
#### Première transaction:
**Exemple p231-9.** Exemple extrait du PDF\, page 231\.
```sql
BEGIN ; --session 1
```
**Exemple p231-10.** Exemple extrait du PDF\, page 231\.
```sql
INSERT INTO mouvements_comptes(client, mouvement) VALUES (2, -500) ;
CALL verifie_solde_positif (2) ;
```
**Exemple p231-11.** Exemple extrait du PDF\, page 231\.
```text
NOTICE: Client 2 - Solde positif : 100
```
On ne commite pas encore.
Dans la deuxième session, il se passe exactement la même chose:
**Exemple p231-12.** Exemple extrait du PDF\, page 231\.
```sql
BEGIN ; --session 2
```
**Exemple p231-13.** Exemple extrait du PDF\, page 231\.
```sql
INSERT INTO mouvements_comptes(client, mouvement) VALUES (2, -500) ;
CALL verifie_solde_positif (2) ;
```
**Exemple p231-14.** Exemple extrait du PDF\, page 231\.
```text
NOTICE: Client 2 - Solde positif : 100
```
En effet, cette deuxième session ne voit pas encore le débit de la première session.
Les deux tests étant concluants, les deux sessions committent:
**Exemple p232-1.** Exemple extrait du PDF\, page 232\.
```sql
COMMIT ; --session 1
COMMIT
COMMIT ; --session 2
```
**Exemple p232-2.** Exemple extrait du PDF\, page 232\.
```sql
COMMIT
```
Au final, le solde est négatif, ce qui est pourtant strictement interdit!
**Exemple p232-3.** Exemple extrait du PDF\, page 232\.
```sql
CALL verifie_solde_positif (2) ;
```
**Exemple p232-4.** Exemple extrait du PDF\, page 232\.
```text
ERROR: Client 2 - Solde négatif : -400 !
CONTEXTE : PL/pgSQL function verifie_solde_positif(integer) line 11 at RAISE
```
Les deux sessions en parallèle sont donc un moyen de contourner la sécurité, qui porte sur le résultat d’un ensemble de lignes, et non juste sur la ligne concernée.
- Reproduire avec le client **3** le même scénario de deux débits parallèles de 500 €, mais avec des transactions sérialisables: (`BEGIN TRANSACTION ISOLATION LEVEL SERIALIZABLE`).
- Avant chaque `COMMIT`, consulter la vue `pg_locks` pour la table `mouvements_comptes`:
**`SELECT`** `locktype,` **`mode`** `, pid, granted` **`FROM`** `pg_locks` **`WHERE`** `relation = (` **`SELECT oid FROM`** `pg_class` **`WHERE`** `relname = 'mouvements_comptes')` `;`
#### Première session:
**Exemple p232-5.** Exemple extrait du PDF\, page 232\.
```sql
BEGIN TRANSACTION ISOLATION LEVEL SERIALIZABLE ;
INSERT INTO mouvements_comptes(client, mouvement) VALUES (3, -500) ;
CALL verifie_solde_positif (3) ;
```
**Exemple p232-6.** Exemple extrait du PDF\, page 232\.
```text
NOTICE: Client 3 - Solde positif : 100
```
On ne committe pas encore.
Deuxième session:
**Exemple p232-7.** Exemple extrait du PDF\, page 232\.
```sql
BEGIN TRANSACTION ISOLATION LEVEL SERIALIZABLE ;
INSERT INTO mouvements_comptes(client, mouvement) VALUES (3, -500) ;
CALL verifie_solde_positif (3) ;
```
**Exemple p232-8.** Exemple extrait du PDF\, page 232\.
```text
NOTICE: Client 3 - Solde positif : 100
```
Les verrous en place sont les suivants:
**Exemple p232-9.** Exemple extrait du PDF\, page 232\.
```sql
SELECT locktype, mode, pid, granted
FROM pg_locks
WHERE relation = (SELECT oid FROM pg_class WHERE relname = 'mouvements_comptes') ;
```
**Tableau p233-1.** Tableau extrait du PDF\, page 233\.
```text
locktype | mode | pid | granted
----------+------------------+---------+---------
relation | AccessShareLock | 28304 | t
relation | RowExclusiveLock | 28304 | t
relation | AccessShareLock | 28358 | t
relation | RowExclusiveLock | 28358 | t
tuple | SIReadLock | 28304 | t
tuple | SIReadLock | 28358 | t
tuple | SIReadLock | 28358 | t
tuple | SIReadLock | 28304 | t
tuple | SIReadLock | 28358 | t
tuple | SIReadLock | 28304 | t
```
`SIReadLock` est un verrou lié à la sérialisation: noter qu’il porte sur des lignes, portées par les deux sessions. `AccessShareLock` empêche surtout de supprimer la table. `RowExclusiveLock` est un verrou de ligne.
Validation de la première session:
```sql
COMMIT ;
```
```text
COMMIT
```
Dans les verrous, il subsiste toujours les verrous `SIReadLock` de la session de PID 28304, qui a pourtant committé:
**Tableau p233-2.** Tableau extrait du PDF\, page 233\.
```text
locktype | mode | pid | granted
----------+------------------+---------+---------
relation | AccessShareLock | 28358 | t
relation | RowExclusiveLock | 28358 | t
tuple | SIReadLock | 28304 | t
tuple | SIReadLock | 28358 | t
tuple | SIReadLock | 28358 | t
tuple | SIReadLock | 28304 | t
tuple | SIReadLock | 28358 | t
tuple | SIReadLock | 28304 | t
```
Tentative de validation de la seconde session:
**Exemple p233-1.** Exemple extrait du PDF\, page 233\.
```text
COMMIT;
```
**Exemple p233-2.** Exemple extrait du PDF\, page 233\.
```text
ERROR: could not serialize access due to read/write dependencies among transactions
DÉTAIL : Reason code: Canceled on identification as a pivot, during commit attempt.
ASTUCE : The transaction might succeed if retried.
```
La transaction est annulée pour erreur de sérialisation. En effet, le calcul effectué pendant la seconde transaction n’est plus valable puisque la première a modifié les lignes qu’elle a lues.
La transaction annulée doit être rejouée de zéro, et elle tombera alors bien en erreur.
#### 4.15.3 Effets de MVCC
Créer une nouvelle table `t2` avec deux colonnes: un entier et un texte.
**Exemple p234-1.** Exemple extrait du PDF\, page 234\.
```sql
CREATE TABLE t2 (i int, t text) ;
```
**Exemple p234-2.** Exemple extrait du PDF\, page 234\.
```sql
CREATE TABLE
```
Insérer 5 lignes dans la table `t2`, de `(1, 'un')` à `(5, 'cinq')`.
**Exemple p234-3.** Exemple extrait du PDF\, page 234\.
```sql
INSERT INTO t2(i, t)
VALUES
(1, 'un'), (2, 'deux'), (3, 'trois'), (4, 'quatre'), (5, 'cinq');
```
**Exemple p234-4.** Exemple extrait du PDF\, page 234\.
```sql
INSERT 0 5
```
Lire les données de la table `t2`.
```sql
SELECT * FROM t2;
```
**Exemple p234-5.** Exemple extrait du PDF\, page 234\.
```text
i | t
----+--------
1 | un
2 | deux
3 | trois
4 | quatre
5 | cinq
```
Commencer une transaction. Mettre en majuscules le texte de la troisième ligne de la table `t2`.
**Exemple p234-6.** Exemple extrait du PDF\, page 234\.
```sql
BEGIN ;
UPDATE t2 SET t = upper(t) WHERE i = 3;
```
**Exemple p234-7.** Exemple extrait du PDF\, page 234\.
```text
UPDATE1
```
Lire les données de la table `t2`. Que faut-il remarquer?
```sql
SELECT * FROM t2;
```
**Exemple p234-8.** Exemple extrait du PDF\, page 234\.
```text
i | t
----+--------
1 | un
2 | deux
4 | quatre
5 | cinq
3 | TROIS
```
La ligne mise à jour n’apparaît plus, ce qui est normal. Elle apparaît en fin de table. En effet, quand un `UPDATE` est exécuté, la ligne courante est considérée comme morte et une nouvelle ligne est ajoutée, avec les valeurs modifiées. Comme nous n’avons pas demandé de récupérer les résultats dans un certain ordre (pas d’ `ORDER BY`), les lignes sont simplement affichées dans leur ordre de stockage dans les blocs de la table.
Ouvrir une autre session et lire les données de la table `t2`. Que faut-il observer?
**Exemple p235-1.** Exemple extrait du PDF\, page 235\.
```sql
SELECT * FROM t2;
```
- `i | t`
- `----+-------1 | un 2 | deux 3 | trois 4 | quatre 5 | cinq`
L’ordre des lignes en retour n’est pas le même. Les autres sessions voient toujours l’ancienne version de la ligne 3, puisque la transaction n’a pas encore été validée.
Afficher `xmin` et `xmax` lors de la lecture des données de la table `t2`, dans chaque session.
Voici ce que renvoie la session qui a fait la modification:
**Exemple p235-2.** Exemple extrait du PDF\, page 235\.
```sql
SELECT xmin, xmax, * FROM t2;
```
**Exemple p235-3.** Exemple extrait du PDF\, page 235\.
```text
xmin | xmax | i | t
------+------+----+--------
753 | 0 | 1 | un
753 | 0 | 2 | deux
753 | 0 | 4 | quatre
753 | 0 | 5 | cinq
754 | 0 | 3 | TROIS
```
Et voici ce que renvoie l’autre session:
**Exemple p235-4.** Exemple extrait du PDF\, page 235\.
```sql
SELECT xmin, xmax, * FROM t2;
```
**Exemple p235-5.** Exemple extrait du PDF\, page 235\.
```text
xmin | xmax | i | t
------+------+----+--------
753 | 0 | 1 | un
753 | 0 | 2 | deux
753 | 754 | 3 | trois
753 | 0 | 4 | quatre
753 | 0 | 5 | cinq
```
La transaction 754 est celle qui a réalisé la modification. La colonne `xmin` de la nouvelle version de ligne contient ce numéro. De même pour la colonne `xmax` de l’ancienne version de ligne. PostgreSQL se base sur cette information pour savoir si telle transaction peut lire telle ou telle ligne.
Récupérer maintenant en plus le `ctid` lors de la lecture des données de la table `t2`, dans chaque session.
Voici ce que renvoie la session qui a fait la modification:
**Exemple p235-6.** Exemple extrait du PDF\, page 235\.
```sql
SELECT ctid, xmin, xmax, * FROM t2;
```
**Tableau p236-1.** Tableau extrait du PDF\, page 236\.
```text
ctid | xmin | xmax | i | t
-------+------+------+---+--------
(0,1) | 753 | 0 | 1 | un
(0,2) | 753 | 0 | 2 | deux
(0,4) | 753 | 0 | 4 | quatre
(0,5) | 753 | 0 | 5 | cinq
(0,6) | 754 | 0 | 3 | TROIS
```
Et voici ce que renvoie l’autre session:
**Exemple p236-1.** Exemple extrait du PDF\, page 236\.
```sql
SELECT ctid, xmin, xmax, * FROM t2 ;
```
**Tableau p236-2.** Tableau extrait du PDF\, page 236\.
```text
ctid | xmin | xmax | i | t
-------+------+------+----+--------
(0,1) | 753 | 0 | 1 | un
(0,2) | 753 | 0 | 2 | deux
(0,3) | 753 | 754 | 3 | trois
(0,4) | 753 | 0 | 4 | quatre
(0,5) | 753 | 0 | 5 | cinq
```
La colonne `ctid` contient une paire d’entiers. Le premier indique le numéro de bloc, le second le numéro de l’enregistrement dans le bloc. Autrement dit, elle précise la position de l’enregistrement sur le fichier de la table.
En récupérant cette colonne, nous voyons que la première session voit la nouvelle position (enregistrement 6 du bloc 0) car elle est dans la transaction 754. Mais pour la deuxième session, cette nouvelle transaction n’est pas validée, donc l’information d’effacement de la ligne 3 n’est pas prise en compte, et on la voit toujours.
Valider la transaction.
**Exemple p236-2.** Exemple extrait du PDF\, page 236\.
```text
COMMIT;
```
**Exemple p236-3.** Exemple extrait du PDF\, page 236\.
```sql
COMMIT
```
Installer l’extension `pageinspect`.
**Exemple p236-4.** Exemple extrait du PDF\, page 236\.
```sql
CREATE EXTENSION pageinspect ;
```
**Exemple p236-5.** Exemple extrait du PDF\, page 236\.
```sql
CREATE EXTENSION
```
La documentation[^a] indique comment décoder le contenu du bloc 0 de la table `t2`:
**`SELECT`** `*` **`FROM`** `heap_page_items(get_raw_page('t2', 0));` Que faut-il remarquer?
Cette table est assez petite pour tenir dans le bloc 0 toute entière. `pageinspect` nous fournit le détail de ce qu’il y a dans les lignes (la sortie est coupée en deux pour l’affichage):
**Exemple p236-6.** Exemple extrait du PDF\, page 236\.
```sql
SELECT * FROM heap_page_items(get_raw_page('t2', 0)) ;
```
**Exemple p237-1.** Exemple extrait du PDF\, page 237\.
```text
lp | lp_off | lp_flags | lp_len | t_xmin | t_xmax | t_field3 | t_ctid |
```
**Exemple p237-2.** Exemple extrait du PDF\, page 237\.
```text
----+--------+----------+--------+--------+--------+----------+--------+-
```
**Tableau p237-1.** Tableau extrait du PDF\, page 237\.
```text
1 | 8160 | 1 | 31 | 753 | 0 | 0 | (0,1) |
2 | 8120 | 1 | 33 | 753 | 0 | 0 | (0,2) |
3 | 8080 | 1 | 34 | 753 | 754 | 0 | (0,6) |
4 | 8040 | 1 | 35 | 753 | 0 | 0 | (0,4) |
5 | 8000 | 1 | 33 | 753 | 0 | 0 | (0,5) |
6 | 7960 | 1 | 34 | 754 | 0 | 0 | (0,6) |
lp | t_infomask2 | t_infomask | t_hoff | t_bits | t_oid | t_data
----+-------------+------------+--------+--------+-------+--------------------------
1 | 2 | 2306 | 24 | | | \x0100000007756e
2 | 2 | 2306 | 24 | | | \x020000000b64657578
3 | 16386 | 258 | 24 | | | \x030000000d74726f6973
4 | 2 | 2306 | 24 | | | \x040000000f717561747265
5 | 2 | 2306 | 24 | | | \x050000000b63696e71
6 | 32770 | 10242 | 24 | | | \x030000000d54524f4953
```
**Exemple p237-3.** Exemple extrait du PDF\, page 237\.
```text
----+-------------+------------+--------+--------+-------+--------------------------
```
Tous les champs ne sont pas immédiatement compréhensibles, mais on peut lire facilement ceci:
- Les six lignes sont bien présentes, dont les deux versions de la ligne 3;
- Le `t_ctid` de l’ancienne ligne ne contient plus `(0,3)` mais l’adresse de la nouvelle ligne (soit `(0,6)`).
Mais encore:
- Les lignes sont stockées à rebours depuis la fin du bloc: la première a un _offset_ de 8160 octets depuis le début, la dernière est à seulement 7960 octets du début;
- la longueur de la ligne est indiquée par le champ `lp_len`: la ligne 4 est la plus longue;
- `t_infomask2` est un champ de bits: la valeur 16386 pour l’ancienne version nous indique que
- le changement a eu lieu en utilisant la technologie hot(la nouvelle version de laligne est maintenue dans le même bloc et un chaînage depuis l’ancienne est effectué);
- le champ `t_data` contient les valeurs de la ligne: nous devinons `i` au début (01 à 05), et la fin correspond aux chaînes de caractères, précédée d’un octet lié à la taille.
La signification de tous les champs n’est pas dans la documentation mais se trouve dans le code de PostgreSQL[^20].
- Lancer `VACUUM` sur `t2`.
- Relancer la requête avec `pageinspect`.
- Comment est réorganisé le bloc?
**Exemple p237-4.** Exemple extrait du PDF\, page 237\.
```sql
VACUUM (VERBOSE) t2 ;
```
- `INFO: vacuuming "postgres.public.t2"`
**Exemple p237-5.** Exemple extrait du PDF\, page 237\.
```text
…
tuples:1removed,5remain,0aredeadbutnotyetremovable
```
**Exemple p237-6.** Exemple extrait du PDF\, page 237\.
```sql
VACUUM
```
Une seule ligne a bien été nettoyée. La requête suivante nous montre qu’elle a bien disparu:
**Exemple p237-7.** Exemple extrait du PDF\, page 237\.
```sql
SELECT * FROM heap_page_items(get_raw_page('t2', 0)) ;
```
[^20]: https://doxygen.postgresql.org/itemid_8h_source.html
**Tableau p238-1.** Tableau extrait du PDF\, page 238\.
```text
lp | lp_off | lp_flags | … | t_ctid |… | t_data
----+--------+----------+---+--------+--+--------------------------
1 | 8160 | 1 | | (0,1) | | \x0100000007756e
2 | 8120 | 1 | | (0,2) | | \x020000000b64657578
3 | 6 | 2 | | | |
4 | 8080 | 1 | | (0,4) | | \x040000000f717561747265
5 | 8040 | 1 | | (0,5) | | \x050000000b63696e71
6 | 8000 | 1 | | (0,6) | | \x030000000d54524f4953
```
La 3è ligne ici a été remplacée par un simple pointeur sur la nouvelle version de la ligne dans le bloc (mise à jour HOT).
On peut aussi remarquer que les lignes non modifiées ont été réorganisées dans le bloc: là où se trouvait l’ancienne version de la 3è ligne (à 8080 octets du début de bloc) se trouve à présent la 4è. Le `VACUUM` opère ainsi une défragmentation des blocs qu’il nettoie.
Pourquoi l’autovacuum n’a-t-il pas nettoyé encore la table?
Le vacuum ne se déclenche qu’à partir d’un certain nombre de lignes modifiées ou effacées (50 + 20% de la table par défaut). On est encore très loin de ce seuil avec cette très petite table.
#### 4.15.4 Verrous
Ouvrir une transaction et lire les données de la table `t1`. Ne pas terminer la transaction.
**Exemple p239-1.** Exemple extrait du PDF\, page 239\.
```sql
BEGIN;
SELECT * FROM t1;
```
**Exemple p239-2.** Exemple extrait du PDF\, page 239\.
```text
c1 | c2
----+--------
1 | un
2 | deux
3 | TROIS
4 | QUATRE
5 | CINQ
```
Ouvrir une autre transaction, et tenter de supprimer la table `t1`.
**Exemple p239-3.** Exemple extrait du PDF\, page 239\.
```sql
DROP TABLE t1;
```
La suppression semble bloquée.
Lister les processus du serveur PostgreSQL. Que faut-il remarquer?
En tant qu’utilisateur système `postgres`:
**Exemple p239-4.** Exemple extrait du PDF\, page 239\.
```text
$ ps -o pid,cmd fx
PID CMD
2657 -bash
2693 \_ psql
2431 -bash
2622 \_ psql
2728 \_ ps -o pid,cmd fx
2415 /usr/pgsql-17/bin/postmaster -D /var/lib/pgsql/15/data/
2417 \_ postgres: logger
2419 \_ postgres: checkpointer
2420 \_ postgres: background writer
2421 \_ postgres: walwriter
2422 \_ postgres: autovacuum launcher
2424 \_ postgres: logical replication launcher
2718 \_ postgres: postgres b2 [local] DROP TABLE waiting
2719 \_ postgres: postgres b2 [local] idle in transaction
```
la ligne intéressante est la ligne du `DROP TABLE`.Elle contient le mot-clé `waiting`.ce dernier indique que l’exécution de la requête est en attente d’un verrou sur un objet.
Depuis une troisième session, récupérer la liste des sessions en attente avec la vue `pg_stat_activity`.
**Exemple p239-5.** Exemple extrait du PDF\, page 239\.
```text
\x
```
**Exemple p239-6.** Exemple extrait du PDF\, page 239\.
```text
Expanded display is on.
```
**Exemple p239-7.** Exemple extrait du PDF\, page 239\.
```sql
SELECT * FROM pg_stat_activity
WHERE application_name='psql' AND wait_event IS NOT NULL;
```
**Tableau p240-1.** Tableau extrait du PDF\, page 240\.
```text
-[ RECORD 1 ]----+------------------------------
datid | 16387
datname | b2
pid | 2718
usesysid | 10
usename | postgres
application_name | psql
client_addr |
client_hostname |
client_port | -1
backend_start | 2018-11-02 15:56:45.38342+00
xact_start | 2018-11-02 15:57:32.82511+00
query_start | 2018-11-02 15:57:32.82511+00
state_change | 2018-11-02 15:57:32.825112+00
wait_event_type | Lock
wait_event | relation
state | active
backend_xid | 575
backend_xmin | 575
query_id |
query | drop table t1 ;
backend_type | client backend
-[ RECORD 2 ]----+------------------------------
datid | 16387
datname | b2
pid | 2719
usesysid | 10
usename | postgres
application_name | psql
client_addr |
client_hostname |
client_port | -1
backend_start | 2018-11-02 15:56:17.173784+00
xact_start | 2018-11-02 15:57:25.311573+00
query_start | 2018-11-02 15:57:25.311573+00
state_change | 2018-11-02 15:57:25.311573+00
wait_event_type | Client
wait_event | ClientRead
state | idle in transaction
backend_xid |
backend_xmin |
query_id |
query | SELECT * FROM t1;
backend_type | client backend
```
Récupérer la liste des verrous en attente pour la requête bloquée.
**Exemple p240-1.** Exemple extrait du PDF\, page 240\.
```sql
SELECT * FROM pg_locks WHERE pid = 2718 AND NOT granted;
```
**Tableau p240-2.** Tableau extrait du PDF\, page 240\.
```text
-[ RECORD 1 ]------+--------------------
locktype | relation
database | 16387
relation | 16394
page |
tuple |
virtualxid |
transactionid |
```
**Exemple p241-1.** Exemple extrait du PDF\, page 241\.
```text
classid |
objid |
objsubid |
virtualtransaction | 5/7
pid | 2718
mode | AccessExclusiveLock
granted | f
fastpath | f
waitstart |
```
Récupérer le nom de l’objet dont le verrou n’est pas récupéré.
**Exemple p241-2.** Exemple extrait du PDF\, page 241\.
```sql
SELECT relname FROM pg_class WHERE oid=16394;
```
**Exemple p241-3.** Exemple extrait du PDF\, page 241\.
```text
-[ RECORD 1 ]
relname | t1
```
Noter que l’objet n’est visible dans `pg_class` que si l’on est dans la même base de données que lui. D’autre part, la colonne `oid` des tables systèmes n’est pas visible par défaut dans les versions antérieures à la 12, il faut demander explicitement son affichage pour la voir.
Récupérer la liste des verrous sur cet objet. Quel processus a verrouillé la table `t1`?
**Exemple p241-4.** Exemple extrait du PDF\, page 241\.
```sql
SELECT * FROM pg_locks WHERE relation = 16394;
```
**Tableau p241-1.** Tableau extrait du PDF\, page 241\.
```text
-[ RECORD 1 ]------+--------------------
locktype | relation
database | 16387
relation | 16394
page |
tuple |
virtualxid |
transactionid |
classid |
objid |
objsubid |
virtualtransaction | 4/10
pid | 2719
mode | AccessShareLock
granted | t
fastpath | f
waitstart |
-[ RECORD 2 ]------+--------------------
locktype | relation
database | 16387
relation | 16394
page |
tuple |
virtualxid |
transactionid |
classid |
objid |
objsubid |
virtualtransaction | 5/7
pid | 2718
```
**Exemple p242-1.** Exemple extrait du PDF\, page 242\.
```text
mode | AccessExclusiveLock
granted | f
fastpath | f
waitstart |
```
Le processus de PID 2718 (le `DROP TABLE`) demande un verrou exclusif sur `t1`, mais ce verrou n’est pas encore accordé (`granted` est à `false`). La session `idle in transaction` a acquis un verrou `Access Share`, normalement peu gênant, qui n’entre en conflit qu’avec les verrous exclusifs.
Retrouver les informations sur la session bloquante.
On retrouve les informations déjà affichées:
**Exemple p242-2.** Exemple extrait du PDF\, page 242\.
```sql
SELECT * FROM pg_stat_activity WHERE pid = 2719;
```
**Tableau p242-1.** Tableau extrait du PDF\, page 242\.
```text
-[ RECORD 1 ]----+------------------------------
datid | 16387
datname | b2
pid | 2719
usesysid | 10
usename | postgres
application_name | psql
client_addr |
client_hostname |
client_port | -1
backend_start | 2018-11-02 15:56:17.173784+00
xact_start | 2018-11-02 15:57:25.311573+00
query_start | 2018-11-02 15:57:25.311573+00
state_change | 2018-11-02 15:57:25.311573+00
wait_event_type | Client
wait_event | ClientRead
state | idle in transaction
backend_xid |
backend_xmin |
query_id |
query | SELECT * FROM t1;
backend_type | client backend
```
Retrouver cette information avec la fonction `pg_blocking_pids`.
Il existe une fonction pratique indiquant quelles sessions bloquent une autre. En l’occurence, notre `DROP TABLE t1` est bloqué par:
**Exemple p242-3.** Exemple extrait du PDF\, page 242\.
```sql
SELECT pg_blocking_pids(2718);
```
**Exemple p242-4.** Exemple extrait du PDF\, page 242\.
```text
-[ RECORD 1 ]----+-------
pg_blocking_pids | {2719}
```
Potentiellement, la session pourrait attendre la levée de plusieurs verrous de différentes sessions.
Détruire la session bloquant le `DROP TABLE`.
À partir de là, il est possible d’annuler l’exécution de l’ordre bloqué, le `DROP TABLE`, avec la fonction `pg_cancel_backend()`. Si l’on veut détruire le processus bloquant, il faudra plutôt utiliser la fonction `pg_terminate_backend()`:
**Exemple p243-1.** Exemple extrait du PDF\, page 243\.
```sql
SELECT pg_terminate_backend (2719) ;
```
dans ce dernier cas, vérifiez que la table a été supprimée, et que la session en statut `idle in transaction` affiche un message indiquant la perte de la connexion.
Pour créer un verrou, effectuer un `LOCK TABLE` dans une transaction qu’il faudra laisser ouverte.
**Exemple p243-2.** Exemple extrait du PDF\, page 243\.
```sql
LOCK TABLE t1;
```
Construire une vue `pg_show_locks` basée sur `pg_stat_activity`, `pg_locks`, `pg_class` qui permette de connaître à tout moment l’état des verrous en cours sur la base: processus, nom de l’utilisateur, âge de la transaction, table verrouillée, type de verrou.
Le code source de la vue `pg_show_locks` est le suivant:
**Exemple p243-3.** Exemple extrait du PDF\, page 243\.
```sql
CREATE VIEW pg_show_locks as
```
**Exemple p243-4.** Exemple extrait du PDF\, page 243\.
```sql
SELECT
```
**Exemple p243-5.** Exemple extrait du PDF\, page 243\.
```text
a.pid,
usename,
(now() - query_start) as age,
c.relname,
l.mode,
l.granted
FROM
pg_stat_activity a
LEFT OUTER JOIN pg_locks l
ON (a.pid = l.pid)
LEFT OUTER JOIN pg_class c
ON (l.relation = c.oid)
WHERE
c.relname !~ '^pg_'
ORDER BY
pid;
```
---
_Source : [manuel complet PDF](/downloads/dalibo/manuals/dba2-handout.pdf), révision 26.09, pages PDF 177-244. Les travaux pratiques et leurs solutions proviennent exclusivement de la version complète._
Pour poursuivre la lecture, voir [VACUUM et autovacuum](/fr/dba2/05-vacuum-autovacuum/#dba2-ch5).