5 VACUUM et autovacuum
5/ VACUUM et autovacuum
5.1 AU MENU
Principe & fonctionnement du
VACUUMOptions:
VACUUMseul,ANALYZE,FULL,FREEZEne pas les confondre!
Suivi
Autovacuum
Paramétrages
VACUUM est la contrepartie de la flexibilité du modèle MVCC. Derrière les différentes options de VACUUM se cachent plusieurs tâches très différentes. Malheureusement, la confusion est facile. Il est capital de les connaître et de comprendre leur fonctionnement.
Autovacuum permet d’automatiser le VACUUM et allège considérablement le travail de l’administrateur.
Il fonctionne généralement bien, mais il faut savoir le surveiller et l’optimiser.
5.2 VACUUM
5.2.1 VACUUM: nettoyage des lignes & lancement
VACUUMnettoie d’abord les lignes mortes
mais aussi d’autres opérations de maintenance
Lancement:
manuel par
VACUUM(SQL)manuel par
vacuumdb(shell, pour appels en masse)par le démon
autovacuum(seuils)
VACUUM est né du besoin de nettoyer les lignes mortes. Au fil du temps, il a été couplé à d’autres ordres (ANALYZE, VACUUM FREEZE) et s’est occupé d’autres opérations de maintenance (création de la visibility map par exemple). Des options permettent de réguler son activité. Son paramétrage n’est donc pas toujours très clair.
autovacuum est un processus de l’instance PostgreSQL. Il est activé par défaut, et il est fortement conseillé de le conserver ainsi. Dans le cas général, son fonctionnement convient et il ne gênera pas les utilisateurs. Au contraire, il faudra parfois le rendre plus agressif.
L’autovacuum ne gère pas toutes les variantes de VACUUM (notamment pas le FULL).
5.2.2 VACUUM ou ANALYZE en ligne de commande: vacuumdb
Nombreuses options:
--all: toutes les bases--jobs=…: connexions simultanées--schema=… --exclude-schema--echo --verboseNettoyage:
--[no|force]-index-cleanupStatistiques:
--analyze[-only]--missing-stats-only(v18)Exceptionnellement:
--full,--freeze
L’outil vacuumdb est un outil qui génère des ordres VACUUM après s’être connecté à PostgreSQL. Il se connecte comme n’importe quel client avec les options habituelles, depuis le serveur ou ailleurs. Il reprend les options de VACUUM (voir sa page de manuel1).
Il est plutôt destiné aux appels depuis le système ou comme tâche planifiée. Par rapport à un ordre VACUUM en SQL, vacuumdb facilite les appels en masse, avec notamment ces options:
--allpour nettoyer toutes les bases de données les unes après les autres;--jobspour paralléliser sur plusieurs sessions connectées;--parallelpour paralléliser le nettoyage des index d’une table sur plusieurs processus (outrepasse le paramètremax_parallel_maintenance_workers, soit 2 par défaut);des options pour ne traiter que certains objets ou en ignorer (
--table=…,--schema=…,--exclude-schema=…).
Les options --echo et --verbose sont conseillées pour voir et suivre ce qui est exécuté. Pour nettoyer un schéma par exemple:
Par défaut, vacuumdb procède au nettoyage de toutes les tables de la base (VACUUM).
Avec --analyze (-z), il procède aussi à l’ ANALYZE. Avec --analyze-only, il ne fait même que cela (il n’y a pas d’outil en ligne de commande dédié). --analyze-in-stages fait de même par étape, --analyze-in-stages fait de même en plusieurs passes avec une augmentation progressive de l’échantillonnage, l’objectif étant de produire rapidement des statistiques que l’on affine ensuite. L’option ne sert pratiquement que lors des migrations. À partir de PostgreSQL 18, --missing-stats-only est très pratique pour calculer uniquement les statistiques manquantes (nouvelles tables ou après une migration).
--full et --freeze correspondent aux ordres VACUUM FULL et VACUUM FREEZE et sont utilisés exceptionnellement.
D’autres options utiles sont:
--no-index-cleanuppour éviter le nettoyage des index (souvent long) si l’on est pressé, ou--force-index-cleanuppour le forcer;
--buffer-usage-limitaméliore les performances en augmentant la quantité de mémoire allouable (voirvacuum_buffer_usage_limitplus bas; à partir de PostgreSQL 16);--dry-runn’affiche que les ordresVACUUMetANALYZEsans les lancer (pratique pour créer un script);
5.2.3 Fonctionnement de VACUUM
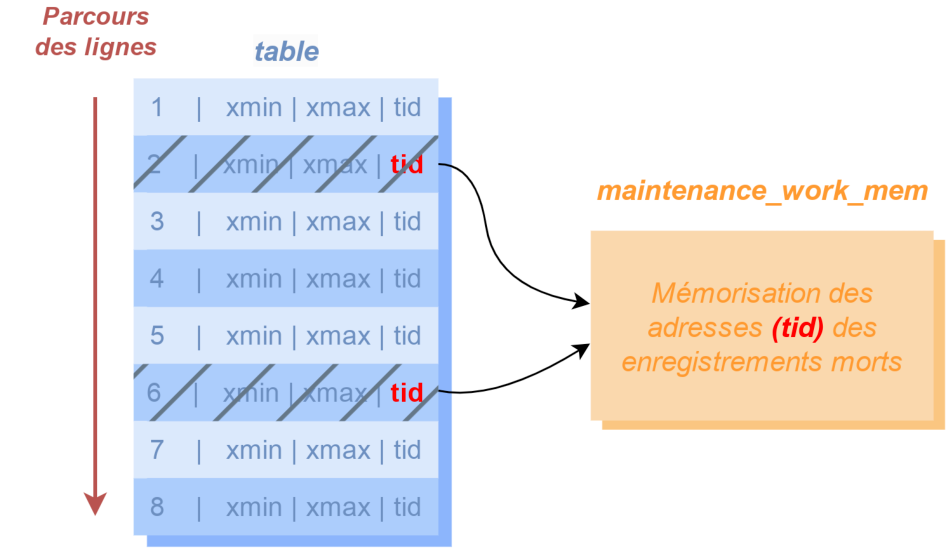
Un ordre VACUUM vise d’abord à nettoyer les lignes mortes. Le traitement VACUUM se déroule en trois passes. Cette première passe parcourt la table à nettoyer, à la recherche d’enregistrements morts. Un enregistrement est mort s’il possède un xmax qui correspond à une transaction validée, et que cet enregistrement n’est plus visible dans l’instantané d’aucune transaction en cours sur la base. D’autres lignes mortes portent un xmin d’une transaction annulée.
L’enregistrement mort ne peut pas être supprimé immédiatement: des enregistrements d’index pointent vers lui et doivent aussi être nettoyés. La session effectuant le VACUUM garde en mémoire la liste des adresses des enregistrements morts, à hauteur d’une quantité indiquée par le paramètre maintenance_work_mem. Si cet espace est trop petit pour contenir tous les enregistrements morts, VACUUM effectue plusieurs séries de ces trois passes.
5.2.4 Fonctionnement de VACUUM (suite)
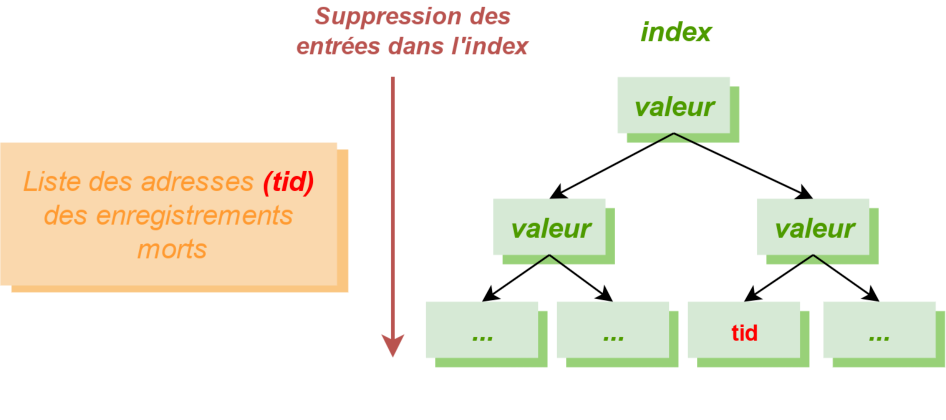
La seconde passe se charge de nettoyer les entrées d’index. VACUUM possède une liste de tid (tuple id) à invalider. Il parcourt donc toutes les pages de tous les index de la table à la recherche de ces tid et les supprime. En effet, les index sont triés afin de mettre en correspondance une valeur de clé (la colonne indexée par exemple) avec un tid. Il n’est par contre pas possible de trouver un tid directement. Les pages entièrement vides sont supprimées de l’arbre et stockées dans la liste des pages réutilisables, la Free Space Map (FSM).
Cette phase peut être longue sur les grosses tables, plus que le nettoyage de la table même. Elle peut être parallélisée avec la clause PARALLEL, chaque index pouvant être traité par un worker fonctionnant sur un CPU. Un index peut être ignoré s’il n’y a pas grand-chose à nettoyer.
Qwe
- Si le temps presse, le nettoyage des index peut être désactivé avec l’option
INDEX_CLEANUP off(voir plus loin):
5.2.5 Fonctionnement de VACUUM (suite)
<1 | NB: L’espace est rarement rendu à l’OS!
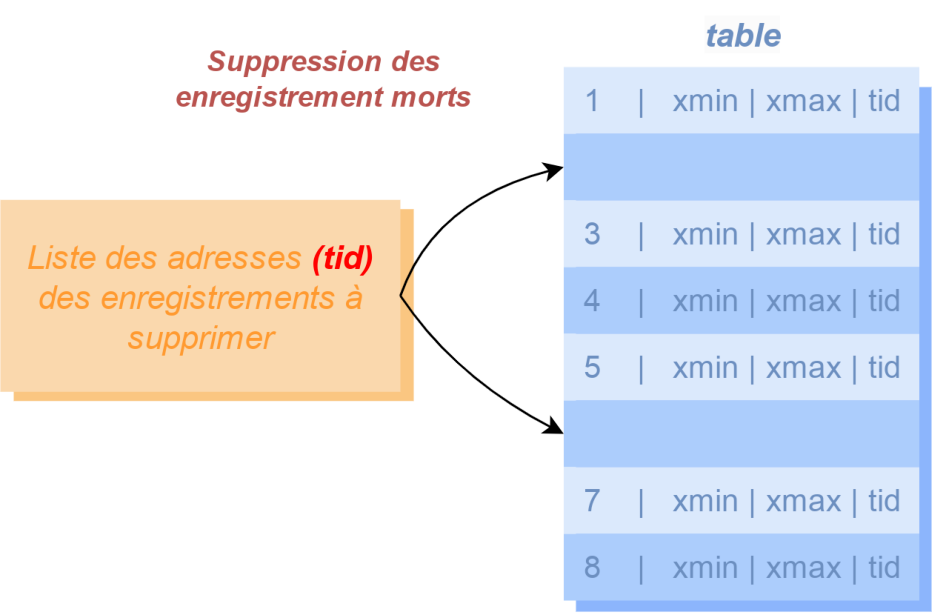
Maintenant qu’il n’y a plus d’entrée d’index pointant sur les enregistrements morts identifiés, ceux-ci peuvent disparaître. C’est le rôle de cette passe. Quand un enregistrement est supprimé d’un bloc, ce bloc est complètement réorganisé afin de consolider l’espace libre. Cet espace est renseigné dans la Free Space Map (FSM).
Une fois cette passe terminée, si le parcours de la table n’a pas été terminé lors de la passe précédente, le travail reprend où il en était du parcours de la table.
Si les derniers blocs de la table sont vides, ils sont rendus au système (si le verrou nécessaire peut être obtenu, et si l’option TRUNCATE n’est pas off). C’est le seul cas où VACUUM réduit la taille de la table. Les espaces vides (et réutilisables) au milieu de la table constituent le bloat (littéralement « boursouflure » ou « gonflement », que l’on peut aussi traduire par fragmentation).
Les statistiques d’activité sont aussi mises à jour.
5.3 LES OPTIONS DE VACUUM
Quelles tâches?
Comment améliorer les performances?
Quelles options en cas d’urgence?
Autres options
5.3.1 Tâches d’un VACUUM
Ne pas confondre:
VACUUMseulnettoyage des lignes mortes, visibility map, hint bits
ANALYZEstatistiques sur les données
VACUUM (ANALYZE)nettoyage & statistiques
VACUUM (FREEZE)gel des lignes (parfois gênant ou long)
VACUUM FULLbloquant!
jamais lancé par l’autovacuum
VACUUM
Par défaut, VACUUM procède principalement au nettoyage des lignes mortes. Pour que cela soit efficace, il met à jour la visibility map, et la crée au besoin. Au passage, il peut geler certaines lignes rencontrées.
L’autovacuum le déclenchera sur les tables en fonction de l’activité.
Le verrou SHARE UPDATE EXCLUSIVE posé protège la table contre les modifications simultanées du schéma, et ne gêne généralement pas les opérations, sauf les plus intrusives (il empêche par exemple un LOCK TABLE). L’autovacuum arrêtera spontanément un VACUUM qu’il aurait lancé et qui gênerait; mais un VACUUM lancé manuellement continuera jusqu’à la fin.
VACUUM ANALYZE
ANALYZE existe en tant qu’ordre séparé, pour rafraîchir les statistiques sur un échantillon des données, à destination de l’optimiseur. L’autovacuum se charge également de lancer des ANALYZE en fonction de l’activité.
L’ordre VACUUM ANALYZE (ou VACUUM (ANALYZE)) force le calcul des statistiques sur les données en même temps que le VACUUM.
VACUUM FREEZE
VACUUM FREEZE procède au « gel » des lignes visibles par toutes les transactions en cours sur l’instance, afin de parer au problème du wraparound des identifiants de transaction.
Un ordre FREEZE n’existe pas en tant que tel.
Préventivement, lors d’un VACUUM simple, l’autovacuum procède au gel de certaines des lignes rencontrées. De plus, il lancera un VACUUM FREEZE sur une table dont les plus vieilles transactions dépassent un certain âge. Ce peut être très long, et très lourd en écritures si une grosse table doit être entièrement gelée d’un coup. Autrement, l’activité n’est qu’exceptionnellement gênée (voir plus bas). L’opération de gel sera détaillée plus loin.
VACUUM FULL
L’ordre VACUUM FULL permet de reconstruire la table sans les espaces vides. C’est une opération très lourde, risquant de bloquer d’autres requêtes à cause du verrou exclusif qu’elle pose (on ne peut même plus lire la table!), mais il s’agit de la seule option qui permet de réduire la taille de la table au niveau du système de fichiers de façon certaine.
Il faut prévoir l’espace disque (la table est reconstruite à côté de l’ancienne, puis l’ancienne est supprimée). Les index sont reconstruits au passage. Un VACUUM FULL gèle agressivement les lignes, et effectue donc au passage l’équivalent d’un FREEZE.
L’autovacuum ne lancera jamais un VACUUM FULL!
Il existe aussi un ordre CLUSTER, qui permet en plus de trier la table suivant un des index.
5.3.2 Options de performance de VACUUM
Index:
PARALLEL(défaut: 2)Taille du buffer ring (v16+)
VACUUM (BUFFER_USAGE_LIMIT 2MB)paramètre
vacuum_buffer_usage_limit256 ko ou 2 Mo par défaut, à monter
SKIP_DATABASE_STATS,ONLY_DATABASE_STATS(v16+)Éviter les verrous
SKIP_LOCKEDSET lock_timeout = '1s'
PARALLEL:
L’option PARALLEL permet le traitement parallélisé des index. Le nombre indiqué après PARALLEL précise le niveau de parallélisation souhaité. Par exemple:
La valeur par défaut (2) découle du paramètre max_parallel_maintenance_workers.
SKIP_DATABASE_STATS, ONLY_DATABASE_STATS:
En fin d’exécution d’un VACUUM, même sur une seule table, le champ pg_database.datfrozenxid est mis à jour. Il contient le numéro de la transaction la plus ancienne non encore gelée dans toute la base de données. Cette opération impose de parcourir pg_class pour récupérer le plus ancien des numéros de transaction de chaque table (relfrozenxid), Or cette mise à jour n’est utile que pour l’autovacuum et le VACUUM FREEZE, et a rarement un caractère d’urgence.
Depuis la version 16, l’option SKIP_DATABASE_STATS demande au VACUUM d’ignorer la mise à jour de l’identifiant de transaction. Le principe est d’activer cette option pour les nettoyages en masse. À l’inverse, l’option ONLY_DATABASE_STATS demande de ne faire que la mise à jour du datfrozenxid, ce qui peut être fait une seule fois en fin de traitement. L’outil vacuumdb procède ainsi automatiquement si le serveur est en version 16 minimum. Par exemple:
BUFFER_USAGE_LIMIT:
Cette option apparue en version 16 permet d’augmenter la taille de la mémoire partagée que peuvent utiliser VACUUM, et ANALYZE. Par défaut, cet espace nommé buffer ring n’est que de 256 ko de mémoire partagée, une valeur assez basse, cela pour protéger le cache (shared buffers). Si cette mémoire ne suffit pas, PostgreSQL doit recycler certains de ces buffers, d’où une écriture possible de journaux sur disque, avec un ralentissement à la clé.
Monter la taille du buffer ring avec BUFFER_USAGE_LIMIT permet une exécution plus rapide de VACUUM, et génère moins de journaux. De manière globale, on peut aussi modifier le paramètre vacuum_buffer_usage_limit. Les valeurs vont de 128 ko à 16 Go; 0 désactive le buffer ring, il n’y a alors aucune limite en terme d’utilisation du cache.
La taille par défaut n’est que de 2 Mo (et même seulement 256 ko jusque PostgreSQL 16 inclus). Les machines modernes permettent de monter ce paramètre à quelques mégaoctets sans problème, pour un gain en vitesse d’écriture très appréciable2. Il peut y avoir un impact négatif sur les autres requêtes si le débit en lecture ou écriture du VACUUM augmente trop. La valeur 0 est envisageable dans le cas d’une plage de maintenance où une purge du cache de PostgreSQL n’aurait pas de gros impact.
Exemples d’utilisation:
Les verrous, SKIP_LOCKED et lock_timeout:
L’option SKIP_LOCKED permet d’ignorer toute table pour laquelle la commande VACUUM ne peut pas obtenir immédiatement son verrou. Cela évite de bloquer le VACUUM sur une table, et permet d’éviter un empilement des verrous derrière celui que le VACUUM veut poser, surtout en cas de VACUUM FULL. La commande passe alors à la table suivante à traiter. Exemple:
Une technique un peu différente est de paramétrer dans la session un petit délai avant abandon en cas de problème de verrou. Là encore, cela vise à limiter les empilements de verrou sur une base active. Par contre, comme l’ordre tombe immédiatement en erreur après le délai, il est plus adapté aux ordres ponctuels sur une table.
5.3.3 Options pour un VACUUM en urgence
VACUUM (SKIP_DATABASE_STATS, /* PG 16+ */ INDEX_CLEANUP off , /* défaut: auto */ PROCESS_TOAST off , TRUNCATE off , BUFFER_USAGE_LIMIT '1GB' /* voire 0 (PG 16+) */ ); VACUUM (ONLY_DATABASE_STATS); /* PG 16+ */
Ces options sont surtout destinées à désactiver certaines étapes d’un VACUUM quand le temps presse vraiment.
La plupart n’ont pas de sens avec VACUUM FULL (qui reconstruit la table, les index, les tables TOAST).
Les options non traitées plus haut sont:
INDEX_CLEANUP:
L’option INDEX_CLEANUP à on déclenche systématiquement le nettoyage des index, c’est-à-dire que le VACUUM supprime les enregistrements de l’index qui pointent vers des lignes mortes de la table. Il est nécessaire de parcourir tout l’index, et cette opération est parfois la plus longue d’un VACUUM.
Le défaut d’ INDEX_CLEANUP est auto: le VACUUM ne traite alors un index que si 2 % de blocs de la table sont à nettoyer. Ce seuil est vite atteint si les pointeurs de lignes mortes sont répartis dans la table, et non regroupés. En effet, le but est de garder une visibility map à jour.
Quand il faut nettoyer des lignes mortes urgemment dans une grosse table, la valeur off fait gagner beaucoup de temps:
Les index ne sont alors pas nettoyés (et quelques pointeurs de lignes dans la table non plus). Ces index conservent leur fragmentation, mais c’est généralement un souci mineur. Il faudra tout de même prévoir un autre VACUUM classique plus tard, éventuellement un REINDEX.
Cette option existe aussi sous la forme d’un paramètre de stockage (vacuum_index_cleanup) propre à la table. La valeur off peut accélérer l’ autovacuum, mais il ne faut surtout pas oublier un VACUUM (INDEX_CLEANUP on) périodique sur les tables concernées.
PROCESS_TOAST:
Cette option active ou non le traitement de la partie TOAST associée à la table (parfois la partie la plus volumineuse d’une table). Elle est activée par défaut. Son utilité est la même que pour INDEX_CLEANUP.
TRUNCATE:
L’option TRUNCATE (à on par défaut) permet de tronquer les derniers blocs vides d’une table. TRUNCATE off évite d’avoir à poser un verrou exclusif certes court, mais parfois gênant.
Cette option existe aussi sous la forme d’un paramètre de stockage de table (vacuum_truncate).
BUFFER_USAGE_LIMIT:
Le ring buffer du VACUUM étant par défaut très réduit, une augmentation, même modeste, accélère les écritures. À la limite, s’il n’y a pas d’autre activité, on peut lui octroyer tout le cache de PostgreSQL (valeur 0).
5.3.4 Autres options de VACUUM
VERBOSEPonctuellement:
DISABLE_PAGE_SKIPPING
VERBOSE:
Cette option affiche un grand nombre d’informations sur ce que fait la commande. En général, c’est une bonne idée de l’activer:
DISABLE_PAGE_SKIPPING:
Par défaut, PostgreSQL ne traite que les blocs modifiés depuis le dernier VACUUM, ce qui est un gros gain en performance (l’information est stockée dans la Visibility Map, qui est généralement un tout petit fichier).
Activer l’option DISABLE_PAGE_SKIPPING force l’analyse de tous les blocs de la table. La table est intégralement reparcourue. Ce peut être utile en cas de problème, notamment pour reconstruire cette Visibility Map.
Mélange des options:
Il est possible de mélanger toutes ces options presque à volonté, et de préciser plusieurs tables à nettoyer:
5.4 SUIVI DU VACUUM
pg_stat_activityoutopLa table est-elle suffisamment nettoyée?
Vue
pg_stat_user_tableslast_vacuum/last_autovacuumlast_analyze/last_autoanalyzedurées
total_*_timelog_autovacuum_min_duration = 0ms(si possible)
Un VACUUM, y compris lancé par l’autovacuum, apparaît dans pg_stat_activity et le processus est visible comme processus système avec top ou ps:
$ ps faux … postgres 3470724 0.0 0.0 12985308 6544? Ss 13:58 0:02 \_ postgres: 13/main: autovacuum launcher postgres 795432 7.8 0.0 14034140 13424? Rs 16:22 0:01 \_ postgres: 13/main: autovacuum worker pgbench1000p10
Il est fréquent de se demander si l’autovacuum s’occupe suffisamment d’une table qui grossit ou dont les statistiques semblent périmées. La vue pg_stat_user_tables contient quelques informations.
Elle comprend les dates et nombres des VACUUM déclenchés automatiquement (last_autovacuum, autovacuum_count) et de ceux lancés manuellement ou par une application (last_vacuum, vacuum_count). À partir de PostgreSQL 18, les durées totales (en millisecondes) sont aussi calculées (total_[auto]vacuum_time). Comptes et durées se calculent depuis la réinitialisation des statistiques.
Des champs similaires existent pour ANALYZE.
Dans l’exemple ci-dessous, 161 113 lignes ont été modifiées depuis le rafraîchissement des statistiques (champ n_mod_since_analyze). Il reste 106 287 lignes mortes à nettoyer, contre 10 millions vivantes (n_live_tup). Aucune n’a été insérée depuis le dernier nettoyage (n_ins_since_vacuum).
La vue pg_stat_user_tables peut être réinitialisée après un crash ou la promotion d’un serveur secondaire en primaire. Il est alors conseillé de lancer un VACUUM ANALYZE global.
De plus, pour suivre les autovacuums dans les traces, il est courant et conseillé de passer le paramètre log_autovacuum_min_duration à 0 ou à une valeur faible comme 1s (selon la taille des logs générés). Un outil comme pgBadger permet de voir aisément les tables les plus sollicitées par l’autovacuum.
5.4.1 Progression du VACUUM
Pour
VACUUMsimple /VACUUM FREEZEvue
pg_stat_progress_vacuumblocs parcourus / nettoyés
nombre de passes dans l’index
Partie
ANALYZEpg_stat_progress_analyzeManuel ou via autovacuum
Pour
VACUUM FULLvue
pg_stat_progress_cluster
La vue pg_stat_progress_vacuum contient une ligne par VACUUM (simple ou FREEZE) en cours d’exécution:
Dans cet exemple, le VACUUM est exécuté par le processus indiqué par pid. La phase est le parcours de la table (scanning heap). Par la suite, peuvent apparaître les phases liées au nettoyage des index (vacuuming indexes …), entre autres.
heap_blks_scanned indique que le VACUUM a parcouru 2 378 638 blocs (sur 6 599 090 blocs) lors de la copie d’écran, mais ce chiffre inclut les blocs ignorés grâce à la visibility map, souvent l’essentiel de la table.
Pour les détails, voir la documentation officielle3. À noter que le suivi du VACUUM dans les index (les deux derniers champs) nécessite au moins PostgreSQL 17. C’est souvent la partie la plus longue d’un VACUUM.
Dans le cas d’un VACUUM ANALYZE, la seconde partie de recueil des statistiques pourra être suivie dans pg_stat_progress_analyze:
Les vues précédentes affichent aussi bien les opérations lancées manuellement que celles décidées par l’autovacuum.
Par contre, pour un VACUUM FULL, il faut suivre la progression avec la vue pg_stat_progress_cluster. Cette vue est utilisable aussi avec l’ordre CLUSTER, d’où le nom. Exemple:
Ces vues n’affichent que les opérations en cours, elles n’historisent rien. Si aucun VACUUM n’est en cours, elles n’afficheront rien.
5.4.2 Droit de lancer un VACUUM
- Propriétaire
- Superutilisateur
- Inclus dans droit de maintenance (v17)
VACUUM est une opération de maintenance ne pouvant être effectuée que par:
le propriétaire de la table;
un superutilisateur;
à partir de PostgreSQL 17, un utilisateur possédant le droit de maintenir la table, soit via le rôle
pg_maintainou par unGRANT MAINTAINsur la table. (Ce droit de maintenance inclut d’autres droits, comme les droits deANALYZE,CLUSTER,LOCK TABLE,REFRESH MATERIALIZED VIEWetREINDEX, mais pas celui de lire les données.)
Sans droit de maintenance, le VACUUM ne fonctionne pas pour un utilisateur non propriétaire de la table:
Si maintenance devient membre du rôle pg_maintain, tout fonctionne:
Avant la version 17, il est toujours possible d’avoir un groupe propriétaire de l’objet et d’ajouter un rôle de maintenance comme membre de ce groupe. Il aura le droit de lire les données. Mais si jamais un objet est créé par quelqu’un sans transférer la propriété au groupe, le rôle de maintenance ne peut faire d’opération de maintenance sur cet objet.
5.5 AUTOVACUUM
5.5.1 Autovacuum: buts & contraintes
Processus autovacuum
But: ne plus s’occuper de
VACUUMSuit l’activité
Seuil dépassé => worker dédié
Bridé, s’arrête en cas de verrou
Gère:
VACUUM,ANALYZE,FREEZEmais pas
FULL
Lancer manuellement des VACUUM étant fastidieux, un démon autovacuum se charge de la tâche. Le principe est le suivant:
Le démon autovacuum launcher s’occupe de lancer des workers régulièrement sur les différentes bases. Ce nouveau processus inspecte les statistiques sur les tables (vue pg_stat_all_tables): nombres de lignes insérées, modifiées et supprimées. Quand certains seuils sont dépassés sur un objet, le worker effectue un VACUUM, un ANALYZE, voire un VACUUM FREEZE (mais jamais, rappelons-le, un VACUUM FULL).
Sauf exception, un VACUUM lancé par l’ autovacuum est arrêté si le verrou qu’il pose entre en conflit avec l’activité normale.
Le nombre de ces workers est limité, afin de ne pas engendrer de charge trop élevée. De même, les débits en lecture/écriture sont limités.
Tout cela se paramètre.
Pour les détails précis sur tout qui suit, ne pas hésiter à consulter la documentation officielle4.
5.5.2 Paramétrage du déclenchement de l’autovacuum
autovacuum(on!)autovacuum_naptime(1 min)autovacuum_max_workers(3)plusieurs workers simultanés sur une base
un seul par table
(v18) changement à chaud jusque
autovacuum_worker_slots(16)
Activation & désactivation de l’autovacuum:
autovacuum (on par défaut) détermine si le démon autovacuum doit être activé. À off, il ne se déclenche pas spontanément.
Il est fortement conseillé de laisser autovacuum à on!
S’il le faut vraiment, il est possible de désactiver l’autovacuum sur une table précise:
Mais cela est très rare, et impose que le nettoyage soit géré manuellement.
autovacuum_naptime:
autovacuum_naptime est le temps d’attente minimum entre deux périodes de vérification sur une même base (1 minute par défaut). Son but est de ne pas déclencher l’autovacuum trop souvent et inutilement sur une même base. C’est la principale raison pour laquelle le déclenchement de l’autovacuum après des modifications de tables n’est pas instantané. Il arrive rarement qu’on réduise autovacuum_naptime quand l’autovacuum ne passe pas assez souvent sur certaines tables très actives.
Workers de l’autovacuum:
autovacuum_max_workers est le nombre maximum de workers que l’autovacuum peut utiliser simultanément, chacun s’occupant d’une table (ou partition de table). Chaque table ne peut être traitée simultanément que par un unique worker.
La valeur par défaut (3) est généralement suffisante. Néanmoins, s’il y a fréquemment trois autovacuum workers travaillant en même temps, et surtout si cela dure, il peut être nécessaire d’augmenter ce paramètre. Cela est fréquent quand il y a de très nombreuses tables.
Noter qu’il faut alors augmenter certaines ressources allouées au nettoyage, car les workers se les partagent, comme le paramètre autovacuum_vacuum_cost_limit (voir plus bas).
Une exception est autovacuum_work_mem qui, lui, est une quantité de RAM utilisable par chaque worker indépendamment, et par défaut égal à maintenance_work_mem, souvent relativement élevé.
Depuis PostgreSQL 18, autovacuum_max_workers peut être changé à chaud, ce qui n’était pas le cas auparavant. La valeur peut être augmentée jusqu’à une autre valeur fixée par autovacuum_worker_slots (valeur par défaut 16, qui devrait suffire).
5.5.3 Déclenchement de l’autovacuum
- Seuil de déclenchement = threshold + scale factor × nb lignes de la table
Dans le cas général, l’autovacuum déclenche un VACUUM ou un ANALYZE à partir de seuils calculés sur le principe d’un nombre de lignes minimal (threshold) et d’une proportion de la table existante (scale factor) de lignes modifiées, insérées ou effacées.
Ces seuils pourront être adaptés table par table en modifiant les paramètres qui suivent.
5.5.4 Déclenchement de l’autovacuum: VACUUM
Pour
VACUUM(modifications/suppressions)autovacuum_vacuum_scale_factor(20 %)autovacuum_vacuum_threshold(50)(v18) seuil
autovacuum_vacuum_max_threshold(100 Mlignes)Pour
VACUUM(insertions)autovacuum_vacuum_insert_threshold(1000)autovacuum_vacuum_insert_scale_factor(20 %)
5.5.4.1 VACUUM automatique suite aux modifications
Pour le VACUUM, si on considère les enregistrements morts (supprimés ou anciennes versions de lignes), la condition de déclenchement est:
nb_enregistrements_morts (pg_stat_all_tables.n_dead_tup) >= autovacuum_vacuum_threshold+ autovacuum_vacuum_scale_factor × nb_enregs (pg_class.reltuples)
où, par défaut:
autovacuum_vacuum_thresholdvaut 50 lignes;autovacuum_vacuum_scale_factorvaut 0,2 soit 20 % de la table.
Donc, par exemple, dans une table d’un million de lignes, modifier 200 050 lignes provoque le passage d’un VACUUM.
Pour les grosses tables avec de l’historique, modifier 20 % de la volumétrie peut être extrêmement long. Quand l’ autovacuum lance enfin un VACUUM, celui-ci a donc beaucoup de travail et peut durer longtemps et générer beaucoup d’écritures. Il est donc fréquent de descendre la valeur de autovacuum_vacuum_scale_factor à quelques pour cent sur les grosses tables.
S’il faut modifier un paramètre, il est préférable de ne pas le faire au niveau global, mais de cibler les tables où cela est nécessaire. Par exemple, l’ordre suivant réduit à 5 % de la table le nombre de lignes à modifier avant que l’ autovacuum y lance un VACUUM:
Une alternative est de monter autovacuum_vacuum_threshold à un nombre de lignes élevé et de descendre autovacuum_vacuum_scale_factor à 0, mais il faut alors calculer le nombre de lignes qui déclenchera le nettoyage, et cela dépend fortement de la table et de sa fréquence de mise à jour. Par exemple, si on estime que la table doit être nettoyée après 5 millions de modifications ou suppressions:
Dans le même esprit, PostgreSQL 18 possède un paramètre autovacuum_vacuum_max_threshold (par défaut 100 millions): à partir de ce nombre de lignes modifiées, l’autovacuum lance un VACUUM sur la table, quels que soient les paramètres précédents. Par exemple, une table avec 10 milliards de lignes est nettoyée après 100 millions de modifications, et non après 2 milliards comme en PostgreSQL 17 avec le paramétrage par défaut. Ce seuil assez élevé peut être ajusté au besoin. La commande suivante au niveau d’une table est aussi possible et équivaut aux deux ordres précédents:
La valeur -1 désactive ce seuil.
5.5.4.2 VACUUM automatique suite aux insertions
Le démon autovacuum lance également un VACUUM sur une table après un certain nombre d’insertions de nouvelles lignes. Dans ce cas, l’intérêt n’est pas de nettoyer des lignes, mais principalement de créer et rafraîchir la visibility map, nécessaire à certaines optimisations, et de procéder à un gel des lignes plus régulier5 Les paramètres en jeu sont différents:
nb_enregistrements_insérés (pg_stat_all_tables.n_ins_since_vacuum) >= autovacuum_vacuum_insert_threshold
+ autovacuum_vacuum_insert_scale_factor × nb_enregs (pg_class.reltuples)
Par défaut, ils valent aussi 50 lignes et 0,2.
5.5.5 Adapter le déclenchement de l’autovacuum: VACUUM
- Pour une grosse table:
- Ne pas être trop agressif!
Ces exemples reprennent les trois méthodes de modification de paramétrage sur une grande table: réduire le scale factor; poser un seuil fixe et un scale factor nul; poser un seuil maximum à la valeur calculée par défaut.
Une méthode n’est pas meilleure qu’une autre. Le choix dépend du nombre de bases et tables à maintenir, des volumétries, de leur croissance prévisible…
Ne rendez pas l’autovacuum trop agressif! Il doit tourner assez souvent sur les tables importantes, mais pas en permanence dès qu’il y a quelques modifications! Le premier risque est de saturer les workers.
5.5.6 Déclenchement de l’autovacuum: ANALYZE
Pour
ANALYZEautovacuum_analyze_scale_factor(10 %)autovacuum_analyze_threshold(50)Adapter pour une grosse table:
Pour le lancement automatique d’un ANALYZE, le principe est le même. Il n’y a que deux paramètres de calcul du seuil, qui prennent en compte toutes les lignes modifiées ou insérées:
où, par défaut:
autovacuum_analyze_thresholdvaut 50 lignes;autovacuum_analyze_scale_factorvaut 0,1, soit 10 %.
Dans une table d’un million de lignes, modifier 100 050 lignes provoque donc le passage d’un ANALYZE.
Là encore, il est fréquent de modifier ces paramètres sur les grosses tables pour rafraîchir les statistiques plus fréquemment.
5.6 PARAMÉTRAGE DE VACUUM & AUTOVACUUM
VACUUM vs autovacuum
Mémoire
Mémoire
Gestion des coûts
Gel des lignes
En fonction de la tâche exacte, de l’agressivité acceptable ou de l’urgence, plusieurs paramètres peuvent être mis en place.
Ces paramètres peuvent différer (par le nom ou la valeur) selon qu’ils s’appliquent à un VACUUM lancé manuellement ou par script, ou à un processus lancé par l’autovacuum.
5.6.1 VACUUM vs autovacuum
| VACUUM manuel | autovacuum |
|---|---|
| Urgent | Arrière-plan |
| Pas de limite | Peu agressif |
| Paramètres | Les mêmes + paramètres de surcharge |
Quand on lance un ordre VACUUM, il y a souvent urgence, ou l’on est dans une période de maintenance, ou dans un batch. Les paramètres que nous allons voir ne cherchent donc pas, par défaut, à économiser des ressources.
À l’inverse, un VACUUM lancé par l’autovacuum ne doit pas gêner une production peut-être chargée. Il existe donc des paramètres autovacuum_* surchargeant les précédents, et beaucoup plus conservateurs.
5.6.2 Mémoire
Quantité de mémoire allouable
maintenance_work_memautovacuum_work_memmontés souvent à ½ à 1 Go
Impact
VACUUMnettoyage & construction d’index
maintenance_work_mem est la quantité de mémoire qu’un processus effectuant une opération de maintenance (c’est-à-dire n’exécutant pas des requêtes classiques comme SELECT, INSERT, UPDATE …) est autorisé à allouer pour sa tâche de maintenance.
Cette mémoire est utilisée lors de la construction d’index ou l’ajout de clés étrangères et, dans le contexte de VACUUM, pour stocker les adresses des enregistrements pouvant être recyclés. Cette mémoire est remplie pendant la phase 1 du processus de VACUUM, tel qu’expliqué plus haut. Rappelons qu’une adresse d’enregistrement (tid, pour tuple id) a une taille de 6 octets et est composée du numéro de bloc dans la table (4 octets), et du numéro d’enregistrement dans le bloc (2 octets), par exemple (0,1), (3164,98) ou (5351510,42).
Le défaut de 64 Mo est assez faible. Si tous les enregistrements morts d’une table ne tiennent pas dans maintenance_work_mem, VACUUM est obligé de faire plusieurs passes de nettoyage, donc plusieurs parcours complets de chaque index. Une valeur plus élevée de maintenance_work_mem est donc conseillée: s’il est déjà possible de stocker plusieurs dizaines de millions d’enregistrements à effacer dans 256 Mo, 1 Go peut être utile lors de très grosses purges.
PostgreSQL 17 améliore beaucoup la consommation mémoire et la vitesse de nettoyage des index, et doit rendre rarissime les nettoyages d’index en plusieurs passes.
PostgreSQL 17 fait aussi disparaître une limite de 1 Go pour le nettoyage des index: VACUUM ne sait pas en utiliser plus jusque PostgreSQL 16. Par contre, l’indexation de grosses tables pourra toujours bénéficier d’une valeur supérieure à 1 Go.
Rappelons que plusieurs VACUUM ou autovacuum peuvent fonctionner simultanément et consommer chacun un maintenance_work_mem! (Voir autovacuum_max_workers plus haut.)
autovacuum_work_mem permet de surcharger maintenance_work_mem spécifiquement pour l’autovacuum. Par défaut les deux sont identiques, et l’on conserve généralement cette configuration. Au besoin, maintenance_work_mem peut être surchargé le temps d’une session.
5.6.3 Bridage du VACUUM et de l’autovacuum
Pauses régulières après une certaine activité
Par bloc traité
vacuum_cost_page_hit/_miss/_dirty(1/2/20)jusque total de:
vacuum_cost_limit(200)pause:
vacuum_cost_delay(en manuel: 0 ms!)Surcharge pour l’autovacuum
autovacuum_vacuum_cost_limit(identique)autovacuum_vacuum_cost_delay(2 ms)=> débit en écriture max: ~40 Mo/s
Pour accélérer: augmenter la limite
Principe:
Les paramètres suivant permettent d’éviter qu’un VACUUM ne gêne les autres sessions en saturant le disque. Le principe est de provoquer une pause après qu’une certaine activité a été réalisée.
Paramètres de coûts:
Ces trois paramètres « quantifient » l’activité de VACUUM, affectant un coût arbitraire à chaque fois qu’une opération est réalisée:
vacuum_cost_page_hit: coût d’accès à chaque page présente dans le cache de PostgreSQL(valeur: 1);
vacuum_cost_page_miss: coût d’accès à chaque page hors de ce cache (valeur: 2);vacuum_cost_page_dirty: coût de modification d’une page, et donc de son écriture (valeur:20).
Il est déconseillé de modifier ces paramètres de coût.
Pause:
Quand le coût cumulé atteint un seuil, l’opération de nettoyage marque une pause. Elle est gouvernée par deux paramètres:
vacuum_cost_limit: coût cumulé à atteindre avant de déclencher la pause (défaut: 200);vacuum_cost_delay: temps à attendre (défaut: 0 ms!)En conséquence, les
VACUUMlancés manuellement (en ligne de commande ou viavacuumdb) ne sont pas freinés par ce mécanisme et peuvent donc entraîner de fortes écritures! Mais c’est généralement ce que l’on veut dans un batch ou en urgence, et il vaut mieux alors être le plus rapide possible.
Pour les urgences, rappelons que les options INDEX_CLEANUP off ou PROCESS_TOAST off permettent aussi d’ignorer le nettoyage des index ou des TOAST.
Paramétrage pour le VACUUM manuel:
Il est conseillé de ne pas toucher au paramétrage par défaut de vacuum_cost_limit et vacuum_cost_delay.
Si on doit lancer un VACUUM manuellement en limitant son débit, procéder comme suit dans une session:
Avec vacuumdb, il faudra passer par la variable d’environnement PGOPTIONS.
Paramétrage pour l’autovacuum:
Les VACUUM d’autovacuum, eux, sont par défaut limités en débit pour ne pas gêner l’activité normale de l’instance. Deux paramètres surchargent les précédents:
autovacuum_vacuum_cost_limitvaut par défaut -1, donc reprend la valeur 200 devacuum_cost_limit;autovacuum_vacuum_cost_delayvaut par défaut 2 ms.
Un (autovacuum_) vacuum_cost_limit à 200 consiste à traiter au plus 200 blocs lus en cache (car vacuum_cost_page_hit = 1), soit 1,6 Mo, avant de faire la pause de 2 ms. Si ces blocs doivent être écrits, on descend en-dessous de 10 blocs traités avant chaque pause (vacuum_cost_page_dirty = 20) avant la pause de 2 ms, d’où un débit en écriture maximal de l’autovacuum de 40 Mo/s Cela s’observe aisément par exemple avec iotop.
Ce débit est partagé équitablement entre les différents workers lancés par l’autovacuum (sauf paramétrage spécifique au niveau de la table).
Pour rendre l’autovacuum plus rapide, il est préférable d’augmenter autovacuum_vacuum_cost_limit au-delà de 200, plutôt que de réduire autovacuum_vacuum_cost_delay qui n’est qu’à 2 ms, pour ne pas monopoliser le disque. (Exception : les versions antérieures à la 12, car autovacuum_vacuum_cost_delay valait alors 20 ms et le débit en écriture saturait à 4 Mo/s ! La valeur 2 ms tient mieux compte des disques actuels.)
La prise en compte de la nouvelle valeur de la limite par les workers en cours sur les tables est automatique à partir de PostgreSQL 16. Dans les versions précédentes, il faut arrêter les workers en cours (avec pg_cancel_backend()) et attendre que l’autovacuum les relance. Quand
autovacuum_max_workers est augmenté, prévoir aussi d’augmenter autovacuum_vacuum_cost_limit, sinon le débit global ne montera pas. Il faut d’ailleurs vérifier que les disques peuvent supporter la charge en plus.
Sur le sujet, voir la conférence de Robert Haas à PGconf.EU 2023 à Prague6.
5.6.4 Paramétrage du FREEZE (1)
Le but est de geler les numéros de transaction assez vite:
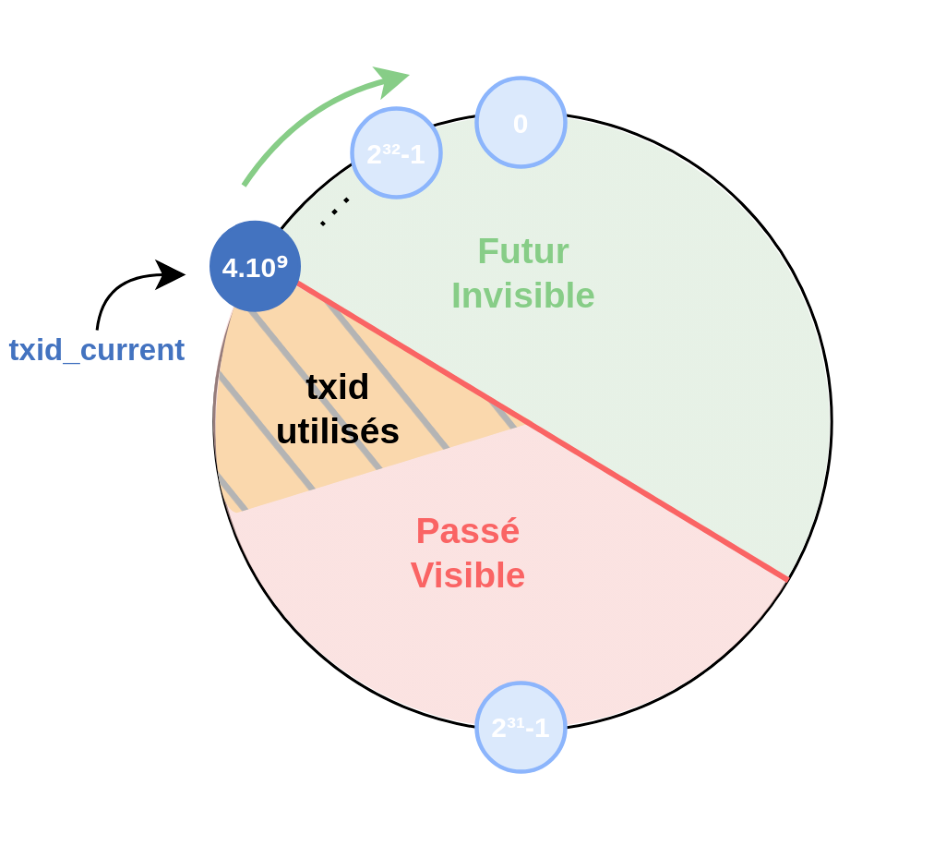
Rappelons que les numéros de transaction stockés sur les lignes ne sont stockés que sur 32 bits, et sont recyclés. Il y a donc un risque de mélanger le passé et le futur des transactions lors du rebouclage (wraparound). Afin d’éviter ce phénomène, l’opération VACUUM FREEZE « gèle » les vieux enregistrements, afin que ceux-ci ne se retrouvent pas brusquement dans le futur.
Concrètement, il s’agit de positionner un hint bit dans les entêtes des lignes concernées, indiquant qu’elle est plus vieille que tous les numéros de transactions actuellement actifs. (Avant PostgreSQL 9.4, la colonne système xmin était simplement remplacée par un numéro spécial FrozenTransactionId, soit 2, ce qui revient au même).
5.6.5 Paramétrage du FREEZE (2)
Quand le VACUUM gèle-t-il les lignes?
« Âge » d’une table:
age (pgclass.relfrozenxid)Les blocs nettoyés/gelés sont notés dans la visibility map
vacuum_freeze_min_age(50 Mtrx)âge des lignes rencontrées à geler
vacuum_freeze_table_age(150 Mtrx)agressif (toute la table)
Au plus tard, par l’autovacuum sur toute la table:
autovacuum_freeze_max_age(200 Mtrx)Généralement on ne touche pas
Geler une ligne ancienne implique de réécrire le bloc et donc des écritures dans les journaux de transactions et les fichiers de données. Il est inutile de geler trop tôt une ligne récente, qui sera peut-être bientôt réécrite.
Le numéro de transaction le plus ancien connu au sein d’une table est porté par pgclass.relfrozenxid, et est sur 32 bits. Il faut utiliser la fonction age() pour connaître l’écart par rapport au numéro de transaction courant (géré sur 64 bits en interne).
Paramétrage:
Plusieurs seuils gèrent le déclenchement du gel des lignes d’une table.
Leurs valeurs par défaut sont satisfaisantes pour la plupart des installations et ne sont pour ainsi dire jamais modifiées. Un souci lié au gel a généralement une cause plus profonde (dysfonctionnement du VACUUM …), et augmenter les seuils suivants ne devrait servir qu’à se donner le temps de le résoudre.
Par contre, il est important de bien connaître le fonctionnement pour ne pas être surpris.
Une partie du gel se fait lors d’un VACUUM normal. Si ce dernier rencontre, dans un bloc qu’il nettoie, un enregistrement plus vieux que vacuum_freeze_min_age (par défaut 50 millions de transactions écoulées), alors le tuple peut et doit être gelé. Cela ne concerne que les lignes dans des blocs qui ont des lignes mortes à nettoyer: les lignes dans des blocs rarement utilisés y échappent. (Y échappent aussi les lignes qui ne sont pas forcément visibles par toutes les transactions ouvertes.)
VACUUM doit donc périodiquement déclencher un nettoyage plus agressif de toute la table (et non pas uniquement des blocs modifiés depuis le dernier VACUUM), afin de nettoyer tous les vieux enregistrements. C’est le rôle de vacuum_freeze_table_age (par défaut 150 millions de transactions). Si la table a atteint cet âge, un VACUUM (manuel ou automatique) lancé dessus deviendra « agressif »:
Les blocs ne contenant que des lignes visibles par toutes les transactions, normalement ignorés, sont tout de même parcourus.Seuls les blocs marqués comme entièrement gelés dans la visibility map sont ignorés. Les lignes non gelées qui s’y trouvent et plus vieilles que vacuum_freeze_min_age seront alors gelées. Ce peut être long, ou pas, en fonction de l’efficacité de l’étape précédente.
À côté des numéros de transaction habituels, les identifiants multixact, qui servent au verrouillage des lignes par des transactions multiples, évitent aussi le wraparound avec des paramètres spécifiques (vacuum_multixact_freeze_min_age, vacuum_multixact_freeze_table_age) qui ont les mêmes valeurs que leurs homologues.
Enfin, il faut traiter le cas des tables sur lesquelles un VACUUM n’a pas eu besoin de se déclencher, ni n’a été demandé, depuis très longtemps. L’autovacuum y veille: autovacuum_freeze_max_age (par défaut 200 millions de transactions) est l’âge maximum que doit avoir une table. S’il est dépassé, l’autovacuum lance un VACUUM agressif sur cette table. Il est visible dans pg_stat_activity avec la mention caractéristique to prevent wraparound:
Ce traitement est lancé même si autovacuum est désactivé (c’est-à-dire à off).
Un VACUUM FREEZE lancé manuellement gèle toutes les lignes possibles, même « jeunes ». Il équivaut donc à un VACUUM avec les paramètres vacuum_freeze_table_age (âge minimal de la table) et vacuum_freeze_min_age (âge minimal des lignes pour les geler) à 0.
Monter vacuum_freeze_table_age et autovacuum_freeze_max_age, par exemple à 300 millions, est possible, mais cela ne fait souvent que repousser une opération nécessaire.
Charge induite par le gel:
Le gel des lignes peut être très lourd s’il y a beaucoup de lignes à geler, surtout en terme d’écriture et de journaux générés. En effet, le FREEZE réécrit tous les blocs concernés. Le déclenchement inopiné d’un VACUUM FREEZE sur l’intégralité d’une très grosse table très statique est une mauvaise surprise assez fréquente. La table est réécrite, les entrées-sorties sont chargées, la sauvegarde PITR enfle, évidemment à un moment où la base est chargée.
Heureusement, le gel est généralement très rapide, car l’essentiel du travail a été fait par les nettoyages précédents. Si la table a déjà été entièrement gelée dans le passé, et pas modifiée, il peut juste s’agir d’une mise à jour du relfrozenxid.
Les blocs déjà entièrement gelés sont recensés dans la visibility map, qui recense aussi les blocs sans ligne morte. Ces blocs gelés ne seront pas reparcourus s’ils ne sont plus modifiés. Cela accélère énormément le FREEZE sur les grosses tables.
Si unpas d’inconvénient à l’interrompre s’il gêne. Par contre, l’ VACUUM FREEZE est interrompu, ce qu’il a déjà gelé n’est pas perdu. Il n’y a donc autovacuum risque de le redéclencher très vite s’il le juge nécessaire.
L’âge de la table peut dépasser autovacuum_freeze_max_age si le nettoyage est laborieux, ce qui explique la marge par rapport à la limite fatidique des 2 milliards de transactions.
Quelques problèmes possibles sont évoqués plus bas.
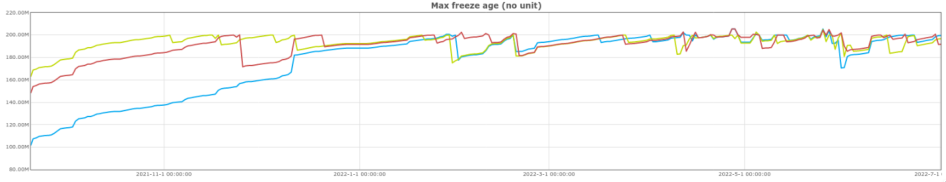
Évolution de l’âge d’une base:
Nous avons vu que l’âge d’une base est en fait l’âge de la table la plus ancienne, qui se calcule à partir de la colonne pg_database.datfrozenxid:
Concrètement, on voit l’âge d’une base de données s’approcher peu à peu de 200 millions de transactions, ce qui correspond à l’âge des plus « vieilles » tables, souvent celles sur lesquelles l’autovacuum ne passe jamais. L’âge des tables évolue même si l’essentiel de leur contenu, voire la totalité, est déjà gelé (car il reste au moins le pg_class.relfrozenxid à mettre à jour, ce qui est bien sûr très rapide). Cet âge retombe quand un gel est forcé sur ces tables, puis remonte, etc.
Résumé:
Que retenir de ce paramétrage complexe?
le
VACUUMgèlera une partie des lignes un peu anciennes lors de son fonctionnement habituel;un bloc gelé non modifié ne sera plus à regeler;
de grosses tables statiques peuvent engendrer soudainement une grosse charge en écriture; il vaut mieux être proactif.
5.7 PROBLÈMES COURANTS
5.7.1 L’autovacuum dure trop longtemps
£3
Fréquence de passage?
Débit?
Nombre de workers?
Taille vraiment trop grosse?
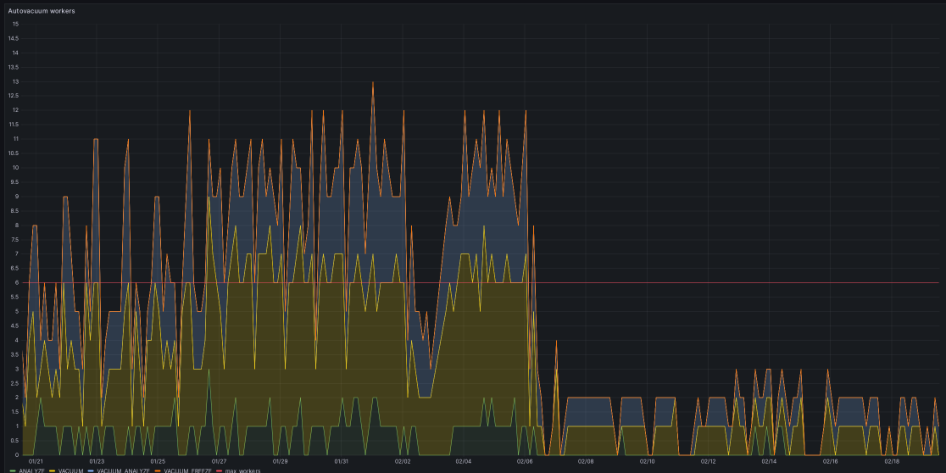
Nous avons vu que le paramétrage de l’autovacuum vise à limiter la charge sur la base. Le nettoyage d’une grosse table peut donc être parfois très long. Ce n’est pas forcément un problème majeur si l’opération arrive à terme dans un délai raisonnable, mais il vaut mieux savoir pourquoi. Il peut y avoir plusieurs causes, qui ne s’excluent pas mutuellement.
Il est fréquent que les grosses tables soient visitées trop peu souvent. Rappelons que la propriété autovacuum_vacuum_scale_factor de chaque table est par défaut à 20 %: lorsque l’autovacuum se déclenche, il doit donc traiter une volumétrie importante. Il est conseillé de réduire la valeur de ce paramètre (ou de jouer sur autovacuum_vacuum_threshold) pour un nettoyage plus fréquent. Dans l’idéal, la même volumétrie sera traitée de manière plus étalée. Les index risquent cependant d’être intégralement parcourus plus souvent, même si PostgreSQL ne nettoie pas un index en-dessous d’un certain seuil de modifications. Le compromis peut être délicat à trouver.
Le débit en écriture peut être insuffisant (c’est fréquent sur les anciennes versions), auquel cas, avec des disques corrects, on peut baisser autovacuum_vacuum_cost_delay ou plutôt monter autovacuum_vacuum_cost_limit. Sur le graphique ci-dessus, issu d’un cas réel, les trois workers semblaient en permanence occupés. Il risquait donc d’y avoir un retard pour nettoyer certaines tables, ou rafraîchir les statistiques. La réduction de autovacuum_vacuum_cost_delay de 20 à 2 ms (le défaut à présent) a mené à une réduction drastique de la durée de traitement de chaque worker.
Rappelons qu’un VACUUM manuel (ou planifié) n’est soumis à aucun bridage.
Le nombre de workers peut être trop bas, notamment s’il y a de nombreuses tables. Auquel cas ils semblent tous activés en permanence, comme ci-dessus. Monter autovacuum_max_workers au-delà de 3 nécessite d’augmenter le débit autorisé avec les paramètres ci-dessus.
Pour des grandes tables, le partitionnement permet de paralléliser l’activité de l’autova-cuum.Les workers peuvent en effet travailler simultanément sur des partitions de tables différentes.
Un grand nombre de bases actives peut devenir un frein et augmenter l’intervalle entre deux nettoyages d’une base, bien que l’ autovacuum launcher ignore les bases inutilisées.
Exceptionnellement, l’autovacuum peut tomber en erreur (bloc corrompu, index fonctionnel avec une fonction boguée…) et ne jamais finir (surveiller les traces).
5.7.2 Arrêter un VACUUM?
Lancement manuel ou script
conflit avec certains verrous
Autovacuum
interrompre s’il gêne
par superutilisateur ou rôle
pg_signal_autovacuum_worker(v18)Exception: to prevent wraparound lent et bloquant
pg_cancel_backend+VACUUM FREEZEmanuel
Le cas des VACUUM manuels a été vu plus haut: ils peuvent gêner quelques verrous ou opérations DDL. Il faudra les arrêter manuellement au besoin.
C’est différent si l’ autovacuum launcher a lancé le processus: l’opération s’arrête si un utilisateur pose un verrou en conflit. La seule exception concerne un VACUUM FREEZE lancé quand la table doit être gelée, donc avec la mention to prevent wraparound dans pg_stat_activity: celui-ci ne sera pas interrompu.
L’autovacuum ne pose certes qu’un verrou destiné à éviter les modifications de schéma simultanées (SHARE UPDATE EXCLUSIVE). Comme le débit en lecture et écriture est bridé par le paramétrage habituel de l’autovacuum, ce verrou peut durer assez longtemps. Cela peut s’avérer gênant avec certaines applications qui posent des verrous lourds (par exemple LOCK TABLE), ce qui est à éviter. (C’était surtout un souci avant PostgreSQL 9.6, où toute la table était relue à chaque FREEZE).
Une solution pérenne est d’augmenter le débit en écriture (voir plus haut).
Si les opérations sont impactées, on peut vouloir lancer soi-même un VACUUM FREEZE manuel, donc non bridé. Il faudra alors repérer le PID du VACUUM FREEZE en cours, l’arrêter avec pg_cancel_backend, puis lancer manuellement l’ordre VACUUM FREEZE sur la table concernée, (et rapidement avant que l’autovacuum ne relance un processus).
La supervision peut se faire avec pg_stat_progress_vacuum et iotop.
Les processus de l’autovacuum appartiennent aux superutilisateurs. Seul un superutilisateur peut les arrêter. Cependant, à partir de PostgreSQL 18, le nouveau rôle pg_signal_autovacuum_worker peut être attribué à un utilisateur pour annuler une requête ou arrêter une connexion d’ autovacuum worker. Comme pour tous les rôles pg_*, il convient d’être très prudent lors de l’attribution de ces rôles.
5.7.3 Si le VACUUM FREEZE tarde…
- Messages quand le wraparound approche:
- Mode d’urgence (failsafe) automatique
Si les messages ci-dessus apparaissent dans les traces, le wraparound est à moins de 40 millions, respectivement 3 millions de transactions, dans le futur. Cela laisse un peu de temps pour procéder au nettoyage soi-même et voir pourquoi il n’est pas efficace. Ce peut être aussi très court sur certaines installations.
Mode « failsafe »:
Il existe un mode failsafe: son but est de rendre le VACUUM très agressif, uniquement pour éviter le wraparound. Quand la table atteint l’âge, très élevé, de 1,6 milliard de transactions (défaut des paramètres vacuum_failsafe_age et vacuum_multixact_failsafe_age), un VACUUM simple va automatiquement désactiver le nettoyage des index pour nettoyer plus rapidement la table et permettre, espérons-le, d’avancer l’identifiant le plus ancien de la table.
5.7.4 Ce qui peut bloquer le VACUUM FREEZE
Causes:
sessions idle in transaction sur une longue durée
slot de réplication en retard/oublié
transactions préparées oubliées (
pg_prepared_xacts)erreur à l’exécution du
VACUUMConséquences:
processus autovacuum répétés
plus de nouvelles transactions en écriture
Supervision:
check_pg_activity:xmin,max_freeze_agesurveillez les traces!
Il arrive que le fonctionnement du FREEZE soit gêné par un problème qui lui interdit de recycler les plus anciens numéros de transactions, ce qui fait apparaître les messages d’alerte plus haut. (Ces causes gênent aussi un VACUUM simple, mais les symptômes sont alors surtout un gonflement des tables concernées.)
Les causes possibles sont:
des sessions idle in transactions en attente depuis des jours ou des semaines (voir le statut
idle in transactiondanspg_stat_activity, et au besoin fermer la session): au pire,elles disparaissent après redémarrage;
des slots de réplication pointent vers un secondaire très en retard, voire disparu (consulter
pg_replication_slots, et supprimer le slot);des transactions préparées (pas des requêtes préparées!) n’ont jamais été validées ni annulées, (voir
pg_prepared_xacts, et annuler la transaction): elles ne disparaissent pas après redémarrage;l’opération de
VACUUMtombe en erreur: corruption de table ou index, fonction d’index fonctionnel buggée, etc. (voir les traces et corriger le problème, supprimer l’objet ou la fonction, etc.).
Pour effectuer le FREEZE en urgence le plus rapidement possible, on peut utiliser:
- (À partir de PostgreSQL 16, ajouter
BUFFER_USAGE_LIMIT 0).
Cette commande force le gel de toutes les lignes, ignore le nettoyage des index et ne supprime pas les blocs vides finaux (le verrou peut être gênant). Un VACUUM classique serait à prévoir ensuite à l’occasion.
On peut aussi cibler d’abord les tables les plus « anciennes » avec la requête déjà citée.
La clause VERBOSE permet d’avoir plus d’informations sur l’opération de gel. Elle est hélas assez pauvre sur ce sujet avant PostgreSQL 16.
Dans cet exemple, la ligne frozen indique que 50,01 % de la table et 1 million de lignes ont été effectivement gelées.
Il est bon de vérifier que le new relfrozenxid indiqué est proche du dernier numéro de transaction:
Ne pas oublier de nettoyer toutes les bases de l’instance.
En toute rigueur, VACUUM sans l’option FREEZE est encore plus rapide: le mode agressif serait spontanément déclenché mais les lignes plus récentes que vacuum_freeze_min_age (50 millions de transaction) ne seraient pas tout de suite gelées. On peut même monter ce paramètre dans la session pour alléger au maximum la charge sur une table dont les lignes ont des âges bien étalés.
Dans le pire des cas, plus aucune transaction ne devient possible (y compris les opérations d’administration comme DROP, ou VACUUM sans TRUNCATE off):
Mais il reste possible d’exécuter la commande VACUUM (TRUNCATE OFF) car celle-ci ne va pas consommer d’identifiant de transaction.
Pour les versions 11 et inférieures, où l’option TRUNCATE de VACUUM n’était pas disponible, il était parfois nécessaire de redémarrer avec le très austère mode monoutilisateur7 de PostgreSQL, mais ce n’est plus nécessaire à partir de la version 12, contrairement à ce qui est suggéré par la ligne HINT dans les traces ci-dessus. Ce mauvais conseil a finalement été supprimé en version 17, comme expliqué dans cet article8.
Avec la sonde Nagios check_pgactivity9, et les services max_freeze_age et oldest_xmin, il est possible de vérifier que l’âge des bases ne dérive pas, ou de trouver quel processus porte le xmin le plus ancien. S’il y a un problème, il entraîne généralement l’apparition de nombreux messages dans les traces: lisez-les régulièrement!
Comme référence, consulter le chapitre Éviter les cycles des identifiants de transactions10 de la documentation officielle.
5.7.5 FREEZE massif de l’essentiel de la base
Attention après un import massif/migration logique!
VACUUM FREEZEpréventif en période de maintenanceéventuellement par étapes
Le gel des lignes s’opère en général au fil de l’eau, et les écritures sont réparties dans le temps. Ce n’est pas toujours le cas.
Si une base est chargée en bloc, et que l’essentiel de sa volumétrie est peu modifiée, il y a des chances que le FREEZE se déclenche sur toutes les tables en même temps et génèrent énormément d’écritures.
Le délai avant le déclenchement du gel par l’autovacuum dépend de la consommation des numéros de transaction sur l’instance migrée, et varie de quelques semaines à des années.
Le problème concerne bien sûr surtout les grosses bases.
Sont concernés tout ce qui charge beaucoup de lignes en très peu de transactions proches: imports massifs, restauration de base (pg_restore), migration par réplication logique, migration depuis d’autres bases de données… Mais le souci ne concerne pas les migrations et restaurations physiques, qui préservent les numéros de transaction des lignes.
Après une migration ou un chargement massif, des ordres VACUUM FREEZE sur les plus grosses tables à des moments calmes permettent d’étaler ces écritures. Si ces ordres sont interrompus, l’essentiel de ce qu’ils auront pu geler n’est plus à re-geler plus tard.
5.8 RÉSUMÉ DES CONSEILS SUR L’AUTOVACUUM
“Vacuuming is like exercising.
If it hurts, you’re not doing it enough!”
(Robert Haas, PGConf.EU 2023, Prague, 13 décembre 2023)
Certains sont frileux à l’idée de passer un VACUUM. En général, cela amène à plus de soucis que ceux que l’on croyait éviter.
5.8.1 Résumé des conseils sur l’autovacuum (1/2)
Laisser l’autovacuum faire son travail
Augmenter le débit autorisé
Surveiller
pg_stat_all_tablesNombre de workers
Grosses tables, par ex:
L’autovacuum fonctionne convenablement pour les charges habituelles. Il ne faut pas s’étonner qu’il fonctionne longtemps en arrière-plan: il est justement conçu pour ne pas se presser. Au besoin, ne pas hésiter à lancer manuellement l’opération, donc sans bridage en débit.
Si les disques sont bons, on peut augmenter le débit autorisé:
de préférence, en augmentant le coût à atteindre avant une pause (
autovacuum_vacuum_cost_limit);en augmentant
vacuum_buffer_usage_limit(en version 16);mais la durée de pause (
autovacuum_vacuum_cost_delay) ne peut plus guère être réduite depuis sa réduction à 2 ms avec PostgreSQL 12.
Comme le déclenchement d’ autovacuum est très lié à l’activité, il faut vérifier qu’il passe assez souvent sur les tables sensibles en surveillant pg_stat_all_tables.last_autovacuum et
last_autoanalyze.
Si les statistiques peinent à se rafraîchir, ne pas hésiter à activer plus souvent l’autovacuum sur les grosses tables problématiques ainsi:
De même, si la fragmentation s’envole, descendre autovacuum_vacuum_scale_factor. (On peut préférer utiliser les variantes en *_threshold de ces paramètres, et mettre les *_scale_factor à 0).
Dans un modèle avec de très nombreuses tables actives, le nombre de workers doit parfois être augmenté.
5.8.2 Résumé des conseils sur l’autovacuum (2/2)
Planifier nuit ou week-end
Mode manuel
batchs / tables temporaires
si pressé!
Danger du
FREEZEbrutal après migration logique ou gros importprévenir
VACUUM FULL: dernière extrémité
L’autovacuum n’est pas toujours assez rapide à se déclencher, par exemple entre les différentes étapes d’un batch: on intercalera des VACUUM ANALYZE manuels. Il faudra le faire systématiquement pour les tables temporaires (que l’autovacuum ne voit pas).
Au final, on peut conseiller de planifier vacuumdb, vacuum --analyze, ou script SQL VACUUM, à un moment calme, chaque jour ou chaque week-end au moins. Il sera rapide s’il y a peu à faire, et peut être rendu agressif (penser à --jobs, --buffer-usage-limit …).
Ce qu’il traite ne sera plus à nettoyer en journée, et la planification apporte la garantie qu’aucune table n’est négligée. Cette opération ne dispense pas de contrôler et affiner l’activité de l’autovacuum sur les grosses tables très sollicitées. Ces deux maintenances sont complémentaires.
Un point d’attention reste le gel brutal de grosses quantités de données chargées ou modifiées en même temps. Un VACUUM FREEZE préventif dans une période calme reste la meilleure solution.
Un VACUUM FULL sur une grande table est une opération très lourde, à réserver à la récupération d’une partie significative de son espace, qui ne serait pas réutilisé plus tard.
5.9 CONCLUSION
VACUUMfait de plus en plus de choses au fil des versionsConvient généralement
Paramétrage apparemment complexe
en fait relativement simple avec un peu d’habitude
5.9.1 Questions
N’hésitez pas, c’est le moment!
5.10 QUIZ
5.11 TRAVAUX PRATIQUES
La version en ligne des solutions de ces TP est disponible sur https://dali.bo/m5_solutions.
5.11.1 Traiter la fragmentation
But: Traiter la fragmentation
Créer une table t3 avec une colonne id de type integer.
Désactiver l’autovacuum pour la table t3.
Insérer un million de lignes dans la table t3 avec la fonction generate_series.
Récupérer la taille de la table t3.
Supprimer les 500 000 premières lignes de la table t3.
Récupérer la taille de la table t3. Que faut-il en déduire?
Exécuter un VACUUM VERBOSE sur la table t3. Quelle est l’information la plus importante?
Récupérer la taille de la table t3. Que faut-il en déduire?
Exécuter un VACUUM FULL VERBOSE sur la table t3.
Récupérer la taille de la table t3. Que faut-il en déduire?
Créer une table t4 avec une colonne id de type integer.
- Désactiver l’autovacuum pour la table
t4. - Insérer un million de lignes dans la table
t4avecgenerate_series. - Récupérer la taille de la table
t4. - Supprimer les 500 000 dernières lignes de la table
t4. - Récupérer la taille de la table
t4. Que faut-il en déduire? - Exécuter un
VACUUMsur la tablet4. - Récupérer la taille de la table
t4. Que faut-il en déduire?
5.11.2 Détecter la fragmentation
But : Détecter la fragmentation.
- Créer une table
t5avec deux colonnes :c1de typeintegeretc2de typetext. - Désactiver l’autovacuum pour la table
t5. - Insérer un million de lignes dans la table
t5avecgenerate_series. - Installer l’extension
pg_freespacemap(documentation : https://docs.postgresql.fr/current/pgfreespacemap.html). Que rapporte la fonctionpg_freespace()quant à l’espace libre de la tablet5? - Modifier exactement 200 000 lignes de la table
t5.
- Que rapporte
pg_freespacequant à l’espace libre de la tablet5?
Exécuter un VACUUM sur la table t5.
Que rapporte pg_freespace quant à l’espace libre de la table t5?
Récupérer la taille de la table t5.
Exécuter un VACUUM (FULL, VERBOSE) sur la table t5.
Récupérer la taille de la table t5 et l’espace libre rapporté par pg_freespacemap. Que faut-il en déduire?
5.11.3 Gestion de l’autovacuum
But: Voir fonctionner l’autovacuum
Créer une table t6 avec une colonne id de type integer.
Insérer un million de lignes dans la table t6:
Que contient la vue pg_stat_user_tables pour la table t6? Il faudra peut-être attendre une minute. (Si la version de PostgreSQL est antérieure à la 13, il faudra lancer un VACUUM t6.)
Vérifier le nombre de lignes dans pg_class.reltuples.
- Modifier 150 000 lignes de la table
t6avec:
- Attendre une minute.
Que contient la vue
pg_stat_user_tablespour la tablet6?Que faut-il en déduire?
Modifier 60 000 lignes supplémentaires de la table
t6avec:
Attendre une minute.
Que contient la vue
pg_stat_user_tablespour la tablet6?Que faut-il en déduire?
Descendre le facteur d’échelle de la table t6 à 10 % pour le VACUUM.
- Modifier encore 200 000 autres lignes de la table
t6:
Attendre une minute.
Que contient la vue
pg_stat_user_tablespour la tablet6?Que faut-il en déduire?
5.12 TRAVAUX PRATIQUES (SOLUTIONS)
5.12.1 Traiter la fragmentation
Créer une table t3 avec une colonne id de type integer.
Désactiver l’autovacuum pour la table t3.
La désactivation de l’autovacuum ici a un but uniquement pédagogique. En production, c’est une très mauvaise idée!
Insérer un million de lignes dans la table t3 avec la fonction generate_series.
Récupérer la taille de la table t3.
Supprimer les 500 000 premières lignes de la table t3.
Récupérer la taille de la table t3. Que faut-il en déduire?
DELETE seul ne permet pas de regagner de la place sur le disque. Les lignes supprimées sont uniquement marquées comme étant mortes. Comme l’autovacuum est ici désactivé, PostgreSQL n’a pas encore nettoyé ces lignes.
Exécuter un VACUUM VERBOSE sur la table t3. Quelle est l’information la plus importante?
L’indication:
Elle indique que 500 000 lignes ont été nettoyées dans 2213 blocs (en gros, la moitié des blocs de la table).
Pour compléter, l’indication suivante:
Elle reprend l’indication sur 500 000 lignes mortes, et précise que 500 000 autres ne le sont pas. Les 4425 pages parcourues correspondent bien à la totalité des 35 Mo de la table complète. C’est la première fois que VACUUM passe sur cette table, il est normal qu’elle soit intégralement parcourue.
Récupérer la taille de la table t3. Que faut-il en déduire?
VACUUM ne permet pas non plus de gagner en espace disque. Principalement, il renseigne la structure FSM (free space map) sur les emplacements libres dans les fichiers des tables.
Exécuter un VACUUM FULL VERBOSE sur la table t3.
Récupérer la taille de la table t3. Que faut-il en déduire?
Là, par contre, nous gagnons en espace disque. Le VACUUM FULL reconstruit la table et la fragmentation disparaît.
Créer une table t4 avec une colonne id de type integer.
Désactiver l’autovacuum pour la table t4.
Insérer un million de lignes dans la table t4 avec generate_series.
Récupérer la taille de la table t4.
Supprimer les 500 000 dernières lignes de la table t4.
Récupérer la taille de la table t4. Que faut-il en déduire?
Là aussi, nous n’avons rien perdu.
Exécuter un VACUUM sur la table t4.
Récupérer la taille de la table t4. Que faut-il en déduire?
En fait, il existe un cas où il est possible de gagner de l’espace disque suite à un VACUUM simple : quand l’espace récupéré se trouve en fin de table et qu’il est possible de prendre rapidement un verrou exclusif sur la table pour la tronquer. C’est assez peu fréquent mais c’est une optimisation intéressante.
5.12.2 Détecter la fragmentation
Créer une table t5 avec deux colonnes: c1 de type integer et c2 de type text.
Désactiver l’autovacuum pour la table t5.
Insérer un million de lignes dans la table t5 avec generate_series.
Installer l’extension
pg_freespacemap(documentation: https://docs.postgresql.fr/current/pgfreespacemap.html)Que rapporte la fonction
pg_freespace()quant à l’espace libre de la tablet5?
Cette extension installe une fonction nommée pg_freespace, dont la version la plus simple ne demande que la table en argument, et renvoie l’espace libre dans chaque bloc, en octets, connu de la Free Space Map.
La table contient donc 6274 blocs (soit 51,4 Mo) sans aucun espace vide.
- Modifier exactement 200 000 lignes de la table
t5. - Que rapporte
pg_freespacequant à l’espace libre de la tablet5?
La table comporte donc 20 % de blocs en plus, où sont stockées les nouvelles versions des lignes modifiées. Le champ avail indique qu’il n’y a quasiment pas de place libre. (Ne pas prendre la valeur de 32 octets au pied de la lettre, la Free Space Map ne cherche pas à fournir une valeur précise.)
Exécuter un VACUUM sur la table t5.
Que rapporte pg_freespace quant à l’espace libre de la table t5?
Il y a toujours autant de blocs, mais environ 8,8 Mo sont à présent repérés comme libres.
Il faut donc bien exécuter un VACUUM pour que PostgreSQL nettoie les blocs et mette à jour la structure FSM, ce qui nous permet de déduire le taux de fragmentation de la table.
Récupérer la taille de la table t5.
Exécuter un VACUUM (FULL, VERBOSE) sur la table t5.
Récupérer la taille de la table t5 et l’espace libre rapporté par pg_freespacemap. Que faut-il en déduire?
VACUUM FULL a réécrit la table sans les espaces morts, ce qui nous a fait gagner entre 8 et 9 Mo. La taille de la table maintenant correspond bien à celle de l’ancienne table, moins la place prise par les lignes mortes.
5.12.3 Gestion de l’autovacuum
Créer une table t6 avec une colonne id de type integer.
Insérer un million de lignes dans la table t6:
Que contient la vue pg_stat_user_tables pour la table t6? Il faudra peut-être attendre une minute. (Si la version de PostgreSQL est antérieure à la 13, il faudra lancer un VACUUM t6.)
Les deux dates last_autovacuum et last_autoanalyze sont renseignées. Il faudra peut-être attendre une minute que l’autovacuum passe sur la table (voire plus sur une instance chargée par ailleurs).
Le seuil de déclenchement de l’autoanalyze est:
Soit, par défaut, 10 % × 0 + 50 = 50. Quand il n’y a que des insertions, le seuil pour l’autovacuum est:
Soit 20 % × 0 + 1000 = 1000.
Avec un million de nouvelles lignes, les deux seuils sont franchis.
Vérifier le nombre de lignes dans pg_class.reltuples.
Vérifions que le nombre de lignes est à jour dans pg_class:
L’autovacuum se base entre autres sur cette valeur pour décider s’il doit passer ou pas. Si elle n’est pas encore à jour, il faut lancer manuellement:
C’est d’ailleurs généralement conseillé après un gros chargement.
- Modifier 150 000 lignes de la table
t6avec:
Attendre une minute.
Que contient la vue
pg_stat_user_tablespour la tablet6?Que faut-il en déduire?
Le démon autovacuum ne se déclenche pas instantanément après les écritures, attendons un peu:
Seul last_autoanalyze a été modifié, et il reste entre 150 000 lignes morts (n_dead_tup). En effet, le démon autovacuum traite séparément l’ ANALYZE (statistiques sur les valeurs des données) et le VACUUM (recherche des espaces morts). Si l’on recalcule les seuils de déclenchement, on trouve pour l’autoanalyze:
Soit, par défaut, 10 % × 1 000 000 + 50 = 100 050, dépassé ici.
Pour l’autovacuum, le seuil est de:
Soit 20 % × 1 000 000 + 50 = 200 050, qui n’est pas atteint.
- Modifier 60 000 lignes supplémentaires de la table
t6avec:
Attendre une minute.
Que contient la vue
pg_stat_user_tablespour la tablet6?Que faut-il en déduire?
L’autovacuum ne passe pas tout de suite, les 210 000 lignes mortes au total sont bien visibles:
Mais comme le seuil de 200 050 lignes modifiées à été franchi, le démon lance un VACUUM:
Noter que n_dead_tup est revenu à 0. last_auto_analyze indique qu’un nouvel ANALYZE n’a pas été exécuté: seules 60 000 lignes ont été modifiées (voir n_mod_since_analyze), en-dessous du seuil de 100 050.
Descendre le facteur d’échelle de la table t6 à 10 % pour le VACUUM.
- Modifier encore 200 000 autres lignes de la table
t6:
Attendre une minute.
Que contient la vue
pg_stat_user_tablespour la tablet6?Que faut-il en déduire?
Le démon a relancé un VACUUM et un ANALYZE. Avec un facteur d’échelle à 10 %, il ne faut plus attendre que la modification de 100 050 lignes pour que le VACUUM soit déclenché par le démon. C’était déjà le seuil pour l’ ANALYZE.
Source : manuel complet PDF, révision 26.09, pages PDF 245-304. Les travaux pratiques et leurs solutions proviennent exclusivement de la version complète.
Pour poursuivre la lecture, voir le partitionnement déclaratif.
https://docs.postgresql.fr/current/progress-reporting.html#VACUUM-PROGRESS-REPORTING ↩︎
https://docs.postgresql.fr/current/routine-vacuuming.html#AUTOVACUUM ↩︎
https://git.postgresql.org/gitweb/?p=postgresql.git;a=commit;h=b07642dbcd8d5de05f0ee1dbb72dd6760dd30436 ↩︎
https://www.postgresql.eu/events/pgconfeu2023/sessions/session/4847/slides/432/Understanding%20and%20Fixing%20Autovacuum%20-%20PGCONF.EU%202023.pdf#page=14 ↩︎
https://docs.postgresql.fr/current/app-postgres.html#APP-POSTGRES-SINGLE-USER ↩︎
https://www.cybertec-postgresql.com/en/database-is-not-accepting-commands/ ↩︎
https://docs.postgresql.fr/current/routine-vacuuming.html#VACUUM-FOR-WRAPAROUND ↩︎