# Partitionnement déclaratif (introduction)
> Principes, implémentation et performances du partitionnement déclaratif.
---
Index LLMS : [llms.txt](/fr/llms.txt)
---
## 6/ Partitionnement déclaratif (introduction) {#dba2-ch6}
- Le partitionnement déclaratif apparaît avec PostgreSQL 10
- Préférer un PostgreSQL récent
- Ne plus utiliser l’ancien partitionnement par héritage.
Ce module introduit le partitionnement déclaratif introduit avec PostgreSQL 10, et amélioré dans les versions suivantes. Les améliorations à chaque nouvelle version de PostgreSQL doivent mener à favoriser une version récente de PostgreSQL.
Le partitionnement par héritage, au fonctionnement totalement différent, reste utilisable, mais ne doit plus servir aux nouveaux développements, du moins pour les cas décrits ici.
### 6.1 PRINCIPE & INTÉRÊTS DU PARTITIONNEMENT
- Faciliter la maintenance de gros volumes
- `VACUUM` (`FULL`), réindexation, déplacements, sauvegarde logique…
- Gain en performance
- parcours complet sur de plus petites tables
- statistiques par partition plus précises
- purge par partitions entières
- `pg_dump` parallélisable
- tablespaces différents (données froides/chaudes)
- Attention à la maintenance sur le code
Maintenir de très grosses tables peut devenir fastidieux, voire impossible. Ce genre de problème peut survenir:
- `VACUUM FULL` trop longs voire impossibles à cause d’un espace disque insuffisant;
- _autovacuum_ pas assez réactif sur les grosses tables;
- index trop gros et réindexations interminables;
- `pg_dump` ne sait pas paralléliser la sauvegarde d’une table volumineuse;
- purge de grandes quantité de données très longue;
- statistiques plus assez fines (et augmenter l’échantillonnage ne suffit pas forcément);
- dilution des lignes actives dans la table au détriment du _hit ratio_ et des I/O;
- mauvaise corrélation de lignes récupérées ensembles;
- impossibilité de séparer données actives et inactives au niveau physique (_tablespaces_).
Certains outils existent pour mitiger ces problèmes (index partiels, index BRIN, autovacuum plus agressif…) mais ne sont pas des solutions définitives.
**Le partitionnement consiste à scinder une table en plusieurs sous-tables (partitions)** ellesmêmes manipulables en tant que tables à part entière.
#### Maintenance
La maintenance s’effectue sur les partitions plutôt que sur l’ensemble complet des données. En particulier, un `VACUUM FULL` ou une réindexation peuvent s’effectuer partition par partition, ce qui permet de limiter les interruptions en production, et lisser la charge.
`pg_dump` peut sauvegarder les différentes partitions d’une même table en parallèle.
Le partitionnement est aussi un préalable au déplacement d’une partie des données dans un autre _tablespace_ pour des raisons de place, ou pour déporter les parties les moins utilisées de la table vers des disques plus lents et moins chers. Cependant, il faut mettre en balance le coût de migration du modèle existant avec l’économie réalisée sur les disques.
#### Parcours complet de partitions
Certaines requêtes (notamment décisionnelles) ramènent tant de lignes, ou ont des critères si complexes, qu’un parcours complet de la table est souvent privilégié par l’optimiseur.
Un partitionnement, souvent par date, permet de ne parcourir qu’une ou quelques partitions au lieu de l’ensemble des données. C’est le rôle de l’optimiseur de choisir la partition (_partition pruning_), par exemple celle de l’année en cours, ou des mois sélectionnés.
#### Suppression des partitions
La suppression de données parmi un gros volume peut poser des problèmes d’accès concurrents ou de performance, par exemple dans le cas de purges. En configurant judicieusement les partitions, on peut résoudre cette problématique en supprimant une partition(ici en partitionnement déclaratif):
**Exemple p307-1.** Exemple extrait du PDF\, page 307\.
```sql
DROP TABLE nompartition ;
```
ou en la _détachant_:
**Exemple p307-2.** Exemple extrait du PDF\, page 307\.
```sql
ALTER TABLE table_partitionnee DETACH PARTITION nompartition ;
```
pour l’archiver (et la réattacher au besoin) ou la supprimer ultérieurement.
D’autres optimisations sont décrites dans ce billet de blog d’Adrien Nayrat[^1]: statistiques plus précises au niveau d’une partition, réduction plus simple de la fragmentation des index, jointure par rapprochement des partitions…
La principale difficulté d’un système de partitionnement consiste à partitionner avec un impact minimal sur la maintenance du code par rapport à une table classique.
[^1]: https://blog.anayrat.info/2021/09/01/cas-dusages-du-partitionnement-natif-dans-postgresql/
### 6.2 PARTITIONNEMENT DÉCLARATIF
- Table partitionnée
- structure uniquement
- index/contraintes répercutés sur les partitions
- Partitions:
- 1 partition = 1 table classique, utilisable directement
- clé de partitionnement (inclue dans PK/UK)
- partition par défaut
- sous-partitions possibles
- FDW comme partitions possible
- attacher/détacher une partition
En partitionnement déclaratif, une table partitionnée ne contient pas de données par elle-même. Elle définit la structure (champs, types) et les contraintes et index, qui sont répercutées sur ses partitions.
Une partition est une table à part entière, rattachée à une table partitionnée. Sa structure suit automatiquement celle de la table partitionnée et ses modifications. Cependant, des index ou contraintes supplémentaires propres à cette partition peuvent être ajoutées de la même manière que pour une table classique.
La partition se définit par une « clé de partitionnement », sur une ou plusieurs colonnes. Les lignes de même clé se retrouvent dans la même partition. La clé peut se définir comme:
- une liste de valeurs;
- une plage de valeurs;
- une valeur de hachage.
Les clés des différentes partitions ne doivent pas se recouvrir.
Une partition peut elle-même être partitionnée, sur une autre clé, ou la même.
Une table classique peut être attachée à une table partitionnée. Une partition peut être détachée et redevenir une table indépendante normale.
Même des tables distantes (utilisant _foreign data wrapper_)peuvent être définies comme partitions, avec des restrictions. Pour les performances, penser aux accès asynchrones.
Les clés étrangères entre tables partitionnées ne sont pas un problème dans les versions récentes de PostgreSQL.
Le routage des données insérées ou modifiées vers la bonne partition est géré de façon automatique en fonction de la définition des partitions. La création d’une partition par défaut permet d’éviter des erreurs si aucune partition ne convient.
De même, à la lecture de la table partitionnée, les différentes partitions nécessaires sont accédées de manière transparente.
Pour le développeur, la table principale peut donc être utilisée comme une table classique. Il vaut mieux cependant qu’il connaisse le mode de partitionnement, pour utiliser la clé autant que possible. la complexité supplémentaire améliorera les performances. L’accès direct aux partitions par leur nom de table reste possible, et peut parfois améliorer les performances. Un développeur pourra aussi purger des données plus rapidement, en effectuant un simple `DROP` de la partition concernée.
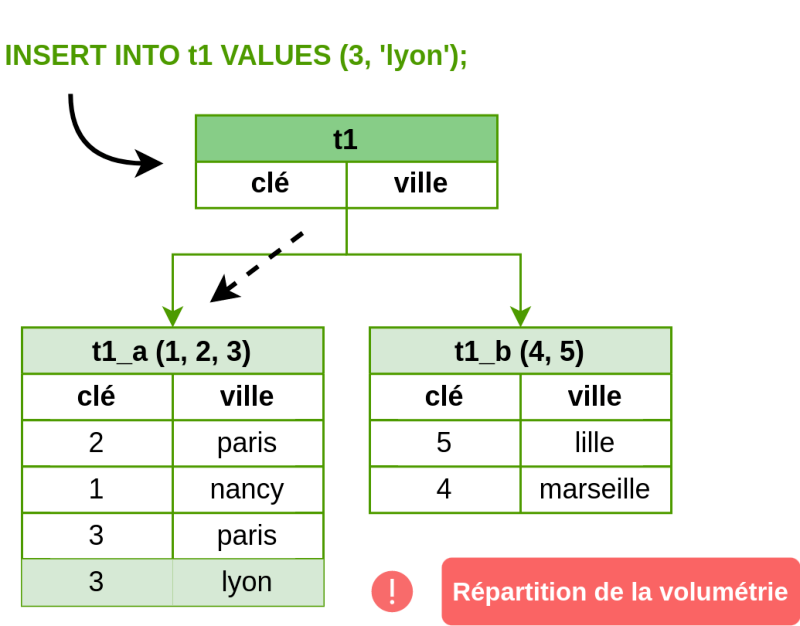
#### 6.2.1 Partitionnement par liste
**Figure p309-1.** Répartition de la volumétrie après insertion dans une partition de liste\.
#### 6.2.2 Partitionnement par liste: implémentation
@ **`CREATE TABLE`** `t1(c1 integer, c2 text)` **`PARTITION BY`** `LIST (c1);` **`CREATE TABLE`** `t1_a` **`PARTITION OF`** `t1` **`FOR VALUES IN`** `(1, 2, 3);` **`CREATE TABLE`** `t1_b` **`PARTITION OF`** `t1` **`FOR VALUES IN`** `(4, 5); …` =|
Le partitionnement par liste définit les valeurs d’une colonne acceptables dans chaque partition. Utilisations courantes: partitionnement par année, par statut, par code géographique…
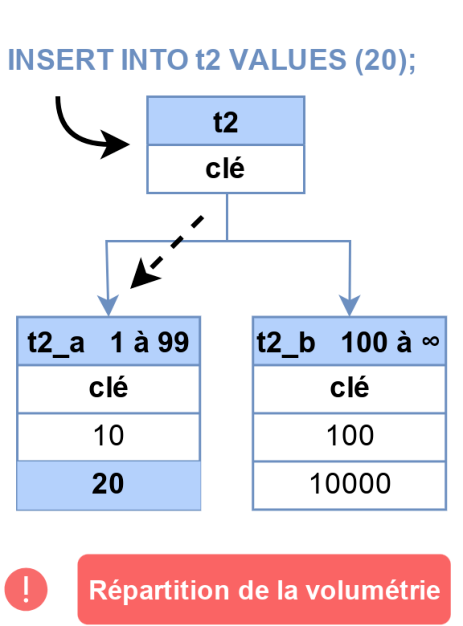
#### 6.2.3 Partitionnement par intervalle
**Figure p310-1.** Répartition de la volumétrie après insertion dans une partition par intervalle\.
#### 6.2.4 Partitionnement par intervalle: implémentation
&-) **`CREATE TABLE`** `logs (d timestamptz, contenu text)` **`PARTITION BY RANGE`** `(d);` **`CREATE TABLE`** `logs_201901` **`PARTITION OF`** `logs` **`FOR VALUES FROM`** `('2019-01-01')` **`TO`** `('2019-02-01');` **`CREATE TABLE`** `logs_201902` **`PARTITION OF`** `logs` **`FOR VALUES FROM`** `('2019-02-01')` **`TO`** `('2019-03-01'); …` **`CREATE TABLE`** `logs_201912` **`PARTITION OF`** `logs` **`FOR VALUES FROM`** `('2019-12-01')` **`TO`** `('2020-01-01'); …` **`CREATE TABLE`** `logs_autres` **`PARTITION OF`** `logs` **`DEFAULT`** `;` _`-- pour ne rien perdre`_
Utilisations courantes : partitionnement par date, par plages de valeurs continues, alphabétiques…
L’exemple ci-dessus utilise le partitionnement par mois. Chaque partition est définie par des plages de date. Noter que la borne supérieure ne fait _pas_ partie des données de la partition. Elle doit donc
être aussi la borne inférieure de la partie suivante. La description de la table partitionnée devient:
```text
=# \d+ logs
Table partitionnée « public.logs »
Colonne | Type | ... | Stockage | …
---------+--------------------------+-----+----------+ …
d | timestamp with time zone | ... | plain | …
contenu | text | ... | extended | …
Clé de partition : RANGE (d)
Partitions: logs_201901 FOR VALUES FROM ('2019-01-01 00:00:00+01') TO ('2019-02-01
00:00:00+01'),
logs_201902 FOR VALUES FROM ('2019-02-01 00:00:00+01') TO ('2019-03-01
00:00:00+01'),
…
logs_201912 FOR VALUES FROM ('2019-12-01 00:00:00+01') TO ('2020-01-01
00:00:00+01'),
logs_autres DEFAULT
```
La partition par défaut reçoit toutes les données qui ne vont dans aucune autre partition: cela évite des erreurs d’insertion. Il vaut mieux que la partition par défaut reste très petite.
Il est possible de définir des plages sur plusieurs champs:
**Exemple p311-2.** Exemple extrait du PDF\, page 311\.
```sql
CREATE TABLE tt_a PARTITION OF tt
FOR VALUES FROM (1,'2020-08-10') TO (100, '2020-08-11') ;
```
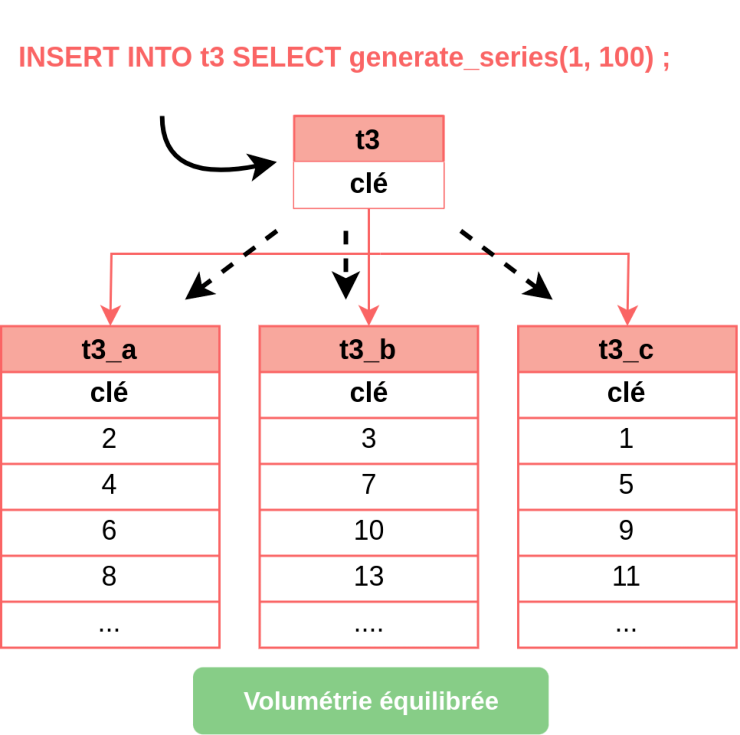
#### 6.2.5 Partitionnement par hachage
**Figure p312-1.** Répartition homogène par partitionnement par hachage\.
#### 6.2.6 Partitionnement par hachage: implémentation
- Hachage des valeurs
- Répartition homogène
- Indiquer un modulo et un reste
**Exemple p312-1.** Exemple extrait du PDF\, page 312\.
```sql
CREATE TABLE t3(c1 integer, c2 text) PARTITION BY HASH (c1);
```
**Exemple p312-2.** Exemple extrait du PDF\, page 312\.
```sql
CREATE TABLE t3_a PARTITION OF t3 FOR VALUES WITH (modulus 3,remainder 0);
CREATE TABLE t3_b PARTITION OF t3 FOR VALUES WITH (modulus 3,remainder 1);
CREATE TABLE t3_c PARTITION OF t3 FOR VALUES WITH (modulus 3,remainder 2);
```
Ce type de partitionnement vise à répartir la volumétrie dans plusieurs partitions de manière homogène, quand il n’y a pas de clé évidente. En général, il y aura plus que 3 partitions.
### 6.3 PERFORMANCES & PARTITIONNEMENT
- Insertions via la table principale
- quasi aucun impact
- Lecture depuis la table principale
- attention à la clé
- Purge
- simple `DROP` ou `DETACH`
- Trop de partitions
- attention au temps de planification
Des `INSERT` dans la table partitionnée seront redirigés directement dans les bonnes partitions avec un impact en performances quasi négligeable.
Lors des lectures ou jointures, il est important de préciser autant que possible la clé de jointure, si elle est pertinente. Dans le cas contraire, toutes les tables de la partition seront interrogées.
Dans cet exemple, la table comprend 10 partitions:
**Exemple p313-1.** Exemple extrait du PDF\, page 313\.
```text
EXPLAIN (COSTS OFF) SELECT COUNT(*) FROM pgbench_accounts ;
```
**Exemple p313-2.** Exemple extrait du PDF\, page 313\.
```text
QUERY PLAN
```
**Exemple p313-3.** Exemple extrait du PDF\, page 313\.
```sql
---------------------------------------------------------------------------------
Finalize Aggregate
```
- `-> Gather Workers Planned: 2`
- `-> Parallel Append -> Partial Aggregate`
- `-> Parallel Index Only Scan using pgbench_accounts_1_pkey on`
- `pgbench_accounts_1 pgbench_accounts -> Partial Aggregate`
- `-> Parallel Index Only Scan using pgbench_accounts_2_pkey on`
- `pgbench_accounts_2 pgbench_accounts_1`
- `-> Partial Aggregate`
- `-> Parallel Index Only Scan using pgbench_accounts_3_pkey on`
- `pgbench_accounts_3 pgbench_accounts_2`
- `-> Partial Aggregate`
- `-> Parallel Index Only Scan using pgbench_accounts_4_pkey on`
- `pgbench_accounts_4 pgbench_accounts_3`
- `-> Partial Aggregate`
- `-> Parallel Index Only Scan using pgbench_accounts_5_pkey on`
- `pgbench_accounts_5 pgbench_accounts_4`
- `-> Partial Aggregate`
- `-> Parallel Index Only Scan using pgbench_accounts_6_pkey on`
- `pgbench_accounts_6 pgbench_accounts_5`
- `-> Partial Aggregate`
- `-> Parallel Index Only Scan using pgbench_accounts_7_pkey on`
- `pgbench_accounts_7 pgbench_accounts_6`
- `-> Partial Aggregate`
- `-> Parallel Index Only Scan using pgbench_accounts_8_pkey on`
- `pgbench_accounts_8 pgbench_accounts_7`
- `-> Partial Aggregate`
- `-> Parallel Index Only Scan using pgbench_accounts_9_pkey on`
- `pgbench_accounts_9 pgbench_accounts_8`
- `-> Partial Aggregate`
- `-> Parallel Index Only Scan using pgbench_accounts_10_pkey on`
- `pgbench_accounts_10 pgbench_accounts_9`
Avec la clé, PostgreSQL se restreint à la (ou les) bonne(s) partition(s):
**Exemple p314-1.** Exemple extrait du PDF\, page 314\.
```text
EXPLAIN (COSTS OFF) SELECT * FROM pgbench_accounts WHERE aid = 599999 ;
```
```text
QUERY PLAN
```
**Exemple p314-2.** Exemple extrait du PDF\, page 314\.
```text
Index Scan using pgbench_accounts_1_pkey on pgbench_accounts_1 pgbench_accounts
Index Cond: (aid = 599999)
```
Si l’on connaît la clé et que le développeur sait en déduire la table, il est aussi possible d’accéder directement à la partition:
**Exemple p314-3.** Exemple extrait du PDF\, page 314\.
```text
EXPLAIN (COSTS OFF) SELECT * FROM pgbench_accounts_6 WHERE aid = 599999 ;
```
**Exemple p314-4.** Exemple extrait du PDF\, page 314\.
```text
QUERY PLAN
```
```text
QUERY PLAN
```
- `Index Scan using pgbench_accounts_6_pkey on pgbench_accounts_6 Index Cond: (aid = 599999)`
Cela allège la planification, surtout s’il y a beaucoup de partitions.
Exemples:
- dans une table partitionnée par statut de commande, beaucoup de requêtes ne s’occupent que d’un statut particulier, et peuvent donc n’appeler que la partition concernée (attention si le statut change…);
- dans une table partitionnée par mois de création d’une facture, la date de la facture permet de s’adresser directement à la bonne partition.
Il est courant que les ORM ne sachent pas exploiter cette fonctionnalité.
#### 6.3.1 Attacher/détacher une partition
**`ALTER TABLE`** `logs` **`ATTACH PARTITION`** `logs_archives` **`FOR VALUES FROM`** `(` **`MINVALUE`** `)` **`TO`** `('2019-01-01');`
- Vérification du respect de la contrainte
- parcours complet de la table: lent + verrou!
**Exemple p314-5.** Exemple extrait du PDF\, page 314\.
```sql
ALTER TABLE logs DETACH PARTITION logs_archives ;
```
- Rapide… mais verrou
Attacher une table existante à une table partitionnée implique de définir une clé de partitionnement. PostgreSQL vérifiera que les valeurs présentes correspondent bien à cette clé. Cela peut être long, surtout que le verrou nécessaire sur la table est gênant. Pour accélérer les choses, il est conseillé d’ajouter au préalable une contrainte `CHECK` correspondant à la clé, voire d’ajouter d’avance les index qui seraient ajoutés lors du rattachement.
Détacher une partition est beaucoup plus rapide qu’en attacher une. Cependant, là encore, le verrou peut être gênant.
#### 6.3.2 Supprimer une partition
**`DROP TABLE`** `logs_2018;`
Là aussi, l’opération est simple et rapide, mais demande un verrou exclusif.
#### 6.3.3 Limitations principales du partitionnement déclaratif
- Temps de planification! Attention si > 100 partitions
- Création non automatique
- Pas d’héritage multiple, schéma fixe
Certaines limitations du partitionnement sont liées à son principe. Les partitions ont forcément le même schéma de données que leur partition mère. Il n’y a pas de notion d’héritage multiple.
La création des partitions n’est pas automatique (par exemple dans un partitionnement par date). Il faudra prévoir de les créer par avance.
Une limitation sérieuse du partitionnement tient au temps de planification qui augmente très vite avec le nombre de partitions, même petites. En général, on considère qu’il faut éviter de dépasser 100 partitions.
Pour contourner cette limite, il reste possible de manipuler directement les partitions s’il est facile de trouver leur nom.
### 6.4 CONCLUSION
- Préférer une version récente de PostgreSQL
- Pour plus de détails sur le partitionnement - https://dali.bo/v1_html
le partitionnement déclaratif apparu en version10est mûr dans les dernières versions.il introduit une complexité supplémentaire, mais peut rendre de grands services quand la volumétrie augmente.
Le module V1 fournit plus de précisions sur l’intérêt, l’utilisation, l’indexation, les statistiques, la maintenance liées au partionnement.
### 6.5 QUIZ
**https://dali.bo/v0_quiz**
---
_Source : [manuel complet PDF](/downloads/dalibo/manuals/dba2-handout.pdf), révision 26.09, pages PDF 305-318. Les travaux pratiques et leurs solutions proviennent exclusivement de la version complète._
Pour poursuivre la lecture, voir [la sauvegarde physique et le PITR](/fr/dba2/07-sauvegarde-pitr/#dba2-ch7).