2 Sauvegarde physique à chaud et PITR
Sauvegarde physique à chaud et PITR
Le module conserve les procédures de sauvegarde et de restauration, puis les deux sections de travaux pratiques et leurs solutions. Pour les mécanismes internes, voir aussi la politique générale de sauvegarde et le chapitre pg_basebackup.
2/ Sauvegarde physique à chaud et PITR
2.1 Introduction
- Sauvegarde traditionnelle
- sauvegarde pg_dump à chaud
- sauvegarde des fichiers à froid
- Insuffisant pour les grosses bases
- long à sauvegarder
- encore plus long à restaurer
- Perte de données potentiellement importante
- car impossible de réaliser fréquemment une sauvegarde
- Une solution : la sauvegarde PITR
La sauvegarde traditionnelle, qu’elle soit logique ou physique à froid, répond à beaucoup de besoins. Cependant, ce type de sauvegarde montre de plus en plus ses faiblesses pour les gros volumes : la sauvegarde est longue à réaliser et encore plus longue à restaurer. Et plus une sauvegarde met du temps, moins fréquemment on l’exécute. La fenêtre de perte de données devient plus importante. PostgreSQL propose une solution à ce problème avec la sauvegarde physique à chaud. On peut l’utiliser comme un simple mode de sauvegarde supplémentaire, mais elle permet bien d’autres possibilités, d’où le nom de PITR (Point In Time Recovery).
2.1.1 Au menu
- Rappel sur la journalisation
- Principe de la sauvegarde PITR
- Mise en place
- sauvegarde : manuelle, ou avec pg_basebackup
- archivage : manuel, ou avec pg_receivewal
- Restaurer une sauvegarde PITR
- Archivage & compression
- Des outils
Ce module fait le tour de la sauvegarde PITR, de la mise en place de l’archivage (manuelle ou avec l’outil pg_receivewal ) à la sauvegarde des fichiers (en manuel, ou avec l’outil pg_basebackup ). Il discute aussi de la restauration d’une telle sauvegarde. Nous évoquerons très rapidement quelques outils externes pour faciliter ces sauvegardes.
2.2 Rappel sur la journalisation
2.2.1 Journaux de transaction
- Write Ahead Logs (WAL)
- Chaque donnée est écrite 2 fois sur le disque !
- Avantages :
- sécurité infaillible (après COMMIT ), intégrité, durabilité
- écriture séquentielle rapide, et un seul sync sur le WAL
- fichiers de données écrits en asynchrone
- sauvegarde PITR et réplication fiables
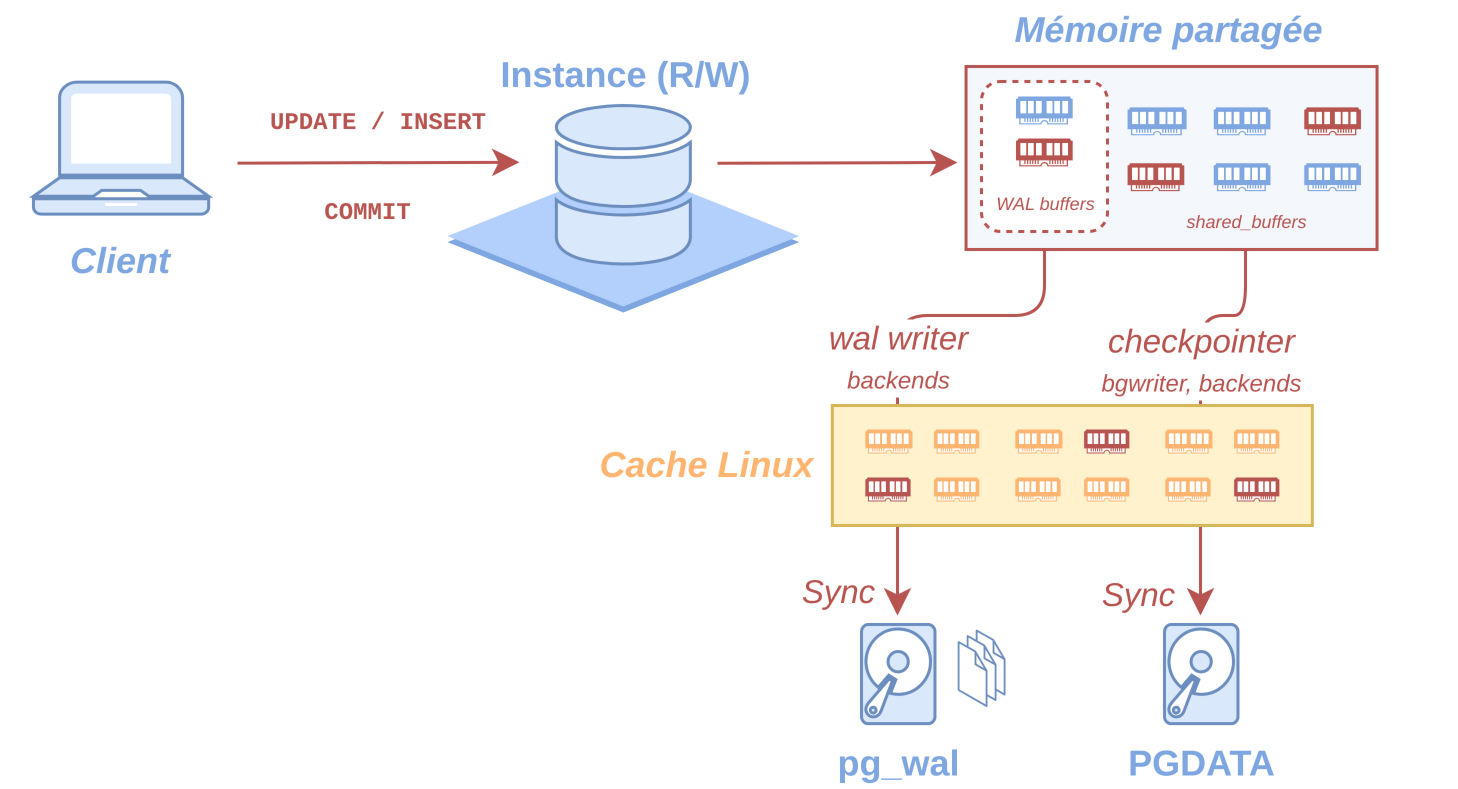
Les journaux de transactions (appelés souvent WAL) sont une garantie contre les pertes de données. Il s’agit d’une technique standard de journalisation appliquée à toutes les transactions, pour garantir l’intégrité (la base reste cohérente quoiqu’il arrive) et la durabilité (ce qui est validé ne sera pas perdu). Ainsi lors d’une modification de donnée, l’écriture au niveau du disque se fait généralement en deux temps :
- écriture des modifications dans le journal de transactions, avec écriture forcée sur disque (« synchronisation ») lors d’un COMMIT ;
- écriture dans le fichier de données bien plus tard, lors d’un « checkpoint ».
Ainsi en cas de crash :
- PostgreSQL redémarre;
- il vérifie s’il reste des données non intégrées aux fichiers de données dans les journaux (mode recovery);
- si c’est le cas, ces données sont recopiées dans les fichiers de données afin de retrouver un état stable et cohérent;
- PostgreSQL peut alors s’ouvrir sans perte des transactions validées lors du crash (une transaction interrompue, et donc jamais validée, est perdue). Les écritures dans le journal se font de façon séquentielle, donc sans grand déplacement de la tête d’écriture (sur un disque dur classique, c’est l’opération la plus coûteuse). De plus, comme nous n’écrivons que dans un seul fichier de transactions, la synchronisation sur disque, lors d’un COMMIT , peut se faire sur ce seul fichier, si le système de fichiers le supporte. Concrètement, ces journaux sont des fichiers de 16 Mo par défaut, avec des noms comme 0000000100000026000000AF , dans le répertoire pg_wal/ de l’instance PostgreSQL (répertoire souvent sur une partition dédiée).
L’écriture définitive dans les fichiers de données est asynchrone, et généralement lissée, ce qui est meilleur pour les performances qu’une écriture immédiate. Cette opération est appelée « checkpoint » et périodique (5 minutes par défaut, ou plus). Divers paramètres et fonctionnalités peuvent altérer ce comportement par défaut, par exemple pour des raisons de performances. À côté de la sécurité et des performances, le mécanisme des journaux de transactions est aussi utilisé pour des fonctionnalités très intéressantes, comme le PITR et la réplication physique, basés sur le rejeu des informations stockées dans ces journaux. Pour plus d’informations :
PostgreSQL et ses journaux de transactions 1 , Guillaume Lelarge, GNU/Linux Magazine n°108 (septembre 2008), encore d’actualité pour l’essentiel.
2.3 PITR
- Point In Time Recovery
- À chaud
- En continu
- Cohérente
2.3.1 Sauvegarde physique
Image de la base au niveau des fichiers
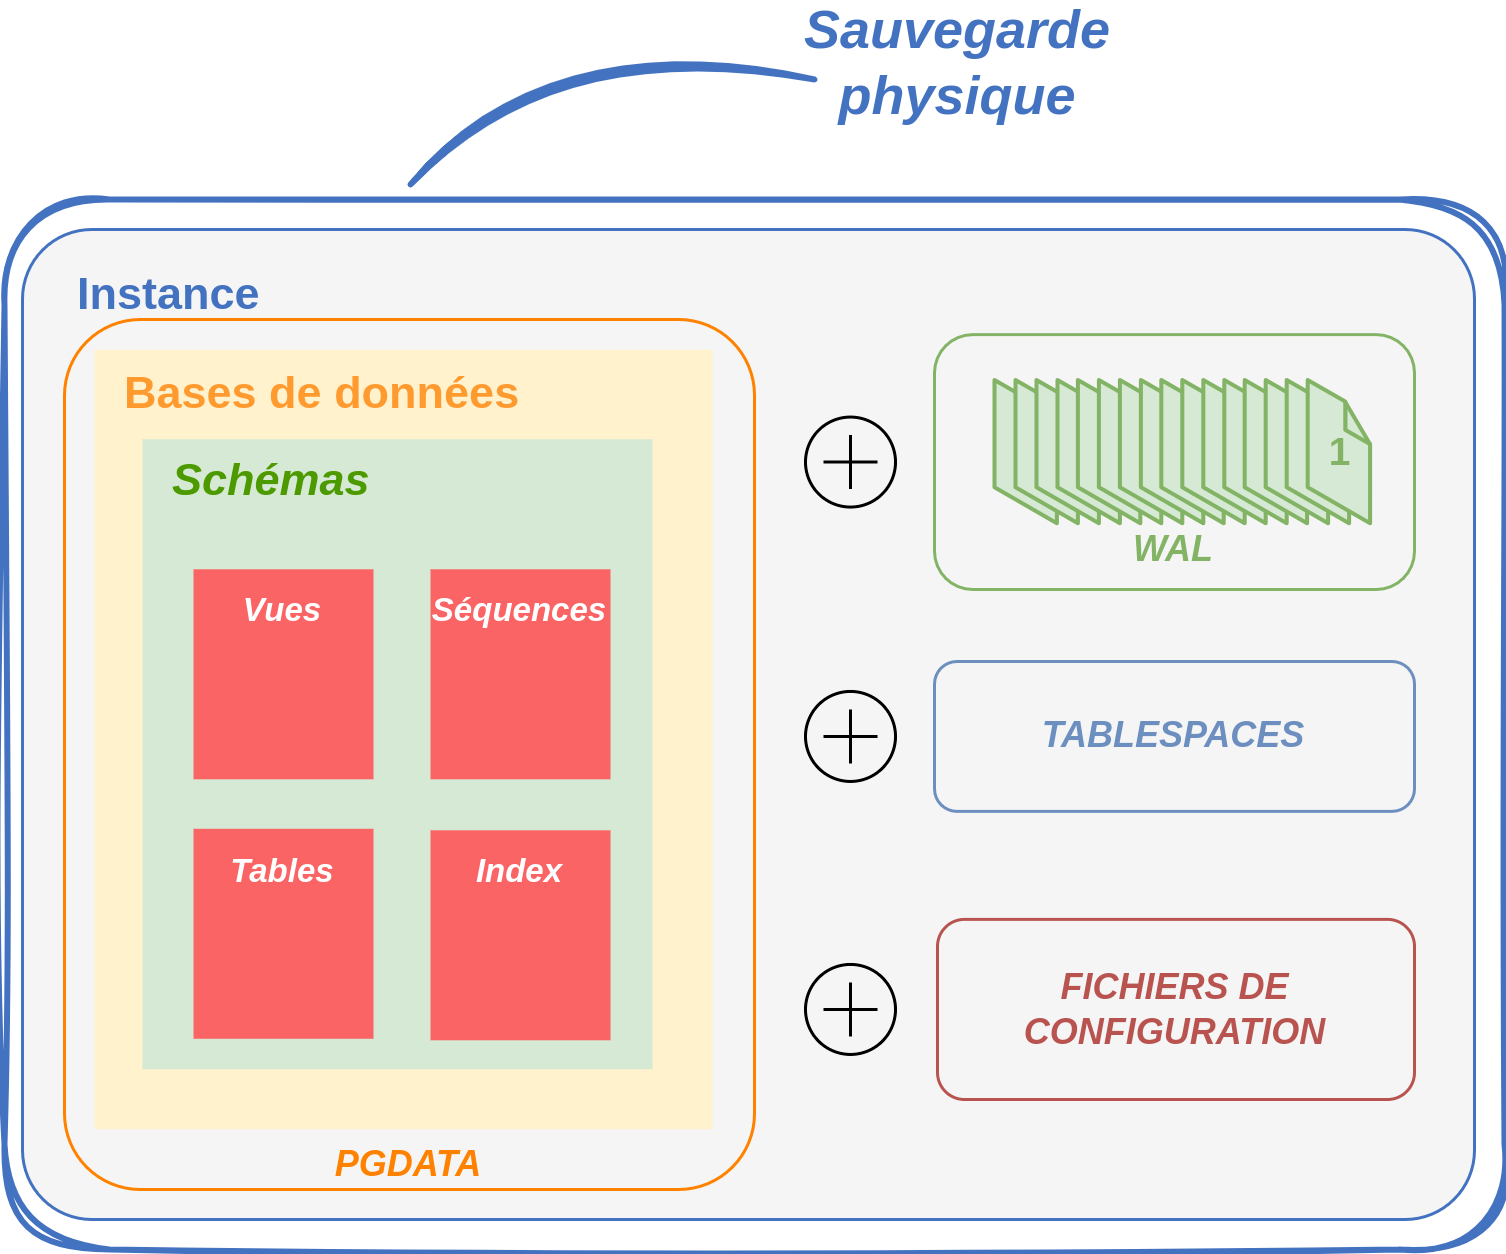
Une sauvegarde PITR est d’abord une sauvegarde physique, c’est-à-dire une image au niveau des fichiers. Sont copiés (presque) tous les fichiers de toutes les bases :
- d’abord bien sûr les fichiers des tables, y compris leur fragmentation et leurs espaces vides ;
- les index complets;
- les vues matérialisées compilées;
- tous les tablespaces;
- les fichiers de configuration (selon le système) :
- tous les fichiers techniques (par exemple le contenu de pg_xact/ )… L’image physique fait donc la même taille que l’instance d’origine. Une telle sauvegarde peut se faire sans problème à froid, base arrêtée, avec un outil aussi simple cp . À chaud ce n’est pas aussi simple. (À l’inverse, une sauvegarde logique faite avec pg_dump ou pg_dumpall ne copie que les données, et uniquement les définitions des index ou des vues matérialisées. Les objets (bases, tables…) peuvent être sélectionnés finement. À la restauration, la fragmentation a disparu, mais les index et vues matérialisées doivent être reconstruites. Cette restauration peut être très lente.)
2.3.2 Principe du PITR
Archiver tous les journaux et le base backup
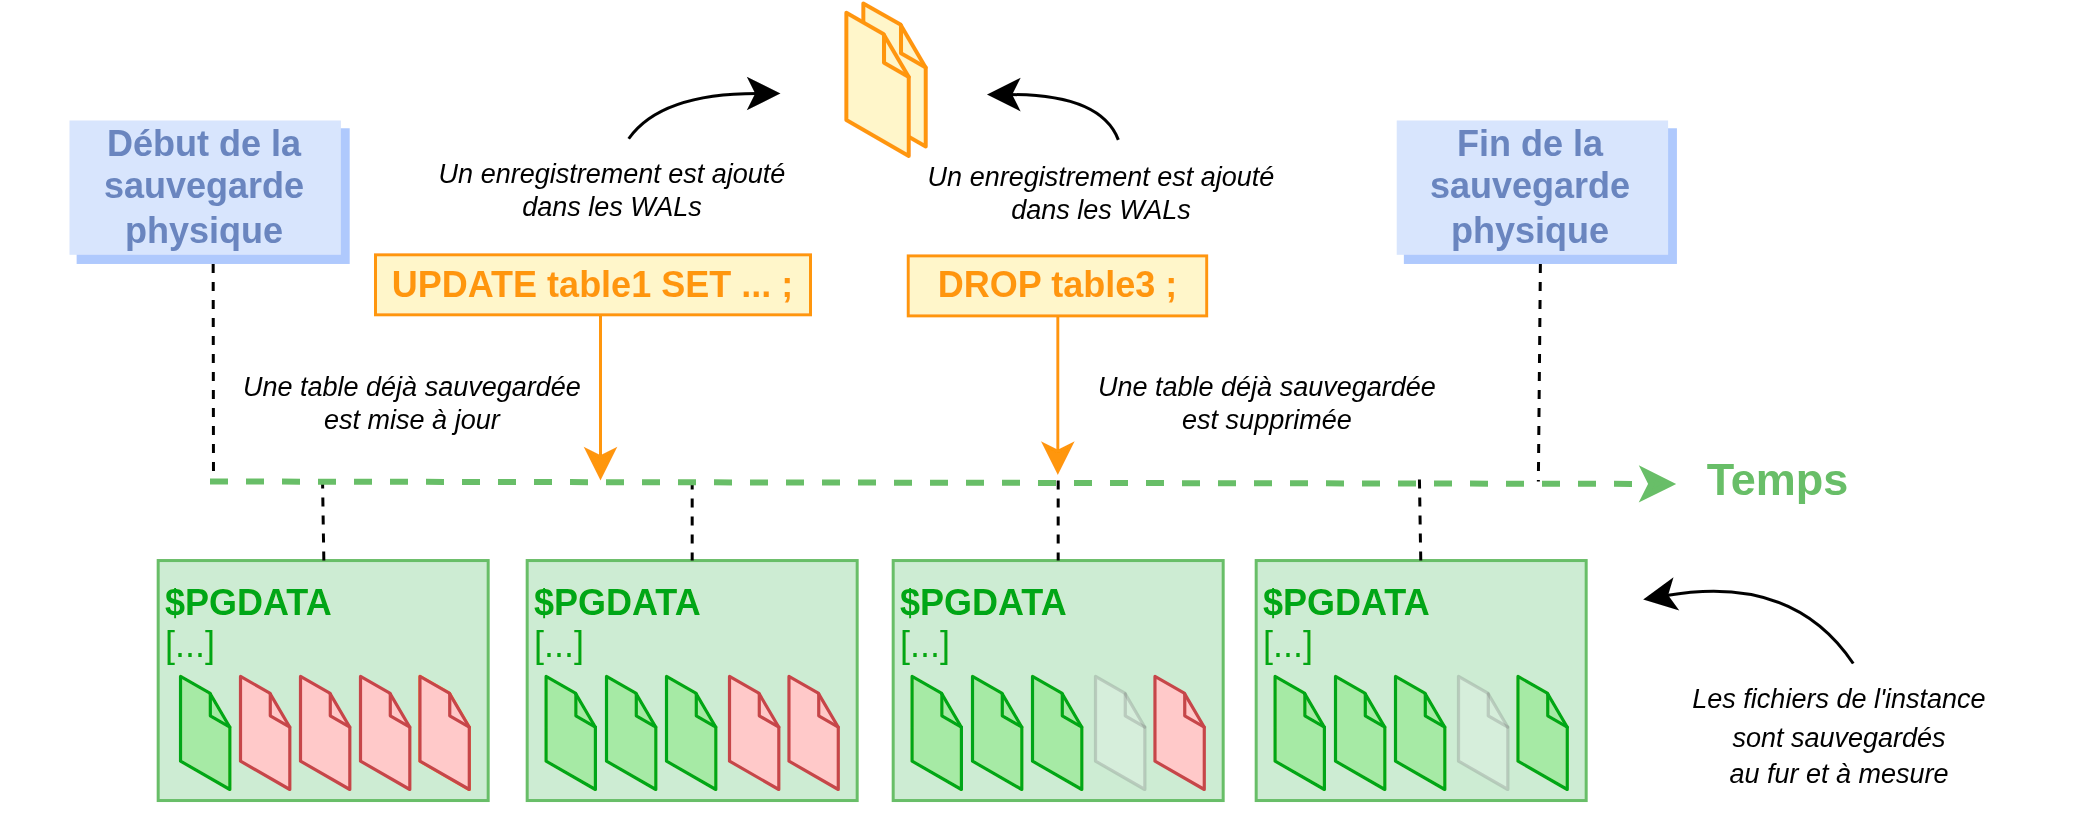
PITR est l’acronyme de Point In Time Recovery, autrement dit restauration à un point dans le temps. C’est une sauvegarde à chaud et surtout en continu. Là où une sauvegarde logique du type pg_dump se fait au mieux une fois toutes les 24 h, la sauvegarde PITR se fait en continu grâce à l’archivage des journaux de transactions. De ce fait, ce type de sauvegarde diminue très fortement la fenêtre de perte de données. Bien qu’elle se fasse à chaud, la sauvegarde est cohérente. Les données à écrire dans les fichiers de données sont d’abord écrites dans un journal de transactions, que la transaction soit validée ou non. Les états des transaction y figurent aussi, ainsi que les résultats des opérations de maintenance et d’administration ( VACUUM , ANALYZE , gestion des rôles…). Les journaux de transactions contiennent donc toutes les modifications survenant sur les fichiers de données, pour les objets utilisateurs comme pour les objets systèmes. Pour reconstruire un système, il suffit donc d’avoir ces journaux et d’avoir un état des fichiers du répertoire des données à un instant t (base backup). Toutes les actions effectuées après cet instant t pourront être rejouées en demandant à PostgreSQL d’appliquer les actions contenues dans les journaux. Les opérations stockées dans les journaux correspondent à des modifications physiques de fichiers, il faut donc partir d’une sauvegarde au niveau du système de fichier, un export avec pg_dump n’est pas utilisable. Il est donc nécessaire de conserver ces journaux de transactions. Or PostgreSQL les recycle dès qu’il n’en a plus besoin. La solution est de demander au moteur de les archiver ailleurs avant ce recyclage. On doit aussi disposer de l’ensemble des fichiers qui composent le répertoire des données, y compris les tablespaces si ces derniers sont utilisés. La restauration a besoin des journaux de transactions archivés. Il n’est pas possible de restaurer avec la seule sauvegarde des fichiers de la base (et encore moins de revenir à un point donné).
Pour être cohérente, une sauvegarde a toujours besoin d’être complétée par les journaux émis pendant qu’elle copiait les fichiers.
Une fois la sauvegarde des fichiers restaurée, et la configuration réalisée pour rejouer les journaux archivés, il sera possible de retrouver une instance cohérente.
2.3.3 Restauration PITR
- Les journaux de transactions contiennent toutes les modifications
- Il faut les archiver
- …et avoir une image des fichiers à un instant t (base backup)
- La restauration se fait en restaurant cette image
- puis en rejouant les journaux
- dans l’ordre
- sans trou
- entièrement
- au moins jusqu’au point de cohérence
- toute l’activité de la base
- tous… ou jusqu’au moment voulu
Comme les journaux redéroulent toute l’activité depuis le début de la sauvegarde PITR, ils doivent impérativement être rejoués dans l’ordre de leur écriture (et donc de leur nom), et leur contenu entier est appliqué.
Tout ce qui a pu modifier les fichiers de données a été écrit dans les journaux, et est donc reproduit pendant le rejeu. Par exemple, si pendant la vie de la base une table a été créée, remplie puis supprimée, le rejeu des journaux reproduira exactement les modifications des fichiers de la base. De même pour les opérations de maintenance liées aux VACUUM , réindexations, analyses de statistiques, etc.
Une fois rejoués les journaux générés pendant la sauvegarde, la base atteint le « point de cohérence » : elle est utilisable. On peut ensuite continuer à rejouer tout ou partie des journaux générés par la suite. Ces journaux peuvent être très nombreux et représenter des jours d’activité de l’instance PostgreSQL. Le rejeu sera bien sûr beaucoup plus rapide. Le rejeu s’arrête quand :
- les journaux à rejouer sont épuisés : on est revenu à l’état final de la base juste avant la restauration;
- ou bien si le DBA a demandé à s’arrêter à un moment précis, par exemple avant une fausse manipulation.
Répétons qu’il est critique de ne perdre aucun journal. S’il en manque un, ou s’il est inutilisable, la restauration n’ira pas plus loin, les journaux suivants ne seront pas rejoués. La base sera cohérente et utilisable uniquement si l’on a pu réappliquer au moins les journaux générés pendant la sauvegarde (point de cohérence).
2.3.4 Avantages du PITR
- Sauvegarde à chaud
- Choix du moment d’arrêt du rejeu
- Moins de perte de données
- Grandes bases : plus réaliste que pg_dump
Tout le travail est réalisé à chaud, que ce soit l’archivage des journaux ou la sauvegarde des fichiers de la base. En effet, il importe peu que les fichiers de données soient modifiés pendant la sauvegarde, car les journaux de transactions archivés permettront de corriger toute incohérence par leur application. Le rejeu des journaux permet de choisir précisément le moment où s’arrêter. Le DBA peut décider de rejouer :
- tous les journaux, par exemple pour revenir à l’état de la base avant une panne du disque ;
- jusqu’avant une fausse manipulation (un DROP TABLE malencontreux par exemple), en précisant l’heure ou la transaction précise;
- jusqu’à un point de sauvegarde, par exemple avant un batch de nuit qui a échoué ;
- jusqu’au point de cohérence seulement, par exemple pour créer une base de données de test à partir de la sauvegarde de la production.
Autre avantage majeur, la sauvegarde PITR est le système de sauvegarde qui occasionne le moins de perte de données (RPO). Avec l’archivage continu des journaux de transactions, la fenêtre de perte de données est très fortement réduite. Plus l’activité est intense, plus la fenêtre de temps est petite, car les fichiers des journaux sont de taille fixe, et ils ne sont archivés que complets. (On peut forcer l’archivage à intervalles réguliers pour réduire encore les pertes en période calme.)
Une perte nulle (RPO) ne se réalise qu’avec une autre instance secondaire utilisant la réplication synchrone, ou éventuellement avec l’outil pg_receivewal .
À l’inverse, une sauvegarde logique avec pg_dump entraîne une perte de données bien plus importante, car elle est généralement quotidienne. Si pg_dump est lancé à 3 h et que le souci imposant la restauration a lieu à 12 h, on perd 9 heures de données. Pour les grandes bases de données (centaines de gigaoctets ou plus), une sauvegarde logique est difficilement envisageable, et une restauration est interminable. Une sauvegarde PITR est généralement plus rapide à faire et à restaurer.
2.3.5 Inconvénients du PITR
- Sauvegarde/restauration de l’instance complète
- Impossible de changer d’architecture (même OS conseillé)
- Nécessite un grand espace de stockage (données + journaux)
- Interdiction de perdre un journal
- Risque d’accumulation des journaux
- dans pg_wal/ si échec d’archivage… et arrêt si plein !
- dans le dépôt d’archivage si échec des sauvegardes
- Plus complexe
Le premier inconvénient vient directement du fait qu’on copie les fichiers : la sauvegarde et la restauration concernent l’instance complète. Il est impossible de ne restaurer qu’une seule base ou que quelques tables. La restauration se fait impérativement sur la même architecture (x86/ARM, 32/64 bits, little/big endian). Il est même fortement conseillé de restaurer dans la même version du même système d’exploitation, sous peine de devoir réindexer l’instance ensuite (à cause d’une différence de définition des locales entre deux versions majeures d’une distribution). De plus, une sauvegarde PITR nécessite un plus grand espace de stockage. Non seulement il faut sauvegarder les fichiers, y compris les index et la fragmentation, mais aussi tous les journaux de transactions sur une certaine période, ce qui peut être volumineux (en tout cas beaucoup plus que des pg_dump ). La volumétrie des journaux dépend fortement de l’activité.
En cas de problème dans l’archivage et selon la méthode choisie, l’instance ne voudra pas effacer les journaux non archivés. Il y a donc un risque d’accumulation de ceux-ci. Il faudra donc surveiller la taille du pg_wal . En cas de saturation, PostgreSQL s’arrête! Si un journal est perdu ou corrompu, la restauration ne pourra jamais aller au-delà de ce journal. Le risque augmente avec le nombre de journaux conservés.
Pour réduire le risque de perte d’un journal, et aussi pour accélérer le temps de rejeu, il est conseillé de procéder à des base backups (complet, différentiels… selon l’outil) assez fréquemment.
Enfin, la sauvegarde PITR est plus complexe à mettre en place qu’une sauvegarde pg_dump . Elle nécessite plus d’étapes, une réflexion sur l’architecture à mettre en œuvre et une meilleure compréhension des mécanismes internes à PostgreSQL pour en avoir la maîtrise.
2.4 Copie physique à chaud ponctuelle avec pg_basebackup
(Non PITR)
2.4.1 Introduction à pg_basebackup
- Simple & efficace
- Fourni avec PostgreSQL
- Réalise les 2 étapes d’une sauvegarde
- « base backup »
- journaux nécessaires (mais pas plus)
- fichiers ou archives
- Pas de reprise si échec
- Pas de PITR
- peut servir de base
- Configuration : streaming (rôle, droits, slots)
- Restauration : décompresser/copier la sauvegarde
2.4.1.1 Introduction
pg_basebackup est un produit qui a beaucoup évolué dans les dernières versions de PostgreSQL. Ce qui suit est une présentation très succinte.
pg_basebackup est simple à mettre en place et à utiliser, et permet d’éviter de nombreuses étapes que nous verrons par la suite. De plus, il est livré avec PostgreSQL, et le paramétrage par défaut le rend immédiatement utilisable.
Il permet de sauvegarder toute l’instance, à distance, via deux connexions de réplication :
- une pour les données ;
- une pour les journaux de transactions qui sont générés pendant la copie.
Au final, la sauvegarde comprend les fichiers et les journaux nécessaires. Elle peut être compressée.
2.4.1.2 Limitations
pg_basebackup convient pour une copie complète unique. Sa sauvegarde incrémentale est peu adaptée à l’utilisation par un DBA. Il ne sait pas réutiliser une sauvegarde interrompue. pg_basebackup ne permet pas de continuer à archiver les journaux. Il utilise le protocole de réplication pour récupérer les journaux de transactions nécessaires à une sauvegarde, et uniquement eux, et pas les suivants. Il n’est donc pas capable de gérer le PITR. Il ne parallélise pas ses opérations de copie.
2.4.1.3 Utilisations
pg_basebackup convient parfaitement pour une copie ponctuelle, à chaud, d’une base pas trop énorme. C’est parfois suffisant. Il peut aussi servir de base à un outil ou un script pour la copie des fichiers de l’instance, qui est la partie la plus pénible à scripter. La partie archivage est plus simple. Barman, notamment, utilise pg_basebackup.
2.4.1.4 Mise en place
Configuration : pg_basebackup nécessite des connexions de réplication. De plus, par défaut et de manière transparente, il utilise aussi un slot de réplication temporaire, une technique qui fiabilise la sauvegarde ou la réplication en indiquant à l’instance quels journaux elle doit conserver. Avec la configuration de PostgreSQL par défaut, tout est en place :
Ensuite, il faut configurer le fichier pg_hba.conf pour accepter la connexion du serveur où est exécuté pg_basebackup. Dans la configuration par défaut, il y a en général cette ligne qui permet au moins de faire une copie en local avec l’utilisateur système postgres :
(noter la base replication). Il vaut mieux un utilisateur dédié à la connexion de réplication (au sens de la base de données) séparé, nommé ici sauve. Il faut donc ajouter cette ligne :
Il faut créer cet utilisateur dédié :
Dans un but d’automatisation, le mot de passe finira souvent dans un fichier .pgpass ou équivalent.
2.4.1.5 Exemple de sauvegarde
La commande suivante :
- lance pg_basebackup , ici en lui demandant une archive au format tar ;
- archive les journaux en utilisant une connexion de réplication par streaming;
- force le checkpoint pour gagner quelques minutes;
- implicitement, utilise un slot de réplication temporaire pour sécuriser l’opération.
644320/644320 kB (100%), 1/1 tablespace
Le résultat est ici un ensemble des deux archives :
total 4163772 -rw——- 1 postgres postgres 659785216 Oct 9 11:37 base.tar -rw——- 1 postgres postgres 16780288 Oct 9 11:37 pg_wal.tar
D’autres archives peuvent apparaître s’il y a des tablespaces supplémentaires. Une sauvegarde avec –format=plain donne une image complète, non compressée, du PGDATA, répertoire pg_wal compris (par défaut). C’est l’idéal pour obtenir un clone du répertoire de données.
Noter que les fichiers de configuration ne sont PAS inclus s’ils ne sont pas dans le PGDATA. Attention donc sur Debian, Ubuntu et leurs versions dérivées.
2.4.1.6 Restauration
pg_basebackup n’a pas d’options de restauration. La copie des données est suffisante, éventuellement après décompression, et doit être placée manuellement à la place du PGDATA à (re)créer. Au démarrage, l’instance repère qu’elle est une sauvegarde restaurée et réapplique les journaux (ou va les chercher si elle est configurée ainsi). L’instance restaurée contient au final les données telles qu’elles étaient à la fin du pg_basebackup et est donc utilisable. La récupération d’autres journaux relève ensuite de la configuration de PostgreSQL. L’outil est développé plus en détail dans notre module BK50 2 .
- Source 2 : https://dali.bo/bk50_html
2.5 Archivage des journaux & archiver
2.5.1 Rappel des étapes d’une sauvegarde PITR
- D’abord :
- archivage des journaux de transactions
- Puis : sauvegarde des fichiers
- pg_basebackup
- ou manuellement (outils de copie classiques)
Une sauvegarde PITR demande peu d’étapes. La première chose à faire est de mettre en place l’archivage des journaux de transactions. Généralement on utilisera l’archivage classique avec le paramètre archive_command, mais il existe une alternative nommée pg_receivewal.
Lorsque cette étape est réalisée (et fonctionnelle), il est possible de passer à la seconde : la sauvegarde des fichiers. Là aussi, il y a différentes possibilités :
- manuellement (c’est une copie de fichiers);
- pg_basebackup;
- son propre script;
- un outil extérieur.
2.5.2 Méthodes d’archivage
Deux méthodes :
- Généralement :
- processus interne archiver
- Alternative :
- pg_receivewal (flux de réplication)
La méthode historique, et la plus utilisée toujours, utilise le processus archiver . Ce processus fonctionne sur l’instance sauvegardée et fait partie des processus du serveur PostgreSQL. Seule sa (bonne) configuration incombe au DBA, notamment le paramètre archive_command .
Une autre méthode existe : pg_receivewal . Cet outil livré aussi avec PostgreSQL se comporte comme un serveur secondaire, tournant sur un autre serveur. Il reconstitue les journaux de transactions à partir du flux de réplication. Elle est plus rarement utilisée (l’outil barman par exemple l’utilise), car les bases critiques ont déjà un serveur en réplication, en général. Chaque solution a ses avantages et inconvénients.
2.5.3 Choix du répertoire d’archivage
- À faire quelle que soit la méthode d’archivage
- Attention aux droits d’écriture dans le répertoire
- la commande configurée pour la copie doit pouvoir écrire dedans
- et potentiellement y lire
Dans le cas de l’archivage historique, le serveur PostgreSQL va exécuter une commande, dont le rôle sera de copier les journaux à l’extérieur de son répertoire de travail :
- sur un disque différent du même serveur (à éviter);
- sur un disque d’un autre serveur (montage réseau, transfert par SSH, bucket S3…) ;
- sur des bandes… L’exemple pris ici utilise le répertoire /mnt/nfs1/archivage comme répertoire de copie. Ce répertoire est en fait un montage NFS. Il faut donc commencer par créer ce répertoire et s’assurer que l’utilisateur système postgres peut écrire dedans :
Dans le cas de l’archivage avec pg_receivewal , c’est cet outil qui va écrire les journaux dans un répertoire de travail. Cette écriture ne peut se faire qu’en local. Cependant, le répertoire peut se trouver dans un montage réseau (NFS…).
2.5.4 Processus archiver : configuration (1/4)
Préalables :
- Dans postgresql.conf :
- wal_level = replica
- archive_mode = on (ou always )
Après avoir créé le répertoire d’archivage, il faut configurer PostgreSQL pour lui indiquer comment archiver. Niveau d’archivage : La valeur par défaut de wal_level est adéquate :
Ce paramètre indique le niveau des informations écrites dans les journaux de transactions. Avec un niveau minimal , les journaux ne servent qu’à garantir la cohérence des fichiers de données en cas de crash. Dans le cas d’un archivage, il faut écrire plus d’informations, d’où la nécessité du niveau
replica (qui est celui par défaut). Le niveau logical , nécessaire à la réplication logique 3 , convient également. Mode d’archivage : Il s’active ainsi sur une instance seule ou primaire :
(La valeur always permet d’archiver depuis un secondaire. Avec on , l’instance n’archive les journaux que si elle est primaire.) Le changement nécessite un redémarrage.
2.5.5 Processus archiver : configuration (2/4)
La commande d’archivage :
- Dans postgresql.conf :
- archive_command = ‘… une commande …’
- ou : archive_library = ‘… une bibliothèque …’ (v15+)
2.5.5.1 Archive_command
Enfin, une commande d’archivage doit être définie par le paramètre archive_command . archive_command sert à archiver un seul fichier à chaque appel. PostgreSQL l’appelle une fois pour chaque fichier WAL, impérativement dans l’ordre des fichiers. En cas d’échec, elle est répétée indéfiniment jusqu’à réussite, avant de passer à l’archivage du fichier suivant.
2.5.5.2 Archive_library
Signalons pour mémoire, qu’il existe une alternative : le paramètre archive_library . Il indique une bibliothèque partagée qui fait ce travail d’archivage. Sur le papier, une bibliothèque en C est plus puissante et performante. PostgreSQL fournit une librairie basic_archive 4 , qui tient plus de la démonstration. Notre blog présente un autre exemple fonctionnel 5 avec une extension en C, capable de compresser les journaux de transactions. Cependant, à notre connaissance (à l’été 2026), aucun outil courant n’utilise encore cette fonctionnalité, qui est sans doute plutôt utilisée par des opérateurs cloud. En production, on ne voit guère qu’ archive_command .
- Source 3 : https://dali.bo/w5_html
- Source 4 : https://docs.postgresql.fr/current/basic-archive.html
- Source 5 : https://blog.dalibo.com/2023/07/28/hackingpg2.html
L’utilisation simultanée de archive_command et archive_library est interdite depuis PostgreSQL 16.
2.5.6 Processus archiver : configuration (3/4)
- Exemples d’ archive_command :
- Ne pas oublier de forcer l’écriture de l’archive sur disque
- Code retour de l’archivage entre 0 (ok) et 125
PostgreSQL laisse le soin à l’administrateur de définir la méthode d’archivage des journaux de transactions suivant son contexte. Si vous utilisez un outil de sauvegarde, la commande vous sera probablement fournie. Une simple commande de copie suffit dans la plupart des cas. La directive archive_command peut alors être positionnée comme suit :
Le joker %p est remplacé par le chemin complet vers le journal de transactions à archiver, par exemple pg_wal/00000001000000A900000065 . Le joker %f correspond au nom du journal de transactions une fois archivé, par exemple 00000001000000A900000065 . La commande réellement exécutée ressemblera donc à ceci :
En toute rigueur, une copie du fichier ne suffit pas. Par exemple, dans le cas de la commande cp , le nouveau fichier n’est pas immédiatement écrit sur disque. La copie est effectuée dans le cache disque du système d’exploitation. En cas de crash juste après la copie, il est tout à fait possible de perdre l’archive. Il est donc essentiel d’ajouter une étape de synchronisation du cache sur disque (ordre sync ). La commande d’archivage suivante est donnée dans la documentation officielle à titre d’exemple :
Cette commande a deux inconvénients. Elle ne garantit pas que les données seront synchronisées sur disque. Et si le fichier existe ou a été copié partiellement à cause d’une erreur précédente, la copie ne s’effectuera pas.
Cette protection est une bonne chose. Cependant, il faut être vigilant lorsque l’on rétablit le fonctionnement de l’archiver suite à un incident ayant provoqué des écritures partielles dans le répertoire d’archive, comme une saturation de l’espace disque.
Il est aussi possible de placer dans archive_command le nom d’un script bash, perl ou autre. L’intérêt est de pouvoir faire plus qu’une simple copie. On peut y ajouter la demande de synchronisation du cache sur disque, ou de la gestion d’erreur plus complexe. Il peut aussi être intéressant de tracer l’action de l’archivage, ou de compresser le journal avant archivage.
Dans vos commandes et scripts, il faut s’assurer d’une chose : la commande d’archivage doit retourner 0 en cas de réussite et surtout une valeur différente de 0 en cas d’échec. Si le code retour de la commande est compris entre 1 et 125, PostgreSQL va tenter périodiquement d’archiver le fichier jusqu’à ce que la commande réussisse (autrement dit, renvoie 0). Tant qu’un fichier journal n’est pas considéré comme archivé avec succès, PostgreSQL ne le supprimera ou recyclera pas! Il ne cherchera pas non plus à archiver les fichiers suivants.
De plus si le code retour de la commande est supérieur à 125, le processus archiver redémarrera, et l’erreur ne sera pas comptabilisée dans la vue pg_stat_archiver ! Ce cas de figure inclut les erreurs de type command not found associées aux codes retours 126 et 127, ou le cas de rsync , qui renvoie un code retour 255 en cas d’erreur de syntaxe ou de configuration du ssh.
Il est donc important de surveiller le processus d’archivage et de faire remonter les problèmes à un opérateur. Les causes d’échec sont nombreuses : problème réseau, montage inaccessible, erreur de paramétrage de l’outil, droits insuffisants ou expirés, génération de journaux trop rapide…
À titre d’exemple encore, les commandes fournies par pgBackRest ou barman ressemblent à ceci :
Enfin, le paramétrage suivant archive « dans le vide ». Cette astuce est utilisée lors de certains dépannages, ou pour éviter le redémarrage que nécessiterait la désactivation de archive_mode .
2.5.7 Processus archiver : configuration (4/4)
- Dans postgresql.conf (suite) :
- période maximale entre deux archivages
- archive_timeout = ‘… min’
Si l’activité en écriture est très réduite en volume, il peut se passer des heures entre deux archivages de journaux. Il est alors conseillé de forcer un archivage périodique, même si le journal n’a pas été rempli complètement, en indiquant un délai maximum entre deux archivages :
(La valeur par défaut, 0, désactive ce comportement.) Ainsi, la perte de données maximale sera de cette durée. Comme la taille d’un fichier journal, même incomplet, reste fixe (16 Mo par défaut), la consommation en terme d’espace disque sera plus importante (la compression par l’outil d’archivage peut compenser cela), et le temps de restauration plus long.
2.5.8 Processus archiver : lancement
- Redémarrage de PostgreSQL
- si modification de wal_level et/ou archive_mode
- ou rechargement de la configuration
Il ne reste plus qu’à indiquer à PostgreSQL de recharger sa configuration pour que l’archivage soit en place (avec SELECT pg_reload_conf(); ou la commande reload adaptée au système). Dans le cas où il a fallu définir wal_level = replica ou archive_mode = on , il faudra relancer PostgreSQL.
2.5.9 Processus archiver : supervision
- Vue pg_stat_archiver
- pg_wal/archive_status/
- fichiers .ready et .done
- Archivage dans l’ordre des fichiers
- Taille de pg_wal
- si saturation : Arrêt!
- Traces
PostgreSQL archive les journaux impérativement dans l’ordre où ils ont été générés.
S’il y a un problème d’archivage d’un journal, les suivants ne seront pas archivés non plus, et vont s’accumuler dans pg_wal ! De plus, une saturation de la partition portant pg_wal mènera à l’arrêt de l’instance PostgreSQL!
La supervision se fait de quatre manières complémentaires. Taille : Si le répertoire pg_wal commence à grossir fortement, c’est que PostgreSQL n’arrive plus à recycler ses journaux de transactions : c’est un indicateur d’une commande d’archivage n’arrivant pas à faire son travail pour une raison ou une autre. Ce peut être temporaire si l’archivage est juste lent. Les causes classiques sont un réseau saturé, une compression des journaux trop lente, ou des écritures trop intenses. Si l’archivage est complètement bloqué (à cause d’un disque saturé par exemple), ce répertoire grossira indéfiniment. Vue pg_stat_archiver : La vue système pg_stat_archiver indique les derniers journaux archivés et les dernières erreurs. Dans l’exemple suivant, il y a eu un problème pendant quelques secondes, d’où 6 échecs, avant que l’archivage reprenne :
Comme dit plus haut, pour que cette supervision soit fiable, la commande exécutée doit renvoyer un code retour inférieur ou égal à 125. Dans le cas contraire, le processus archiver redémarre et l’erreur n’apparaît pas dans la vue!
L’ordre SELECT pg_switch_wal() force un changement de journal, et donc l’archivage du journal en cours, à condition qu’il y ait eu une activité minimale. Cette commande est pratique pour tester.
Traces : On trouvera la sortie et surtout les messages d’erreurs du script d’archivage dans les traces (qui dépendent bien sûr du script utilisé) : 2020-01-17 18:24:18.427 UTC [15431] LOG: archive command failed with exit code 3 2020-01-17 18:24:18.427 UTC [15431] DETAIL: The failed archive command was:
[Receiver=3.1.2] 2020-01-17 18:24:19.456 UTC [15431] LOG: archive command failed with exit code 3 2020-01-17 18:24:19.456 UTC [15431] DETAIL: The failed archive command was:
[Receiver=3.1.2] 2020-01-17 18:24:20.463 UTC [15431] LOG: archive command failed with exit code 3
C’est donc le premier endroit à regarder en cas de souci ou lors de la mise en place de l’archivage. pg_wal/archive_status : Enfin, on peut monitorer les fichiers présents dans pg_wal/archive_status . Les fichiers .ready , de taille nulle, indiquent en permanence quels sont les journaux prêts à être archivés. Théoriquement, leur nombre doit donc rester faible et retomber rapidement à 0 ou 1. Le service ready_archives de la sonde Nagios check_pgactivity 6 se base sur ce répertoire.
- Source 6 : https://github.com/OPMDG/check_pgactivity
2.6 Archivage avec pg_receivewal
2.6.1 Pg_receivewal : principe
- Alternative à archive_command
- Copie les journaux via le protocole de réplication
- au fil de l’eau
- Slot de réplication obligatoire
- Synchrone possible
- Pour RPO à 0 sans secondaire
pg_receivewal est une alternative à l’ archiver . L’outil se fait passer pour un serveur secondaire utilisant la réplication en flux (streaming replication). Il reçoit en continu les journaux de transactions, et les reconstitue en local. Il fonctionne habituellement sur un autre serveur, où seront archivés les journaux. Pour ne perdre aucune transaction, on peut utiliser une réplication synchrone (paramètres
latence des transactions. Il est fortement conseillé d’ajouter un slot de réplication pour ne perdre aucun journal. Penser au paramétrage associé pour éviter que l’arrêt de pg_receivewal n’entraîne une dangereuse accumulation des journaux sur le primaire. pg_receivewal est assez peu utilisé. De fait, une base assez importante pour avoir besoin d’un RPO à zéro a en général aussi un secondaire synchrone. Il est un composant de l’outil de sauvegarde PITR barman. Les auteurs de pgBackRest préfèrent garder l’ archive_command car ils peuvent ainsi mieux paralléliser des débits élevés, et aussi compresser le flux de journaux à la source. Rien n’interdit de doubler un outil PITR classique avec pg_receivewal, mais la purge des journaux copiés en double reste à la charge du DBA.
2.7 Sauvegarde PITR manuelle
2.7.1 Étapes d’une sauvegarde PITR manuelle
- 3 étapes :
- fonction de démarrage
- copie des fichiers par outil externe
- fonction d’arrêt
- Exclusive : simple… & obsolète! (< v15)
- Concurrente : plus complexe à scripter
- Aucun impact pour les utilisateurs; pas de verrou
- Préférer des outils dédiés qu’un script maison
Une fois l’archivage en place, une sauvegarde à chaud a lieu en trois temps :
- l’appel à la fonction de démarrage;
- la copie elle-même par divers outils externes (PostgreSQL ne s’en occupe pas);
- l’appel à la fonction d’arrêt.
La fonction de démarrage s’appelle à partir de la version 15 mais avait
pour nom auparavant. De la même façon, la fonction d’arrêt s’appelle
La sauvegarde exclusive était une méthode simple, et cela en faisait le choix par défaut. Il suffisait d’appeler les fonctions concernées avant et après la copie des fichiers. Il ne pouvait y en avoir qu’une à la fois. Elle ne fonctionnait que depuis un primaire.
À cause de ces limites et de différents problèmes, la sauvegarde exclusive est déclarée obsolète depuis la 9.6, et n’est plus disponible depuis la version 15. Même sur les versions antérieures, il est conseillé d’utiliser dès maintenant des scripts utilisant les sauvegardes concurrentes.
Tout ce qui suit ne concerne plus que la sauvegarde concurrente.
La sauvegarde concurrente peut être lancée plusieurs fois en parallèle. C’est utile pour créer des secondaires alors qu’une sauvegarde physique tourne, par exemple. Elle est nettement plus complexe à gérer par script. Elle peut être exécutée depuis un serveur secondaire, ce qui allège la charge sur le primaire.
Pendant la sauvegarde, l’utilisateur ne verra aucune différence (à part peut-être la conséquence d’I/O saturées pendant la copie). Aucun verrou n’est posé. Lectures, écritures, suppression et création de tables, archivage de journaux et autres opérations continuent comme si de rien n’était.
La description du mécanisme qui suit est essentiellement destinée à la compréhension et l’expérimentation. En production, un script maison reste une possibilité, mais préférez des outils dédiés et fiables : pg_basebackup, pgBackRest…
Les sauvegardes manuelles servent cependant encore quand on veut utiliser une sauvegarde par snapshot de partition ou de baie, ou avec rsync (car pg_basebackup ne sait pas synchroniser vers une sauvegarde interrompue ou ancienne), et quand les outils conseillés ne sont pas utilisables ou disponibles sur le système.
2.7.2 Sauvegarde manuelle - 1/3 : pg_backup_start
- un_label : texte
- fast : forcer un checkpoint ? )
L’exécution de pg_backup_start() peut se faire depuis n’importe quelle base de données de l’instance. (Rappelons que pour les versions avant la 15, la fonction s’appelle pg_start_backup() . Pour effectuer une sauvegarde non-exclusive avec ces versions, il faudra positionner un troisième paramètre 7 à false .) Le label (le texte en premier argument) n’a aucune importance pour PostgreSQL (il ne sert qu’à l’administrateur, pour reconnaître le backup). Le deuxième argument est un booléen qui permet de demander un checkpoint immédiat, si l’on est pressé et si un pic d’I/O n’est pas gênant. Sinon il faudra attendre souvent plusieurs minutes (selon la configuration du déclenchement du prochain checkpoint, dépendant des paramètres et checkpoint_timeout et de la rapidité d’écriture imposée par max_wal_size checkpoint_completion_target ).
La session qui exécute la commande pg_backup_start() doit être la même que celle qui exécutera plus tard pg_backup_stop() . Nous verrons que cette dernière fonction fournira de quoi créer deux fichiers, qui devront être nommés backup_label et tablespace_map . Si la connexion est interrompue avant pg_backup_stop() , alors la sauvegarde doit être considérée comme invalide. En plus de rester connectés à la base, les scripts qui gèrent la sauvegarde concurrente doivent donc récupérer et conserver les informations renvoyées par la commande de fin de sauvegarde. La sauvegarde PITR est donc devenue plus complexe au fil des versions, et il est donc recommandé d’utiliser plutôt pg_basebackup ou des outils la supportant (barman, pgBackRest…).
- Source 7 : https://docs.postgresql.fr/14/continuous-archiving.html#BACKUP-LOWLEVEL-BASE-BACKUP-EXCLUSIVE
2.7.3 Sauvegarde manuelle - 2/3 : copie des fichiers
- Cas courant : snapshot
- cohérence? redondance?
- Sauvegarde des fichiers à chaud
- répertoire principal des données
- tablespaces
- Copie forcément incohérente (la restauration des journaux corrigera)
- rsync et autres outils
- Ignorer :
- postmaster.pid , log , pg_wal , pg_replslot et quelques autres
- Ne pas oublier : configuration!
La deuxième étape correspond à la sauvegarde des fichiers. Le choix de l’outil dépend de l’administrateur. Cela n’a aucune incidence au niveau de PostgreSQL. La sauvegarde doit comprendre aussi les tablespaces si l’instance en dispose. Snapshot : Il est possible d’effectuer cette étape de copie des fichiers par snapshot au niveau de la baie, de l’hyperviseur, ou encore de l’OS (LVM, ZFS…).
Un snapshot cohérent, y compris entre les tablespaces, permet théoriquement de réaliser une sauvegarde en se passant des étapes et
redémarrage brutal. Pour une sauvegarde PITR, il faudra cependant toujours encadrer le snapshot des appels aux fonctions de démarrage et d’arrêt ci-dessus, et c’est généralement ce que font les outils comme Veeam ou Tina. L’utilisation d’un tel outil implique de vérifier qu’il sait gérer les sauvegardes non exclusives pour utiliser PostgreSQL 15 et supérieurs.
Le point noir de la sauvegarde par snapshot est d’être liée au même système matériel que l’instance PostgreSQL (disque, hyperviseur, datacenter…) Une défaillance grave du matériel, ou un bug de la baie, peut donc emporter, corrompre ou bloquer la sauvegarde en même temps que les données originales. La sécurité de l’instance est donc reportée sur celle de l’infrastructure sous-jacente : il vaut mieux que celle-ci soit répliquée sur plusieurs sites. Une copie parallèle, hors infrastructure, des données de manière plus classique reste conseillée pour éviter un désastre total, et pour parer à la malveillance.
Copie manuelle :
La sauvegarde se fait à chaud : il est donc possible que pendant ce temps des fichiers changent, disparaissent avant d’être copiés ou apparaissent sans être copiés. Cela n’a pas d’importance en soi car les journaux de transactions corrigeront cela (leur archivage doit donc commencer avant le début de la sauvegarde et se poursuivre sans interruption jusqu’à la fin). Il faut s’assurer que l’outil de sauvegarde supporte cela, c’est-à-dire qu’il soit capable de différencier les codes d’erreurs dus à « des fichiers ont bougé ou disparu lors de la sauvegarde » des autres erreurs techniques. tar par exemple convient : il retourne 1 pour le premier cas d’erreur, et 2 quand l’erreur est critique. rsync est très courant également.
Sur les plateformes Microsoft Windows, peu d’outils sont capables de copier des fichiers en cours de modification. Assurez-vous d’en utiliser un possédant cette fonctionnalité (il existe différents émulateurs des outils GNU sous Windows). Le plus sûr et simple est sans doute de renoncer à une copie manuelle des fichiers et d’utiliser pg_basebackup . Exclusions : Des fichiers et répertoires sont à ignorer, pour gagner du temps ou faciliter la restauration. Voici la liste exhaustive (disponible aussi dans la documentation officielle 8 ) :
- postmaster.pid , postmaster.opts , pg_internal.init ;
- les fichiers de données des tables non journalisées (unlogged) ;
- pg_wal , ainsi que les sous-répertoires (mais à archiver séparément!) ;
- pg_replslot : les slots de réplication seront au mieux périmés, au pire gênants sur l’instance restaurée;
- pg_dynshmem , pg_notify , pg_serial , pg_snapshots , pg_stat_tmp et pg_subtrans ne doivent pas être copiés (ils contiennent des informations propres à l’instance, ou qui ne survivent pas à un redémarrage);
- les fichiers et répertoires commençant par pgsql_tmp (fichiers temporaires);
- les fichiers autres que les fichiers et les répertoires standards (donc pas les liens symboliques). On n’oubliera pas les fichiers de configuration s’ils ne sont pas dans le PGDATA.
2.7.4 Sauvegarde manuelle - 3/3 : pg_backup_stop
Ne pas oublier !!
- true : attente de l’archivage )
La dernière étape correspond à l’exécution de la procédure stockée SELECT * FROM pg_backup_stop() .
N’oubliez pas d’exécuter pg_backup_stop() , de vérifier qu’il finit avec succès et de récupérer les informations qu’il renvoie! Cet oubli trop courant rend vos sauvegardes inutilisables !
PostgreSQL va alors :
- marquer cette fin de backup dans le journal des transactions (étape capitale pour la restauration);
- forcer la finalisation du journal de transactions courant et donc son archivage, afin que la sauvegarde (fichiers + archives) soit utilisable même en cas de crash juste l’appel à la fonction :
été archivé avec succès. La fonction renvoie :
- le lsn de fin de backup;
- un champ destiné au fichier backup_label ;
- un champ destiné au fichier tablespace_map .
Ces informations se retrouvent aussi dans un fichier .backup mêlé aux journaux :
START WAL LOCATION: 22/2B000028 (file 00000001000000220000002B) STOP WAL LOCATION: 22/2FE5C788 (file 00000001000000220000002F)
BACKUP METHOD: streamed BACKUP FROM: master START TIME: 2019-12-16 13:53:41 CET LABEL: rr START TIMELINE: 1 STOP TIME: 2019-12-16 13:54:04 CET STOP TIMELINE: 1
Il faudra créer le fichier tablespace_map avec le contenu du champ spcmapfile :
134141 /tbl/froid 134152 /tbl/quota
… ce qui n’est pas trivial à scripter. Ces deux fichiers devront être placés dans la sauvegarde, pour être présent d’entrée dans le PGDATA du serveur restauré. À partir du moment où pg_backup_stop() rend la main, il est possible de restaurer la sauvegarde obtenue puis de rejouer les journaux de transactions suivants en cas de besoin, sur un autre serveur ou sur ce même serveur. Tous les journaux archivés avant celui précisé par le champ START WAL LOCATION dans le fichier backup_label ne sont plus nécessaires pour la récupération de la sauvegarde du système de fichiers et peuvent donc être supprimés. Attention, il y a plusieurs compteurs hexadécimaux différents dans le nom du fichier journal, qui ne sont pas incrémentés de gauche à droite.
2.7.5 Sauvegarde de base à chaud : pg_basebackup
Outil de sauvegarde pouvant aussi servir au sauvegarde basique
- Backup de base ici sans les journaux :
-D /var/lib/postgresql/backups/
pg_basebackup a été décrit plus haut. Il a l’avantage d’être simple à utiliser, de savoir quels fichiers ne pas copier, de fiabiliser la sauvegarde par un slot de réplication. Il ne réclame en général pas de configuration supplémentaire. Si l’archivage est déjà en place, copier les journaux est inutile ( –wal-method=none ). Nous verrons plus tard comment lui indiquer où les chercher. L’inconvénient principal de pg_basebackup reste son incapacité à reprendre une sauvegarde interrompue ou à opérer une sauvegarde différentielle ou incrémentale, du moins avant PostgreSQL 17.
2.7.6 Fréquence de la sauvegarde de base
- Dépend des besoins
- De tous les jours à tous les mois
- Plus elles sont espacées, plus la restauration est longue
- et plus le risque d’un journal corrompu ou absent est important
La fréquence dépend des besoins. Une sauvegarde par jour est le plus commun, mais il est possible d’espacer encore plus la fréquence. Cependant, il faut conserver à l’esprit que plus la sauvegarde est ancienne, plus la restauration sera longue, car un plus grand nombre de journaux seront à rejouer.
2.7.7 Suivi de la sauvegarde de base
- Vue pg_stat_progress_basebackup
round(100.0*backup_streamed/backup_total::numeric,2) AS “%” FROM pg_stat_progress_basebackup \gx
backup_streamed tablespaces_total
La vue pg_stat_progress_basebackup permet de suivre la progression de la sauvegarde de base, quelque soit l’outil utilisé, à condition qu’il passe par le protocole de réplication. Cela permet ainsi de savoir à quelle phase la sauvegarde se trouve, quelle volumétrie a été envoyée, celle à envoyer, etc.
2.8 Restaurer une sauvegarde PITR
Simple, mais à appliquer rigoureusement
2.8.1 Exemple de scénario : sauvegarde
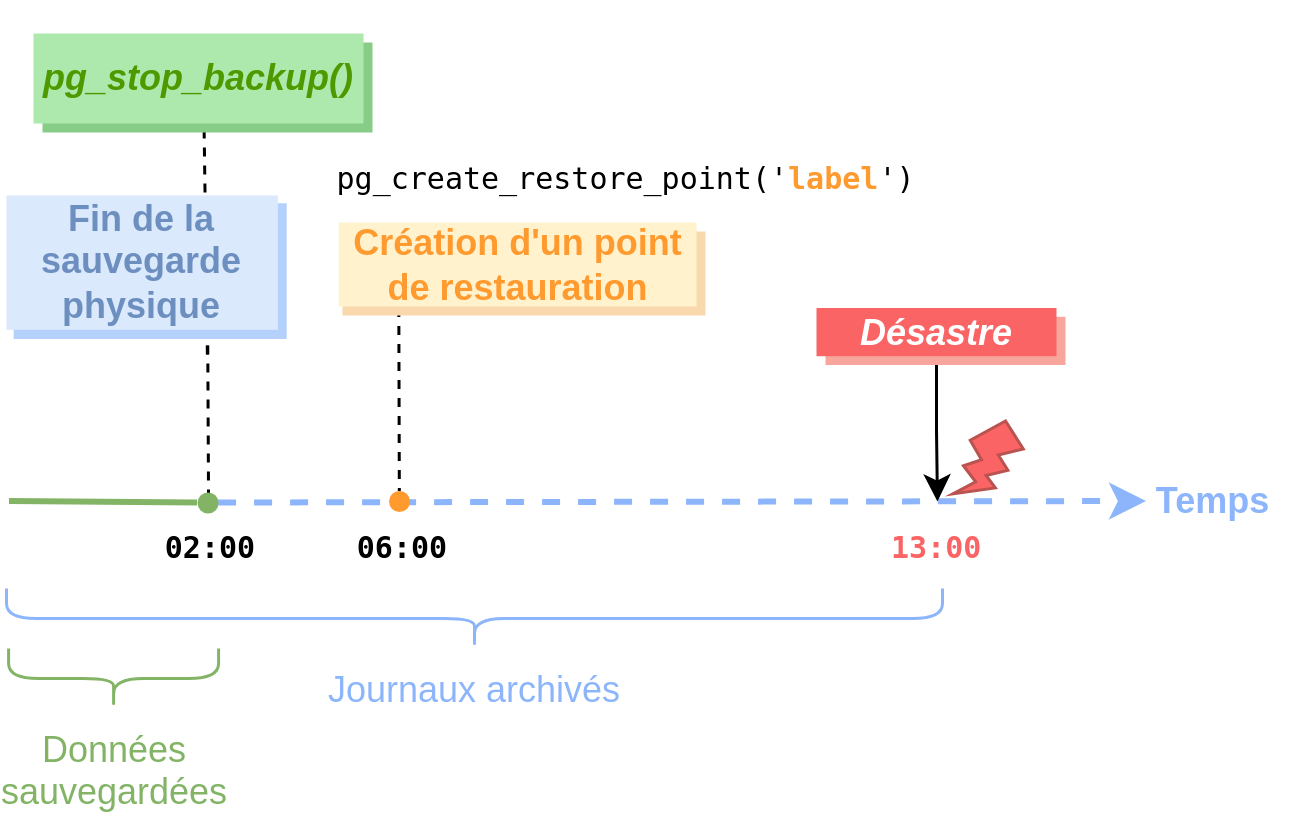
Dans cet exemple, la sauvegarde a fini à 02 h du matin (le moment où une fonction pg_backup_stop() est appelée par un outil ou un script). La sauvegarde des fichiers de données s’est effectuée en parallèle de l’archivage des journaux, qui continue indéfiniment ensuite. À 06 h, le DBA a créé un « point de restauration », ainsi (le nom est arbitraire) :
26/9B000090
Ces points de restauration sont totalement optionnels, et peuvent être créés avant certaines opérations (par exemple un batch ou une mise en production), ou périodiquement. Une catastrophe quelconque frappe à 13 h et il faut restaurer.
2.8.2 Exemple de scénario : restauration
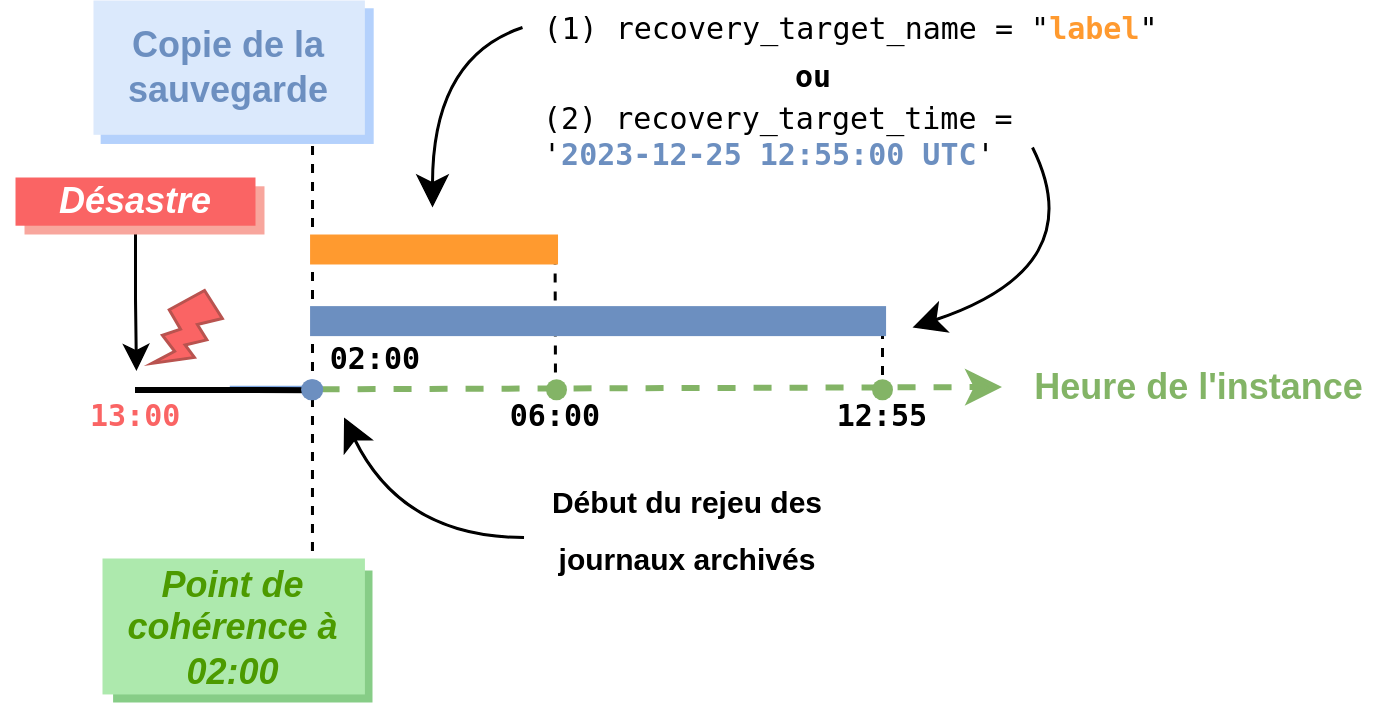
La ligne de temps de ce schéma correspond aux heures des transactions originales. Pour restaurer, le DBA copie la sauvegarde de base, modifie la configuration et démarre l’instance qui commence à rejouer les journaux. Elle atteint le point de cohérence (correspondant à la fin de la sauvegarde), et est donc dans l’état correspondant à la fin de la sauvegarde, donc comme à 02 h. Deux possibilités sont montrées ici :
- le DBA demande à redérouler les journaux jusqu’au point de restauration label , pour avoir une image de la base à 06 h ; 2. le DBA demande à redérouler les journaux jusque 12 h 55, juste avant la catastrophe.
Nous verrons qu’il lui suffira de choisir les bons paramètres (ici ou
2.8.3 Restaurer une sauvegarde PITR (1/5)
- S’il s’agit du même serveur
- arrêter PostgreSQL
- Nettoyer les répertoires des données
- y compris les tablespaces
- sauf outil travaillant en mode delta
La restauration se déroule en trois, voire quatre étapes suivant qu’elle est effectuée sur le même serveur ou sur un autre serveur. Dans le cas où la restauration a lieu sur le même serveur, les étapes préliminaires suivantes sont à effectuer. Il faut arrêter PostgreSQL s’il n’est pas arrêté. Cela arrive quand la restauration a pour but, par exemple, de récupérer des données qui ont été supprimées par erreur. Ensuite, il faut supprimer (ou archiver) l’ancien répertoire des données pour pouvoir y placer la sauvegarde des fichiers. Écraser l’ancien répertoire n’est pas suffisant, il faut le supprimer, ainsi que les répertoires des tablespaces au cas où l’instance en possède. (L’exception est l’utilisation d’outils capable de trouver les différences entre les fichiers à restaurer et ceux présents, pour gagner du temps, comme rsync ou pgbackrest restore –delta .) Cela est valable aussi pour chaque tablespace. Une exception : on peut vouloir mettre de côté le dernier WAL (incomplet) d’une instance que l’on restaure pour ne perdre aucune transaction (voir plus bas).
2.8.4 Restaurer une sauvegarde PITR (2/5)
- Restaurer les fichiers de la sauvegarde
- où ? (pas à la racine)
- Peut-être besoin de nettoyer les fichiers restaurés
- ex : pg_wal , postmaster.pid , log/
- un bon outil ne les a pas copiés
- Si restauration après crash :
- récupérer le dernier journal de transactions connu (si disponible)
La sauvegarde des fichiers peut enfin être restaurée. Il faut bien porter attention à ce que les fichiers soient restaurés au même emplacement, tablespaces compris.
Attention, pour des raisons de sécurité et de fiabilité, les répertoires choisis pour la restauration des données de votre instance ne doivent pas être à la racine d’un point de montage. Si un ou plusieurs points de montage sont dédiés à l’utilisation de PostgreSQL, positionnez toujours les données dans un sous-répertoire, voire deux niveaux en dessous du point de montage (eg. <point de montage>/<version majeure>/<nom instance> ).
Une fois cette étape effectuée, il peut être intéressant de faire un peu de ménage. Des outils comme pgBackRest ou Barman, ou un bon script, rendent cette étape inutile, car ils n’auront pas copié les fichiers inutiles. Par exemple, le fichier postmaster.pid peut poser un problème au démarrage. On peut supprimer les traces, si elles sont dans $PGDATA/log/ , pour éviter toute confusion entre l’ancienne et la nouvelle incarnation de l’instance, surtout si on restaure sur une nouvelle machine.
Si des journaux de transactions sont compris dans la sauvegarde ( $PGDATA/pg_wal/ ), il est préférable de les supprimer. De toute façon, PostgreSQL les ignorera s’ils sont dans les archives. La commande sera similaire à celle-ci :
Enfin, si on restaure après un crash, on peut chercher à récupérer le dernier journal en cours lors de l’arrêt, incomplet et qui n’a pu être archivé. S’il n’a pas disparu avec le disque par exemple, le récupérer peut permettre de sauver les transactions qui y figurent. Ce dernier journal sera pris en compte après le rejeu des journaux archivés, après l’échec de la restore_command sur ce journal.
2.8.5 Restaurer une sauvegarde PITR (3/5)
- Indiquer qu’on est en restauration
- fichier vide recovery.signal
- Commande de restauration
- restore_command = ‘… une commande …’
- directement dans pg_wal/
- dans postgresql.[auto.]conf
Quand PostgreSQL démarre après avoir subi un arrêt brutal, il ne restaure que les journaux en place dans pg_wal/ , puis il s’ouvre en écriture. Pour une restauration, il faut lui indiquer qu’il doit plutôt demander les journaux quelque part, et les rejouer tous jusqu’à épuisement, avant de s’ouvrir. Pour cela, il suffit de créer un fichier vide recovery.signal dans le répertoire des données.
Pour la récupération des journaux, le paramètre essentiel est restore_command . Il contient une commande symétrique des paramètres archive_command (ou archive_library ) pour l’archivage. Il s’agit d’une commande copiant un journal dans le répertoire des journaux pg_wal/ . Cette commande est souvent fournie par l’outil de sauvegarde PITR s’il y en a un. Si nous poursuivons notre exemple, ce paramètre pourrait être :
Cette commande est appelée après la restauration de chaque journal pour récupérer le suivant, qui est restauré, et ainsi de suite. Techniquement, la commande est lancée depuis le PGDATA, en remplaçant %f par le nom du journal attendu (par exemple 0000000100000098000000E0 ) et %p par pg_wal/RECOVERYXLOG . Ce dernier fichier sera ensuite renommé avec le nom du journal. Les traces montrent aussi que PostgreSQL cherche les fichiers d’historique des timelines, qui portent des noms comme 00000002.history , mélangés aux journaux dans le dépôt. S’il trouve un de ces fichiers, PostgreSQL le sauve temporairement sous le nom pg_wal/RECOVERYHISTORY . Il en a besoin
pour savoir quelle chaîne de journaux suivre quand il y a eu des restaurations ou bascules sur un secondaire (voir plus loin). Il n’y a aucune parallélisation prévue, mais des outils de sauvegarde PITR peuvent en faire en arrièreplan pendant l’exécution de la commande (par exemple pgBackRest en mode asynchrone ). Si le but est de restaurer tous les journaux archivés, il n’est pas nécessaire d’aller plus loin dans la configuration. La restauration se poursuivra jusqu’à ce que restore_command tombe en erreur, ce qui signifie l’épuisement de tous les journaux disponibles, et la fin de la restauration.
Au cas où vous rencontreriez une instance en version 11 ou antérieure : il faut savoir que la restauration se paramétrait dans un fichier texte nommé recovery.conf , dans le PGDATA, contenant recovery_command et éventuellement les options de restauration.
2.8.6 Restaurer une sauvegarde PITR (4/5)
- Jusqu’où restaurer :
- recovery_target_name , recovery_target_time
- recovery_target_xid , recovery_target_lsn
- recovery_target_inclusive
- Le backup de base doit être antérieur!
- Suivi de timeline :
- recovery_target_timeline : latest (en général)
- Et on fait quoi ?
- recovery_target_action : pause
- pg_wal_replay_resume pour ouvrir immédiatement
- ou modifier & redémarrer
Si l’on ne veut pas simplement restaurer tous les journaux, par exemple pour s’arrêter avant une fausse manipulation désastreuse, plusieurs paramètres permettent de préciser le point d’arrêt :
- jusqu’à un certain nom, grâce au paramètre recovery_target_name (le nom correspond à un label enregistré précédemment dans les journaux de transactions grâce à la fonction
jusqu’à une certaine heure, grâce au paramètre recovery_target_time ;
jusqu’à un certain identifiant de transaction, grâce au paramètre recovery_target_xid , numéro de transaction qu’il est possible de chercher dans les journaux eux-mêmes grâce à l’utilitaire pg_waldump (voir cet article 9 );
Source 9 : https://blog.hagander.net/locating-the-recovery-point-just-before-a-dropped-table-230/
- jusqu’à un certain LSN (Log Sequence Number 10 ), grâce au paramètre recovery_target_lsn , que là aussi on doit aller chercher dans les journaux eux-mêmes. Évidemment, il ne faudra choisir qu’un paramètre parmi ceux-là. Avec le paramètre recovery_target_inclusive (par défaut à true ), il est possible de préciser si la restauration se fait en incluant les transactions au nom, à l’heure ou à l’identifiant de transaction demandé, ou en les excluant. Dans les cas complexes, nous verrons plus tard que choisir la timeline peut être utile (avec
Exemples de paramétrage :
Ces restaurations à un moment précis ne sont possibles que si elles correspondent à un état cohérent d’après la fin du base backup, soit après le moment du pg_stop_backup . Si l’on a un historique de plusieurs sauvegardes, il faudra en choisir une antérieure au point de restauration voulu. Ce n’est pas forcément la dernière. Les outils ne sont pas forcément capables de deviner la bonne sauvegarde à restaurer.
Il est possible de demander à la restauration de s’arrêter une fois arrivée au stade voulu avec :
C’est même l’action par défaut si une des options d’arrêt ci-dessus a été choisie : cela permet à l’utilisateur de vérifier que le serveur est bien arrivé au point qu’il désirait. Les alternatives sont promote (ouverture en écriture après le rejeu) et shutdown . Si la cible est atteinte mais que l’on décide de continuer la restauration jusqu’à un autre point (évidemment postérieur), il faut modifier la cible de restauration dans le fichier de configuration, et redémarrer PostgreSQL. C’est le seul moyen de rejouer d’autres journaux sans ouvrir l’instance en écriture. Si l’on est arrivé au point de restauration voulu, un message de ce genre apparaît : LOG:recovery stopping before commit of transaction 8693270, time 2021-09-02 11:46:35.394345+02 LOG:pausing at the end of recovery HINT:Execute pg_wal_replay_resume() to promote.
(Le terme promote pour une restauration est un peu abusif.) pg_wal_replay_resume() - malgré ce que pourrait laisser croire son nom ! - provoque ici l’arrêt immédiat de la restauration, donc ignore
les opérations contenues dans les WALs que l’on n’a pas souhaités restaurer, puis le serveur s’ouvre en écriture sur une nouvelle timeline.
Attention : jusque PostgreSQL 12 inclus, si un recovery_target était spécifié mais n’était toujours pas atteint à la fin du rejeu des archives, alors le mode recovery se terminait et le serveur était promu sans erreur, et ce, même si recovery_target_action avait la valeur pause ! (À condition, bien sûr, que le point de cohérence ait tout de même été dépassé.) Il faut donc être vigilant quant aux messages dans le fichier de trace de PostgreSQL! Depuis PostgreSQL 13, l’instance détecte le problème et s’arrête avec un message FATAL : la restauration ne s’est pas déroulée comme attendu. S’il manque juste certains journaux de transactions, cela permet de relancer PostgreSQL après correction de l’oubli.
La documentation officielle complète sur le sujet est sur le site du projet 11 .
2.8.7 Restaurer une sauvegarde PITR (5/5)
- Démarrer PostgreSQL
- Rejeu des journaux
- Vérifier que le point de cohérence est atteint!
- Ne jamais effacer recovery.signal volontairement
La dernière étape est particulièrement simple. Il suffit de démarrer PostgreSQL. PostgreSQL va comprendre qu’il doit rejouer les journaux de transactions. Les éventuels journaux présents sont rejoués, puis est appelé pour fournir
d’autres journaux, jusqu’à ce que la commande ne trouve plus rien dans les archives. Les journaux doivent se dérouler au moins jusqu’à rencontrer le « point de cohérence », c’est-à-dire la mention insérée par pg_backup_stop() . Avant ce point, il n’est pas possible de savoir si les fichiers issus du base backup sont à jour ou pas, et il est impossible de démarrer l’instance. Le message apparaît dans les traces et, dans le doute, on doit vérifier sa présence : 2020-01-17 16:08:37.285 UTC [15221] LOG: restored log file “000000010000000100000031”… 2020-01-17 16:08:37.789 UTC [15221] LOG: restored log file “000000010000000100000032”… 2020-01-17 16:08:37.949 UTC [15221] LOG: consistent recovery state reached at 1/32BFDD88 2020-01-17 16:08:37.949 UTC [15217] LOG: database system is ready to accept read only connections
- Source 11 : https://www.postgresql.org/docs/current/runtime-config-wal.html#RUNTIME-CONFIG-WAL-RECOVERY-TARGET
2020-01-17 16:08:38.009 UTC [15221] LOG: restored log file “000000010000000100000033”…
Au moment où ce message apparaît, le rejeu n’est pas terminé, mais il a atteint un stade où l’instance est cohérente et utilisable. PostgreSQL continue ensuite jusqu’à arriver à la limite fixée, jusqu’à ce qu’il ne trouve plus de journal à rejouer ( restore_command tombe en erreur), ou que le bloc de journal lu soit incohérent (ce qui indique qu’on est arrivé à la fin d’un journal qui n’a pas été terminé, le journal courant au moment du crash par exemple). PostgreSQL vérifie qu’il n’existe pas une timeline supérieure sur laquelle basculer (par exemple s’il s’agit de la deuxième restauration depuis la sauvegarde du PGDATA). Puis il va s’ouvrir en écriture (sauf si vous avez demandé recovery_target_action = pause ). 2020-01-17 16:08:45.938 UTC [15221] LOG: restored log file “00000001000000010000003C” from archive 2020-01-17 16:08:46.116 UTC [15221] LOG: restored log file “00000001000000010000003D”… 2020-01-17 16:08:46.547 UTC [15221] LOG: restored log file “00000001000000010000003E”… 2020-01-17 16:08:47.262 UTC [15221] LOG: restored log file “00000001000000010000003F”… 2020-01-17 16:08:47.842 UTC [15221] LOG: invalid record length at 1/3F0000A0: wanted 24, got 0 2020-01-17 16:08:47.842 UTC [15221] LOG: redo done at 1/3F000028 2020-01-17 16:08:47.842 UTC [15221] LOG: last completed transaction was at log time 2020-01-17 14:59:30.093491+00 2020-01-17 16:08:47.860 UTC [15221] LOG: restored log file “00000001000000010000003F”…
2020-01-17 16:08:47.966 UTC [15221] LOG: selected new timeline ID: 2 2020-01-17 16:08:48.179 UTC [15221] LOG: archive recovery complete
2020-01-17 16:08:51.613 UTC [15217] LOG: database system is ready to accept connections
Le fichier recovery.signal est effacé pour ne pas poser problème en cas de crash immédiat. (Ne l’effacez jamais manuellement !) Le fichier backup_label d’une sauvegarde exclusive est renommé en backup_label.old .
2.8.8 Restauration PITR : durée
- Durée dépendante du nombre de journaux
- rejeu séquentiel des WAL
- Accéléré en version 15 (prefetch)
La durée de la restauration est fortement dépendante du nombre de journaux. Ils sont rejoués séquentiellement. Mais avant cela, un fichier journal peut devoir être récupéré, décompressé, et restauré dans pg_wal .
Il est donc préférable qu’il n’y ait pas trop de journaux à rejouer, et donc qu’il n’y ait pas trop d’espaces entre sauvegardes complètes successives. La version 15 a optimisé le rejeu en permettant l’activation du prefetch des blocs de données lors du rejeu des journaux. Un outil comme pgBackRest en mode asynchrone permet de paralléliser la récupération des journaux, ce qui permet de les récupérer via le réseau et de les décompresser par avance pendant que PostgreSQL traite les journaux précédents.
2.8.9 Restauration PITR : différentes timelines
- Fin de recovery => changement de timeline :
- l’historique des données prend une autre voie
- le nom des WAL change (ex : 00000002000000000000000C )
- fichiers .history
- Permet plusieurs restaurations PITR à partir du même basebackup
- Choix : recovery_target_timeline
- défaut : latest
Lorsque le mode recovery s’arrête, au point dans le temps demandé ou faute d’archives disponibles, l’instance accepte les écritures. De nouvelles transactions se produisent alors sur les différentes bases de données de l’instance. Dans ce cas, l’historique des données prend un chemin différent par rapport aux archives de journaux de transactions produites avant la restauration. Par exemple, dans ce nouvel historique, il n’y a pas le DROP TABLE malencontreux qui a imposé de restaurer les données. Cependant, cette transaction existe bien dans les archives des journaux de transactions. On a alors plusieurs historiques des transactions, avec des « bifurcations » aux moments où on a réalisé des restaurations. PostgreSQL permet de garder ces historiques grâce à la notion de timeline. Une timeline est donc l’un de ces historiques. Elle est identifiée par un numéro et se matérialise par un ensemble de journaux de transactions. Le numéro de la timeline est le premier nombre hexadécimal du nom des segments de journaux de transactions, en 8ᵉ position (le second est le numéro du journal, et le troisième, à la fin, le numéro du segment). Ainsi, lorsqu’une instance s’ouvre après une restauration PITR, elle peut archiver immédiatement ses journaux de transactions au même endroit, les fichiers ne seront pas écrasés vu qu’ils seront nommés différemment. Par exemple, après une restauration PITR s’arrêtant à un point situé dans le segment 000000010000000000000009 :
000000010000000000000007 000000010000000000000008 000000010000000000000009 00000001000000000000000A 00000001000000000000000B 00000001000000000000000C 00000001000000000000000D 00000001000000000000000E
00000001000000000000000F 000000010000000000000010 000000010000000000000011 000000020000000000000009 00000002000000000000000A 00000002000000000000000B 00000002000000000000000C 00000002.history
Noter les timelines 1 et 2 en 8ᵉ position des noms des fichiers. Il y a deux fichiers finissant par 09 : le premier contient des informations communes aux deux 000000010000000000000009 timelines mais sa fin ne figure pas dans la timeline 2. Les fichiers 00000001000000000000000A à 000000010000000000000011 contiennent des informations qui ne figurent que dans la timeline 1. Les fichiers 00000002000000000000000A jusque sont uniquement 00000002000000000000000C dans la timeline 2. Le fichier 00000002.history contient l’information sur la transition entre les deux timelines. Ce fichier sert pendant le recovery, quand l’instance doit choisir les timelines à suivre et les fichiers à restaurer. Les timelines connues avec leur point de départ sont suivies grâce aux fichiers d’historique, nommés d’après le numéro hexadécimal sur huit caractères de la timeline et le suffixe .history , et archivés avec les journaux. En partant de la timeline qu’elle quitte, l’instance restaure les fichiers historiques des timelines suivantes pour choisir la première disponible. Une fois la restauration finie, avant de s’ouvrir en écriture, l’instance archive un nouveau fichier .history pour la nouvelle timeline sélectionnée. Il contient l’adresse du point de départ dans la timeline qu’elle quitte, c’est-à-dire le point de bifurcation entre la 1 et la 2 :
Puis l’instance continue normalement, et archive ses journaux commençant par 00000002 . Après une seconde restauration, repartant de la timeline 2, l’instance choisit la timeline 3 et écrit un nouveau fichier :
Ce fichier reprend les timelines précédemment suivies par l’instance. En effet, l’enchaînement peut être complexe s’il y a eu plusieurs retours en arrière ou restauration. À la restauration, on peut choisir la timeline cible en configurant le paramètre recovery_target_timeline . Il vaut par défaut latest , et la restauration suit donc les changements de timeline depuis le moment de la sauvegarde. Pour choisir une autre timeline que la dernière, il faut donner le numéro de la timeline cible comme valeur du paramètre recovery_target_timeline . Les timelines permettent ainsi d’effectuer plusieurs restaurations successives à partir du même base backup, avec des retours en arrière, et d’archiver vers le même dépôt sans mélanger les journaux. Bien sûr, pour restaurer dans une timeline précise, il faut que le fichier .history correspondant soit encore présent dans les archives, sous peine d’erreur.
Un changement de timeline ne se produit que lors d’une restauration explicite, et pas en cas de recovery après crash, notamment. (Cela arrive aussi quand un serveur secondaire est promu : il crée une nouvelle timeline.) Il y a quelques pièges :
- Le numéro de timeline dans les traces, ou affiché par pg_controldata , est en décimal. Mais les fichiers .history portent un numéro en hexadécimal (par exemple 00000014.history pour la timeline 20). On peut fournir les deux à recovery_target_timeline ( 20 ou ‘0x14’ ). Attention, il n’y a pas de contrôle!
- Attention sur les anciennes versions : jusque PostgreSQL 11 compris, la valeur par défaut de recovery_target_timeline était current : la restauration se faisait donc dans la même timeline que le base backup. Si entre-temps il y avait eu une bascule ou une précédente restauration, la nouvelle timeline n’était pas automatiquement suivie !
2.8.10 Restauration PITR : illustration des timelines
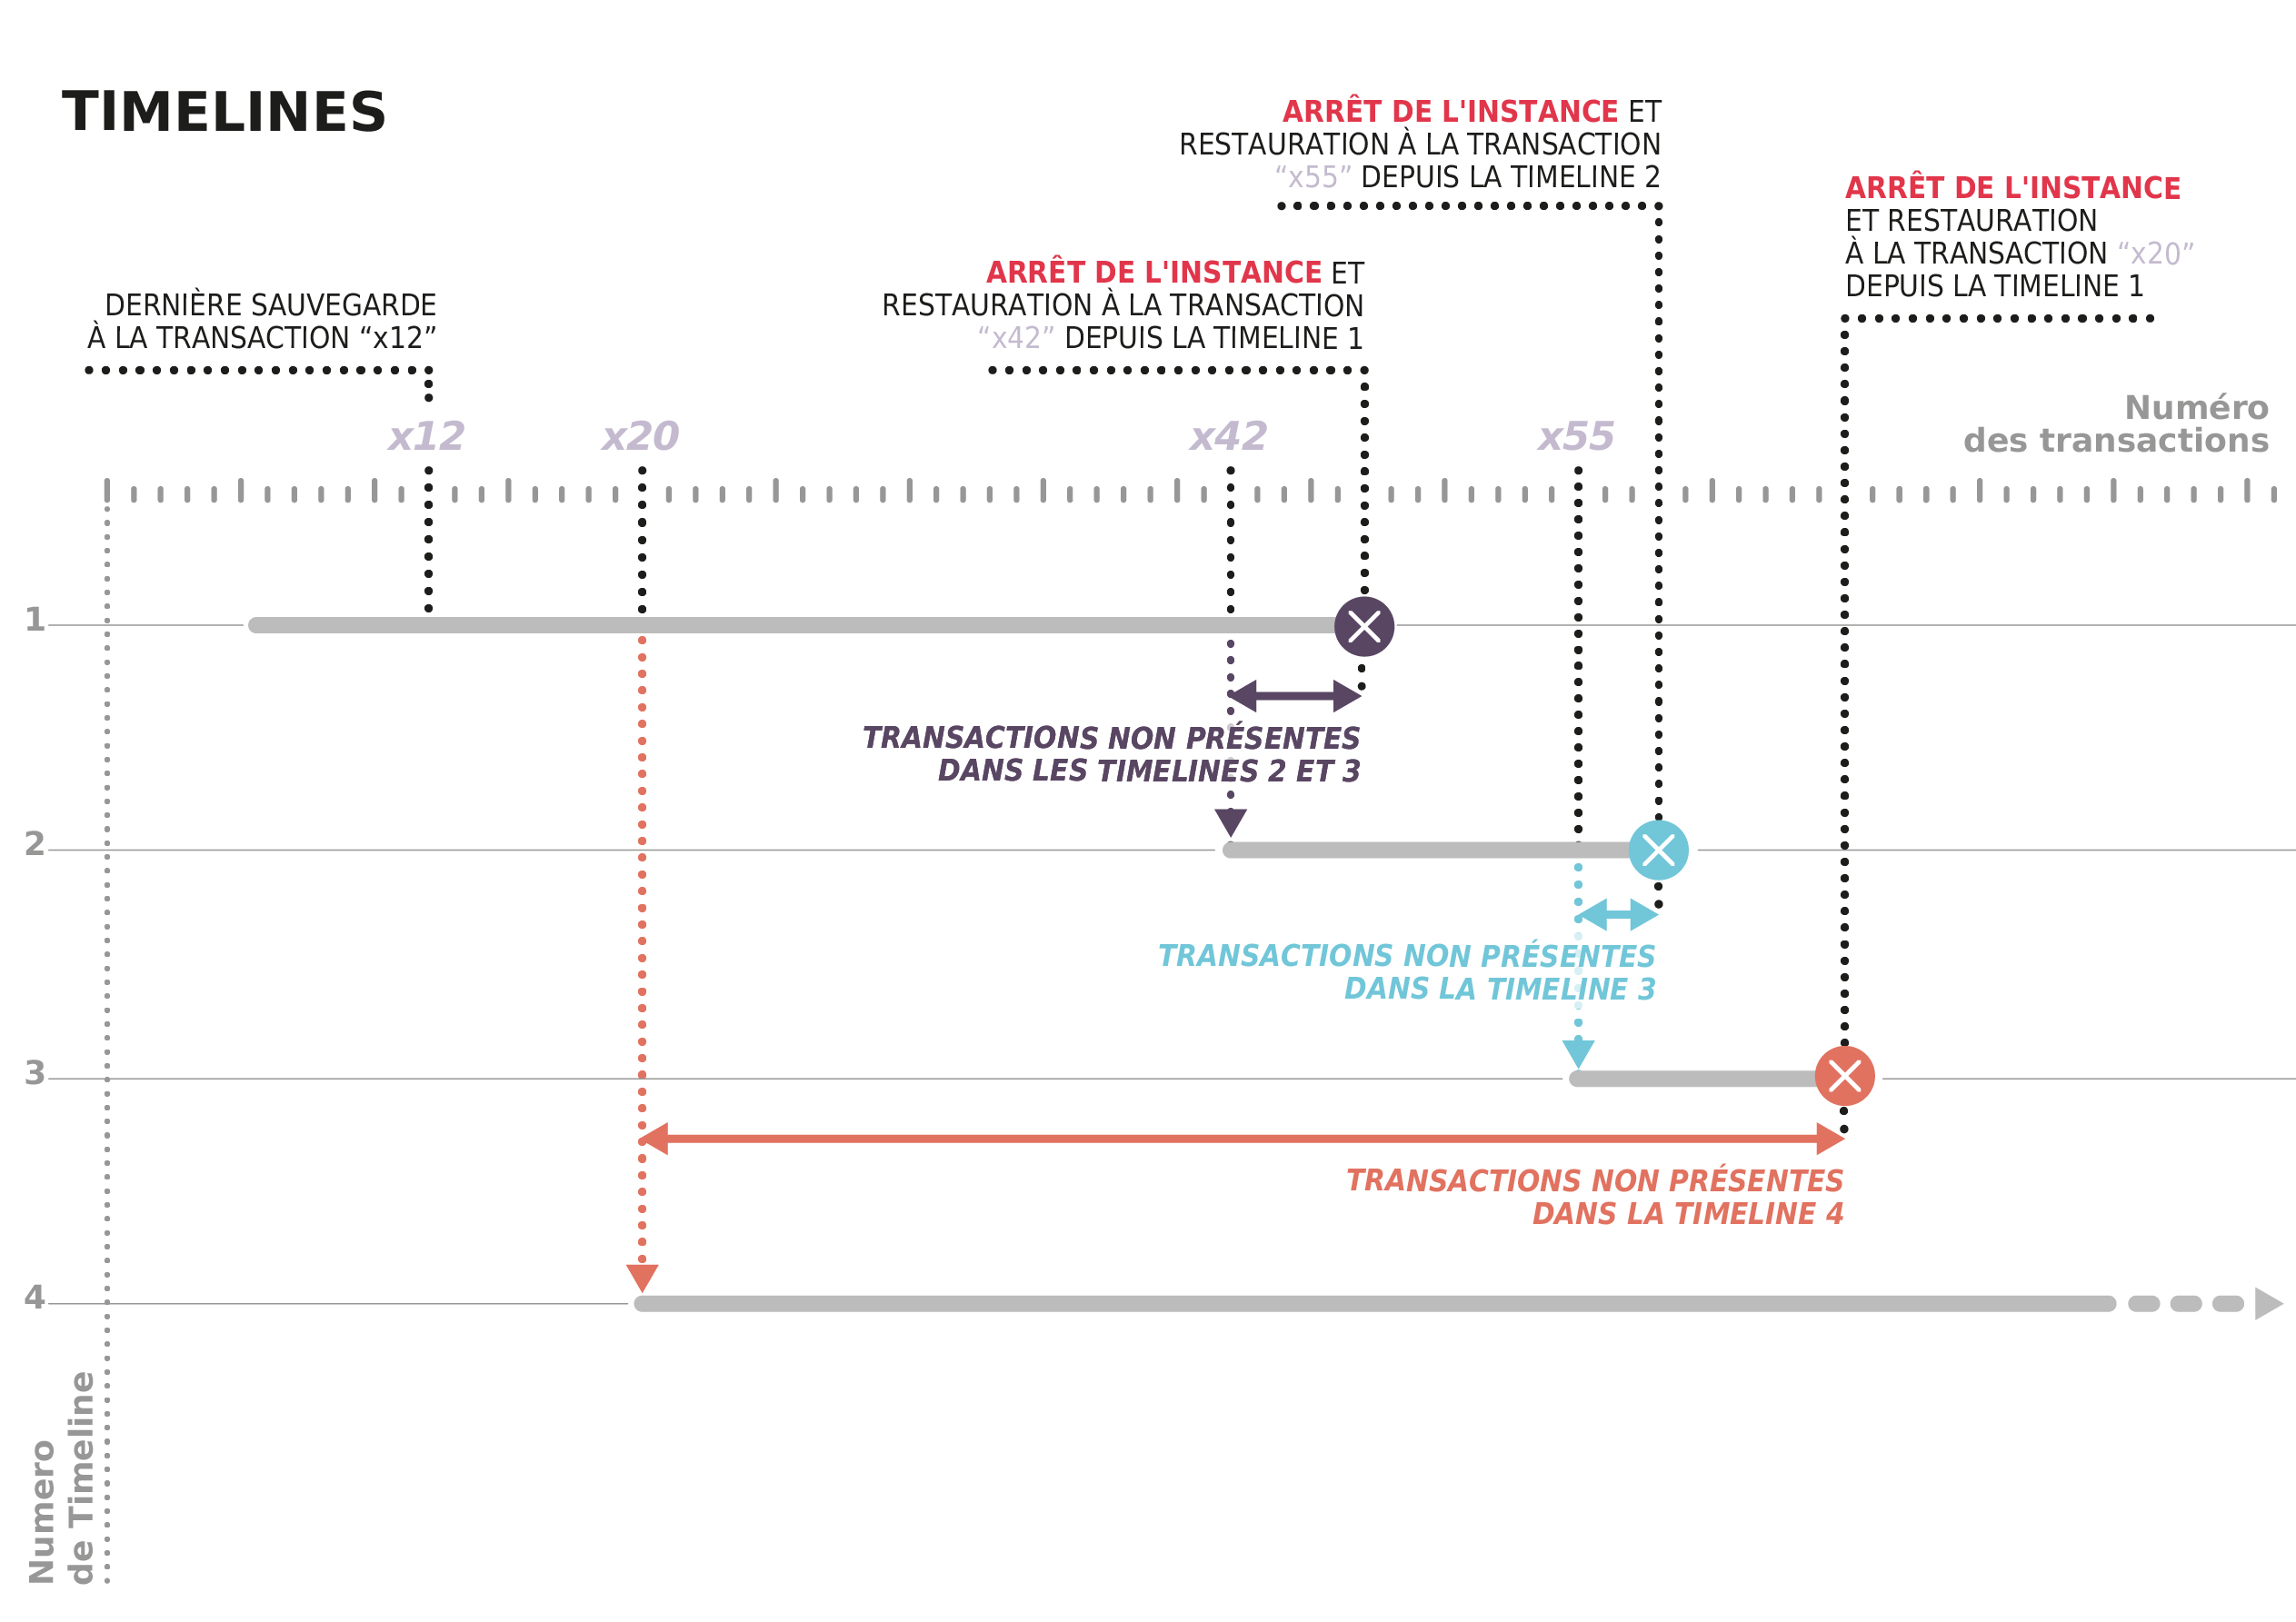
Ce schéma illustre ce processus de plusieurs restaurations successives, et la création de différentes timelines qui en résulte. On observe ici les éléments suivants avant la première restauration :
- la fin de la dernière sauvegarde se situe en haut à gauche sur l’axe des transactions, à la transaction x12 ;
- cette sauvegarde a été effectuée alors que l’instance était en activité sur la timeline 1. On décide d’arrêter l’instance alors qu’elle est arrivée à la transaction x47 , par exemple parce qu’une nouvelle livraison de l’application a introduit un bug qui provoque des pertes de données. L’objectif est de restaurer l’instance avant l’apparition du problème afin de récupérer les données dans un état cohérent, et de relancer la production à partir de cet état. Pour cela, on restaure les fichiers de l’instance à partir de la dernière sauvegarde, puis on modifie le fichier de configuration pour que l’instance, lors de sa phase de recovery :
- restaure les WAL archivés jusqu’à l’état de cohérence (transaction x12 ) ;
- restaure les WAL archivés jusqu’au point précédant immédiatement l’apparition du bug applicatif (transaction x42 ). On démarre ensuite l’instance et on l’ouvre en écriture, on constate alors que celle-ci bascule sur la timeline 2, la bifurcation s’effectuant à la transaction x42 . L’instance étant de nouveau ouverte en écriture, elle va générer de nouveaux WAL, qui seront associés à la nouvelle timeline : ils n’écrasent pas les fichiers WAL archivés de la timeline 1, ce qui permet de les réutiliser pour une autre restauration en cas de besoin (par exemple si la transaction x42 utilisée comme point d’arrêt était trop loin dans le passé, et que l’on désire restaurer de nouveau jusqu’à un point plus récent). Un peu plus tard, on a de nouveau besoin d’effectuer une restauration dans le passé - par exemple, une nouvelle livraison applicative a été effectuée, mais le bug rencontré précédemment n’était toujours pas corrigé. On restaure donc de nouveau les fichiers de l’instance à partir de la même sauvegarde, puis on configure PostgreSQL pour suivre la timeline 2 (paramètre recovery_target_timeline = 2 ) jusqu’à la transaction x55 . Lors du recovery, l’instance va :
- restaurer les WAL archivés jusqu’à l’état de cohérence (transaction x12 ) ;
- restaurer les WAL archivés jusqu’au point de la bifurcation (transaction x42 );
- suivre la timeline indiquée (2) et rejouer les WAL archivés jusqu’au point précédant immédiatement l’apparition du bug applicatif (transaction x55 ). On démarre ensuite l’instance et on l’ouvre en écriture, on constate alors que celle-ci bascule sur la timeline 3, la bifurcation s’effectuant cette fois à la transaction x55 . Enfin, on se rend compte qu’un problème bien plus ancien et subtil a été introduit précédemment aux deux restaurations effectuées. On décide alors de restaurer l’instance jusqu’à un point dans le temps situé bien avant, jusqu’à la transaction x20 . On restaure donc de nouveau les fichiers de l’instance à partir de la même sauvegarde, et on configure le serveur pour restaurer jusqu’à la transaction x20 . Lors du recovery, l’instance va :
- restaurer les WAL archivés jusqu’à l’état de cohérence (transaction x12 ) ;
- restaurer les WAL archivés jusqu’au point précédant immédiatement l’ apparition du bug applicatif (transaction x20 ).
Comme la création des deux timelines précédentes est archivée dans les fichiers history, l’ouverture de l’instance en écriture va basculer sur une nouvelle timeline (4). Suite à cette restauration, toutes les modifications de données provoquées par des transactions effectuées sur la timeline 1 après la transaction x20 , ainsi que celles effectuées sur les timelines 2 et 3, ne sont donc pas présentes dans l’instance.
2.8.11 Après la restauration
- Bien vérifier que l’archivage a repris
- et que les archives des journaux sont complètes
- Ne pas hésiter à reprendre une sauvegarde complète
- Bien vérifier que les secondaires ont suivi
Une fois le nouveau primaire en place, la production peut reprendre, mais il faut vérifier que la sauvegarde PITR est elle aussi fonctionnelle. Ce nouveau primaire a généralement commencé à archiver ses journaux à partir du dernier journal récupéré de l’ancien primaire, renommé avec l’extension .partial , juste avant la bascule sur la nouvelle timeline. Il faut bien sûr vérifier que l’archivage des nouveaux journaux fonctionne. Sur l’ancien primaire, les derniers journaux générés juste avant l’incident n’ont pas forcément été archivés. Ceux-ci possèdent un fichier témoin .ready dans pg_wal/archive_status . Même s’ils ont été copiés manuellement vers le nouveau primaire avant sa promotion, celui-ci ne les a pas archivés.
Rappelons qu’un « trou » dans le flux des journaux dans le dépôt des archives empêchera la restauration d’aller au-delà de ce point !
Il est possible de forcer l’archivage des fichiers .ready depuis l’ancien primaire, avant la bascule, en exécutant à la main les archive_command que PostgreSQL aurait générées, mais la facilité pour le faire dépend de l’outil. La copie de journaux à la main est donc risquée. De plus, s’il y a eu plusieurs restaurations successives, qui ont provoqué quelques archivages et des apparitions de timelines dans le même dépôt d’archives, avant d’être abandonnées, il faut faire attention au paramètre recovery_target_timeline ( latest ne convient plus), ce qui complique une future restauration.
Pour faciliter des restaurations ultérieures, il est recommandé de procéder au plus tôt à une sauvegarde complète du nouveau primaire.
Quant aux éventuelles instances secondaires, il est vraisemblable qu’elles doivent être reconstruites suite à la restauration de l’instance primaire. (Si elles ont appliqué des journaux qui ont été perdus et n’ont pas été repris par le primaire restauré, ces secondaires ne pourront se raccrocher. Consulter les traces.)
2.9 Archivage & compression
- Limiter la volumétrie des journaux sauvegardés
- Quels sont les outils PITR ?
2.9.1 Réduire le nombre de journaux sauvegardés
- Monter
- checkpoint_timeout
- max_wal_size
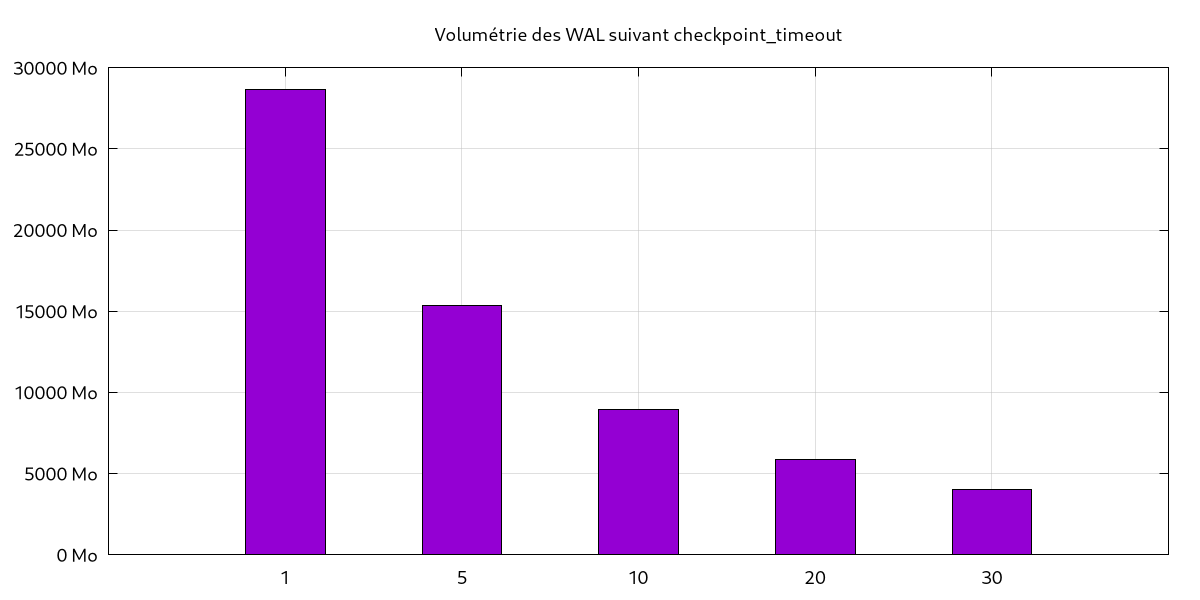
L’un des problèmes de la sauvegarde PITR est la place prise sur disque par les journaux de transactions. Si un journal de 16 Mo (par défaut) est généré toutes les minutes, le total est de 23 Go de journaux par jour, et parfois beaucoup plus. Il n’est pas forcément possible de conserver autant de journaux. Un premier moyen est de reduire la volumétrie à la source en espaçant les checkpoints. Le graphique ci-dessus représente la volumétrie générée par un simple test avec pgbench (OLTP classique donc) avec checkpoint_timeout variant entre 1 et 30 minutes : les écarts sont énormes.
La raison est que, pour des raisons de fiabilité, un bloc modifié est intégralement écrit (8 ko) dans les journaux à sa première modification après un checkpoint. Par la suite, seules les modifications de ce bloc, souvent beaucoup plus petites, sont journalisées. (Ce comportement dépend du paramètre
full_page_writes 12 , activé par défaut et qu’il est impératif de laisser tel quel, sauf peut-être sur ZFS.) Espacer les checkpoints permet d’économiser des écritures de blocs complets, si l’activité s’y prête (en OLTP surtout). Il y a un intérêt en performances, mais surtout en place disque économisée quand les journaux sont archivés, aussi accessoirement en CPU s’ils sont compressés, et en trafic réseau s’ils sont répliqués. Un exemple figure dans ce billet du blog Dalibo 13 . Par cohérence, si l’on monte checkpoint_timeout , il faut penser à augmenter aussi max_wal_size , et vice-versa. Des valeurs courantes sont respectivement 15 minutes, parfois plus, et plusieurs gigaoctets. Il y a cependant un inconvénient : un écart plus grand entre checkpoints peut allonger la restauration après un arrêt brutal, car il y aura plus de journaux à rejouer, parfois des centaines ou des milliers.
2.9.2 Compresser les journaux de transactions
- wal_compression = on
- moins de journaux
- un peu plus de CPU
- à activer : pglz ( on ), lz4 , zstd (v15+)
- Outils de compression standards : gzip , bzip2 , lzma …
- attention à ne pas ralentir l’archivage
PostgreSQL peut compresser les journaux à la source, avec le paramètre wal_compression (hélas désactivé par défaut). La compression est opérée par PostgreSQL au niveau de la page, avec un gros gain en volumétrie (souvent plus de 50 % !). Les journaux font toujours 16 Mo (par défaut), mais ils sont moins nombreux. Cela accélère la réplication et la reprise après un crash. Cette compression des journaux est totalement transparente pour l’archivage ou la restauration. Le prix est une augmentation de la consommation en CPU, souvent négligeable. Cependant, cette compression ne concerne que les insertions de blocs de données complets, donc pas l’intégralité des journaux. Les algorithmes de compression disponibles sont (depuis PostgreSQL 15) : pglz , lz4 ou zstd . on est le synonyme de pglz … qui est sans doute le moins bon des trois, surtout en terme de consommation CPU. Ce petit test de Michael Paquier 14 montre que l’impact sur le taux de compression est assez faible. Une solution complémentaire est la compression à la volée des journaux archivés dans l’ archive_command . Les outils classiques comme gzip , bzip2 , lzma , xz , etc. conviennent. Tous les outils PITR incluent plusieurs de ces algorithmes. Un fichier de 16 Mo aura généralement une taille compressée comprise entre 3 et 6 Mo. Cette compression reste utile même si wal_compression est activé.
Cependant, attention au temps de compression des journaux : en cas d’écritures lourdes, une compression élevée, mais lente, peut mener à un retard conséquent de l’archivage par rapport à l’écriture des journaux, jusque saturation de pg_wal/ , et arrêt de l’instance. Il est courant de se contenter de gzip -1 ou lz4 -1 pour les journaux, et de ne compresser agressivement que les sauvegardes des fichiers de la base.
2.10 Outils de sauvegarde PITR
- Ne réinventez pas la roue!
- Avantage des outils éprouvés :
- gestion des backups & de leur rétention
- commande sûre pour l’archivage
- commandes pour la restauration
- nombreuses optimisations
- tranquillité d’esprit
Il n’est pas conseillé de réinventer la roue et d’écrire soi-même des scripts de sauvegarde PITR. En effet, il faut prévoir de nombreux cas et bien gérer les erreurs. La sauvegarde concurrente est également difficile à manier.
Des outils reconnus existent, dont nous évoquerons brièvement les plus connus parmi ceux qui sont libres. Ils ne font pas partie du projet PostgreSQL à proprement parler, et doivent être installés séparément. Il en existe d’autres, parfois payants.
Les outils décrits succinctement plus bas permettent :
- d’archiver aisément et en sécurité;
- de procéder aux sauvegardes;
- de gérer leur rétention;
- de gérer celle des journaux associés ;
- de compresser et optimiser finement sauvegardes complètes et archives;
- de restaurer avec un outil éprouvé.
Ces outils ne sont pas adaptés à l’utilisation de snapshots. Il faudra se tourner vers des outils propriétaires pour cela.
Leur philosophie peut différer, notamment en terme de centralisation ou de compromis entre simplicité et fonctionnalités. Ces dernières s’enrichissent d’ailleurs au fil du temps.
2.10.1 PgBackRest
- Gère la sauvegarde et la restauration PITR
- pull ou push, multidépôts
- mono- ou multiserveur
- Indépendant des commandes système
- protocole dédié
- Sauvegardes complètes, différentielles ou incrémentales
- Compression, multi-dépôts
- Multithread, sauvegarde depuis un secondaire, archivage asynchrone…
- Projet mature
pgBackRest 15 est un outil de gestion de sauvegardes PITR écrit en C, par David Steele. Le code source 16 est sous licence MIT. Il met l’accent sur les performances avec de gros volumes et les fonctionnalités, au prix d’une complexité à la configuration :
- un protocole dédié pour le transfert et la compression des données ;
- des opérations parallélisables en multithread;
- la possibilité de réaliser des sauvegardes complètes, différentielles et incrémentales selon les besoins et contraintes de durées;
- la possibilité d’archiver ou restaurer les WAL de façon asynchrone, et donc plus rapide;
- la possibilité d’abandonner l’archivage en cas d’accumulation et de risque de saturation de pg_wal ;
- la gestion de dépôts de sauvegarde multiples (pour sécuriser, ou avoir plusieurs niveaux d’archives);
- le support intégré de dépôts S3 ou Azure;
- le support d’un accès TLS géré par pgBackRest en alternative à SSH;
- la sauvegarde depuis un serveur secondaire;
- le chiffrement des sauvegardes;
- la restauration en mode delta, très pratique pour restaurer un serveur qui a décroché mais n’a que peu divergé;
- la reprise d’une sauvegarde échouée. pgBackRest n’utilise pas pg_receivewal pour garantir la sauvegarde du dernier journal (non terminé) avant un sinistre. Les auteurs considèrent que dans ce cas un secondaire synchrone est plus adapté et plus fiable. Le projet est très actif et considéré comme fiable, et les fonctionnalités proposées sont intéressantes. Pour la supervision de l’outil, une sonde Nagios est fournie par un des développeurs : check_pgbackrest 17 .
- Source 15 : https://pgbackrest.org/
- Source 16 : https://github.com/pgbackrest/pgbackrest
- Source 17 : https://github.com/pgstef/check_pgbackrest/
2.10.2 Barman
- Gère la sauvegarde et la restauration
- mode pull
- multiserveurs
- Une seule commande ( barman )
- Et de nombreuses actions
- list-server , backup , list-backup , recover …
- Utilise pg_basebackup , pg_receivewal
- Utilisé par CloudNativePG
barman est un outil créé par 2ndQuadrant (racheté depuis par EDB). Il a pour but de faciliter la mise en place de sauvegardes PITR. Il gère à la fois la sauvegarde et la restauration. La commande barman dispose par exemple de ces actions :
- list-server , pour connaître la liste des serveurs configurés;
- backup , pour lancer une sauvegarde de base;
- list-backup , pour connaître la liste des sauvegardes de base;
- show-backup , pour afficher des informations sur une sauvegarde;
- delete , pour supprimer une sauvegarde;
- recover , pour restaurer une sauvegarde (la restauration peut se faire à distance).
À la différence de pgBackRest, barman repose sur les outils internes de PostgreSQL :
- pg_basebackup pour la copie des fichiers;
- pg_receivewal (optionnellement) pour streamer les journaux à archiver.
Il supporte aussi les dépôts S3 ou blob Azure. Un outil annexe, barman-cli-cloud 18 , permet de sauvegarder directement dans le cloud sans serveur Barman dédié. Cet outil est inclus dans l’opérateur Kubernetes CloudNativePG, également issu d’EDB. Voir : Site web de barman 19
2.10.3 WAL-G
- Successeur de WAL-E, par Citus Data & Yandex
- Orientation cloud
- Aussi pour MySQL et SQL Server
- Source 18 : https://docs.pgbarman.org/release/3.19.1/user_guide/barman_cloud.html
- Source 19 : https://www.pgbarman.org/
WAL-G 20 est une réécriture d’un ancien outil assez populaire, WAL-E, par Citus 21 et Yandex, et actif.
De par sa conception, il est optimisé pour l’archivage des journaux de transactions vers des stockages cloud (Amazon S3, Google, Yandex), la compression multiprocesseur par différents algorithmes 22 et l’optimisation du temps de restauration. Il supporte aussi MySQL/MariaDB et SQL Server (et d’autres dans le futur).
2.10.4 Autres outils de l’écosystème
- De nombreux autres outils existent
- …ou ont existé
- pitrery, WAL-E, OmniPITR, pg_rman, walmgr…
Du fait du dynamisme du projet, l’écosystème des outils autour de PostgreSQL est très changeant. À côté des outils évoqués ci-dessus, que nous recommandons, on trouve de nombreux projets autour du thème de la gestion des sauvegardes.
Certains de ces projets répondent à des problématiques de manière plus sûre ou spécifique.
D’autres sont assez anciens et plus guère maintenus, comme WAL-E 23 , remplacé par WAL-G. D’autres ont été rendus inutiles par l’évolution de PostgreSQL ces dernières années, comme walmgr, de la suite Skytools 24 ; ou OmniPITR 25 ; ou encore Pitrery 26 , de Nicolas Thauvin, issu du labo R&D de Dalibo, encore supporté jusque fin 2026 et jusque PostgreSQL 14, qui s’appuyait uniquement sur la sauvegarde concurrente et visait la simplicité d’utilisation pour des bases de taille petite ou moyenne. D’autres enfin sont simplement peu actifs et peu rencontrés en production, par exemple pg_rman 27 , développé par NTT.
- Source 20 : https://github.com/wal-g/wal-g
- Source 21 : https://www.citusdata.com/blog/2017/08/18/introducing-wal-g-faster-restores-for-postgres/
- Source 22 : https://wal-g.readthedocs.io/
- Source 23 : https://github.com/wal-e/wal-e
- Source 24 : https://wiki.postgresql.org/wiki/SkyTools
- Source 25 : https://github.com/omniti-labs/omnipitr
- Source 26 : https://dalibo.github.io/pitrery/
- Source 27 : https://github.com/ossc-db/pg_rman
2.10.5 Définir ses besoins
- Sauvegardes physiques ? Logiques?
- Sauvegarde locale (NFS?) / distante (SSH? S3 ?)
- Push/pull?
- Ressources à disposition ?
- Accès? OS/environnement?
- Rétention?
- Compression? Performances?
- Pérennité, historique?
- Supervision ?
Le choix d’un outil de sauvegarde est structurant. Il faut bien définir ses besoins. Signalons d’abord qu’une sauvegarde logique ( pg_dump , pg_back 28 ) répond déjà à bien des besoins. Toutes les bases n’ont pas besoin de la complexité du PITR. Où les sauvegardes doivent-elles être stockées? Un partage NFS est courant, un S3 l’est aussi à présent. A-t-on besoin de sauvegardes différentielles/incrémentales, l’outil les gère-t-il? Quelles ressources sont à disposition ? Y a-t-il un serveur de sauvegardes dédié ? Si oui, a-t-il la puissance pour compresser fortement une grosse base, ou faut-il que ce soit fait à la source, auquel cas les ressources doivent être du côté du serveur de base de données ? Ou accepte-t-on des sauvegardes plus volumineuses? La capacité de gérer la compression et la parallélisation de l’archivage face à des écritures massives est importante. pgBackRest a d’abord été conçu pour ce besoin. Vise-t-on un RPO de zéro? Un réplica est-il disponible ? Peut-il servir à faire la sauvegarde? De quel type d’accès aux serveurs de bases de données dispose-t-on? Le mode pull est-il acceptable? recommandé? Quel est l’environnement? La plupart des outils sont diffusés par le PGDG sur les grandes distributions Linux; mais CloudNativePG impose (pour le moment) barman-cli-cloud . Quel est l’historique et la pérennité de l’outil envisagé? On ne confie pas une chose aussi importante que la sauvegarde à un outil apparu récemment, peu utilisé et mal documenté. Enfin, sait-on correctement superviser les sauvegardes (fraîcheur des sauvegardes, « trous » dans les journaux)?
- Source 28 : https://github.com/orgrim/pg_back
2.11 Conclusion
- Une sauvegarde
- fiable
- éprouvée
- rapide
- continue
- Mais
- plus complexe à mettre en place que pg_dump
- qui restaure toute l’instance
Cette méthode de sauvegarde est la seule utilisable dès que les besoins de performance de sauvegarde et de restauration augmentent (Recovery Time Objective ou RTO), ou que le volume de perte de données doit être drastiquement réduit (Recovery Point Objective ou RPO).
2.11.1 Questions
N’hésitez pas, c’est le moment !
2.12 Quiz
2.13 Installation de PostgreSQL depuis les paquets
COMMUNAUTAIRES
L’installation est détaillée ici pour Rocky Linux 8 et 9 (similaire à Red Hat et à d’autres variantes comme Oracle Linux et Fedora), et Debian/Ubuntu. Elle ne dure que quelques minutes.
2.13.1 Sur Rocky Linux 8, 9 ou 10
ATTENTION : Red Hat, CentOS, Rocky Linux fournissent souvent par défaut des versions de PostgreSQL qui ne sont plus supportées. Ne jamais installer les packages postgresql , postgresql-client et postgresql-server ! L’utilisation des dépôts du PGDG est fortement conseillée.
Installation du dépôt communautaire : Les dépôts de la communauté sont sur https://yum.postgresql.org/. Les commandes qui suivent sont inspirées de celles générées par l’assistant sur https://www.postgresql.org/download/linux/redhat/. Il n’y a guère que les informations de version qui diffèrent en fonction de :
- la version majeure de PostgreSQL (ici la 18) ;
- la distribution (ici Rocky Linux 9) ;
- l’architecture (ici x86_64, la plus courante). Les commandes sont à lancer sous root :
Installation de PostgreSQL 18 (client, serveur, librairies, extensions) :
Les outils clients et les librairies nécessaires seront automatiquement installés. Une fonctionnalité avancée optionnelle, le JIT (Just In Time compilation), nécessite un paquet séparé.
Création d’une première instance : C’est optionnel, mais il est conseillé de déclarer PGSETUP_INITDB_OPTIONS , notamment pour forcer les traces en anglais. Depuis la version 18, les sommes de contrôle sont automatiquement activées.
Ce dernier fichier permet de vérifier que tout s’est bien passé et doit finir par : Success. You can now start the database server using:
Chemins :
Objet Chemin
Binaires /usr/pgsql-18/bin Répertoire de l’utilisateur postgres
PGDATA par défaut /var/lib/pgsql/18/data Fichiers de configuration dans PGDATA/ Traces dans PGDATA/log
Configuration : Modifier postgresql.conf est facultatif pour un premier lancement. Commandes d’administration habituelles : Démarrage, arrêt, statut, rechargement à chaud de la configuration, redémarrage :
Test rapide de bon fonctionnement et connexion à psql :
Démarrage de l’instance au lancement du système d’exploitation :
Ouverture du firewall pour le port 5432 : Voir si le firewall est actif :
Si c’est le cas, autoriser un accès extérieur :
(Rappelons que listen_addresses doit être également modifié dans postgresql.conf .) Création d’autres instances : Si des instances de versions majeures différentes doivent être installées, il faut d’abord installer les binaires pour chacune (adapter le numéro dans dnf install … ) et appeler le script d’installation de chaque version. l’instance par défaut de chaque version vivra dans un sous-répertoire numéroté de /var/lib/pgsql automatiquement créé à l’installation. Il faudra juste modifier les ports dans les postgresql.conf pour que les instances puissent tourner simultanément.
Si plusieurs instances d’une même version majeure (forcément de la même version mineure) doivent cohabiter sur le même serveur, il faut les installer dans des PGDATA différents.
- Ne pas utiliser de tiret dans le nom d’une instance (problèmes potentiels avec systemd).
- Respecter les normes et conventions de l’OS : placer les instances dans un nouveau sousrépertoire de /var/lib/pgsqsl/18/ (ou l’équivalent pour d’autres versions majeures). Pour créer une seconde instance, nommée par exemple infocentre :
- Création du fichier service de la deuxième instance :
- Modification de ce dernier fichier avec le nouveau chemin :
- Option 1 : création d’une nouvelle instance vierge :
- Option 2 : restauration d’une sauvegarde : la procédure dépend de votre outil.
- Adaptation de /var/lib/pgsql/18/infocentre/postgresql.conf (port surtout).
- Commandes de maintenance de cette instance :
- Ouvrir le nouveau port dans le firewall au besoin.
2.13.2 Sur Debian / Ubuntu
L’installation ne varie quasiment pas selon les versions de Debian et Ubuntu. Ce qui suit a été testé sur Debian 10 à 13 et Ubuntu LTS 22.04 et 24.04. Sauf précision, tout est à effectuer en tant qu’utilisateur root. Référence : https://apt.postgresql.org/ Installation du dépôt communautaire : L’installation des dépôts du PGDG est prévue dans le paquet Debian postgresql-common :
gnupg2 postgresql-common
Ce dernier ordre créera le fichier du dépôt /etc/apt/sources.list.d/pgdg.list adapté à la distribution en place. Installation de PostgreSQL 18 : La méthode la plus propre consiste à modifier la configuration par défaut avant l’installation : Dans /etc/postgresql-common/createcluster.conf , paramétrer au moins les traces en anglais. Depuis la version 18, les sommes de contrôle sont automatiquement activées.
Puis installer les paquets serveur et clients et leurs dépendances :
La première instance est automatiquement créée, avec un nom ( main par défaut‘), déclarée comme service à lancer au démarrage du système, puis démarrée.
Ver Cluster Port Status Owner Data directory Log file 18 main 5432 online postgres /var/lib/postgresql/18/main /var/log/postgresql/postgresql-18-main.log
● postgresql@18-main.service - PostgreSQL Cluster 18-main Loaded: loaded (/usr/lib/systemd/system/postgresql@.service; enabled-runtime; preset: enabled) Active: active (running) since Fri 2026-01-30 15:18:43 UTC; 2min 13s ago …
L’utilisateur système postgres peut y accéder immédiatement. Chemins :
Objet Chemin
Binaires /usr/lib/postgresql/18/bin/
Objet Chemin
Répertoire de l’utilisateur postgres/var/lib/postgresql PGDATA de l’instance par défaut /var/lib/postgresql/18/main Fichiers de configuration dans /etc/postgresql/18/main/ Traces dans /var/log/postgresql/
Configuration Modifier postgresql.conf est facultatif pour un premier essai. Démarrage/arrêt de l’instance, rechargement de configuration : Debian fournit ses propres outils, qui demandent en paramètre la version et le nom de l’instance :
Démarrage de l’instance avec le serveur : C’est en place par défaut, et modifiable dans /etc/postgresql/18/main/start.conf . Ouverture du firewall : Debian et Ubuntu n’installent pas de firewall par défaut. Statut des instances du serveur :
Ver Cluster Port Status Owner Data directory Log file 18 main 5432 online postgres /var/lib/postgresql/18/main /var/log/postgresql/postgresql-18-main.log
Test rapide de bon fonctionnement et connexion à psql :
Destruction d’une instance :
Création d’autres instances : Ce qui suit est valable pour remplacer l’instance par défaut par une autre, par exemple pour activer les sommes de contrôles (checksums) avant la version v18 :
- optionnellement, permet de mettre en
place tout d’entrée les messages en anglais, le format des traces, l’emplacement séparé pour les journaux ou les checksums pour une version inférieure à 18 :
- créer une instance :
Il est également possible de préciser certains paramètres du fichier postgresql.conf , voire les chemins des fichiers (il est conseillé de conserver les chemins par défaut) :
– –data-checksums –waldir=/ssd/postgresql/18/infocentre/journaux
- adapter au besoin /etc/postgresql/18/infocentre/postgresql.conf ;
- démarrage :
2.13.3 Accès à l’instance depuis le serveur même (toutes distributions)
Par défaut, l’instance n’est accessible que par l’utilisateur système postgres, qui n’a pas de mot de passe. Un détour par sudo est nécessaire :
Type “help” for help.
Ce qui suit permet la connexion directement depuis un utilisateur du système : Pour des tests (pas en production!), il suffit de passer à trust le type de la connexion en local dans le pg_hba.conf :
localall postgres trust
La connexion en tant qu’utilisateur postgres (ou tout autre) n’est alors plus sécurisée :
dalibo:~$ psql -U postgres
Type “help” for help.
Une authentification par mot de passe est plus sécurisée :
- dans pg_hba.conf , paramétrer une authentification par mot de passe pour les accès depuis localhost (déjà en place sous Debian) :
(Ne pas oublier de recharger la configuration en cas de modification.)
- ajouter un mot de passe à l’utilisateur postgres de l’instance :
dalibo:~$ sudo -iu postgres psql
Type “help” for help.
Enter new password for user “postgres”: Enter it again:
dalibo:~$ psql -h localhost -U postgres Password for user postgres:
Type “help” for help.
- Pour se connecter sans taper le mot de passe à une instance, un fichier .pgpass dans le répertoire personnel doit contenir les informations sur cette connexion :
localhost:5432:*:postgres:motdepassetrèslong
Ce fichier doit être protégé des autres utilisateurs :
- Pour n’avoir à taper que psql , on peut définir ces variables d’environnement dans la session voire dans ~/.bashrc :
Rappels :
- en cas de problème, consulter les traces (dans
/var/lib/pgsql/18/data/logou/var/log/postgresql/); - toute modification de
pg_hba.confoupostgresql.confimpliquant de recharger la configuration peut être réalisée par une de ces trois méthodes en fonction du système :
2.14 Introduction à pgbench
pgbench est un outil de test livré avec PostgreSQL. Son but est de faciliter la mise en place de benchmarks simples et rapides. Par défaut, il installe une base très simple, génère une activité plus ou moins intense et calcule le nombre de transactions par seconde et la latence. C’est ce qui sera fait ici dans cette introduction. On peut aussi lui fournir ses propres scripts.
La documentation complète est sur https://docs.postgresql.fr/current/pgbench.html. L’auteur principal, Fabien Coelho, a fait une présentation complète, en français, à la PG Session #9 de 2017 29 .
2.14.1 Installation
L’outil est installé avec les paquets habituels de PostgreSQL, client ou serveur suivant la distribution. Sur les distributions à paquets RPM (RockyLinux…), l’outil n’est pas dans le chemin par défaut, il faudra fournir le chemin complet (qui ne sera pas répété ici) :
Il est préférable de créer un rôle non privilégié dédié, qui possédera la base de donnée :
- Source 29 : https://youtu.be/aTwh_CgRaE0
Le pg_hba.conf doit éventuellement être adapté. La base par défaut s’initialise ainsi (ajouter
avec 10 millions de lignes dans la table principale pgbench_accounts :
Liste des relations
2.14.2 Générer de l’activité
Pour simuler une activité de 20 clients simultanés, répartis sur 4 processeurs, pendant 100 secondes :
Pour afficher, ajouter –debug :
VALUES (134, 78, 3789437, -3455, CURRENT_TIMESTAMP);
À la fin, s’affichent notamment le nombre de transactions (avec et sans le temps de connexion) et la durée moyenne d’exécution du point de vue du client ( latency ) :
scaling factor: 100 query mode: simple number of clients: 20 number of threads: 4 duration: 10 s number of transactions actually processed: 20433 latency average = 9.826 ms
Modifier le paramétrage est facile grâce à la variable d’environnement PGOPTIONS :
2>/dev/null
latency average = 6.992 ms
Des tests rigoureux doivent durer bien sûr beaucoup plus longtemps que 100 s, par exemple pour tenir compte des effets de cache, des checkpoints périodiques, etc.
2.15 Travaux pratiques
La version en ligne des solutions de ces TP est disponible sur https://dali.bo/i2_solutions.
2.15.1 Pg_basebackup : sauvegarde ponctuelle & restauration
But : Créer une sauvegarde physique à chaud à un moment précis de la base avec pg_basebackup , et la restaurer.
NB : Ce TP a été mis à jour pour la version 18 de PostgreSQL. Adapter les chemins pour les autres versions au besoin. Dans ce qui suit, la plupart des commandes seront à lancer en tant que postgres, les ordres sudo nécessitant un utilisateur privilégié. Vous aurez besoin de plusieurs terminaux sous postgres (application, sauvegardes, restauration), et d’un terminal pour l’utilisateur privilégié..
Préparer la réplication dans postgresql.conf et pg_hba.conf :
- activer l’archivage;
- simuler un archivage fonctionnel avec /bin/true comme valeur pour la commande d’archivage ( archive_command ) ;
- autoriser les connexions de réplication en streaming en local.
Pour insérer des données :
- en arrière-plan dans un autre terminal, générer de l’activité avec pgbench en tant qu’utilisateur postgres :
- surveiller l’évolution de l’activité sur la table pgbench_history , par exemple ainsi :
En parallèle, sauvegarder l’instance avec :
- pg_basebackup au format tar, compressé avec gzip;
- sans oublier les journaux ;
- avec l’option –max-rate=10M pour ralentir la sauvegarde;
- le répertoire de sauvegarde sera /var/lib/pgsql/backups/data.bb.bak ;
- surveiller la progression dans une autre session avec la vue système adéquate.
Une fois la sauvegarde terminée : quels sont les fichiers générés?
Arrêter la session pgbench ;
Noter l’heure exacte de dernière modification dans pgbench_history .
Arrêter l’instance.
Faire une copie à froid des données (par exemple avec cp -rfp ) vers /var/lib/pgsql/backups/data.afroid (cette copie resservira plus tard).
Vider le répertoire des données ;
Restaurer la sauvegarde pg_basebackup en décompressant ses deux archives ( tar -C … -xzf … ) dans le répertoire de données original ;
Redémarrer l’instance.
Une fois l’instance restaurée et démarrée, vérifier les traces : la base doit accepter les connexions.
Quelle est la dernière donnée restaurée (dans pgbench_history ) ? Y a-t-il un écart? Est-ce normal?
Tenter une nouvelle restauration depuis l’archive pg_basebackup sans restaurer les journaux de transaction. Que se passe-t-il? Consulter le fichier backup_label .
(Optionnel) Copier une partie des journaux sauvegardés dans pg_wal et tenter un démarrage. Que se passe-t-il?
(Optionnel) Chercher l’enregistrement suivant parmi les journaux avec :
Restaurer à nouveau la sauvegarde par pg_basebackup . Quelle est la timeline?
2.15.2 Pg_basebackup : sauvegarde ponctuelle & restauration des journaux
suivants
But : Coupler une sauvegarde à chaud avec pg_basebackup et l’archivage
Si après le TP précédent l’instance n’est pas fonctionnelle, remettre en place la copie à froid de l’instance depuis /var/lib/pgsql/backups/data.afroid.bak/ .
Configurer l’archivage vers un répertoire /archives , par exemple avec rsync . Configurer la commande de restauration inverse; Démarrer PostgreSQL.
Générer à nouveau de l’activité avec pgbench : en tant qu’utilisateur postgres :
Vérifier que l’archivage fonctionne dans le répertoire /archives , dans les traces et dans la vue pg_stat_archiver .
En parallèle, lancer une nouvelle sauvegarde avec pg_basebackup au format plain (non compressé).
Utiliser pg_verify_backup pour contrôler l’intégrité de la sauvegarde.
À quoi correspond le fichier finissant par .backup dans les archives?
Arrêter pgbench et noter la date des dernières données insérées.
Effacer le PGDATA; Restaurer la sauvegarde précédente sans les journaux ; Configurer la restore_command ;. Créer le fichier recovery.signal ; Démarrer PostgreSQL.
Vérifier les traces, ainsi que les données restaurées une fois le service démarré.
Vérifier quelles données ont été restaurées.
2.16 Travaux pratiques (solutions)
2.16.1 Pg_basebackup : sauvegarde ponctuelle & restauration
NB : Ce TP a été mis à jour pour la version 18 de PostgreSQL. Adapter les chemins pour les autres versions au besoin. Dans ce qui suit, la plupart des commandes seront à lancer en tant que postgres, les ordres sudo nécessitant un utilisateur privilégié. Vous aurez besoin de plusieurs terminaux sous postgres (application, sauvegardes, restauration), et un pour l’utilisateur privilégié.
Préparer la réplication dans postgresql.conf et pg_hba.conf :
- activer l’archivage;
- simuler un archivage fonctionnel avec /bin/true comme valeur pour la commande d’archivage ( archive_command ) ;
- autoriser les connexions de réplication en streaming en local.
On n’aura pas encore besoin de l’archivage ici. S’il est déjà actif, on peut se contenter d’inhiber ainsi la commande d’archivage (cela économise le redémarrage suite à modification de archive_mode ) :
dans /var/lib/pgsql/18/data/postgresql.conf (pour les paquets RPM du PGDG ; sur Debian/Ubuntu, le postgresql.conf est dans /etc/postgresql/18/main/). Vérifier l’autorisation de connexion en réplication dans pg_hba.conf. Si besoin, mettre à jour la ligne en fin de fichier :
Cela va ouvrir l’accès sans mot de passe depuis l’utilisateur système postgres. Redémarrer PostgreSQL :
(Sous Debian, le nom du service est plutôt postgresql@18-main .)
Pour insérer des données :
- en arrière-plan dans un autre terminal, générer de l’activité avec pgbench en tant qu’utilisateur postgres :
- surveiller l’évolution de l’activité sur la table pgbench_history , par exemple ainsi :
Les commandes suivantes créent une base de 1,5 Go :
L’option suivante ne sert qu’à accélérer les tests (ne pas utiliser en production au risque de perdre quelques données en cas de crash) :
Celle-ci génère quelques centaines de transactions/seconde, limitées par un processeur :
En parallèle, sauvegarder l’instance avec :
- pg_basebackup au format tar, compressé avec gzip;
- sans oublier les journaux ;
- avec l’option –max-rate=10M pour ralentir la sauvegarde;
- le répertoire de sauvegarde sera /var/lib/pgsql/backups/data.bb.bak ;
- surveiller la progression dans une autre session avec la vue système adéquate.
(Le répertoire de sauvegarde correspond à une installation par défaut sur un Linux Red Hat ou similaire. Adapter le chemin sur un système Debian/Ubuntu.) En tant que postgres :
1583675/1583675 kB (100%), 1/1 tablespace
Évidemment, en production, il ne faut pas sauvegarder sur le même serveur, et encore moins le même disque, que les données. La progression peut se suivre depuis psql avec :
\x on
\watch 1
backup_streamed
tablespaces_total
backup_streamed
tablespaces_total
…
La sauvegarde devrait durer trois minutes.
Une fois la sauvegarde terminée : quels sont les fichiers générés?
Les fichiers générés sont : ls -lha /var/lib/pgsql/backups/data.bb.bak
… -rw——-. 1 postgres postgres 180K Sep 4 16:58 backup_manifest -rw——-. 1 postgres postgres 88M Sep 4 16:58 base.tar.gz -rw——-. 1 postgres postgres 5.1M Sep 4 16:58 pg_wal.tar.gz
On obtient donc :
- une archive de la sauvegarde « de base » ;
- une archive des journaux nécessaires;
- un fichier manifeste JSON contenant les sommes de contrôles des fichiers archivés. Ce dernier peut se consulter avec :
… { “Path”: “base/1/3466”, “Size”: 0, “Last-Modified”: “2026-09-04 06:17:19 GMT”, “Checksum-Algorithm”: “CRC32C”, “Checksum”: “00000000” }, …
- Arrêter la session pgbench ;
- Noter l’heure exacte de dernière modification dans pgbench_history .
L’activité avec pgbench s’arrête avec un simple Ctrl-C. Noter l’heure de dernière modification :
max
2026-09-04 17:31:09.360418
- Arrêter l’instance;
- Faire une copie à froid des données (par exemple avec cp -rfp ) vers /var/lib/pgsql/backups/data.afroid (cette copie resservira plus tard).
En tant qu’utilisateur privilégié :
En tant qu’utilisateur postgres :
Ce répertoire de données correspond à une installation par défaut sur un Linux Red Hat, Rocky Linux ou similaire. Sur un système Debian/Ubuntu, les données sont par défaut dans
- Vider le répertoire des données ;
- Restaurer la sauvegarde pg_basebackup en décompressant ses deux archives ( tar -C … -xzf … ) dans le répertoire de données original ;
- Redémarrer l’instance.
On restaure dans le répertoire de données l’archive de base, puis les journaux dans leur sousrépertoire pg_wal/ . La suppression des traces est optionnelle, mais elle évite de mélanger celles d’avant et celles d’après la restauration. En tant qu’utilisateur postgres :
-xzf /var/lib/pgsql/backups/data.bb.bak/base.tar.gz
-xzf /var/lib/pgsql/backups/data.bb.bak/pg_wal.tar.gz
ls -l /var/lib/pgsql/18/data/pg_wal/
total 49152 -rw——-. 1 postgres postgres 16777216 Sep 4 16:32 000000010000000000000059 -rw——-. 1 postgres postgres 16777216 Sep 4 16:33 00000001000000000000005A -rw——-. 1 postgres postgres 16777216 Sep 4 16:33 00000001000000000000005B drwx——. 2 postgres postgres 80 Sep 4 17:06 archive_status drwx——. 2 postgres postgres 6 Sep4 16:32 summaries
En tant qu’utilisateur privilégié :
Une fois l’instance restaurée et démarrée, vérifier les traces : la base doit accepter les connexions.
En tant postgres ou root : tail -F /var/lib/pgsql/18/data/log/postgresql-*.log
… … LOG:listening on Unix socket “/tmp/.s.PGSQL.5432” … LOG:database system was interrupted; last known up at 2026-09-04 17:29:08 CEST … LOG:starting backup recovery with redo LSN 0/5106DCA8, checkpoint LSN 0/510F5D78, on timeline ID 1 … LOG:redo starts at 0/5106DCA8 … LOG:completed backup recovery with redo LSN 0/5106DCA8 and end LSN 0/54FF3C88 … LOG:consistent recovery state reached at 0/54FF3C88 … LOG:redo done at 0/54FF3C88 system usage: CPU: user: 0.08 s, system: 0.07 s, elapsed: 0.16 s … LOG:checkpoint starting: end-of-recovery immediate wait … LOG:checkpoint complete: wrote 8353 buffers (51.0%), wrote 3 SLRU buffers; 0 WAL file(s) added, 0 removed, 4 recycled; write=0.292 s, sync=0.634 s, total=0.985 s; sync files=23, longest=0.622 s, average=0.028 s; distance=65096 kB, estimate=65096 kB; lsn=0/55000028, redo lsn=0/55000028 … LOG:database system is ready to accept connections …
PostgreSQL considère qu’il a été interrompu brutalement et part en recovery. Noter en particulier la mention consistent recovery state reached : la sauvegarde est bien cohérente.
Quelle est la dernière donnée restaurée (dans pgbench_history ) ? Y a-t-il un écart? Est-ce normal?
max
2026-09-04 17:29:44.286013
Il y a un petit écart. Grâce aux journaux ( pg_wal ) restaurés, l’ensemble des modifications survenues pendant la sauvegarde ont bien été récupérées. Par contre, les données générées après la sauvegarde n’ont, elles, pas été récupérées. Il aurait fallu des journaux postérieurs à la sauvegarde.
Tenter une nouvelle restauration depuis l’archive pg_basebackup sans restaurer les journaux
de transaction. Que se passe-t-il? Consulter le fichier backup_label .
En tant qu’utilisateur privilégié :
-xzf /var/lib/pgsql/backups/data.bb.bak/base.tar.gz
ls /var/lib/pgsql/18/data/pg_wal/
Il n’y a plus les journaux :
summaries
Et le redémarrage donne :
Job for postgresql-18.service failed because the control process exited with error code. See “systemctl status postgresql-18.service” and “journalctl -xeu postgresql-18.service” for details.
Pour trouver la cause, il faut aller chercher dans les traces : tail /var/lib/pgsql/18/data/log/postgresql-*.log
… LOG:starting backup recovery with redo LSN 0/5106DCA8, checkpoint LSN 0/510F5D78, on timeline ID 1 … LOG:invalid checkpoint record … FATAL: could not locate required checkpoint record at 0/510F5D78 … HINT:If you are restoring from a backup, touch “/var/lib/pgsql/18/data/recovery.signal” or “/var/lib/pgsql/18/data/standby.signal” and add required recovery options. If you are not restoring from a backup, try removing the file “/var/lib/pgsql/18/data/backup_label”. Be careful: removing “/var/lib/pgsql/18/data/backup_label” will result in a corrupt cluster if restoring from a backup. … LOG:startup process (PID 30842) exited with exit code 1 … LOG:terminating any other active server processes … LOG:shutting down due to startup process failure … LOG:database system is shut down
PostgreSQL ne trouve pas les journaux nécessaires à sa restauration à un état cohérent, le service refuse de démarrer. Il a trouvé le point de départ 0/5106DCA8 dans le fichier backup_label créé au début de la sauvegarde, mais aucun checkpoint postérieur dans les journaux (et pour cause).
START WAL LOCATION: 0/5106DCA8 (file 000000010000000000000051)
BACKUP METHOD: streamed
BACKUP FROM: primary START TIME: 2026-09-04 17:29:08 CEST LABEL: pg_basebackup base backup START TIMELINE: 1
Supprimer le backup_label permettrait peut-être de démarrer l’instance mais celle-ci serait alors dans un état incohérent! Il y a de bonnes chances que le démarrage s’achève par : … LOG:database system was interrupted; last known up at 2026-09-04 17:29:08 CEST … LOG:invalid checkpoint record … PANIC: could not locate a valid checkpoint record at 0/510F5D78 … LOG:startup process (PID 31394) was terminated by signal 6: Aborted … LOG:terminating any other active server processes … LOG:shutting down due to startup process failure … LOG:database system is shut down
En résumé : la restauration n’est pas possible sans les journaux !
(Optionnel) Copier une partie des journaux sauvegardés dans pg_wal et tenter un démarrage. Que se passe-t-il?
Décompression des journaux dans /tmp :
Copie des premiers : mv /tmp/000000010000000000000051 /var/lib/pgsql/18/data/pg_wal/ mv /tmp/000000010000000000000052 /var/lib/pgsql/18/data/pg_wal/ …
La base redémarrera… mais on a une bonne chance d’avoir ensuite ce message puis un arrêt : … LOG:restarting backup recovery with redo LSN 1> - le répertoire de sauvegarde sera /var/lib/psql/backups/data.bb.bak ;/4980DC78 … LOG:database system was not properly shut down; automatic recovery in progress … LOG:redo starts at 1/4980DC78 … LOG:redo done at 1/D0FFFC10 system usage: CPU: user: 4.45 s, system: 4.51 s, elapsed: 9.43 s … FATAL: WAL ends before end of online backup … HINT:All WAL generated while online backup was taken must be available at recovery. … LOG:startup process (PID 33428) exited with exit code 1 … LOG:terminating any other active server processes … LOG:shutting down due to startup process failure … LOG:database system is shut down
Il faut vraiment tous les journaux. (Optionnel) Chercher l’enregistrement suivant parmi les journaux avec :
PostgreSQL attend de trouver l’enregistrement BACKUP_END posé par pg_backup_stop() . Pour le chercher il faut avoir tous les journaux archivés :
Recherche dans les journaux, en fournissant les deux bornes : cd /tmp
rmgr: XLOG len (rec/tot):
34/ 34, tx: 0, lsn: 0/54FF3C60, prev
0/54FF3C38, desc: BACKUP_END 0/5106DCA8
BACKUP_END 0/5106DCA8 indique de quel backup il s’agit.
L’entrée 0/54FF3C38 indique le journal final, et il finit donc par 54 … et désigne ainsi le dernier journal de l’archive. Si l’on affiche tout le journal avec :
il finira par ceci : rmgr: XLOG len (rec/tot):
34/ 34, tx: 0, lsn: 0/54FF3C60, prev
0/54FF3C38, desc: BACKUP_END 0/5106DCA8 rmgr: XLOG len (rec/tot):
24/ 24, tx: 0, lsn: 0/54FF3C88, prev
0/54FF3C60, desc: SWITCH
indique une demande de changement de journal, (provoquant ensuite un éventuel archivage).
Restaurer à nouveau la sauvegarde par pg_basebackup . Quelle est la timeline?
Pour repartir d’une base propre : En tant qu’utilisateur privilégié :
-xzf /var/lib/pgsql/backups/data.bb.bak/base.tar.gz
-xzf /var/lib/pgsql/backups/data.bb.bak/pg_wal.tar.gz
En tant qu’utilisateur privilégié :
La timeline est visible par divers moyens :
- le premier numéro non-zéro dans les noms des journaux ;
- l’utilitaire système pg_controldata ;
- et au plus simple :
prev_timeline_id
full_page_writes
next_multixact_id
next_multi_offset
oldest_xid_dbid
oldest_active_xid
oldest_multi_xid
oldest_multi_dbid
checkpoint_time
En l’occurence, après un simple redémarrage sans recovery_signal , la timeline reste la même qu’avant.
2.16.2 Pg_basebackup : sauvegarde ponctuelle & restauration des journaux
suivants Si après le TP précédent l’instance n’est pas fonctionnelle, remettre en place la copie à froid de l’instance depuis /var/lib/pgsql/backups/data.afroid.bak/ .
Vérifier qu’il est possible de se connecter par psql .
Configurer l’archivage vers un répertoire /archives , par exemple avec rsync ; Configurer la commande de restauration inverse; Démarrer PostgreSQL.
Créer un répertoire d’archivage, s’il n’existe pas déjà, et vérifier que postgres a les droits nécessaires pour l’utiliser :
Là encore, en production, ce sera plutôt un partage distant. L’utilisateur système postgres doit avoir le droit d’y écrire. La commande d’archivage se définit dans postgresql.conf :
et on peut y définir aussi tout de suite la commande de restauration :
Si archive_mode n’était pas déjà à on , il faut redémarrer (sinon reload suffit) :
(Sous Debian, le nom du service est plutôt postgresql@18-main .) Vérifier le bon démarrage :
Générer à nouveau de l’activité avec pgbench : en tant qu’utilisateur postgres :
Cela devrait générer quelque centaines de transactions par seconde selon la machine.
Vérifier que l’archivage fonctionne dans le répertoire /archives , dans les traces et dans la vue pg_stat_archiver .
ls -lha /archives
… -rw——-. 1 postgres postgres 30M Jan 5 18:32 0000000100000000000000BB -rw——-. 1 postgres postgres 30M Jan 5 18:32 0000000100000000000000BC -rw——-. 1 postgres postgres 30M Jan 5 18:32 0000000100000000000000BD …
Si cela ne fonctionne pas, il faut aller voir les traces dans le dernier fichier en date sous
ou dans /var/log/postgresql/postgresql-18-main.log (paquets Debian).
Par exemple, une erreur de frappe dans archive_command peut donner ces messages :
…ERROR: invalid value for parameter “archive_command”: “rsync % p /archives/%f” …DETAIL: String contains unexpected placeholder “% “. …WARNING: archiving write-ahead log file “0000000100000000000000C5” failed too many times, will try again later
La vue pg_stat_archiver doit indiquer que les erreurs d’archivage sont plus anciennes que les succès, comme ci-dessous. pg_switch_wal() peut aider à forcer un archivage si l’activité est trop faible.
0/CC1232A8
-[ RECORD 1 ]——+—————————–archived_count
last_archived_wal
last_failed_wal
last_failed_time
En parallèle, lancer une nouvelle sauvegarde avec pg_basebackup au format plain (non compressé).
En tant que postgres :
1586078/1586078 kB (100%), 1/1 tablespace
La taille de la sauvegarde sera bien sûr nettement plus grosse qu’en tar compressé.
Utiliser pg_verify_backup pour contrôler l’intégrité de la sauvegarde.
Si tout va bien, le message sera lapidaire :
backup successfully verified
S’il y a un problème, des messages de ce genre apparaîtront : pg_verifybackup: error: “global/TEST” is present on disk but not in the manifest pg_verifybackup: error: “global/2671” is present in the manifest but not on disk pg_verifybackup: error: “postgresql.conf” has size 29507 on disk but size 29506 in the manifest
À quoi correspond le fichier finissant par .backup dans les archives?
En effet, parmi les journaux archivés, figure ce fichier : ls -1 /archives
… 000000010000000100000003 000000010000000100000003.00D75CA8.backup 000000010000000100000004 …
Son contenu correspond au futur backup_label :
START WAL LOCATION: 1/3D75CA8 (file 000000010000000100000003)
BACKUP METHOD: streamed BACKUP FROM: primary START TIME: 2026-09-04 19:38:34 CEST LABEL: pg_basebackup base backup START TIMELINE: 1
Arrêter pgbench et noter la date des dernières données insérées.
max
2026-09-04 19:42:17.531995
Effacer le PGDATA; Restaurer la sauvegarde précédente sans les journaux ; Configurer la restore_command ; Créer le fichier recovery.signal ; Démarrer PostgreSQL.
- La sauvegarde étant au format plain, il s’agit d’une simple copie de fichiers. En tant que postgres :
- Si ça n’a pas déjà été fait, paramétrer la restore_command en sens inverse de l’ archive_command dans postgresql.conf , éventuellement postgresql.auto.conf .
(Un cp aurait pu convenir aussi.)
- Créer le fichier recovery.signal :
- Démarrer le service :
Vérifier les traces, ainsi que les données restaurées une fois le service démarré.
Les traces sont plus complexes à cause de la restauration depuis les archives :
tail -F /var/lib/pgsql/18/data/log/postgresql-Mon.log
… … LOG: database system was interrupted; last known up at 2026-09-04 19:40:40 CEST … LOG: creating missing WAL directory “pg_wal/archive_status” … LOG: creating missing WAL directory “pg_wal/summaries”
PostgreSQL s’est aperçu que ces fichiers n’avaient pas été restaurées de l’archive.
directory (2)
at main.c(1327) [sender=3.2.5] … LOG: starting backup recovery with redo LSN 1/3D75CA8, checkpoint LSN 1/4E03970, on timeline ID 1
Les messages d’erreur de rsyncne sont pas inquiétants : celui-ci ne trouve simplement pas les fichiers demandés par la restore_command . PostgreSQL sait ainsi qu’il n’y a pas de fichier 00000002.history et donc pas de timeline de ce numéro. Il devine plus loin qu’il a restauré tous les journaux quand la récupération de l’un d’entre eux échoue. Les erreurs sur les fichiers 00000001.history et 00000002.history sont normales. PostgreSQL cherche ces fichiers pour voir quel est l’enchaînement des timelines et quelle est la dernière. Puis il restaure les premiers journaux : … LOG: restored log file “000000010000000100000004” from archive … LOG: restored log file “000000010000000100000003” from archive … LOG: starting archive recovery … LOG: redo starts at 1/3D75CA8 … … … LOG: restored log file “00000001000000010000001B” from archive … LOG: redo in progress, elapsed time: 10.20 s, current LSN: 1/1AFE9938 … … LOG: redo in progress, elapsed time: 20.32 s, current LSN: 1/2FFEB818 … … … LOG: restored log file “000000010000000100000041” from archive … LOG: restartpoint starting: wal … LOG: restored log file “000000010000000100000042” from archive … LOG: redo in progress, elapsed time: 30.20 s, current LSN: 1/41FF2AC8 … … … LOG: restored log file “00000001000000010000004F” from archive … LOG: restored log file “000000010000000100000050” from archive … LOG: completed backup recovery with redo LSN 1/3D75CA8 and end LSN 1/4FE2B368 … LOG: consistent recovery state reached at 1/4FE2B368 … LOG: database system is ready to accept read-only connections
contenait 00000001000000010000004Fl’enregistrement (comme BACKUP_END lerévélerait pg_waldump ). À ce stade, la base est cohérente et utilisable.
Les journaux suivants ont été générés pendant la sauvegarde et sont restaurés jusqu’à épuisement : … LOG: restored log file “000000010000000100000051” from archive … … … LOG: restored log file “000000010000000100000070” from archive
or directory (2)
at main.c(1327) [sender=3.2.5]
or directory (2)
at main.c(1327) [sender=3.2.5] … LOG: redo done at 1/706EF970 system usage: CPU: user: 6.26 s, system: 5.25 s, elapsed: 52.45 s … LOG: last completed transaction was at log time 2026-09-04 19:42:43.073467+02 … LOG: restored log file “000000010000000100000070” from archive
directory (2)
at main.c(1327) [sender=3.2.5] … LOG: selected new timeline ID: 2 … … LOG: archive recovery complete … LOG: restartpoint complete: wrote 2073 buffers (12.7%), wrote 6 SLRU buffers; 0 WAL file(s) added, 13 removed, 20 recycled; write=5.397 s, sync=2.311 s, total=7.987 s; sync files=20, longest=1.512 s, average=0.116 s; distance=540672 kB, estimate=540672 kB; lsn=1/63141140, redo lsn=1/45022D00 … LOG: recovery restart point at 1/45022D00 … DETAIL: Last completed transaction was at log time 2026-09-04 19:42:43.073467+02. … … LOG:
… LOG:
file(s) added, 0 removed, 44 recycled; write=0.291 s, sync=0.995 s, total=1.543 s; sync files=12, longest=0.971 s, average=0.083 s; distance=720756 kB, estimate=720756 kB; lsn=1/71000028, redo lsn=1/71000028 … LOG: database system is ready to accept connections
Les dernières lignes montrent une dernière recherche de fichiers d’historiques qui auraient pu apparaître entre temps. Il n’y a plus rien à suivre. Il y a bascule sur une nouvelle timeline, et un checkpoint. Noter que les journaux portent bien une nouvelle timeline numérotée 2 : ls -l /var/lib/pgsql/18/data/pg_wal/
… -rw——-. 1 postgres postgres 17777217 Jan 5 18:43 000000020000000100000023 -rw——-. 1 postgres postgres 17777217 Jan 5 18:43 000000020000000100000024 -rw——-. 1 postgres postgres 42 Jan 5 18:43 00000002.history drwx——. 2 postgres postgres 35 Jan 5 18:43 archive_status
Vérifier quelles données ont été restaurées.
Cette fois, toutes les données générées après la sauvegarde ont bien été récupérées :
max
2026-09-04 19:42:17.531995