4 Sauvegarde PITR avec pgBackRest
Sauvegarde PITR avec pgBackRest
Le texte complet décrit pgBackRest, sa configuration, ses dépôts, sa supervision et le TP avec solution. Les références au PITR renvoient au chapitre 2.
4/ Sauvegarde PITR avec pgBackRest
4.1 PgBackRest
4.1.1 PgBackRest - Présentation générale
- David Steele (Crunchy Data)
- Langage : C
- Licence : MIT (libre)
- Type d’interface : CLI (ligne de commande)
4.1.2 PgBackRest - Fonctionnalités
- Gère la sauvegarde et la restauration PITR
- pull ou push, multidépôts
- mono- ou multiserveur
- Indépendant des commandes système
- protocole dédié
- Sauvegardes complètes, différentielles ou incrémentales
- Compression, multi-dépôts
- Multithread, sauvegarde depuis un secondaire, archivage asynchrone…
- Projet mature
pgBackRest 1 est un outil de gestion de sauvegardes PITR écrit en C, par David Steele. Le code source 2 est sous licence MIT. Il met l’accent sur les performances avec de gros volumes et les fonctionnalités, au prix d’une complexité à la configuration :
- Source 1 : https://pgbackrest.org/
- Source 2 : https://github.com/pgbackrest/pgbackrest
- un protocole dédié pour le transfert et la compression des données ;
- des opérations parallélisables en multithread;
- la possibilité de réaliser des sauvegardes complètes, différentielles et incrémentales selon les besoins et contraintes de durées;
- la possibilité d’archiver ou restaurer les WAL de façon asynchrone, et donc plus rapide;
- la possibilité d’abandonner l’archivage en cas d’accumulation et de risque de saturation de pg_wal ;
- la gestion de dépôts de sauvegarde multiples (pour sécuriser, ou avoir plusieurs niveaux d’archives);
- le support intégré de dépôts S3 ou Azure;
- le support d’un accès TLS géré par pgBackRest en alternative à SSH;
- la sauvegarde depuis un serveur secondaire;
- le chiffrement des sauvegardes;
- la restauration en mode delta, très pratique pour restaurer un serveur qui a décroché mais n’a que peu divergé;
- la reprise d’une sauvegarde échouée.
pgBackRest n’utilise pas pg_receivewal pour garantir la sauvegarde du dernier journal (non terminé) avant un sinistre. Les auteurs considèrent que dans ce cas un secondaire synchrone est plus adapté et plus fiable.
Le projet est très actif et considéré comme fiable, et les fonctionnalités proposées sont intéressantes.
Pour la supervision de l’outil, une sonde Nagios est fournie par un des développeurs : check_pgbackrest 3 .
4.1.3 PgBackRest - Sauvegardes
- Type de sauvegarde : physique/PITR (à chaud)
- Type de stockage : local, push ou pull
- Planification : crontab (ou autre)
- Compression des WAL
pgBackRest gère uniquement des sauvegardes physiques.
La technique utilisée pour la sauvegarde repose sur le mécanisme interne standard et historique :
avec de nombreux contrôles et optimisations.
L’archivage des journaux se fait bien sûr en permanence et utilise le paramètre classique
- Source 3 : https://github.com/pgstef/check_pgbackrest/
4.1.4 PgBackRest - Sauvegardes « push »
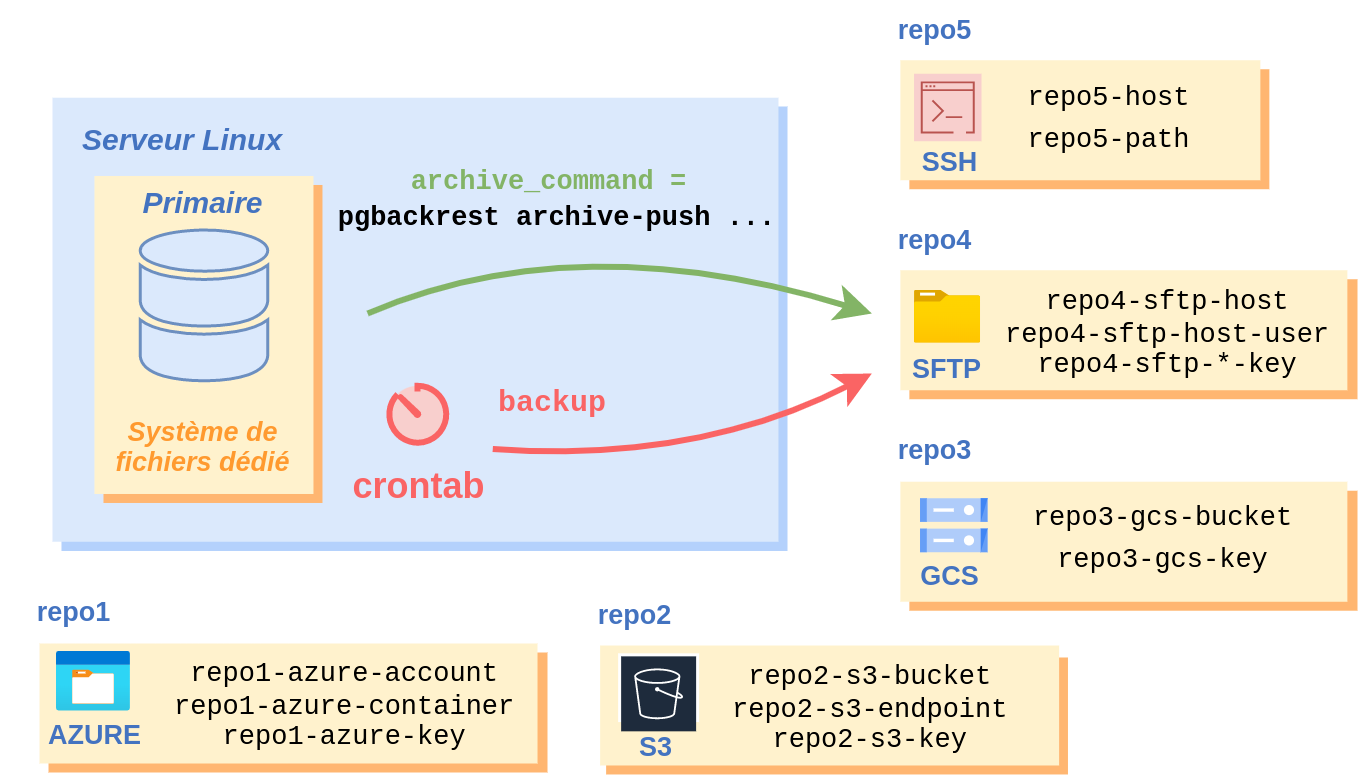
Le serveur « pousse » sauvegardes & archives
Et les « tire » lors d’une restauration
La sauvegarde s’effectue soit en local (push), soit vers un serveur distant (push) Dans le cas du push, la cible est :
soit un stockage local des sauvegardes (à déconseiller si c’est le seul dépôt, car la sauvegarde ne doit pas être au même endroit que la base) ;
soit un montage réseau, généralement NFS, parfois CIFS;
soit un dépôt externe accessible par les protocoles SFTP 4 , S3 ou compatible 5 , Azure 6 , GCS 7 . La planification des sauvegardes peut être faite par n’importe quel outil de planification de tâches, le plus connu étant cron .
Source 4 : https://pgbackrest.org/configuration.html#section-repository/option-repo-sftp-host
Source 5 : https://pgbackrest.org/configuration.html#section-repository/option-repo-s3-bucket
Source 6 : https://pgbackrest.org/configuration.html#section-repository/option-repo-azure-account
Source 7 : https://pgbackrest.org/configuration.html#section-repository/option-repo-gcs-bucket
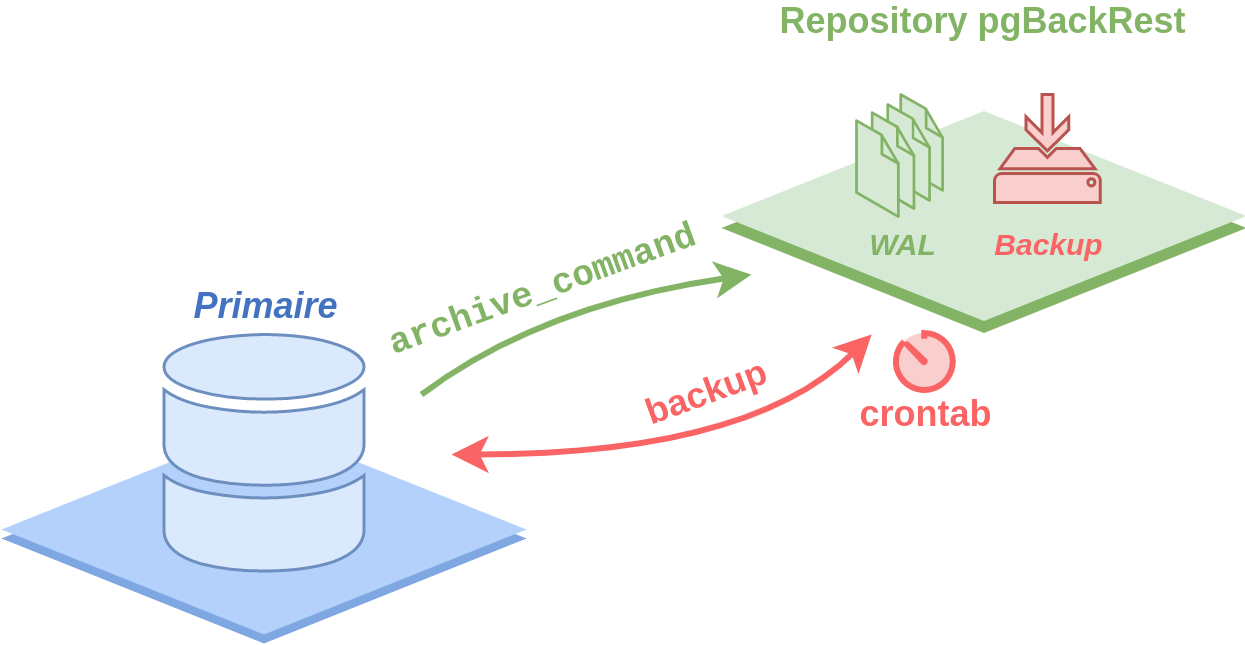
La sauvegarde (ordre pgbackrest backup ), la restauration ( pgbackrest restore ), et l’archivage ( pgbackrest archive-push dans l’ archive_command ) se font depuis le serveur PostgreSQL, en général le primaire.
4.1.5 PgBackRest - Sauvegardes « pull »
Le serveur de sauvegarde « tire » les sauvegardes
L’archivage reste en « push »
Restauration depuis le serveur PostgreSQL
Dans le cas du pull, la cible est un serveur de sauvegarde séparé. La configuration des accès doit être faite dans les deux sens entre le serveur PostgreSQL et ce serveur de sauvegarde, que ce soit en SSH ou en TLS. Les sauvegardes (ordre pgbackrest backup ) s’effectuent depuis ce serveur de sauvegarde. La planification des sauvegardes peut être faite par n’importe quel outil de planification de tâches, le plus connu étant cron . L’archivage ( pgbackrest archive-push dans l’ archive_command ) continue de se faire en mode push depuis le primaire PostgreSQL généralement. La restauration ( pgbackrest restore ) s’effectue toujours sur le serveur PostgreSQL à restaurer.
4.1.6 PgBackRest - Restauration
- Exécutée sur le serveur de BDD (pull)
- où que soit le serveur
- Point dans le temps :
- date
- identifiant de transaction
- timeline
- point de restauration ( pg_create_restore_point() )
- pgBackrest copie et prépare
- PostgreSQL fait la restauration
La restauration d’une sauvegarde peut se faire soit localement, si les sauvegardes sont stockées en local, soit à distance. Dans ce dernier cas, les données à restaurer sont récupérées via S3, SSH… selon le dépôt. Si l’on remonte assez loin dans le temps, pgBackRest sait généralement repérer la sauvegarde à réinstaller. Il modifie le fichier postgresql.auto.conf , en paramètrant notamment la restore_command . La est également un appel à pgBackRest (ordre
Par défaut, pgBackRest prévoit de restaurer tous les journaux qu’il a archivé. Mais comme dans toute sauvegarde PITR, plusieurs types de points dans le temps peuvent être utilisés comme cible de restauration :
- la date;
- un identifiant de transaction;
- une timeline;
- un point de restauration créé par un appel préalable à la fonction pg_create_restore_point() , par exemple avant un batch de nuit ou une migration.
4.1.7 PgBackRest - Installation
- Accéder au dépôt communautaire PGDG
- paquet pgbackrest
- Même version sur :
- tous les serveurs PostgreSQL
- celui de backup
- Mises à jour assez fréquentes
- les appliquer rapidement
pgBackRest est disponible sur le dépôt communautaire maintenu par la communauté PostgreSQL pour les systèmes d’exploitation disposant des gestionnaires de paquets au format deb (Debian, Ubuntu…) 8 ou rpm (Red Hat, Rocky Linux, CentOS, Fedora…) 9 . Il est recommandé de manière générale de privilégier une installation à partir de ces paquets plutôt que par les sources, essentiellement pour des raisons de maintenance. pgBackRest doit être installé :
- sur le serveur d’où PostgreSQL archive ses journaux (presque toujours le serveur primaire);
- sur les serveurs où PostgreSQL peut être restauré
- serveurs primaire et secondaires
- serveurs de test ou développement copies physiques de la production (attention à la configuration pour éviter un conflit dans les sauvegardes avec la production);
- sur le ou les serveurs de sauvegarde si séparés. Un inconvénient de l’outil est que les fichiers de configuration sont indépendants entre les différentes machines. Ils n’ont pas à être strictement identiques, même si c’est conseillé. C’est au DBA de conserver synchrones les parties importantes.
Il est impératif que les versions de pgBackRest soient les mêmes sur toutes les machines. Sinon, pgBackRest tombera en erreur.
Si un serveur de sauvegardes est utilisé, la mise à jour de sa version de pgBackRest implique donc la mise à jour de l’outil sur les serveurs PostgreSQL, sauf à gérer soi-même plusieurs versions différentes sans les paquets, ce qui n’est pas conseillé. Les mises à jour de pgBackRest sont assez fréquentes (tous les deux ou trois mois au moins), sans calendrier prévisionnel. Elles apportent parfois des fonctionnalités, et corrigent des bugs. L’application rapide des nouvelles versions est généralement conseillée.
- Source 8 : https://apt.postgresql.org/pub/repos/apt/
- Source 9 : https://yum.postgresql.org/
4.1.8 PgBackRest - Utilisation
Usage:
pgBackRest n’a qu’un seul exécutable. Il possède différentes commandes en argument selon l’action voulue : archivage ou restauration de journaux, sauvegardes, restauration, expiration de sauvegardes, vérifications, gestion des dépôts des stanzas, etc… Ces différentes commandes seront détaillées ultérieurement.
4.1.9 PgBackRest - Stanza
- Stanza = instance répartie dans un cluster (groupe de serveurs)
- la même pour primaire & secondaire
- Ex : erp_prod , dwh
- sans n° de version
Pour désigner les instances à sauvegarder, pgBackRest repose sur la notion de « stanza ». Il s’agit de la configuration comprenant une instance PostgreSQL avec ses différentes bases de données (cluster en terminologie PostgreSQL), réparties sur plusieurs serveurs primaire et secondaires (cluster au sens de « grappe »). La stanza est l’unité de sauvegarde et restauration de pgBackRest. Une stanza est définie par son nom et ses accès à PostgreSQL (connexion, chemin des fichiers).
Un serveur primaire et ses secondaires abritent en général une seule stanza, avec le même nom de stanza dans leurs fichier de configuration, puisque l’instance primaire peut basculer ou être restaurée ou copiée sur n’importe lequel de ces serveurs. Les différentes bases de données d’une instance sont bien sûr dans la même stanza, et sont archivées, sauvegardées et restaurées ensemble. S’il y a des serveurs secondaires, ne créez qu’une seule stanza pour le primaire et ses secondaires. S’il y a plusieurs instances sur un serveur, il faut leur créer des stanzas séparées. Le nom de la stanza est important et doit être significatif car il sera utilisé lors des tâches d’exploitation pour identifier le cluster cible. Ne nommez pas une stanza d’après le nom du serveur hébergeant le primaire, mais plutôt selon le nom fonctionnel de l’instance : erp_prod , dwh_europe … Le numéro de version de PostgreSQL est à proscrire car une stanza peut être conservée après une migration majeure. On ne peut pas renommer une stanza après sa création. Une instance PostgreSQL restaurée physiquement depuis sa sauvegarde peut continuer à sauvegarder et archiver ses journaux dans la même stanza. Les mécanismes de PostgreSQL s’occupent de gérer les timelines dans un même dépôt. Un serveur de sauvegardes peut héberger plusieurs stanzas, de versions majeures différentes. Chacune doit être déclarée dans la configuration de pgBackRest sur le serveur. Chaque stanza a ses répertoires de données, et doit être sauvegardée/purgée séparément.
4.1.10 PgBackRest - Emplacement des fichiers de configuration
- /etc/pgbackrest/pgbackrest.conf
- /etc/pgbackrest.conf
- pgbackrest –config=…
- /etc/pgbackrest/conf.d/*.conf
- pgbackrest –config-include-path=…
Le fichier de configuration est de type INI. pgBackRest le cherche dans /etc/pgbackrest/pgbackrest.conf ; à défaut il regarde aussi
Pour faciliter la maintenance et la lisibilité, la configuration peut être éclatée dans des fichiers *.conf dans /etc/pgbackrest/conf.d , ou un autre chemin à préciser par –config-include-path .
4.1.11 PgBackRest - Sections
[global:archive-push] , [global:archive-get]
- Stanzas :
- [nomstanza1]
- [nomstanza2] …
- Surcharges :
- entre sections
- en CLI par –nom-option
La section [global] liste les paramètres de configuration globaux. Les stanzas suivent, chacune dans une section à son nom. Il n’y en aura en général qu’une sur un serveur PostgreSQL, mais plusieurs sur un serveur de sauvegardes. Elles peuvent surcharger certains des paramètres précédents. Exemple de début de configuration sur un serveur hébergeant 3 instances à sauvegarder :
[erp_prod]
[crm_prod]
[referentiel]
Nous verrons que l’on peut ajouter des sections dédiées à une fonctionnalité, notamment [global:archive-push] , [global:archive-get] pour adapter la configuration de l’archivage et de la récupération des journaux. pgBackRest permet aussi de surcharger en ligne de commande. Par exemple, si la configuration contient start-fast=y , il est possible de changer cette valeur en l’ajoutant à la ligne de commande ainsi :
Dans les traces de pgBackRest (ou de PostgreSQL pour l’archivage), on trouvera souvent toutes les options utilisées. Par exemple pour une commande d’archivage, dans les traces de pgBackRest : ——————-PROCESS START——————- 2026-08-25 14:22:42.960 P00 INFO: archive-push:async command begin 2.59.1: [/var/lib/postgresql/17/main/pg_wal] –archive-async –archive-push-queue-max=10GB –compress-level=1 –compress-type=zst –exec-id=2713036-a79b88a0 –log-level-console=off –log-level-file=detail –log-level-stderr=off –log-path=/var/log/pgbackrest –pg1-path=/var/lib/postgresql/17/main –process-max=3 –repo1-host=srvbak1 –repo2-host=srvbak2 –repo1-host-config=/etc/pgbackrest/pgbackrest.conf –repo1-host-type=ssh –repo2-host-type=ssh –repo1-host-user=postgres –repo2-host-user=postgres –repo2-path=/home/postgres_backups/depot2 –spool-path=/var/spool/pgbackrest –stanza=prod
4.1.12 PgBackRest - Configuration PostgreSQL : archivage
- postgresql.conf
Comme d’habitude, il est nécessaire d’activer l’archivage des journaux de transactions en positionnant le paramètre archive_mode à on . wal_level (le niveau d’enregistrement d’informations
dans les journaux de transactions) est normalement déjà au moins à replica (il ne doit pas être à minimal ).
La commande d’archivage est fournie par pgBackRest, et n’a généralement besoin que de la stanza :
Au besoin ajouter –config=/chemin/vers/pgbackrest.conf .
Comme pgBackRest n’archive que des journaux complets, il vaut mieux penser à mettre un archive_timeout adapté au RPO accepté, pour forcer un archivage au moins toutes les quelques minutes. Si le RPO est nul (aucune perte de données enregistrées n’est admissible), les auteurs recommandent d’utiliser un secondaire synchrone 10 .
4.1.13 PgBackRest - Configuration globale
- Dans pgbackrest.conf :
De nombreux paramètres 11 sont disponibles. Citons les principaux.
4.1.13.1 Repo1-path
Les paramètres commençant par repo1- traitent du premier serveur de sauvegardes (appelé dépôt de sauvegardes). S’il y en a un deuxième, ce sera repo2-* , etc.
Dans le cas simple d’un montage en local (disque local ou NFS notamment), repo1-path est juste le chemin où seront stockées les sauvegardes et les journaux archivés. Nous verrons plus loin les dépôts distants et la rétention. Parmi les paramètres liés à un dépôt, citons par exemple repo1-cipher-pass (passphrase à utiliser pour chiffrer/déchiffrer le répertoire des sauvegardes).
- Source 10 : https://github.com/pgbackrest/pgbackrest/issues/2233#issuecomment-1831406999
- Source 11 : https://pgbackrest.org/configuration.html
4.1.13.2 Process-max
C’est le nombre de processus maximum à utiliser pour la compression, la copie et la décompression des sauvegardes. Pour profiter aussi du parallélisme dans l’archivage ou la restauration des journaux, il faudra également activer le mode asynchrone ( archive-async=y ). Ce paramètre est souvent surchargé plus loin suivant la tâche ou la stanza.
4.1.13.3 Traces
log-level-console et log-level-file , par défaut à warn et info , définissent respectivement le niveau de traces des commandes dans le terminal et le niveau stocké dans le fichier de traces. Il est conseillé d’être assez verbeux (au moins info , et même detail , voire debug ).
4.1.14 PgBackRest - Exemples de déclaration de dépôts
Ci-dessus figurent les déclarations de trois dépôts différents. Il est possible d’en déclarer plusieurs, même si la plupart du temps un seul suffit. Chaque type de dépôt possède différents paramètres décrits dans la documentation 12 .
4.1.15 PgBackRest - Rétention
- Type de rétention des sauvegardes complètes
- Nombre de sauvegardes complètes
- Nombre de sauvegardes différentielles
- Expiration sur demande :
4.1.15.1 Type de rétention
L’option repo1-retention-full-type permet de configurer la politique de rétention des sauvegardes complètes. Elle peut prendre deux valeurs :
- count : nombre de sauvegardes à conserver (valeur par défaut);
- time : nombre de jours pendant lequel on doit pouvoir restaurer, c’est-à-dire que l’on doit avoir au moins une sauvegarde plus vieille que ce nombre de jours.
4.1.15.2 Exemple de rétention par le nombre
Une configuration classique pour une sauvegarde complète (full), lancée une fois par semaine, avec une rétention d’un mois, et des sauvegardes différentielles (diff ) quotidiennes dont on ne veut garder que deux, est :
Si une cinquième sauvegarde full est faite avec succès, la plus ancienne est supprimée, avec les différentielles et incrémentales qui en dépendent.
Le maximum de deux sauvegardes différentielles est global, parmi toutes celles dépendant de sauvegardes complètes différentes. La plus ancienne est au besoin supprimée.
4.1.15.3 Rétention selon le temps
Voici un exemple pour illustrer le mode de rétention time , dont le fonctionnement n’est pas très intuitif. Si l’on dispose des trois sauvegardes complètes suivantes :
- F1 : 25 jours;
- F2 : 20 jours;
- F3 : 10 jours.
Avec une rétention de 15 jours, seule la sauvegarde F1 sera supprimée. F2 sera conservée, car il doit exister au moins une sauvegarde de plus de 15 jours pour garantir de pouvoir restaurer pendant cette période.
Par contre, la rétention pour les sauvegardes différentielles ne peut être définie qu’en nombre.
4.1.15.4 Sauvegardes incrémentales
Les sauvegardes incrémentales ne peuvent avoir une rétention, car, dès qu’il y en a deux à la suite, la dernière dépend de celles d’avant.
Elles disparaissent avec les sauvegardes différentielles et complètes dont elles dépendent.
4.1.15.5 Expiration des sauvegardes et journaux
La suppression des plus anciennes sauvegardes n’a lieu qu’en cas de succès d’une nouvelle sauvegarde.
Lorsqu’une sauvegarde complète expire, toutes les sauvegardes différentielles et incrémentales qui en dépendent disparaissent également.
Les journaux devenus inutiles, car ne dépendant plus d’aucune sauvegarde, sont aussi effacés.
4.1.15.6 Expiration sur demande
Pour faire de la place, on peut supprimer une sauvegarde précise (full ou différentielle) en la précisant avec –set (le code peut se trouver avec pgbackrest info ). L’alternative –oldest désigne la plus vieille sauvegarde full du dépôt. Exemples :
Dans tous les cas, pgBackRest exige de conserver au moins une sauvegarde full par dépôt.
4.1.16 PgBackRest - Accès au dépôt par SSH
- Échange des clés SSH entre instances ( postgres ) & le dépôt
- Accès depuis serveurs PostgreSQL au serveur de sauvegarde :
- Accès depuis le serveur de sauvegardes aux instances : … [nomstanza]
Si le stockage des sauvegardes se fait sur un serveur tiers, pgBackRest peut accéder au dépôt par SSH depuis l’instance, pour archiver les journaux ou restaurer une sauvegarde ou les journaux. Le serveur de sauvegardes, à l’inverse, sera celui où la sauvegarde sera exécutée. Il aura besoin de se connecter par SSH au serveur d’où seront copiés les fichiers de données (souvent le primaire, mais ce peut être un secondaire). Il a également besoin d’une connexion par SSH au serveur primaire lors d’une sauvegarde (au moins pour déclencher des archivages et pg_backup_start() ). Il faut donc une authentification SSH par clé sans mot de passe, et un échange des clés publiques entre les différents serveurs hébergeant toutes les instances PostgreSQL des différentes stanzas et le serveur de sauvegarde.
- Sur les serveurs PostgreSQL : adapter les paramètres
repo1-host*dans la configuration de pgBackRest pour accéder au serveur :
Il existe plusieurs paramètres 13 pour utiliser des certificats, ou indiquer un chemin spécifique du binaire pgbackrest, etc.
- Sur le serveur de sauvegardes, pour une connexion au primaire :
4.1.17 PgBackRest - Configuration TLS
Alternative au SSH :
- {repo1|pg1}-host-type = tls
- Certificats à fournir
- Service dédié sur serveurs PG et serveur de sauvegardes
Il existe une alternative à l’utilisation de SSH : l’activation d’un service pgbackrest accessible par TLS sur le serveur de sauvegarde et les serveurs PostgreSQL. L’intérêt est de ne plus dépendre de SSH. Il n’y a plus qu’un service géré intégralement par pgBackRest. Le paramétrage est décrit complètement dans la base de connaissance Dalibo 14 . En résumé :
- La fonctionalité s’active avec repo1-host-type=tls , pg1-host-type=tls (et non ssh ). tls (défaut : ssh )
- La configuration du serveur sur chaque machine se fait ensuite avec les paramètres tls-* : IP d’écoute, clients autorisés, certificats (à générer ou faire générer);
- Des certificats doivent aussi être rensignés pour repo1-* et pg1-* .
- Un service systemd dédié doit être lancé sur chaque machine.
4.1.18 PgBackRest - Configuration par stanza
[erp_prod]
Chaque section [stanza] , sur un serveur PostgreSQL ou un serveur de backup définit :
- Source 14 : https://kb.dalibo.com/sauvegardes/pitr/pgbackrest/pgbackrest/#une-alternative-au-ssh-tls
- pg1-path : l’emplacement du répertoire de données sur le serveur;
- pg1-port , pg1-database , pg1-socket-path : le port, l’utilisateur ou la socket locale pour se connecter (si pas ceux par défaut).
Sur un serveur de backup, on aura aussi dans chaque [stanza] :
- pg1-host , pg1-host-port , pg1-host-user pour les accès SSH
- éventuellement, des champs pour les certificats SSL;
- alternativement, une configuration tls .
D’autres paramètres 15 existent, par exemple pour le chemin de la configuration ou de l’exécutable.
Chaque configuration de la partie globale peut être surchargée par stanza .
Il est également possible d’ajouter ici des recovery-option afin de personnaliser les options du postgresql.auto.conf qui sera généré automatiquement à la restauration d’une sauvegarde.
4.1.19 PgBackRest - Initialiser le répertoire de stockage
- Initialisation par stanza :
- Vérification :
La commande d’initialisation doit être lancée sur le serveur où se situe le répertoire de stockage après que la stanza ait été configurée dans pgbackrest.conf .
La commande check valide que pgBackRest et le paramètre archive_command sont correctement configurés. Les commandes pg_create_restore_point(‘pgBackRest Archive Check’) et
pgBackRest vérifie qu’il arrive bien dans le dépôt.
4.1.20 PgBackRest - Effectuer une sauvegarde
- Déclencher une nouvelle sauvegarde :
- –type=full , –type=diff , –type=incr
- La plupart des paramètres peuvent être surchargés
La sauvegarde est lancée depuis le serveur de sauvegarde s’il existe. Si le serveur PostgreSQL a accès à celui-ci directement (montage NFS…), on peut lancer la sauvegarde depuis celui-ci.
Exemple de sortie d’une sauvegarde complète :
P00 INFO: backup command begin 2.19: –log-level-console=info
P00 INFO: execute non-exclusive pg_start_backup() with label “pgBackRest backup started at 2019-11-26 12:39:26”: backup begins after the next regular checkpoint completes P00 INFO: backup start archive = 000000010000000000000005, lsn = 0/5000028 P00 INFO: full backup size = 24.2MB P00 INFO: execute non-exclusive pg_stop_backup() and wait for all WAL segments to archive P00 INFO: backup stop archive = 000000010000000000000005, lsn = 0/5000100 P00 INFO: new backup label = 20191126-123926F P00 INFO: backup command end: completed successfully P00 INFO: expire command begin 2.19: –log-level-console=info
P00 INFO: expire full backup 20191126-123848F P00 INFO: remove expired backup 20191126-123848F P00 INFO: expire command end: completed successfully
pgBackRest va alors :
- se connecter au primaire et appeler pg_backup_start() ;
- déclencher un checkpoint (si start-fast=y ), ou en attendre un ;
- déclencher un archivage, et vérifier que le journal arrive dans le dépôt dans un temps raisonnable (30 s par défaut) (ce qui implique que l’ archive_command fonctionne);
- copier les fichiers;
- appeler pg_backup_stop() ;
- attendre que tous les journaux nécessaires soient archivés (ceux générés pendant la sauvegarde);
- supprimer les anciennes sauvegardes selon les règles de rétention.
4.1.20.1 Types de sauvegarde
Les sauvegardes complètes ( –type=full ) sont une copie des fichiers de données. Une copie complète ne dépend d’aucune autre. Les sauvegardes différentielles ( –type=diff ) ne contiennent que les différences par rapport à la sauvegarde commplète précédente. Elles sont donc en général plus petites et rapides à réaliser qu’une complète, mais chaque nouvelle sauvegarde différentielle est plus grosse que la précédente au fur et à mesure que la dernière complète est ancienne. Une sauvegarde différentielle disparaît si la sauvegarde complète précédente disparaît. Les sauvegardes incrémentales ( –type=incr ) ne contiennent que les différences par rapport à la dernière sauvegarde, quelle qu’elle soit. En général, elles seront donc plus petites que des différentielles, mais on ne peut supprimer une sauvegarde incrémentale sans supprimer les incrémentales suivantes, qui en dépendent.
Il est très fréquent d’effectuer une sauvegarde full le week-end, et des diff , parfois des incr chaque jour de la semaine. Mais les volumétries de chaque type de sauvegarde dépendent beaucoup de la proportion de la base mise à jour chaque jour, et si l’on met souvent à jour les mêmes données.
La commande backup se charge automatiquement de supprimer les sauvegardes devenues obsolètes, et celles qui en dépendent. Quant aux journaux, ils sont archivés en permanence, donc non inclus à proprement parler dans la sauvegarde. Par défaut, tous les journaux depuis le début de la plus ancienne sauvegarde conservée sont conservés. Ils permettent de restaurer la base telle qu’à n’importe quel moment entre la fin de ce plus ancien backup et le présent. (Des options existent pour purger des journaux intermédiaires entre des backups mais nous ne conseillons pas leur utilisation.)
4.1.21 PgBackRest - Autres options de sauvegardes
La sauvegarde accepte de très nombreux paramètres. Ils sont souvent dans pgbackrest.conf sous la forme ci-dessus. Cette liste reprend leur version en option de ligne de commande :
- –archive-copy : archive les WAL dans la sauvegarde en plus de les mettre dans le dépôt de WAL, pour garantir une sauvegarde cohérente (option « légèrement paranoïaque » selon la documentation de pgBackRest);
- –backup-standby : déclenche la sauvegarde depuis un serveur secondaire, qui assumera les entrées/sorties, mais l’archivage continuera à partir du primaire. La présence de l’instance secondaire peut être préférée ( prefer ) ou requise ( y ) ;
- –no-online : fait une sauvegarde à froid;
- –resume : reprend une sauvegarde précédemment arrêtée pour une raison ou une autre en conservant les fichiers qui n’ont pas changés (option activée par défaut, elle représente un gros avantage sur pg_basebackup);
- –start-fast : exécute un checkpoint dès le lancement du backup pour éviter d’attendre quelques minutes qu’il se déclenche ; l’activer pose rarement un souci ;
- –archive-timeout : ce délai règle le temps pendant lequel pgBackRest attend l’archivage des journaux nécessaires en fin de sauvegarde, avant de tomber en erreur : en effet, le défaut de 30 s peut être trop court si la sauvegarde a lieu à un moment où l’archivage a du mal à suivre. Il est possible d’ajouter des annotations aux sauvegardes comme ceci :
L’annotation peut être observé en affichant les informations du backup set.
4.1.22 PgBackRest - Lister les sauvegardes
- Lister les sauvegardes présentes et leur taille
- ou une sauvegarde spécifique (backup set)
Exemple de sortie des commandes :
4.1.23 PgBackRest - Dépôts multiples
- Plusieurs dépôts simultanés possibles, tous types
- sauvegarde & rétention indépendants
- archivage sur tous les dépôts (asynchrone conseillé!)
- –repo1-option=… , appel avec –repo=1
pgBackRest permet de maintenir plusieurs dépôts de sauvegarde simultanément 16 . Un intérêt est de gérer des rétentions différentes. Par exemple un dépôt local contiendra juste les dernières sauvegardes et journaux, alors qu’un deuxième dépôt sera sur un autre site plus lointain, éventuellement moins cher, et/ou une rétention supérieure. Les propriétés des différents dépôts (type, chemin, rétention…) se définissent avec les options repo1-path, repo2-path, etc. Par exemple, cette configuration définit un dépôt sur un montage NFS et un autre accessible par SSH, avec deux rétentions différentes :
Désigner un dépôt particulier sur la ligne de commande se fait avec –repo=1 , par exemple. Une sauvegarde se fait toujours vers un seul dépôt, explicitement désigné. De même pour une restauration. Cependant, l’archivage des journaux est simultané sur tous les dépôts à la fois.
L’archivage asynchrone est fortement conseillé dans ce cas pour paralléliser les accès, et éviter qu’un dépôt lent ralentisse la diffusion sur les autres!
Les types de dépôts supportés sont ceux montés sur le serveur ou accessibles par ssh, NFS (avec la même attention aux options de montage que pour PostgreSQL 17 ), CIFS (avec des restrictions sur les liens symboliques ou le fsync), mais aussi ceux à base de buckets : S3 ou compatible, Google Cloud, et Azure Blob. Pour les détails, voir la conférence de Stefan Fercot à la PGSession 14 de 2021 18 (slides 19 ).
- Source 17 : https://docs.postgresql.fr/current/creating-cluster.html#CREATING-CLUSTER-FILESYSTEM
- Source 18 : https://dali.bo/pgsession14_conf_pgbackrest
- Source 19 : https://pgsessions.com/assets/archives/pgs14_depots_sauvegarde_multiples_avec_pgBackRest.pdf
4.1.24 PgBackRest - Compression
Variantes possibles selon les différentes étapes :
pgBackRest permet de compresser différemment les sauvegardes complètes et les archives. Il n’est pas forcément conseillé de mélanger les algorithmes de compression comme ci-dessus, mais il est courant d’ajuster le taux de compression. En effet, une sauvegarde effectuée la nuit sur une serveur inactif peut prendre le temps (et les processeurs) pour compresser au maximum. L’archivage doit être le plus rapide possible, et ne peut mobiliser beaucoup de processeurs : le taux de compression peut se réduire dans [global:archive-push] , qui ne concerne que l’archivage. L’algorithme et le taux idéaux pour une installation dépendent des données et des contraintes en temps et place, c’est à tester au cas par cas.
4.1.25 PgBackRest - Mode asynchrone
Parallélisation de l’archivage/restauration :
- Gros gain en temps
PostgreSQL archive ou restaure les journaux un par un, en appelant l’ archive_command et en attendant qu’elle ait terminé. En cas de succès il passe au journal suivant; sinon il retente l’appel avec le même journal. Par défaut, pgBackRest travaille donc sur un journal à la fois, sur sa compression puis sur sa copie. Le mode asynchrone accélère les choses. Il s’active dans pgbackrest.conf avec :
pgBackrest sauvegarde (ou restaure) alors les WAL de manière asynchrone, sans suivre l’enchaînement strict des ordres de PostgreSQL, Il tente d’archiver de manière proactive les journaux qui suivent celui en cours d’archivage, et en utilisant plusieurs processus. Quand PostgreSQL demande à archiver les journaux suivants, pgBackrest peut lui répondre instantanément que c’est fait. Cette technique permet de paralléliser compression et téléchargement (upload) des journaux, au lieu de faire l’un puis l’autre pour chaque journal. À l’inverse, lors d’un rejeu après restauration, pgBackRest peut récupérer et décompresser plusieurs journaux simultanément. Il peut alors les fournir à PostgreSQL immédiatement quand celui-ci demande à les restaurer. Ce système est transparent pour PostgreSQL, qui travaille toujours journal par journal. Tout se passe dans le spool géré par pgBackRest ( spool-path ). L’archivage asynchrone des journaux ne crée que des fichiers vides dans ce répertoire, et pour la restauration une volumétrie de quelques gigaoctets suffit en pratique (paramètre archive-get-queue-max ). Il est possible de régler ce mécanisme, notamment en précisant le nombre de processus dans la clause [global:archive-get] . En effet, il vaut mieux ne pas être trop agressif sur la récupération des journaux, car le réseau limite souvent. Deux processus qui téléchargent et décompressent en parallèle permette déjà un très gros gain de temps au rejeu. La valeur de [global:archive-push] dépend du nombre de journaux à archiver, du taux de compression demandé, du nombre de dépôts, du nombre de processeurs disponibles, du délai tolérable pour archiver tous les journaux lors des pointes d’activité… Il faudra tester, et là aussi voir si le goulot d’étranglement n’est pas le réseau.
4.1.26 PgBackRest - Sécurité contre la saturation de pg_wal
- Abandon de l’archivage si trop de retard :
- Sauvegarde à relancer!
Le paramètre archive-push-queue-max permet d’abandonner l’archivage si le retard d’archivage dépasse le seuil indiqué. Cela permet de ne pas saturer la partition de pg_wal/ , et de provoquer l’arrêt de l’instance.
Quand cela arrive, pgBackRest ment à PostgreSQL en lui disant que les journaux en attente sont archivés. On ne pourra donc plus restaurer à un moment postérieur à cet événement, et une sauvegarde en cours à ce moment échouera. Des serveurs secondaires en log shipping sans streaming décrocheront, car ils ne recevront jamais une partie des journaux.
Ce paramètre protège la production, mais il faudra refaire une sauvegarde (complète, différentielle ou incrémentale) le plus vite possible ! (Sinon, la prochaine sauvegarde planifiée remettra la situation d’équerre.)
Évidemment cette situation doit rester exceptionnelle, mais peut permettre de ne pas faire échouer certains gros imports, par exemple. Il est conseillé d’utiliser la sonde check_pgbackrest 20 pour surveiller l’apparition de « trous » qui pourraient ainsi apparaître dans la suite des journaux archivés.
4.1.27 PgBackRest - Bundling et sauvegarde incrémentale en mode block
- Regrouper les petits fichiers dans des bundles
- Sauvegarde incrémentale en mode block (requiert le bundling)
« Bundling » des petits fichiers Si une instance contient de nombreux petits fichiers (base aux nombreuses toutes petites tables, rempli à cause de pg_commit_ts àon , très nombreuses petites track_commit_timestamp partitions, chacune avec des fichiers annexes…), il est possible de les regrouper par paquets.
Les bundles ne sont pas conservés en cas de backup interrompu puis redémarré. Les fichiers doivent être re-sauvegardés lors de la relance. Bundles et hard-links ne peuvent pas être utilisés ensemble. Cette fonctionnalité est particulièrement utile avec un stockage comme S3 où le coût de création de fichier est prohibitif. Sauvegarde incrémentale en mode bloc
- Source 20 : https://github.com/dalibo/check_pgbackrest
La sauvegarde incrémentale par bloc permet plus de granularité en divisant les fichiers en blocs qui peuvent être sauvegardés indépendamment. C’est particulièrement intéressant pour des fichiers avec peu de modifications, car pgBackRest ne sauvegardera que quelques blocs au lieu du fichier complet (les tables et index sont segmentés en fichiers de 1 Go). Cela permet donc d’économiser de l’espace dans le dépôt de sauvegarde et accélère les restaurations par delta. La sauvegarde incrémentale par bloc doit être activée sur tous les types de sauvegardes : full, incrémentielle ou différentielle. Cela aura pour impact de rendre la sauvegarde full un peu plus grosse du fait de la création de fichier de cartographie des blocs. En revanche, les sauvegardes différentielles et incrémentielles suivantes pourront utiliser cette cartographie pour économiser de l’espace. La taille du bloc pour un fichier donné est définie en fonction de l’âge et de la taille du fichier. Généralement, les fichiers les plus gros et/ou les plus anciens auront des tailles de bloc supérieures. Si un fichier est assez vieux, aucune cartographie ne sera crée. Cette fonctionnalité nécessite le bundling et s’active ainsi :
4.1.28 PgBackRest - Restauration : commande
- dans postgresql.auto.conf :
La commande pgbackrest restore se lance toujours sur le serveur où l’instance PostgreSQL doit être restaurée. pgbackrest.conf doit y être présent et correctement configuré, ou alors il faudra reprendre toutes les options en ligne de commande ( –repo1-path , –process-max , etc…)
Exemple de sortie :
Il vaut mieux prendre l’habitude de toujours préciser –pg1-path pour savoir ce qu’on va exactement écraser. C’est obligatoire si on resture sur un autre serveur dans un autre chemin.
Comme pour toute restauration PITR, pgBackRest ajoute un fichier recovery.signal et un fichier backup_label indiquant d’où redémarrer la restauration.
pgBackRest ajoute des lignes à la fin du postgresql.auto.conf dans le PGDATA restauré, au moins celle définissant la restore_command . Celle-ci appelle pgbackrest archive-get .
4.1.29 PgBackRest - Restauration : option
- Nombreuses options à la restauration, notamment :
- –delta (gros gain de temps parfois)
- –db-exclude / –db-include (ne restaure pas tout!)
- –archive_mode=off (sécurité)
- –target / –type
L’option –delta permet de ne restaurer que les fichiers qui seraient différents entre la sauvegarde et le répertoire de données déjà présent sur le serveur. Elle permet de gagner beaucoup de temps pour reprendre une restauration qui a été interrompue pour une raison ou une autre, pour resynchroniser une instance qui a récemment « décroché », ou pour restaurer une version de l’instance légèrement antérieure ou postérieure. Si une restauration en delta n’est pas possible, pgBackRest affiche un message et bascule sur une restauration normale.
--db-exclude nombase est un gros point fort de pgBackRest. D’habitude, une sauvegarde PITR restaure intégralement une instance. Les paramètres --db-exclude / --db-include permettent de définir quelles bases restaurer et lesquelles ne pas restaurer. Les bases négligées seront corrompues (fichiers vides) et devront être supprimées (DROP DATABASE baseperdue).
Ne pas utiliser ces options pour restaurer votre production! L’option ne doit servir qu’à restaurer sur une autre instance.
--archive_mode=off est une sécurité pour éviter qu’une instance copiée de la production ne se mette à archiver vers le dépôt d’origine si l’on oublie d’adapter la configuration avant.
La cible à restaurer peut être spécifiée avec –target , associé à –type . Nous allons voir plus bas des exemples.
Dans tous les cas, les options qui se trouvent dans pgbackrest.conf et en ligne de commande se retrouvent sous la forme de paramètres dans postgresql.auto.conf dans le PGDATA (qui surcharge ce que peut contenir postgresql.conf ).
4.1.30 PgBackRest - Exemple de restauration à une date précise
Par exemple, pour restaurer à une date précise sur une timeline précise, on utilisera --type=time et --target='…' pour l’heure.
Optionnellement, pour des cas un peu complexes où il y a eu plusieurs bascules et rejeux dans le passé récent, on peut préciser la timeline à suivre ( –target-timeline ) et la sauvegarde à utiliser (paramètre –set , où le nom de la sauvegarde se trouve avec pgbackrest info ). Dans postgresql.conf , on trouvera donc :
pgBackRest va notamment reconstruire la restore_command à partir des paramètres utilisés pour la restauration.
4.1.31 PgBackRest - Exemple de restauration d’un secondaire
- Ajoute recovery.signal , restore_command
- Pour streaming, dans pgbackrest.conf :
Avec –type=standby , on demande à pgBackRest de paramétrer l’instance restaurée comme un nouveau secondaire, ou pour restaurer un secondaire qui a décroché (auquel cas –delta sert souvent).
Si le chemin du répertoire de données est différent de celui du primaire, il faut le préciser avec pg1-path .
Un recovery.signal est créé dans l’instance restaurée pour que l’instance sache d’entrée qu’elle est un secondaire.
En général on veut ajouter la connexion par streaming. Il faut préciser dans pgbackrest.conf la chaîne de connexion comme dans l’exemple ci-dessus, ou la passer en ligne de commande avec --recovery-option=primary_conninfo='…'.
4.1.32 PgBackRest - Mises à jour
- Mise à jour de pgBackRest
- faire en même temps sur toutes les machines
- Mise à jour mineure de PostgreSQL
- transparent
- Mise à jour majeure de PostgreSQL ( pg_upgrade )
- mise à jour des chemins
- pgbackrest –stanza=… stanza-upgrade
Mettre à jour pgBackRest n’implique pas de mise à jour des dépôts. La seule contrainte est de mettre à jour l’outil sur toutes les machines concernées en même temps : serveurs PostgreSQL et serveurs de sauvegarde.
Une mise à jour mineure de PostgreSQL est transparente. Les serveurs primaire et secondaire n’ont même à être sur la même version, pgBackRest ne s’en occupe pas.
Une mise à jour majeure est plus complexe. Si c’est une mise à jour par restauration logique ( pg_dump / pg_restore ) ou réplication logique, les deux versions sont des instances totalement différentes qui doivent avoir leur propre stanza définie.
S’il s’agit d’une mise à jour avec pg_upgrade , après la mise à jour de PostgreSQL il faut :
- adapter les fichiers de configuration, car le chemin a souvent changé, parfois le port ;
- lancer la commande suivante pour que pgBackRest ne se plaigne pas que l’instance a changé :
Les backups de l’ancienne version de PostgreSQL restent utilisables si l’on veut revenir en arrière (préciser –set ) mais bien sûr il faudra créer une instance de la bonne version, et il ne sera pas possible de redérouler les journaux au-delà du moment de la migration.
4.1.33 PgBackRest - Traces
- /var/log/pgbackrest : par stanza+commandes
- NOMSTANZA-archive-push-async.log
- NOMSTANZA-backup.log
- NOMSTANZA-expire.log
- Sur serveur TLS :
- /var/log/pgbackrest/all-server.log
- log-level-console , log-level-file
Les traces de pgBackRest vont par défaut dans /var/log/pgbackrest. Le propriétaire est postgres. Il y a un fichier pour chaque stanza et chaque commande. On trouvera donc par exemple ceci :
Une exception : les traces d’un serveur accédé par TLS vont toutes dans le même fichier
serveur) qui y écrit. Rappelons que le niveau de verbosité est réglé par le paramètre log-level-file (à mettre si possible à DETAIL ).
4.1.34 PgBackRest - Conclusion
- Un outil de sauvegarde très puissant
- Nombreuses options
Sa puissance et ses nombreuses options font de pgBackRest l’outil préféré de sauvegarde de Dalibo. Cette puissance induit cependant une certaine complexité, et il ne faudra donc pas hésiter à tester y compris les restaurations bien sûr.
4.2 Quiz
4.3 Travaux pratiques
La version en ligne des solutions de ces TP est disponible sur https://dali.bo/i4_solutions.
4.3.1 Utilisation de pgBackRest (Optionnel)
But : Sauvegarder et restaurer avec pgBackRest.
Installer pgBackRest à partir des paquets du PGDG.
En vous aidant de https://pgbackrest.org/user-guide.html#quickstart :
- configurer pgBackRest pour sauvegarder le serveur PostgreSQL en local dans /var/lib/pgsql/backups ;
- le nom de la stanza sera instance_dev;
- prévoir de ne conserver qu’une seule sauvegarde complète.
Configurer l’archivage des journaux de transactions de PostgreSQL avec pgBackRest.
Initialiser le répertoire de stockage des sauvegardes et vérifier la configuration de l’archivage.
Lancer une sauvegarde complète. Afficher les détails de cette sauvegarde.
Ajouter des données :
- ajouter une table avec 1 million de lignes;
- forcer la rotation du journal de transaction courant ( pg_switch_wal ) pour s’assurer que les dernières modifications sont archivées;
- vérifier que le journal concerné est bien dans les archives.
Simulation d’un incident : noter l’heure puis supprimer tout le contenu de la table.
Restaurer les données telles que juste avant l’incident à l’aide de pgBackRest. Avant de redémarrer PostgreSQL, consulter les fichiers que pgBackRest a créé ou modifié dans le PGDATA. Redémarrer.
Vérifier les logs et la présence des données disparues.
4.4 Travaux pratiques (solutions)
4.4.1 Utilisation de pgBackRest
NB : Ce TP a été mis à jour pour PostgreSQL 17. Adapter le numéro de version dans les chemins au besoin.
Installer pgBackRest à partir des paquets du PGDG.
L’installation du paquet est triviale avec les paquets du PGDG :
En vous aidant de https://pgbackrest.org/user-guide.html#quickstart :
- configurer pgBackRest pour sauvegarder le serveur PostgreSQL en local dans
/var/lib/pgsql/backups; - le nom de la stanza sera
instance_dev; - prévoir de ne conserver qu’une seule sauvegarde complète.
Le ficher de configuration de pgBackRest est /etc/pgbackrest.conf. Le modifier ainsi :
Les chemins ci-dessus sont ceux par défaut des paquets RPM du PGDG. Sous Debian/Ubuntu, les données sont dans /var/lib/postgresql/17/main. Adapter les autres chemins en fonction.
Configurer l’archivage des journaux de transactions de PostgreSQL avec pgBackRest.
Le fichier de configuration de PostgreSQL doit être modifié au besoin ainsi :
Redémarrer PostgreSQL :
Initialiser le répertoire de stockage des sauvegardes et vérifier la configuration de l’archivage.
Sous l’utilisateur postgres :
Vérifier la configuration de pgBackRest et de l’archivage :
pgBackRest force ainsi un archivage :
Vérifier que l’archivage fonctionne en vérifiant que ce répertoire n’est pas vide :
On peut le vérifier aussi du côté PostgreSQL :
Autre méthode, regarder le nom du processus archiver, qui contient le nom du dernier journal archivé :
Lancer une sauvegarde complète. Afficher les détails de cette sauvegarde.
Noter le soin avec lequel pgBackRest vérifie que l’archivage est fonctionnel avant la sauvegarde, et l’attente du dernier journal avant d’assurer que la sauvegarde est terminée :
Lister les sauvegardes :
Ajouter des données :
- ajouter une table avec 1 million de lignes ;
- forcer la rotation du journal de transaction courant afin de s’assurer que les dernières modifications sont archivées ;
- vérifier que le journal concerné est bien dans les archives.
La table suivante fait 35 Mo, qui seront intégralement écrits dans les journaux :
Pour ce test, il est possible de forcer la rotation du journal avec pg_switch_wal. Dans la vie réelle, il y a de l’activité dans la base et le journal sera assez vite archivé. Sans cela, il pourrait ne pas être sauvegardé.
pg_switch_wal renvoie un LSN peu lisible, comme 0/E8000180, où E8 correspond à la fin du nom du journal. On peut ajouter pg_walfile_name() pour voir plus clairement le nom du journal à archiver :
Vérifier que le journal concerné est bien dans le répertoire de sauvegarde des archives de pgBackRest, soit dans notre exemple /var/lib/pgsql/backups/archive/instance_dev/17-1/. La copie devrait être ici instantanée, mais en production ça ne ne l’est pas forcément.
Simulation d’un incident : noter l’heure puis supprimer tout le contenu de la table.
Noter l’heure exacte avant de détruire des données :
Restaurer les données telles que juste avant l’incident à l’aide de pgBackRest. Avant de redémarrer PostgreSQL, consulter les fichiers que pgBackRest a créé ou modifié dans le PGDATA. Redémarrer.
D’abord, stopper PostgreSQL, sinon pgBackRest refusera de toucher aux données :
En tant que postgres, lancer la commande de restauration avec une heure juste avant la destruction des données :
Noter déjà le mode « delta » pour accélérer la restauration, et le type de restauration time avec une heure.
La restauration du base backup est un succès, mais il va falloir rejouer les journaux archivés. pgBackRest a créé ou modifié ces fichiers :
recovery.signalsignalera à PostgreSQL qu’il est en mode restauration, et pas en redémarrage après un crash ;postgresql.auto.confcontient des paramètres qui vont surchargerpostgresql.conf:
On y trouve :
- la
restore_commandpour récupérer les journaux dans le dépôt, commande que pgBackRest a préparé en fonction de sa configuration et des paramètres de la ligne de commande de restauration ; recovery_target_timeindique l’heure cible ;recovery_target_inclusive = 'false'arrête la restauration juste avant cette heure pour ne pas rejouer la destruction des données, le défaut étant de rejouer jusqu’à l’heure cible incluse ;recovery_target_action = 'promote'demande à PostgreSQL de s’ouvrir en écriture après le rejeu.
Démarrer PostgreSQL :
Attendre la fin de la restauration dans les traces :
Vérifier les logs et la présence des données disparues.
La trace ci-dessus indique bien :
- la restauration de divers journaux ;
- l’arrivée au point de cohérence qui permet au moins d’avoir une instance utilisable telle qu’à la fin du base backup (
consistent recovery state) ; - le changement vers une nouvelle timeline (
selected new timeline ID: 3), comme après toute restauration ; - et l’heure de fin de la dernière transaction rejouée (
last completed transaction was at …).
Les lignes perdues sont bien revenues :
Remarque : sans spécifier de --target-action=promote, on obtiendrait dans les traces de PostgreSQL, après restore :