3 Création d’objets et mises à jour
Création d’objets et mises à jour
Introduction
- DDL, gérer les objets
- DML, écrire des données
- Gérer les transactions
Le module précédent nous a permis de voir comment lire des données à partir de requêtes SQL. Ce module a pour but de présenter la création et la gestion des objets dans la base de données (par exemple les tables), ainsi que l’ajout, la suppression et la modification de données.
Une dernière partie sera consacrée aux transactions.
Menu
- DDL (Data Definition Language)
- DML (Data Manipulation Language)
- TCL (Transaction Control Language)
Objectifs
- Savoir créer, modifier et supprimer des objets
- Savoir utiliser les contraintes d’intégrité
- Savoir mettre à jour les données
- Savoir utiliser les transactions
DDL
- DDL
- Data Definition Language
- langage de définition de données
- Permet de définir des objets dans la base de données
Les ordres DDL (acronyme de Data Definition Language) permettent de définir des objets dans la base de données et notamment la structure de base du standard SQL : les tables.
Objets d’une base de données
- Objets définis par la norme SQL :
- schémas
- séquences
- tables
- contraintes
- domaines
- vues
- fonctions
- triggers
La norme SQL définit un certain nombre d’objets standards qu’il est possible de créer en utilisant les ordres DDL. D’autres types d’objets existent bien entendu, comme les domaines. Les ordres DDL permettent également de créer des index, bien qu’ils ne soient pas définis dans la norme SQL.
La seule structure de données possible dans une base de données relationnelle est la table.
Créer des objets
- Ordre
CREATE - Syntaxe spécifique au type d’objet
- Exemple :
La création d’objet passe généralement par l’ordre CREATE. La syntaxe dépend fortement du type d’objet. Voici trois exemples :
Pour créer un objet, il faut être propriétaire du schéma ou de la base auquel appartiendra l’objet ou avoir le droit CREATE sur le schéma ou la base.
Modifier des objets
Ordre
ALTERSyntaxe spécifique pour modifier la définition d’un objet
Exemple :
- renommage
ALTER type_objet ancien_nom RENAME TO nouveau_nom ;
- changement de schéma
Modifier un objet veut dire modifier ses propriétés. On utilise dans ce cas l’ordre ALTER. Il faut être propriétaire de l’objet pour pouvoir le faire.
Deux propriétés sont communes à tous les objets : le nom de l’objet et son propriétaire. Deux autres sont fréquentes et dépendent du type de l’objet : le schéma et le tablespace. Les autres propriétés dépendent directement du type de l’objet.
Supprimer des objets
Ordre
DROPExemples :
- supprimer un objet :
DROP type_objet nom_objet ;
Seul un propriétaire peut supprimer un objet. Il utilise pour cela l’ordre DROP. Pour les objets ayant des dépendances, l’option CASCADE permet de tout supprimer d’un coup. C’est très pratique, et c’est en même temps très dangereux : il faut donc utiliser cette option à bon escient.
Si un objet dépendant de l’objet à supprimer a lui aussi une dépendance, sa dépendance sera également supprimée. Ainsi de suite jusqu’à la dernière dépendance.
Schéma
- Identique à un espace de nommage
- Permet d’organiser les tables de façon logique
- Possibilité d’avoir des objets de même nom dans des schémas différents
- Pas d’imbrication (contrairement à des répertoires par exemple)
- Schéma
public- existe par défaut dans une base PostgreSQL
GRANT CREATEnécessaire pour y écrire- parfois supprimé pour la sécurité
La notion de schéma dans PostgreSQL est à rapprocher de la notion d’espace de nommage (ou namespace) de certains langages de programmation. Le catalogue système qui contient la définition des schémas dans PostgreSQL s’appelle d’ailleurs pg_namespace.
Les schémas sont utilisés pour répartir les objets de façon purement logique, suivant un schéma interne à l’organisation. Ils servent aussi à faciliter la gestion des droits (il suffit de révoquer le droit d’utilisation d’un schéma à un utilisateur pour que les objets contenus dans ce schéma ne soient plus accessibles à cet utilisateur).
Un schéma public est créé par défaut dans toute nouvelle base de données.
Attention
Par défaut, un simple utilisateur ne peut écrire dans public. Le droit d’écriture doit être donné explicitement :
(Jusque PostgreSQL 14 inclus, tout le monde pouvait y créer des objets. Cela posait des problèmes de sécurité, donc ce droit était souvent révoqué, ou le schéma public supprimé.)
Il existe des schémas système masqués, par exemple pour des tables temporaires ou les tables système (schéma pg_catalog).
Gestion d’un schéma
CREATE SCHEMA nom_schémaALTER SCHEMA nom_schéma- renommage
- changement de propriétaire
DROP SCHEMA [ IF EXISTS ] nom_schéma [ CASCADE ]
L’ordre CREATE SCHEMA permet de créer un schéma. Il suffit de lui spécifier le nom du schéma. CREATE SCHEMA offre d’autres possibilités qui sont rarement utilisées.
L’ordre ALTER SCHEMA nom_schema RENAME TO nouveau_nom_schema permet de renommer un schéma. L’ordre ALTER SCHEMA nom_schema OWNER TO proprietaire permet de changer le propriétaire d’un schéma.
Enfin, l’ordre DROP SCHEMA permet de supprimer un schéma si il est vide. La clause IF EXISTS permet d’éviter la levée d’une erreur si le schéma n’existe pas (très utile dans les scripts SQL). La clause CASCADE permet de supprimer le schéma ainsi que tous les objets qui sont positionnés dans le schéma.
Exemples
Création d’un schéma reference :
Une table peut être créée dans ce schéma :
La suppression directe du schéma ne fonctionne pas car il porte encore la table communes :
L’option CASCADE permet de supprimer le schéma et ses objets dépendants :
Accès aux objets
- Nommage explicite
nom_schema.nom_objet
- Chemin de recherche de schéma
- paramètre
search_path SET search_path = schema1,schema2,public;- par défaut :
$user, public
- paramètre
Le paramètre search_path permet de définir un chemin de recherche pour pouvoir retrouver les tables dont le nom n’est pas qualifié par le nom de son schéma. PostgreSQL procèdera de la même façon que le système avec la variable $PATH : il recherche la table dans le premier schéma listé. S’il trouve une table portant ce nom dans le schéma, il préfixe le nom de table avec celui du schéma. S’il ne trouve pas de table de ce nom dans le schéma, il effectue la même opération sur le prochain schéma de la liste du search_path. S’il n’a trouvé aucune table de ce nom dans les schémas listés par search_path, PostgreSQL lève une erreur.
Comme beaucoup d’autres paramètres, le search_path peut être positionné à différents endroits. Par défaut, il est assigné à $user, public, c’est-à-dire que le premier schéma de recherche portera le nom de l’utilisateur courant, et le second schéma de recherche est public.
Il est possible de vérifier la configuration de la variable search_path à l’aide de la commande SHOW :
Pour obtenir une configuration particulière, la variable search_path peut être positionnée dans le fichier postgresql.conf :
Cette variable peut aussi être positionnée au niveau d’un utilisateur. Chaque fois que l’utilisateur se connectera, il prendra le search_path de sa configuration spécifique :
Cela peut aussi se faire au niveau d’une base de données. Chaque fois qu’un utilisateur se connectera à la base, il prendra le search_path de cette base, sauf si l’utilisateur a déjà une configuration spécifique :
La variable search_path peut également être positionnée pour un utilisateur particulier, dans une base particulière :
Enfin, la variable search_path peut être modifiée dynamiquement dans la session avec la commande SET :
Séquences
- Séquence
- génère une séquence de nombres
- Paramètres
- valeur minimale
MINVALUE - valeur maximale
MAXVALUE - valeur de départ
START - incrément
INCREMENT - cache
CACHE - cycle autorisé
CYCLE
- valeur minimale
Les séquences sont des objets standards qui permettent de générer des séries de valeur. Elles sont utilisées notamment pour générer un numéro unique pour un identifiant ou, plus rarement, pour disposer d’un compteur informatif, mis à jour au besoin.
Le cache de la séquence a pour effet de générer un certain nombre de valeurs en mémoire afin de les mettre à disposition de la session qui a utilisé la séquence. Même si les valeurs pré-calculées ne sont pas consommées dans la session, elles seront consommées au niveau de la séquence. Cela peut avoir pour effet de créer des trous dans les séquences d’identifiants et de consommer très rapidement les numéros de séquence possibles. Le cache de séquence n’a pas besoin d’être ajusté sur des applications réalisant de petites transactions. Il permet en revanche d’améliorer les performances sur des applications qui utilisent massivement des numéros de séquences, notamment pour réaliser des insertions massives.
Création d’une séquence
La syntaxe complète est donnée dans le slide.
Le mot clé TEMPORARY ou TEMP permet de définir si la séquence est temporaire. Si tel est le cas, elle sera détruite à la déconnexion de l’utilisateur.
Le mot clé INCREMENT définit l’incrément de la séquence, MINVALUE, la valeur minimale de la séquence et MAXVALUE, la valeur maximale. START détermine la valeur de départ initiale de la séquence, c’est-à-dire juste après sa création. La clause CACHE détermine le cache de séquence. CYCLE permet d’indiquer au SGBD que la séquence peut reprendre son compte à MINVALUE lorsqu’elle aura atteint MAXVALUE. La clause NO CYCLE indique que le rebouclage de la séquence est interdit, PostgreSQL lèvera alors une erreur lorsque la séquence aura atteint son MAXVALUE. Enfin, la clause OWNED BY détermine l’appartenance d’une séquence à une colonne d’une table. Ainsi, si la colonne est supprimée, la séquence sera implicitement supprimée.
Exemple de séquence avec rebouclage :
Modification d’une séquence
- Il est aussi possible de modifier
- le propriétaire
- le schéma
Les propriétés de la séquence peuvent être modifiées avec l’ordre ALTER SEQUENCE.
La séquence peut être affectée à un nouveau propriétaire :
Elle peut être renommée :
Enfin, elle peut être positionnée dans un nouveau schéma :
Suppression d’une séquence
Voici la syntaxe complète de DROP SEQUENCE :
Le mot clé CASCADE permet de supprimer la séquence ainsi que tous les objets dépendants (par exemple la valeur par défaut d’une colonne).
Séquences, utilisation
- Obtenir la valeur suivante
nextval('nom_sequence')
- Obtenir la valeur courante
currval('nom_sequence')- mais
nextval()doit être appelé avant dans la même session
- Ne pas utiliser pour une numérotation « sans trou » !
La fonction nextval() permet d’obtenir le numéro de séquence suivant. Son comportement n’est pas transactionnel. Une fois qu’un numéro est consommé, il n’est pas possible de revenir dessus, malgré un ROLLBACK de la transaction. La séquence est le seul objet à avoir un comportement de ce type. C’est cependant nécessaire, notamment pour des raisons de performance.
La fonction currval() permet d’obtenir le numéro de séquence courant, mais son usage nécessite d’avoir utilisé nextval() dans la même session.
Il est possible d’interroger une séquence avec une requête SELECT. Cela permet d’obtenir des informations sur la séquence, dont la dernière valeur utilisée dans la colonne last_value. Cet usage n’est pas recommandé en production et doit plutôt être utilisé à titre informatif.
Exemples
Utilisation d’une séquence simple :
Utilisation d’une séquence simple avec cache :
Déconnexion et reconnexion de l’utilisateur :
Suppression en cascade d’une séquence :
Attention
Une séquence n’est pas le bon outil s’il vous faut générer des suites de nombres « sans trou », par exemple des numéros de factures. Une séquence est conçue d’abord pour livrer des numéros uniques, et certaines valeurs peuvent être « perdues ».
Une suite unique réclame des techniques plus complexes nécessitant un verrouillage plus lourd.
Type SERIAL
- Type
serial/bigserial/smallserial- séquence générée automatiquement
- valeur par défaut
nextval(…)
- Préférer un entier avec
IDENTITY
Certaines bases de données offrent des colonnes auto-incrémentées (autoincrement de MySQL ou identity de SQL Server).
PostgreSQL possède identity à partir de PostgreSQL 10. Il était déjà possible d’utiliser serial, un équivalent qui s’appuie sur les séquences et la possibilité d’appliquer une valeur par défaut à une colonne.
Par exemple, si l’on crée la table suivante :
On s’aperçoit que la table a été créée telle que demandé, mais qu’une séquence a aussi été créée. Elle porte un nom dérivé de la table associé à la colonne correspondant au type serial, terminé par seq :
En examinant plus précisément la définition de la table, on s’aperçoit que la colonne id porte une valeur par défaut qui correspond à l’appel de la fonction nextval() sur la séquence qui a été créée implicitement :
smallserial et bigserial sont des variantes de serial s’appuyant sur des types d’entiers plus courts ou plus longs.
Domaines
- Permet d’associer
- un type standard
- et une contrainte (optionnelle)
Un domaine est un type standard (numérique, texte…) auquel ont été ajoutées des contraintes particulières.
Les domaines sont utiles pour ne pas définir les mêmes contraintes sur plusieurs colonnes. La maintenance en est ainsi facilitée.
Les domaines sont utiles pour ramener la définition de contraintes communes à plusieurs colonnes sur un seul objet. La maintenance en est ainsi facilitée.
L’ordre CREATE DOMAIN permet de créer un domaine, ALTER DOMAIN permet de modifier sa définition, et enfin, DROP DOMAIN permet de supprimer un domaine.
Exemples : gestion d’un domaine salaire :
Commençons par le domaine et une table d’exemple :
Insérons des données dans la table :
L’erreur ci-dessus est logique vu qu’on ne peut avoir qu’un entier strictement positif.
Tous les employés doivent avoir un salaire. Il faut donc modifier la contrainte pour s’assurer qu’aucune valeur NULL (vide) ne soit saisie
En effet, une ligne avec NULL est déjà présente, il faut la corriger pour pouvoir ajouter la contrainte.
La contrainte est donc bien vérifiée, et la ligne avec NULL rejetée.
Supprimons maintenant la contrainte :
Il n’est pas possible de supprimer le domaine car il est référencé dans une table. Il faut donc utiliser l’option CASCADE pour détruire aussi les objets qui dépendent du domaine.
Attention
Soyez très prudent en supprimant des objets avec CASCADE !
Le domaine a été supprimée ainsi que toutes les colonnes de ce type :
Exemples : création et utilisation d’un domaine code_postal_us :
Tables
- Équivalent ensembliste d’une relation
- Composé principalement de
- colonnes ordonnées
- contraintes
La table est l’élément de base d’une base de données. Elle est composée de colonnes (à sa création) et est remplie avec des enregistrements (lignes de la table). Sa définition peut aussi faire intervenir des contraintes, qui sont au niveau table ou colonne.
Création d’une table
- Définition de son nom
- Définition de ses colonnes
- nom, type, contraintes éventuelles
- Clauses de stockage
CREATE TABLE
Pour créer une table, il faut donner son nom et la liste des colonnes. Une colonne est définie par son nom et son type, mais aussi des contraintes optionnelles.
Des options sont possibles pour les tables, comme les clauses de stockage. Dans ce cas, on sort du contexte logique pour se placer au niveau physique.
CREATE TABLE
La création d’une table passe par l’ordre CREATE TABLE. La définition des colonnes et des contraintes sont entre parenthèse après le nom de la table.
Définition des colonnes
Les colonnes sont indiquées l’une après l’autre, en les séparant par des virgules.
Deux informations sont obligatoires pour chaque colonne : le nom et le type de la colonne. Dans le cas d’une colonne contenant du texte, il est possible de fournir le collationnement de la colonne. Quelle que soit la colonne, il est ensuite possible d’ajouter des contraintes.
Valeur par défaut
DEFAULT- affectation implicite
- Utiliser directement par les types sériés
La clause DEFAULT permet d’affecter une valeur par défaut lorsqu’une colonne n’est pas référencée dans l’ordre d’insertion ou si une mise à jour réinitialise la valeur de la colonne à sa valeur par défaut.
Les types sériés définissent une valeur par défaut sur les colonnes de ce type. Cette valeur est le retour de la fonction nextval() sur la séquence affectée automatiquement à cette colonne.
Exemples
Assignation d’une valeur par défaut :
Copie de la définition d’une table
- Création d’une table à partir d’une autre table
CREATE TABLE … (LIKE table clause_inclusion)
- Avec les valeurs par défaut des colonnes :
INCLUDING DEFAULTS
- Avec ses autres contraintes :
INCLUDING CONSTRAINTS
- Avec ses index :
INCLUDING INDEXES
L’ordre CREATE TABLE permet également de créer une table à partir de la définition d’une table déjà existante en utilisant la clause LIKE en lieu et place de la définition habituelle des colonnes. Par défaut, seule la définition des colonnes avec leur typage est repris.
Les clauses INCLUDING permettent de récupérer d’autres éléments de la définition de la table, comme les valeurs par défaut (INCLUDING DEFAULTS), les contraintes d’intégrité (INCLUDING CONSTRAINTS), les index (INCLUDING INDEXES), les clauses de stockage (INCLUDING STORAGE) ainsi que les commentaires (INCLUDING COMMENTS). Si l’ensemble de ces éléments sont repris, il est possible de résumer la clause INCLUDING à INCLUDING ALL.
La clause CREATE TABLE suivante permet de créer une table archive_evenements_2010 à partir de la définition de la table evenements :
Elle est équivalente à :
Modification d’une table
ALTER TABLE- Définition de la table
- renommage de la table
- ajout/modification/suppression d’une colonne
- déplacement dans un schéma différent
- changement du propriétaire
- Définition des colonnes
- renommage d’une colonne
- changement de type d’une colonne
- Définition des contraintes
- ajout/suppression d’une contrainte
Pour modifier la définition d’une table (et non pas son contenu), il convient d’utiliser l’ordre ALTER TABLE. Il permet de traiter la définition de la table (nom, propriétaire, schéma, liste des colonnes), la définition des colonnes (ajout, modification de nom et de type, suppression… mais pas de changement au niveau de leur ordre), et la définition des contraintes (ajout et suppression).
Conséquences des modifications d’une table
- Contention : verrous
- Vérification des données : durée
- Performance : possible réécriture de la table
Suivant la modification de la table, les verrous posés ne sont pas les mêmes, même si le verrou par défaut est un verrou exclusif. Par exemple, renommer une table nécessite un verrou exclusif, mais changer la taille de l’échantillon statistiques bloque uniquement certaines opérations de maintenance (comme VACUUM et ANALYZE) et certaines opérations DDL. L’utilisation de la commande ALTER TABLE sur un serveur en production doit donc souvent passer par une opération de maintenance planifiée.
Certaines opérations nécessitent de vérifier que les données satisfassent les nouvelles contraintes. C’est évident lors de l’ajout d’une clé primaire ou d’une contrainte NOT NULL, par exemple : il faut vérifier que les lignes existantes respectent la nouvelle contrainte. Or, relire une grosse table peut être très coûteux ! Toutefois, PostgreSQL sait parfois éviter un contrôle inutile, par exemple lors d’une conversion de varchar(10) en varchar(20).
Certaines opérations nécessitent une réécriture de la table. Par exemple, convertir une colonne de type varchar(5) vers le type int impose une réécriture de la table car il n’y a pas de compatibilité binaire entre les deux types.
Il convient donc d’être très prudent lors de l’utilisation de la commande ALTER TABLE. Elle peut poser des problèmes de performances, à cause de verrous posés par d’autres commandes, de verrous qu’elle réclame, de la vérification des données, voire de la réécriture de la table.
Suppression d’une table
- Supprimer une table :
- Supprimer une table et tous les objets dépendants :
L’ordre DROP TABLE permet de supprimer une table. L’ordre DROP TABLE … CASCADE permet de supprimer une table ainsi que tous ses objets dépendants. Il peut s’agir de séquences rattachées à une colonne d’une table, à des colonnes référençant la table à supprimer, etc.
Contraintes d’intégrité
- ACID
- Cohérence
- une transaction amène la base d’un état stable à un autre
- Assurent la cohérence des données
- unicité des enregistrements
- intégrité référentielle
- vérification des valeurs
- identité des enregistrements
- règles sémantiques
Les données dans les différentes tables ne sont pas indépendantes mais obéissent à des règles sémantiques mises en place au moment de la conception du modèle de données. Les contraintes d’intégrité ont pour principal objectif de garantir la cohérence des données entre elles, et donc de veiller à ce qu’elles respectent ces règles sémantiques. Si une insertion, une mise à jour ou une suppression viole ces règles, l’opération est purement et simplement annulée.
Clé primaire d’une table
- Identifie une ligne de manière unique
- Une seule clé primaire par table
- Une ou plusieurs colonnes
- À choisir parmi les clés candidates
- clé naturelle ou artificielle (technique, invisible)
- les autres clés possibles peuvent être
UNIQUE
- Index automatique
Une « clé primaire » permet d’identifier une ligne de façon unique.
Il n’existe qu’une seule clé primaire par table.
Une clé primaire exige que toutes les valeurs de la ou des colonnes qui composent cette clé soient uniques et non nulles. La clé peut être composée d’une seule colonne ou de plusieurs colonnes, selon le besoin.
La clé primaire est déterminée au moment de la conception du modèle de données. Cette clé peut être « naturelle » et visible de l’utilisateur, ou purement technique et non visible. Le débat entre les deux modélisations a longtemps fait rage.
Clé primaire naturelle :
Par exemple, une table des factures peut avoir comme clé primaire « naturelle » le numéro de la facture. C’est le plus intuitif.
De nombreuses applications utilisent des « clés naturelles », par exemple un numéro de commande ou de Sécurité Sociale. Ces clés peuvent même être composées de plusieurs champs.
Cela peut poser des soucis techniques. Par exemple, il y a des contraintes légales sur l’incrémentation des numéros de facture qui obligent à les générer tard dans le processus. Enregistrer une facture incomplète sans son numéro devient compliqué. Un numéro provisoire est possible, mais le changer implique de modifier aussi toutes les tables qui y font référence.
Attention
De manière générale, on évitera toujours de modifier une clé primaire, car elle sert d’identifiant vers la ligne dans d’autres tables, et une modification serait à répercuter dans toutes ces tables !
Liée à notre table des factures, une table des lignes de facture aurait alors comme clé primaire composée le numéro de la facture et le numéro de la ligne. Cela fonctionne, mais une clé composée, d’ailleurs souvent de type texte, est moins performante pour les jointures qu’un champ monocolonne numérique.
Clé primaire technique :
Astuce
Les bonnes pratiques conseillent plutôt d’identifier chaque ligne de chaque table par une clé technique monocolonne et numérique, de valeur arbitraire et sans aucune signification métier.
Cette surrogate keys est donc une clé primaire destinée à résoudre les soucis techniques des clés primaires naturelles.
L’utilisateur final de l’application ne doit jamais la voir.
Cette clé technique est souvent un entier produit avec une séquence, ou un UUID (quasi-aléatoire) généré par une fonction dédiée ou fourni par l’applicatif. Ce qui compte est l’unicité.
La clé technique n’a pas à être modifiée puisque sa valeur n’a pas de sens fonctionnel.
Les jointures se font alors sur cet unique champ numérique, de manière efficace.
Les clés « naturelles » restent présentes sous forme d’un champ d’une table, avec une contrainte d’unicité. Si cette clé naturelle doit être modifiée pour une raison ou une autre, il suffit de changer la valeur dans le champ de la table, et il n’y a aucune modification à faire dans les tables possédant une clé étrangère vers cette table, puisqu’elles utilisent l’identifiant technique.
Dans notre exemple, la table des factures porte une clé primaire numérique facture_id arbitraire, et un champ numero_facture, unique, qui, lui, peut être modifié ou être temporairement vide. La table des lignes de facture porte une clé primaire technique facture_ligne_id sans lien, et une clé étrangère (non composée) reprenant facture_id, et un champ unique numero_ligne.
Exemple 2 :
Pour un assureur automobile ou un garagiste, une table des véhicules ne peut pas avoir pour clé primaire la plaque d’immatriculation : elle peut changer, elle peut être inconnue, provisoire, absente, voire fausse.
Un identifiant technique est largement préférable.
Exemple 3 :
Une table des clients ne peut pas porter de clé primaire naturelle liée aux nom, prénom, date de naissance… à cause des nombreuses homonymies, et des changements et corrections d’état-civil possibles.
Un code client est plus envisageable, mais il pourrait changer aussi (migration de logiciel, fusion de bases clients…). Le code client peut devenir une clé unique dans une table des clients, dont la clé primaire est purement technique.
Exemple 4 :
Une table de personnes identifiées par le numéro de Sécurité Sociale ne peut utiliser ce dernier comme clé naturelle : valeur parfois absente ou inconnue, changement possible, voire doublons (!), sans parler de la confidentialité.
Un code de personne propre à l’application est plus pertinent.
Là encore, on crée une clé technique, et le code de la personne et le code de Sécurité Sociale sont juste des champs uniques.
Exemple 5 :
Une table des commandes clients porte une référence vers une table des adresses. Cette table des adresses doit impérativement porter une clé technique : il n’y a guère de sens à créer un « code adresse » et, surtout, les clients changent régulièrement d’adresse.
Un changement d’adresse d’un client consiste à créer une nouvelle ligne dans la table des adresses et à modifier l’identifiant d’adresse dans la table des clients. Les anciennes commandes et factures doivent en effet conserver l’identifiant des anciennes adresses.
Exemple 6 :
La table des adresses possède un champ renvoyant à une table des pays.
Un code pays ISO est ce qui se rapproche le plus d’une clé naturelle acceptable comme clé technique : courte (FR, DE), normalisée et sans risque de changement (le code reste identique et n’est pas recyclé).
Index :
Astuce
La création d’une clé primaire crée implicitement un index sur le champ, pour des raisons de performance.
Astuce
Si la clé techique est un UUID, il est recommandé qu’il soit généré avec la norme UUID v7, pour des raisons techniques liées à l’effet de cache trop longues à développer ici.
Déclaration d’une clé primaire
Construction :
- Séquence
serialGENERATED ALWAYS BY IDENTITY- UUID
Exemple avec clé technique manuelle :
La clé primaire est forcément NOT NULL : ceci va être rejeté :
Exemple avec séquence :
La séquence génère des identifiants que l’on peut utiliser :
Noter que cette dernière erreur va « consommer » un numéro de séquence, ce qui en fait n’a pas d’importance pour une clé technique.
Exemples avec serial :
Noter que serial est considéré comme un type (il existe aussi bigserial). Il y a création d’une séquence en arrière-plan, utilisée de manière transparente.
Interférer avec l’autoincrémentation est une très mauvaise idée :
Exemple avec IDENTITY :
Le maniement est identique au serial. Il faut préférer l’identité pour des raisons de respect de standard SQL et à cause de quelques spécificités dans la gestion automatique des séquences sous-jacentes.
Exemple avec une clé composée :
Nous verrons plus loin un exemple avec une clé primaire composée, qui doit se déclarer alors après les colonnes :
Contrainte d’unicité
- Garantit l’unicité des valeurs d’une ou plusieurs colonnes
- Clause
UNIQUE - Contrainte
UNIQUE!= indexUNIQUE
Une contrainte d’unicité permet de garantir que les valeurs de la ou des colonnes sur lesquelles porte la contrainte sont uniques.
Une contrainte d’unicité peut être créée simplement en créant un index UNIQUE approprié. Ceci est fortement déconseillé du fait que la contrainte ne sera pas référencée comme telle dans le schéma de la base de données. Il sera donc très facile de ne pas la remarquer au moment d’une reprise du schéma pour une évolution majeure de l’application. Une colonne possédant juste l’index UNIQUE peut malgré tout être référencée par une clé étrangère.
Les contraintes d’unicité créent implicitement et obligatoirement un index pour implémenter cette unicité.
Déclaration d’une contrainte d’unicité
Construction :
Voici un exemple complet.
Sans contrainte d’unicité, on peut insérer plusieurs fois la même valeur, sans erreur :
Ce n’est plus le cas en déclarant une contrainte d’unicité :
Le cas de NULL est un peu particulier. Par défaut, plusieurs valeurs NULL peuvent figurer dans un index car elles ne sont pas considérées comme égales, mais de valeur inconnue (unknown). Par exemple, une table de personnes physiques peut contenir un champ numero_secu qui ne doit pas contenir de doublon, mais n’est pas forcément rempli, donc contient de nombreuses valeurs nulles.
Ici, on peut insérer plusieurs valeurs NULL :
Ce comportement est modifiable en version 15, et une seule valeur NULL sera tolérée. Lors de la création de la contrainte, il faut préciser ce nouveau comportement :
Intégrité référentielle
- Contrainte d’intégrité référentielle
- ou Clé étrangère
- Référence une clé primaire ou un groupe de colonnes
UNIQUEetNOT NULL - Garantit l’intégrité des données
FOREIGN KEY
Une clé étrangère sur une table fait référence à une clé primaire ou une contrainte d’unicité d’une autre table. La clé étrangère garantit que les valeurs des colonnes de cette clé existent également dans la table portant la clé primaire ou la contrainte d’unicité. On parle de contrainte référentielle d’intégrité : la contrainte interdit les valeurs qui n’existent pas dans la table référencée. Toute insertion ou modification qui viole cette règle est rejetée.
C’est ce mécanisme qui permet de garantir qu’une commande sera liée à un client existant dans la table des clients, ou que le pays dans une adresse existe bien dans la table des pays. Et à l’inverse, on ne pourra supprimer un pays ou un client dans les tables des commandes ou adresses qui possèdent une contrainte d’intégrité dessus.
À titre d’exemple nous allons utiliser la base cave. Si vous ne l’avez pas déjà, la base cave (dump de 2,6 Mo, pour 71 Mo sur le disque au final) peut être téléchargée et restaurée ainsi :
Le schéma suivant montre les différentes tables de la base :
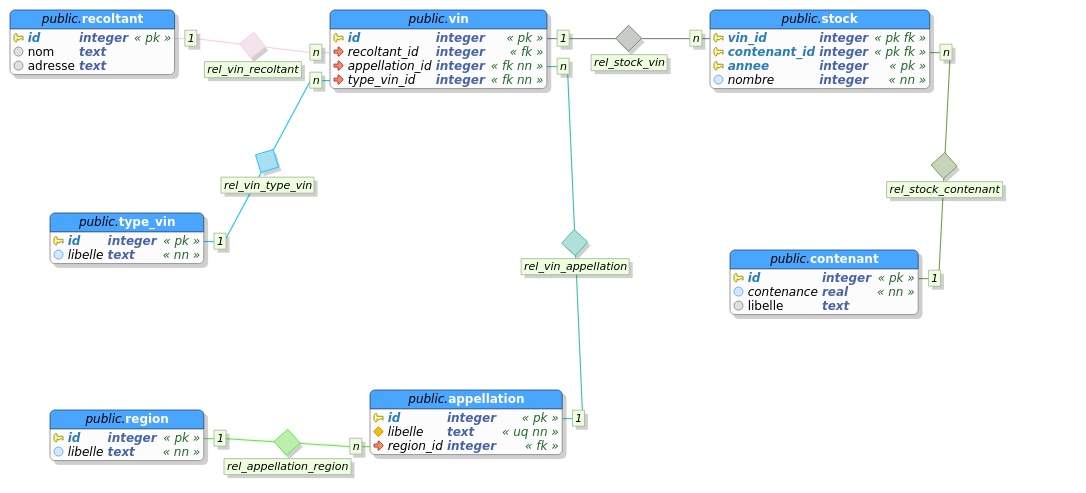
Ainsi, la base cave définit une table region et une table appellation. Une appellation d’origine est liée au terroir, et par extension à son origine géographique. La table appellation est donc liée par une clé étrangère à la table region : la colonne region_id de la table appellation référence la colonne id de la table region.
Cette contrainte permet d’empêcher les utilisateurs d’entrer dans la table appellation des identifiants de région (region_id) qui n’existent pas dans la table region.
Déclaration d’une clé étrangère
Exemples :
Définition de la table stock :
Cette table possède une clé primaire composée : il ne peut exister qu’une seule ligne pour un trio vin, contenant, année précis.
Création d’une table « mère » et d’une table « fille ». La table fille possède une clé étrangère qui référence la table mère :
Ces trois dernières options sont optionnelles, et les valeurs par défaut sont différentes (voir plus bas).
L’ajout de données dans la table fille qui font bien référence à la table mere est accepté :
L’ajout de données dans la table fille qui ne font pas référence à la table mère est refusé :
Mettre à jour la référence dans la table mère ne fonctionnera pas car la contrainte a été définie pour refuser les mises à jour (ON UPDATE NO ACTION) :
Par contre, la suppression d’une ligne de la table mère référencée dans la table fille va propager la suppression jusqu’à la table fille (ON DELETE CASCADE) :
Vérification simple ou complète
- Vérification complète ou partielle d’une clé étrangère
MATCHMATCH FULL(complète)MATCH SIMPLE(partielle)
La directive MATCH permet d’indiquer si la contrainte doit être entièrement vérifiée (MATCH FULL) ou si la clé étrangère autorise des valeurs NULL (MATCH SIMPLE). MATCH SIMPLE est la valeur par défaut.
Avec MATCH FULL, toutes les valeurs des colonnes qui composent la clé étrangère de la table référençant doivent avoir une correspondance dans la table référencée.
Avec MATCH SIMPLE, les valeurs des colonnes qui composent la clé étrangère de la table référençant peuvent comporter des valeurs NULL. Dans le cas des clés étrangères multicolonnes, toutes les colonnes peuvent ne pas être renseignées. Dans le cas des clés étrangères sur une seule colonne, la contrainte autorise les valeurs NULL.
Exemples
Les exemples reprennent les tables mere et fille créées plus haut.
Clé primaire et colonne identité
- Identité d’un enregistrement
GENERATED … AS IDENTITYALWAYSBY DEFAULT
- Préférer à
serial - Ne dispense pas d’ajouter la contrainte de clé primaire !
La syntaxe GENERATED … AS IDENTITY permet d’avoir une colonne dont la valeur est incrémentée automatiquement, soit en permanence (clause ALWAYS), soit quand aucune valeur n’est saisie (clause BY DEFAULT). GENERATED … AS IDENTITY est apparue dans PostgreSQL après le pseudo-type serial, d’utilisation similaire, mais il en corrige certains défauts.
Astuce
Pour les raisons qui suivent, préférez l’utilisation de GENERATED … AS IDENTITY à celle de serial, lequel peut se rencontrer encore dans de nombreuses applications.
Tout d’abord, GENERATED … AS IDENTITY fait partie du standard SQL, alors que le pseudo-type serial est propre à PostgreSQL.
serial n’est en effet qu’un raccourci pour créer à la fois une séquence, un champ entier et un DEFAULT nextval() pour alimenter ce champ, et cela peut poser quelques soucis. Notamment, le DDL saisi par l’utilisateur diffère de celui stocké en base ou sorti par pg_dump, ce qui n’est pas idéal. Ou encore, l’ordre de copie de structure de tables CREATE TABLE … LIKE (INCLUDING ALL) copie le serial sans en changer la séquence ni en créer une autre : on a alors une séquence partagée par deux tables ! Il n’est pas non plus possible d’ajouter ou de supprimer un pseudo-type serial avec l’instruction ALTER TABLE. La suppression de la contrainte DEFAULT d’un type serial ne supprime pas la séquence associée. Tout ceci fait que la définition d’une colonne d’identité est préférable à l’utilisation du pseudo-type serial.
Il reste obligatoire de définir une clé primaire ou unique si l’on tient à l’unicité des valeurs, car même une clause GENERATED ALWAYS AS IDENTITY peut être contournée avec une mise à jour portant la mention OVERRIDING SYSTEM VALUE.
Exemple :
Mise à jour de la clé primaire
- Que faire en cas de mise à jour d’une clé primaire ?
- les clés étrangères seront fausses
ON UPDATEON DELETE- Définition d’une action au niveau de la clé étrangère
- interdiction
- propagation de la mise à jour
- NULL
- valeur par défaut
Si des valeurs d’une clé primaire sont mises à jour ou supprimées, cela peut entraîner des incohérences dans la base de données si des valeurs de clés étrangères font référence aux valeurs de la clé primaire touchées par le changement.
Afin de pouvoir gérer cela, la norme SQL prévoit plusieurs comportements possibles. La clause ON UPDATE permet de définir comment le SGBD va réagir si la clé primaire référencée est mise à jour. La clause ON DELETE fait de même pour les suppressions.
Les actions possibles sont :
NO ACTION(ouRESTRICT), qui produit une erreur si une ligne référence encore le ou les lignes touchées par le changement ;CASCADE, pour laquelle la mise à jour ou la suppression est propagée aux valeurs référençant le ou les lignes touchées par le changement ;SET NULL, la valeur de la colonne devientNULL;SET DEFAULT, pour lequel la valeur de la colonne prend la valeur par défaut de la colonne.
Astuce
Le comportement par défaut est NO ACTION, ce qui est habituellement recommandé pour éviter les suppressions en chaîne mal maîtrisées.
Exemples
Les exemples reprennent les tables mere et fille créées plus haut.
Tentative d’insertion d’une ligne dont la valeur de mere_id n’existe pas dans la table mere :
Mise à jour d’une ligne de la table mere pour modifier son id. La clé étrangère est déclarée ON UPDATE NO ACTION, donc la mise à jour devrait être interdite :
Suppression d’une ligne de la table mere. La clé étrangère sur fille est déclarée ON DELETE CASCADE, la suppression sera donc propagée aux tables qui référencent la table mere :
Vérifications
- Présence d’une valeur
NOT NULL- NB : obligatoire dans une clé primaire
- Vérification de la valeur d’une colonne
CHECK
La clause NOT NULL permet de s’assurer que la valeur de la colonne portant cette contrainte est renseignée. Dit autrement, elle doit obligatoirement être renseignée. Par défaut, une colonne peut avoir une valeur NULL, donc n’est pas obligatoirement renseignée. Rappelons qu’une clé primaire ne peut pas être à NULL.
La clause CHECK spécifie une expression de résultat booléen que les nouvelles lignes ou celles mises à jour doivent satisfaire pour qu’une opération d’insertion ou de mise à jour réussisse. Les expressions de résultat TRUE ou NULL réussissent. Si une des lignes de l’opération d’insertion ou de mise à jour produit un résultat FALSE, une exception est levée et la base de données n’est pas modifiée. Une contrainte de vérification sur une colonne ne fait référence qu’à la valeur de la colonne tandis qu’une contrainte sur la table fait référence à plusieurs colonnes. Une fonction définie par l’utilisateur peut être utilisée à condition de respecter ces mêmes règles.
Actuellement, les expressions CHECK ne peuvent ni contenir des sous-requêtes ni faire référence à des variables autres que les colonnes de la ligne courante. C’est techniquement réalisable, mais non supporté.
Cet exemple est inspiré de la documentation officielle, page Contraintes de vérification.
Vérifications différées
- Vérifications après chaque ordre SQL
- problèmes de cohérence
- Différer les vérifications de contraintes
- clause
DEFERRABLE,NOT DEFERRABLE INITIALLY DEFERED,INITIALLY IMMEDIATE
- clause
Par défaut, toutes les contraintes d’intégrité sont vérifiées lors de l’exécution de chaque ordre SQL de modification, y compris dans une transaction. Cela peut poser des problèmes de cohérences de données : insérer dans une table fille alors qu’on n’a pas encore inséré les données dans la table mère, la clé étrangère de la table fille va rejeter l’insertion et annuler la transaction.
Le moment où les contraintes sont vérifiées est modifiable dynamiquement par l’ordre SET CONSTRAINTS :
mais ce n’est utilisable que pour les contraintes déclarées comme déferrables.
Voici quelques exemples :
- avec la définition précédente des tables
mereetfille:
- cette erreur survient aussi dans le cas où on demande que la vérification des contraintes soit différée pour cette transaction :
- il faut que la contrainte soit déclarée comme étant différable :
Vérifications plus complexes
- Un trigger
- si une contrainte porte sur plusieurs tables
- si sa vérification nécessite une sous-requête
- Préférer les contraintes déclaratives
Les contraintes d’intégrités du SGBD ne permettent pas d’exprimer une contrainte qui porte sur plusieurs tables ou simplement si sa vérification nécessite une sous-requête. Dans ce cas là, il est nécessaire d’écrire un trigger spécifique qui sera déclenché après chaque modification pour valider la contrainte.
Attention
Il ne faut toutefois pas systématiser l’utilisation de triggers pour valider des contraintes d’intégrité. Cela aurait un fort impact sur les performances et sur la maintenabilité de la base de données. Il vaut mieux privilégier les contraintes déclaratives et les colonnes générées, et n’utiliser les triggers qu’en dernier recours.
Colonnes par défaut et générées
DEFAULT: expressions très simples, modifiablesGENERATED- fonctions « immutables », ne dépendant que de la ligne
- (avant v17) difficilement modifiables
- peuvent porter des contraintes
Les champs DEFAULT sont très utilisés, mais PostgreSQL supporte les colonnes générées (ou calculées).
DEFAULT …
Les champs avec une clause DEFAULT sont remplis automatiquement à la création de la ligne quand une valeur n’est pas fournie dans l’ordre INSERT (celui-ci peut ne renseigner que certains champs).
Seules sont autorisées avec DEFAULT des expressions simples, sans variable, ni utilisation de champs de la ligne, ni sous-requête. Sont acceptées des constantes, certains calculs ou fonctions simples, comme now(), ou un appel à nextval ('nom_séquence').
Attention
Ajouter une clause DEFAULT sur un champ existant calcule les valeurs pour toutes les lignes pré-existantes de la table, ce qui peut entraîner la réécriture de la table ! Une optimisation évite de tout réécrire si les anciennes lignes se retrouvent toutes avec la même valeur constante.
La valeur par défaut peut être écrasée, par déclaration explicite du champ lors de l’INSERT, ou plus tard avec UPDATE.
Changer l’expression d’une clause DEFAULT est possible :
mais cela n’a pas d’impact sur les lignes existantes, juste les nouvelles.
GENERATED ALWAYS AS ( … ) STORED
La syntaxe est :
Les colonnes générées sont recalculées à chaque fois que les champs sur lesquels elles sont basées changent, donc aussi lors d’un UPDATE. Ces champs calculés sont impérativement marqués ALWAYS, c’est-à-dire obligatoires et non modifiables, et STORED, c’est-à-dire stockés sur le disque (et non recalculés à la volée comme dans une vue). Ils ne doivent pas se baser sur d’autres champs calculés.
Un intérêt est que les champs calculés peuvent porter des contraintes, par exemple la clause CHECK ci-dessous, mais encore des clés étrangères ou unique.
Exemple :
Expression immutable :
Avec GENERATED, l’expression du calcul doit être « immutable », c’est-à-dire ne dépendre que des autres champs de la même ligne, n’utiliser que des fonctions elles-mêmes immutables, et rien d’autre. Il n’est donc pas possible d’utiliser des fonctions comme now(), ni des fonctions de conversion de date dépendant du fuseau horaire, ou du paramètre de formatage de la session en cours (toutes choses autorisées avec DEFAULT), ni des appels à d’autres lignes ou tables…
La colonne calculée peut être convertie en colonne « normale » :
Modifier l’expression n’est pas possible avant PostgreSQL 17, sauf à supprimer la colonne générée et en créer une nouvelle. Il faut alors recalculer toutes les lignes et réécrire toute la table, ce qui peut être très lourd.
À partir de PostgreSQL 17, l’expression est modifiable avec cette syntaxe :
Attention, la table est totalement bloquée le temps de la réécriture (verrou AccessExclusiveLock).
Utilisation d’une fonction :
Il est possible de créer sa propre fonction pour l’expression, qui doit aussi être immutable :
Attention
Attention : modifier la fonction ne réécrit pas spontanément la table, il faut forcer la réécriture avec par exemple :
et ceci dans la même transaction que la modification de fonction. On pourrait imaginer de négliger cet UPDATE pour garder les valeurs déjà présentes qui suivraient d’anciennes règles… mais ce serait une erreur. En effet, les valeurs calculées ne figurent pas dans une sauvegarde logique, et en cas de restauration, tous les champs sont recalculés avec la dernière formule !
On préférera donc gérer l’expression dans la définition de la table dans les cas simples.
Attention
Un autre piège : il faut résister à la tentation de déclarer une fonction comme immutable sans la certitude qu’elle l’est bien (penser aux paramètres de session, aux fuseaux horaires…), sous peine d’incohérences dans les données.
Cas d’usage :
Les colonnes générées économisent la création de triggers, ou de vues de « présentation ». Elles facilitent la dénormalisation de données calculées dans une même table tout en garantissant l’intégrité.
Un cas d’usage courant est la dénormalisation d’attributs JSON pour les manipuler comme des champs de table classiques :
L’accès au champ est notablement plus rapide que l’analyse systématique du champ JSON.
Par contre, les colonnes GENERATED ne sont pas un bon moyen pour créer des champs portant la dernière mise à jour. Certes, PostgreSQL ne vous empêchera pas de déclarer une fonction (abusivement) immutable utilisant now() ou une variante. Mais ces informations seront perdues en cas de restauration logique. Dans ce cas, les triggers restent une option plus complexe mais plus propre.
DML : mise à jour des données
SELECTpeut lire les données d’une table ou plusieurs tables- mais ne peut pas les mettre à jour (sauf fonction)
- Ajout de données dans une table
INSERT
- Modification des données d’une table
UPDATE
- L’un ou l’autre
MERGE
- Suppression des données d’une table
DELETE
L’ordre SELECT permet de lire une ou plusieurs tables, sans modification. Il faut toutefois savoir que SELECT peut aussi servir à appeler des fonctions, et que celles-ci sont susceptibles de faire à peu près n’importe quoi dans la base.
Les mises à jours utilisent des ordres distincts. L’ordre INSERT permet d’ajouter ou insérer des données dans une table. L’ordre UPDATE permet de modifier des lignes déjà existantes.
Depuis PostgreSQL 15, il existe un ordre MERGE (conforme au standard SQL) permettant par exemple de mettre à jour une ligne dont la clé existe, ou de l’insérer au besoin. L’utilisation peut être complexe.
Enfin, l’ordre DELETE permet de supprimer des lignes.
Ces derniers ordres ne peuvent modifier qu’une seule table à la fois. Si on souhaite par exemple insérer des données dans deux tables, il est nécessaire de réaliser deux ordres INSERT distincts.
Noter qu’il est possible de regrouper plusieurs SELECT/DELETE/INSERT/etc. dans une même requête, grâce aux Common Table Expressions, que nous n’aborderons pas ici.
Ajout de données : INSERT
- Ajoute des lignes à partir des données de la requête
- Ajoute des lignes à partir d’une requête
SELECT - Syntaxe :
- Précisez toujours les champs à renseigner
L’ordre INSERT insère de nouvelles lignes dans une table. Il permet d’insérer une ou plusieurs lignes spécifiées par les expressions de valeur, ou zéro ou plusieurs lignes provenant d’une requête.
La liste des noms des colonnes est optionnelle. L’ordre des noms des colonnes dans la liste n’a pas d’importance particulière, il suffit de nommer les colonnes mises à jour.
Si la liste n’est pas spécifiée, alors PostgreSQL utilisera implicitement la liste de toutes les colonnes de la table dans l’ordre de leur déclaration, ou les N premiers noms de colonnes si seules N valeurs de colonnes sont fournies dans la clause VALUES ou dans la requête.
Astuce
Cette dernière pratique est à éviter car elle rend votre code sensible aux modifications de structures : ajout de champs, modification de l’ordre des champs… Cela arrive plus facilement qu’on ne le croit.
Prenez l’habitude de nommer les champs à renseigner.
Chaque colonne absente de la liste, implicite ou explicite, se voit attribuer sa valeur par défaut, s’il y en a une ou NULL dans le cas contraire. Les expressions de colonnes qui ne correspondent pas au type de données déclarées sont transtypées automatiquement dans la mesure du possible. Si vous avez défini des triggers avant insertion, ils se déclencheront aussi.
Dans l’exemple suivant, seules deux colonnes sur cinq sont renseignées à l’insertion :
INSERT avec liste d’expressions
La clause VALUES permet de définir une liste d’expressions qui va constituer la ligne à insérer dans la base de données. Les éléments de cette liste d’expression sont séparés par une virgule. Cette liste d’expression est composée de constantes ou d’appels à des fonctions retournant une valeur, pour obtenir par exemple la date courante ou la prochaine valeur d’une séquence. Les valeurs fournies par la clause VALUES ou par la requête sont associées à la liste explicite ou implicite des colonnes de gauche à droite.
Exemples
Insertion d’une ligne dans la table stock :
Insertion d’une ligne dans la table vin :
INSERT à partir d’un SELECT
L’ordre INSERT peut aussi prendre une requête SQL en entrée. Dans ce cas, INSERT va insérer autant de lignes dans la table d’arrivée qu’il y a de lignes retournées par la requête SELECT. L’ordre des colonnes retournées par SELECT doit correspondre exactement à l’ordre précisé dans l’ordre INSERT. Leur type de données doit également correspondre.
Exemple :
Insertion dans une table stock2 à partir d’une requête SELECT sur la table stock1 :
Mise à jour de données : UPDATE
- Met à jour une ou plusieurs colonnes d’une même ligne
- à partir des valeurs de la requête
- à partir des anciennes valeurs
- à partir d’une requête
SELECT - à partir de valeurs d’une autre table
L’ordre de mise à jour de lignes s’appelle UPDATE.
Construction d’UPDATE
L’ordre UPDATE permet de mettre à jour les lignes d’une table.
L’ordre UPDATE ne met à jour que les lignes qui satisfont les conditions de la clause WHERE. La clause SET permet de définir les colonnes à mettre à jour. Le nom des colonnes mises à jour doivent faire partie de la table mise à jour.
Les valeurs mises à jour peuvent faire référence aux valeurs avant mise à jour de la colonne, dans ce cas on utilise la forme nom_colonne = expression. La partie de gauche référence la colonne à mettre à jour, la partie de droite est une expression qui permet de déterminer la valeur à appliquer à la colonne. La valeur à appliquer peut bien entendu être une référence à une ou plusieurs colonnes et elles peuvent être dérivées par une opération arithmétique.
La clause FROM ne fait pas partie de la norme SQL mais certains SGBDR la supportent, dont PostgreSQL. Elle permet de réaliser facilement la mise à jour d’une table à partir des valeurs d’une ou plusieurs tables annexes. La norme SQL permet aussi de réaliser des mises à jour en utilisant une sous-requête, sans clause FROM.
Exemples :
Mise à jour du prix d’un livre particulier :
Augmentation de 5 % du prix des livres :
Mise à jour d’une table employees à partir des données d’une table bonus_plan :
La même requête avec une sous-requête, conforme à la norme SQL :
Lorsque plusieurs colonnes doivent être mises à jour à partir d’une jointure, il est possible d’utiliser ces deux écritures :
et :
Suppression de données : DELETE
- Supprime les lignes répondant au prédicat
- Syntaxe :
L’ordre DELETE supprime l’ensemble des lignes qui répondent au prédicat de la clause WHERE.
Exemples :
Suppression d’un livre épuisé du catalogue :
Suppression de tous les livres :
Attention
N’oubliez jamais de préciser la clause WHERE !
Astuce
Pour des raisons techniques, il faut savoir qu’il est beaucoup plus rapide de vider une table avec l’ordre TRUNCATE TABLE livres ; qu’avec un DELETE sans clause WHERE.
Clause RETURNING
- Spécifique à PostgreSQL
- Permet de retourner les lignes complètes ou partielles résultants de
INSERT,UPDATEouDELETE - Ancienne (
OLD) et nouvelle version (NEW) (v18+) - Syntaxe :
La clause RETURNING est une syntaxe propre à PostgreSQL et très pratique. Elle permet de retourner les lignes insérées, mises à jour ou supprimées par un ordre DML de modification. Il est également possible de dériver une valeur retournée.
L’emploi de la clause RETURNING peut nécessiter des droits complémentaires sur les objets de la base.
Exemple :
Mise à jour du nombre de bouteilles en stock :
À partir de la version 18, il est possible de récupérer l’ancienne et/ou la nouvelle valeur de chaque champ en utilisant les pseudo-tables OLD et NEW :
Transactions
- ACID
- Atomicité
- un traitement se fait en entier…
- …ou pas du tout
- TCL pour Transaction Control Language
- ouvrir une transaction :
BEGIN - valide une transaction :
COMMIT - annule une transaction :
ROLLBACK - points de sauvegarde :
SAVEPOINT
- ouvrir une transaction :
Les transactions sont une partie essentielle du langage SQL. Elles permettent de rendre atomiques un certain nombre de requêtes. Le résultat de toutes les requêtes regroupées dans une transaction est validé ou pas, mais on ne peut pas enregistrer d’état intermédiaire.
Un client qui ouvre une transaction et déroule des ordres, est isolé des autres sessions, dans le sens où les autres sessions ne voient pas ses modifications avant la validation par COMMIT.
Astuce
Pour les autres sessions, même appartenant au même utilisateur, les données sont soit telles qu’elles étaient avant la transaction, soit telles qu’elles sont devenues après validation.
L’utilisateur qui fait les modifications peut voir les éventuels états intermédiaires d’une transaction entre deux ordres (il peut faire des SELECT sur ce qu’il vient de modifier), mais uniquement depuis la session de la transaction.
Il est impossible de voir les étapes intermédiaires d’un ordre SQL, car une session exécute séquentiellement les ordres, et attend la fin de chaque ordre avant de poursuivre.
Par défaut, une transaction en cours voit les modifications validées dans d’autres sessions parallèles. Ce « niveau d’isolation » peut se changer pour que la transaction ne voit pas les modifications d’autres transaction, comme si la base était figée pendant sa durée.
Le langage SQL définit qu’une transaction peut être ouverte avec BEGIN, et à la fin être validée ou annulée. Ce sont respectivement les ordres COMMIT et ROLLBACK. Il est aussi possible de faire des points de reprise ou de sauvegarde dans une transaction. Ils se font en utilisant l’ordre SAVEPOINT.
Auto-commit et transactions
- Par défaut, PostgreSQL fonctionne en autocommit
- à moins d’ouvrir explicitement une transaction
- Ouvrir une transaction
BEGIN ;
Une transaction débute toujours par un BEGIN ;. (BEGIN TRANSACTION et START TRANSACTION sont des synonymes, mais se rencontrent très peu.)
PostgreSQL fonctionne en autocommit. Autrement dit, sans BEGIN, une requête est considérée comme une transaction complète et n’a donc pas besoin de COMMIT. Celui-ci est implicite.
Pour l’utilisateur, cela est en fait géré par l’outil client, qui ajoute des BEGIN invisibles si on le configure avec autocommit à off. La transaction ne finira qu’avec un COMMIT, un ROLLBACK ou la déconnexion (le ROLLBACK est alors implicite).
Validation ou annulation d’une transaction
- Valider une transaction
COMMIT ;
- Annuler une transaction
ROLLBACK ;
- Sans validation, une transaction est forcément annulée
- Quasi-instantané sous PostgreSQL
Une transaction est toujours terminée par un COMMIT ; quand on veut que les modifications soient définitivement enregistrées. END ; existe aussi mais est rarissime et moins clair.
ROLLBACK quitte la transaction en annulant toutes les modifications qui y ont été faites, donc en revenant à l’état précédant la transaction. D’autres transactions ont pu faire d’autres actions pendant ce temps, elles ne seront pas annulées.
Attention
Ce retour à l’état initial doit se comprendre d’un point de vue logique et pas physique.
Les modifications au sein d’une transaction annulée par un ROLLBACK ont quand même eu une incidence sur le stockage de vos données. Il peut y avoir eu de nombreux changements sur le disque, à nettoyer plus tard par PostgreSQL, avec un impact sur les performances.
N’abusez donc pas des ROLLBACK si vous pouvez l’éviter.
Astuce
Contrairement à certains produits concurrents, PostgreSQL exécute presque instantanément les ordres COMMIT et ROLLBACK.
En simplifiant, PostgreSQL se limite à noter que la transaction est valide ou pas, et que dans le futur les modifications concernées dans les fichiers de données doivent être prises en compte ou ignorées.
Si une session se termine, quelle que soit la raison, la transaction en cours sans COMMIT et sans ROLLBACK est considérée comme annulée.
Exemple :
Avant de retirer une bouteille du stock, on vérifie tout d’abord qu’il reste suffisamment de bouteilles en stock :
Programmation
- Certains langages implémentent des méthodes de gestion des transactions
- PHP, Java, etc.
- Utiliser ces méthodes prioritairement
La plupart des langages permettent de gérer les transactions à l’aide de méthodes ou fonctions particulières. Il est recommandé de les utiliser.
En Java, ouvrir une transaction revient à désactiver l’autocommit :
La transaction est confirmée (COMMIT) avec la méthode suivante :
À l’inverse, elle est annulée (ROLLBACK) avec la méthode suivante :
Points de sauvegarde
- Certains traitements dans une transaction peuvent être annulés
- mais la transaction est atomique
- Définir un point de sauvegarde
SAVEPOINT nom_savepoint ;
- Valider le traitement depuis le dernier point de sauvegarde
RELEASE SAVEPOINT nom_savepoint ;
- Annuler le traitement depuis le dernier point de sauvegarde
ROLLBACK TO SAVEPOINT nom_savepoint ;- et on continue dans la même transaction
Au sein d’une transaction, les points de sauvegarde (ordre SAVEPOINT nom ;) permettent d’encadrer un traitement sur lequel on peut vouloir revenir sans quitter la transaction (par exemple, selon le retour d’un test), ou au cas où un ordre tombe en erreur.
Revenir à l’état du point de sauvegarde se fait avec ROLLBACK TO SAVEPOINT nom ; pour annuler uniquement la partie du traitement voulue, ou pour revenir à l’état d’avant l’erreur, sans annuler le début de la transaction. On peut ensuite continuer.
Les savepoints n’existent qu’au sein de la transaction ; on ne peut bien sûr revenir sur une validation par COMMIT qu’une fois celui-ci terminé.
L’ordre RELEASE SAVEPOINT nom ; permet de « libérer » (oublier) un savepoint précédent ainsi que ceux posés après. C’est surtout utile pour libérer quelques ressources dans des transactions complexes.
Les points de sauvegarde sont des éléments nommés, il convient donc de leur affecter un nom particulier. Leur nom doit être unique dans la transaction courante.
Astuce
N’abusez pas des SAVEPOINT : ils complexifient le code, et trop de ROLLBACK partiels peuvent entraîner des soucis de performance. Les SAVEPOINT sont rarement nécessaires quand on crée des transactions vraiment atomiques en « tout ou rien ». Réservez-les aux transactions vraiment complexes.
Exemple :
Transaction avec un point de sauvegarde et la gestion de l’erreur :
Conclusion
- SQL : toujours un traitement d’ensembles d’enregistrements
- c’est le côté relationnel
- Pour les définitions d’objets
CREATE,ALTER,DROP
- Pour les données
INSERT,UPDATE,DELETE
Le standard SQL permet de traiter des ensembles d’enregistrements, que ce soit en lecture, en insertion, en modification et en suppression. Les ensembles d’enregistrements sont généralement des tables qui, comme tous les autres objets, sont créées (CREATE), modifiées (ALTER) et/ou supprimées (DROP).
Questions
Quiz
Travaux pratiques
La version en ligne des solutions de ces TP est disponible sur https://dali.bo/s30_solutions.
Cet exercice utilise la base tpc. Si vous ne l’avez pas déjà, la base tpc (dump de 31 Mo, pour 267 Mo sur le disque au final) et ses utilisateurs peuvent être installés comme suit :
Les mots de passe sont dans le script /tmp/tpc_roles.sql. Pour vous connecter :
Pour cet exercice, les modifications de schéma doivent être effectuées par un rôle ayant suffisamment de droits pour modifier son schéma. Le rôle tpc_admin a les droits suffisants.
Ajouter une colonne
textà la tablecontacts. Cette colonne va permettre de stocker l’adresse e-mail des clients et des fournisseurs. Ajouter également un commentaire décrivant cette colonne dans le catalogue de PostgreSQL (utiliser la commandeCOMMENT).
Mettre à jour la table des contacts pour indiquer l’adresse e-mail de Client6657 qui est
client6657@dalibo.com.
Ajouter une contrainte d’intégrité qui valide que la valeur de la colonne
@).
Valider que la contrainte fonctionne dans une transaction de test.
Déterminer quels sont les contacts qui disposent d’une adresse e-mail et affichez leur nom ainsi que le code de leur pays.
La génération des numéros de commande est actuellement réalisée à l’aide de la séquence
commandes_commande_id_seq. Cette méthode ne permet pas de garantir que tous les numéros de commande se suivent. Proposer une solution pour sérialiser la génération des numéros de commande. Autrement dit, proposer une méthode pour obtenir un numéro de commande sans avoir de « trou » dans la séquence en cas d’échec d’une transaction.
Noter le nombre de lignes de la table
pieces. Dans une transaction, majorer de 5% le prix des pièces de moins de 1500 € et minorer de 5 % le prix des pièces dont le prix actuel est égal ou supérieur à 1500 €. Vérifier que le nombre de lignes mises à jour au total correspond au nombre total de lignes de la tablepieces.
Dans une même transaction, créer un nouveau client en incluant l’ajout de l’ensemble des informations requises pour pouvoir le contacter. Un nouveau client a un solde égal à 0.
Créer une nouvelle table
mode_expeditionavec deux colonnes :
mode_exp_idun entier auto incrémenté qui sera la clé primaire de la table ;nomune chaîne de 10 charactères maximum, non nulle.
Insérer les différentes valeurs possible de
lignes_commandes.mode_expeditiondans la nouvelle table et afficher les données insérées.
Ajouter une colonne
mode_exp_idàlignes_commandes, l’alimenter avec les bons id et créer une clé etrangère entrelignes_commandes.mode_exp_idetmode_expedition.mode_exp_id
Travaux pratiques (solutions)
Cet exercice utilise la base tpc. Si vous ne l’avez pas déjà, la base tpc (dump de 31 Mo, pour 267 Mo sur le disque au final) et ses utilisateurs peuvent être installés comme suit :
Les mots de passe sont dans le script /tmp/tpc_roles.sql. Pour vous connecter :
Ajouter une colonne
textà la tablecontacts. Cette colonne va permettre de stocker l’adresse e-mail des clients et des fournisseurs. Ajouter également un commentaire décrivant cette colonne dans le catalogue de PostgreSQL (utiliser la commandeCOMMENT).
Mettre à jour la table des contacts pour indiquer l’adresse e-mail de Client6657 qui est
client6657@dalibo.com.
Vérifier les résultats :
Ajouter une contrainte d’intégrité qui valide que la valeur de la colonne
@).
Cette expression régulière est simplifiée et simpliste pour les besoins de l’exercice. Des expressions régulières plus complexes permettent de valider réellement une adresse e-mail.
Voici un exemple un tout petit peu plus évolué en utilisant une expression rationnelle simple, ici pour vérifier que la chaîne précédant le caractère @ contient au moins un caractère, et que la chaîne le suivant est une chaîne de caractères contenant un point :
Valider que la contrainte fonctionne dans une transaction de test.
Démarrer la transaction :
Tenter de mettre à jour la table contacts avec une adresse e-mail ne répondant pas à la contrainte :
L’ordre UPDATE retourne l’erreur suivante, indiquant que l’expression régulière est fonctionnelle :
La transaction doit être ensuite annulée :
Note: lorsqu’une transaction échoue comme ici, PostgreSQL exécutera un ROLLBACK même si la commande COMMIT lui est envoyée.
Déterminer quels sont les contacts qui disposent d’une adresse e-mail et affichez leur nom ainsi que le code de leur pays.
La génération des numéros de commande est actuellement réalisée à l’aide de la séquence
commandes_commande_id_seq. Cette méthode ne permet pas de garantir que tous les numéros de commande se suivent. Proposer une solution pour sérialiser la génération des numéros de commande. Autrement dit, proposer une méthode pour obtenir un numéro de commande sans avoir de « trou » dans la séquence en cas d’échec d’une transaction.
La solution la plus simple pour imposer la sérialisation des numéros de commandes est d’utiliser une table de séquences. Une ligne de cette table correspondra au compteur des numéros de commande.
L’obtention d’un nouveau numéro de commande sera réalisé dans la transaction de création de la commande de la façon suivante :
L’ordre UPDATE pose un verrou exclusif sur la ligne mise à jour. Tant que la mise à jour n’aura pas été validée ou annulée par COMMIT ou ROLLBACK, le verrou posé va bloquer toutes les autres transactions qui tenteraient de mettre à jour cette ligne. De cette façon, toutes les transactions seront sérialisées.
Concernant la génération des numéros de séquence, si la transaction est annulée, alors le compteur sequence retrouvera sa valeur précédente et la transaction suivante obtiendra le même numéro de séquence. Si la transaction est validée, alors le compteur sequence est incrémenté. La transaction suivante verra alors cette nouvelle valeur et non plus l’ancienne. Cette méthode garantit qu’il n’y ait pas de rupture de séquence.
Il va de soi que les transactions de création de commandes doivent être extrêmement courtes. Si une telle transaction est bloquée, toutes les transactions suivantes seront également bloquées, paralysant ainsi tous les utilisateurs de l’application.
Le fait qu’une sequence peut avoir des trous n’est généralement pas un problème.
Noter le nombre de lignes de la table
pieces. Dans une transaction, majorer de 5% le prix des pièces de moins de 1500 € et minorer de 5 % le prix des pièces dont le prix actuel est égal ou supérieur à 1500 €. Vérifier que le nombre de lignes mises à jour au total correspond au nombre total de lignes de la tablepieces.
Au total, la transaction a mis à jour 214200 (99922+114278) lignes, soit 14200 lignes de trop mises à jour.
Annuler la mise à jour :
Explication : Le premier UPDATE a majoré de 5 % les pièces dont le prix est inférieur à 1500 €. Or, tous les prix supérieurs à 1428,58 € passent la barre des 1500 € après le premier UPDATE. Le second UPDATE minore les pièces dont le prix est égal ou supérieur à 1500 €, ce qui inclue une partie des prix majorés par le précédent UPDATE. Certaines lignes ont donc subies deux modifications au lieu d’une. L’instruction CASE du langage SQL, qui sera abordée dans le prochain module, propose une solution à ce genre de problématique :
ou plus simplement :
Dans une même transaction, créer un nouveau client en incluant l’ajout de l’ensemble des informations requises pour pouvoir le contacter. Un nouveau client a un solde égal à 0.
Créer une nouvelle table
mode_expeditionavec deux colonnes :
mode_exp_idun entier auto incrémenté qui sera la clé primaire de la table ;nomune chaine de 10 charactères maximum non nulle.
Insérer les différentes valeurs possible de
lignes_commandes.mode_expeditiondans la nouvelle table et afficher les données insérées.
Ajouter une colonne
mode_exp_idàlignes_commandes, l’alimenter avec les bons id et créer une clé etrangère entrelignes_commandes.mode_exp_idetmode_expedition.mode_exp_id
Afin de supprimer la colonne mode_expedition la commande suivante peut être utilisée. Nous ne le ferons pas ici afin d’éviter d’interférer avec d’autres TP.