Après la définition des objets, leur lecture et leur écriture
Aller plus loin dans l’écriture de requêtes avec :
les jointures
les sous-requêtes
les vues
les fonctions
Maintenant que nous avons vu comment définir des objets, comment lire des données provenant de relation et comment écrire des données, nous allons pousser vers les perfectionnements du langage SQL. Nous allons notamment aborder la lecture de plusieurs tables en même temps, que ce soit par des jointures ou par des sous-requêtes.
Les exemples suivants utilisent souvent la base cave. Si vous ne l’avez pas déjà, la base cave (dump de 2,6 Mo, pour 71 Mo sur le disque au final) peut être téléchargée et restaurée ainsi :
Exemple 4-1Exemple 4-1 - code ou sortie extraite du manuel DEV1.
curl -kL https://dali.bo/tp_cave -o cave.dump
psql -c "CREATE ROLE caviste LOGIN PASSWORD 'caviste'"psql -c "CREATE DATABASE cave OWNER caviste"pg_restore -d cave cave.dump
# NB : une erreur sur un schéma 'public' existant est normale
Valeur NULL
Comment représenter une valeur que l’on ne connaît pas ?
valeur NULL
Trois sens possibles pour NULL :
valeur inconnue
valeur inapplicable
absence de valeur
Logique à 3 états
Le standard SQL définit très précisément la valeur que doit avoir une colonne dont on ne connaît pas la valeur. Il faut utiliser le mot clé NULL. En fait, ce mot clé est utilisé dans trois cas : pour les valeurs inconnues, pour les valeurs inapplicables et pour une absence de valeurs.
Avertissement
Chris J. Date a écrit :
La valeur NULL telle qu’elle est implémentée dans SQL peut poser plus de problèmes qu’elle n’en résout. Son comportement est parfois étrange et est source de nombreuses erreurs et de confusions.
Éviter d’utiliser NULL le plus possible
utiliser NULL correctement lorsqu’il le faut
Il ne faut utiliser NULL que lorsque cela est réellement nécessaire. La gestion des valeurs NULL est souvent source de confusions et d’erreurs, ce qui explique qu’il est préférable de l’éviter tant qu’on n’entre pas dans les trois cas vu ci-dessus (valeur inconnue, valeur inapplicable, absence de valeur).
Assignation de NULL
Assignation de NULL pour INSERT et UPDATE
Explicitement :
NULL est indiqué explicitement dans les assignations
Implicitement :
la colonne n’est pas affectée par INSERT
et n’a pas de valeur par défaut
Empêcher la valeur NULL
contrainte NOT NULL
Il est possible de donner le mot-clé NULL pour certaines colonnes dans les INSERT et les UPDATE. Si jamais une colonne n’est pas indiquée dans un INSERT, elle aura comme valeur sa valeur par défaut (très souvent, il s’agit de NULL). Si jamais on veut toujours avoir une valeur dans une colonne particulière, il faut utiliser la clause NOT NULL lors de l’ajout de la colonne. C’est le cas pour les clés primaires par exemple.
Voici quelques exemples d’insertion et de mise à jour :
Exemple 4-2Exemple 4-2 - code ou sortie extraite du manuel DEV1.
Tableau 4-1Tableau 4-1 - sortie tabulaire ou résultat extrait du manuel DEV1.
L’affichage (null) dans psql est obtenu avec la méta-commande :
Exemple 4-4Exemple 4-4 - code ou sortie extraite du manuel DEV1.
\pset null (null)
Calculs avec NULL
Utilisation dans un calcul
propagation de NULL
NULL est inapplicable
le résultat vaut NULL
La valeur NULL est définie comme inapplicable. Ainsi, si elle présente dans un calcul, elle est propagée sur l’ensemble du calcul : le résultat vaudra NULL.
Exemples de calcul
Calculs simples :
Exemple 4-5Exemple 4-5 - code ou sortie extraite du manuel DEV1.
SELECT1+2ASresultat;
 resultat
----------
        3
Tableau 4-2Tableau 4-2 - sortie tabulaire ou résultat extrait du manuel DEV1.Exemple 4-6Exemple 4-6 - code ou sortie extraite du manuel DEV1.
SELECT1+2+NULLASresultat;
 resultat
----------
  (null)
Tableau 4-3Tableau 4-3 - sortie tabulaire ou résultat extrait du manuel DEV1.
Calcul à partir de l’âge :
Exemple 4-7Exemple 4-7 - code ou sortie extraite du manuel DEV1.
Tableau 4-5Tableau 4-5 - sortie tabulaire ou résultat extrait du manuel DEV1.
L’affichage (null) est obtenu avec la méta-commande \pset null (null) du shell psql.
NULL et les prédicats
Dans un prédicat du WHERE :
opérateur IS NULL ou IS NOT NULL
AND :
vaut false si NULL AND false
vaut NULL si NULL AND true ou NULL AND NULL
OR :
vaut true si NULL OR true
vaut NULL si NULL OR false ou NULL OR NULL
Les opérateurs de comparaisons classiques ne sont pas fonctionnels avec une valeur NULL. Du fait de la logique à trois états de PostgreSQL, une comparaison avec NULL vaut toujours NULL, ainsi expression = NULL vaudra toujours NULL et de même pour expression <> NULL vaudra toujours NULL. Cette comparaison ne vaudra jamais ni vrai, ni faux.
De ce fait, il existe les opérateurs de prédicats IS NULL et IS NOT NULL qui permettent de vérifier qu’une expression est NULL ou n’est pas NULL.
Tableau 4-9Tableau 4-9 - sortie tabulaire ou résultat extrait du manuel DEV1.
COALESCE
Remplacer NULL par une autre valeur
COALESCE(attribut, …);
Cette fonction permet de tester une colonne et de récupérer sa valeur si elle n’est pas NULL et une autre valeur dans le cas contraire. Elle peut avoir plus de deux arguments. Dans ce cas, la première expression de la liste qui ne vaut pas NULL sera retournée par la fonction.
Voici quelques exemples :
Remplace les prénoms non-renseignés par la valeur X dans le résultat :
Exemple 4-13Exemple 4-13 - code ou sortie extraite du manuel DEV1.
SELECTnom,COALESCE(prenom,'X')FROMpersonnes;
   nom    | coalesce
----------+----------
 Lagaffe  | Gaston
 Fantasio | X
 Prunelle | Léon
Tableau 4-10Tableau 4-10 - sortie tabulaire ou résultat extrait du manuel DEV1.
Cette fonction est efficace également pour la concaténation précédente :
Exemple 4-14Exemple 4-14 - code ou sortie extraite du manuel DEV1.
Tableau 4-11Tableau 4-11 - sortie tabulaire ou résultat extrait du manuel DEV1.
Agrégats
Regroupement de données
Calculs d’agrégats
Comme son nom l’indique, l’agrégation permet de regrouper des données, qu’elles viennent d’une ou de plusieurs colonnes. Le but est principalement de réaliser des calculs sur les données des lignes regroupées.
Regroupement de données
Regroupement de données :
GROUP BY expression [, …]
- Chaque groupe de données est ensuite représenté sur une seule ligne

- Permet d’appliquer des calculs sur les ensembles regroupés

- comptage, somme, moyenne, etc.

La clause `GROUP BY` permet de réaliser des regroupements de données. Les données regroupées sont alors représentées sur une seule ligne. Le principal intérêt de ces regroupements est de permettre de réaliser des calculs sur ces données.

### Calculs d’agrégats

- Effectuent un calcul sur un ensemble de valeurs
- somme, moyenne, etc.
- Retournent `NULL` si l’ensemble est vide
- sauf `count()`

Nous allons voir les différentes fonctions d’agrégats disponibles.

### Agrégats simples

- Comptage :

```sql
count (expression)
compte les lignes : count(*)
compte les valeurs renseignées : count (colonne)
Valeur minimale :
min (expression)
- Valeur maximale :

```sql
max (expression)
La fonction count() permet de compter les éléments. La fonction est appelée de deux façons.
La première forme consiste à utiliser count(*) qui revient à transmettre la ligne complète à la fonction d’agrégat. Ainsi, toute ligne transmise à la fonction sera comptée, même si elle n’est composée que de valeurs NULL. On rencontre parfois une forme du type count(1), qui transmet une valeur arbitraire à la fonction, et qui permettait d’accélérer le temps de traitement sur certains SGBD mais qui reste sans intérêt avec PostgreSQL.
La seconde forme consiste à utiliser une expression, par exemple le nom d’une colonne : count(nom_colonne). Dans ce cas-là, seules les valeurs renseignées, donc non NULL, seront prises en compte. Les valeurs NULL seront exclues du comptage.
La fonction min() permet de déterminer la valeur la plus petite d’un ensemble de valeurs données. La fonction max() permet à l’inverse de déterminer la valeur la plus grande d’un ensemble de valeurs données. Les valeurs NULL sont bien ignorées. Ces deux fonctions permettent de travailler sur des données numériques, mais fonctionnent également sur les autres types de données comme les chaînes de caractères.
Exemple 4-15Exemple 4-15 - code ou sortie extraite du manuel DEV1.
CREATETABLEtest(xINTEGER);-- insertion de cinq lignes dans la table test
INSERTINTOtest(x)VALUES(1),(2),(2),(NULL),(NULL);SELECTx,count(*)AScount_etoile,count(x)AScount_xFROMtestGROUPBYx;
Tableau 4-12Tableau 4-12 - sortie tabulaire ou résultat extrait du manuel DEV1.
Déterminer la date de naissance de la personne la plus jeune :
Exemple 4-16Exemple 4-16 - code ou sortie extraite du manuel DEV1.
SELECTMAX(date_naissance)FROMpersonnes;
    max
------------
 1957-02-28
Tableau 4-13Tableau 4-13 - sortie tabulaire ou résultat extrait du manuel DEV1.
Calculs d’agrégats
Moyenne :
avg (expression)
- Somme :

```sql
sum (expression)
Écart-type :
stddev (expression)
- Variance :

```sql
variance (expression)
La fonction avg() permet d’obtenir la moyenne d’un ensemble de valeurs données. La fonction sum() permet, quant à elle, d’obtenir la somme d’un ensemble de valeurs données. Enfin, les fonctions stddev() et variance() permettent d’obtenir respectivement l’écart-type et la variance d’un ensemble de valeurs données.
Ces fonctions retournent NULL si aucune donnée n’est applicable. Elles ne prennent en compte que des valeurs numériques.
Tableau 4-17Tableau 4-17 - sortie tabulaire ou résultat extrait du manuel DEV1.Exemple 4-22Exemple 4-22 - code ou sortie extraite du manuel DEV1.
SELECTcorr(y,x)FROMtest;
       corr
-------------------
 0.999962873745297
Tableau 4-18Tableau 4-18 - sortie tabulaire ou résultat extrait du manuel DEV1.
Clause HAVING
Filtrer sur des regroupements
HAVING
WHERE s’applique sur les lignes lues
HAVING s’applique sur les lignes groupées
La clause HAVING permet de filtrer les résultats sur les regroupements réalisés par la clause GROUP BY. Il est possible d’utiliser une fonction d’agrégat dans la clause HAVING.
La clause HAVING est toujours accompagnée de la clause GROUP BY. La clause GROUP BY quant à elle n’est pas toujours accompagnée de la clause HAVING.
Il faudra néanmoins faire attention à ne pas utiliser la clause HAVING comme clause de filtrage des données lues par la requête. La clause HAVING ne doit permettre de filtrer que les données traitées par la requête.
Ainsi, si l’on souhaite connaître le nombre de vins rouge référencés dans le catalogue. La requête va donc exclure toutes les données de la table vin qui ne correspondent pas au filtre type_vin = 3. Pour réaliser cela, on utilisera la clause WHERE.
En revanche, si l’on souhaite connaître le nombre de vins par type de cépage si ce nombre est supérieur à 2030, on utilisera la clause HAVING.
Exemples
Exemple 4-23Exemple 4-23 - code ou sortie extraite du manuel DEV1.
Tableau 4-19Tableau 4-19 - sortie tabulaire ou résultat extrait du manuel DEV1.
Si la colonne correspondant à la fonction d’agrégat est renommée avec la clause AS, il n’est pas possible d’utiliser le nouveau nom au sein de la clause HAVING. Par exemple :
Exemple 4-24Exemple 4-24 - code ou sortie extraite du manuel DEV1.
Exemple 4-25Exemple 4-25 - code ou sortie extraite du manuel DEV1.
ERROR: column "nombre" does not exist
Sous-requêtes
Corrélation requête/sous-requête
Sous-requêtes retournant une seule ligne
Sous-requêtes retournant une liste de valeur
Sous-requêtes retournant un ensemble
Sous-requêtes retournant un ensemble vide ou non-vide
Corrélation requête/sous-requête
Fait référence à la requête principale
Peut utiliser une valeur issue de la requête principale
Une sous-requête peut faire référence à des variables de la requête principale. Ces variables seront ainsi transformées en constante à chaque évaluation de la sous-requête.
La corrélation requête/sous-requête permet notamment de créer des clauses de filtrage dans la sous-requête en utilisant des éléments de la requête principale.
Qu’est-ce qu’une sous-requête ?
Une requête imbriquée dans une autre requête
Le résultat de la requête principale dépend du résultat de la sous-requête
Encadrée par des parenthèses : ( et )
Une sous-requête consiste à exécuter une requête à l’intérieur d’une autre requête. La requête principale peut être une requête de sélection (SELECT) ou une requête de modification (INSERT, UPDATE, DELETE). La sous-requête est obligatoirement un SELECT.
Le résultat de la requête principale dépend du résultat de la sous-requête. La requête suivante effectue la sélection des colonnes d’une autre requête, qui est une sous-requête. La sous-requête effectue une lecture de la table appellation. Son résultat est transformé en un ensemble qui est nommé requete_appellation :
Exemple 4-26Exemple 4-26 - code ou sortie extraite du manuel DEV1.
Tableau 4-20Tableau 4-20 - sortie tabulaire ou résultat extrait du manuel DEV1.
Utiliser une seule ligne
La sous-requête ne retourne qu’une seule ligne
sinon une erreur est levée
Positionnée
au niveau de la liste des expressions retournées par SELECT
au niveau de la clause WHERE
au niveau d’une clause HAVING
La sous-requête peut être positionnée au niveau de la liste des expressions retournées par SELECT. La sous-requête est alors généralement un calcul d’agrégat qui ne donne en résultat qu’une seule colonne sur une seule ligne. Ce type de sous-requête est peu performant. Elle est en effet appelée pour chaque ligne retournée par la requête principale.
La requête suivante permet d’obtenir le cumul du nombre de bouteilles année par année.
Exemple 4-27Exemple 4-27 - code ou sortie extraite du manuel DEV1.
Les sous-requêtes retournant une liste de valeur sont plus fréquemment utilisées. Ce type de sous-requête permet de filtrer les résultats de la requête principale à partir des résultats de la sous-requête.
Clause IN
Exemple 4-29Exemple 4-29 - code ou sortie extraite du manuel DEV1.
expressionIN(sous-requete)
L’expression de gauche est évaluée et vérifiée avec la liste de valeurs de droite
IN vaut true
si l’expression de gauche correspond à un élément de la liste de droite
IN vaut false
si aucune correspondance n’est trouvée et la liste ne contient pas NULL
IN vaut NULL
si l’expression de gauche vaut NULL
si aucune valeur ne correspond et la liste contient NULL
La clause IN dans la requête principale permet alors d’exploiter le résultat de la sous-requête pour sélectionner les lignes dont une colonne correspond à une valeur retournée par la sous-requête.
L’opérateur IN retourne true si la valeur de l’expression de gauche est trouvée au moins une fois dans la liste de droite. La liste de droite peut contenir la valeur NULL dans ce cas :
Exemple 4-30Exemple 4-30 - code ou sortie extraite du manuel DEV1.
SELECT1IN(1,2,NULL)ASin;
 in
---
 t
Tableau 4-22Tableau 4-22 - sortie tabulaire ou résultat extrait du manuel DEV1.
Si aucune correspondance n’est trouvée entre l’expression de gauche et la liste de droite, alors IN vaut false :
Exemple 4-31Exemple 4-31 - code ou sortie extraite du manuel DEV1.
SELECT1IN(2,4)ASin;
 in
---
 f
Tableau 4-23Tableau 4-23 - sortie tabulaire ou résultat extrait du manuel DEV1.
Mais IN vaut NULL si aucune correspondance n’est trouvée et que la liste de droite contient au moins une valeur NULL :
Exemple 4-32Exemple 4-32 - code ou sortie extraite du manuel DEV1.
SELECT1IN(2,4,NULL)ASin;
   in
--------
 (null)
Tableau 4-24Tableau 4-24 - sortie tabulaire ou résultat extrait du manuel DEV1.
IN vaut également NULL si l’expression de gauche vaut NULL :
Exemple 4-33Exemple 4-33 - code ou sortie extraite du manuel DEV1.
SELECTNULLIN(2,4)ASin;
   in
--------
 (null)
Tableau 4-25Tableau 4-25 - sortie tabulaire ou résultat extrait du manuel DEV1.
Exemples
La requête suivante permet de sélectionner les bouteilles du stock de la cave dont la contenance est comprise entre 0,3 litre et 1 litre. Pour répondre à la question, la sous-requête retourne les identifiants de contenant qui correspondent à la condition. La requête principale ne retient alors que les lignes dont la colonne contenant_id correspond à une valeur d’identifiant retournée par la sous-requête.
Exemple 4-34Exemple 4-34 - code ou sortie extraite du manuel DEV1.
Exemple 4-35Exemple 4-35 - code ou sortie extraite du manuel DEV1.
expressionNOTIN(sous-requete)
L’expression de droite est évaluée et vérifiée avec la liste de valeurs de gauche
NOT IN vaut true
si aucune correspondance n’est trouvée et la liste ne contient pas NULL
NOT IN vaut false
si l’expression de gauche correspond à un élément de la liste de droite
NOT IN vaut NULL
si l’expression de gauche vaut NULL
si aucune valeur ne correspond et la liste contient NULL
À l’inverse, la clause NOT IN permet dans la requête principale de sélectionner les lignes dont la colonne impliquée dans la condition ne correspond pas aux valeurs retournées par la sous-requête.
La requête suivante permet de sélectionner les bouteilles du stock dont la contenance n’est pas inférieure à 2 litres.
Exemple 4-36Exemple 4-36 - code ou sortie extraite du manuel DEV1.
Il est à noter que les requêtes impliquant les clauses IN ou NOT IN peuvent généralement être réécrites sous la forme d’une jointure.
De plus, les optimiseurs SQL parviennent difficilement à optimiser une requête impliquant NOT IN. Il est préférable d’essayer de réécrire ces requêtes en utilisant une jointure.
Avec NOT IN, la gestion des valeurs NULL est à l’inverse de celle de la clause IN :
Si une correspondance est trouvée, NOT IN vaut false :
Exemple 4-37Exemple 4-37 - code ou sortie extraite du manuel DEV1.
SELECT1NOTIN(1,2,NULL)ASnotin;
 notin
-------
 f
Tableau 4-26Tableau 4-26 - sortie tabulaire ou résultat extrait du manuel DEV1.
Si aucune correspondance n’est trouvée, NOT IN vaut true :
Exemple 4-38Exemple 4-38 - code ou sortie extraite du manuel DEV1.
SELECT1NOTIN(2,4)ASnotin;
 notin
-------
 t
Tableau 4-27Tableau 4-27 - sortie tabulaire ou résultat extrait du manuel DEV1.
Si aucune correspondance n’est trouvée mais que la liste de valeurs de droite contient au moins un NULL, NOT IN vaut NULL :
Exemple 4-39Exemple 4-39 - code ou sortie extraite du manuel DEV1.
SELECT1NOTIN(2,4,NULL)ASnotin;
 notin
--------
 (null)
Tableau 4-28Tableau 4-28 - sortie tabulaire ou résultat extrait du manuel DEV1.
Si l’expression de gauche vaut NULL, alors NOT IN vaut NULL également :
Exemple 4-40Exemple 4-40 - code ou sortie extraite du manuel DEV1.
SELECTNULLIN(2,4)ASnotin;
 notin
--------
 (null)
Tableau 4-29Tableau 4-29 - sortie tabulaire ou résultat extrait du manuel DEV1.
Les sous-requêtes retournant des valeurs NULL posent souvent des problèmes avec NOT IN. Il est préférable d’utiliser EXISTS ou NOT EXISTS pour ne pas avoir à se soucier des valeurs NULL.
Clause ANY
Exemple 4-41Exemple 4-41 - code ou sortie extraite du manuel DEV1.
expressionoperateurANY(sous-requete)
L’expression de gauche est comparée au résultat de la sous-requête avec l’opérateur donné
La ligne de gauche est retournée
si le résultat d’au moins une comparaison est vraie
La ligne de gauche n’est pas retournée
si aucun résultat de la comparaison n’est vrai
si l’expression de gauche vaut NULL
si la sous-requête ramène un ensemble vide
La clause ANY, ou son synonyme SOME, permet de comparer l’expression de gauche à chaque ligne du résultat de la sous-requête en utilisant l’opérateur indiqué. Ainsi, la requête de l’exemple avec la clause IN aurait pu être écrite avec = ANY de la façon suivante :
Exemple 4-42Exemple 4-42 - code ou sortie extraite du manuel DEV1.
Exemple 4-43Exemple 4-43 - code ou sortie extraite du manuel DEV1.
expressionoperateurALL(sous-requete)
L’expression de gauche est comparée à tous les résultats de la sous-requête avec l’opérateur donné
La ligne de gauche est retournée
si tous les résultats des comparaisons sont vrais
si la sous-requête retourne un ensemble vide
La ligne de gauche n’est pas retournée
si au moins une comparaison est fausse
si au moins une comparaison est NULL
La clause ALL permet de comparer l’expression de gauche à chaque ligne du résultat de la sous-requête en utilisant l’opérateur de comparaison indiqué.
La ligne de la table de gauche sera retournée si toutes les comparaisons sont vraies ou si la sous-requête retourne un ensemble vide. En revanche, la ligne de la table de gauche sera exclue si au moins une comparaison est fausse ou si au moins une comparaison est NULL.
La requête d’exemple de la clause NOT IN aurait pu être écrite avec <> ALL de la façon suivante :
Exemple 4-44Exemple 4-44 - code ou sortie extraite du manuel DEV1.
La sous-requête peut être utilisée dans la clause FROM afin d’être utilisée comme une table dans la requête principale. La sous-requête devra obligatoirement être nommée avec un alias de table. Lorsqu’elles sont issues d’un calcul, les colonnes résultantes doivent également être nommées avec un alias de colonne afin d’éviter toute confusion ou comportement incohérent.
La requête suivante permet de déterminer le nombre moyen de bouteilles par année :
Exemple 4-45Exemple 4-45 - code ou sortie extraite du manuel DEV1.
Exemple 4-46Exemple 4-46 - code ou sortie extraite du manuel DEV1.
EXISTS(sous-requête)
Intéressant avec une corrélation
La clause EXISTS vérifie la présence ou l’absence de résultats
vrai si l’ensemble est non vide
faux si l’ensemble est vide
EXISTS présente peu d’intérêt sans corrélation entre la sous-requête et la requête principale.
Le prédicat EXISTS est en général plus performant que IN. Lorsqu’une requête utilisant IN ne peut pas être réécrite sous la forme d’une jointure, il est recommandé d’utiliser EXISTS en lieu et place de IN. Et à l’inverse, une clause NOT IN sera réécrite avec NOT EXISTS.
La requête suivante permet d’identifier les vins pour lesquels il y a au moins une bouteille en stock :
Exemple 4-47Exemple 4-47 - code ou sortie extraite du manuel DEV1.
Les jointures permettent d’écrire des requêtes qui impliquent plusieurs tables. Elles permettent de combiner les colonnes de plusieurs tables selon des critères particuliers, appelés conditions de jointures.
Les jointures permettent de tirer parti du modèle de données dans lequel les tables sont associées à l’aide de clés étrangères.
Conditions de jointure : dans JOIN ou dans WHERE ?
Jointure dans clause JOIN
séparation nette jointure et filtrage
plus lisible et maintenable
jointures externes propres
facilite le travail de l’optimiseur
Jointure dans clause WHERE
historique
Bien qu’il soit possible de décrire une jointure interne sous la forme d’une requête SELECT portant sur deux tables dont la condition de jointure est décrite dans la clause WHERE, cette forme d’écriture n’est pas recommandée. Elle est essentiellement historique et se retrouve surtout dans des projets migrés sans modification.
En effet, les conditions de jointures se trouvent mélangées avec les clauses de filtrage, rendant ainsi la compréhension et la maintenance difficiles. Il arrive aussi que, noyé dans les autres conditions de filtrage, l’utilisateur oublie la configuration de jointure, ce qui aboutit à un produit cartésien, n’ayant rien à voir avec le résultat attendu, sans même parler de la lenteur de la requête.
Il est recommandé d’utiliser la syntaxe SQL:92 et d’exprimer les jointures à l’aide de la clause JOIN. D’ailleurs, cette syntaxe est la seule qui soit utilisable pour exprimer simplement et efficacement une jointure externe. Cette syntaxe facilite la compréhension de la requête mais facilite également le travail de l’optimiseur SQL qui peut déduire beaucoup plus rapidement les jointures qu’en analysant la clause WHERE pour déterminer les conditions de jointure et les tables auxquelles elles s’appliquent le cas échéant.
Comparer ces deux exemples d’une requête typique d’ERP pourtant simplifiée :
Exemple 4-48Exemple 4-48 - code ou sortie extraite du manuel DEV1.
Réalise toutes les combinaisons entre les lignes d’une table et les lignes d’une autre
À éviter dans la mesure du possible
peu de cas d’utilisation
peu performant
Le produit cartésien peut être exprimé avec la clause de jointure CROSS JOIN :
Exemple 4-50Exemple 4-50 - code ou sortie extraite du manuel DEV1.
-- préparation du jeu de données
CREATETABLEt1(i1integer,v1integer);CREATETABLEt2(i2integer,v2integer);INSERTINTOt1(i1,v1)VALUES(0,0),(1,1);INSERTINTOt2(i2,v2)VALUES(2,2),(3,3);-- requête CROSS JOIN
SELECT*FROMt1CROSSJOINt2;
Exemple 4-53Exemple 4-53 - code ou sortie extraite du manuel DEV1.
-- quels sont les relevés manquants entre 12h et 14h ?
SELECTid_sonde,heures_relevesFROMsondesCROSSJOINgenerate_series('2013-01-01 12:00:00','2013-01-01 14:00:00',interval'1 hour')series(heures_releves)WHERENOTEXISTS(SELECT1FROMreleves_horairesWHEREreleves_horaires.id_sonde=sondes.id_sondeANDreleves_horaires.heure_releve=series.heures_releves);
Tableau 4-32Tableau 4-32 - sortie tabulaire ou résultat extrait du manuel DEV1.
Jointure interne
Clause INNER JOIN
meilleure lisibilité
facilite le travail de l’optimiseur
Joint deux tables entre elles
Selon une condition de jointure
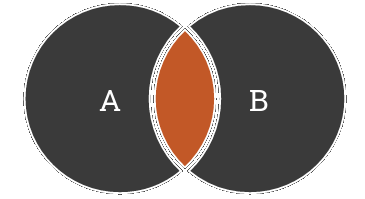
Figure 4-1Figure 4-1 - Schéma de jointure interne (page PDF 190).
Une jointure interne est considérée comme un produit cartésien accompagné d’une clause de jointure pour ne conserver que les lignes qui répondent à la condition de jointure. Les SGBD réalisent néanmoins l’opération plus simplement.
La condition de jointure est généralement une égalité, ce qui permet d’associer entre elles les lignes de la table à gauche et de la table à droite dont les colonnes de condition de jointure sont égales.
La jointure interne est exprimée à travers la clause INNER JOIN ou plus simplement JOIN. En effet, si le type de jointure n’est pas spécifié, l’optimiseur considère la jointure comme étant une jointure interne.
Syntaxe d’une jointure interne
Condition de jointure par prédicats :
table1 [INNER] JOIN table2 ON prédicat […]
- Condition de jointure implicite par liste des colonnes impliquées :

```sql
table1 [INNER] JOIN table2 USING (colonne [, …])
Liste des colonnes de même nom (dangereux) :
table1 NATURAL [INNER] JOIN table2
La clause `ON` permet d’écrire les conditions de jointures sous la forme de prédicats tels qu’on les retrouve dans une clause `WHERE`.
La clause `USING` permet de spécifier les colonnes sur lesquelles porte la jointure. Les tables jointes devront posséder toutes les colonnes sur lesquelles portent la jointure. La jointure sera réalisée en vérifiant l’égalité entre chaque colonne portant le même nom.
La clause `NATURAL` permet de réaliser la jointure entre deux tables en utilisant les colonnes qui portent le même nom sur les deux tables comme condition de jointure. `NATURAL JOIN` est fortement déconseillée car elle peut facilement entraîner des comportements inattendus.
La requête suivante permet de joindre la table appellation avec la table `region` pour déterminer l’origine d’une appellation :
Exemple 4-54Exemple 4-54 - code ou sortie extraite du manuel DEV1.
### Jointure externe à gauche
- Jointure externe à gauche
- ramène le résultat de la jointure interne
- ramène l’ensemble de la table de gauche qui ne peut être joint avec la table de droite
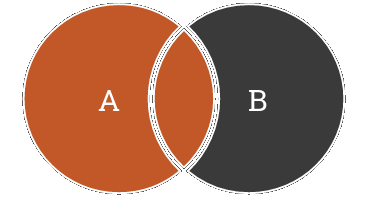
- les attributs de la table de droite sont alors `NULL`Figure 4-2Figure 4-2 - Schéma de jointure externe gauche (page PDF 192).Il existe deux types de jointures externes : la jointure à gauche et la jointure à droite. Cela ne concerne que l’ordre de la jointure, le traitement en lui-même est identique.
### Jointure externe à droite
- Jointure externe à droite
- ramène le résultat de la jointure interne
- ramène l’ensemble de la table de droite qui ne peut être joint avec la table de gauche
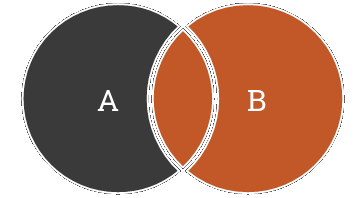
- les attributs de la table de gauche sont alors `NULL`Figure 4-3Figure 4-3 - Schéma de jointure externe droite (page PDF 193).### Jointure externe complète
- Ramène le résultat de la jointure interne
- Ramène l’ensemble de la table de gauche qui ne peut être joint avec la table de droite
- les attributs de la table de droite sont alors `NULL`
- Ramène l’ensemble de la table de droite qui ne peut être joint avec la table de gauche
- les attributs de la table de gauche sont alors `NULL`
### Syntaxe d’une jointure externe à gauche
- Condition de jointure par prédicats :
```sql
table1 LEFT [OUTER] JOIN table2 ON prédicat […]
Condition de jointure implicite par liste des colonnes impliquées :
table1 LEFT [OUTER] JOIN table2 USING (colonne [, …])
- Liste des colonnes implicites :

```sql
table1 NATURAL LEFT [OUTER] JOIN table2
Il existe trois écritures différentes d’une jointure externe à gauche. La clause NATURAL permet de réaliser la jointure entre deux tables en utilisant les colonnes qui portent le même nom sur les deux tables comme condition de jointure.
Les voici en exemple :
par prédicat :
SELECT article.art_titre, auteur.aut_nom FROM article LEFT JOIN auteur ON (article.aut_id=auteur.aut_id) ;
- par liste de colonnes :

```sql
SELECT article.art_titre, auteur.aut_nom FROM article LEFT JOIN auteur USING (aut_id) ;
Syntaxe d’une jointure externe à droite
Condition de jointure par prédicats :
table1 RIGHT [OUTER] JOIN table2 ON prédicat […]
- Condition de jointure implicite par liste des colonnes impliquées :

```sql
table1 RIGHT [OUTER] JOIN table2 USING (colonne [, …])
Liste des colonnes implicites :
table1 NATURAL RIGHT [OUTER] JOIN table2
Les jointures à droite sont moins fréquentes mais elles restent utilisées.

### Syntaxe d’une jointure externe complète

- Condition de jointure par prédicats :

```sql
table1 FULL OUTER JOIN table2 ON prédicat […]
Condition de jointure implicite par liste des colonnes impliquées :
table1 FULL OUTER JOIN table2 USING (colonne [, …])
- Liste des colonnes implicites :

```sql
table1 NATURAL FULL OUTER JOIN table2
Jointure ou sous-requête ?
Jointures
algorithmes très efficaces
ne gèrent pas tous les cas
Sous-requêtes
parfois peu performantes
répondent à des besoins non couverts par les jointures
Les sous-requêtes sont fréquemment utilisées mais elles sont moins performantes que les jointures. Ces dernières permettent d’utiliser des optimisations très efficaces.
Expressions CASE
Équivalent à l’instruction switch en C ou Java
Emprunté au langage Ada
Retourne une valeur en fonction du résultat de tests
CASE permet de tester différents cas. Il s’utilise de la façon suivante :
Exemple 4-55Exemple 4-55 - code ou sortie extraite du manuel DEV1.
SELECTCASEWHENcol1=10THEN'dix'WHENcol1>10THEN'supérieur à 10'ELSE'inférieur à 10'ENDAStestFROMt1;
CASE simple
Exemple 4-56Exemple 4-56 - code ou sortie extraite du manuel DEV1.
Il est possible de tester le résultat d’une expression avec CASE. Dans ce cas, chaque clause WHEN reprendra la valeur à laquelle on souhaite associer une expression particulière :
Exemple 4-57Exemple 4-57 - code ou sortie extraite du manuel DEV1.
Une expression peut être évaluée pour chaque clause WHEN. Dans ce cas, l’expression CASE retourne la première expression qui est vraie. Si une autre peut satisfaire la suivante, elle ne sera pas évaluée.
Par exemple :
Exemple 4-59Exemple 4-59 - code ou sortie extraite du manuel DEV1.
les expressions sont évaluées dans l’ordre d’apparition
Transtypage
le type du retour de l’expression dépend du type de rang le plus élevé de toute l’expression
Imbrication
des expressions CASE à l’intérieur d’autres expressions CASE
Clause ELSE
recommandé
Il est possible de placer plusieurs clauses WHEN. Elles sont évaluées dans leur ordre d’apparition.
Exemple 4-60Exemple 4-60 - code ou sortie extraite du manuel DEV1.
CASEnom_regionWHEN'Afrique'THEN1WHEN'Amérique'THEN2/* l'expression suivante ne sera jamais évaluée */WHEN'Afrique'THEN5WHEN'Asie'THEN1WHEN'Europe'THEN3ELSE0END
Le type de données renvoyé par l’instruction CASE correspond au type indiqué par l’expression au niveau des THEN et du ELSE. Ce doit être le même type. Si les types de données ne correspondent pas, alors PostgreSQL retournera une erreur :
Exemple 4-61Exemple 4-61 - code ou sortie extraite du manuel DEV1.
Exemple 4-62Exemple 4-62 - code ou sortie extraite du manuel DEV1.
ERROR:  invalid input syntax for integer: "inconnu"
LIGNE 7 :     ELSE 'inconnu'
La clause ELSE n’est pas obligatoire mais fortement recommandé. En effet, si une expression CASE ne comporte pas de clause ELSE, alors la base de données ajoutera une clause ELSE NULL à l’expression.
Ainsi l’expression suivante :
Exemple 4-63Exemple 4-63 - code ou sortie extraite du manuel DEV1.
Tableau 4-33Tableau 4-33 - sortie tabulaire ou résultat extrait du manuel DEV1.
Différence entre deux ensembles
Différence entre deux ensembles avec dédoublonnage :
Exemple 4-71Exemple 4-71 - code ou sortie extraite du manuel DEV1.
requete_select1EXCEPTrequete_select2
Différence entre deux ensembles sans dédoublonnage :
Exemple 4-72Exemple 4-72 - code ou sortie extraite du manuel DEV1.
requete_select1EXCEPTALLrequete_select2
L’opérateur ensembliste EXCEPT est l’équivalent de l’opérateur MINUS d’Oracle. Il permet d’obtenir la différence entre deux ensembles : toutes les lignes présentes dans les deux ensembles sont exclues du résultat.
Le dédoublonnage peut être particulièrement coûteux car il implique un tri des données.
Exemples :
L’exemple suivant n’a pas d’autre intérêt que de montrer le résultat de l’opérateur EXCEPT sur deux ensembles simples. La première requête retourne l’ensemble des lignes de la table region alors que la seconde requête retourne la ligne qui correspond au prédicat id = 3. Cette ligne est ensuite retirée du résultat car elle est présente dans les deux ensembles de gauche et de droite :
Exemple 4-73Exemple 4-73 - code ou sortie extraite du manuel DEV1.
 id |          libelle
----+----------------------------
 11 | Cotes du Rhone
 12 | Provence produit a Cassis.
 10 | Beaujolais
 19 | Savoie
  7 | Languedoc-Roussillon
  4 | Loire
  6 | Provence
 16 | Est
  8 | Bordeaux
 14 | Lyonnais
 15 | Auvergne
  2 | Bourgogne
 17 | Forez
  9 | Vignoble du Sud-Ouest
 18 | Charente
 13 | Champagne
  5 | Jura
  1 | Provence et Corse
Tableau 4-34Tableau 4-34 - sortie tabulaire ou résultat extrait du manuel DEV1.
Fonctions de base
Transtypage
Manipulation de chaînes
Manipulation de types numériques
Manipulation de dates
Génération de jeu de données
PostgreSQL propose un nombre conséquent de fonctions permettant de manipuler les différents types de données disponibles. Les étudier de façon exhaustive n’est pas l’objet de ce module. Néanmoins, le manuel de PostgreSQL établit une liste complète des fonctions disponibles dans le SGBD.
Transtypage
Conversion d’un type de données vers un autre type de données
CAST (expression AS type)
expression::type
Les opérateurs de transtypages permettent de convertir une donnée d’un type particulier vers un autre type. La conversion échoue si les types de données sont incompatibles.
Exemples
Transtypage incorrect d’une chaîne de caractères vers un entier :
Exemple 4-74Exemple 4-74 - code ou sortie extraite du manuel DEV1.
SELECT3+'3.5'::integer;
Exemple 4-75Exemple 4-75 - code ou sortie extraite du manuel DEV1.
ERROR:  invalid input syntax for type integer: "3.5"
LIGNE 1 : select 3 + '3.5'::integer ;
                     ^
Astuce
PostgreSQL est volontairement peu flexible pour éviter certaines erreurs subtiles liées à une conversion trop hâtive.
Opérations simples sur les chaînes
Concaténation : chaîne1 || chaîne2
Longueur de la chaîne : char_length(chaîne)
Conversion en minuscules : lower(chaîne)
Conversion en majuscules : upper(chaîne)
L’opérateur de concaténation permet de concaténer deux chaînes de caractères :
Exemple 4-76Exemple 4-76 - code ou sortie extraite du manuel DEV1.
SELECT'Bonjour'||', Monde!';
-----------------
 Bonjour, Monde!
Tableau 4-35Tableau 4-35 - sortie tabulaire ou résultat extrait du manuel DEV1.
Il permet aussi de concaténer une chaîne de caractères avec d’autres types de données :
Exemple 4-77Exemple 4-77 - code ou sortie extraite du manuel DEV1.
SELECT'Texte '||1::integer;
---------
 Texte 1
Tableau 4-36Tableau 4-36 - sortie tabulaire ou résultat extrait du manuel DEV1.
La fonction char_length() permet de connaître la longueur d’une chaîne de caractères :
Exemple 4-78Exemple 4-78 - code ou sortie extraite du manuel DEV1.
SELECTchar_length('Texte'||1::integer);
-------------
           6
Tableau 4-37Tableau 4-37 - sortie tabulaire ou résultat extrait du manuel DEV1.
Les fonctions lower et upper permettent de convertir une chaîne respectivement en minuscule et en majuscule :
Exemple 4-79Exemple 4-79 - code ou sortie extraite du manuel DEV1.
Tableau 4-38Tableau 4-38 - sortie tabulaire ou résultat extrait du manuel DEV1.
-----------------
 BONJOUR, MONDE!
Tableau 4-39Tableau 4-39 - sortie tabulaire ou résultat extrait du manuel DEV1.
Manipulations de chaînes
Extrait une chaîne à partir d’une autre :
substring(chaîne [from int] [for int])
Emplacement d’une sous-chaîne :
position(sous-chaîne in chaîne)
La fonction substring permet d’extraire une chaîne de caractères à partir d’une chaîne en entrée. Il faut lui indiquer, en plus de la chaîne source, la position de départ, et la longeur de la sous-chaîne. Par exemple :
Exemple 4-80Exemple 4-80 - code ou sortie extraite du manuel DEV1.
SELECTsubstring('Bonjour, Monde'from5for4);
 substring
-----------
 our,
Tableau 4-40Tableau 4-40 - sortie tabulaire ou résultat extrait du manuel DEV1.
Notez que vous pouvez aussi utiliser un appel de fonction plus standard :
Exemple 4-81Exemple 4-81 - code ou sortie extraite du manuel DEV1.
SELECTsubstring('Bonjour, Monde',5,4);
 substring
-----------
 our,
Tableau 4-41Tableau 4-41 - sortie tabulaire ou résultat extrait du manuel DEV1.
La fonction position indique la position d’une chaîne de caractères dans la chaîne indiquée. Par exemple :
Exemple 4-82Exemple 4-82 - code ou sortie extraite du manuel DEV1.
SELECTposition(','in'Bonjour, Monde');
 position
----------
        8
Tableau 4-42Tableau 4-42 - sortie tabulaire ou résultat extrait du manuel DEV1.
La combinaison des deux est intéressante :
Exemple 4-83Exemple 4-83 - code ou sortie extraite du manuel DEV1.
SELECTversion();
                            version
-------------------------------------------------------------------
 PostgreSQL 14.2 (Ubuntu 14.2-1.pgdg20.04+1) on x86_64-pc-linux-…
Tableau 4-43Tableau 4-43 - sortie tabulaire ou résultat extrait du manuel DEV1.Exemple 4-84Exemple 4-84 - code ou sortie extraite du manuel DEV1.
SELECT substring(version() from 1 for position(' on' in version()));
    substring
-----------------
 PostgreSQL 14.2
Tableau 4-44Tableau 4-44 - sortie tabulaire ou résultat extrait du manuel DEV1.
Manipulation de types numériques
Opérations arithmétiques
Manipulation de types numériques
Génération de données
Opérations arithmétiques
Addition : +
Soustraction : -
Multiplication : *
Division : /
entière si implique des entiers !
Reste (modulo) : %
Ces opérateurs sont classiques. L’ensemble des opérations arithmétiques disponibles sont documentées dans le manuel.
La principale surprise vient de / qui est par défaut une division entière si des entiers sont seuls impliqués :
Exemple 4-85Exemple 4-85 - code ou sortie extraite du manuel DEV1.
Exemple 4-86Exemple 4-86 - code ou sortie extraite du manuel DEV1.
-- Suite d'entiers, 1 par ligne
SELECTiFROMgenerate_series(0,100,1)i;-- Nombre entre 0 et 1.0
SELECTrandom();-- Entre 1 et 100
SELECT(random()*100)::int;-- Entre 2 bornes (v17+)
SELECTrandom(20.0,50.0);-- numeric
SELECTrandom(-100,100);-- entier
La fonction generate_series est spécifique à PostgreSQL et permet de générer une suite d’entiers compris entre une borne de départ et une borne de fin :
Exemple 4-87Exemple 4-87 - code ou sortie extraite du manuel DEV1.
Tableau 4-46Tableau 4-46 - sortie tabulaire ou résultat extrait du manuel DEV1.
Avec un incrément pour chaque itération :
Exemple 4-88Exemple 4-88 - code ou sortie extraite du manuel DEV1.
SELECTgenerate_series(1,10,4);
 generate_series
-----------------
               1
               5
               9
(3 rows)
Tableau 4-47Tableau 4-47 - sortie tabulaire ou résultat extrait du manuel DEV1.
Cette fonction est aussi utilisée pour générer des lignes à volonté :
Exemple 4-89Exemple 4-89 - code ou sortie extraite du manuel DEV1.
SELECTiFROMgenerate_series(1,10,3)i;
 i
----
  1
  4
  7
 10
(4 lignes)
Tableau 4-48Tableau 4-48 - sortie tabulaire ou résultat extrait du manuel DEV1.
La fonction random() génère un nombre aléatoire, de type double precision (synonyme de float et float8), compris entre 0 et 1.
Exemple 4-90Exemple 4-90 - code ou sortie extraite du manuel DEV1.
SELECTrandom();
      random
-------------------
 0.381810061167926
Tableau 4-49Tableau 4-49 - sortie tabulaire ou résultat extrait du manuel DEV1.
Pour générer un entier compris entre 0 et 100, il suffit de réaliser la requête suivante :
Exemple 4-91Exemple 4-91 - code ou sortie extraite du manuel DEV1.
SELECTround(100*random())::integer;
 round
-------
    74
Tableau 4-50Tableau 4-50 - sortie tabulaire ou résultat extrait du manuel DEV1.
Depuis PostgreSQL 17, il existe une version plus pratique avec deux bornes, et qui peut renvoyer, selon les paramètres, un integer, un bigint, ou un numeric :
Exemple 4-92Exemple 4-92 - code ou sortie extraite du manuel DEV1.
SELECTrandom(1.5,1.9),-- numeric
random(-100,100),-- int
random(1e10,1e10+100);-- bigint
 random | random |   random
--------+--------+-------------
    1.8 |    -22 | 10000000084
Tableau 4-51Tableau 4-51 - sortie tabulaire ou résultat extrait du manuel DEV1.
Il est possible de contrôler la graine du générateur de nombres aléatoires en positionnant le paramètre de session seed :
Exemple 4-93Exemple 4-93 - code ou sortie extraite du manuel DEV1.
SETseed=0.123;
ou à l’aide de la fonction setseed() :
Exemple 4-94Exemple 4-94 - code ou sortie extraite du manuel DEV1.
Retourne la date et l’heure courante : current_timestamp / now()
Les fonctions current_date et current_time permettent d’obtenir respectivement la date courante et l’heure courante. La première fonction retourne le résultat sous la forme d’un type date et la seconde sous la forme d’un type time with time zone.
Préférer current_timestamp et son synonyme now() pour obtenir la date et l’heure courante, le résultat étant de type timestamp with time zone.
Exceptionnellement, les fonctions current_date, current_time et current_timestamp n’ont pas besoin d’être invoquée avec les parenthèses ouvrantes et fermantes typiques de l’appel d’une fonction. En revanche, l’appel de la fonction now() requiert ces parenthèses.
Exemple 4-95Exemple 4-95 - code ou sortie extraite du manuel DEV1.
SELECTcurrent_date;
 current_date
--------------
 2017-10-04
Tableau 4-52Tableau 4-52 - sortie tabulaire ou résultat extrait du manuel DEV1.Exemple 4-96Exemple 4-96 - code ou sortie extraite du manuel DEV1.
Par rapport à une date de référence : age (timestamp, timestamp)
La fonction age(timestamp) permet de déterminer l’âge de la date donnée en paramètre par rapport à la date courante. L’âge sera donné sous la forme d’un type interval.
La forme age(timestamp, timestamp) permet d’obtenir l’âge d’une date par rapport à une autre date, par exemple pour connaître l’âge de Gaston Lagaffe au 5 janvier 1997 :
Exemple 4-102Exemple 4-102 - code ou sortie extraite du manuel DEV1.
SELECTage(date'1997-01-05',date'1957-02-28');
           age
-------------------------
 39 years 10 mons 5 days
Tableau 4-55Tableau 4-55 - sortie tabulaire ou résultat extrait du manuel DEV1.
Tronquer et extraire
Troncature d’une date : date_trunc(text, timestamp)
ex : date_trunc('month' from date_naissance)
Composante de la date : extract(text, timestamp)
ex : extract('year' from date_naissance)
La fonction date_trunc(text, timestamp) permet de tronquer la date à une précision donnée. La précision est exprimée en anglais, et autorise les valeurs suivantes :
microseconds
milliseconds
second
minute
hour
day
week
month
quarter
year
decade
century
millennium
La fonction date_trunc() peut agir sur une donnée de type timestamp, date ou interval. Par exemple, pour arrondir l’âge de Gaston Lagaffe de manière à ne représenter que le nombre d’années :
Exemple 4-103Exemple 4-103 - code ou sortie extraite du manuel DEV1.
Tableau 4-56Tableau 4-56 - sortie tabulaire ou résultat extrait du manuel DEV1.
La fonction extract(text from timestamp) permet d’extraire uniquement une composante donnée d’une date, par exemple l’année. Elle retourne un type de données flottant double precision.
Exemple 4-104Exemple 4-104 - code ou sortie extraite du manuel DEV1.
     soustraction
----------------------
 734502 days 10:23:10
Tableau 4-58Tableau 4-58 - sortie tabulaire ou résultat extrait du manuel DEV1.
L’addition entre deux types de données est plus restreinte. En effet, l’expression de gauche est obligatoirement de type timestamp ou date et l’expression de droite doit être obligatoirement de type time. Le résultat de l’addition permet d’obtenir une donnée de type timestamp, avec ou sans information sur le fuseau horaire selon que cette information soit présente ou non sur l’expression de gauche.
Exemple 4-106Exemple 4-106 - code ou sortie extraite du manuel DEV1.
Quant à la fonction to_date(), elle permet de convertir une chaîne de caractères dans une donnée de type date. La fonction to_timestamp() permet de réaliser la même mais en donnée de type timestamp.
Exemple 4-117Exemple 4-117 - code ou sortie extraite du manuel DEV1.
Le paramètre DateStyle contrôle le format de saisie et de restitution des dates et heures. La documentation de ce paramètre permet de connaître les différentes valeurs possibles. Il reste néanmoins recommandé d’utiliser les fonctions de formatage de date qui permettent de rendre l’application indépendante de la configuration du SGBD.
La norme ISO impose le format de date « année/mois/jour ». La norme SQL est plus permissive et permet de restituer une date au format « jour/mois/année » si le paramètre DateStyle est égal à 'SQL, DMY'.
Exemple 4-118Exemple 4-118 - code ou sortie extraite du manuel DEV1.
SETdatestyle='ISO, DMY';SELECTcurrent_timestamp;
              now
-------------------------------
 2017-10-04 16:36:38.189973+02
Tableau 4-71Tableau 4-71 - sortie tabulaire ou résultat extrait du manuel DEV1.Exemple 4-119Exemple 4-119 - code ou sortie extraite du manuel DEV1.
SETdatestyle='SQL, DMY';
Exemple 4-120Exemple 4-120 - code ou sortie extraite du manuel DEV1.
SELECTcurrent_timestamp;
              now
---------------------------------
 04/10/2017 16:37:04.307034 CEST
Tableau 4-72Tableau 4-72 - sortie tabulaire ou résultat extrait du manuel DEV1.
Tableau 4-73Tableau 4-73 - sortie tabulaire ou résultat extrait du manuel DEV1.
Vues
Tables virtuelles
définies par une requête SELECT
définition stockée dans le catalogue de la base de données
Objectifs
masquer la complexité d’une requête
masquer certaines données à l’utilisateur
Vues ≠ vues matérialisées
Les vues sont des « tables virtuelles » qui permettent d’obtenir le résultat d’une requête SELECT. Sa définition est stockée dans le catalogue système de la base de données. Le SELECT est exécuté quand la vue est appelée.
De cette façon, il est possible de créer une vue à destination de certains utilisateurs pour combler différents besoins :
permettre d’interroger facilement une vue qui exécute une requête complexe ou lourde à écrire ;
masquer certaines lignes ou certaines colonnes aux utilisateurs, pour amener un niveau de sécurité complémentaire ;
rendre les données plus intelligibles, en nommant mieux les colonnes d’une vue et/ou en simplifiant la structure de données ;
assurer la compatibilité avec d’anciennes requêtes après des modifications…
En plus de cela, les vues permettent d’obtenir facilement des valeurs dérivées d’autres colonnes. Ces valeurs dérivées pourront alors être utilisées simplement en appelant la vue plutôt qu’en réécrivant systématiquement le calcul de dérivation à chaque requête qui le nécessite.
Les vues classiques équivalent à exécuter un SELECT. Il existe des « vues matérialisées », qui ne seront pas développées ici, qui sont des vraies tables créées à partir d’une requête (et rafraîchies uniquement sur demande explicitement).
Création d’une vue
Une vue porte un nom au même titre qu’une table
elle sera nommée avec les mêmes règles
Création d’une vue :
Exemple 4-122Exemple 4-122 - code ou sortie extraite du manuel DEV1.
CREATEVIEWvue(colonne…)ASSELECT…`
Bien qu’une vue n’ait pas de représentation physique directe, elle est accédée au même titre qu’une table avec SELECT et dans certains cas avec INSERT, UPDATE et DELETE. La vue logique ne distingue pas les accès à une vue des accès à une table. De cette façon, une vue doit utiliser les mêmes conventions de nommage qu’une table.
Une vue est créée avec l’ordre SQL CREATE VIEW :
Exemple 4-123Exemple 4-123 - code ou sortie extraite du manuel DEV1.
Le mot clé CREATE VIEW permet de créer une vue. Si elle existe déjà, il est possible d’utiliser CREATE OR REPLACE VIEW qui aura pour effet de créer la vue si elle n’existe pas ou de remplacer la définition de la vue si elle existe déjà. Attention, dans ce dernier cas, les colonnes et les types de données retournés par la vue ne doivent pas changer d’ordre par rapport à l’ordre CREATE original.
La clause nom permet de nommer la vue. La clause nom_colonne, … permet lister explicitement les colonnes retournées par une vue, cette clause est optionnelle mais recommandée pour mieux documenter la vue.
La clause requete correspond simplement à la requête SELECT exécutée lorsqu’on accède à la vue.
Exemple :
Exemple 4-124Exemple 4-124 - code ou sortie extraite du manuel DEV1.
Une vue est lue de la même façon qu’une table. On utilisera donc l’ordre SELECT pour le faire. L’optimiseur de PostgreSQL remplacera l’appel à la vue par la définition de la vue pendant la phase de réécriture de la requête. Le plan d’exécution prendra alors compte des particularités de la vue pour optimiser les accès aux données.
Exemples
Exemple 4-125Exemple 4-125 - code ou sortie extraite du manuel DEV1.
Le droit SELECT autorise un utilisateur à lire une table. Les droits INSERT, UPDATE et DELETE permettent de contrôler les accès en mise à jour à une vue.
Les droits TRUNCATE et REFERENCES n’ont pas d’utilité avec une vue. Ils ne sont tout simplement pas supportés car TRUNCATE n’agit que sur une table et une clé étrangère ne peut être liée d’une table qu’à une autre table.
Les vues sont parfois utilisées pour filtrer les lignes pouvant être lues par l’utilisateur. Cette protection peut être contournée si l’utilisateur a la possibilité de créer une fonction. L’option security_barrier permet d’éviter ce problème.
Exemple :
Exemple 4-127Exemple 4-127 - code ou sortie extraite du manuel DEV1.
CREATETABLEelements(idserial,contenutext,priveboolean);INSERTINTOelements(contenu,prive)VALUES('a',false),('b',false),('c super prive',true),('d',false),('e prive aussi',true);SELECT*FROMelements;
 id |    contenu    | prive
----+---------------+-------
  1 | a             | f
  2 | b             | f
  3 | c super prive | t
  4 | d             | f
  5 | e prive aussi | t
Tableau 4-75Tableau 4-75 - sortie tabulaire ou résultat extrait du manuel DEV1.
La table elements contient cinq lignes, dont trois considérés comme privés. Nous allons donc créer une vue ne permettant de voir que les lignes publiques.
Exemple 4-128Exemple 4-128 - code ou sortie extraite du manuel DEV1.
Exemple 4-129Exemple 4-129 - code ou sortie extraite du manuel DEV1.
SELECT*FROMelements_public;
 id |    contenu    | prive
----+---------------+-------
  1 | a             | f
  2 | b             | f
  3 | c super prive | t
  4 | d             | f
  5 | e prive aussi | t
Tableau 4-76Tableau 4-76 - sortie tabulaire ou résultat extrait du manuel DEV1.Exemple 4-130Exemple 4-130 - code ou sortie extraite du manuel DEV1.
-- Création d'un utilisateur nommé u1
CREATEROLEu1LOGIN;GRANTSELECTONelements_publicTOu1;
La connexion avec l’utilisateur u1 suppose que la configuration nécessaire a été faite par le DBA.
Exemple 4-131Exemple 4-131 - code ou sortie extraite du manuel DEV1.
\c - u1
You are now connected to database "postgres" as user "u1".
Tentative de lecture de la table puis de la vue :
Exemple 4-132Exemple 4-132 - code ou sortie extraite du manuel DEV1.
SELECT*FROMelements;
Exemple 4-133Exemple 4-133 - code ou sortie extraite du manuel DEV1.
ERROR: permission denied for relation elements
Exemple 4-134Exemple 4-134 - code ou sortie extraite du manuel DEV1.
SELECT*FROMelements_public;
 id | contenu | prive
----+---------+-------
  1 | a       | f
  2 | b       | f
  4 | d       | f
Tableau 4-77Tableau 4-77 - sortie tabulaire ou résultat extrait du manuel DEV1.
L’utilisateur u1 n’a pas le droit de lire directement la table elements mais a le droit d’y accéder via la vue elements_public, uniquement pour les lignes dont le champ prive est à false.
Cependant, u1 peut révéler le contenu de elements à travers une fonction spécifique. Cette fonction peut divulguer les informations des lignes de données qu’elle traite avant même qu’elles ne soient filtrées par la vue :
Exemple 4-135Exemple 4-135 - code ou sortie extraite du manuel DEV1.
CREATEORREPLACEFUNCTIONabracadabra(integer,text,boolean)RETURNSboolAS$$BEGIN-- afficher chaque ligne rencontrée
RAISENOTICE'% - % - %',$1,$2,$3;RETURNtrue;END$$LANGUAGEplpgsql-- définir un coût d'exécution très bas pour exécuter
-- cette fonction avant le filtre dans la vue
COST0.0000000000000000000001;
Exemple 4-136Exemple 4-136 - code ou sortie extraite du manuel DEV1.
NOTICE:  1 - a - f
NOTICE:  2 - b - f
NOTICE:  3 - c super prive - t
NOTICE:  4 - d - f
NOTICE:  5 - e prive aussi - t
 id | contenu | prive
----+---------+-------
  1 | a       | f
  2 | b       | f
  4 | d       | f
Tableau 4-78Tableau 4-78 - sortie tabulaire ou résultat extrait du manuel DEV1.
Que s’est-il passé ? pour comprendre, il suffit de regarder le plan d’exécution de cette requête avec la commande EXPLAIN :
Exemple 4-137Exemple 4-137 - code ou sortie extraite du manuel DEV1.
                      QUERY PLAN
---------------------------------------------------------------
 Seq Scan on elements  (cost=0.00..28.15 rows=202 width=37)
   Filter: (abracadabra(id, contenu, prive) AND
           CASE WHEN ("current_user"() = 'u1'::name)
                THEN (NOT prive) ELSE true END)
Tableau 4-79Tableau 4-79 - sortie tabulaire ou résultat extrait du manuel DEV1.
La requête contient deux filtres : celui dans la vue, celui dans la fonction abracadra. On a déclaré un coût si faible pour cette dernière que PostgreSQL, pour optimiser, l’exécute avant le filtre de la vue. Du coup, la fonction voit toutes les lignes de la table et peut trahir leur contenu.
Pour interdire l’optimisation malvenue du planificateur, ajouter à la vue l’option security_barrier :
Exemple 4-138Exemple 4-138 - code ou sortie extraite du manuel DEV1.
postgres=> \c - postgres
You are now connected to database "postgres" as user "postgres".
Exemple 4-139Exemple 4-139 - code ou sortie extraite du manuel DEV1.
                               QUERY PLAN
-------------------------------------------------------------------------------
 Subquery Scan on elements_public  (cost=0.00..34.20 rows=202 width=37)
   Filter: abracadabra(elements_public.id, elements_public.contenu,
           elements_public.prive)
   ->  Seq Scan on elements  (cost=0.00..28.15 rows=605 width=37)
         Filter: CASE WHEN ("current_user"() = 'u1'::name)
                 THEN (NOT prive) ELSE true END
Tableau 4-81Tableau 4-81 - sortie tabulaire ou résultat extrait du manuel DEV1.
Il peut y avoir un impact en performance : le filtre de la vue s’applique d’abord, et peut donc forcer l’optimiseur à s’écarter du chemin optimal.
Le moteur permet de mettre à jour les données dans des vues simples, ou, plus exactement, de mettre à jour les tables sous-jacentes au travers de la vue. Les critères déterminant si une vue peut être mise à jour ou non sont assez simples à résumer : la vue doit reprendre la définition de la table, avec au plus une clause WHERE pour restreindre les résultats.
La clause WITH CHECK OPTION empêche l’utilisateur d’insérer des données qui ne satisfont pas les critères de filtrage de la vue. En effet, par défaut, il est par exemple possible d’insérer un numéro de téléphone privé alors que la vue ne permet pas d’afficher les numéros privés. WITH CHECK OPTION doit être demandée explicitement.
Pour gérer les cas plus complexes, PostgreSQL permet de créer des triggers INSTEAD OF sur des vues. Un trigger INSTEAD OF permet de déclencher une fonction utilisateur lorsqu’une opération de mise à jour est déclenchée sur une vue. Le code de la fonction sera exécuté en lieu et place de la mise à jour.
Exemples
Exemple 4-143Exemple 4-143 - code ou sortie extraite du manuel DEV1.
CREATETABLEphone_data(persontext,phonetext,privateboolean);CREATEVIEWmaj_phone_number(person,phone,private)ASSELECTperson,phone,privateFROMphone_dataWHEREprivate=false;-- On peut insérer des données car les colonnes de la vue correspondent aux
-- colonnes de la table
INSERTINTOmaj_phone_numberVALUES('Titi','0123456789',false);-- On parvient même à insérer des données qui ne pourront pas être affichées
-- par la vue. Ça peut être gênant.
INSERTINTOmaj_phone_numberVALUES('Loulou','0123456789',true);SELECT*FROMmaj_phone_number;
 person |   phone    | private
--------+------------+---------
 Titi   | 0123456789 | f
Tableau 4-82Tableau 4-82 - sortie tabulaire ou résultat extrait du manuel DEV1.Exemple 4-144Exemple 4-144 - code ou sortie extraite du manuel DEV1.
-- L'option WITH CHECK OPTION rajoute une sécurité
CREATEORREPLACEVIEWmaj_phone_number(person,phone,private)ASSELECTperson,phone,privateFROMphone_dataWHEREprivate=falseWITHCHECKOPTION;INSERTINTOmaj_phone_numberVALUES('Lili','9993456789',true);
Exemple 4-145Exemple 4-145 - code ou sortie extraite du manuel DEV1.
ERROR:  new row violates check option for view "maj_phone_number"
DETAIL : Failing row contains (Lili, 9993456789, t).
Exemple 4-146Exemple 4-146 - code ou sortie extraite du manuel DEV1.
-- Cas d'une vue avec un champ calculé
CREATEVIEWphone_number(person,phone)ASSELECTperson,CASEWHENNOTprivateTHENphoneENDASphoneFROMphone_data;
Exemple 4-147Exemple 4-147 - code ou sortie extraite du manuel DEV1.
-- On ne peut pas insérer de données car les colonnes de la vue ne
-- correspondent pas à celles de la table
INSERTINTOphone_numberVALUES('Fifi','0123456789');
Exemple 4-148Exemple 4-148 - code ou sortie extraite du manuel DEV1.
ERROR:  cannot insert into column "phone" of view "phone_number"
DETAIL:  View columns that are not columns of their base relation are not updatable.
Exemple 4-149Exemple 4-149 - code ou sortie extraite du manuel DEV1.
Exemple 4-151Exemple 4-151 - code ou sortie extraite du manuel DEV1.
-- Avec le trigger, c'est maintenant possible.
INSERTINTOphone_numberVALUES('Rominet','0123456788');SELECT*FROMphone_number;
 person  |   phone
---------+------------
 Titi    | 0123456789
 Loulou  |
 Rominet | 0123456788
Tableau 4-83Tableau 4-83 - sortie tabulaire ou résultat extrait du manuel DEV1.
Attention
Une alternative aux triggers serait d’utiliser le système de règles (rules), mais son utilisation est fortement déconseillée en raison de la difficulté de débogage et de maintenance.
Mauvaises utilisations des vues
Prolifération des vues
créer une vue doit se justifier
ne pas créer une vue par table
Vues trop complexes utilisées comme interface
Vues empilées
La création d’une vue doit être pensée préalablement et doit se justifier du point de vue de l’application ou d’une règle métier. Toute vue créée doit être documentée, au moins en plaçant un commentaire sur la vue.
Bien qu’une vue n’ait pas de représentation physique, elle occupe malgré tout un peu d’espace disque. En effet, le catalogue système comporte une entrée pour chaque vue créée, autant d’entrées qu’il y a de colonnes à la vue, etc. Trop de vues entraîne donc malgré tout l’augmentation de la taille du catalogue système, donc une empreinte mémoire plus importante car ce catalogue reste en général systématiquement présent en cache.
Un problème fréquent est celui de vues complexes calculant beaucoup de choses pour le confort de l’usager… au prix des performances quand l’utilisateur n’a pas besoin de ces informations. L’optimiseur ne peut pas forcément tout élaguer.
Pour cette raison, et pour des raisons de facilité de maintenance, il faut aussi éviter d’empiler les vues.
Requêtes préparées
Exécution en deux temps
préparation du plan d’exécution de la requête
exécution de la requête en utilisant le plan préparé
Objectif :
éviter simplement les injections SQL
améliorer les performances
Les requêtes préparées, aussi appelées requêtes paramétrées, permettent de séparer la phase de préparation du plan d’exécution de la phase d’exécution. Le plan d’exécution qui est alors généré est générique car les paramètres de la requêtes sont inconnus à ce moment là.
L’exécution est ensuite commandée par l’application, en passant l’ensemble des valeurs des paramètres de la requête. De plus, ces paramètres sont passés de façon à éviter les injections SQL.
L’exécution peut être ensuite commandée plusieurs fois, sans avoir à préparer le plan d’exécution. Cela permet un gain important en terme de performances car l’étape d’analyse syntaxique et de recherche du plan d’exécution optimal n’est plus à faire.
L’utilisation de requêtes préparées peut toutefois être contre-performant si les sessions ne sont pas maintenues et les requêtes exécutées qu’une seule fois. En effet, l’étape de préparation oblige à un premier aller-retour entre l’application et la base de données et l’exécution oblige à un second aller-retour, ajoutant ainsi une surcharge qui peut devenir significative.
Utilisation
PREPARE, préparation du plan d’exécution d’une requête
EXECUTE, passage des paramètres de la requête et exécution réelle
L’implémentation dépend beaucoup du langage de programmation utilisé
le connecteur JDBC supporte les requêtes préparées
le connecteur PHP/PDO également
L’ordre PREPARE permet de préparer le plan d’exécution d’une requête. Le plan d’exécution prendra en compte le contexte courant de l’utilisateur au moment où la requête est préparée, et notamment le search_path. Tout changement ultérieur de ces variables ne sera pas pris en compte à l’exécution.
L’ordre EXECUTE permet de passer les paramètres de la requête et de l’exécuter.
La plupart des langages de programmation mettent à disposition des méthodes qui permettent d’employer les mécanismes de préparation de plans d’exécution directement. Les paramètres des requêtes seront alors transmis un à un à l’aide d’une méthode particulière.
Voici comment on prépare une requête :
Exemple 4-152Exemple 4-152 - code ou sortie extraite du manuel DEV1.
préparation de deux scripts SQL, une pour les requêtes standards, l’autre pour les requêtes préparées :
Exemple 4-154Exemple 4-154 - code ou sortie extraite du manuel DEV1.
$ for i in $(seq 1 100000);doecho"SELECT * FROM t1 WHERE c1=$i;";done > requetes_std.sql
echo"PREPARE req AS SELECT * FROM t1 WHERE c1=\$1;" > requetes_prep.sql
for i in $(seq 1 100000);doecho"EXECUTE req($i);";done >> requetes_prep.sql
exécution du test (deux fois pour s’assurer que les temps d’exécution sont réalistes) :
Exemple 4-155Exemple 4-155 - code ou sortie extraite du manuel DEV1.
$ time psql -f requetes_std.sql postgres >/dev/null

real  0m12.742s
user  0m2.633s
sys 0m0.771s
$ time psql -f requetes_std.sql postgres >/dev/null

real  0m12.781s
user  0m2.573s
sys 0m0.852s
$ time psql -f requetes_prep.sql postgres >/dev/null

real  0m10.186s
user  0m2.500s
sys 0m0.814s
$ time psql -f requetes_prep.sql postgres >/dev/null

real  0m10.131s
user  0m2.521s
sys 0m0.808s
Le gain est de 16 % dans cet exemple. Il peut être bien plus important. En lisant 500 000 lignes (et non pas 100 000), on arrive à 25 % de gain.
Conclusion
Possibilité d’écrire des requêtes complexes
C’est là où PostgreSQL est le plus performant
Le standard SQL va bien plus loin que ce que les requêtes simplistes laissent penser. Utiliser des requêtes complexes permet de décharger l’application d’un travail conséquent et le développeur de coder quelque chose qui existe déjà. Cela aide aussi la base de données car il est plus simple d’optimiser une requête complexe qu’un grand nombre de requêtes simplistes.
Ces TP utilisent la base tpc. Si vous ne l’avez pas déjà, la base tpc (dump de 31 Mo, pour 267 Mo sur le disque au final) et ses utilisateurs peuvent être installés comme suit :
Exemple 4-156Exemple 4-156 - code ou sortie extraite du manuel DEV1.
curl -kL https://dali.bo/tp_tpc -o /tmp/tpc.dump
curl -kL https://dali.bo/tp_tpc_roles -o /tmp/tpc_roles.sql
# Exécuter le script de création des rôlespsql < /tmp/tpc_roles.sql
# Création de la basecreatedb --owner tpc_owner tpc
# L'erreur sur un schéma 'public' existant est normalepg_restore -d tpc /tmp/tpc.dump
Les mots de passe sont dans le script /tmp/tpc_roles.sql. Pour vous connecter :
Exemple 4-157Exemple 4-157 - code ou sortie extraite du manuel DEV1.
$ psql -U tpc_admin -h localhost -d tpc
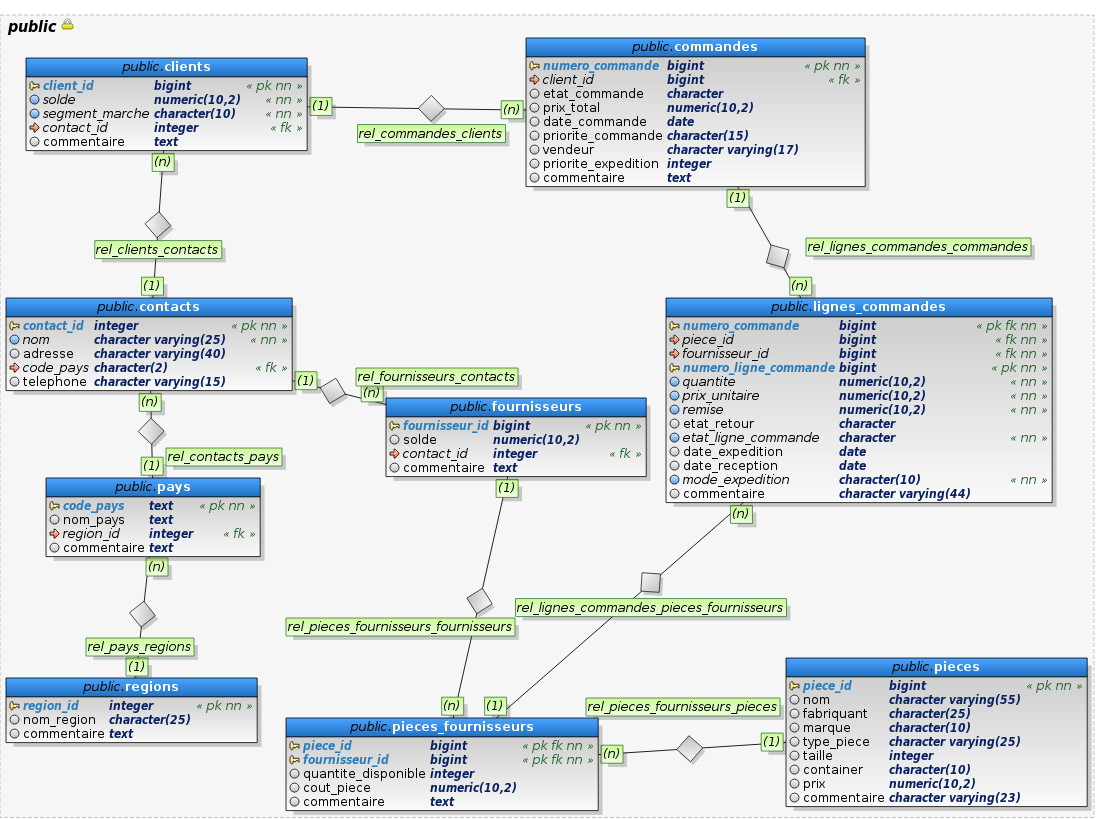
Le schéma suivant montre les différentes tables de la base :
Figure 4-4Figure 4-4 - Schéma base tpc (page PDF 227).
Tableau 4-86Tableau 4-86 - sortie tabulaire ou résultat extrait du manuel DEV1.
Pour les 30 premières commandes (selon la date de commande), affichez le prix total de la commande, en appliquant la remise accordée sur chaque article commandé. La sortie sera triée de la commande la plus chère à la commande la moins chère.
Tableau 4-88Tableau 4-88 - sortie tabulaire ou résultat extrait du manuel DEV1.
Pour toutes les commandes, calculez le temps moyen de livraison, depuis la date d’expédition. Le temps de livraison moyen sera exprimé en jours, arrondi à l’entier supérieur (fonction ceil()).
Tableau 4-89Tableau 4-89 - sortie tabulaire ou résultat extrait du manuel DEV1.
Pour les 30 commandes les plus récentes (selon la date de commande), calculez le temps moyen de livraison de chaque commande, depuis la date de commande. Le temps de livraison moyen sera exprimé en jours, arrondi à l’entier supérieur (fonction ceil()).
Tableau 4-90Tableau 4-90 - sortie tabulaire ou résultat extrait du manuel DEV1.
Déterminez le taux de retour des marchandises (l’état à R indiquant qu’une marchandise est retournée).
Sortie attendue :
taux_retour
-------------
       24.29
Tableau 4-91Tableau 4-91 - sortie tabulaire ou résultat extrait du manuel DEV1.
Déterminez le mode d’expédition qui est le plus rapide, en moyenne.
Sortie attendue :
 mode_expedition |       delai
-----------------+--------------------
 AIR             | 7.4711070230494535
Tableau 4-92Tableau 4-92 - sortie tabulaire ou résultat extrait du manuel DEV1.
Un bug applicatif est soupçonné, déterminez s’il existe des commandes dont la date de commande est postérieure à la date d’expédition des articles.
Sortie attendue :
count
-------
     2
Tableau 4-93Tableau 4-93 - sortie tabulaire ou résultat extrait du manuel DEV1.
Écrivez une requête qui corrige les données erronés en positionnant la date de commande à la date d’expédition la plus ancienne des marchandises. Vérifiez qu’elle soit correcte. Cette requête permet de corriger des calculs de statistiques sur les délais de livraison.
Écrivez une requête qui calcule le délai total maximal de livraison de la totalité d’une commande donnée, depuis la date de la commande.
Sortie attendue pour la commande n°1 :
delai_max
-----------
       102
Tableau 4-94Tableau 4-94 - sortie tabulaire ou résultat extrait du manuel DEV1.
Écrivez une requête pour déterminer les 10 commandes réalisées en 2011 dont le délai de livraison, entre la date de commande et la date de réception, est le plus important.
Tableau 4-96Tableau 4-96 - sortie tabulaire ou résultat extrait du manuel DEV1.
Écrivez une requête pour supprimer ces commandes. Vérifiez le travail avant de valider.
Écrivez une requête pour déterminer les 20 pièces qui ont eu le plus gros volume de commande.
Sortie attendue :
                    nom                     |  sum
--------------------------------------------+--------
 lemon black goldenrod seashell plum        | 461.00
 brown lavender dim white indian            | 408.00
 burlywood white chiffon blanched lemon     | 398.00
(…)
Tableau 4-97Tableau 4-97 - sortie tabulaire ou résultat extrait du manuel DEV1.
Affichez les fournisseurs des 20 pièces qui ont été le plus commandées sur l’année 2011.
Tableau 4-99Tableau 4-99 - sortie tabulaire ou résultat extrait du manuel DEV1.
Affichez pour les commandes passées en 2011, la liste des continents (régions) et la marge brute d’exploitation réalisée par continents, triés dans l’ordre décroissant.
Tableau 4-100Tableau 4-100 - sortie tabulaire ou résultat extrait du manuel DEV1.
Affichez le nom, le numéro de téléphone et le pays des fournisseurs qui ont un commentaire contenant le mot clé Complaints.
Sortie attendue :
 nom_fournisseur |    telephone    |           nom_pays
-----------------+-----------------+-------------------------------
 Supplier3873    | 10-741-199-8614 | IRAN, RÉPUBLIQUE ISLAMIQUE D'
(…)
Tableau 4-101Tableau 4-101 - sortie tabulaire ou résultat extrait du manuel DEV1.
Déterminez le top 10 des fournisseurs ayant eu le plus long délai de livraison, entre la date de commande et la date de réception, pour les commandes passées en 2011 uniquement.
Tableau 4-102Tableau 4-102 - sortie tabulaire ou résultat extrait du manuel DEV1.
TP n°2
Ajouter une adresse mail à chaque contact avec la concaténation du nom avec le texte « @dalibo.com ».
Concaténer nom et adresse mail des contacts français sous la forme « nom <mail> ».
Même demande mais avec le nom en majuscule et l’adresse mail en minuscule.
Ajouter la colonne prix_total de type numeric(10,2) à la table commandes.
Écrivez une requête qui calcul la somme d’une commande en fonction de la quantité, le prix unitaire ainsi que la remise d’un produit. Vous trouverez ces informations dans la table lignes_commandes.
Mettre à jour la colonne prix_total de la table commandes avec la somme récupérée de la table lignes_commandes.
Récupérer le montant total des commandes par mois pour l’année 2010. Les montants seront arrondis à deux décimales.
Supprimer les commandes de mai 2010.
Ré-exécuter la requête trouvée à la septième question.
Qu’observez-vous ?
Corriger le problème rencontré.
Créer une vue calculant le prix total de chaque commande.
Réécrire la requête de la question 7 pour utiliser la vue créée au point 10.
Travaux pratiques (solutions)
Ces TP utilisent la base tpc. Si vous ne l’avez pas déjà, la base tpc (dump de 31 Mo, pour 267 Mo sur le disque au final) et ses utilisateurs peuvent être installés comme suit :
Exemple 4-158Exemple 4-158 - code ou sortie extraite du manuel DEV1.
curl -kL https://dali.bo/tp_tpc -o /tmp/tpc.dump
curl -kL https://dali.bo/tp_tpc_roles -o /tmp/tpc_roles.sql
# Exécuter le script de création des rôlespsql < /tmp/tpc_roles.sql
# Création de la basecreatedb --owner tpc_owner tpc
# L'erreur sur un schéma 'public' existant est normalepg_restore -d tpc /tmp/tpc.dump
Les mots de passe sont dans le script /tmp/tpc_roles.sql. Pour vous connecter :
Exemple 4-159Exemple 4-159 - code ou sortie extraite du manuel DEV1.
$ psql -U tpc_admin -h localhost -d tpc
Le schéma suivant montre les différentes tables de la base :
Figure 4-5Figure 4-5 - Schéma base tpc (page PDF 234).
TP n°1
Affichez, par pays, le nombre de fournisseurs.
Exemple 4-160Exemple 4-160 - code ou sortie extraite du manuel DEV1.
Affichez le nombre de commandes trié selon le nombre de lignes de commandes au sein de chaque commande.
Exemple 4-162Exemple 4-162 - code ou sortie extraite du manuel DEV1.
SELECTnombre_lignes_commandes,count(*)ASnombre_total_commandesFROM(/* cette sous-requête permet de compter le nombre de lignes de commande de
chaque commande, et remonte cette information à la requête principale */SELECTcount(numero_ligne_commande)ASnombre_lignes_commandesFROMlignes_commandesGROUPBYnumero_commande)comm_agg/* la requête principale aggrège et trie les données sur ce nombre de lignes
de commandes pour compter le nombre de commandes distinctes ayant le même
nombre de lignes de commandes */GROUPBYnombre_lignes_commandesORDERBYnombre_lignes_commandesASC;
Pour les 30 premières commandes (selon la date de commande), affichez le prix total de la commande, en appliquant la remise accordée sur chaque article commandé. La sortie sera triée de la commande la plus chère à la commande la moins chère.
Exemple 4-163Exemple 4-163 - code ou sortie extraite du manuel DEV1.
Pour toutes les commandes, calculez le temps moyen de livraison, depuis la date d’expédition. Le temps de livraison moyen sera exprimé en jours, arrondi à l’entier supérieur (fonction ceil()).
Exemple 4-165Exemple 4-165 - code ou sortie extraite du manuel DEV1.
Pour les 30 commandes les plus récentes (selon la date de commande), calculez le temps moyen de livraison de chaque commande, depuis la date de commande. Le temps de livraison moyen sera exprimé en jours, arrondi à l’entier supérieur (fonction ceil()).
Exemple 4-166Exemple 4-166 - code ou sortie extraite du manuel DEV1.
Note : la colonne date_commande de la table commandes n’a pas de contrainte NOT NULL, il est donc possible d’avoir des commandes sans date de commande renseignée (ici ce n’est pas le cas). Dans ce cas, ces commandes vont remonter par défaut en haut de la liste, puisque la clause ORDER BY renvoie les NULL après les valeurs les plus grandes, et que l’on inverse le tri. Pour éviter que ces commandes ne faussent les résultats, il faut donc les exclure de la sous-requête, de la façon suivante :
Exemple 4-167Exemple 4-167 - code ou sortie extraite du manuel DEV1.
Il est intéressant de constater que cette sous-requête ne ramène pas le même résultat que les autres. En effet, aucune des trois requêtes ne spécifie l’ordre des lignes pour lesquelles la date est égale.
Déterminez le taux de retour des marchandises (l’état à R indiquant qu’une marchandise est retournée).
Exemple 4-169Exemple 4-169 - code ou sortie extraite du manuel DEV1.
Écrivez une requête qui corrige les données erronés en positionnant la date de commande à la date d’expédition la plus ancienne des marchandises. Vérifiez qu’elle soit correcte. Cette requête permet de corriger des calculs de statistiques sur les délais de livraison.
Afin de se protéger d’une erreur de manipulation, on ouvre une transaction :
Exemple 4-173Exemple 4-173 - code ou sortie extraite du manuel DEV1.
BEGIN;
Exemple 4-174Exemple 4-174 - code ou sortie extraite du manuel DEV1.
Depuis la version 18, il est possible de retourner les anciennes et nouvelles valeurs d’une colonne avec la clause RETURNING. En ajoutant ceci à la fin de la requête, on peut voir l’ancienne et la nouvelle date pour chaque commande modifiée :
Exemple 4-179Exemple 4-179 - code ou sortie extraite du manuel DEV1.
Écrivez une requête pour déterminer les 10 commandes réalisées en 2011 dont le délai de livraison, entre la date de commande et la date de réception, est le plus important.
Exemple 4-181Exemple 4-181 - code ou sortie extraite du manuel DEV1.
Un autre bug applicatif est détecté. Certaines commandes n’ont pas de lignes de commandes. Écrivez une requête pour les retrouver.
Pour réaliser cette requête, il faut effectuer une jointure spéciale, nommée « Anti-jointure ». Il y a plusieurs façons d’écrire ce type de jointure. Les différentes méthodes sont données de la moins efficace à la plus efficace.
La version la moins performante est la suivante, avec NOT IN :
Exemple 4-182Exemple 4-182 - code ou sortie extraite du manuel DEV1.
Il n’y a aucune corrélation entre la requête principale et la sous-requête. PostgreSQL doit donc vérifier pour chaque ligne de commandes que numero_commande n’est pas présent dans l’ensemble retourné par la sous-requête. Il est préférable d’éviter cette syntaxe.
Autre écriture possible, avec LEFT JOIN :
Exemple 4-183Exemple 4-183 - code ou sortie extraite du manuel DEV1.
SELECTc.numero_commandeFROMcommandescLEFTJOINlignes_commandeslcONc.numero_commande=lc.numero_commande/* c'est le filtre suivant qui permet de ne conserver que les lignes de la
table commandes qui n'ont PAS de correspondance avec la table
numero_commandes */WHERElc.numero_commandeISNULL;
Enfin, l’écriture généralement préférée pour sa lisibilité, avec NOT EXISTS :
Exemple 4-184Exemple 4-184 - code ou sortie extraite du manuel DEV1.
Écrivez une requête pour supprimer ces commandes. Vérifiez le travail avant de valider.
Afin de se protéger d’une erreur de manipulation, on ouvre une transaction :
Exemple 4-185Exemple 4-185 - code ou sortie extraite du manuel DEV1.
BEGIN;
La requête permettant de supprimer ces commandes est dérivée de la version NOT EXISTS de la requête ayant permis de trouver le problème :
Exemple 4-186Exemple 4-186 - code ou sortie extraite du manuel DEV1.
DELETEFROMcommandescWHERENOTEXISTS(SELECT1FROMlignes_commandeslcWHERElc.numero_commande=c.numero_commande)-- on peut renvoyer directement les numeros de commande qui ont été supprimés :
-- RETURNING numero_commande
;
Pour vérifier que le problème est corrigé :
Exemple 4-187Exemple 4-187 - code ou sortie extraite du manuel DEV1.
Affichez les fournisseurs des 20 pièces qui ont été le plus commandées sur l’année 2011.
Exemple 4-190Exemple 4-190 - code ou sortie extraite du manuel DEV1.
SELECTco.nom,max_p.piece_id,total_piecesFROM(/* cette sous-requête est sensiblement la même que celle de l'exercice
précédent, sauf que l'on remonte cette fois l'id de la piece plutôt
que son nom pour pouvoir faire la jointure avec pieces_fournisseurs, et
que l'on ajoute une jointure avec commandes pour pouvoir filtrer sur
l'année 2011 */SELECTp.piece_id,sum(quantite)AStotal_piecesFROMpiecespJOINlignes_commandeslcONp.piece_id=lc.piece_idJOINcommandescONc.numero_commande=lc.numero_commandeWHEREdate_commandeBETWEENto_date('01/01/2011','DD/MM/YYYY')ANDto_date('31/12/2011','DD/MM/YYYY')GROUPBYp.piece_idORDERBYsum(quantite)DESCLIMIT20)max_p/* il faut passer par la table de liens pieces_fournisseurs pour récupérer
la liste des fournisseurs d'une piece */JOINpieces_fournisseurspfONmax_p.piece_id=pf.piece_idJOINfournisseursfONf.fournisseur_id=pf.fournisseur_id-- la jointure avec la table contact permet d'afficher le nom du fournisseur
JOINcontactscoONf.contact_id=co.contact_id;
Affichez le pays qui a passé, en nombre, le plus de commandes sur l’année 2011.
Exemple 4-191Exemple 4-191 - code ou sortie extraite du manuel DEV1.
Affichez pour les commandes passées en 2011, la liste des continents (régions) et la marge brute d’exploitation réalisée par continents, triés dans l’ordre décroissant.
Exemple 4-192Exemple 4-192 - code ou sortie extraite du manuel DEV1.
SELECTnom_region,round(sum(quantite*prix-remise)-sum(quantite*cout_piece),2)ASmarge_bruteFROMcommandescJOINlignes_commandeslcONlc.numero_commande=c.numero_commande/* il faut passer par la table de liens pieces_fournisseurs pour récupérer
la liste des fournisseurs d'une piece - attention, la condition de
jointure entre lignes_commandes et pieces_fournisseurs porte sur deux
colonnes ! */JOINpieces_fournisseurspfONlc.piece_id=pf.piece_idANDlc.fournisseur_id=pf.fournisseur_idJOINpiecespONp.piece_id=pf.piece_idJOINfournisseursfONf.fournisseur_id=pf.fournisseur_idJOINclientsclONc.client_id=cl.client_idJOINcontactscoONcl.contact_id=co.contact_idJOINpayspaONco.code_pays=pa.code_paysJOINregionsrONr.region_id=pa.region_idWHEREdate_commandeBETWEENto_date('01/01/2011','DD/MM/YYYY')ANDto_date('31/12/2011','DD/MM/YYYY')GROUPBYnom_regionORDERBYsum(quantite*prix-remise)-sum(quantite*cout_piece)DESC;
Affichez le nom, le numéro de téléphone et le pays des fournisseurs qui ont un commentaire contenant le mot clé Complaints.
Exemple 4-193Exemple 4-193 - code ou sortie extraite du manuel DEV1.
Déterminez le top 10 des fournisseurs ayant eu le plus long délai de livraison, entre la date de commande et la date de réception, pour les commandes passées en 2011 uniquement.
Exemple 4-194Exemple 4-194 - code ou sortie extraite du manuel DEV1.
Écrivez une requête qui calcul la somme d’une commande en fonction de la quantité, le prix unitaire ainsi que la remise d’un produit. Vous trouverez ces informations dans la table lignes_commandes.
Exemple 4-202Exemple 4-202 - code ou sortie extraite du manuel DEV1.
Mettre à jour la colonne prix_total de la table commandes avec la somme récupérée de la table lignes_commandes.
Exemple 4-203Exemple 4-203 - code ou sortie extraite du manuel DEV1.
BEGIN;UPDATEcommandescSETprix_total=(/* cette sous-requête fait une jointure entre lignes_commandes et la
table commandes à mettre à jour pour calculer le prix par commande */SELECTSUM(quantite*prix_unitaire-remise)FROMlignes_commandeslcWHERElc.numero_commande=c.numero_commande)-- on peut récupérer le détail de la mise à jour directement dans la
-- requête :
-- RETURNING numero_commande, prix_total
;COMMIT;
Une autre variante de cette requête serait :
Exemple 4-204Exemple 4-204 - code ou sortie extraite du manuel DEV1.
Attention : il n’y a pas de contrainte NOT NULL sur le champ date_commande, donc s’il existe des commandes sans date de commande, celles-ci seront agrégées à part des autres, puisque extract() renverra NULL pour ces lignes.
Supprimer les commandes de mai 2010.
Exemple 4-206Exemple 4-206 - code ou sortie extraite du manuel DEV1.
BEGIN;/* en raison de la présence de clés étrangères, il faut en premier leur
supprimer les lignes de la table lignes_commandes correspondant aux
commandes à supprimer */DELETEFROMlignes_commandesWHEREnumero_commandeIN(SELECTnumero_commandeFROMcommandesWHEREdate_commande>=to_date('01/05/2010','DD/MM/YYYY')ANDdate_commande<to_date('01/06/2010','DD/MM/YYYY'));-- ensuite seulement on peut supprimer les commandes
DELETEFROMcommandesWHEREdate_commande>=to_date('01/05/2010','DD/MM/YYYY')ANDdate_commande<to_date('01/06/2010','DD/MM/YYYY');COMMIT;
Le problème de l’approche précédente est d’effectuer l’opération en deux temps. Il est possible de réaliser la totalité des suppressions dans les deux tables lignes_commandes et commandes en une seule requête en utilisant une CTE :
Exemple 4-207Exemple 4-207 - code ou sortie extraite du manuel DEV1.
WITHdel_lcAS(/* ici on déclare la CTE qui va se charger de supprimer les lignes
dans la table lignes_commandes et retourner les numeros de
commande supprimés */DELETEFROMlignes_commandesWHEREnumero_commandeIN(SELECTnumero_commandeFROMcommandesWHEREdate_commande>=to_date('01/05/2010','DD/MM/YYYY')ANDdate_commande<to_date('01/06/2010','DD/MM/YYYY'))RETURNINGnumero_commande)/* requête principale, qui supprime les commandes dont les numéros
correspondent aux numéros de commandes remontés par la CTE */DELETEFROMcommandescWHEREEXISTS(SELECT1FROMdel_lcWHEREdel_lc.numero_commande=c.numero_commande);
Ré-exécuter la requête trouvée à la septième question.
Exemple 4-208Exemple 4-208 - code ou sortie extraite du manuel DEV1.
Exemple 4-209Exemple 4-209 - code ou sortie extraite du manuel DEV1.
SELECTnumero_mois,round(coalesce(sum(prix_total),0.0),2)ASmontant_total/* la fonction generate_series permet de générer une pseudo-table
d'une colonne contenant les chiffres de 1 à 12 */FROMgenerate_series(1,12)ASnumero_mois/* le LEFT JOIN entre cette pseudo-table et la table commandes permet
de s'assurer que même si aucune commande n'a eu lieu sur un mois, la
ligne correspondante sera tout de même présente */LEFTJOINcommandesONextract('month'fromdate_commande)=numero_moisANDdate_commande>=to_date('01/01/2010','DD/MM/YYYY')ANDdate_commande<to_date('01/01/2011','DD/MM/YYYY')GROUPBY1ORDERBY1;
Notez l’utilisation de la fonction coalesce() dans le SELECT, afin d’affecter la valeur 0.0 aux lignes « ajoutées » par le LEFT JOIN qui n’ont par défaut aucune valeur (NULL).
Créer une vue calculant le prix total de chaque commande.
Exemple 4-210Exemple 4-210 - code ou sortie extraite du manuel DEV1.