5 SQL avancé pour le transactionnel
SQL avancé pour le transactionnel
Préambule
- SQL et PostgreSQL proposent de nombreuses fonctionnalités avancées
- normes SQL:99, 2003, 2008 et 2011
- parfois, extensions propres à PostgreSQL
La norme SQL a continué d’évoluer et a bénéficié d’un grand nombre d’améliorations. Beaucoup de requêtes qu’il était difficile d’exprimer avec les premières incarnations de la norme sont maintenant faciles à réaliser avec les dernières évolutions.
Ce module a pour objectif de voir les fonctionnalités pouvant être utiles pour développer une application transactionnelle.
Menu
LIMIT/OFFSET- Jointures
LATERAL UPSERT:INSERTouUPDATE- Common Table Expressions
- Serializable Snapshot Isolation
Objectifs
- Aller au-delà de SQL:92
- Concevoir des requêtes simples pour résoudre des problèmes complexes
Beaucoup de personnes écrivant du SQL ne connaissent que les bases du SQL:92. Le langage a cependant de nombreuses fonctionnalités très puissantes à connaître.
LIMIT
- Clause
LIMIT - ou syntaxe en norme SQL :
FETCH FIRST xx ROWS - Utilisation :
- limite le nombre de lignes du résultat
La clause LIMIT, ou sa déclinaison normalisée par le comité ISO FETCH FIRST xx ROWS, permet de limiter le nombre de lignes résultant d’une requête SQL. La syntaxe LIMIT est cependant plus connue et est plus concise.
LIMIT : exemple
L’exemple ci-dessous s’appuie sur un jeu d’essai créé ainsi :
Il faut faire attention au fait que ces fonctions ne permettent pas d’obtenir des résultats stables si les données ne sont pas triées explicitement. En effet, le standard SQL ne garantit en aucune façon l’ordre des résultats à moins d’employer la clause ORDER BY, et que l’ensemble des champs sur lequel on trie soit unique et non NULL.
Si une ligne était modifiée, changeant sa position physique dans la table, le résultat de la requête ne serait pas le même. Par exemple, en réalisant une mise à jour fictive de la ligne correspondant au matricule 00000001 :
L’ordre du résultat n’est pas garanti :
L’application d’un critère de tri explicite permet d’obtenir la sortie souhaitée :
OFFSET
- Clause OFFSET
- à utiliser avec
LIMIT
- à utiliser avec
- Utilité :
- pagination de résultat
- sauter les n premières lignes avant d’afficher le résultat
Ainsi, en reprenant le jeu d’essai utilisé précédemment :
OFFSET : exemple (1/2)
- Sans offset :
OFFSET : exemple (2/2)
- En sautant les deux premières lignes :
OFFSET : problèmes
OFFSETest problématique- beaucoup de données lues
- temps de réponse dégradés
- Alternative possible
- utilisation d’un index sur le critère de tri
- critère de filtrage sur la page précédente
- https://use-the-index-luke.com/fr/no-offset
Cependant, sur un jeu de données conséquent et une pagination importante, ce principe de fonctionnement peut devenir contre-performant. En effet, la base de données devra lire malgré tout les enregistrements qui n’apparaîtront pas dans le résultat de la requête, simplement dans le but de les compter.
Soit la table posts suivante (téléchargeable sur https://dali.bo/tp_posts, à laquelle on ajoute un index sur (id_article_id, id_post)) :
Si l’on souhaite récupérer les 10 premiers enregistrements :
On obtient le plan d’exécution suivant :
La requête est rapide car elle profite d’un index bien trié et elle ne lit que peu de données, ce qui est bien.
En revanche, si l’on saute un nombre conséquent d’enregistrements grâce à la clause OFFSET, la situation devient problématique :
Le plan n’est plus le même :
Pour répondre à la requête, PostgreSQL choisit la lecture de l’ensemble des résultats, puis leur tri, pour enfin appliquer la limite. En effet, LIMIT et OFFSET ne peuvent s’opérer que sur le résultat trié : il faut lire les 910 posts avant de pouvoir choisir les 10 derniers.
Le problème de ce plan est que, plus le jeu de données sera important, plus les temps de réponse seront importants. Ils seront encore plus importants si le tri n’est pas utilisable dans un index, ou si l’on déclenche un tri sur disque. Il faut donc trouver une solution pour les minimiser.
Les problèmes de l’utilisation de la clause OFFSET sont parfaitement expliqués dans cet article.
Dans notre cas, la solution revient à créer un index qui contient le critère ainsi que le champ qui fixe la pagination (l’index existant convient). Puis on mémorise à quel post_id la page précédente s’est arrêtée, pour le donner comme critère de filtrage (ici 12900). Il suffit donc de récupérer les 10 articles pour lesquels id_article = 12 et id_post > 12900 :
RETURNING
- Clause
RETURNING - Utilité :
- récupérer les enregistrements modifiés
INSERT,UPDATE,DELETE
- À partir de la v18
- ancienne version :
OLD - nouvelle version :
NEW
- ancienne version :
La clause RETURNING permet de récupérer les valeurs modifiées par un ordre DML.
On a ainsi une modification et la récupération des valeurs générées, modifiées ou supprimées en un seul ordre.
RETURNING : exemple
Dans l’exemple ci-dessus, l’insertion d’une ligne mène à la génération d’une clé par la séquence associée au pseudo-type serial. La clause RETURNING permet de récupérer cette valeur dans la même commande que celle d’insertion.
RETURNING permet également de récupérer les valeurs des colonnes mises à jour :
Associée à l’ordre DELETE, RETURNING renvoie les lignes supprimées :
Ce qui suit illustre les nouveautés de la version 18 et l’utilisation d’une CTE :
UPSERT (INSERT … ON CONFLICT)
INSERTouUPDATE?INSERT … ON CONFLICT DO { NOTHING | UPDATE }
- Utilité :
- mettre à jour en cas de conflit sur un
INSERT - ne rien faire en cas de conflit sur un
INSERT
- mettre à jour en cas de conflit sur un
- Plutôt préférer
MERGE
Par upsert, on entend la syntaxe INSERT … ON CONFLICT DO { NOTHING | UPDATE } qui permet d’insérer une ligne, ou de la mettre à jour si elle existe déjà (c’est-à-dire si la clé qui sert à l’identifier est mise à jour).
L’implémentation de PostgreSQL de ON CONFLICT DO UPDATE est une opération atomique, c’est-à-dire que PostgreSQL garantit que l’une ou l’autre seulement des conditions sera effectuée, sans souci en cas de traitements en parallèle et de suppression (sauf erreur pour une autre raison). En comparaison, plusieurs approches naïves présentent des problèmes de concurrences d’accès. (Voir les différentes approches décrites dans cet article de Depesz).
Il faut évidemment qu’il y ait une contrainte d’unicité pour l’identification des lignes.
Une bonne conception évitera autant que possible de modifier les mêmes lignes par des traitements simultanés, ne serait-ce que pour éviter des ralentissements à cause de verrous. Mais ce n’est pas toujours possible.
La clause INSERT … ON CONFLICT est très proche de la commande MERGE (voir plus bas), plus proche du standard, mais qui n’est apparue dans PostgreSQL que plus tard.
UPSERT : problème à résoudre
- Insérer une ligne déjà existante provoque une erreur :
Si l’on souhaite insérer une ligne contenant un matricule déjà existant, une erreur de clé dupliquée est levée et toute la transaction est annulée.
ON CONFLICT DO NOTHING
- La clause
ON CONFLICT DO NOTHINGévite d’insérer une ligne existante :
Les données n’ont pas été modifiées :
La transaction est toujours valide.
ON CONFLICT DO NOTHING : syntaxe
Il suffit d’indiquer à PostgreSQL de ne rien faire en cas de conflit sur une valeur dupliquée avec la clause ON CONFLICT DO NOTHING placée à la fin de l’ordre INSERT qui peut poser problème.
Dans ce cas, si une rupture d’unicité est détectée, alors PostgreSQL ignorera l’erreur, silencieusement. En revanche, si une erreur apparaît sur une autre contrainte, l’erreur sera levée.
En prenant l’exemple suivant :
L’insertion d’une valeur dupliquée provoque bien une erreur d’unicité :
L’erreur d’unicité est bien ignorée si la ligne existe déjà, le résultat est INSERT 0 0 qui indique qu’aucune ligne n’a été insérée :
L’insertion est aussi ignorée si l’on tente d’insérer des lignes rompant la contrainte d’unicité mais ne comportant pas les mêmes valeurs pour d’autres colonnes :
Si l’on insère une valeur interdite par la contrainte CHECK, une erreur est bien levée :
ON CONFLICT DO UPDATE
La clause ON CONFLICT permet de déterminer une colonne sur laquelle le conflit peut arriver. Cette colonne ou ces colonnes doivent porter une contrainte d’unicité ou une contrainte d’exclusion, c’est à dire une contrainte portée par un index. La clause DO UPDATE associée fait référence aux valeurs rejetées par le conflit à l’aide de la pseudo-table excluded. Les valeurs courantes sont accessibles en préfixant les colonnes avec le nom de la table. L’exemple montre cela.
Avec la requête de l’exemple, on voit que le salaire du directeur n’a pas été modifié, mais son nom l’a été :
La clause ON CONFLICT permet également de définir une contrainte d’intégrité sur laquelle on réagit en cas de conflit :
On remarque que seul le salaire du directeur a changé :
ON CONFLICT DO UPDATE
- Avec plusieurs lignes insérées :
Bien sûr, on peut insérer plusieurs lignes, INSERT ON CONFLICT réagira uniquement sur les doublons :
La nouvelle employée, Moizelle Jeanne a été intégrée dans la table employes, et Lebrac a été traité comme un doublon, en appliquant la règle de mise à jour vue plus haut : seul le nom est mis à jour et le salaire est inchangé.
À noter que la clause SET salaire = employes.salaire est inutile, c’est ce que fait PostgreSQL implicitement.
ON CONFLICT DO UPDATE : syntaxe
- Colonne(s) portant(s) une contrainte d’unicité
- Pseudo-table excluded
Si l’on choisit de réaliser une mise à jour plutôt que de générer une erreur, on utilisera la clause ON CONFLICT DO UPDATE. Il faudra dans ce cas préciser là ou les colonnes qui portent une contrainte d’unicité. Cette contrainte d’unicité permettra de détecter la duplication de valeur, PostgreSQL pourra alors appliquer la règle de mise à jour édictée.
La règle de mise à jour permet de définir très finement les colonnes à mettre à jour et les colonnes à ne pas mettre à jour. Dans ce contexte, la pseudo-table excluded représente l’ensemble rejeté par l’INSERT. Il faudra explicitement indiquer les colonnes dont la valeur sera mise à jour à partir des valeurs que l’on tente d’insérer, reprise de la pseudo-table excluded :
En alternative, il est possible d’indiquer un nom de contrainte plutôt que le nom d’une colonne portant une contrainte d’unicité :
De plus amples informations quant à la syntaxe sont disponibles dans la documentation.
MERGE
MERGE est très voisin de INSERT … ON CONFLICT mais n’est apparu qu’avec PostgreSQL 15. Leurs mécanismes diffèrent complètement et les deux syntaxes ont leur utilité.
MERGE est conforme au standard SQL (avec quelques extensions de syntaxe propres à PostgreSQL), a une syntaxe plus complexe et permet aussi des DELETE dans la table cible.
Attention
MERGE ne s’appuie pas sur les contraintes d’unicité et est plus susceptible de mener à des erreurs en cas de concurrence d’accès forte, au contraire de INSERT … ON CONFLICT.
Lors de son exécution, la commande commence par réaliser une jointure entre la source de donnée et la table cible. La source de donnée peut être une table ou une requête quelconque. La condition de jointure ne doit contenir que des colonnes des tables source et cible qui participent à la jointure, et la jointure ne doit produire qu’une ligne pour chaque ligne candidate.
Chaque ligne candidate se voit assigner le statut [NOT] MATCHED, suivant que la jointure a été un succès ou non. Ensuite, les clauses WHEN sont évaluées dans l’ordre où elles sont spécifiées. Seule l’action associée à la première clause WHEN qui renvoie « vrai » est exécutée.
Lorsqu’elles sont exécutées, les actions ont les mêmes effets que des ordres INSERT, UPDATE ou DELETE classiques. La syntaxe est similaire, à la différence prêt qu’il n’y a ni clause FROM ni clause WHERE. Les actions agissent sur la cible, utilisent les lignes courantes de la jointure et agissent sur la cible.
Il est possible de spécifier DO NOTHING si on souhaite ignorer la ligne en cours. Ce résultat peut également être obtenu si aucune clause n’est évaluée à vrai.
INSERT … ON CONFLICT UPDATE garantit l’exécution atomique d’un INSERT ou d’un UPDATE même en cas de forte concurrence d’accès. La commande MERGE n’a pas ce genre de garantie. Si un INSERT est exécutée en même temps que le MERGE, il est possible que le MERGE ne la voit pas et choisisse d’utiliser son action INSERT, ce qui aboutira à une erreur de violation de contrainte d’unicité. C’est la raison pour laquelle la commande MERGE avait été initialement refusée et remplacée par INSERT … ON CONFLICT.
Pour les détails et les différences avec INSERT … ON CONFLICT, voir :
- Notre workshop de la version 15, avec l’exemple ci-dessus complet ;
- la documentation de PostgreSQL.
LATERAL
- Jointures
LATERAL- SQL:99
- équivalent d’une boucle
foreach
LATERAL apparaît dans la révision de la norme SQL de 1999. Elle permet d’appliquer une requête ou une fonction sur le résultat d’une table. L’implémentation dans la plupart des SGBD reste cependant relativement récente.
C’est une manière d’introduire une forme de fonctionnement procédural, alors que le SQL est de nature ensembliste. Ce peut être très utile dans certains cas.
LATERAL : utilité
- Utilité :
- Top-N à partir de plusieurs tables
- jointure avec une fonction retournant un ensemble
- exemple : afficher les 5 derniers messages des 5 derniers sujets actifs d’un forum
LATERAL permet d’utiliser les données de la requête principale dans une sous-requête. La sous-requête sera appliquée à chaque enregistrement retourné par la requête principale.
LATERAL : exemple
L’exemple ci-dessus montre comment afficher les 5 derniers messages postés sur les 5 derniers sujets actifs d’un forum avec la clause LATERAL.
Une autre forme d’écriture emploie le mot clé JOIN, inutile dans cet exemple. Il peut avoir son intérêt si l’on utilise une jointure externe (LEFT JOIN par exemple si un sujet n’impliquait pas forcément la présence d’un message) :
Il aurait été possible de réaliser cette requête par d’autres moyens, mais LATERAL permet d’obtenir la requête la plus performante. Une autre approche quasiment aussi performante aurait été de faire appel à une fonction retournant les 5 enregistrements souhaités.
Astuce
À noter qu’une colonne date_modification a été ajouté à la table sujets afin de déterminer rapidement les derniers sujets modifiés. Sans cela, il faudrait parcourir l’ensemble des sujets, récupérer la date de publication des derniers messages avec une jointure LATERAL et récupérer les 5 derniers sujets actifs. Cela nécessite de lire beaucoup de données. Un trigger positionné sur la table messages permettra d’entretenir la colonne date_modification sur la table sujets sans difficulté. Il s’agit donc ici d’une entorse aux règles de modélisation en vue d’optimiser les traitements.
Astuce
Un index sur les colonnes sujet_id et date_publication permettra de minimiser les accès pour cette requête :
LATERAL : principe
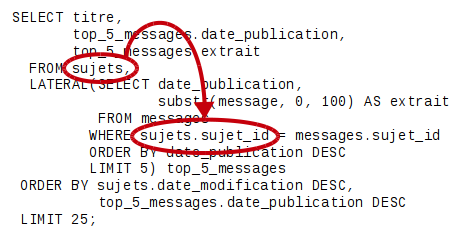
Si nous n’avions pas la clause LATERAL, nous pourrions être tentés d’écrire la requête suivante :
Cependant, la norme SQL interdit une telle construction, il n’est pas possible de référencer la table principale dans une sous-requête. Mais avec la clause LATERAL, la sous-requête peut faire appel à la table principale.
LATERAL : avec une fonction
- Utilisation avec une fonction retournant un ensemble
- clause
LATERALoptionnelle
- clause
- Utilité :
- extraire les données d’un tableau ou d’une structure JSON sous forme tabulaire
- utiliser une fonction métier qui retourne un ensemble X selon un ensemble Y fourni
L’exemple ci-dessous montre qu’il est possible d’utiliser une fonction retournant un ensemble (SRF pour Set Returning Functions).
LATERAL : exemple avec une fonction
La fonction get_top_5_messages() est la suivante :
La clause LATERAL n’est pas obligatoire, mais elle s’utiliserait ainsi :
Common Table Expressions (CTE)
- Common Table Expressions
- clauses
WITHetWITH RECURSIVE
- clauses
- Utilité :
- factoriser des sous-requêtes
CTE et SELECT
- Utilité
- factoriser des sous-requêtes
- améliorer la lisibilité d’une requête
Les Common Table Expressions, ou CTE, permettent de factoriser la définition d’une sous-requête qui pourrait être appelée plusieurs fois.
Une CTE est exprimée avec la clause WITH. Cette clause permet de définir des « vues éphémères » qui seront utilisées les unes après les autres, éventuellement en cascade, et au final utilisées dans la requête principale.
CTE et SELECT : exemple
La première utilité d’une CTE est de factoriser la définition d’une sous-requête commune, comme resultat dans l’exemple ci-dessus.
Cela est logiquement équivalent à écrire une vue resultat de même définition et à l’utiliser dans la requête. La CTE évite la création, la maintenance et la suppression de ces vues. La souplesse et, nous le verrons, même les performances peuvent y gagner. Évidemment, si la définition de resultat est utilisée dans plusieurs requêtes, une vue à part entière sera plus pertinente.
L’exemple suivant illustre une réutilisation multiple d’une même CTE. Il utilise la base d’exemple magasin. Si vous ne l’avez pas déjà, la base magasin (dump de 96 Mo, pour 667 Mo sur le disque au final) peut être téléchargée et restaurée comme suit dans une nouvelle base magasin :
Les données sont dans deux schémas, magasin et facturation. Penser au search_path.
Pour ce TP, figer les paramètres suivants :
La CTE commandes_2014 définit un ensemble de commandes, et ce jeu de données est utilisé deux fois, dans chacun des membres du UNION ALL.
Le plan d’exécution de la requête ci-dessous peut être obtenu en précédant la requête de EXPLAIN (ANALYZE, COSTS OFF, SUMMARY OFF). Une vision graphique plus complète est visible sur https://explain.dalibo.com/plan/92hce934hg875a80.
Ce plan montre que la vue commandes_2014 est exécutée une seule fois, au début. Son résultat est ensuite relu par les deux opérations de regroupements définies dans la requête principale (voir les mentions CTE Scan on commandes_2014) :
Sans CTE, il aurait fallu décrire deux fois la même sous-requête, ou créer une vue commandes_2014 qui aurait été appelée deux fois. Le coût d’exécution aurait été multiplié par deux, car il aurait fallu exécuter la sous-requête deux fois au lieu d’une.
Le temps de la requête, le résultat de la CTE peut être stocké en mémoire ou sur disque : PostgreSQL s’en occupe. Dans l’exemple ci-dessus, le résultat de la CTE est matérialisé (en mémoire ou sur disque) pour être relu. Cette méthode évite souvent le recours à des alternatives beaucoup plus lourdes comme les vues matérialisées ou les tables de travail temporaires. De nombreuses CTE ne nécessitent pas de matérialisation.
CTE et SELECT : syntaxe
On utilise aussi les CTE pour améliorer la lisibilité des requêtes complexes.
On peut enchaîner plusieurs vues les unes à la suite des autres comme dans l’exemple ci-dessous.
Il est donc possible de définir un jeu de données en plusieurs étapes dans la même requête, dans plusieurs clauses séparées, avec par exemple une première CTE pour une sélection des données, puis de l’utiliser dans une deuxième CTE pour une jointure, puis faire l’agrégat dans une troisième CTE, avec un SELECT final ne procédant qu’à un formatage. Une requête plus complexe peut devenir plus lisible. PostgreSQL, en interne, sait rassembler toutes ces vues en une requête unique.
CTE, MATERIALIZED, et barrière d’optimisation
- Clause
MATERIALIZEDpour forcer une barrière d’optimisation - Normalement automatique, et pour le meilleur
- Parfois un souci
Normalement, PostgreSQL « fusionne » le contenu d’un CTE avec les autres de la même requête pour choisir la manière dont il va récupérer les données
Il pourrait y avoir des cas où le planificateur de PostgreSQL échoue à comprendre le bon plan. Un CTE peut permettre de le forcer à exécuter les CTE dans l’ordre qui a été précisé. Cela s’appelle une « barrière d’optimisation », et cela peut se faire grâce au mot-clé MATERIALIZED :
La CTE est alors intégralement exécutée avec son filtre propre, matérialisée, puis son contenu est relu dans un autre nœud et le deuxième filtre appliqué .
En général, ce genre de manipulation n’est pas nécessaire.
À l’inverse, PostgreSQL peut choisir de « matérialiser » une CTE, notamment quand elle est utilisée plusieurs fois dans une requête (voir l’exemple plus haut).
CTE en écriture
- CTE avec des requêtes en modification
- avec
INSERT/UPDATE/DELETE - et éventuellement
RETURNING
- avec
- Exemples d’utilisation :
- requête complexe
- écriture dans plusieurs tables
- déplacement de données (archivage…)
Les CTE peuvent contenir des ordres d’écriture. Grâce à RETURNING, les données modifiées/insérées/effacées peuvent être réutilisées dans une autre partie de la requête.
Cette technique permet des requêtes très complexes capables d’écrire dans plusieurs lignes, ou déplaçant des données d’une table à une autre, dans un seul ordre. Sans les CTE, il faudrait des transactions plus complexes, avec des tables de travail, du code procédural, voire des curseurs…
CTE en écriture : exemple
La requête d’exemple permet d’archiver des données dans une table dédiée à l’archivage en utilisant une CTE en écriture. L’emploi de la clause RETURNING permet de récupérer les lignes purgées.
En plus de ce cas d’usage simple, il est possible d’utiliser cette fonctionnalité pour déboguer une requête complexe.
On peut également envisager une requête CTE en écriture pour émuler une requête MERGE pour réaliser une intégration de données complexe, là où l’UPSERT ne serait pas suffisant. Il faut toutefois avoir à l’esprit qu’une telle requête présente des problèmes de concurrences d’accès, pouvant entraîner des résultats inattendus si elle est employée alors que d’autres sessions modifient les données. On se contentera d’utiliser une telle requête dans des traitements batchs.
CTE récursive
- SQL permet d’exprimer des récursions
WITH RECURSIVE
- Utilité :
- récupérer une arborescence de menu hiérarchique
- parcourir des graphes (réseaux sociaux, etc.)
Le langage SQL permet de réaliser des récursions avec des CTE récursives. Son principal intérêt est de pouvoir parcourir des arborescences, comme par exemple des arbres généalogiques, des arborescences de service ou des entrées de menus hiérarchiques.
Il permet également de réaliser des parcours de graphes, mais les possibilités en SQL sont plus limitées de ce côté-là. En effet, SQL utilise un algorithme de type Breadth First (parcours en largeur) où PostgreSQL produit tout le niveau courant, et approfondit ensuite la récursion. Ce fonctionnement est à l’opposé d’un algorithme Depth First (parcours en profondeur) où chaque branche est explorée à fond individuellement avant de passer à la branche suivante. Ce principe de fonctionnement de l’implémentation dans SQL peut poser des problèmes sur des recherches de types réseaux sociaux où des bases de données orientées graphes, tel que Neo4J.
CTE récursive : exemple (1/2)
Voici le résultat de cette requête :
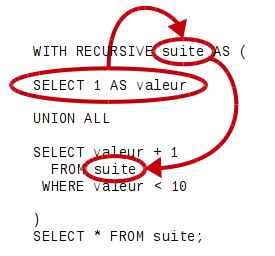
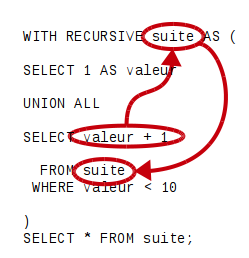
L’exécution de cette requête commence avec le SELECT 1 AS valeur (la requête avant le UNION ALL), d’où la première ligne avec la valeur 1. Puis PostgreSQL exécute le SELECT valeur + 1 FROM suite WHERE valeur < 10 tant que cette requête renvoie des lignes. À la première exécution, il additionne 1 avec la valeur précédente (1), ce qui fait qu’il renvoie 2. À la deuxième exécution, il additionne 1 avec la valeur précédente (2), ce qui fait qu’il renvoie 3. Etc. La récursivité s’arrête quand la requête ne renvoie plus de ligne, autrement dit quand la colonne vaut 10.
Cet exemple n’a aucun autre intérêt que de présenter la syntaxe permettant de réaliser une récursion en langage SQL.
CTE récursive : principe
- 1ère étape : initialisation de la récursion
CTE récursive : principe
- récursion : la requête s’appelle elle-même
CTE récursive : exemple (2/2)
Cet exemple suivant porte sur le parcours d’une arborescence de menu hiérarchique.
Une table entrees_menu est créée :
Elle dispose du contenu suivant :
Nous allons définir une CTE récursive qui va afficher l’arborescence du menu Terminal. La récursion va donc commencer par chercher la ligne correspondant à cette entrée de menu dans la table entrees_menu. Une colonne calculée arborescence est créée, elle servira plus tard dans la récursion :
La requête qui réalisera la récursion est une jointure entre le résultat de l’itération précédente, obtenu par la vue parcours_menu de la CTE, qui réalisera une jointure avec la table entrees_menu sur la colonne entrees_menu.parent_id qui sera jointe à la colonne menu_id de l’itération précédente.
La condition d’arrêt de la récursion n’a pas besoin d’être exprimée. En effet, les entrées terminales des menus ne peuvent pas être jointes avec de nouvelles entrées de menu, car il n’y a pas d’autre correspondance avec parent_id).
On obtient ainsi la requête CTE récursive présentée ci-dessus.
Pour des besoins plus complexes existe l’extension pgRouting, souvent utilisée pour des recherches de chemin d’un point à un autre. À titre d’exemple, voici l’implémentation du jeu des six degrés de Kevin Bacon en utilisant pgRouting et l’algorithme de recherche du plus court chemin de Dijkstra :
Concurrence d’accès
- Problèmes pouvant se poser :
UPDATEperdu- lecture non répétable
- Plusieurs solutions possibles
- versionnement des lignes
SELECT FOR UPDATESERIALIZABLE
Plusieurs problèmes de concurrences d’accès peuvent se poser quand plusieurs transactions modifient les mêmes données en même temps.
Tout d’abord, des UPDATE peuvent être perdus, dans le cas où plusieurs transactions lisent la même ligne, puis la mettent à jour sans concertation. Par exemple, si la transaction 1 ouvre une transaction et effectue une lecture d’une ligne donnée :
La transaction 2 effectue les mêmes traitements :
Après un traitement applicatif, la transaction 1 met les données à jour pour noter l’augmentation de 5 % du salarié. La transaction est validée dans la foulée avec COMMIT :
Après un traitement applicatif, la transaction 2 met également les données à jour pour noter une augmentation exceptionnelle de 100 € :
Le salarié a normalement droit à son augmentation de 100 € ET l’augmentation de 5 %, or l’augmentation de 5 % a été perdue car écrasée par la transaction n°2. Ce problème aurait pu être évité de trois façons différentes :
- en effectuant un
UPDATEutilisant la valeur lue par l’ordreUPDATE(… SET salaire = salaire*1.05 WHERE …) au lieu ; - en verrouillant les données lues avec
SELECT FOR UPDATE: ces verrous peuvent cependant ralentir l’application ; - en utilisant le niveau d’isolation
SERIALIZABLE.
La première solution n’est pas toujours envisageable, il faut donc se tourner vers les deux autres solutions.
Le problème des lectures sales (dirty reads) ne peut pas se poser car PostgreSQL n’implémente pas le niveau d’isolation READ UNCOMMITTED. Si ce niveau d’isolation est sélectionné, PostgreSQL utilise alors le niveau READ COMMITTED.
SELECT FOR UPDATE
SELECT FOR UPDATE- Utilité :
- « réserver » des lignes en vue de leur mise à jour
- éviter les problèmes de concurrence d’accès
L’ordre SELECT FOR UPDATE permet de lire des lignes tout en les réservant en posant un verrou dessus en vue d’une future mise à jour. Le verrou n’interdira pas la lecture par une autre session, mais mettra toute mise à jour en attente.
Reprenons l’exemple précédent et utilisons SELECT FOR UPDATE pour voir si le problème de concurrence d’accès peut être résolu.
Session 1 :
La requête SELECT a retourné les données souhaitées.
Session 2 :
La requête SELECT ne rend pas la main, elle est mise en attente.
Session 3 :
Une troisième session effectue une lecture, sans poser de verrou explicite :
Le SELECT n’a pas été bloqué par la session 1. Seule la session 2 est bloquée car elle tente d’obtenir le même verrou.
Session 1 :
L’application a effectué ses calculs et met à jour les données en appliquant l’augmentation de 5 % :
Les données sont vérifiées :
Enfin, la transaction est validée :
Session 2 :
La session 2 a rendu la main, le temps d’attente a été important pour réaliser ces calculs complexes :
Le salaire obtenu est bien le salaire mis à jour par la session 1. Sur cette base, l’application applique l’augmentation de 100 € :
La transaction est validée :
Les deux transactions ont donc été effectuée de manière sérialisée, l’augmentation de 100 € ET l’augmentation de 5 % ont été accordées à Fantasio. En contrepartie, l’une des deux transactions concurrentes a été mise en attente afin de pouvoir sérialiser les transactions. Cela implique de penser les traitements en verrouillant les ressources auxquelles on souhaite accéder.
L’ordre SELECT FOR UPDATE dispose également d’une option NOWAIT qui permet d’annuler la transaction courante si un verrou ne pouvait être acquis. Si l’on reprend les premières étapes de l’exemple précédent :
Session 1 :
Aucun verrou préalable n’avait été posé, la requête SELECT a retourné les données souhaitées.
Session 2 :
On effectue la même chose sur la session n°2 :
Comme la session n°1 possède déjà un verrou sur la ligne qui nous intéresse, l’option NOWAIT sur le SELECT a annulé la transaction.
Une application bien conçue interceptera l’erreur et décidera d’abandonner ou recommencer plus tard la mise à jour, au lieu d’attendre, peut-être très longtemps, que le verrou soit levé.
Il faut maintenant effectuer un ROLLBACK explicite pour pouvoir recommencer les traitements au risque d’obtenir le message suivant :
SKIP LOCKED
SELECT FOR UPDATE SKIP LOCKED- Utilité :
- files d’attentes parallélisables
Une dernière fonctionnalité intéressante de SELECT FOR UPDATE est idéal dans le cas de différents workers qui consomment des tâches d’une table contenant une file d’attente. Il s’agit de la clause SKIP LOCKED.
En prenant une table représentant la file d’attente suivante, peuplée avec des données générées :
Une première transaction est ouverte et tente d’obtenir un verrou sur les 10 premières lignes :
La session va s’occuper ensuite de ces lignes avant de rendre la main, ce qui peut prendre plus ou moins de temps.
Si on démarre une seconde transaction en parallèle, avec la première transaction toujours ouverte, le fait d’exécuter la requête SELECT FOR UPDATE sans la clause SKIP LOCKED aurait pour effet de la mettre en attente. Le deuxième SELECT ne rendra la main lorsque la transaction n°1 se terminera, et s’apercevra peut-être ensuite que les lignes ont déjà été traitées par la première session.
Avec la clause SKIP LOCKED, les 10 premières verrouillées par la transaction n°1 seront ignorées puisque déjà verrouillées, et ce sont les 10 lignes suivantes qui seront selectionnées, verrouillées et retournées par l’ordre SELECT :
Ensuite, la première transaction supprime les lignes verrouillées et valide la transaction :
De même pour la seconde transaction, qui aura traité d’autres lignes en parallèle de la transaction n°1.
Serializable Snapshot Isolation
SSI : Serializable Snapshot Isolation
- Chaque transaction est seule sur la base
- Si on ne peut maintenir l’illusion
- une des transactions en cours est annulée
- Sans blocage
- On doit être capable de rejouer la transaction
- Toutes les transactions impliquées doivent être
serializable default_transaction_isolation=serializabledans la configuration
PostgreSQL fournit plusieurs modes d’isolation, pour un bon compromis entre fiabilité et performances. Par défaut, en mode READ COMMITTED, une transaction en cours d’exécution peut voir les modifications committés par d’autres transactions parallèles. En mode REPEATABLE READ, une transaction ne voit que les données telles qu’au début de la transaction, et ses propres modifications.
PostgreSQL fournit un autre mode d’isolation appelé SERIALIZABLE. Dans ce mode, toutes les transactions déclarées comme telles s’exécutent comme si elles étaient seules sur la base. Dès que cette garantie ne peut plus être apportée, une des transactions est annulée.
L’intérêt est par exemple de pouvoir garantir que certaines validations touchant d’autres tables pourront s’effectuer sans race conditions, et ce sans poser des verrous trop gênants. L’application doit bien sûr être prête à ce que ses transactions échouent souvent, et à retenter ensuite.
Toute transaction non déclarée comme SERIALIZABLE peut en théorie s’exécuter n’importe quand, ce qui rend inutile le mode SERIALIZABLE sur les autres. C’est donc un mode qui doit être mis en place sur un domaine assez large.
Dans l’exemple suivant, des enregistrements avec une colonne couleur contiennent ‘blanc’ ou ‘rouge’. Deux utilisateurs essayent simultanément de convertir tous les enregistrements vers une couleur unique, mais chacun dans une direction opposée. Un utilisateur veut passer tous les blancs en rouge, et l’autre tous les rouges en blanc.
L’exemple peut être mis en place avec ces ordres :
Session 1 :
Session 2 :
À ce moment, une des deux transaction est condamnée à mourir.
Session 2 :
Le premier à valider gagne.
Session 1 :
Celle-ci s’est exécutée comme si elle était seule.
Une erreur de sérialisation. On annule et on réessaye.
Il n’y a pas de transaction concurrente pour gêner.
La transaction s’est exécutée seule, après l’autre.
Le mode SERIALIZABLE permet de s’affranchir des SELECT FOR UPDATE qu’on écrit habituellement, dans les applications en mode READ COMMITTED. Toutefois, il fait bien plus que ça, puisqu’il réalise du verrouillage de prédicats. Un enregistrement qui « apparaît » ultérieurement suite à une mise à jour réalisée par une transaction concurrente déclenchera aussi une erreur de sérialisation. Il permet aussi de gérer les problèmes ci-dessus avec plus de deux sessions.
Pour des exemples plus complets, le mieux est de consulter la documentation officielle.
Conclusion
- SQL est un langage très riche
- Connaître les nouveautés des versions de la norme depuis 20 ans permet de
- gagner énormément de temps de développemment
- mais aussi de performance
Quiz
Travaux pratiques
La version en ligne des solutions de ces TP est disponible sur https://dali.bo/s60_solutions.
Jointure latérale
Cette série de question utilise la base de TP magasin. Si vous ne l’avez pas déjà, la base magasin (dump de 96 Mo, pour 667 Mo sur le disque au final) peut être téléchargée et restaurée comme suit dans une nouvelle base magasin :
Les données sont dans deux schémas, magasin et facturation. Penser au search_path.
Pour ce TP, figer les paramètres suivants :
Afficher les 10 derniers articles commandés.
Pour chacune des 10 dernières commandes passées, afficher le premier article commandé (ID et nom).
CTE récursive
Si vous ne l’avez pas déjà, la table genealogie peut être téléchargée depuis https://dali.bo/tp_genealogie et restaurée à l’aide de pg_restore :
Voici la description de la table genealogie qui sera utilisée :
À partir de la table
genealogie, déterminer qui sont les descendants de Fernand DEVAUX.
À l’inverse, déterminer qui sont les ancètres de Adèle TAILLANDIER
Réseau social
Si vous ne l’avez pas déjà, la table socialnet peut être téléchargée et restaurée ainsi :
Cet exercice est assez similaire au précédent et propose de manipuler des arborescences.
Astuce
Les tableaux et la fonction unnest() peuvent être utiles pour résoudre plus facilement ce problème.
La table personnes contient la liste de toutes les personnes d’un réseau social.
La table relation contient les connexions entre ces personnes.
Déterminer le niveau de connexions entre Sadry Luettgen et Yelsi Kerluke et afficher le chemin de relation le plus court qui permet de les connecter ensemble.
Dépendance de vues
Les dépendances entre objets est un problème classique dans les bases de données :
- dans quel ordre charger des tables selon les clés étrangères ?
- dans quel ordre recréer des vues ?
- etc.
Le catalogue de PostgreSQL décrit l’ensemble des objets de la base de données. Deux tables vont nous intéresser pour mener à bien cet exercice :
pg_dependliste les dépendances entre objetspg_rewritestocke les définitions des règles de réécritures des vues (RULES)pg_classliste les objets que l’on peut interroger comme une table, hormis les fonctions retournant des ensembles
La définition d’une vue peut être obtenue à l’aide de la fonction pg_get_viewdef.
Pour plus d’informations sur ces tables, se référer à la documentation :
- Catalogue
pg_depend - Catalogue
pg_rewrite - Catalogue
pg_class - Fonctions d’information du catalogue système
L’objectif de se TP consiste à récupérer l’ordre de suppression et de recréation des vues de la base brno2015 en fonction du niveau de dépendances entre chacune des vues. Brno est une ville de Tchéquie, dans la région de Moravie-du-Sud. Le circuit Brno-Masaryk est situé au nord-ouest de la ville. Le Grand Prix moto de Tchéquie s’y déroule chaque année.
Si vous ne l’avez pas déjà, la base brno2015 avec la table du même nom peut être téléchargée et restaurée ainsi :
Retrouver les dépendances de la vue
pilotes_brno. Déduisez également l’ordre de suppression et de recréation des vues.
Travaux pratiques (solutions)
Jointure latérale
Afficher les 10 derniers articles commandés.
Tout d’abord, nous positionnons le search_path pour chercher les objets du schéma magasin :
On commence par afficher les 10 dernières commandes :
Une simple jointure nous permet de retrouver les 10 derniers articles commandés :
Pour chacune des 10 dernières commandes passées, afficher le premier article commandé (ID et nom).
La requête précédente peut être dérivée pour répondre à la question demandée. Ici, pour chacune des dix dernières commandes, nous voulons récupérer le nom du dernier article commandé, ce qui sera transcrit sous la forme d’une jointure latérale :
CTE récursive
À partir de la table
genealogie, déterminer qui sont les descendants de Fernand DEVAUX.
À l’inverse, déterminer qui sont les ancètres de Adèle TAILLANDIER
Réseau social
Déterminer le niveau de connexions entre Sadry Luettgen et Yelsi Kerluke et afficher le chemin de relation le plus court qui permet de les connecter ensemble.
La requête suivante permet de répondre à cette question :
Attention
Cet exemple fonctionne sur une faible volumétrie, mais les limites des bases relationnelles sont rapidement atteintes sur de telles requêtes.
Une solution consisterait à implémenter un algorithme de parcours de graphe avec pgRouting, mais il faudrait présenter les données sous une forme particulière. Pour les problématiques de traitement de graphe, notamment sur de grosses volumétries, une base de données orientée graphe comme Neo4J peut être plus adaptée.
Dépendance de vues
Retrouver les dépendances de la vue
pilotes_brno. Déduisez également l’ordre de suppression et de recréation des vues.
Si la jointure entre pg_depend et pg_rewrite est possible pour l’objet de départ, alors il s’agit probablement d’une vue. En discriminant sur les objets qui référencent la vue pilotes_brno, nous arrivons à la requête de départ suivante :
La présence de doublons nous oblige à utiliser la clause DISTINCT.
Nous pouvons donc créer un graphe de dépendances à partir de cette requête de départ, transformée en requête récursive :
Il faut maintenant résoudre les OID pour déterminer les noms des vues et leur schéma. Pour cela, nous ajoutons une vue resolved telle que :
Nous pouvons maintenant présenter les ordres de suppression et de recréation des vues, dans le bon ordre. Les vues doivent être supprimées selon le numéro d’ordre décroissant et recrées selon le numéro d’ordre croissant :