Transcription française complète du chapitre « SQL pour l’analyse de données » du manuel DEV42, révision 26.09, pages PDF 23 à 86.
DEV42
SQL pour l’analyse de données
Préambule
Analyser des données est facile avec PostgreSQL
opérations d’agrégation disponibles
fonctions OLAP avancées
Menu
Agrégation de données
Clause FILTER
Fonctions WINDOW
GROUPING SETS, ROLLUP, CUBE
WITHIN GROUPS
Objectifs
Écrire des requêtes encore plus complexes
Analyser les données en amont
pour ne récupérer que le résultat
Tables d’exemple
Table employes
Tables population et continents
La plupart des exemples utilisent une petite table employes à créer ainsi, dans la base de votre choix :
-- Si la table existe déjà, la détruire
DROPTABLEIFEXISTSemployesCASCADE;-- Création de la table
CREATETABLEemployes(matriculechar(8)PRIMARYKEY,nomtextNOTNULL,servicetext,salairenumeric(7,2));-- Données
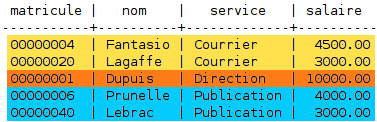
INSERTINTOemployes(matricule,nom,service,salaire)VALUES('00000001','Dupuis','Direction',10000.00),('00000004','Fantasio','Courrier',4500.00),('00000006','Prunelle','Publication',4000.00),('00000020','Lagaffe','Courrier',3000.00),('00000040','Lebrac','Publication',3000.00);SELECT*FROMemployes;
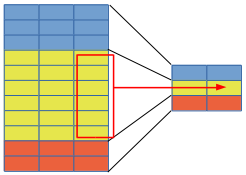
Ici, la base de données réalise les calculs sur l’ensemble des données de la table, car il n’y a ni clause WHERE ni jointure. Ne s’affiche que le résultat du calcul, pas les données qui ont été utilisées.
Si l’on applique un filtre sur les données, par exemple pour ne prendre en compte que le service Courrier, alors PostgreSQL réalise le calcul uniquement sur les données issues de la lecture :
Une limitation : il n’est pas possible de référencer d’autres colonnes pour les afficher à côté du résultat d’un calcul d’agrégation à moins de les utiliser comme critère de regroupement avec GROUP BY :
SELECTavg(salaire),nomFROMemployes;
ERROR:  column "employes.nom" must appear in the GROUP BY clause or be used in
        an aggregate function
LIGNE 1 : SELECT avg(salaire), nom FROM employes;
                               ^
En effet, cela reviendrait à afficher une donnée agrégée (avg()) sur une ligne qui fait partie de l’agrégat. Ce n’est pas prévu par le SQL dans sa version originale. Nous verrons plus loin les fonctions de fenêtrage pour faire rigoureusement ce genre de chose.
Agrégats avec GROUP BY
agrégat + GROUP BY
Utilité
effectue des calculs sur des regroupements : moyenne, somme, comptage, etc.
regroupement selon un critère défini par la clause GROUP BY
exemple : calcul du salaire moyen de chaque service
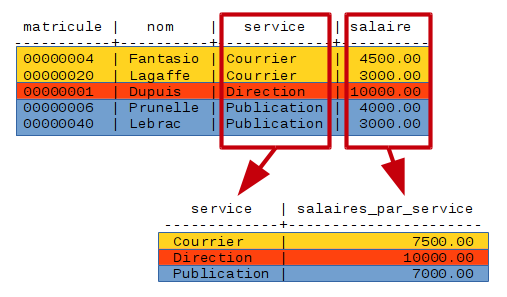
L’opérateur d’agrégat GROUP BY indique à la base de données que l’on souhaite regrouper les données selon les mêmes valeurs d’une colonne.
Opérateur GROUP BY
Des calculs pourront être réalisés sur les données agrégées selon le critère de regroupement donné. Le résultat sera alors représenté en n’affichant que les colonnes de regroupement puis les valeurs calculées par les fonctions d’agrégation :
Agrégats
GROUP BY : principe
L’agrégation est ici réalisée sur la colonne service. En guise de calcul d’agrégation, une somme est réalisée sur les salaires payés dans chaque service.
   service   | salaires_par_service
-------------+----------------------
 Courrier    |              7500.00
 Direction   |             10000.00
 Publication |              7000.00
(3 lignes)
SQL permet depuis le début de réaliser des calculs d’agrégation. Pour cela, la base de données observe les critères de regroupement définis dans la clause GROUP BY de la requête et effectue l’opération sur l’ensemble des lignes qui correspondent au critère de regroupement.
Pour avoir un total sur tous les services, une première technique est de le calculer séparément, et de combiner le résultat des deux requêtes d’agrégation avec UNION ALL, si les lignes retournées sont de même type :
   service   | salaires_par_service
-------------+----------------------
 Courrier    |              7500.00
 Direction   |             10000.00
 Publication |              7000.00
 Total       |             24500.00
(4 lignes)
On le verra plus loin, cette dernière requête peut être écrite plus simplement avec les GROUPING SETS.
Agrégats et ORDER BY
Extension propriétaire de PostgreSQL
ORDER BY dans la fonction d’agrégat
Utilité :
ordonner les données agrégées
surtout utile avec array_agg, string_agg et xmlagg
Les fonctions array_agg, string_agg et xmlagg permettent d’agréger des éléments dans un tableau, dans une chaîne ou dans une arborescence XML. Autant l’ordre dans lequel les données sont utilisées n’a pas d’importance lorsque l’on réalise un calcul d’agrégat classique, autant cet ordre va influencer la façon dont les données seront produites par les trois fonctions citées plus haut. En effet, le tableau généré par array_agg est composé d’éléments ordonnés, de même que la chaîne de caractères ou l’arborescence XML.
   service   |   liste_employes
-------------+--------------------
 Courrier    | {Fantasio,Lagaffe}
 Direction   | {Dupuis}
 Publication | {Lebrac,Prunelle}
Il est possible de réaliser la même chose mais pour obtenir un tableau plutôt qu’une chaîne de caractère.
Un tableau est un type composé dans PostgreSQL. Plusieurs valeurs peuvent être stockées dans un unique champ d’une ligne. Le maniement ensuite est bien sûr un peu plus compliqué.
Clause FILTER
Clause FILTER
Utilité :
filtrer les données sur les agrégats
évite les expressions CASE complexes
SQL:2003
La clause FILTER permet de remplacer des expressions complexes écrites avec CASE et donc de simplifier l’écriture de requêtes réalisant un filtrage dans une fonction d’agrégat.
Le premier calcul count(*) compte simplement le nombre de lignes. Le second, count(CASE … ELSE NULL END), compte les pays européens. Pour cela, il utilise un opérateur CASE qui renvoie NULL si le pays n’est pas en Europe, et Oui sinon (n’importe quelle valeur non nulle aurait fait l’affaire), et au final le count renvoie le nombre de valeurs non nulles calculées sur la ligne.
Une variante de cette requête peut s’écrire avec sum(), qui somme des 1 et des 0 selon que le pays est en Europe ou pas :
Cela fonctionne, mais dès que l’on a besoin d’avoir de multiples filtres, ou des filtres plus complexes, la requête devient très rapidement peu lisible et difficile à maintenir. Le risque d’erreur est également élevé.
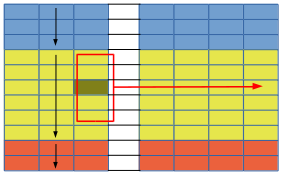
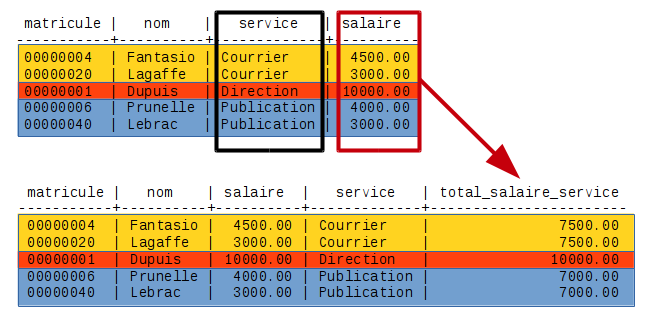
Les calculs réalisés par cette requête sont identiques à ceux réalisés avec une agrégation utilisant GROUP BY. La principale différence est que l’on évite ici de perdre le détail des données tout en disposant des données agrégées dans le résultat de la requête.
Les calculs du champ total_salaire_service sont ceux que l’on a déjà pu effectuer ainsi :
Avec le fenêtrage, le salaire est sommé par service (comme indiqué par la clause OVER), et le résultat est reporté sur chaque ligne correspondant à ce service. La valeur peut se répéter d’une ligne à l’autre.
Tout cela est plus compliqué, voire illisible et source d’erreurs quand les critères deviennent complexes.
Les fonctions de fenêtrage sont optimisées et offrent de bien meilleures performances que les requêtes ci-dessus !
Notamment, la syntaxe avec le fenêtrage ne parcourt la table qu’un fois, au contraire de toutes les requêtes en SQL plus simple ci-dessus, qui la parcourent deux fois ou plus.
Fonctions de fenêtrage : utilisation
Fonctions de fenêtrage avec OVER ( … )
travail sur des ensembles de données, regroupés et triés, indépendamment de la requête principale
Utilisation :
référence à d’autres lignes de l’ensemble de données
différents critères d’agrégation dans la même requête
fonctions de classement
Exemples :
ratios entre ligne et ensemble
sommes courantes, moyennes glissantes
évolution entre deux lignes
Performances
L’exemple précédent est très simple mais il montre déjà que les fonctions de fenêtrage permettent de travailler sur un ensemble de lignes, filtrées mais que l’on pourra aussi ordonner, tout en affichant le résultat d’une ligne. Plusieurs fonctions de fenêtrage sont utilisables (par exemple sum() OVER () et avg() SUM OVER()).
La clause OVER permet de définir la façon dont les données sont regroupées uniquement pour la colonne définie. La clause PARTITION BY définit un regroupement mais il y a déjà d’autres possibilités.
Il est déjà possible de calculer un ratio entre une valeur de la ligne et un agrégat par fenêtrage par une simple division. Avec une syntaxe un peu plus complexe, les fonctions de fenêtrage permettent de calculer des sommes courantes, ou l’évolution d’une valeur d’une ligne à l’autre.
La syntaxe est plus simple que des requêtes SQL complexes, et les performances sont meilleures.
NB : rien à voir avec le partitionnement d’une table
Le terme PARTITION BY permet d’indiquer les critères de regroupement de la fenêtre sur laquelle on souhaite travailler.
Ne pas confondre cette clause avec le « partitionnement » d’une table, qui consiste, en simplifiant, à découper une grande table en sous-tables physiques plus petites. Les deux concepts n’ont rien à voir. PARTITION BY consiste uniquement à regrouper logiquement des lignes récupérées par la requête.
Fenêtrage et tri : OVER (ORDER BY …)
OVER(ORDERBYmatricule)
Utilité :
numéroter les lignes : row_number()
classer des résultats : rank(), dense_rank()
faire appel à d’autres lignes du résultat : lead(), lag()
Le tri du fenêtrage est indépendant du ORDER BY des lignes
La clause OVER (ORDER BY…) permet de calculer une fonction qui dépend d’un tri comme des fonctions de numérotation de ligne. Cet ordre est indépendant de celui qu’une clause ORDER BY peut imposer aux lignes une fois qu’elles ont toutes été calculées.
La fonction row_number() permet de numéroter les lignes selon un critère de tri défini dans la clause OVER(). Dans l’exemple ci-dessus, le row_number suit l’ordre alphabétique (Dupuis puis Fantasio puis Lagaffe, etc.), puis les lignes calculées sont ordonnées par matricule.
La clause (ORDER BY …) peut contenir plusieurs colonnes, ou des précisions comme DESC ou NULLS FIRST.
Fenêtrage et tri : numéroter des lignes sans critère
Les row_number() over() dans des vues sont des soucis de performance fréquents : la numérotation a lieu avant tout filtrage depuis la requête appelante !
En effet, une vue est équivalente à une sous-requête et la numérotation des lignes s’effectue donc selon le résultat de cette sous-requête, sans prise en compte d’un critère présent dans la requête.
Prenons un exemple :
CREATETABLEdemo(idintGENERATEDALWAYSASIDENTITY,cletext,donneestext);INSERTINTOdemo(cle,donnees)SELECT(i/3.0)::int::text,'data'FROMgenerate_series(1,10000)i;VACUUMANALYZEdemo;CREATEINDEXONdemo(cle);/* Utilisation directe en SQL : 3 lignes numéros 1 à 3 */SELECTrow_number()OVER()ASnumligne,id,cle,donneesFROMdemoWHEREcle='500';
 numligne |  id  | cle | donnees
----------+------+-----+---------
        1 | 1499 | 500 | data
        2 | 1500 | 500 | data
        3 | 1501 | 500 | data
/* Le plan indique bien l'utilisation de l'index */EXPLAIN(COSTSOFF)SELECTrow_number()OVER()ASnumligne,id,cle,donneesFROMdemoWHEREcle='500';
                  QUERY PLAN
-----------------------------------------------
 WindowAgg
   Window: w1 AS (ROWS UNBOUNDED PRECEDING)
   ->  Bitmap Heap Scan on demo
         Recheck Cond: (cle = '500'::text)
         ->  Bitmap Index Scan on demo_cle_idx
               Index Cond: (cle = '500'::text)
/* Même requête, dans une vue */CREATEVIEWdemovASSELECTrow_number()OVER()ASnumligne,id,cle,donneesFROMdemo;/* Le plan montre un parcours complet
puis le filtrage en fin de requête */EXPLAIN(COSTSOFF)SELECT*FROMdemovWHEREcle='500';
                    QUERY PLAN
--------------------------------------------------
 Subquery Scan on demov
   Filter: (demov.cle = '500'::text)
   ->  WindowAgg
         Window: w1 AS (ROWS UNBOUNDED PRECEDING)
         ->  Seq Scan on demo
/* Les 3 lignes sont numérotées avant le filtrage */SELECT*FROMdemovWHEREcle='500';
 numligne |  id  | cle | donnees
----------+------+-----+---------
     1499 | 1499 | 500 | data
     1500 | 1500 | 500 | data
     1501 | 1501 | 500 | data
En effet, la vue se comporte comme une sous-requête, et la requête avec la vue revient à :
 numligne |  id  | cle | donnees
----------+------+-----+---------
        1 | 1499 | 500 | data
        2 | 1500 | 500 | data
        3 | 1501 | 500 | data
Si le but est seulement de numéroter les lignes pour les distinguer par la suite, ou si elles sont déjà triées dans l’ordre voulu, le plus simple et économique est l’utilisation d’une séquence (SELECT nextval('nom_seq'), * FROM …). Dans beaucoup de cas, il n’est même pas nécessaire qu’elle commence à 1 (sinon exécuter ALTER SEQUENCE donnees_id_seq RESTART 1 ;).
Fenêtrage et tri : rang
Rang selon le salaire :
SELECTmatricule,nom,salaire,service,rank()OVER(ORDERBYsalaire),dense_rank()OVER(ORDERBYsalaire)-- pas de trous
FROMemployes;
La fonction de fenêtrage rank() renvoie un classement en autorisant des trous dans la numérotation quand il y a ex-aequos, et dense_rank() le classement sans trous.
Ces fonctions seraient beaucoup plus compliquées à écrire en SQL.
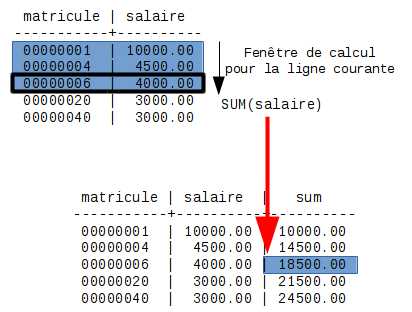
OVER (ORDER BY …) peut aussi être utilisé avec sum(). Là où SUM () OVER (PARTITION BY….) calculait une somme d’un regroupement, SUM() OVER (ORDER BY…) calcule la somme courante selon le tri en cours.
Là encore, attention à la cohérence entre le tri du calcul et celui de l’affichage si cela a une importance :
Lorsque l’on utilise une clause de tri, la portion de données visible par l’opérateur d’agrégat correspond aux données comprises entre la première ligne examinée et la ligne courante.
Par défaut, la fenêtre de calcul intègre les lignes précédant celle en cours, incluse, ce qui correspond à ceci avec la syntaxe complète :
travailler sur des jeux de données ordonnés et isolés les uns des autres
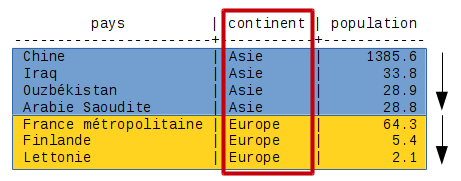
Il est possible de combiner les clauses de fenêtrage PARTITION BY et ORDER BY. Cela permet d’isoler des jeux de données entre eux avec la clause PARTITION BY, tout en appliquant un critère de tri avec la clause ORDER BY. Beaucoup d’applications sont possibles si l’on associe à cela les nombreuses fonctions analytiques disponibles.
    continent     |       pays         | population | rang
------------------+--------------------+------------+------
 Afrique          | Nigéria            |      173.6 |    1
 Afrique          | Éthiopie           |       94.1 |    2
 Afrique          | Égypte             |       82.1 |    3
 Afrique          | Rép. dém. du Congo |       67.5 |    4
(…)
 Amérique du Nord | États-Unis         |      320.1 |    1
 Amérique du Nord | Canada             |       35.2 |    2
(…)
Si l’on applique les deux clauses PARTITION BY et ORDER BY à une fonction de fenêtrage, alors le critère de tri est appliqué dans la partition et chaque partition est indépendante l’une de l’autre.
Ci-dessus, le Nigéria et les États-Unis sont bien les pays les plus peuplés de leur continent respectif.
Voici un extrait plus complet du résultat de la requête présentée ci-dessus :
Cette construction ne pose aucune difficulté syntaxique. La norme impose de placer la clause PARTITION BY avant la clause ORDER BY, c’est la seule chose à retenir au niveau de la syntaxe.
faire référence à d’autres lignes du même ensemble
évite les auto-jointures complexes et lentes
Sans les fonctions analytiques, il serait difficile en SQL d’écrire des requêtes nécessitant de faire appel à des données provenant d’autres lignes que la ligne courante.
Par exemple, pour renvoyer la liste détaillée de tous les employés ET le salaire le plus élevé du service auquel il appartient, on peut utiliser la fonction first_value() :
         pays          | continent | population |  lag
-----------------------+-----------+------------+--------
 Nigéria               | Afrique   |      173.6 |
 Éthiopie              | Afrique   |       94.1 | 173.6
 Égypte                | Afrique   |       82.1 |  94.1
 …
 Tunisie               | Afrique   |       11.0 |  14.1
 Féd. de Russie        | Europe    |      142.8 |
 Allemagne             | Europe    |       82.7 | 142.8
 France métropolitaine | Europe    |       64.3 |  82.7
 Royaume-Uni           | Europe    |       63.1 |  64.3
 Italie                | Europe    |       61.0 |  63.1
 …
 Malte                 | Europe    |        0.4 |   0.5
(53 lignes)
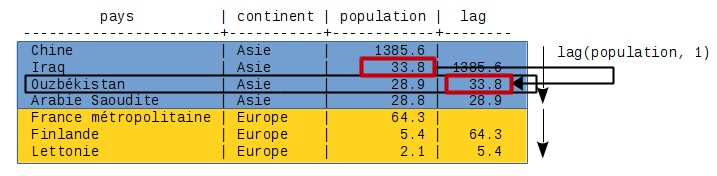
L’exemple ci-dessus utilise une fonction de fenêtrage par continent.
Avec lag(), il est possible de ramener la valeur de la ligne précédente selon le tri sur population sur la ligne en cours. NULL est renvoyé lorsque la valeur n’est pas accessible dans la fenêtre de données, comme pour le pays le plus peuplé de chaque continent.
retourne la n-ème valeur (en comptant à partir de 1) pour la colonne
Figurent plus haut des exemples avec dense_rank ou row_number. Il existe également les fonctions suivantes :
last_value(colonne) : renvoie la dernière valeur pour la colonne ;
nth_value(colonne, n) : renvoie la nᵉ valeur (en comptant à partir de 1) pour la colonne ;
lag(colonne, n) : renvoie la valeur située en nᵉ position avant la ligne en cours pour la colonne ;
lead(colonne, n) : renvoie la valeur située en nᵉ position après la ligne en cours pour la colonne ;
pour ces deux fonctions, le n est facultatif et vaut 1 par défaut : lead(colonne) est équivalente à lead(colonne, 1) et lag(colonne) est équivalente à lag(colonne, 1), pour récupérer les valeurs suivante ou précédente de la colonne ;
ces deux fonctions acceptent un troisième argument facultatif spécifiant la valeur à renvoyer si aucune valeur n’est trouvée en nᵉ position avant ou après. Par défaut, NULL est renvoyé.
         pays          | continent | population | first_value
-----------------------+-----------+------------+-------------
 Nigéria               | Afrique   |      173.6 |       173.6
 Éthiopie              | Afrique   |       94.1 |       173.6
 Égypte                | Afrique   |       82.1 |       173.6
 …
 Féd. de Russie        | Europe    |      142.8 |       142.8
 Allemagne             | Europe    |       82.7 |       142.8
 France métropolitaine | Europe    |       64.3 |       142.8
 …
Lorsque la clause ORDER BY est utilisée pour définir une fenêtre, la fenêtre visible depuis la ligne courante commence par défaut à la première ligne de résultat et s’arrête à la ligne courante incluse (clause implicite RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW).
Cela pose un souci avec last_value() qui récupère la dernière valeur d’une fenêtre où la dernière valeur triée est toujours celle de la ligne :
Il arrive que l’on ait besoin d’utiliser plusieurs fonctions de fenêtrage au sein d’une même requête qui utilisent la même définition de fenêtre (même clause PARTITION BY et/ou ORDER BY). Afin d’éviter de dupliquer cette clause, il est possible de définir une fenêtre nommée et de l’utiliser à plusieurs endroits de la requête. Par exemple, l’exemple précédant des fonctions de classement pourrait s’écrire :
À noter qu’il est possible de définir de multiples définitions de fenêtres au sein d’une même requête, et qu’une définition de fenêtre peut surcharger la clause ORDER BY si la définition parente ne l’a pas définie. Par exemple, la requête SQL suivante est correcte :
Lorsque la clause ORDER BY est utilisée pour définir une fenêtre, la fenêtre visible depuis la ligne courante commence par défaut à la première ligne de résultat et s’arrête à la ligne courante incluse (clause implicite RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW).
La clause RANGE BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING inclut toutes les lignes avant et après ligne courante (voir plus haut l’exemple avec last_value).
Fenêtre de travail avec RANGE
Intervalle à bornes flou
Borne de départ :
UNBOUNDED PRECEDING: depuis le début de la partition
CURRENT ROW : depuis la ligne courante
Borne de fin :
UNBOUNDED FOLLOWING : jusqu’à la fin de la partition
La syntaxe ROWS BETWEEN xxx PRECEDING AND xxx FOLLOWING permet de restreindre la fenêtre à un certain nombre de lignes avant et après la ligne en cours. Un cas d’utilisation est constitué par les moyennes glissantes.
Exemple :
Le jeu de valeur suivant donne un salaire brut sur douze mois qui varie chaque mois. La valeur moyenne du salaire mensuel sur toute l’année se calcule avec avg () OVER (), et est une moyenne sur toutes les données. Avec avg() OVER(ORDER BY mois) se calcule une moyenne sur la fenêtre par défaut, c’est-à-dire depuis le premier mois jusque la ligne courante. Enfin, le dernier champ utilise la syntaxe ROWS pour définir une moyenne mobile arithmétique, c’est-à-dire que la valeur sur la ligne est la moyenne des trois valeurs des lignes précédente, suivante, et en cours (sauf pour les première et dernière lignes qui ne moyennent que deux valeurs).
Noter que l’ordre d’affichage selon le mois n’est qu’un artefact dû à l’algorithme de calcul. Cet ordre n’est pas garanti sans ajout d’une clause ORDER BY finale, qui ne changerait pas les valeurs des données.
Fenêtre de travail avec GROUPS
Intervalle borné par un groupe de lignes de valeurs identiques défini avant et après la ligne courante
Borne de départ :
xxx PRECEDING : depuis les xxx groupes de valeurs identiques devant la ligne courante
CURRENT ROW : depuis la ligne courante ou le premier élément identique selonORDER BY
Borne de fin :
xxx FOLLOWING : depuis les xxx groupes de valeurs identiques derrière la ligne courante
CURRENT ROW : jusqu’à la ligne courante ou le dernier élément identique selon ORDER BY
EXCLUDE GROUP : exclut la ligne courante et le groupe de valeurs identiques dans l’ordre
EXCLUDE TIES : exclut les valeurs identiques à la ligne courante dans l’ordre mais pas la ligne courante
EXCLUDE NO OTHERS : pas d’exclusion (par défaut)
La clause EXCLUDE permet d’ignorer des lignes dans la fenêtre, par exemple la ligne courante seule, ou les lignes de même valeur que la valeur courante, avec ou sans la ligne courante.
WITHIN GROUP
WITHIN GROUP
Utilité :
calcul de médianes, centiles
La clause WITHIN GROUP est une clause pour les agrégats utilisant des fonctions dont les données doivent être triées. Quelques fonctions ont été ajoutées pour profiter au mieux de cette nouvelle clause.
Cet exemple permet d’afficher le continent, la médiane de la population par continent et la population du pays le moins peuplé parmi les 5 % de pays les plus peuplés de chaque continent.
Regroupement avancés
GROUPING SETS / ROLLUP / CUBE
Extension de GROUP BY
Utilité :
plusieurs agrégations différentes dans la même requête
moins de requêtes, meilleures performances
Les GROUPING SETS permettent de définir plusieurs clauses d’agrégation GROUP BY. Les résultats seront présentés comme si plusieurs requêtes d’agrégation avec les clauses GROUP BY mentionnées étaient assemblées avec UNION ALL.
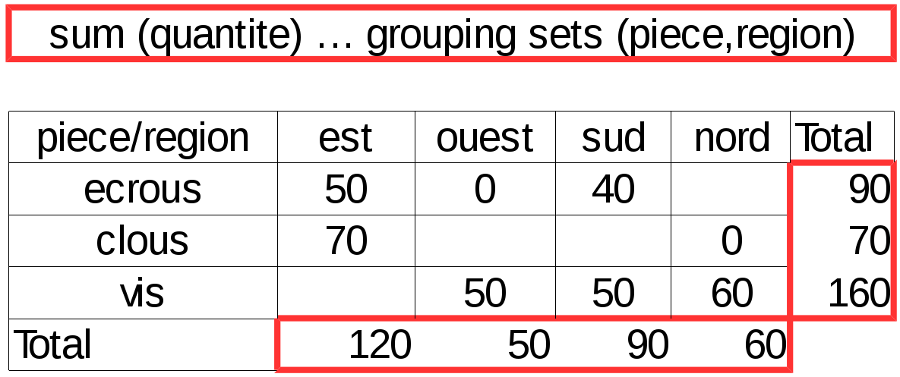
Le but est ici d’obtenir les totaux indiqués en rouge : des totaux par type de pièces, et par région, indépendamment. La clause GROUPING SETS permet cela en précisant juste les champs.
 piece  | region | sum
--------+--------+-----
 vis    |        | 160
 ecrous |        |  90
 clous  |        |  70
        | ouest  |  50
        | nord   |  60
        | est    | 120
        | sud    |  90
Le comportement de la clause GROUPING SETS peut être émulée avec deux requêtes utilisant chacune une clause GROUP BY sur les colonnes de regroupement souhaitées et en prévoyant des colonnes vides à NULL pour les champs non calculés.
Surtout, cette requête duplique beaucoup de logique, ce qui va poser souci si elle est plus complexe et est souvent modifiée. De plus, son plan d’exécution ci-dessous indique que PostgreSQL procède à deux lectures séparées. Ce peut être particulièrement coûteux sur une grande table :
              QUERY PLAN
---------------------------------------
 Append
   ->  HashAggregate
         Group Key: stock.piece
         ->  Seq Scan on stock
   ->  HashAggregate
         Group Key: stock_1.region
         ->  Seq Scan on stock stock_1
 piece  | region | sum
--------+--------+-----
 vis    |        | 160
 ecrous |        |  90
 clous  |        |  70
        | ouest  |  50
        | nord   |  60
        | est    | 120
        | sud    |  90
Les GROUPING SETS servent à définir différents champs indépendants de regrouper les données. Dans ce cas précis, l’intérêt est d’abord d’éviter de dupliquer le contenu de la requête.
Le plan d’exécution montre aussi que la table n’est parcourue qu’une seule fois pour calculer les deux agrégats en même temps, il y a donc aussi un intérêt en performances.
       QUERY PLAN
-------------------------
 HashAggregate
   Hash Key: piece
   Hash Key: region
   ->  Seq Scan on stock
ROLLUP
ROLLUP
Utilité :
calcul de totaux dans la même requête
La clause ROLLUP est une fonctionnalité d’analyse type OLAP du langage SQL. Elle s’utilise dans la clause GROUP BY, tout comme GROUPING SETS
ROLLUP : exemple visuel
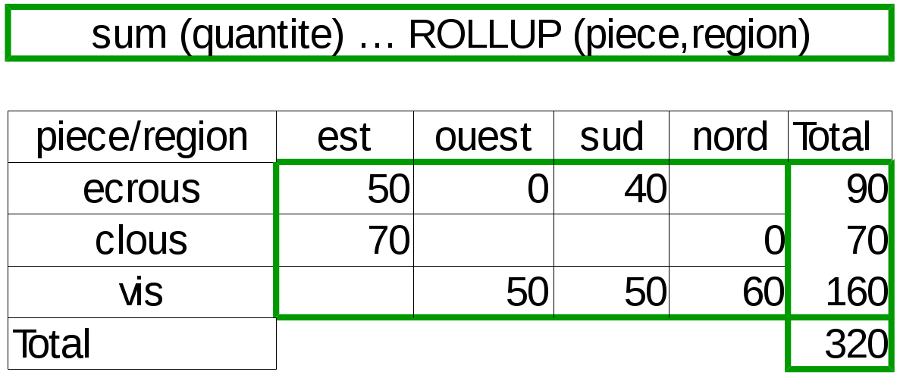
Il s’agit à présent d’obtenir des agrégats par type de pièce, puis des détails pour chaque pièce et chaque région, et un total final. ROLLUP va permettre cela.
 piece  | region | sum
--------+--------+-----
        |        | 320
 ecrous | ouest  |   0
 clous  | nord   |   0
 vis    | nord   |  60
 clous  | est    |  70
 vis    | sud    |  50
 ecrous | est    |  50
 ecrous | sud    |  40
 vis    | ouest  |  50
 vis    |        | 160
 ecrous |        |  90
 clous  |        |  70
L’ordre des lignes est comme d’habitude non défini. On pourra rajouter un ORDER BY. Proposer une présentation lisible pour un humain est laissé en général à l’outil de restitution.
Cette requête est équivalente à la requête suivante utilisant GROUPING SETS :
Le plan d’exécution est le même, ROLLUP est donc d’abord une facilité syntaxique intéressante.
Exemple :
Cet exemple utilise la base magasin. Si vous ne l’avez pas déjà, la base magasin (dump de 96 Mo, pour 667 Mo sur le disque au final) peut être téléchargée et restaurée comme suit dans une nouvelle base magasin :
createdb magasin
curl -kL https://dali.bo/tp_magasin -o /tmp/magasin.dump
pg_restore -d magasin /tmp/magasin.dump
# le message sur public préexistant est normalrm -- /tmp/magasin.dump
Les données sont dans deux schémas, magasin et facturation. Penser au search_path.
 type_client | code_pays |    montant
-------------+-----------+---------------
             |           | 5217862160.65
 A           |           |  111557177.00
 A           | CA        |    6273168.32
 A           | CN        |    7928641.50
 A           | DE        |    6642061.57
 A           | DZ        |    6404425.16
 A           | FR        |   55261295.52
 A           | IN        |    7224008.95
 A           | PE        |    7356239.93
 A           | RU        |    6766644.98
 A           | US        |    7700691.07
 E           |           |  414152232.57
 E           | CA        |   28457655.81
 E           | CN        |   25537539.68
 E           | DE        |   25508815.68
 E           | DZ        |   24821750.17
 E           | FR        |  209402443.24
 E           | IN        |   26788642.27
 E           | PE        |   24541974.54
 E           | RU        |   25397116.39
 E           | US        |   23696294.79
 P           |           | 4692152751.08
 P           | CA        |  292975985.52
 P           | CN        |  287795272.87
 P           | DE        |  287337725.21
 P           | DZ        |  302501132.54
 P           | FR        | 2341977444.49
 P           | IN        |  295256262.73
 P           | PE        |  300278960.24
 P           | RU        |  287605812.99
 P           | US        |  296424154.49
CUBE
CUBE
Utilité :
calcul de totaux dans la même requête
sur toutes les clauses de regroupement
La clause CUBE est une autre fonctionnalité d’analyse type OLAP du langage SQL. Tout comme ROLLUP, elle s’utilise dans la clause GROUP BY.
CUBE : exemple visuel
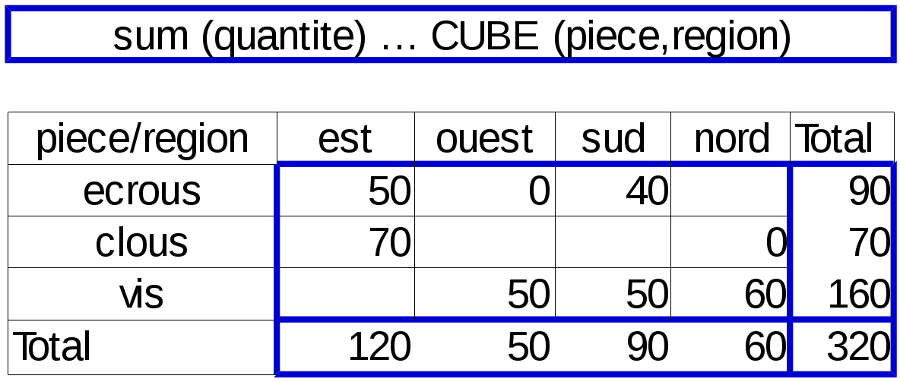
CUBE permet de réaliser des regroupements sur l’ensemble des combinaisons possibles des clauses de regroupement indiquées, avec les totaux intermédiaires et le total final. Pour de plus amples détails, se référer à l’article Wikipédia sur le cube OLAP.
Par rapport au résultat précédent, on obtient en plus les totaux par pays :
 type_client | code_pays |    montant
-------------+-----------+---------------
             |           | 5217862160.65
             | CA        |  327706809.65
             | CN        |  321261454.05
             | DE        |  319488602.46
             | DZ        |  333727307.87
             | FR        | 2606641183.25
             | IN        |  329268913.95
             | PE        |  332177174.71
             | RU        |  319769574.36
             | US        |  327821140.35
 A           |           |  111557177.00
 A           | CA        |    6273168.32
 A           | CN        |    7928641.50
 A           | DE        |    6642061.57
 A           | DZ        |    6404425.16
 A           | FR        |   55261295.52
 A           | IN        |    7224008.95
 A           | PE        |    7356239.93
 A           | RU        |    6766644.98
 A           | US        |    7700691.07
 E           |           |  414152232.57
 E           | CA        |   28457655.81
 E           | CN        |   25537539.68
 E           | DE        |   25508815.68
 E           | DZ        |   24821750.17
 E           | FR        |  209402443.24
 E           | IN        |   26788642.27
 E           | PE        |   24541974.54
 E           | RU        |   25397116.39
 E           | US        |   23696294.79
 P           |           | 4692152751.08
 P           | CA        |  292975985.52
 P           | CN        |  287795272.87
 P           | DE        |  287337725.21
 P           | DZ        |  302501132.54
 P           | FR        | 2341977444.49
 P           | IN        |  295256262.73
 P           | PE        |  300278960.24
 P           | RU        |  287605812.99
 P           | US        |  296424154.49
GROUPING SETS, ROLLUP ou CUBE ?
CUBE peut le plus
mais forcément plus coûteux
On pourrait imaginer qu’il suffit de toujours faire un CUBE en filtrant certaines lignes sur des valeurs NULL, et que les syntaxes ROLLUP ou GROUPING SETS n’ont pas vraiment d’intérêt.
Cependant, CUBE calcule plus de données, et il peut être notablement plus lent, surtout quand les volumétries sont non triviales. ROLLUP et GROUPING SETS permettent de préciser exactement les calculs dont on a besoin.
Pour que l’application distingue rigoureusement les lignes appartenant à un certain niveau de regroupement, on peut utiliser la fonction GROUPING. En effet la colonne de regroupement peut posséder des valeurs NULL légitimes, il est alors difficile de les distinguer. L’exemple suivant montre une requête qui exploite cette fonction :
Dans son résultat, la première ligne indique le total. C’est la seule où les booléens g_type_cli et g_code_pays sont à true.
 grouping | g_type_cli | g_code_pays | type_client | code_pays |    montant
----------+------------+-------------+-------------+-----------+---------------
 11       | t          | t           |             |           | 5217862160.65
 00       | f          | f           | P           | DZ        |  302501132.54
 00       | f          | f           | P           | FR        | 2341977444.49
 00       | f          | f           | P           | RU        |  287605812.99
 00       | f          | f           | E           | RU        |   25397116.39
 00       | f          | f           | A           | DE        |    6642061.57
 00       | f          | f           | A           | FR        |   55261295.52
 00       | f          | f           | P           | CN        |  287795272.87
 00       | f          | f           | A           | IN        |    7224008.95
 00       | f          | f           | E           | IN        |   26788642.27
 00       | f          | f           | A           | DZ        |    6404425.16
 00       | f          | f           | P           | IN        |  295256262.73
 00       | f          | f           | E           | CN        |   25537539.68
 00       | f          | f           | A           | CA        |    6273168.32
 00       | f          | f           | E           | PE        |   24541974.54
 00       | f          | f           | E           | FR        |  209402443.24
 00       | f          | f           | P           | DE        |  287337725.21
 00       | f          | f           | A           | US        |    7700691.07
 00       | f          | f           | A           | PE        |    7356239.93
 00       | f          | f           | A           | CN        |    7928641.50
 00       | f          | f           | E           | US        |   23696294.79
 00       | f          | f           | P           | PE        |  300278960.24
 00       | f          | f           | E           | DE        |   25508815.68
 00       | f          | f           | E           | CA        |   28457655.81
 00       | f          | f           | P           | CA        |  292975985.52
 00       | f          | f           | E           | DZ        |   24821750.17
 00       | f          | f           | A           | RU        |    6766644.98
 00       | f          | f           | P           | US        |  296424154.49
 01       | f          | t           | P           |           | 4692152751.08
 01       | f          | t           | E           |           |  414152232.57
 01       | f          | t           | A           |           |  111557177.00
 10       | t          | f           |             | RU        |  319769574.36
 10       | t          | f           |             | CA        |  327706809.65
 10       | t          | f           |             | IN        |  329268913.95
 10       | t          | f           |             | CN        |  321261454.05
 10       | t          | f           |             | PE        |  332177174.71
 10       | t          | f           |             | US        |  327821140.35
 10       | t          | f           |             | DZ        |  333727307.87
 10       | t          | f           |             | FR        | 2606641183.25
 10       | t          | f           |             | DE        |  319488602.46
(40 rows)
La présentation finale est laissée à la charge de l’application. Elle sera à même de gérer la présentation des résultats en fonction des valeurs des champs grouping, g_type_client ou g_code_pays.
Le résultat de GROUPING peut servir aussi de tri (voir plus bas).
Affichage des tableaux croisés
PostgreSQL ne renvoie que des lignes
Dans psql : \crosstabview
Extension : tablefunc, fonction crosstab (text,text)
PostgreSQL ne renvoie que des lignes au nom de colonne figé. Un tableau croisé, dont les noms de colonnes dépendent des données, va à l’encontre de cette logique. Convertir un jeu de lignes obtenu avec CUBE, par exemple, en tableau croisé est à la charge de l’application (tableur, outil de Business Intelligence, etc…)
Ponctuellement, deux outils intégrés à PostgreSQL peuvent dépanner.
psql et crosstabview :
Cette fonctionnalité existe uniquement dans le client psql. Le maniement est simple :
-- Paramétrage pour l'affichage dans psql
\psetnullTOTAL\psetlinestyleunicodeSELECTpieceAS"Pièces",regionAS"Région",sum(quantite)FROMstockGROUPBYCUBE(piece,region)ORDERBYGROUPING(piece,region)\crosstabview
 Pièces │ ouest │ nord │ est │ sud │ TOTAL
────────┼───────┼──────┼─────┼─────┼───────
 vis    │    50 │   60 │     │  50 │   160
 ecrous │     0 │      │  50 │  40 │    90
 clous  │       │    0 │  70 │     │    70
 TOTAL  │    50 │   60 │ 120 │  90 │   320
Ou pour inverser :
\crosstabview"Région""Pièces"
 Région │ vis │ ecrous │ clous │ TOTAL
────────┼─────┼────────┼───────┼───────
 ouest  │  50 │      0 │       │    50
 nord   │  60 │        │     0 │    60
 est    │     │     50 │    70 │   120
 sud    │  50 │     40 │       │    90
 TOTAL  │ 160 │     90 │    70 │   320
Remarquer que modifier l’affichage du NULL en lui substituant TOTAL ne concerne pas les colonnes vides en milieu de tableau. L’ORDER BY GROUPING(…) garantit que les totaux seront à la fin du tableau.
tablefunc :
Il existe une extension fournie avec PostgreSQL nommée tablefunc qui fournit des fonctions dédiées aux tableaux croisés. Leur maniement n’est pas évident. Il est conseillé d’utiliser la fonction crosstab (text,text) qui tient bien compte des valeurs absentes. Cette fonction demande que la requête à formater lui soit fournie comme chaîne de caractère.
CREATEEXTENSIONIFNOTEXISTStablefunc;SELECT*FROMcrosstab($$SELECTcoalesce(piece,'Total'),coalesce(region,'Total'),sum(quantite)FROMstockGROUPBYCUBE(piece,region)ORDERBYGROUPING(piece,region)$$,'SELECT DISTINCT region FROM stock ORDER BY region')ASct(piecetext,"Est"text,"Nord"text,"Ouest"text,"Sud"text);
 piece  | Est | Nord | Ouest | Sud
--------+-----+------+-------+-----
 vis    |     |      | 50    |
 ecrous |     |      | 0     |
 clous  |     | 0    |       |
 vis    |     | 60   |       |
 clous  | 70  |      |       |
 vis    |     |      |       | 50
 ecrous | 50  |      |       | 40
 vis    |     |      |       |
 clous  |     |      |       |
 Total  | 120 | 60   | 50    | 90
Attention à la cohérence entre la deuxième requête et les titres sur la dernière ligne, ce n’est pas dynamique !
Cet exemple utilise aussi $$ à la place des guillemets droits pour délimiter une chaîne, car une requête contient souvent elle-même des chaînes.
Si vous ne l’avez pas déjà, la base brno2015 avec la table du même nom peut être téléchargée et restaurée ainsi :
curl -kL https://dali.bo/tp_brno2015 -o /tmp/brno2015.dump
createdb  brno2015
pg_restore -O -d brno2015 /tmp/brno2015.dump
# une erreur sur l'existence du schéma public est normale
Le schéma public dispose d’une table pilotes ainsi que les résultats tour par tour de la course de MotoGP de Brno (CZ) de la saison 2015.
La table brno2015 indique pour chaque tour, pour chaque pilote, le temps réalisé dans le tour :
Une table pilotes permet de connaître les détails d’un pilote :
      Table "public.pilotes"
   Column    |  Type   | Modifiers
-------------+---------+-----------
 no          | integer |
 nom         | text    |
 nationalite | text    |
 ecurie      | text    |
 moto        | text    |
Précisions sur les données à manipuler : la course est réalisée en plusieurs tours ; certains coureurs n’ont pas terminé la course, leur relevé de tours s’arrête donc brutalement.
Agrégation
Quel est le pilote qui a le moins gros écart entre son meilleur tour et son moins bon tour ?
Déterminer quel est le pilote le plus régulier (écart-type).
Window Functions
Afficher la place sur le podium pour chaque coureur.
À partir de la requête précédente, afficher également la différence du temps de chaque coureur par rapport à celui de la première place.
Pour chaque tour, afficher :
le nom du pilote ;
son rang dans le tour ;
son temps depuis le début de la course ;
dans le tour, la différence de temps par rapport au premier.
Pour chaque coureur, quel est son meilleur tour et quelle place avait-il sur ce tour ?
Déterminer quels sont les coureurs ayant terminé la course qui ont gardé la même position tout au long de la course.
En quelle position a terminé le coureur qui a doublé le plus de personnes ? Combien de personnes a-t-il doublées ?
Grouping Sets
Ce TP s’appuie sur les tables présentes dans le schéma magasin.
En une seule requête, afficher le montant total des commandes par année et pays et le montant total des commandes uniquement par année. - Ne sélectionnez que les code pays FR et DE et les années 2010 et supérieures. - Ordonnez les résultats par année et code pays ascendant les nuls présents dans la colonne code_pays doivent être placés à la fin.
Ajouter également le montant total des commandes depuis le début de l’activité.
Ajouter également le montant total des commandes par pays.
À partir de la requête précédente, ajouter une colonne par critère de regroupement, de type booléen, qui est positionnée à true lorsque le regroupement est réalisé sur l’ensemble des valeurs de la colonne.
Travaux pratiques (solutions)
Si vous ne l’avez pas déjà, la base brno2015 avec la table du même nom peut être téléchargée et restaurée ainsi :
curl -kL https://dali.bo/tp_brno2015 -o /tmp/brno2015.dump
createdb  brno2015
pg_restore -O -d brno2015 /tmp/brno2015.dump
# une erreur sur l'existence du schéma public est normale
Le schéma public dispose d’une table pilotes ainsi que les résultats tour par tour de la course de MotoGP de Brno (CZ) de la saison 2015.
La table brno2015 indique pour chaque tour, pour chaque pilote, le temps réalisé dans le tour :
Une table pilotes permet de connaître les détails d’un pilote :
      Table "public.pilotes"
   Column    |  Type   | Modifiers
-------------+---------+-----------
 no          | integer |
 nom         | text    |
 nationalite | text    |
 ecurie      | text    |
 moto        | text    |
Précisions sur les données à manipuler : la course est réalisée en plusieurs tours; certains coureurs n’ont pas terminé la course, leur relevé de tours s’arrête donc brutalement.
Agrégation
Quel est le pilote qui a le moins gros écart entre son meilleur tour et son moins bon tour ?
Le résultat montre le coureur qui a abandonné en premier :
       nom       |      stddev
-----------------+-------------------
 Alex DE ANGELIS | 0.130107647741847
On s’aperçoit qu’Alex De Angelis n’a pas terminé la course. Il semble donc plus intéressant de ne prendre en compte que les pilotes qui ont terminé la course et toujours en excluant le premier tour (il y a 22 tours sur cette course, on peut le positionner soit en dur dans la requête, soit avec un sous-select permettant de déterminer le nombre maximum de tours) :
 no |       nom       |         stddev
----+-----------------+------------------------
 19 | Alvaro BAUTISTA | 0.21876178961754816450
Window Functions
Afficher la place sur le podium pour chaque coureur.
Les coureurs qui ne franchissent pas la ligne d’arrivée sont dans le classement malgré tout. Il faut donc tenir compte de cela dans l’affichage des résultats.
 rang |       nom        |           ecurie            |  total_time
------+------------------+-----------------------------+--------------
    1 | Jorge LORENZO    | Movistar Yamaha MotoGP      | 00:42:53.042
    2 | Marc MARQUEZ     | Repsol Honda Team           | 00:42:57.504
    3 | Valentino ROSSI  | Movistar Yamaha MotoGP      | 00:43:03.439
    4 | Andrea IANNONE   | Ducati Team                 | 00:43:06.113
    5 | Dani PEDROSA     | Repsol Honda Team           | 00:43:08.692
    6 | Andrea DOVIZIOSO | Ducati Team                 | 00:43:08.767
    7 | Bradley SMITH    | Monster Yamaha Tech 3       | 00:43:14.863
    8 | Pol ESPARGARO    | Monster Yamaha Tech 3       | 00:43:16.282
    9 | Aleix ESPARGARO  | Team SUZUKI ECSTAR          | 00:43:36.826
   10 | Danilo PETRUCCI  | Octo Pramac Racing          | 00:43:38.303
   11 | Yonny HERNANDEZ  | Octo Pramac Racing          | 00:43:43.015
   12 | Scott REDDING    | EG 0,0 Marc VDS             | 00:43:43.216
   13 | Alvaro BAUTISTA  | Aprilia Racing Team Gresini | 00:43:47.479
   14 | Stefan BRADL     | Aprilia Racing Team Gresini | 00:43:47.666
   15 | Loris BAZ        | Forward Racing              | 00:43:53.358
   16 | Hector BARBERA   | Avintia Racing              | 00:43:54.637
   17 | Nicky HAYDEN     | Aspar MotoGP Team           | 00:43:55.43
   18 | Mike DI MEGLIO   | Avintia Racing              | 00:43:58.986
   19 | Jack MILLER      | CWM LCR Honda               | 00:44:04.449
   20 | Claudio CORTI    | Forward Racing              | 00:44:43.075
   21 | Karel ABRAHAM    | AB Motoracing               | 00:44:55.697
   22 | Maverick VIÑALES | Team SUZUKI ECSTAR          | 00:29:31.557
   23 | Cal CRUTCHLOW    | CWM LCR Honda               | 00:27:38.315
   24 | Eugene LAVERTY   | Aspar MotoGP Team           | 00:08:04.096
   25 | Alex DE ANGELIS  | E-Motion IodaRacing Team    | 00:06:05.782
(25 rows)
À partir de la requête précédente, afficher également la différence du temps de chaque coureur par rapport à celui de la première place.
La requête n’est pas beaucoup modifiée, seule la fonction first_value() est utilisée pour déterminer le temps du vainqueur, temps qui sera ensuite retranché au temps du coureur courant.
 r|       nom       |          ecurie      | total_time  |  difference
--+-----------------+----------------------+-------------+---------------
 1| Jorge LORENZO   | Movistar Yamaha [...]|00:42:53.042 | 00:00:00
 2| Marc MARQUEZ    | Repsol Honda Team    |00:42:57.504 | 00:00:04.462
 3| Valentino ROSSI | Movistar Yamaha [...]|00:43:03.439 | 00:00:10.397
 4| Andrea IANNONE  | Ducati Team          |00:43:06.113 | 00:00:13.071
 5| Dani PEDROSA    | Repsol Honda Team    |00:43:08.692 | 00:00:15.65
 6| Andrea DOVIZIOSO| Ducati Team          |00:43:08.767 | 00:00:15.725
 7| Bradley SMITH   | Monster Yamaha Tech 3|00:43:14.863 | 00:00:21.821
 8| Pol ESPARGARO   | Monster Yamaha Tech 3|00:43:16.282 | 00:00:23.24
 9| Aleix ESPARGARO | Team SUZUKI ECSTAR   |00:43:36.826 | 00:00:43.784
10| Danilo PETRUCCI | Octo Pramac Racing   |00:43:38.303 | 00:00:45.261
11| Yonny HERNANDEZ | Octo Pramac Racing   |00:43:43.015 | 00:00:49.973
12| Scott REDDING   | EG 0,0 Marc VDS      |00:43:43.216 | 00:00:50.174
13| Alvaro BAUTISTA | Aprilia Racing [...] |00:43:47.479 | 00:00:54.437
14| Stefan BRADL    | Aprilia Racing [...] |00:43:47.666 | 00:00:54.624
15| Loris BAZ       | Forward Racing       |00:43:53.358 | 00:01:00.316
16| Hector BARBERA  | Avintia Racing       |00:43:54.637 | 00:01:01.595
17| Nicky HAYDEN    | Aspar MotoGP Team    |00:43:55.43  | 00:01:02.388
18| Mike DI MEGLIO  | Avintia Racing       |00:43:58.986 | 00:01:05.944
19| Jack MILLER     | CWM LCR Honda        |00:44:04.449 | 00:01:11.407
20| Claudio CORTI   | Forward Racing       |00:44:43.075 | 00:01:50.033
21| Karel ABRAHAM   | AB Motoracing        |00:44:55.697 | 00:02:02.655
22| Maverick VIÑALES| Team SUZUKI ECSTAR   |00:29:31.557 | -00:13:21.485
23| Cal CRUTCHLOW   | CWM LCR Honda        |00:27:38.315 | -00:15:14.727
24| Eugene LAVERTY  | Aspar MotoGP Team    |00:08:04.096 | -00:34:48.946
25| Alex DE ANGELIS | E-Motion Ioda[...]    |00:06:05.782 | -00:36:47.26
(25 rows)
Pour chaque tour, afficher :
le nom du pilote ;
son rang dans le tour ;
son temps depuis le début de la course ;
dans le tour, la différence de temps par rapport au premier.
Pour construire cette requête, nous avons besoin d’obtenir le temps cumulé tour après tour pour chaque coureur. Nous commençons donc par écrire une première requête :
Cette requête de base est ensuite utilisée dans une CTE qui sera utilisée par la requête répondant à la question de départ. La colonne temps_tour_glissant est utilisée pour calculer le rang du pilote dans la course, est affiché et le temps cumulé du meilleur pilote est récupéré avec la fonction first_value :
Pour chaque coureur, quel est son meilleur tour et quelle place avait-il sur ce tour ?
Il est ici nécessaire de sélectionner pour chaque tour le temps du meilleur tour. On peut alors sélectionner les tours pour lequels le temps du tour est égal au meilleur temps :
La suite de ce TP est maintenant réalisé avec la base de formation magasin.
Tout d’abord, nous positionnons le search_path pour chercher les objets du schéma magasin :
SETsearch_path=magasin;
En une seule requête, afficher le montant total des commandes par année et pays et le montant total des commandes uniquement par année. - Ne sélectionnez que les code pays FR et DE et les années 2010 et supérieures. - Ordonnez les résultats par année et code pays ascendant les nuls présents dans la colonne code_pays doivent être placés à la fin.
À partir de la requête précédente, ajouter une colonne par critère de regroupement, de type booléen, qui est positionnée à true lorsque le regroupement est réalisé sur l’ensemble des valeurs de la colonne.
Ces colonnes booléennes permettent d’indiquer à l’application comment gérer la présentation des résultats.