4 PL/pgSQL avancé
PL/pgSQL avancé
Préambule
Au menu
- Routines « variadic » et polymorphes
- Fonctions trigger
- Curseurs
- Récupérer les erreurs
- Messages d’erreur dans les logs
- Sécurité
- Optimisation
- Problèmes fréquents
Objectifs
- Connaître la majorité des possibilités de PL/pgSQL
- Les utiliser pour étendre les fonctionnalités de la base
- Écrire du code robuste
- Éviter les pièges de sécurité
- Savoir optimiser une routine
Routines variadic
Routines variadic : introduction
- Permet de créer des routines avec un nombre d’arguments variables
- … mais du même type
L’utilisation du mot clé VARIADIC dans la déclaration des routines permet d’utiliser un nombre variable d’arguments dans la mesure où tous les arguments optionnels sont du même type de données. Ces arguments sont passés à la fonction sous forme de tableau d’arguments du même type.
Il n’est pas possible d’utiliser d’autres arguments en entrée à la suite d’un paramètre VARIADIC.
Routines variadic : exemple
Récupérer le minimum d’une liste :
Quelques explications sur cette fonction :
- SQL est un langage de routines stockées
- une routine SQL ne contient que des ordres SQL exécutés séquentiellements
- le résultat de la fonction est le résultat du dernier ordre
generate_subscript()prend un tableau en premier paramètre et la dimension de ce tableau (un tableau peut avoir plusieurs dimensions), et elle retourne une série d’entiers allant du premier au dernier indice du tableau dans cette dimension- g(i) est un alias :
generate_subscriptsest une SRF (set-returning function, retourne unSETOF), g est donc le nom de l’alias de table, et i le nom de l’alias de colonne.
Routines variadic : exemple PL/pgSQL
- En PL/pgSQL, cette fois-ci
- Démonstration de
FOREACH xxx IN ARRAY aaa LOOP - Précédemment, obligé de convertir le tableau en relation pour boucler (
unnest)
En PL/pgSQL, il est possible d’utiliser une boucle FOREACH pour parcourir directement le tableau des arguments optionnels.
Auparavant, il fallait développer le tableau avec la fonction unnest() pour réaliser la même opération.
Routines polymorphes
Routines polymorphes : introduction
- Typer les variables oblige à dupliquer les routines communes à plusieurs types
- PostgreSQL propose des types polymorphes
- Le typage se fait à l’exécution
Pour pouvoir utiliser la même fonction en utilisant des types différents, il est nécessaire de la redéfinir avec les différents types autorisés en entrée. Par exemple, pour autoriser l’utilisation de données de type integer ou float en entrée et retournés par une même fonction, il faut la dupliquer.
L’utilisation de types polymorphes permet d’éviter ce genre de duplications fastidieuses.
Routines polymorphes : anyelement
- Remplace tout type de données simple ou composite
- pour les paramètres en entrée comme pour les paramètres en sortie
- Tous les paramètres et type de retour de type
anyelementse voient attribués le même type - Donc un seul type pour tous les
anyelementautorisés - Paramètre spécial
$0: du type attribué aux élémentsanyelement
Routines polymorphes : anyarray
anyarrayremplace tout tableau de type de données simple ou composite- pour les paramètres en entrée comme pour les paramètres en sortie
- Le typage se fait à l’exécution
- Tous les paramètres de type
anyarrayse voient attribués le même type
Routines polymorphes : exemple
L’addition est un exemple fréquent :
Routines polymorphes : tests
L’opérateur + étant défini pour les entiers comme pour les numeric, la fonction ne pose aucun problème pour ces deux types de données, et retourne une donnée du même type que les données d’entrée.
Routines polymorphes : problème
- Attention lors de l’utilisation de type polymorphe…
Le typage n’étant connu qu’à l’exécution, c’est aussi à ce moment que se déclenchent les erreurs.
De même, l’affectation du type unique pour tous les éléments se fait sur la base du premier élément, ainsi :
génère une erreur car du premier argument est déduit le type integer, ce qui n’est évidement pas le cas du deuxième. Il peut donc être nécessaire d’utiliser une conversion explicite pour résoudre ce genre de problématique.
Fonctions trigger
Fonctions trigger : introduction
- Fonction stockée
- Action déclenchée par
INSERT(incluantCOPY),UPDATE,DELETE,TRUNCATE - Mode par ligne ou par instruction
- Exécution d’une fonction
Un trigger est une spécification précisant que la base de données doit exécuter une fonction particulière quand un certain type d’opération est traité. Les fonctions trigger peuvent être définies pour s’exécuter avant ou après une commande INSERT, UPDATE, DELETE ou TRUNCATE.
La fonction trigger doit être définie avant que le trigger lui-même puisse être créé. La fonction trigger doit être déclarée comme une fonction ne prenant aucun argument et retournant un type trigger.
Une fois qu’une fonction trigger est créée, le trigger est créé avec CREATE TRIGGER. La même fonction trigger est utilisable par plusieurs triggers.
Un trigger TRUNCATE ne peut utiliser que le mode par instruction, contrairement aux autres triggers pour lesquels vous avez le choix entre « par ligne » et « par instruction ».
Enfin, l’instruction COPY est traitée comme s’il s’agissait d’une commande INSERT.
À noter que les problématiques de visibilité et de volatilité depuis un trigger sont assez complexes dès lors que l’on lit ou modifie les données. Voir la documentation pour plus de détails à ce sujet.
Fonctions trigger : variables (1/5)
OLD:- type de données
RECORDcorrespondant à la ligne avant modification - valable pour un
DELETEet unUPDATE
- type de données
NEW:- type de données
RECORDcorrespondant à la ligne après modification - valable pour un
INSERTet unUPDATE
- type de données
Fonctions trigger : variables (2/5)
- Ces deux variables sont valables uniquement pour les triggers en mode ligne
- pour les triggers en mode instruction, utiliser les tables de transition
- Accès aux champs par la notation pointée
NEW.champ1pour accéder à la nouvelle valeur dechamp1
Fonctions trigger : variables (3/5)
TG_NAME- nom du trigger qui a déclenché l’appel de la fonction
TG_WHEN- chaîne valant
BEFORE,AFTERouINSTEAD OFsuivant le type du trigger
- chaîne valant
TG_LEVEL- chaîne valant
ROWouSTATEMENTsuivant le mode du trigger
- chaîne valant
TG_OP- chaîne valant
INSERT,UPDATE,DELETE,TRUNCATEsuivant l’opération qui a déclenché le trigger
- chaîne valant
Fonctions trigger : variables (4/5)
TG_RELIDOIDde la table qui a déclenché le trigger
TG_TABLE_NAME- nom de la table qui a déclenché le trigger
TG_TABLE_SCHEMA- nom du schéma contenant la table qui a déclenché le trigger
Vous pourriez aussi rencontrer dans du code la variable TG_RELNAME. C’est aussi le nom de la table qui a déclenché le trigger. Attention, cette variable est obsolète, il est préférable d’utiliser maintenant TG_TABLE_NAME.
Fonctions trigger : variables (5/5)
TG_NARGS- nombre d’arguments donnés à la fonction trigger
TG_ARGV- les arguments donnés à la fonction trigger (le tableau commence à 0)
La fonction trigger est déclarée sans arguments mais il est possible de lui en passer dans la déclaration du trigger. Dans ce cas, il faut utiliser les deux variables ci-dessus pour y accéder. Attention, tous les arguments sont convertis en texte. Il faut donc se cantonner à des informations simples, sous peine de compliquer le code.
Fonctions trigger : retour
- Une fonction trigger a un type de retour spécial :
trigger - Trigger
BEFORE FOR EACH ROW:- si retour
NULL: annulation de l’opération, sans erreur, la transaction continue - modification possible de
NEW BEFORE DELETE:NEWestNULL, retournerOLDBEFORE INSERT:OLDestNULL, retournerNEW
- si retour
- Trigger
AFTER:- valeur de retour ignorée (même
NULL)
- valeur de retour ignorée (même
- Trigger
FOR EACH STATEMENT:- valeur de retour ignorée, renvoyer
NULL
- valeur de retour ignorée, renvoyer
RAISE EXCEPTIONtoujours possible, interrompt la transaction
Une fonction trigger retourne le type spécial trigger. Pour cette raison, ces fonctions ne peuvent être utilisées que dans le contexte d’un ou plusieurs triggers.
Pour pouvoir être utilisée comme valeur de retour dans la fonction (avec RETURN), une variable doit être de structure identique à celle de la table sur laquelle le trigger a été déclenché. Les variables spéciales OLD (ancienne valeur avant application de l’action à l’origine du déclenchement) et NEW (nouvelle valeur après application de l’action) sont également disponibles, utilisables et même modifiables.
Trigger BEFORE … FOR EACH ROW :
La valeur de retour d’un trigger de type ligne déclenché avant l’opération peut changer complètement l’effet de la commande.
Il est possible de changer les valeurs de la nouvelle ligne créée par une action INSERT ou UPDATE en modifiant NEW directement, puis en faisant RETURN NEW.
Il est également possible d’annuler complètement l’action sur la ligne, sans erreur en retournant NULL. Cette annulation ne vaut que pour la ligne, et la transaction continue normalement. Les triggers ne sont plus déclenchés pour cette ligne.
Attention ! Dans le cas d’une fonction trigger BEFORE DELETE, il faut prendre en compte que NEW contient NULL, et en conséquence RETURN NEW provoque l’annulation du DELETE ! Dans ce cas, la convention est de faire un RETURN OLD pour poursuivre, ou RETURN NULL pour une annulation explicite.
Trigger AFTER … FOR EACH ROW et FOR EACH STATEMENT :
En revanche, la valeur de retour utilisée n’a pas d’effet dans les cas des triggers ROW et AFTER, et des triggers FOR EACH STATEMENT (par exemple les triggers sur TRUNCATE ou les triggers utilisant les tables de transition). La documentation conseille alors de toujours retourner NULL.
Dans ces cas, il reste possible d’annuler l’action en remontant une erreur à l’exécution de la fonction (RAISE EXCEPTION). Mais cela va annuler toute la transaction.
Fonctions trigger : exemple - 1
- Horodater une opération sur une ligne
Fonctions trigger : exemple - 2
Options de CREATE TRIGGER
CREATE TRIGGER permet quelques variantes :
CREATE TRIGGER name WHEN ( condition )CREATE TRIGGER name BEFORE UPDATE OF colx ON my_tableCREATE CONSTRAINT TRIGGER: exécuté qu’au moment de la validation de la transactionCREATE TRIGGER view_insert INSTEAD OF INSERT ON my_view
- On peut ne déclencher un trigger que si une condition est vérifiée. Cela simplifie souvent le code du trigger, et gagne en performances : plus besoin pour le moteur d’aller exécuter la fonction.
- On peut ne déclencher un trigger que si une colonne spécifique a été modifiée. Il ne s’agit donc que de triggers sur
UPDATE. Encore un moyen de simplifier le code et de gagner en performances en évitant les déclenchements inutiles. - On peut créer un trigger en le déclarant comme étant un trigger de contrainte. Il peut alors être deferrable, deferred, comme tout autre contrainte, c’est-à-dire n’être exécuté qu’au moment de la validation de la transaction, ce qui permet de ne vérifier les contraintes implémentées par le trigger qu’au moment de la validation finale.
- On peut créer un trigger sur une vue. C’est un trigger
INSTEAD OF, qui permet de programmer de façon efficace lesINSERT/UPDATE/DELETE/TRUNCATEsur les vues. Auparavant, il fallait passer par le système de règles (RULES), complexe et sujet à erreurs.
Tables de transition
- Pour les triggers de type
AFTERet de niveau statement - Possibilité de stocker les lignes avant et/ou après modification
REFERENCING OLD TABLEREFERENCING NEW TABLE
- Par exemple :
Dans le cas d’un trigger en mode instruction, il n’est pas possible d’utiliser les variables OLD et NEW car elles ciblent une seule ligne. Pour cela, le standard SQL parle de tables de transition.
Exemple :
Nous allons créer une table t1 qui portera le trigger et une table archives qui aura pour but de récupérer les enregistrements supprimés de la table t1.
Maintenant, il faut créer le code de la procédure stockée :
Et ajouter le trigger sur la table t1 :
Maintenant, insérons un million de ligne dans t1 puis supprimons-les :
La suppression avec le trigger prend 2 secondes. Il est possible de connaître le temps à supprimer les lignes et le temps à exécuter le trigger en utilisant l’ordre EXPLAIN ANALYZE :
Donc la suppression des lignes met 0,7 seconde alors que l’exécution du trigger met 1,5 seconde.
Pour comparer, voici l’ancienne façon de faire (configuration d’un trigger en mode ligne) :
Donc avec un trigger en mode ligne, la suppression du million de lignes met presque 9 secondes à s’exécuter, dont 7,7 pour l’exécution du trigger. Sur le trigger en mode instruction, il faut compter 2,2 secondes, dont 1,5 sur le trigger. Les tables de transition nous permettent de gagner en performance.
Le gros intérêt des tables de transition est le gain en performance que cela apporte.
Curseurs
Curseurs : introduction
- Exécuter une requête en une fois peut ramener beaucoup de résultats
- Tout ce résultat est en mémoire
- risque de dépassement mémoire
- La solution : les curseurs
- Un curseur permet d’exécuter la requête sur le serveur mais de ne récupérer les résultats que petit bout par petit bout
- Dans une transaction ou une routine
À noter que la notion de curseur existe aussi en SQL pur, sans passer par une routine PL/pgSQL. On les crée en utilisant la commande DECLARE, et les règles de manipulation sont légèrement différentes (on peut par exemple créer un curseur WITH HOLD, qui persistera après la fin de la transaction). Voir la documentation pour plus d’informations à ce sujet : https://docs.postgresql.fr/current/sql-declare.html
Curseurs : déclaration d’un curseur
- Avec le type refcursor
- Avec la pseudo-instruction
CURSOR FOR - Avec une requête paramétrée
- Exemples :
La première forme permet la création d’un curseur non lié à une requête.
Curseurs : ouverture d’un curseur
- Lier une requête à un curseur :
- Plan de la requête mis en cache
- Lier une requête dynamique à un curseur
Voici un exemple de lien entre une requête et un curseur :
Et voici un exemple d’utilisation d’une requête dynamique :
Curseurs : ouverture d’un curseur lié
- Instruction SQL :
OPEN curseur(arguments) - Permet d’ouvrir un curseur déjà lié à une requête
- Impossible d’ouvrir deux fois le même curseur
- Plan de la requête mise en cache
- Exemple
Curseurs : récupération des données
- Instruction SQL :
- Récupère la prochaine ligne
- FOUND indique si cette nouvelle ligne a été récupérée
- Cible est
- une variable RECORD
- une variable ROW
- un ensemble de variables séparées par des virgules
Curseurs : récupération des données
directionduFETCH:NEXT,PRIORFIRST,LASTABSOLUTE nombre,RELATIVE nombre- nombre
ALLFORWARD,FORWARD nombre,FORWARD ALLBACKWARD,BACKWARD nombre,BACKWARD ALL
Curseurs : modification des données
- Mise à jour d’une ligne d’un curseur :
- Suppression d’une ligne d’un curseur :
Attention, ces différentes syntaxes ne modifient pas les données dans le curseur en mémoire, mais font réellement la modification dans la table. L’emplacement actuel du curseur est utilisé ici pour identifier la ligne correspondante à mettre à jour.
Curseurs : fermeture d’un curseur
- Instruction SQL :
CLOSE curseur - Ferme le curseur
- Permet de récupérer de la mémoire
- Permet aussi de réouvrir le curseur
Curseurs : renvoi d’un curseur
- Fonction renvoyant une valeur de type
refcursor - Permet donc de renvoyer plusieurs valeurs
Voici un exemple d’utilisation d’une référence de curseur retournée par une fonction :
Gestion des erreurs
Gestion des erreurs : introduction
- Sans exceptions :
- toute erreur provoque un arrêt de la fonction
- toute modification suite à une instruction SQL (
INSERT,UPDATE,DELETE) est annulée - d’où l’ajout d’une gestion personnalisée des erreurs avec le concept des exceptions
Gestion des erreurs : une exception
- La fonction comporte un bloc supplémentaire,
EXCEPTION:
Gestion des erreurs : flot dans une fonction
- L’exécution de la fonction commence après le
BEGIN - Si aucune erreur ne survient, le bloc
EXCEPTIONest ignoré - Si une erreur se produit
- tout ce qui a été modifié dans la base dans le bloc est annulé
- les variables gardent par contre leur état
- l’exécution passe directement dans le bloc de gestion de l’exception
Gestion des erreurs : flot dans une exception
- Recherche d’une condition satisfaisante
- Si cette condition est trouvée
- exécution des instructions correspondantes
- Si aucune condition n’est compatible
- sortie du bloc
BEGIN/ENDcomme si le bloc d’exception n’existait pas - passage de l’exception au bloc
BEGIN/ENDcontenant (après annulation de ce que ce bloc a modifié en base)
- sortie du bloc
- Dans un bloc d’exception, les instructions
INSERT,UPDATE,DELETEde la fonction ont été annulées - Dans un bloc d’exception, les variables locales de la fonction ont gardé leur ancienne valeur
Gestion des erreurs : codes d’erreurs
SQLSTATE: code d’erreurSQLERRM: message d’erreur- Par exemple :
Data Exception: division par zéro, overflow, argument invalide pour certaines fonctions, etc.Integrity Constraint Violation: unicité, CHECK, clé étrangère, etc.Syntax ErrorPL/pgSQL Error:RAISE EXCEPTION, pas de données, trop de lignes, etc.
- Les erreurs sont contenues dans des classes d’erreurs plus génériques, qui peuvent aussi être utilisées
Toutes les erreurs sont référencées dans la documentation
Attention, des codes d’erreurs nouveaux apparaissent à chaque version.
La classe data_exception contient de nombreuses erreurs, comme datetime_field_overflow, invalid_escape_character, invalid_binary_representation… On peut donc, dans la déclaration de l’exception, intercepter toutes les erreurs de type data_exception d’un coup, ou une par une.
L’instruction GET STACKED DIAGNOSTICS permet d’avoir une vision plus précise de l’erreur récupéré par le bloc de traitement des exceptions. La liste de toutes les informations que l’on peut collecter est disponible dans la documentation .
La démonstration ci-dessous montre comment elle peut être utilisée.
Messages d’erreurs : RAISE - 1
- Envoyer une trace dans les journaux applicatifs et/ou vers le client
RAISE niveau message
- Niveau correspond au niveau d’importance du message
DEBUG,LOG,INFO,NOTICE,WARNING,EXCEPTION
- Message est la trace à enregistrer
- Message dynamique… tout signe
%est remplacé par la valeur indiquée après le message - Champs
DETAILetHINTdisponibles
Il convient de noter qu’un message envoyé de cette manière ne fera pas partie de l’éventuel résultat d’une fonction, et ne sera donc pas exploitable en SQL. Pour cela, il faut utiliser l’instruction RETURN avec un type de retour approprié.
Le traitement des messages de ce type et leur destination d’envoi sont contrôlés par le serveur à l’aide des paramètres log_min_messages et client_min_messages.
Messages d’erreurs : RAISE - 2
Exemples :
Les autres niveaux pour RAISE ne sont que des messages, sans déclenchement d’exception.
Messages d’erreurs : configuration des logs
- Deux paramètres importants pour les traces
log_min_messages- niveau minimum pour que la trace soit enregistrée dans les journaux
client_min_messages- niveau minimum pour que la trace soit envoyée au client
- Dans le cas d’un
RAISE NOTICE message, il faut avoir soitlog_min_messages, soitclient_min_messages, soit les deux à la valeurNOTICEau minimum.
Messages d’erreurs : RAISE EXCEPTION - 1
- Annule le bloc en cours d’exécution
RAISE EXCEPTION message
- Sauf en cas de présence d’un bloc
EXCEPTIONgérant la conditionRAISE_EXCEPTION - message est la trace à enregistrer, et est dynamique… tout signe % est remplacé par la valeur indiquée après le message
Messages d’erreurs : RAISE EXCEPTION - 2
Exemple :
Le rôle d’une exception est d’intercepter une erreur pour exécuter un traitement permettant soit de corriger l’erreur, soit de remonter une erreur pertinente. Intercepter un problème pour retourner « erreur interne » n’est pas une bonne idée.
Flux des erreurs dans du code PL
- Les exceptions non traitées «remontent»
- de bloc
BEGIN/ENDimbriqués vers les blocs parents (fonctions appelantes comprises) - jusqu’à ce que personne ne puisse les traiter
- voir note pour démonstration
- de bloc
Démonstration en plusieurs étapes :
Une exception a été remontée avec un message explicite.
La fonction a bien été annulée.
Flux des erreurs dans du code PL - 2
- Les erreurs remontent
- Cette fois-ci, on rajoute un bloc PL pour intercepter l’erreur
L’erreur est bien devenue un message de niveau NOTICE.
La table n’en reste pas moins vide pour autant puisque le bloc a été annulé.
Flux des erreurs dans du code PL - 3
- Cette fois-ci, on rajoute un bloc PL indépendant pour gérer le second
INSERT
Voici une nouvelle version de la fonction :
En apparence, le résultat est identique.
Mais cette fois-ci, le bloc BEGIN parent n’a pas eu d’exception, il s’est donc bien terminé.
Flux des erreurs dans du code PL - 4
- Illustrons maintenant la remontée d’erreurs
- Nous avons deux blocs imbriqués
- Une erreur non prévue va se produire dans le bloc intérieur
On commence par ajouter une contrainte sur la colonne pour empêcher les valeurs supérieures ou égales à 10 :
Puis, on recrée la fonction de façon à ce qu’elle déclenche cette erreur dans le bloc le plus bas, et la gère uniquement dans le bloc parent :
Exécutons la fonction :
C’est normal, nous avons toujours l’enregistrement à 1 du test précédent. L’exception se déclenche donc dans le bloc parent, sans espoir d’interception: nous n’avons pas d’exception pour lui.
Nettoyons donc la table, pour reprendre le test :
Le gestionnaire d’exception qui intercepte l’erreur est bien ici celui de l’appelant. Par ailleurs, comme nous retournons nous-même une exception, la requête ne retourne pas de résultat, mais une erreur : il n’y a plus personne pour récupérer l’exception, c’est donc PostgreSQL lui-même qui s’en charge.
Abus des exceptions
- Ne pas abuser des exceptions
- les sous-transactions ne sont pas gratuites
- Si saturation, paramétre SLRU dédié (v17)
La levée d’une exception revient à poser un SAVEPOINT pendant la transaction (une forme de sous-transaction).
En cas de trop nombreuses levées d’exception, un des caches dédiés en mémoire partagée (SLRU) de PostgreSQL peut saturer et poser des soucis de performance (le wait event SubtransSLRU apparaît dans pg_stat_activity.wait_event). Depuis PostgreSQL 17 le DBA peut monter ce cache, avec le paramètre subtransaction_buffers.
Sécurité
Sécurité : droits
- L’exécution de la routine dépend du droit
EXECUTE - Par défaut, ce droit est donné à la création de la routine
- au propriétaire de la routine
- au groupe spécial PUBLIC
Sécurité : ajout
- Ce droit peut être donné avec l’instruction SQL
GRANT:
Sécurité : suppression
- Un droit peut être révoqué avec l’instruction SQL
REVOKE
Sécurité : SECURITY INVOKER/DEFINER
SECURITY INVOKER- la routine s’exécute avec les droits de l’utilisateur qui l’exécute
SECURITY DEFINER- la routine s’exécute avec les droits du propriétaire
- équivalent du
sudoUnix - Impérativement sécuriser les variables d’environnement
- et surtout
search_path
Rappelons qu’une fonction s’exécute par défaut avec les droits d’accès de l’utilisateur qui l’exécute ; et que pour donner accès à ses données, un utilisateur peut mettre à disposition des autres des fonctions en mode SECURITY DEFINER qui profiteront de ses droits. Il est impératif de réinitialiser l’environnement et en particulier le search_path pour éviter des attaques de la part d’utilisateurs malveillants, et de restreindre au maximum l’accès à ces fonctions.
Sécurité : LEAKPROOF
LEAKPROOF- indique au planificateur que la routine ne peut pas faire fuiter d’information de contexte
- réservé aux superutilisateurs
- si on la déclare telle, s’assurer que la routine est véritablement sûre !
- Option utile lorsque l’on utilise des vues avec l’option
security_barrier
Certains utilisateurs créent des vues pour filtrer des lignes, afin de restreindre la visibilité sur certaines données. Or, cela peut se révéler dangereux si un utilisateur malintentionné a la possibilité de créer une fonction car il peut facilement contourner cette sécurité si cette option n’est pas utilisée, notamment en jouant sur des paramètres de fonction comme COST, qui permet d’indiquer au planificateur un coût estimé pour la fonction.
En indiquant un coût extrêmement faible, le planificateur aura tendance à réécrire la requête, et à déplacer l’exécution de la fonction dans le code même de la vue, avant l’application des filtres restreignant l’accès aux données : la fonction a donc accès a tout le contenu de la table, et peut faire fuiter des données normalement inaccessibles, par exemple à travers l’utilisation de la commande RAISE.
L’option security_barrier des vues dans PostgreSQL bloque ce comportement du planificateur, mais en conséquence empêche le choix de plans d’exécutions potentiellement plus performants. Déclarer une fonction avec l’option LEAKPROOF permet d’indiquer à PostgreSQL que celle-ci ne peut pas occasionner de fuite d’informations. Ainsi, le planificateur de PostgreSQL sait qu’il peut en optimiser l’exécution. Cette option n’est accessible qu’aux superutilisateurs.
Sécurité : visibilité des sources - 1
- Le code d’une fonction est visible par tout le monde
- y compris ceux qui n’ont pas le droit d’exécuter la fonction
- Vous devez donc écrire un code robuste
- pas espérer que, comme personne n’en a le code, personne ne trouvera de faille
- Surtout pour les fonctions SECURITY DEFINER
Sécurité : visibilité des sources - 2
La méta-commande psql \df+ public.addition permet également d’obtenir cette information.
Sécurité : Injections SQL
- Les paramètres d’une routine doivent être considérés comme hostiles :
- ils contiennent des données non validées (qui appelle la routine ?)
- ils peuvent, si l’utilisateur est imaginatif, être utilisés pour exécuter du code
- Utiliser
quote_ident,quote_literaletquote_nullable - Utiliser aussi
format
Voici un exemple simple :
Tout va bien, elle effectue ce qui est demandé.
Par contre, elle effectue aussi ce qui n’est pas prévu :
Cet exemple est évidemment simplifié.
Une règle demeure : ne jamais faire confiance aux paramètres d’une fonction. Au minimum, un quote_ident pour param1 et un quote_literal pour val1 étaient obligatoires, pour se protéger de ce genre de problèmes.
Optimisation
Fonctions immutables, stables ou volatiles - 1
- Par défaut, PostgreSQL considère que les fonctions sont
VOLATILE volatile: fonction dont l’exécution ne peut ni ne doit être évitée
Les fonctions de ce type sont susceptibles de renvoyer un résultat différent à chaque appel, comme par exemple random() ou setval().
Toute fonction ayant des effets de bords doit être qualifiée volatile dans le but d’éviter que PostgreSQL utilise un résultat intermédiaire déjà calculé et évite ainsi d’exécuter le code de la fonction.
À noter qu’il est possible de « forcer » le pré-calcul du résultat d’une fonction volatile dans une requête SQL en utilisant une sous-requête. Par exemple, dans l’exemple suivant, random() est exécutée pour chaque ligne de la table ma_table, et renverra donc une valeur différente par ligne :
Par contre, en utilisant une sous-requête, l’optimiseur va pré-calculer le résultat de random()… l’exécution sera donc plus rapide, mais le résultat différent, puisque la même valeur sera affichée pour toutes les lignes !
Fonctions immutables, stables ou volatiles - 2
immutable: fonctions déterministes, dont le résultat peut être précalculé avant de planifier la requête.
Certaines fonctions que l’on écrit sont déterministes. C’est-à-dire qu’à paramètre(s) identique(s), le résultat est identique.
Le résultat de telles fonctions est alors remplaçable par son résultat avant même de commencer à planifier la requête.
Voici un exemple qui utilise cette particularité :
La fonction est exécutée une fois, remplacée par sa constante, et la requête est ensuite planifiée.
Si on déclare la fonction comme stable :
La requête est planifiée sans connaître factorielle(12), donc avec une hypothèse très approximative sur la cardinalité. factorielle(12) est calculé, et la requête est exécutée. Grâce au Index Only Scan, le requête s’effectue rapidement.
Si on déclare la fonction comme volatile :
La requête est planifiée, et factorielle(12) est calculé pour chaque enregistrement de la table, car on ne sait pas si elle retourne toujours le même résultat.
Fonctions immutables, stables ou volatiles - 3
stable: fonction ayant un comportement stable au sein d’un même ordre SQL.
Ces fonctions retournent la même valeur pour la même requête SQL, mais peuvent retourner une valeur différente dans la prochaine instruction.
Il s’agit typiquement de fonctions dont le traitement dépend d’autres valeurs dans la base de données, ou bien de réglages de configuration. Les fonctions comme to_char(), to_date() sont STABLE et non IMMUTABLE car des paramètres de configuration (locale utilisée pour to_char(), timezone pour les fonctions temporelles, etc.) pourraient influer sur le résultat.
À noter au passage que les fonctions de la famille de current_timestamp (et donc le fréquemment utilisé now()) renvoient de plus une valeur constante au sein d’une même transaction.
PostgreSQL refusera de déclarer comme STABLE toute fonction modifiant des données : elle ne peut pas être stable si elle modifie la base.
Optimisation : rigueur
- Fonction
STRICT - La fonction renvoie
NULLsi au moins un des arguments estNULL
Les fonctions définies comme STRICT ou RETURNS NULL ON NULL INPUT annule l’exécution de la requête si l’un des paramètres passés est NULL. Dans ce cas, la fonction est considérée comme ayant renvoyé NULL.
Si l’on reprend l’exemple de la fonction factorielle() :
on obtient le résultat suivant si elle est exécutée avec la valeur NULL passée en paramètre :
Optimisation : EXCEPTION
- Un bloc contenant une clause
EXCEPTIONest plus coûteuse en entrée/sortie qu’un bloc sans- un
SAVEPOINTest créé à chaque fois pour pouvoir annuler le bloc uniquement.
- un
- À utiliser avec parcimonie
- Un bloc
BEGINimbriqué a un coût aussi- un
SAVEPOINTest créé à chaque fois.
- un
Requête statique ou dynamique ?
- Les requêtes statiques :
- sont écrites « en dur » dans le code PL/pgSQL
- donc pas d’
EXECUTEouPERFORM - sont préparées une fois par session, à leur première exécution
- peuvent avoir un plan générique lorsque c’est jugé utile par le planificateur
Avant la version 9.2, un plan générique (indépendant des paramètres de l’ordre SQL) était systématiquement généré et utilisé. Ce système permet de gagner du temps d’exécution si la requête est réutilisée plusieurs fois, et qu’elle est coûteuse à planifier.
Toutefois, un plan générique n’est pas forcément idéal dans toutes les situations, et peut conduire à des mauvaises performances.
Par exemple :
est un excellent candidat à être écrit statiquement : le plan sera toujours le même : on attaque l’index de la clé primaire pour trouver l’enregistrement.
est un moins bon candidat : le plan, idéalement, dépend de param_function : on ne parcourt pas la même fraction de la table suivant la valeur de param_function.
Par défaut, un plan générique ne sera utilisé dès la première exécution d’une requête statique que si celle-ci ne dépend d’aucun paramètre. Dans le cas contraire, cela ne se produira qu’au bout de plusieurs exécutions de la requête, et seulement si le planificateur détermine que les plans spécifiques utilisés n’apportent pas d’avantage par rapport au plan générique.
Requête statique ou dynamique ? - 2
- Les requêtes dynamiques :
- sont écrites avec un
EXECUTE,PERFORM… - sont préparées à chaque exécution
- ont un plan optimisé
- sont donc plus coûteuses en planification
- mais potentiellement plus rapides à l’exécution
- sont écrites avec un
L’écriture d’une requête dynamique est par contre un peu plus pénible, puisqu’il faut fabriquer un ordre SQL, puis le passer en paramètre à EXECUTE, avec tous les quote_* que cela implique pour en protéger les paramètres.
Pour se faciliter la vie, on peut utiliser EXECUTE query USING param1, param2 …, qui est même quelquefois plus lisible que la syntaxe en dur : les paramètres de la requête sont clairement identifiés dans cette syntaxe.
Par contre, la syntaxe USING n’est utilisable que si le nombre de paramètres est fixe.
Requête statique ou dynamique ? -3
- Alors, statique ou dynamique ?
- Si la requête est simple : statique
- peu de
WHERE - peu ou pas de jointure
- peu de
- Sinon dynamique
La limite est difficile à placer, il s’agit de faire un compromis entre le temps de planification d’une requête (quelques dizaines de microsecondes pour une requête basique à potentiellement plusieurs secondes si on dépasse la dizaine de jointures) et le temps d’exécution.
Dans le doute, réalisez un test de performance de la fonction sur un jeu de données représentatif.
Outils
- Deux outils disponibles
- un debugger
- un pseudo-profiler
Tous les outils d’administration PostgreSQL permettent d’écrire des routines stockées en PL/pgSQL, la plupart avec les fonctionnalités habituelles (comme le surlignage des mots clés, l’indentation automatique, etc.).
Par contre, pour aller plus loin, l’offre est restreinte. Il existe tout de même un debugger qui fonctionne avec pgAdmin 4, sous la forme d’une extension.
pldebugger
- License Artistic 2.0
- Développé par EDB et intégrable dans pgAdmin
- Installé par défaut avec le one-click installer
- mais non activé
- Compilation nécessaire pour les autres systèmes
pldebugger est un outil initialement créé par Dave Page et Korry Douglas au sein d’EnterpriseDB, repris par la communauté. Il est proposé sous license libre (Artistic 2.0).
Il fonctionne grâce à des hooks implémentés dans la version 8.2 de PostgreSQL.
Il est assez peu connu, ce qui explique que peu l’utilisent. Seul l’outil d’installation « one-click installer » l’installe par défaut. Pour tous les autres systèmes, cela réclame une compilation supplémentaire. Cette compilation est d’ailleurs peu aisée étant donné qu’il n’utilise pas le système pgxs.
pldebugger - Compilation
- Récupérer le source avec git
- Copier le répertoire dans le répertoire contrib des sources de PostgreSQL
- Et les suivre étapes standards
- make
- make install
Voici les étapes à réaliser pour compiler pldebugger en prenant pour hypothèse que les sources de PostgreSQL sont disponibles dans le répertoire /usr/src/postgresql-10 et qu’ils ont été préconfigurés avec la commande ./configure :
- Se placer dans le répertoire contrib des sources de PostgreSQL :
- Cloner le dépôt git :
- Se placer dans le nouveau répertoire
pldebugger:
- Compiler pldebugger :
- Installer pldebugger :
L’installation copie le fichier plugin_debugger.so dans le répertoire des bibliothèques partagées de PostgreSQL. L’installation copie ensuite les fichiers SQL et de contrôle de l’extension pldbgapi dans le répertoire extension du répertoire share de PostgreSQL.
pldebugger - Activation
- Configurer
shared_preload_librariesshared_preload_libraries = 'plugin_debugger'
- Redémarrer PostgreSQL
- Installer l’extension
pldbgapi:
La configuration du paramètre shared_preload_libraries permet au démarrage de PostgreSQL de laisser la bibliothèque plugin_debugger s’accrocher aux hooks de l’interpréteur PL/pgSQL. Du coup, pour que la modification de ce paramètre soit prise en compte, il faut redémarrer PostgreSQL.
L’interaction avec pldebugger se fait par l’intermédiaire de procédures stockées. Il faut donc au préalable créer ces procédures stockées dans la base contenant les procédures PL/pgSQL à débugguer. Cela se fait en créant l’extension :
auto_explain
- Mise en place globale (traces) :
shared_preload_libraries='auto_explain'si globalALTER DATABASE erp SET auto_explain.log_min_duration = '3s'
- Ou par session :
LOAD 'auto_explain'SET auto_explain.log_analyze TO true;SET auto_explain.log_nested_statements TO true;
auto_explain est une « contrib » officielle de PostgreSQL (et non une extension). Il permet de tracer le plan d’une requête. En général, on ne trace ainsi que les requêtes dont la durée d’exécution dépasse la durée configurée avec le paramètre’auto_explain.log_min_duration. Par défaut, ce paramètre est à -1 pour ne tracer aucun plan.
Comme dans un EXPLAIN classique, on peut activer toutes les options (par exemple ANALYZE ou TIMING avec, respectivement SET auto_explain.log_analyze TO true; et SET auto_explain.log_timing TO true;) mais l’impact en performance peut être important même pour les requêtes qui ne seront pas tracées.
D’autres options existent, qui reprennent les paramètres habituels d’EXPLAIN, notamment auto_explain.log_buffers et auto_explain.log_settings (voir la documentation).
L’exemple suivant utilise deux fonctions imbriquées mais cela marche pour une simple requête :
Chargement dans la session d’auto_explain (si pas déjà présent dans shared_preload_libraries) :
Activation pour toutes les requêtes, avec les options ANALYZE et BUFFERS, puis affichage dans la console (si la sortie dans les traces ne suffit pas) :
Test de la première fonction : le plan s’affiche, mais les compteurs (ici juste shared hit), ne concernent que la fonction dans son ensemble.
En activant auto_explain.log_nested_statements, on voit clairement les plans de chaque requête exécutée :
Cet exemple permet de mettre le doigt sur un petit problème de performance dans la fonction : le _ est interprété comme critère de recherche. En modifiant le paramètre on peut constater le changement de plan au niveau des index :
Pour les procédures, il est possible de mettre en place cette trace avec ALTER PROCEDURE … SET auto_explain.log_min_duration = 0. Cela ne fonctionne pas pour les fonctions.
pgBadger est capable de lire les plans tracés par auto_explain, de les intégrer à son rapport et d’inclure un lien vers depesz.com pour une version plus lisible.
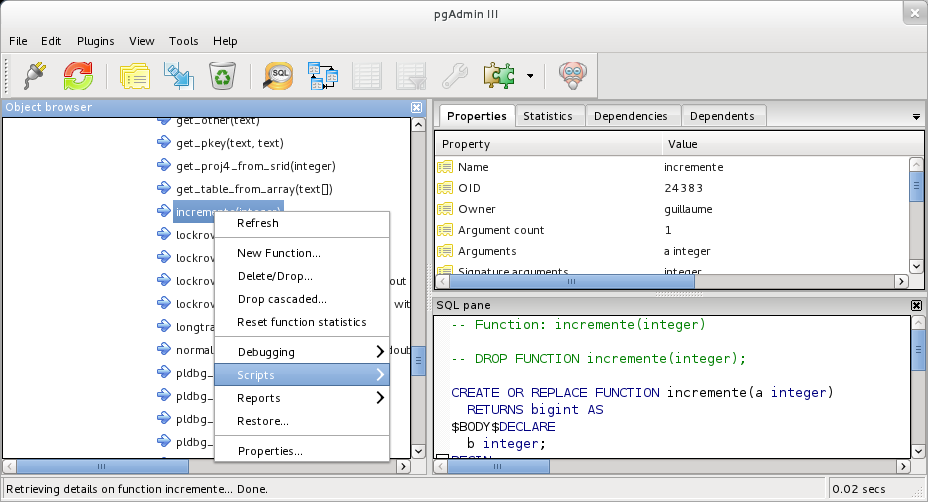
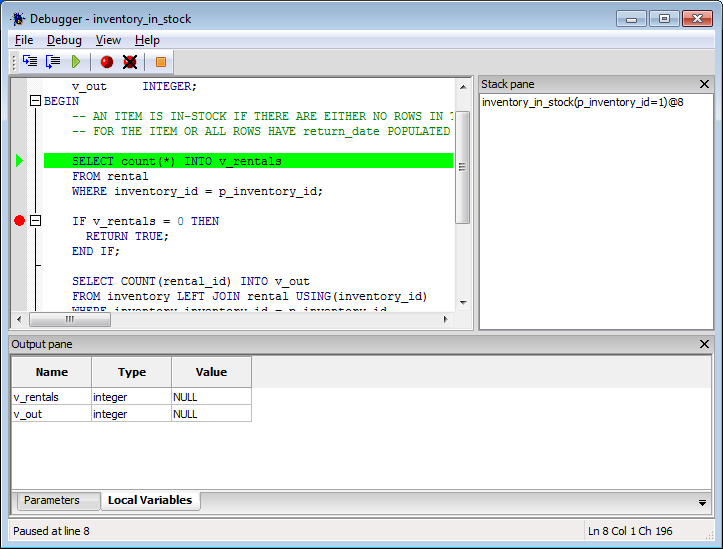
pldebugger - Utilisation
- Via pgAdmin
Le menu contextuel pour accéder au débuggage d’une fonction :
La fenêtre du débugger :
log_functions
- Créé par Dalibo
- License BSD
- Compilation nécessaire
log_functions est un outil créé par Guillaume Lelarge au sein de Dalibo. Il est proposé sous license libre (BSD).
log_functions - Compilation
- Récupérer l’archive sur PGXN.org
- Décompresser l’archive puis :
make USE_PGXS=1 && make USE_PGXS=1 install
Voici les étapes à réaliser pour compiler log_functions en prenant pour hypothèse que les sources de PostgreSQL sont disponibles dans le répertoire /home/guillaume/postgresql-9.1.4 et qu’ils ont été préconfigurés avec la commande ./configure :
- Se placer dans le répertoire contrib des sources de PostgreSQL :
- Récupérer le dépôt git de log_functions :
- Se placer dans le nouveau répertoire
log_functions:
- Compiler log_functions :
- Installer log_functions :
L’installation copie le fichier log_functions.o dans le répertoire des bibliothèques partagées de PostgreSQL.
Si la version de PostgreSQL est supérieure ou égale à la 9.2, alors l’installation est plus simple et les sources de PostgreSQL ne sont plus nécessaires.
Téléchargement de log_functions :
puis décompression et installation de l’extension :
L’installation copie aussi le fichier log_functions.so dans le répertoire des bibliothèques partagées de PostgreSQL.
log_functions - Activation
- Permanente
shared_preload_libraries = 'log_functions'- Redémarrage de PostgreSQL
- Au cas par cas
LOAD 'log_functions'
Le module log_functions est activable de deux façons.
La première consiste à demander à PostgreSQL de le charger au démarrage. Pour cela, il faut configurer la variable shared_preload_libraries, puis redémarrer PostgreSQL pour que le changement soit pris en compte.
La deuxième manière de l’activer est de l’activer seulement au moment où son utilisation s’avère nécessaire. Il faut utiliser pour cela la commande LOAD en précisant le module à charger.
La première méthode a un coût en terme de performances car le module s’exécute à chaque exécution d’une procédure stockée écrite en PL/pgSQL. La deuxième méthode rend l’utilisation du profiler un peu plus complexe. Le choix est donc laissé à l’administrateur.
log_functions - Configuration
- 5 paramètres en tout
- À configurer
- dans Postgresql.conf
- ou avec
SET
Les informations de profilage récupérées par log_functions sont envoyées dans les traces de PostgreSQL. Comme cela va générer plus d’écriture, et donc plus de lenteurs, il est possible de configurer chaque trace.
La configuration se fait soit dans le fichier postgresql.conf soit avec l’instruction SET.
Voici la liste des paramètres et leur utilité :
log_functions.log_declare, à mettre à true pour tracer le moment où PL/pgSQL exécute la partieDECLAREd’une procédure stockée ;log_functions.log_function_begin, à mettre à true pour tracer le moment où PL/pgSQL exécute la partieBEGINd’une procédure stockée ;log_functions.log_function_end, à mettre à true pour tracer le moment où PL/pgSQL exécute la partieENDd’une procédure stockée ;log_functions.log_statement_begin, à mettre à true pour tracer le moment où PL/pgSQL commence l’exécution d’une instruction dans une procédure stockée ;log_functions.log_statement_end, à mettre à true pour tracer le moment où PL/pgSQL termine l’exécution d’une instruction dans une procédure stockée.
Par défaut, seuls log_statement_begin et log_statement_end sont à false pour éviter la génération de traces trop importantes.
log_functions - Utilisation
- Exécuter des procédures stockées en PL/pgSQL
- Lire les journaux applicatifs
greptrès utile
Voici un exemple d’utilisation de cet outil :
Conclusion
- PL/pgSQL est un langage puissant
- Seul inconvénient
- sa lenteur par rapport à d’autres PL comme PL/perl ou C
- PL/perl est très efficace pour les traitements de chaîne notamment
- Permet néanmoins de traiter la plupart des cas, de façon simple et efficace
Pour aller plus loin
- Documentation officielle
- « Chapitre 40. PL/pgSQL - Langage de procédures SQL »
Quelques liens utiles dans la documentation de PostgreSQL :
Questions
N’hésitez pas, c’est le moment !
Travaux pratiques
La version en ligne des solutions de ces TP est disponible sur https://dali.bo/p2_solutions.
Exceptions
Ré-écrire la fonction suivante pour intercepter une division par zéro (utiliser l’exception DIVISION_BY_ZERO), afficher un message et renvoyer
Nan.
Triggers
Créer la table suivante :
Créer une table
log_stockcomme ci-desssous pour tracer toutes les modifications du champnombredansstock, avec l’ancienne et la nouvelle valeur, l’article, l’année, le moment, et qui a fait la modification (variablesession_user). Créer un triggerAFTERpar ligne, et sa fonction associée pour tracer cela. Insérer quelques lignes, les mettre à jour, en supprimer une.
Dans un autre trigger
BEFORE DELETEpar ligne, interdire la suppression des lignes dansstock.
Afficher un message d’erreur dans les logs dans ce cas.
Tenter d’interdire l’exécution d’un
TRUNCATEavec un triggerBEFORE TRUNCATE(Il faudra unRAISE EXCEPTION).
Quelle alternative y a-t-il pour interdire
DELETEouTRUNCATEsur cette table ? Tester avec un nouvel utilisateur nommé pierre.
Supprimer le trigger
BEFORE DELETEpour le remplacer par un autre plus complet qui :
- interdit les
DELETEcomme précédemment ;- affiche un message
NOTICEquand le stock est ou devient inférieur ou égal à 5 (à moins qu’il ne remonte) ;- affiche un message
WARNINGquand il est ou tombe à 0 ;- remplace une valeur négative ou NULL par un 0.
Tester et vérifier danslog_stock.
Insérer des lignes et comparer les performances de la requête suivante avant et après la suppression de tous les triggers :
Réécrire le trigger de trace en utilisant des tables de transition (il va falloir trois triggers et une fonction qui distingue les trois cas
UPSERT/INSERT/DELETE).
En profiter pour ajouter desRAISE NOTICEqui affichent les valeurs des fonctionscurrent_user,session_user,system_user(sur PostgreSQL 15 ou plus).
Créer un rôle adminlog.
Lui donner la propriété et les droits exclusifs surlog_stock.
Modifier les droits de la fonction de trace destockpour qu’elle fonctionne encore.
Curseur
Écrire une fonction
checkadminqui utilise un curseur pour parcourir la tablepg_stat_user_tables, et affiche unRAISE LOGdans les traces silast_autovacuumetlast_vacuumsont tous deux vides.
Afficher le numéro de la ligne dans le curseur (tri par nom de table).
Sortir après le troisième avertissement, sinon retourner le nombre de lignes lues.
Travaux pratiques (solutions)
Exceptions
Ré-écrire la fonction suivante pour intercepter une division par zéro (utiliser l’exception DIVISION_BY_ZERO), afficher un message et renvoyer
Nan.
Effectivement :
La division par zéro peut s’intercepter ainsi :
Requêtage :
Mais le message d’erreur ne s’affiche que dans les traces (postgresql.log), à moins de changer ce paramètre dans la session :
Une autre possibilité est d’utiliser RAISE NOTICE au lieu de RAISE LOG. Auquel cas le message apparaîtra dans la session et non dans les traces du serveur.
Triggers
Créer la table suivante :
Créer une table
log_stockcomme ci-desssous pour tracer toutes les modifications du champnombredansstock, avec l’ancienne et la nouvelle valeur, l’article, l’année, le moment, et qui a fait la modification (variablesession_user). Créer un triggerAFTERpar ligne, et sa fonction associée pour tracer cela. Insérer quelques lignes, les mettre à jour, en supprimer une.
La colonne id n’est pas totalement nécessaire, mais il est préférable de poser des clés primaires sur toutes les tables.
La fonction trigger :
Le trigger :
Test :
La table de trace contient alors ce qui suit. Noter que l’UPDATE inutile n’est pas tracé (on pourrait en décider autrement).
Dans un autre trigger
BEFORE DELETEpar ligne, interdire la suppression des lignes dansstock.
Afficher un message d’erreur dans les logs dans ce cas.
On pourrait continuer à utiliser le trigger AFTER, mais, sur le principe, il vaut mieux interdire une modification plutôt que de l’annuler.
La fonction trigger :
Le trigger :
Dans la transaction suivante, le DELETE est annulé mais la transaction se poursuit et l’INSERT a bien lieu :
Si l’on préfère une erreur franche avec annulation de la transaction en cours, il faut un
RAISE EXCEPTION(et nonRAISE WARNING), qui donnera lieu à un messageERROR(et nonWARNING). La transaction sera interrompue.
Tenter d’interdire l’exécution d’un
TRUNCATEavec un triggerBEFORE TRUNCATE(Il faudra unRAISE EXCEPTION).
Effectivement, le trigger BEFORE DELETE ne protège pas d’un TRUNCATE :
Cependant, un trigger sur TRUNCATE est un trigger par ordre (FOR EACH STATEMENT). On ne peut annuler son fonctionnement avec un simple RETURN NULL. Il faut un RAISE EXCEPTION, et malheureusement, cela implique d’interrompre la transaction.
Avec tous ces triggers, la définition de la table devient lourde :
Quelle alternative y a-t-il pour interdire
DELETEouTRUNCATEsur cette table ? Tester avec un nouvel utilisateur nommé pierre.
- Il ne faut pas oublier que les droits peuvent interdire aux utilisateurs (sauf le superutilisateur) d’effectuer ces ordres. Cela évite d’avoir à gérer des triggers, et la gestion des droits peut être plus fine :
- Une vue masquant la table est une autre alternative pour interdire
TRUNCATE(unTRUNCATEsur une vue ne fonctionne pas).
Supprimer le trigger
BEFORE DELETEpour le remplacer par un autre plus complet qui :
- interdit les
DELETEcomme précédemment ;- affiche un message
NOTICEquand le stock est ou devient inférieur ou égal à 5 (à moins qu’il ne remonte) ;- affiche un message
WARNINGquand il est ou tombe à 0 ;- remplace une valeur négative ou NULL par un 0.
Tester et vérifier danslog_stock.
À la suppression du trigger BEFORE DELETE, ne pas oublier de supprimer la fonction associée :
Test :
Noter que le SET stock = NULL ne provoque pas d’erreur sur la contrainte NOT NULL de la colonne stock. La vérification se fait après l’ordre SQL et le trigger BEFORE.
La trace reflète bien les valeurs modifiées :
Insérer des lignes et comparer les performances de la requête suivante avant et après la suppression de tous les triggers :
Ce test est un peu rapide, mais il doit montrer un rapport de temps d’exécution de 1 à 3 ou 1 à 4, bien sûr en défaveur des triggers. La trace est l’opération la plus lourde (il faut EXPLAIN (VERBOSE) pour l’afficher) :
Sans les triggers, sur la même machine :
Réécrire le trigger de trace en utilisant des tables de transition (il va falloir trois triggers et une fonction qui distingue les trois cas
UPSERT/INSERT/DELETE).
En profiter pour ajouter desRAISE NOTICEqui affichent les valeurs des fonctionscurrent_user,session_user,system_user(sur PostgreSQL 15 ou plus).
La première difficulté est que les tables correspondant à NEW et OLD ne sont pas définies dans tous les cas. La seconde est qu’il est délicat (et lourd) de rapprocher les valeurs des deux tableaux NEW et OLD si les deux sont remplis, on se contente donc ici d’ajouter deux lignes séparées pour l’UPDATE.
Les triggers :
Test basique :
Le trigger n’est appelé qu’une seule fois par opération, le gain est donc sensible. Cette simple requête reste tout de même deux fois plus lente avec le trigger.
Créer un rôle adminlog.
Lui donner la propriété et les droits exclusifs surlog_stock.
Modifier les droits de la fonction de trace destockpour qu’elle fonctionne encore.
Pour des raisons de sécurité, il est logique que l’utilisateur applicatif ne puisse pas modifier la table de trace log_stock.
Suite au changement de droits, une modification de la table échoue :
La fonction stock_trace2 est SECURITY INVOKER (elle utilise les droits de l’utilisateur), c’est le défaut. On peut lui permettre de tourner avec les droits plus étendus de son propriétaire (SECURITY DEFINER). Il faut donc la donner à adminlog, puis donner les droits d’exécution aux utilisateurs.
Noter que le trigger insère la ligne en tant que adminlog (current_user) et non pierre ou postgres (l’appelant, session_user). C’est à savoir si l’on trace l’utilisateur.
Curseur
Écrire une fonction
checkadminqui utilise un curseur pour parcourir la tablepg_stat_user_tables, et affiche unRAISE LOGdans les traces silast_autovacuumetlast_vacuumsont tous deux vides.
Afficher le numéro de la ligne dans le curseur (tri par nom de table).
Sortir après le troisième avertissement, sinon retourner le nombre de lignes lues.
- Première implémentation possible :
- Seconde implémentation possible, un peu plus courte :
Navigation
Pour revenir au chapitre précédent, voir le chapitre précédent. Pour poursuivre la lecture, voir le chapitre suivant.