15 Vues de masquage
Vues de masquage
Principe
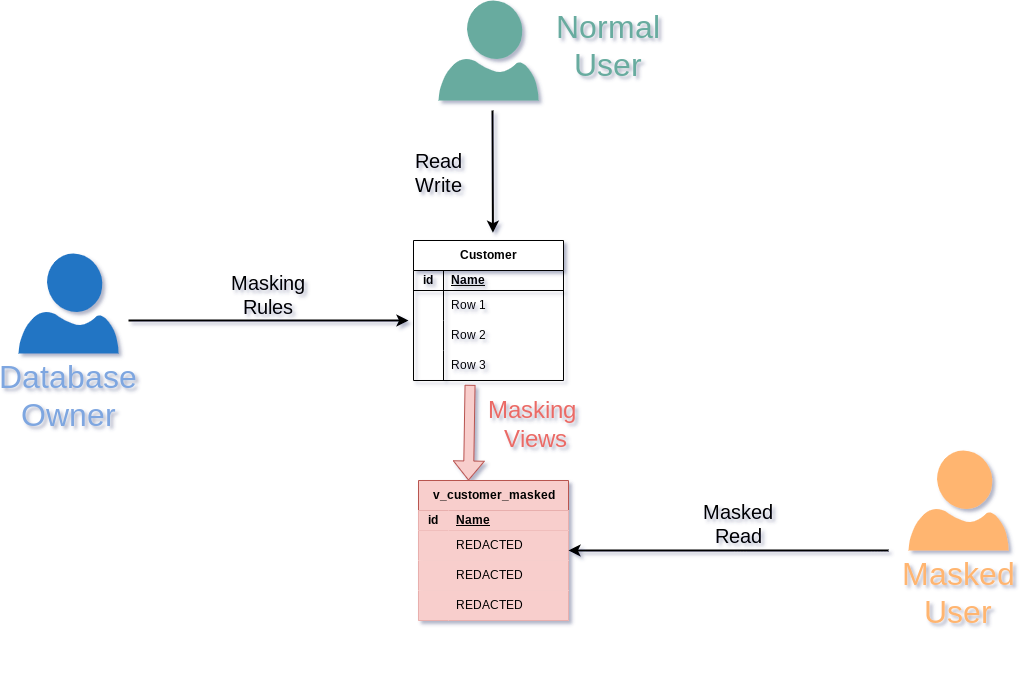
- Les vues de masquage permettent de modifier le type de données
- Similaire au masquage dynamique
- Très utiles pour mettre en place de la généralisation
Généralisation
- Flouter les données
- Par ex : 25 juillet 1989 ⇒ années 1980
L’idée derrière la généralisation est de pouvoir flouter une donnée originale.
Par exemple, au lieu de dire « Monsieur X est né le 25 juillet 1989 », on peut dire « Monsieur X est né dans les années 1980 ». L’information reste vraie, bien que moins précise, et elle rend plus difficile l’identification de la personne.
L’histoire
Paul a embauché des dizaines de salariés au fil du temps.
Il conserve une trace sur la couleur de leurs cheveux, leurs tailles, et leurs conditions médicales.
Paul souhaite extraire des statistiques depuis ces détails.
Il fournit des vues généralisées à Pierre.
Comment ça marche ?
Objectifs
Nous allons voir :
- la différence entre le masquage dynamique et les vues de masquage
- un exemple de généralisation
- le concept de « k-anonymat »
Table « employee »
- Légal ?
Bien sûr, stocker les caractéristiques physiques d’employés est généralement illégal. Quoi qu’il en soit, il sera impératif de les masquer.
Quelques données
Ce fichier charge 16 lignes, dont :
Suppression de données
Pierre peut trouver un lien entre asthme et yeux verts :
Paul souhaite savoir s’il y a une corrélation entre l’asthme et la couleur des yeux.
Il fournit à Pierre la vue ci-dessus, qui peut désormais écrire des requêtes sur cette vue :
Paul vient de prouver que l’asthme est favorisé par les yeux verts, et surtout de trouver une corrélation entre deux champs.
Calculer le k-anonymat
- Les colonnes
asthmaeteyessont considérés comme des identifiants indirects.
La vue v_asthma_eyes a le niveau « 2-anonymity ». Cela signifie que chaque combinaison de quasi-identifiants (eyes-asthma) apparaît au moins 2 fois dans le jeu de données.
En d’autres termes, cela veut dire qu’un individu ne peut pas être distingué d’au moins un autre individu (k-1) dans cette vue.
Pour les détails sur le K-anonymat, voir cet article sur Wikipédia.
Le fournisseur est ici
k-anonymityet plusanon!
Fonctions d’intervalle et de généralisation
Pierre peut écrire une requête pour trouver le nombre d’employés embauchés en novembre 2021 :
Déclarer les identifiants indirects
Calculer le facteur de k-anonymat de cette vue :
Dans ce cas, le résultat est 1, ce qui veut dire qu’au moins une personne peut être directement identifiée par les dates de ses premier et dernier jour en poste.
Dans ce cas, la généralisation est insuffisante.
Exercices
E401 - Simplifier la vue v_staff_per_month pour en réduire la granularité.
Généraliser les dates en mois n’est pas suffisant. - Écrire une autre vue - v_staff_per_year qui va généraliser les dates en années. - Simplifier également la vue en utilisant un intervalle de int pour stocker - l’année, plutôt qu’un intervalle de date.
E402 - Progression du personnel au fil des années
- Combien de personnes ont travaillé pour Paul chaque année entre 2018 et 2021 ?
E403 - Atteindre le facteur 2-anonymity sur la vue v_staff_per_year
- Quel est le facteur k-anonymat de la vue v_staff_per_year ?
Solutions
S401
- Écrire une autre vue
- v_staff_per_year qui va généraliser les dates en années.
- Simplifier également la vue en utilisant un intervalle de
intpour stocker - l’année, plutôt qu’un intervalle de
date.
Cette vue généralise les dates en années :
S402
- Combien de personnes ont travaillé pour Paul chaque année entre 2018 et 2021 ?
Les personnes ayant travaillé pour Paul entre 2018 et 2021 sont :
S403
- Quel est le facteur k-anonymat de la vue v_staff_per_year ?
Le k-anonymat de cette vue est meilleur :
Navigation
Pour revenir au chapitre précédent, voir le chapitre précédent. Pour poursuivre la lecture, voir le chapitre suivant.