7 Comprendre EXPLAIN
Comprendre EXPLAIN
Introduction
Le matériel, le système et la configuration sont importants pour les performances
- Mais il est aussi essentiel de se préoccuper des requêtes et de leurs performances
Face à un problème de performances, l’administrateur se retrouve assez rapidement face à une (ou plusieurs) requête(s). Une requête en soi représente très peu d’informations. Suivant la requête, des dizaines de plans peuvent être sélectionnés pour l’exécuter. Il est donc nécessaire de pouvoir trouver le plan d’exécution et de comprendre ce plan. Cela permet de mieux appréhender la requête et de mieux comprendre les pistes envisageables pour la corriger. Ce qui suit se concentrera sur les plans d’exécution.
Au menu
Exécution globale d’une requête
Planificateur : utilité, statistiques et configuration
EXPLAIN
Nœuds d’un plan
Outils
Nous ferons quelques rappels et approfondissements sur la façon dont une requête s’exécute globalement, et sur le planificateur : en quoi est-il utile, comment fonctionne-t-il, et comment le configurer. Nous ferons un tour sur le fonctionnement de la commande EXPLAIN et les informations qu’elle fournit. Nous verrons aussi plus en détail l’ensemble des opérations utilisables par le planificateur, et comment celui-ci choisit un plan.
Exécution globale d’une requête
L’exécution peut se voir sur deux niveaux
niveau système
niveau SGBD
De toute façon, composée de plusieurs étapes
L’exécution d’une requête peut se voir sur deux niveaux :
ce que le système perçoit;
ce que le SGBD fait.
Une lenteur dans une requête peut se trouver dans l’un ou l’autre de ces niveaux.
Niveau système
Le client envoie une requête au serveur de bases de données
Le serveur l’exécute
Puis il renvoie le résultat au client
PostgreSQL est un système client-serveur. L’utilisateur se connecte via un outil (le client) à une base d’une instance PostgreSQL (le serveur). L’outil peut envoyer une requête au serveur, celui-ci l’exécute et finit par renvoyer les données résultant de la requête ou le statut de la requête.
Généralement, l’envoi de la requête est rapide. Par contre, la récupération des données peut poser problème si une grosse volumétrie est demandée sur un réseau à faible débit. L’affichage peut aussi être un problème (afficher une ligne sera plus rapide qu’afficher un million de lignes, afficher un entier est plus rapide qu’afficher un document texte de 1 Mo, etc.).
Traitement d’une requête
Lorsque le serveur récupère la requête, un ensemble de traitements est réalisé. Tout d’abord, le parser va réaliser une analyse syntaxique de la requête. Puis le rewriter va réécrire, si nécessaire, la requête. Pour cela, il prend en compte les règles, les vues non matérialisées et les fonctions SQL. Si une règle demande de changer la requête, la requête envoyée est remplacée par la nouvelle. Si une vue non matérialisée est utilisée, la requête qu’elle contient est intégrée dans la requête envoyée. Il en est de même pour une fonction SQL intégrable. Ensuite, le planner va générer l’ensemble des plans d’exécutions. Il calcule le coût de chaque plan, puis il choisit le plan le moins coûteux, donc le plus intéressant. Enfin, l’executer exécute la requête. Pour cela, il doit commencer par récupérer les verrous nécessaires sur les objets ciblés. Une fois les verrous récupérés, il exécute la requête.
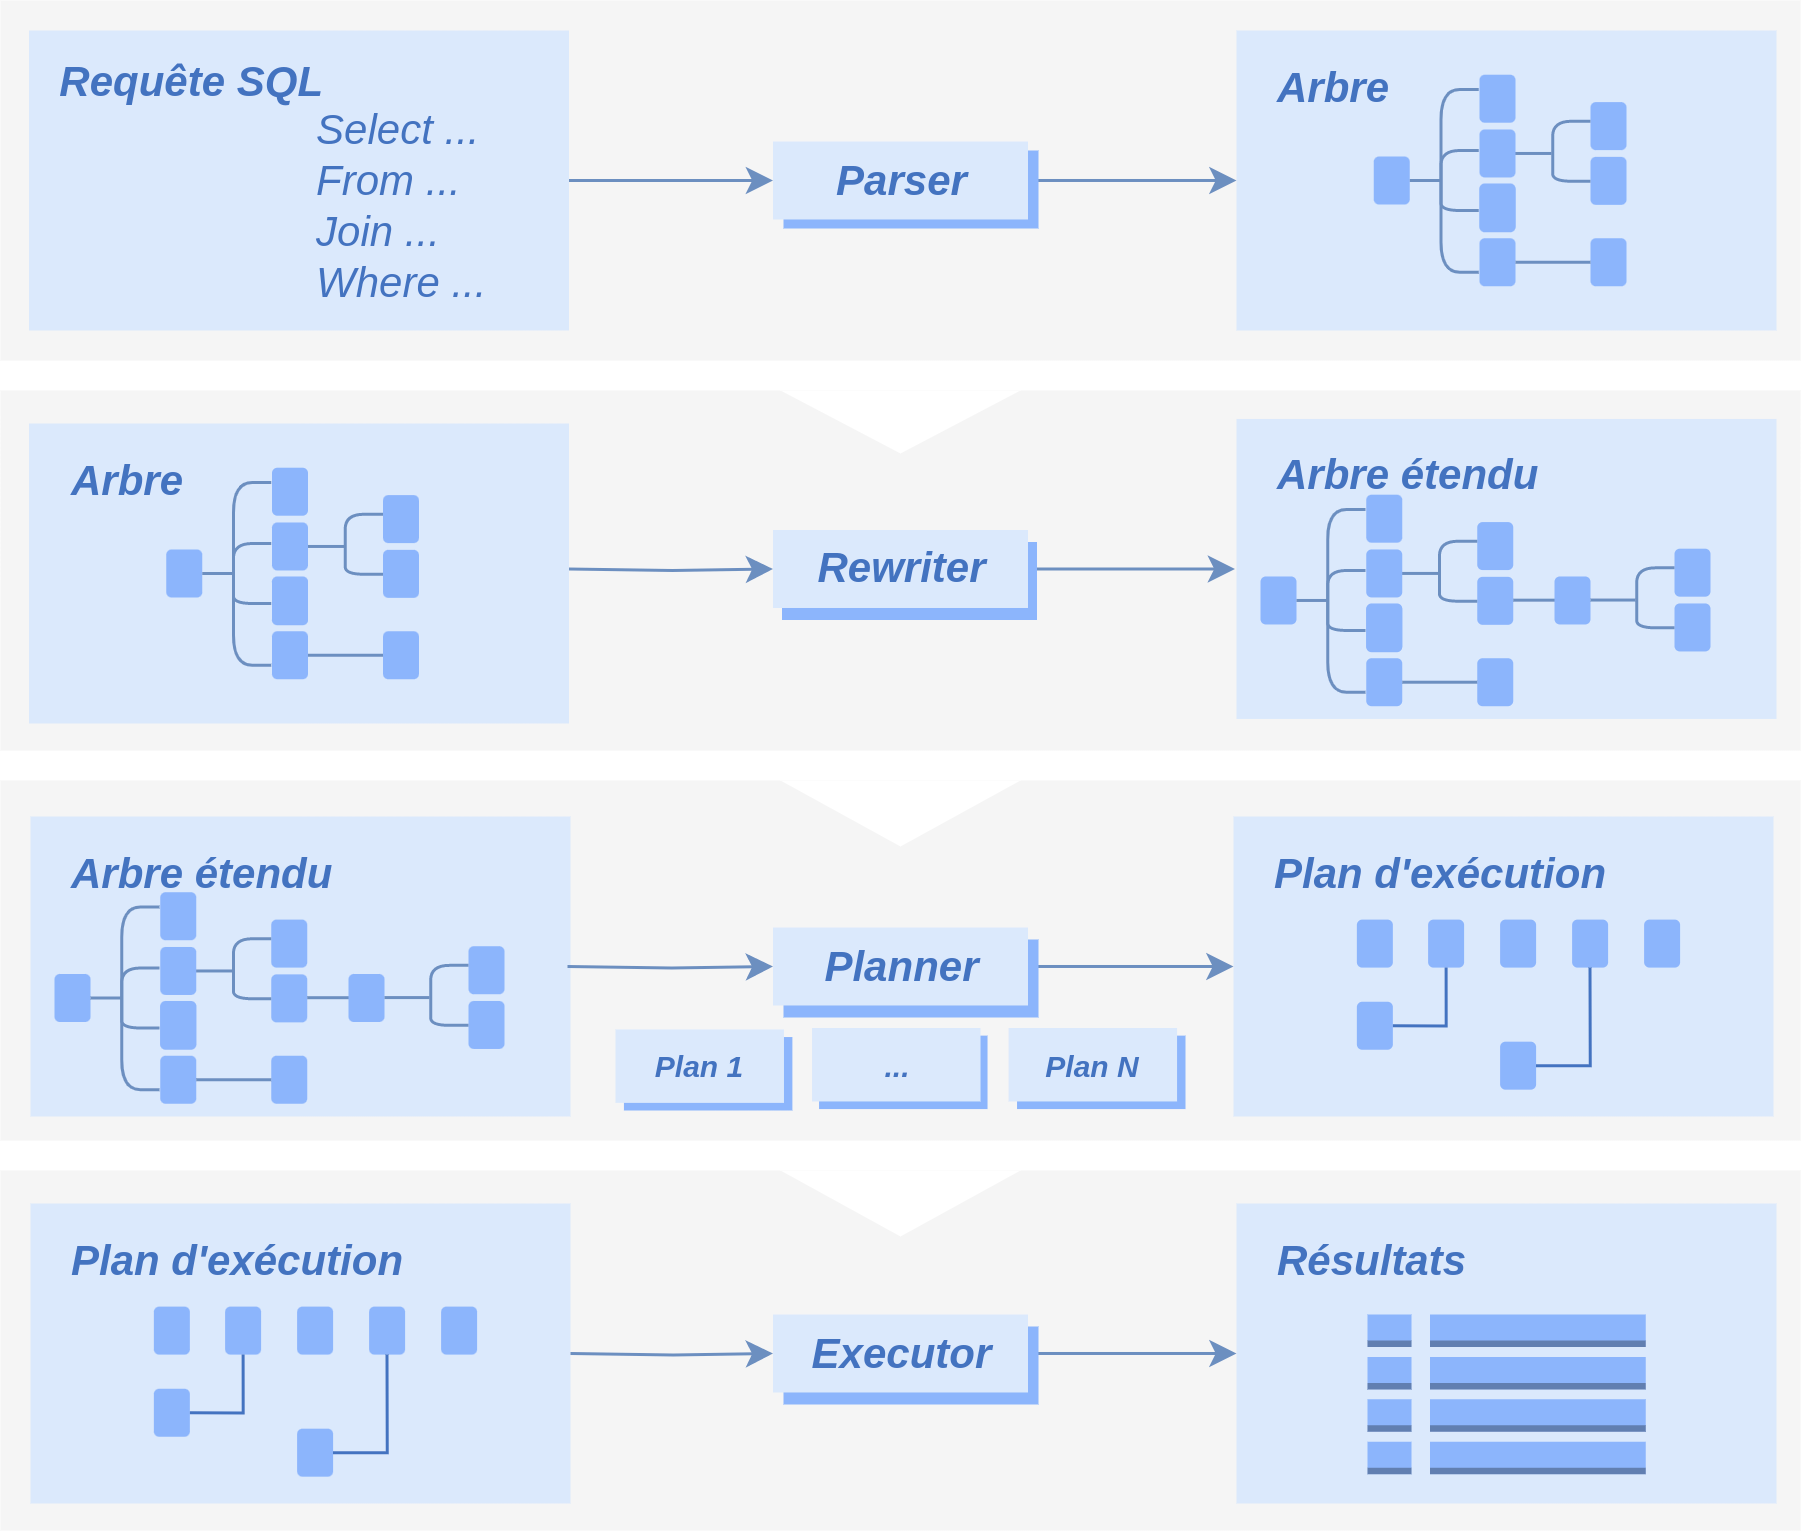
Une fois la requête exécutée, il envoie les résultats à l’utilisateur. Plusieurs goulets d’étranglement sont visibles ici. Les plus importants sont :
- la planification (à tel point qu’il est parfois préférable de ne générer qu’un sous-ensemble de
plans, pour passer plus rapidement à la phase d’exécution);
- la récupération des verrous (une requête peut attendre plusieurs secondes, minutes, voire
heures, avant de récupérer les verrous et exécuter réellement la requête);
l’exécution de la requête;
l’envoi des résultats à l’utilisateur.
Exceptions
Procédures stockées (appelées avec CALL )
Requêtes DDL
Instructions TRUNCATE et COPY
Pas de réécriture, pas de plans d’exécution…
une exécution directe
Il existe quelques requêtes qui échappent à la séquence d’opérations présentées précédemment. Toutes les opérations DDL (modification de la structure de la base), les instructions TRUNCATE et COPY (en partie) sont vérifiées syntaxiquement, puis directement exécutées. Les étapes de réécriture et de planification ne sont pas réalisées. Le principal souci pour les performances sur ce type d’instructions est donc l’obtention des verrous et l’exécution réelle.
Quelques définitions
Prédicat
filtre de la clause WHERE
conditions de jointure
Sélectivité
% de lignes retournées après application d’un prédicat
Cardinalité
nombre de lignes d’une table
nombre de lignes retournées après filtrages
Un prédicat est une condition de filtrage présente dans la clause WHERE d’une requête. Par exemple colonne = valeur . On parle aussi de prédicats de jointure pour les conditions de jointures présentes dans la clause WHERE ou suivant la clause ON d’une jointure. La sélectivité est liée à l’application d’un prédicat sur une table. Elle détermine le nombre de lignes remontées par la lecture d’une relation suite à l’application d’une clause de filtrage, ou prédicat. Elle peut être vue comme un coefficient de filtrage d’un prédicat. La sélectivité est exprimée sous la forme d’un pourcentage. Pour une table de 1000 lignes, si la sélectivité d’un prédicat est de 10 %, la lecture de la table en appliquant le prédicat devrait retourner 10 % des lignes, soit 100 lignes. La cardinalité représente le nombre de lignes d’une relation. En d’autres termes, la cardinalité représente le nombre de lignes d’une table ou de la sortie d’un nœud. Elle représente aussi le nombre de lignes retournées par la lecture d’une table après application d’un ou plusieurs prédicats.
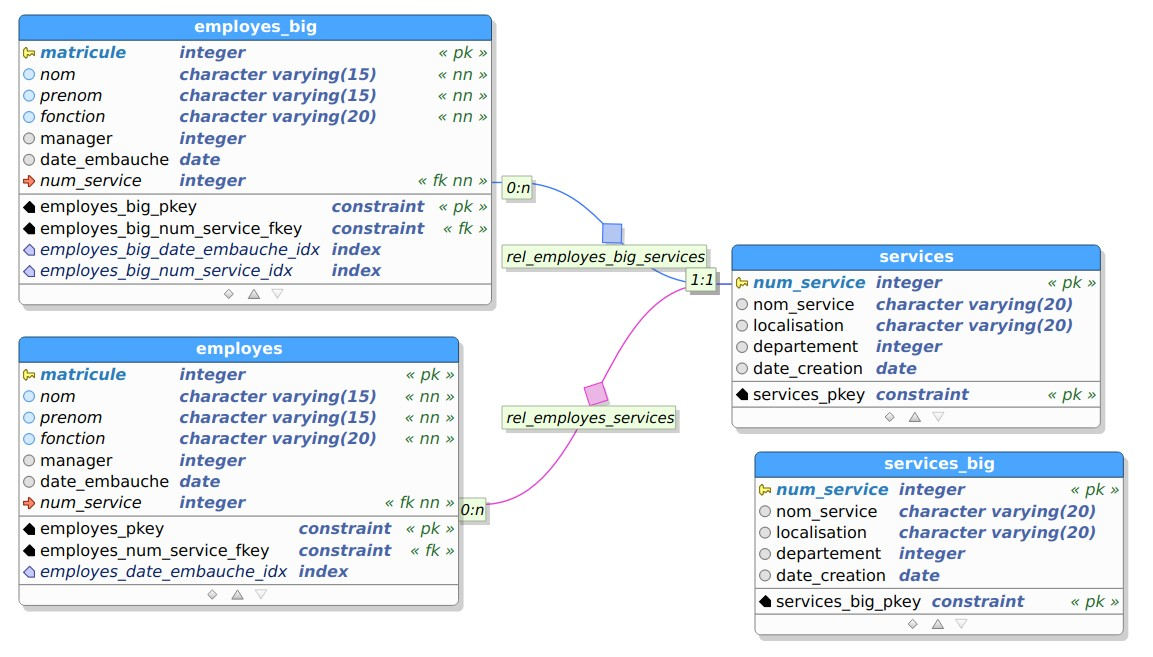
Jeu de tests
Tables
services : 4 lignes
services_big : 40 000 lignes
employes : 14 lignes
employes_big : ~500 000 lignes
Index
service* . num_service (clés primaires)
employes* . matricule (clés primaires)
employes* . date_embauche
employes_big . num_service (clé étrangère)
Les deux volumétries différentes vont permettre de mettre en évidence certains effets.
Jeu de tests (schéma)
Les tables suivantes nous serviront d’exemple par la suite. Si vous n’avez pas déjà la base employes, son script de création se télécharge et s’installe ainsi :
Les quelques tables occupent environ 80 Mo sur le disque.
Requête étudiée
Cette requête nous servira d’exemple. Elle permet de déterminer les employés basés à Nantes et pour résultat :
| matricule | nom | prenom | nom_service | fonction | localisation |
|---|---|---|---|---|---|
| 33 | Roy | Arthur | Consultants | Consultant | Nantes |
| 105 | Vacuum | Anne-Lise | Consultants | Responsable | Nantes |
| 119 | Thierrie | Armand | Consultants | Consultant | Nantes |
| 136 | Barnier | Germaine | Consultants | Consultant | Nantes |
| 137 | Pivert | Victor | Consultants | Consultant | Nantes |
En fonction du cache, elle dure de 1 à quelques millisecondes.
Plan de la requête étudiée
L’objet de ce module est de comprendre son plan d’exécution :
La directive EXPLAIN permet de connaître le plan d’exécution d’une requête. Elle permet de savoir par quelles étapes va passer le SGBD pour répondre à la requête. Ce plan montre une jointure par hachage. La table services est parcourue intégralement (Seq Scan), mais elle est filtrée sur le critère sur « Nantes ». Un hash de la colonne num_service des lignes résultantes de ce filtrage est effectué, et comparé aux valeurs rencontrées lors d’un parcours complet de employes . S’affichent également les coûts estimés des opérations et le nombre de lignes que PostgreSQL s’attend à trouver à chaque étape.
Planificateur
Rappels :
SQL est un langage déclaratif
Planificateur : trouver le meilleur plan
Énumère tous les plans d’exécution possible
tous ou presque…
Statistiques + configuration + règles -> coût
Coût le plus bas = meilleur plan
Le but du planificateur est assez simple. Pour une requête, il existe de nombreux plans d’exécution possibles. Il va donc tenter d’énumérer tous les plans d’exécution possibles ; même si leur nombre devient vite colossal dans une requête complexe : chaque table peut être accédée selon différents plans, selon l’un ou l’autre critère ou une combinaison, les algorithmes de jointure possibles sont multiples, etc. Lors de cette énumération des différents plans, il calcule leur coût. Cela lui permet d’en ignorer certains alors qu’ils sont incomplets si leur plan d’exécution est déjà plus coûteux que les autres. Pour calculer le coût, il dispose d’informations sur les données (des statistiques), d’une configuration (réalisée par l’administrateur de bases de données) et d’un ensemble de règles inscrites en dur. À la fin de l’énumération et du calcul de coût, il ne lui reste plus qu’à sélectionner le plan qui a le plus petit coût, à priori celui qui sera le plus rapide pour la requête demandée. (En toute rigueur, pour réduire le nombre de plans très voisins à étudier, des plans de coûts différents de 1% près peuvent être considérés équivalents 1 , et le coût de démarrage peut alors les départager.)
Le coût d’un plan est une valeur calculée sans unité ni signification physique.
Règles
Règle 1 : récupérer le bon résultat
Règle 2 : le plus rapidement possible
en minimisant les opérations disques
en préférant les lectures séquentielles
en minimisant la charge CPU
en minimisant l’utilisation de la mémoire
Le planificateur suit deux règles : 1 https://doxygen.postgresql.org/pathnode_8c_source.html#l00151
il doit récupérer le bon résultat : un résultat rapide mais faux n’a aucun intérêt;
il doit le récupérer le plus rapidement possible.
Cette deuxième règle lui impose de minimiser l’utilisation des ressources : en tout premier lieu les opérations disques vu qu’elles sont les plus coûteuses, mais aussi la charge CPU (charge des CPU utilisés et nombre de CPU utilisés) et l’utilisation de la mémoire.
Dans le cas des opérations disques, s’il doit en faire, il doit souvent privilégier les opérations séquentielles aux dépens des opérations aléatoires (qui demandent un déplacement de la tête de disque, opération la plus coûteuse sur les disques magnétiques).
Outils de l’optimiseur
L’optimiseur s’appuie sur :
un mécanisme de calcul de coûts
des statistiques sur les données
le schéma de la base de données
Pour déterminer le chemin d’exécution le moins coûteux, l’optimiseur devrait connaître précisément les données mises en œuvre dans la requête, les particularités du matériel et la charge en cours sur ce matériel. Cela est impossible. Ce problème est contourné en utilisant deux mécanismes liés l’un à l’autre :
un mécanisme de calcul de coût de chaque opération;
des statistiques sur les données.
Pour quantifier la charge nécessaire pour répondre à une requête, PostgreSQL utilise un mécanisme de coût. Il part du principe que chaque opération a un coût plus ou moins important. Les statistiques sur les données permettent à l’optimiseur de requêtes de déterminer assez précisément la répartition des valeurs d’une colonne d’une table, sous la forme d’histogramme. Il dispose encore d’autres informations comme la répartition des valeurs les plus fréquentes, le pourcentage de NULL , le nombre de valeurs distinctes, etc.
Toutes ces informations aideront l’optimiseur à déterminer la sélectivité d’un filtre (prédicat de la clause WHERE , condition de jointure) et donc la quantité de données récupérées par la lecture d’une table en utilisant le filtre évalué. Enfin, l’optimiseur s’appuie sur le schéma de la base de données afin de déterminer différents paramètres qui entrent dans le calcul du plan d’exécution : contrainte d’unicité sur une colonne, présence d’une contrainte NOT NULL , etc.
Optimisations
À partir du modèle de données
suppression de jointures externes inutiles
Transformation des sous-requêtes
certaines sous-requêtes transformées en jointures
ex : critere IN (SELECT …)
Appliquer les prédicats le plus tôt possible
réduit le jeu de données manipulé
Intègre le code des fonctions SQL simples (inline)
évite un appel de fonction coûteux
Suppression des jointures externes inutiles À partir du modèle de données et de la requête soumise, l’optimiseur de PostgreSQL va pouvoir déterminer si une jointure externe n’est pas utile à la production du résultat. Sous certaines conditions, PostgreSQL peut supprimer des jointures externes, à condition que le résultat ne soit pas modifié. Dans l’exemple suivant, il ne sert à rien d’aller consulter la table services (ni données à récupérer, ni filtrage à faire, et même si la table est vide, le LEFT JOIN ne provoquera la disparition d’aucune ligne) :
Toutefois, si le prédicat de la requête est modifié pour s’appliquer sur la table services , la jointure est tout de même réalisée, puisqu’on réalise un test d’existence sur cette table services :
Transformation des sous-requêtes Certaines sous-requêtes sont transformées en jointure :
La sous-requête ser a été remontée dans l’arbre de requête pour être intégrée en jointure.
Application des prédicats au plus tôt Lorsque cela est possible, PostgreSQL essaye d’appliquer les prédicats au plus tôt :
Les deux prédicats num_service = 4 et date_embauche < ‘2006-01-01’ ont été appliqués en même temps, réduisant ainsi le jeu de données à considérer dès le départ. C’est généralement une bonne chose. Mais en cas de problème, il est possible d’utiliser une CTE matérialisée (Common Table Expression, clause WITH … AS MATERIALIZED (…) ) pour bloquer cette optimisation et forcer PostgreSQL à exécuter le contenu de la requête en premier 2 . En versions 12 et ultérieures, une CTE est par défaut non matérialisée et donc intégrée avec le reste de la requête (du moins dans les cas simples comme cidessus), comme une sous-requête. On retombe exactement sur le plan précédent :
2 https://docs.postgresql.fr/current/queries-with.html#QUERIES-WITH-CTE-MATERIALIZATION
Pour recréer la « barrière d’optimisation », il est nécessaire d’ajouter le mot-clé MATERIALIZED :
La CTE est alors intégralement exécutée avec son filtre propre, avant que le deuxième filtre soit appliqué dans un autre nœud. Jusqu’en version 11 incluse, ce dernier comportement était celui par défaut, et les CTE étaient une source fréquente de problèmes de performances. Function inlining Voici deux fonctions, la première écrite en SQL, la seconde en PL/pgSQL :
Si l’on utilise la fonction écrite en PL/pgSQL, on retrouve l’appel de la fonction dans la clause Filter du plan d’exécution de la requête :
Effectivement, PostgreSQL ne sait pas intégrer le code des fonctions PL/pgSQL dans ses plans d’exécution. En revanche, en utilisant la fonction écrite en langage SQL, la définition de la fonction est directement intégrée dans la clause de filtrage de la requête :
Le temps d’exécution a été divisé presque par 20 sur ce jeu de données très réduit, montrant l’impact de l’appel d’une fonction dans une clause de filtrage. Dans les deux cas ci-dessus, PostgreSQL a négligé l’index sur date_embauche : la table ne faisait de toute façon qu’un bloc ! Mais pour de plus grosses tables, l’index sera nécessaire, et la différence entre fonctions PL/pgSQL et SQL devient alors encore plus flagrante. Avec la même requête sur la table employes_big , beaucoup plus grosse, on obtient ceci :
La fonction portant sur une « boîte noire », l’optimiseur n’a comme possibilité que le parcours complet de la table.
La fonction SQL est intégrée, l’optimiseur voit le critère dans date_embauche et peut donc se poser la question de l’utiliser (et ici, la réponse est oui : 3 blocs contre 4664, tous présents dans le cache dans cet exemple). D’où une exécution beaucoup plus rapide.
Décisions
L’optimiseur doit choisir :
Stratégie d’accès aux lignes
parcours de table, d’index, fonction, etc.
Stratégie d’utilisation des jointures
ordre
ordre des tables jointes
type (Nested Loop, Merge Join, Hash Join…)
Stratégie d’agrégation
brut, trié, haché
En version parallélisée?
Tenir compte de la consommation mémoire
Pour exécuter une requête, le planificateur va utiliser des opérations. Pour lire des lignes, il peut :
utiliser un parcours de table (Seq Scan) qui ne lit que celle-ci ;
parcourir un index et revenir chercher les lignes dans la table (Index Scan ou Bitmap Scan);
ou se contenter de l’index s’il suffit (Index Only Scan).
Il existe encore d’autres types de parcours. Les accès aux tables et index sont généralement les premières opérations utilisées. Pour joindre les tables, l’ordre est très important pour essayer de réduire la masse des données manipulées. Les jointures se font toujours entre deux des tables impliquées, pas plus ; ou entre une table et le résultat d’un nœud, ou entre les résultats de deux nœuds. Pour la jointure elle-même, il existe plusieurs méthodes différentes : boucles imbriquées (Nested Loops), hachage (Hash Join), tri-fusion (Merge Join)… Il existe également plusieurs algorithmes d’agrégation des lignes. Un tri peut être nécessaire pour une jointure, une agrégation, ou pour un ORDER BY , et là encore il y a plusieurs algorithmes possibles. L’optimiseur peut aussi décider d’utiliser un index (déjà trié) pour éviter ce tri.
Certaines des opérations ci-dessus sont parallélisables. Certaines sont aussi susceptibles de consommer beaucoup de mémoire, l’optimiseur doit en tenir compte.
Parallélisation
Processus supplémentaires pour certains nœuds
parer à la limitation par le CPU
En lecture (sauf exceptions)
Parcours séquentiel
Jointures : Nested Loop / Hash Join / Merge Join
Agrégats
Parcours d’index (B-Tree uniquement)
Création d’index B-Tree
Certaines créations de table et vues matérialisées
DISTINCT (v15)
Principe : À partir d’une certaine quantité de données à traiter par un nœud, un ou plusieurs processus auxiliaires (parallel workers) apparaissent pour répartir la charge sur d’autres processeurs. Sans cela, une requête n’est traitée que par un seul processus sur un seul processeur.
Il ne s’agit pas de lire une table avec plusieurs processus mais de répartir le traitement b des lignes. La parallélisation n’est donc utile que si le CPU est le facteur limitant. Par exemple, un simple SELECT sur une grosse table sans WHERE ne mènera pas à un parcours parallélisé.
La parallélisation concerne en premier lieu les parcours de tables (Seq Scan), les jointures (Nested Loop, Hash Join, Merge Join), ainsi que certaines fonctions d’agrégat (comme min , max , avg , sum , etc.); mais encore les parcours d’index B-Tree (Index Scan, Index Only Scan et Bitmap Scan) La parallélisation est en principe disponible pour les autres types d’index, mais ils n’en font pas usage pour l’instant. La parallélisation ne concerne encore que les opérations en lecture. Il y a des exceptions, comme la création des index B-Tree de façon parallélisée. Certaines créations de table avec
En version 15, il devient possible de paralléliser des clauses DISTINCT . Paramétrage : Le paramétrage s’est affiné au fil des versions. Le paramètre max_parallel_workers_per_gather (2 par défaut) désigne le nombre de processus auxiliaires maximum d’un nœud d’une requête. max_parallel_maintenance_workers (2 par défaut)
est l’équivalent dans les opérations de maintenance (réindexation notamment). Trop de processus parallèles peuvent mener à une saturation de CPU ; l’exécuteur de PostgreSQL ne lancera donc pas plus de max_parallel_workers processus auxiliaires simultanés (8 par défaut), lui-même limité par max_worker_processes (8 par défaut). En pratique, on ajustera le nombre de parallel workers en fonction des CPU de la machine et de la charge attendue. La mise en place de l’infrastructure de parallélisation a un coût, défini par parallel_setup_cost (1000 par défaut), et des tailles de table ou index minimales, en-dessous desquels la parallélisation n’est pas envisagée. La plupart de ces paramètres peuvent être modifiés dans une sessions par SET .
Limites actuelles de la parallélisation
Lourd à déclencher
Pas sur les écritures de données
Très peu d’opérations DDL gérées
Pas en cas de verrous
Pas sur les curseurs
En évolution à chaque version
Même si cette fonctionnalité évolue au fil des versions majeures, des limitations assez fortes restent présentes 3 , notamment :
- elle est assez lourde à mettre en place, elle a donc un coût d’entrée qui la rend inutile quand il
y a peu de lignes;
pas de parallélisation pour les écritures de données ( INSERT , UPDATE , DELETE , etc.),
peu de parallélisation sur les opérations DDL (par exemple un ALTER TABLE ne peut pas être
parallélisé) Il y a des cas particuliers, notamment CREATE TABLE AS ou CREATE MATERIALIZED VIEW , parallélisable à partir de la v11; ou le niveau d’isolation serializable : avant la v12, il ne permet aucune parallélisation.
3 https://docs.postgresql.fr/current/when-can-parallel-query-be-used.html
Mécanisme de coûts
Modèle basé sur les coûts
quantifier la charge pour répondre à une requête
Chaque opération a un coût :
lire un bloc selon sa position sur le disque
manipuler une ligne issue d’une lecture de table ou d’index
appliquer un opérateur
L’optimiseur statistique de PostgreSQL utilise un modèle de calcul de coût. Les coûts calculés sont des indications arbitraires sur la charge nécessaire pour répondre à une requête. Chaque facteur de coût représente une unité de travail : lecture d’un bloc, manipulation des lignes en mémoire, application d’un opérateur sur des données.
Coûts unitaires
Coûts à connaître :
accès au disque séquentiel / non séquentiel
traitement d’un enregistrement issu d’une table
traitement d’un enregistrement issu d’un index
application d’un opérateur
traitement d’un enregistrement dans un parcours parallélisé
mise en place d’un parcours parallélisé
mise en place du JIT, du parallélisme…
Chaque coût = un paramètre
modifiable dynamiquement avec SET
Pour quantifier la charge nécessaire pour répondre à une requête, PostgreSQL utilise un mécanisme de coût. Il part du principe que chaque opération a un coût plus ou moins important. Divers paramètres permettent d’ajuster les coûts relatifs. Ces coûts sont arbitraires, à ne comparer qu’entre eux, et ne sont pas liés directement à des caractéristiques physiques du serveur.
- seq_page_cost (1 par défaut) représente le coût relatif d’un accès séquentiel à un bloc sur le
disque, c’est-à-dire à un bloc lu en même temps que ses voisins dans la table;
- random_page_cost (4 par défaut) représente le coût relatif d’un accès aléatoire (isolé) à un
bloc : 4 signifie que le temps d’accès de déplacement de la tête de lecture de façon aléatoire est estimé 4 fois plus important que le temps d’accès en séquentiel - ce sera moins avec un bon disque, voire 1 pour un SSD;
- cpu_tuple_cost (0,01 par défaut) représente le coût relatif de la manipulation d’une ligne en
mémoire;
- cpu_index_tuple_cost (0,005 par défaut) répercute le coût de traitement d’une donnée issue
d’un index;
cpu_operator_cost (défaut 0,0025) indique le coût d’application d’un opérateur sur une donnée;
parallel_tuple_cost (0,1 par défaut) indique le coût estimé du transfert d’une ligne d’un
processus à un autre;
parallel_setup_cost (1000 par défaut) indique le coût de mise en place d’un parcours parallélisé, une procédure assez lourde qui ne se rentabilise pas pour les petites requêtes;
jit_above_cost (100 000 par défaut), jit_inline_above_cost (500 000 par défaut),
jit_optimize_above_cost (500 000 par défaut) représentent les seuils d’activation de divers niveaux du JIT (Just In Time ou compilation à la volée des requêtes), outil qui ne se rentabilise que sur les gros volumes. En général, on ne modifie pas ces paramètres sans justification sérieuse. Le plus fréquemment, on peut être amené à diminuer random_page_cost si le serveur dispose de disques rapides, d’une carte RAID équipée d’un cache important ou de SSD. Mais en faisant cela, il faut veiller à ne pas déstabiliser des plans optimaux qui obtiennent des temps de réponse constants. À trop diminuer random_page_cost , on peut obtenir de meilleurs temps de réponse si les données sont en cache, mais aussi des temps de réponse dégradés si les données ne sont pas en cache. Pour des besoins particuliers, ces paramètres sont modifiables dans une session. Ils peuvent être modifiés dynamiquement par l’application avec l’ordre SET pour des requêtes bien particulières, pour éviter de toucher au paramétrage général.
Lecture d’un plan
Un plan d’exécution se lit en partant du nœud se trouvant le plus à droite et en remontant jusqu’au nœud final. Quand le plan contient plusieurs nœuds, le premier nœud exécuté est celui qui se trouve le plus à droite. Celui qui est le plus à gauche (la première ligne) est le dernier nœud exécuté. Tous les nœuds sont exécutés simultanément, et traitent les données dès qu’elles sont transmises par le nœud parent (le ou les nœuds justes en dessous, à droite). Chaque nœud montre les coûts estimés dans le premier groupe de parenthèses. cost est un couple de deux coûts : la première valeur correspond au coût pour récupérer la première ligne (souvent nul dans le cas d’un parcours séquentiel) ; la deuxième valeur correspond au coût pour récupérer toutes les lignes (elle dépend essentiellement de la taille de la table lue, mais aussi d’opération de filtrage). rows correspond au nombre de lignes que le planificateur pense récupérer à la sortie de ce nœud. width est la largeur en octets de la ligne.
Cet exemple simple permet de voir le travail de l’optimiseur :
Ce plan débute en bas par la lecture de la table services. L’optimiseur estime que cette lecture ramènera une seule ligne (rows=1), que cette ligne occupera 21 octets en mémoire (width=21). Il s’agit de la sélectivité du filtre WHERE localisation = 'Nantes'. Le coût de départ de cette lecture est de 0 (cost=0.00). Le coût total de cette lecture est de 1,05, qui correspond à la lecture séquentielle d’un seul bloc (paramètre seq_page_cost ) et à la manipulation des 4 lignes de la table services (donc 4 * cpu_tuple_cost + 4 * cpu_operator_cost ). Le résultat de cette lecture est ensuite haché par le nœud Hash, qui précède la jointure de type Hash Join. La jointure peut maintenant commencer, avec le nœud Hash Join. Il est particulier, car il prend 2 entrées : la donnée hachée initialement, et les données issues de la lecture d’une seconde table (peu importe le type d’accès). Le nœud a un coût de démarrage de 1,06, soit le coût du hachage additionné au coût de manipulation du tuple de départ. Il s’agit du coût de production du premier tuple de résultat. Le coût total de production du résultat est de 2,34. La jointure par hachage démarre réellement lorsque la lecture de la table employes commence. Cette lecture remontera 14 lignes, sans application de filtre. La totalité de la table est donc remontée et elle est très petite donc tient sur un seul bloc de 8 ko. Le coût d’accès total est donc facilement déduit à partir de cette information. À partir des sélectivités précédentes, l’optimiseur estime que la jointure ramènera 4 lignes au total.
Rappel des options d’EXPLAIN
ANALYZE : exécution (danger!)
BUFFERS : blocs read/hit/written/dirtied, shared/local/temp
WAL : écritures dans les journaux
SERIALIZE : coût de sérialisation (v17)
SETTINGS : paramètrage en cours
VERBOSE : champs manipulés, workers
MEMORY : mémoire consommée par le planificateur (v17)
GENERIC_PLAN : plan générique (requête préparée, v16)
Désactivables avec OFF :
COSTS , TIMING , SUMMARY (dont planification)
FORMAT : sortie en texte, XML, JSON, YAML
Options personnalisées (v18+)
Au fil des versions, EXPLAIN a gagné en options. L’une d’entre elles permet de sélectionner le format en sortie. Toutes les autres permettent d’obtenir des informations supplémentaires, ou au contraire de masquer des informations affichées par défaut. Option ANALYZE Le but de cette option est d’obtenir les informations sur l’exécution réelle de la requête. EXPLAIN sans ANALYZE renvoie juste le plan prévu.
Cette option n’a rien à voir avec l’ordre ANALYZE nom_table , qui met à jour les statistiques!
Avec ANALYZE , la requête est réellement exécutée! Attention donc aux INSERT / UPDATE / DELETE . N’oubliez pas non plus qu’un SELECT peut appeler des fonctions qui écrivent dans la base. Dans le doute, englober l’appel dans une transaction que vous annulerez après coup.
Voici un exemple utilisant cette option :
Quatre nouvelles informations apparaissent, toutes liées à l’exécution réelle de la requête :
actual time :
la première valeur correspond à la durée en milliseconde pour récupérer la première ligne ;
la deuxième valeur est la durée en milliseconde pour récupérer toutes les lignes ;
rows est le nombre de lignes réellement récupérées : comparer au nombre de la première
parenthèse permet d’avoir une idée de la justesse des statistiques et de l’estimation (ce nombre comporte une décimale à partir de la version 18) ;
- loops est le nombre d’exécutions de ce nœud, car certains peuvent être répétés de nombreuses fois.
Multiplier la durée par le nombre de boucles pour obtenir la durée réelle d’exécution du b nœud !
L’intérêt de cette option est donc de trouver l’opération qui prend du temps dans l’exécution de la requête, mais aussi de voir les différences entre les estimations et la réalité (notamment au niveau du nombre de lignes). Option BUFFERS Elle indique le nombre de blocs impactés par chaque nœud du plan d’exécution, en lecture comme en écriture. Cette option n’est en pratique utilisable qu’avec l’option ANALYZE . Elle est activée par défaut à partir de la version 18.
Cette option est à activer systématiquement. La quantité de blocs manipulés par une b requête est souvent étonnante.
Voici un exemple de son utilisation :
La nouvelle ligne est la ligne Buffers . shared hit indique un accès à une table ou index dans les shared buffers de PostgreSQL. Ces autres indications peuvent se rencontrer :
Informations Type d’objet concerné Explications
Shared hit Table ou index permanent Lecture d’un bloc dans le cache Shared read Table ou index permanent Lecture d’un bloc hors du cache Shared written Table ou index permanent Écriture d’un bloc Local hit Table ou index temporaire Lecture d’un bloc dans le cache Local read Table ou index temporaire Lecture d’un bloc hors du cache Local written Table ou index temporaire Écriture d’un bloc Temp read Tris et hachages Lecture d’un bloc Temp written Tris et hachages Écriture d’un bloc
par la seule planification. C’est surtout intéressant pour mettre en évidence le coût d’une première planification, avec le chargement des tables de statistique et l’effet de cache dans la session par exemple. Cet exemple est extrême (10 000 partitions avec leurs statistiques à consulter) :
Option SETTINGS Désactivée par défaut, cette option affiche les valeurs des paramètres qui ne sont pas à la valeur par défaut dans la session de la requête. Il est conseillé de l’activer, surtout pour communiquer le plan à des personnes extérieures, ou pour comparer l’effet de différents paramétrages.
Option WAL Cette option permet d’obtenir le nombre d’enregistrements et le nombre d’octets écrits dans les journaux de transactions. Elle est désactivée par défaut, et là encore il est conseillé de l’activer au moindre doute, et pas juste lors des écritures. Même un SELECT peut générer des journaux (maintenance des hint bits, appel de fonctions…).
Option SERIALIZE À partir de PostgreSQL 17, il est conseillé d’activer cette option lors d’un EXPLAIN (ANALYZE) . Elle force la lecture des données et leur conversion en texte ou binaire (« sérialisation »), comme le fait une exécution normale. Un EXPLAIN (ANALYZE) sans cette option ne lit pas forcément toutes les données, ne les convertit pas, et peut donc afficher un temps inférieur à la réalité en production. Cet exemple simple montre bien la différence en temps et volumétrie :
Cet autre exemple met en évidence le gain en temps et volume si l’on n’a besoin que d’un seul champ, par rapport au SELECT * qui ramène tout (une mauvaise pratique) :
Le temps perdu peut être encore plus important si une table TOAST est inutilement lue. Le temps supplémentaire perdu lors d’un transfert sur le réseau n’est hélas pas pris en compte, puisque l’ordre s’éxécute intégralement sur le serveur. Option MEMORY À partir de PostgreSQL 17, le planificateur peut afficher la mémoire qu’il consomme le temps de la planification, pour chaque requête. En général, il ne s’agira que de quelques kilo-octets. Ce peut être beaucoup plus haut, par exemple avec de nombreuses partitions :
Option GENERIC_PLAN Cette option (à partir de PostgreSQL 16) sert quand on cherche le plan générique planifié pour une requête préparée (c’est-à-dire dont les paramètres seront fournis séparément).
Option COSTS Activée par défaut, l’option COSTS indique les estimations du planificateur. La désactiver avec OFF permet de gagner en lisibilité.
Option TIMING Cette option n’est utilisable qu’avec l’option ANALYZE et est activée par défaut. Elle ajoute les informations sur les durées en milliseconde. Sa désactivation peut être utile sur certains systèmes où le chronométrage prend beaucoup de temps et allonge inutilement la durée d’exécution de la requête. Voici un exemple :
Option VERBOSE L’option VERBOSE permet d’afficher des informations supplémentaires comme la liste des colonnes en sortie, le nom de la table qualifié du nom du schéma, le nom de la fonction qualifié du nom du schéma, le nom du déclencheur (trigger), le détail des temps de chaque worker parallèle, le SQL envoyé à une table distante, etc. Elle est désactivée par défaut. Il vaut mieux l’activer autant que possible si un affichage chargé n’est pas un souci.
Option FORMAT Par défaut, la sortie est sous forme d’un texte destiné à être lu par un humain, mais il est possible de choisir un format balisé parmi XML, JSON et YAML. Voici ce que donne la commande EXPLAIN avec le format XML :
Les signes + en fin de ligne indiquent un retour à la ligne lors de l’utilisation de l’outil psql . Il est possible de ne pas les afficher en configurant l’option format de psql à unaligned . Cela se fait ainsi :
Ces formats semi-structurés sont utilisés principalement par des outils, car le contenu est plus facile à analyser, voire un peu plus complet. Quelles options utiliser ? Avec EXPLAIN (ANALYZE) , n’hésitez pas à utiliser systématiquement BUFFERS , SETTINGS , SERIALIZE et WAL . VERBOSE peut surcharger l’affichage, mais est conseillé avec des outils externes comme explain.dalibo.com 4 . Les autres options sont plus ciblées. Options personnalisées La version 18 permet l’ajout d’options personnalisées par l’intermédiaire d’extensions. La version 18 propose une extension d’exemple, appelée pg_overexplain qui ajoute deux options à EXPLAIN : DEBUG et RANGE_TABLE .
D’autres options pourraient voir le jour, suivant l’imagination des développeurs et les besoins des DBA.
Cardinalités et coûts
Détermine à partir des statistiques
cardinalité des prédicats
cardinalité des jointures
Coût d’accès déterminé selon
des cardinalités
volumétrie des tables
Afin de comparer les différents plans d’exécution possibles pour une requête et choisir le meilleur, l’optimiseur a besoin d’estimer un coût pour chaque nœud du plan. L’estimation la plus cruciale est celle liée aux nœuds de parcours de données, car c’est d’eux que découlera la suite du plan. Pour estimer le coût de ces nœuds, l’optimiseur s’appuie sur les informations statistiques collectées, ainsi que sur la valeur de paramètres de configuration. Les deux notions principales de ce calcul sont la cardinalité (nombre de lignes estimées en sortie d’un nœud) et la sélectivité (fraction des lignes conservées après l’application d’un filtre). Voici ci-dessous un exemple de calcul de cardinalité et de détermination du coût associé. Calcul de cardinalité Pour chaque prédicat et chaque jointure, PostgreSQL va calculer sa sélectivité et sa cardinalité. Pour un prédicat, cela permet de déterminer le nombre de lignes retournées par le prédicat par rapport au nombre total de lignes de la table. Pour une jointure, cela permet de déterminer le nombre de lignes retournées par la jointure entre deux tables. L’optimiseur dispose de plusieurs façons de calculer la cardinalité d’un filtre ou d’une jointure selon que la valeur recherchée est une valeur unique, que la valeur se trouve dans le tableau des valeurs les plus fréquentes ou dans l’histogramme. Cherchons comment calculer la cardinalité d’un filtre simple sur une table employes de 14 lignes, par exemple WHERE num_service = 1 . Ici, la valeur recherchée se trouve directement dans le tableau des valeurs les plus fréquentes (dans les champs most_common_vals et most_common_freqs ) la cardinalité peut être calculée directement.
| Colonne 1 | Colonne 2 |
|---|---|
| schemaname | public |
| tablename | employes |
| attname | num_service |
| inherited | f |
| null_frac | 0 |
| avg_width | 4 |
| n_distinct | -0.2857143 |
| most_common_vals | {4,3,2,1} |
| most_common_freqs | {0.35714287,0.2857143,0.21428572,0.14285715} |
| histogram_bounds | ¤ |
| correlation | 0.10769231 |
La requête suivante permet de récupérer la fréquence d’apparition de la valeur recherchée :
| tablename | attname | value | freq |
|---|---|---|---|
| employes | num_service | 1 | 0.142857 |
Si l’on n’avait pas eu affaire à une des valeurs les plus fréquentes, il aurait fallu passer par l’histogramme des valeurs ( histogram_bounds , ici vide car il y a trop peu de valeurs), pour calculer d’abord la sélectivité du filtre pour en déduire ensuite la cardinalité. Une fois cette fréquence obtenue, l’optimiseur calcule la cardinalité du prédicat WHERE num_service = 1 en la multipliant avec le nombre total de lignes de la table :
Le calcul est cohérent avec le plan d’exécution de la requête impliquant la lecture de employes sur laquelle on applique le prédicat évoqué plus haut :
Calcul de coût Notre table employes peuplée de 14 lignes va permettre de montrer le calcul des coûts réalisés par l’optimiseur. L’exemple présenté ci-dessous est simplifié. En réalité, les calculs sont plus complexes, car ils tiennent également compte de la volumétrie réelle de la table. Le coût de la lecture séquentielle de la table employes est calculé à partir de deux composantes. Tout d’abord, le nombre de pages (ou blocs) de la table permet de déduire le nombre de blocs à accéder pour lire la table intégralement. Le paramètre seq_page_cost (coût d’accès à un bloc dans un parcours complet) sera appliqué ensuite pour obtenir le coût de l’opération :
| relname | cout_acces |
|---|---|
| employes | 1 |
Cependant, le coût d’accès seul ne représente pas le coût de la lecture des données. Une fois que le bloc est monté en mémoire, PostgreSQL doit décoder chaque ligne individuellement. L’optimiseur multiplie donc par cpu_tuple_cost (0,01 par défaut) pour estimer le coût de manipulation des lignes :
- reltuples * current_setting(‘cpu_tuple_cost’)::float AS cout
| relname | cout |
|---|---|
| employes | 1.14 |
Le calcul est bon :
Avec un filtre dans la requête, les traitements seront plus lourds. Par exemple, en ajoutant le prédicat
autres, mais également appliquer l’opérateur de comparaison utilisé. L’optimiseur utilise le paramètre cpu_operator_cost pour déterminer le coût d’application d’un filtre :
| relname | cost |
|---|---|
| employes | 1.175 |
Ce nombre se retrouve dans le plan, à l’arrondi près :
Pour aller plus loin dans le calcul de sélectivité, de cardinalité et de coût, la documentation de PostgreSQL contient un exemple complet de calcul de sélectivité et indique les références des fichiers sources dans lesquels fouiller pour en savoir plus 5 .
5 https://docs.postgresql.fr/current/planner-stats-details.html
Nœuds d’exécution les plus courants
Un plan est composé de nœuds
qui produisent des données
ou en consomment et en retournent
Chaque nœud consomme les données produites par le(s) nœud(s) parent(s)
Le nœud final retourne les données à l’utilisateur
Les plans sont extrêmement sensibles aux données elles-mêmes bien sûr, aux paramètres, aux tailles réelles des objets, à la version de PostgreSQL, à l’ordre des données
dans la table, voire au moment du passage d’un VACUUM . Il n’est donc pas étonnant de
trouver parfois des plans différents de ceux reproduits ici pour une même requête.
Nœuds de type parcours
Parcours de table
Parcours d’index
Autres parcours
Par parcours, on entend le renvoi d’un ensemble de lignes provenant soit d’un fichier, soit d’un traitement. Le fichier peut correspondre à une table ou à une vue matérialisée, et on parle dans ces deux cas d’un parcours de table. Le fichier peut aussi correspondre à un index, auquel cas on parle de parcours d’index. Un parcours peut être un traitement dans différents cas, principalement celui d’une procédure stockée.
Parcours de table
Seq Scan
- Parallel Seq Scan
Parcours de table : Seq Scan
Les parcours de tables sont les principales opérations qui lisent les données des tables (normales, temporaires ou non journalisées) et des vues matérialisées. Elles ne prennent donc pas d’autre nœud en entrée et fournissent un ensemble de données en sortie. Cet ensemble peut être trié ou non, filtré ou non.
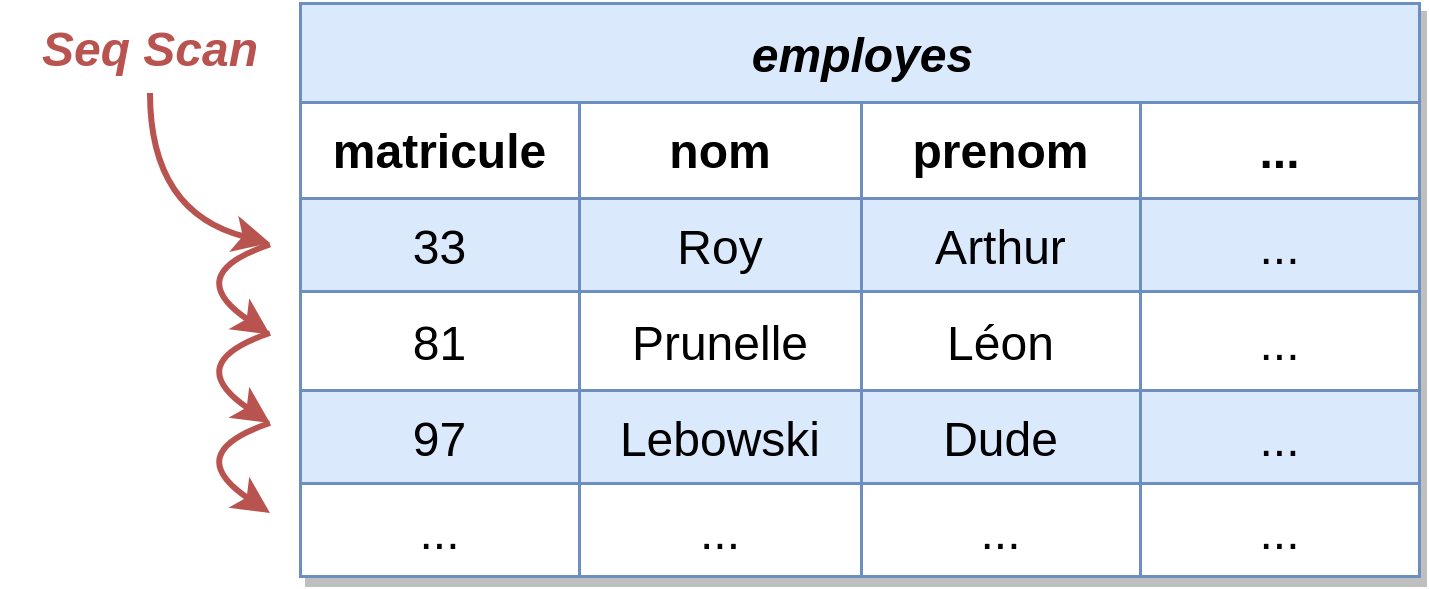
L’opération Seq Scan correspond à une lecture séquentielle d’une table, aussi appelée Full table scan sur d’autres SGBD. Il consiste à lire l’intégralité de la table, du premier bloc au dernier bloc. Une clause de filtrage peut être appliquée.
Ce nœud apparaît lorsque la requête nécessite de lire l’intégralité ou la majorité de la table :
Ce nœud peut également filtrer directement les données, la présence de la clause Filter montre le filtre appliqué par le nœud à la lecture des données :
Parcours de table : paramètres
Seq Scan
seq_page_cost (défaut : 1)
cpu_tuple_cost & cpu_operator_cost
enable_seqscan
Parallel Seq Scan
parallel_tuple_cost , min_parallel_table_scan_size
et les autres paramètres de la parallélisation
Le coût d’un Seq Scan sera fonction du nombre de blocs à parcourir, et donc du paramètre seq_page_cost , ainsi que du nombre de lignes à décoder et, optionnellement, à filtrer. La valeur de seq_page_cost , par défaut à 1, est rarement modifiée ; elle est surtout importante comparée à random_page_cost .
Il est possible d’avoir un parcours parallélisé d’une table (Parallel Seq Scan). La parallélisation doit être activée comme décrit plus haut, notamment :
- les paramètres max_parallel_workers_per_gather et max_parallel_workers doivent
être tous deux supérieurs à 0, ce qui est le cas par défaut ;
- la table à traiter doit avoir une taille minimale ( min_parallel_table_scan_size est à 8 Mo) ;
et plus elle sera grosse plus il y aura de workers ; Pour que ce type de parcours soit valable, il faut que l’optimiseur soit persuadé que le problème sera le temps CPU et non la bande passante disque. Il y a cependant un coût pour chaque ligne (paramètre parallel_tuple_cost ). Autrement dit, dans la majorité des cas, il faut un filtre sur une table importante pour que la parallélisation se déclenche. Dans les exemples suivants, la parallélisation est activée :
Ici, deux processus supplémentaires seront exécutés pour réaliser la requête. Dans le cas de ce type de parcours, chaque processus prend un bloc et traite toutes les lignes de ce bloc. Quand un processus a terminé de traiter son bloc, il regarde quel est le prochain groupe de blocs à traiter et le traite. (Travailler par groupe de blocs permet de profiter de la fonctionnalité de read ahead du noyau.)
Parcours d’index
Index Scan
Index Only Scan
Bitmap Index Scan
et leurs versions parallélisées (B-Tree)
PostgreSQL dispose de trois moyens d’accéder aux données à travers les index. Le plus connu est l’Index Scan, qui possède plusieurs variantes.
Index Scan
Le nœud Index Scan consiste à parcourir les blocs d’index jusqu’à trouver les pointeurs vers les blocs contenant les données. À chaque pointeur trouvé, PostgreSQL lit le bloc de la table pointée pour retrouver l’enregistrement et s’assurer notamment de sa visibilité pour la transaction en cours. De ce fait, il y a beaucoup d’accès non séquentiels pour lire l’index et la table.
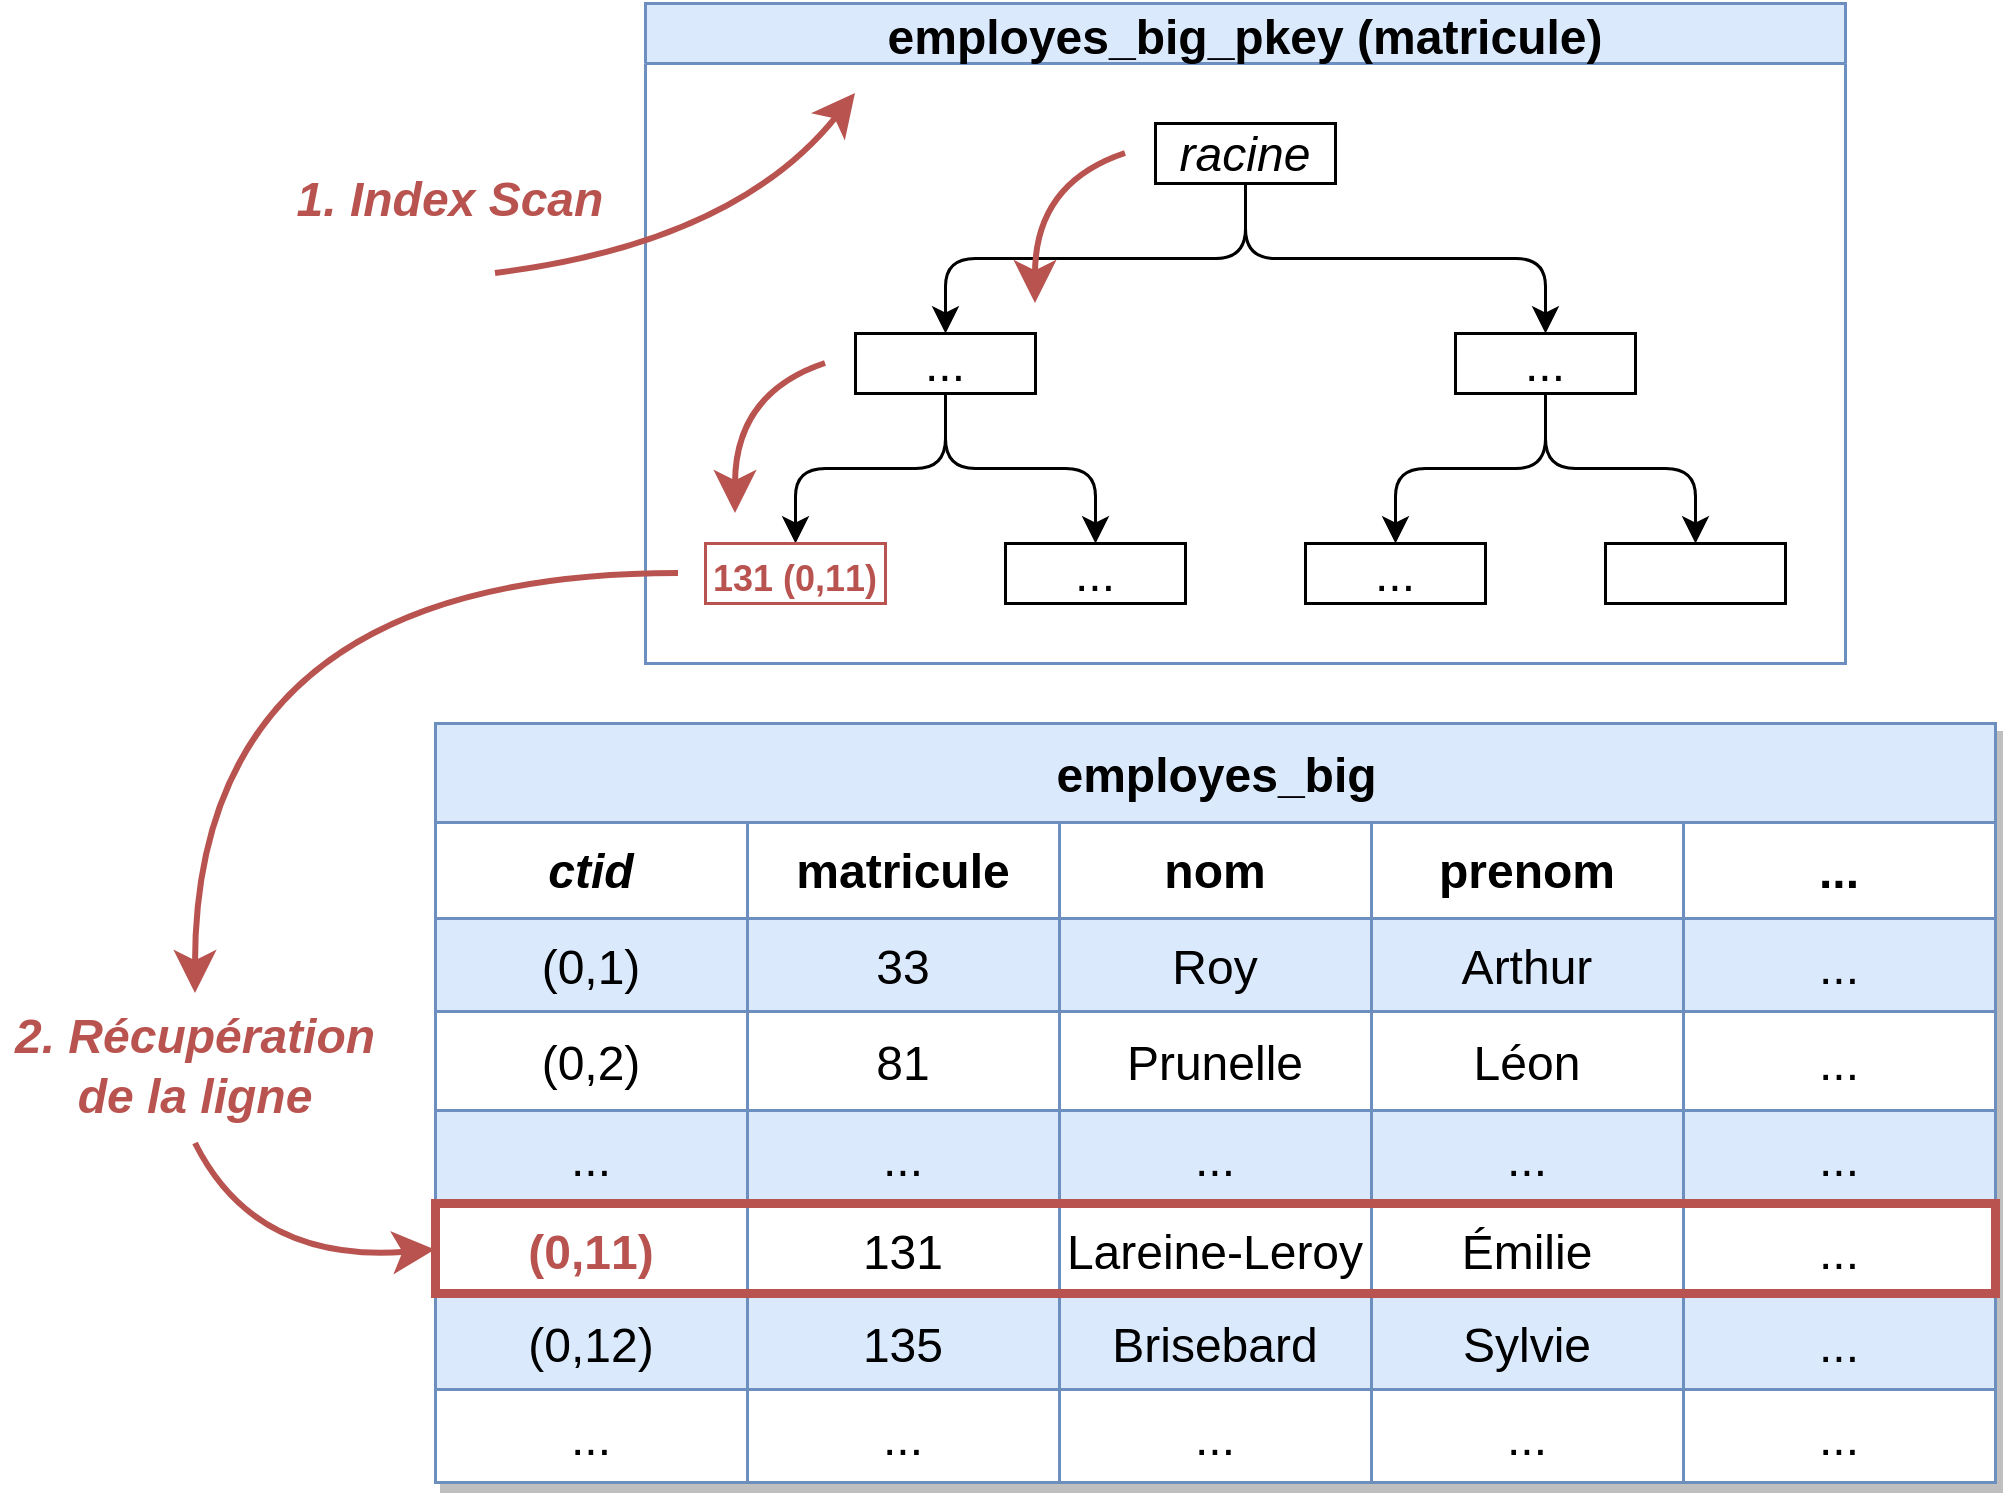
Ce type de nœud ne permet pas d’extraire directement les données à retourner depuis l’index, sans passer par la lecture des blocs correspondants de la table.
Dans ce cas, une seule recherche a été effectuée. Mais dans certains cas, plusieurs parcours de l’index sont nécessaires. En voici un exemple :
La fonction generate_series() a généré toutes les valeurs comprises entre 20 et 30 et chacune de ces valeurs a impliqué une recherche dans l’index, soit 11 recherches en tout comme l’indique la ligne Index Searches (affichée seulement depuis la version 18).
Index Only Scan : principe
Index Only Scan : utilité & limites
Très performant
Besoin d’un VACUUM récent
sinon trop de Heap Fetches
Ne fonctionne pas pour les index fonctionnels
ajouter une colonne générée?
Utilité : Le nœud Index Only Scan est une version plus performante de l’Index Scan. Il est choisi si toutes les colonnes de la table concernées par la requête font partie de l’index :
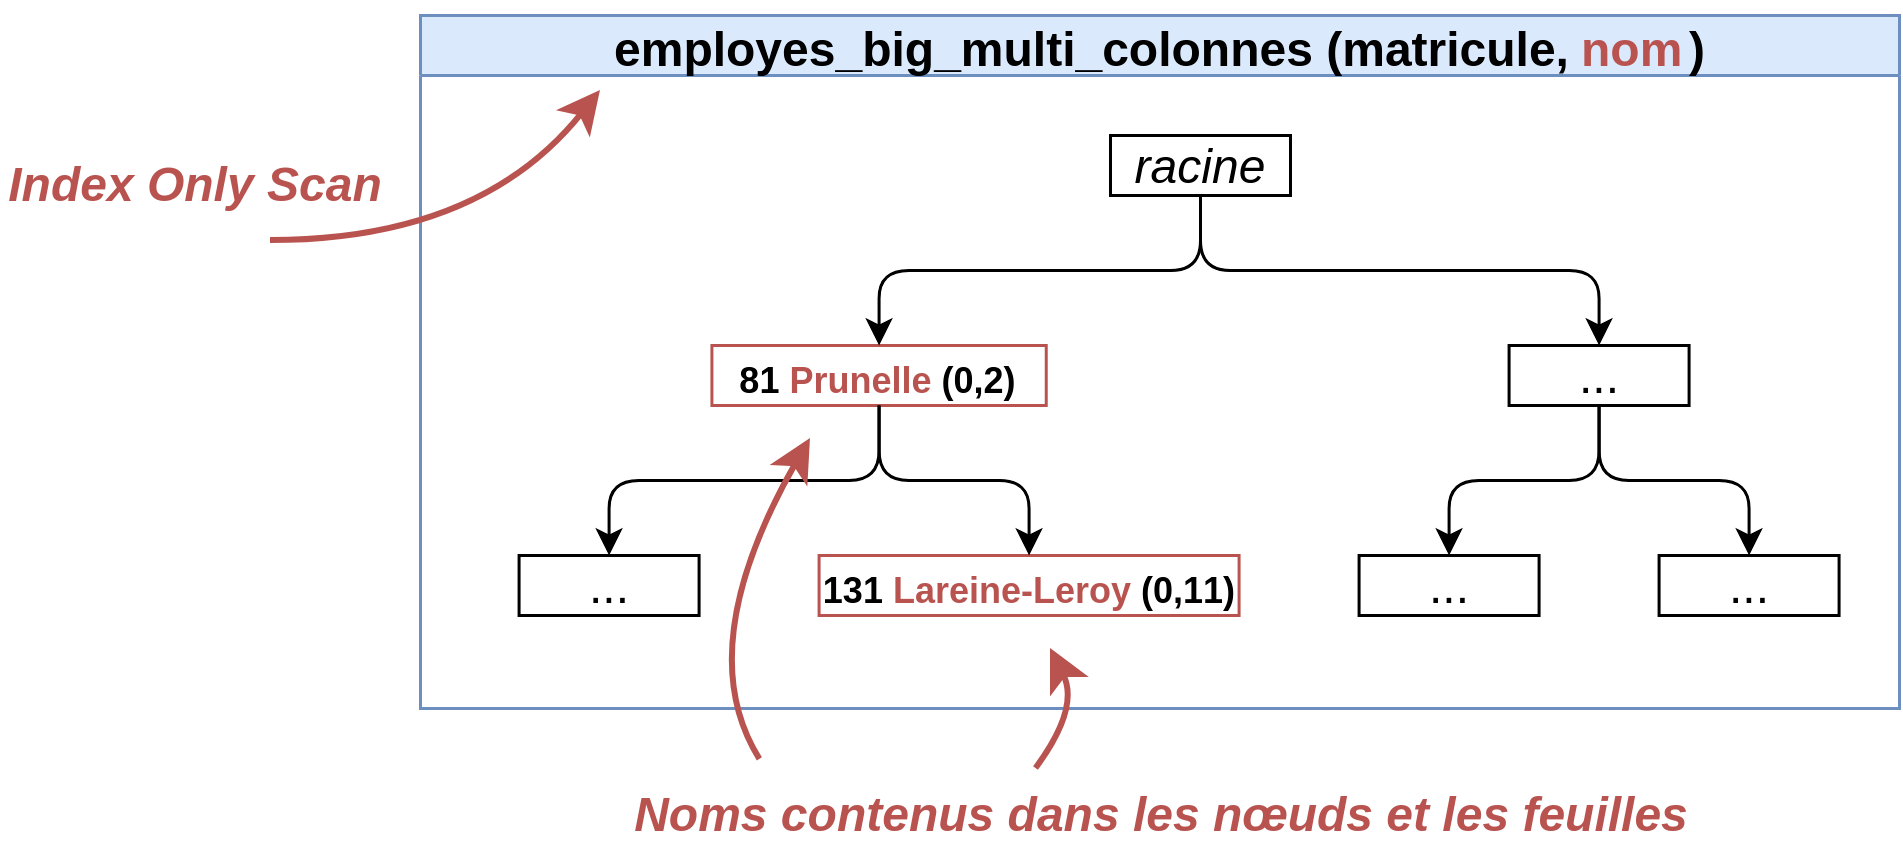
Il n’y a donc plus besoin d’accéder à la table et l’on économise de nombreux accès disque. C’est d’autant plus appréciable que les lignes sont nombreuses. Par contre, si l’on ajoute le champ nom dans la requête, l’optimiseur se rabat sur un Index Scan. En effet, nom ne peut être lu que dans la table puisqu’il ne fait pas partie de l’index. Dans notre exemple avec de petites tables, le temps reste correct mais il est moins bon :
Noter le nombre de blocs lus beaucoup plus important. Index couvrants : Il existe des index dits « couvrants », destinés à favoriser des Index Only Scans. Ils peuvent contenir des données en plus des champs indexés, même avec un index unique comme ici.
Cet index contient aussi nom et permet de revenir à de très bonnes performances :
L’expérience montre qu’un index classique multicolonnes sur (matricule,nom) sera b aussi efficace, voire plus, qu’un index sur (matricule) INCLUDE (nom) . En effet, l’index sans INCLUDE peut être plus petit (la clause INCLUDE inhibe la déduplication des valeurs dans l’index). La clause INCLUDE reste utile pour transformer en index couvrant un index de clé primaire, unique ou étrangère et économiser la création d’un index.
Conditions pour obtenir un Index Only Scan :
- Toutes les colonnes de la table utilisées par la requête doivent figurer dans l’index, aussi bien
celles retournées que celles servant aux calculs ou au filtrage. En pratique, cela réserve l’Index Only Scan au cas où peu de colonnes de la table sont concernées par la requête.
- Il est courant d’ajouter des index dédiés aux requêtes critiques n’utilisant que quelques colonnes. Mais plus le nombre de colonnes et la taille de l’index augmentent, moins PostgreSQL
sera tenté par l’Index Only Scan.
- Pour que l’Index Only Scan soit réellement efficace, il faut que la table soit fréquemment traitée
par des opérations VACUUM . En effet, les informations de visibilité des lignes ne sont pas stockées dans l’index. Pour savoir si la ligne trouvée dans l’index est visible ou pas par la session, il faut soit aller vérifier dans la table (et on en revient à un Index Scan), soit aller voir dans la visibility map de la table que le bloc ne contient pas de lignes potentiellement mortes, ce qui est beaucoup plus rapide. Le choix se fait à l’éxécution pour chaque ligne. Dans l’idéal, le plan indique qu’il n’y a jamais eu à aller dans la table (heap) ainsi : Heap Fetches: 0
S’il y a un trop grand nombre de Heap Fetches, l’Index Only Scan perd tout son intérêt. Il peut suffire de rendre l’ autovacuum beaucoup plus agressif sur la table. Limite pour les index fonctionnels : Le planificateur a du mal à définir un Index Only Scan pour un index fonctionnel. Il échoue par exemple ici :
L’index fonctionnel est bien utilisé mais ce n’est pas un Index Only Scan. Dans certains cas critiques, il peut être intéressant de créer une colonne générée reprenant la fonction et de créer un index dessus, qui permettra un Index Only Scan :
La nouvelle colonne générée est bien sûr maintenue automatiquement si nom change et n’est pas modifiable directement. Mais sa création entraîne la réécriture de la table, qui d’ailleurs grossit un peu, et il faut adapter le code.
Bitmap Scan
Ce dernier parcours est particulièrement efficace pour des opérations de type Range Scan, c’est-àdire où PostgreSQL doit retourner une plage de valeurs, ou pour combiner le résultat de la lecture de plusieurs index. Contrairement à d’autres SGBD, un index bitmap de PostgreSQL n’a aucune existence sur disque : il est créé en mémoire lorsque son utilisation a un intérêt. Le but est de diminuer les déplacements de
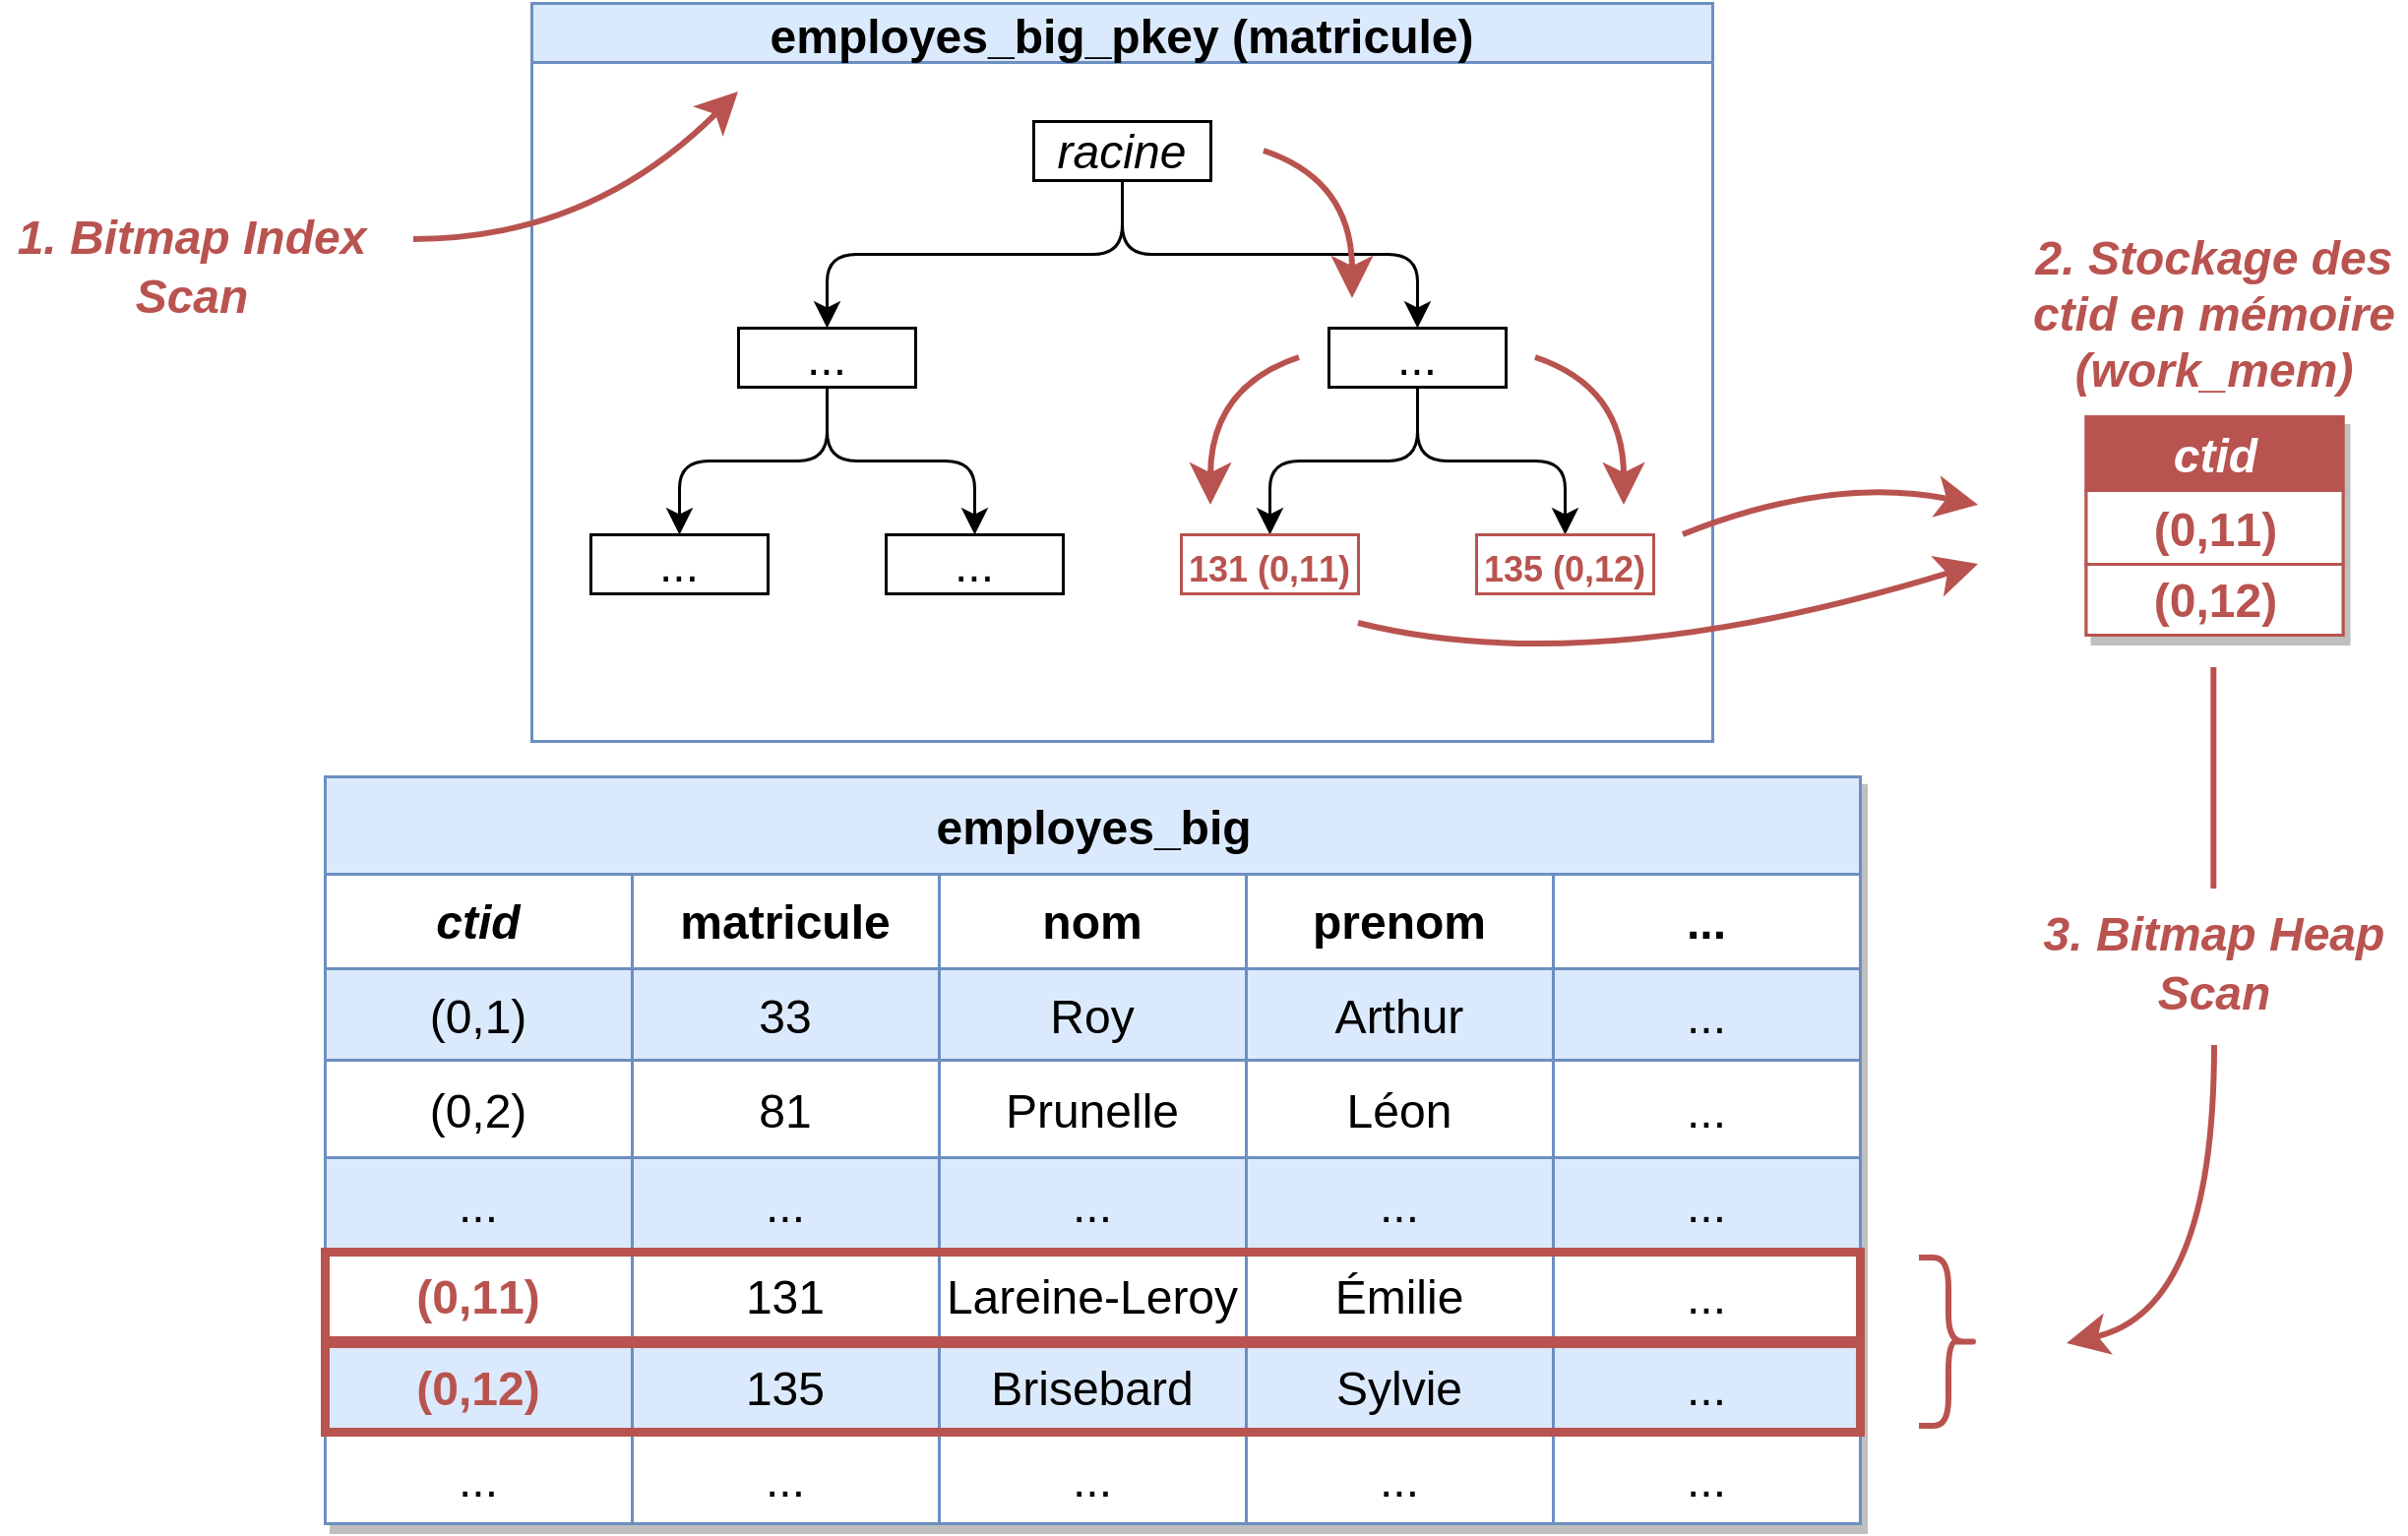
la tête de lecture en découplant le parcours de l’index du parcours de la table :
lecture en un bloc de l’index;
lecture en un bloc de la partie intéressante de la table (dans l’ordre physique de la table, pas
dans l’ordre logique de l’index).
Exemple de combinaison du résultat de la lecture de plusieurs index :
Parcours d’index : paramètres importants
random_page_cost (4 ou moins?)
cpu_index_tuple_cost
effective_cache_size (⅔ de la RAM?)
Selon le disque :
effective_io_concurrency
maintenance_io_concurrency
min_parallel_index_scan_size
enable_indexscan , enable_indexonlyscan , enable_bitmapscan
L’Index Scan n’a d’intérêt que s’il y a très peu de lignes à récupérer, surtout si les disques sont mécaniques. Il faut donc que le filtre soit très sélectif. Le rapport entre les paramètres seq_page_cost et random_page_cost est d’importance majeure dans le choix face à un Seq Scan. Plus il est proche de 1, plus les parcours d’index seront favorisés par rapport aux parcours de table.
Il n’y a pas de paramètre dédié à ce parcours. S’il est possible, l’optimiseur le préfère à un Index Scan.
effective_io_concurrency a pour but d’indiquer le nombre d’opérations disques possibles en même temps pour un client (prefetch). Il n’a d’intérêt que si un nœud Bitmap Scan a été choisi. Cela n’arrive qu’avec un certain nombre de lignes à récupérer, et est favorisé par une valeur importante de effective_cache_size et un peu de corrélation physique dans la table. La valeur d’ effective_io_concurrency n’influe pas sur le choix du plan, mais sa valeur peut notablement accélérer l’exécution du Bitmap Heap Scan. Le temps de lecture peut fréquemment être divisé par 3 ou plus. Les valeurs possibles d’ effective_io_concurrency vont de 0 à 1000. En principe, sur un disque magnétique seul, la valeur 1 ou 0 peut convenir. Avec du SSD, et encore plus du NVMe, il est possible de monter à plusieurs centaines, étant donné la rapidité de ce type de disque. Trouver la bonne valeur dépend de divers paramètres liés aux caractérisques exactes des disques et de leur paramétrage noyau. Le read ahead du noyau intervient également. Le comportement de PostgreSQL sur ce point change aussi avec les versions. De plus, à partir d’un certain nombre de blocs, les I/O peuvent simplement saturer. La valeur par défaut de 1 (jusque PostgreSQL 17) a été choisie de manière très conservatrice. Les développeurs ont décidé 6 que la valeur 16 est plus intéressante, même sur de vieux disques, et que ce 6 https://www.postgresql.org/message-id/flat/CAAKRu_Z%2BJa-mwXebOoOERMMUMvJeRhzTjad4dSThxG0JLXESxw%40mail.gmail.com#c028f5b93307aafb9fe6d09d0cf3eeae
sera le défaut à partir de PostgreSQL 18 7 , qui inclut d’autres améliorations. À l’inverse, la mauvaise latence de certains systèmes aux disques en principe performants (baies surchargées, certains stockages cloud…) peut parfois être compensée par un effective_io_concurrency plus élevé.
Il faut tester avec vos requêtes qui utilisent des Bitmap Heap Scan, et tenir compte du b nombre de requêtes simultanées, mais effective_io_concurrency = 16 semble un bon point de départ, même sur une configuration modeste. Montez si vous avez de bons disques.
Une valeur excessive de effective_io_concurrency mène à un gaspillage de CPU : ne pas monter trop haut sans preuve de l’utilité, surtout sur un système très chargé.
Pour les systèmes RAID matériels, selon la documentation 8 , configurer ce paramètre en fonction du nombre n de disques utiles dans le RAID (n/2 s’il s’agit d’un RAID 1, n-1 s’il s’agit d’un RAID 5 ou 6, n/2 s’il s’agit d’un RAID 10). (Avant la version 13, le principe d’ effective_io_concurrency était le même, mais la valeur exacte de ce paramètre devait être 2 à 5 fois plus basse comme le précise la formule des notes de version de la version 13 9 .) Le paramètre maintenance_io_concurrency a le même but que effective_io_concurrency , mais pour les opérations de maintenance, non les requêtes. Celles-ci peuvent ainsi se voir accorder plus de ressources qu’une simple requête. Sa valeur par défaut est de 10, et il faut penser à le monter aussi si on adapte effective_io_concurrency .
Enfin, le paramètre effective_cache_size indique à PostgreSQL une estimation de la taille du cache disque du système (total du shared buffers et du cache du système). Une bonne pratique est de positionner ce paramètre à ⅔ de la quantité totale de RAM du serveur. Sur un système Linux, il est possible de donner une estimation plus précise en s’appuyant sur la valeur de colonne cached de la commande free . Mais si le cache n’est que peu utilisé, la valeur trouvée peut être trop basse pour pleinement favoriser l’utilisation des Bitmap Index Scan. Parallélisation Il est possible de paralléliser les parcours d’index. Cela donne donc les nœuds Parallel Index Scan, Parallel Index Only Scan et Parallel Bitmap Heap Scan. Cette infrastructure est actuellement uniquement utilisée pour les index B-Tree. Par contre, pour le Bitmap Scan, seul le parcours de la table est parallélisé. Un parcours parallélisé d’un index n’est considéré qu’à partir du moment où l’index a une taille supérieure à la valeur du paramètre min_parallel_index_scan_size (512 ko par défaut). 7 https://git.postgresql.org/gitweb/?p=postgresql.git;a=commit;h=ff79b5b2aba02d720f9b7fff644dd50ce07b8c6e 8 https://docs.postgresql.fr/current/runtime-config-resource.html#GUC-EFFECTIVE-IO-CONCURRENCY 9 https://docs.postgresql.fr/13/release.html
Autres parcours
Function Scan
Values Scan
…et d’autres
On retrouve le nœud Function Scan lorsqu’une requête utilise directement le résultat d’une fonction, comme par exemple, dans des fonctions d’informations système de PostgreSQL :
Il existe d’autres types de parcours, rarement rencontrés. Ils sont néanmoins détaillés en annexe 10 .
Nœuds de jointure
PostgreSQL implémente les 3 algorithmes de jointures habituels
Nested Loop : boucle imbriquée
Hash Join : hachage de la table interne
Merge Join : tri-fusion
Parallélisation
Pour EXISTS , IN et certaines jointures externes
Hash Semi Join & Hash Anti Join
Paramètres :
work_mem ( et hash_mem_multiplier )
seq_page_cost & random_page_cost .
enable_nestloop , enable_hashjoin , enable_mergejoin
Le choix du type de jointure dépend non seulement des données mises en œuvre, mais elle dépend également beaucoup du paramétrage de PostgreSQL, notamment des paramètres work_mem , hash_mem_multiplier , seq_page_cost et random_page_cost .
La Nested Loop se retrouve principalement dans les jointures de petits ensembles de données. Pour chaque ligne de l’ensemble « externe » (à gauche, le plus grand des deux ensembles normalement), l’autre ensemble (« interne ») est lu, par un Seq Scan, Index Scan, etc. 10 https://dali.bo/j6_html
Dans l’exemple suivant, le critère sur services ramène très peu de lignes, il ne coûte pas grand-chose d’aller piocher à chaque fois dans l’index de employes_big .
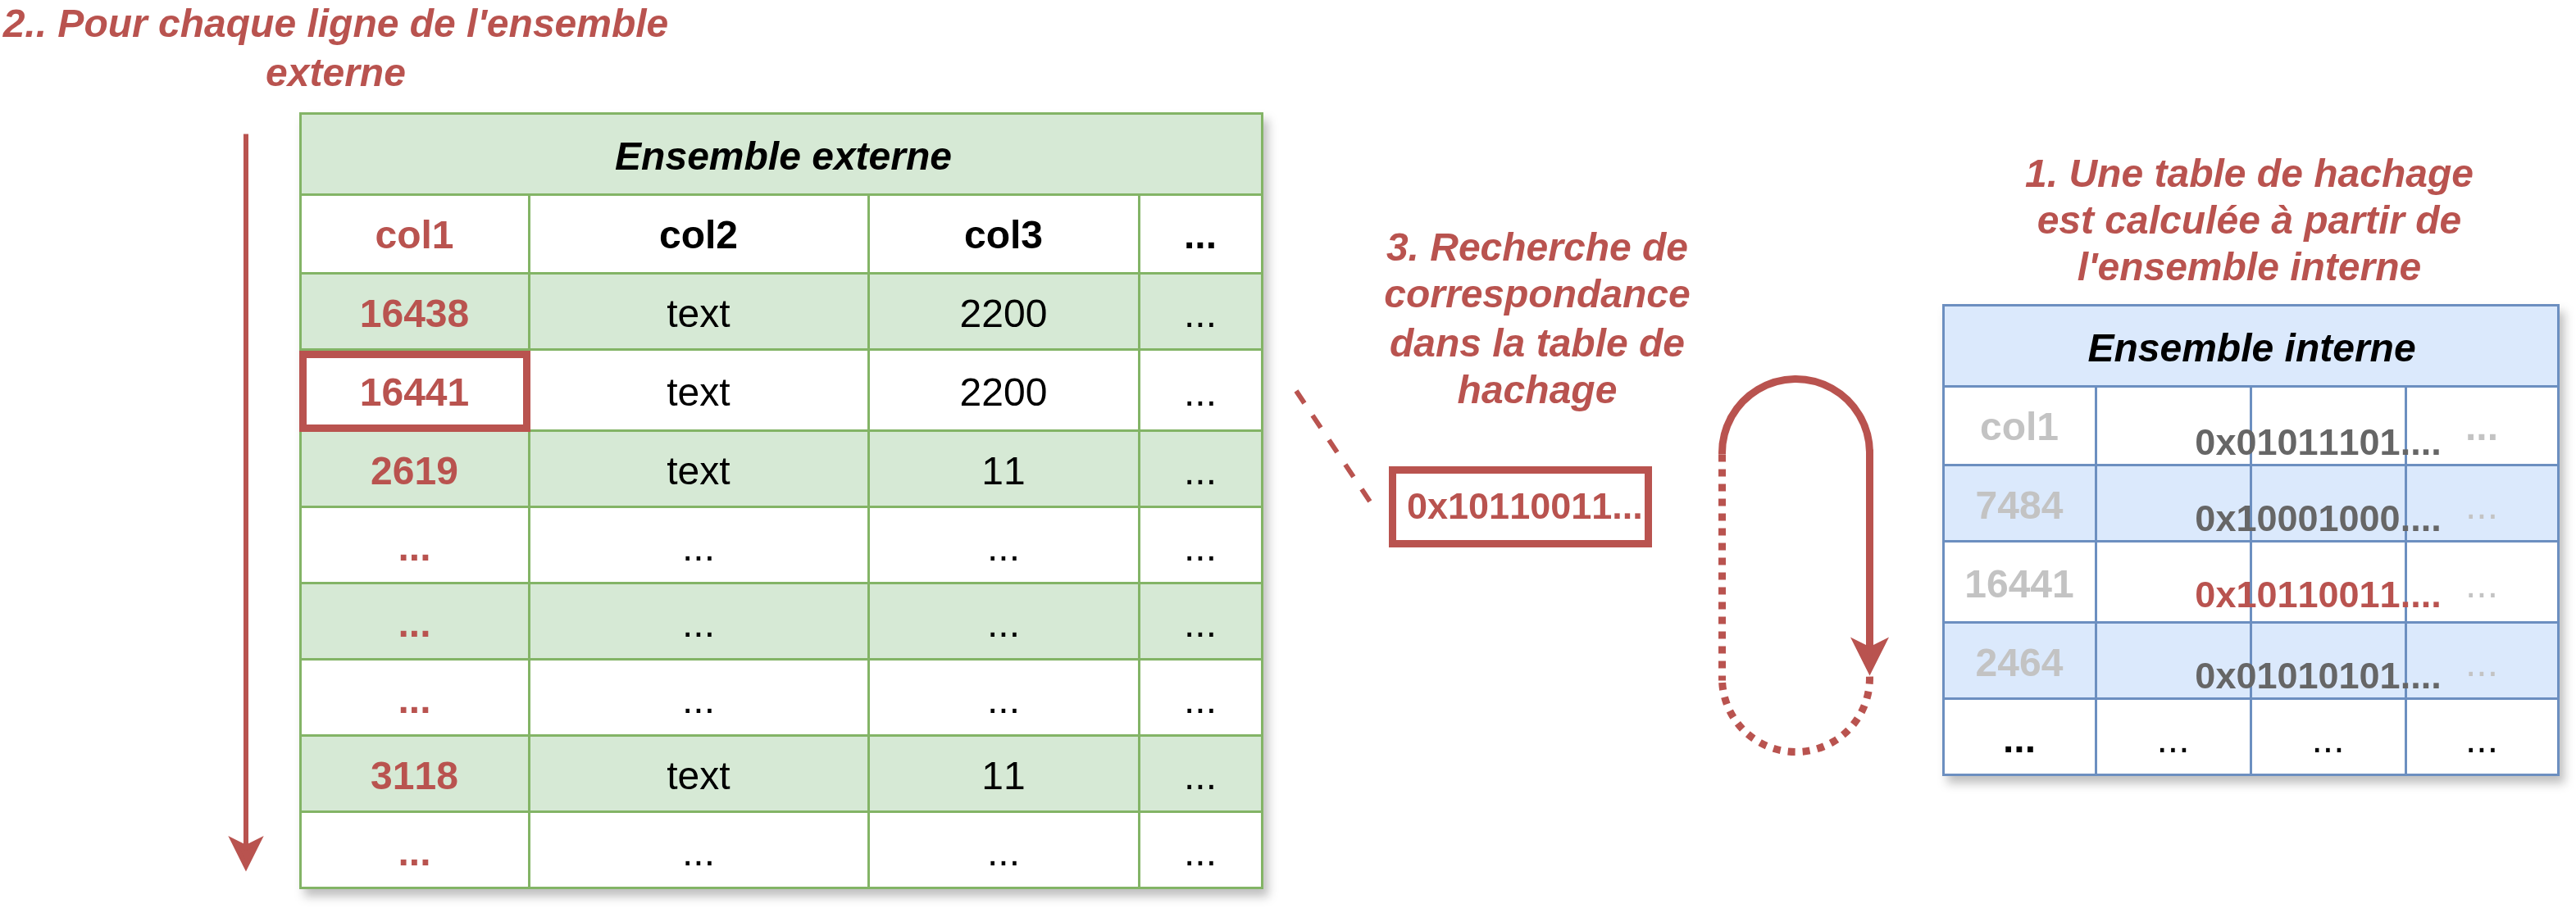
Le Hash Join se retrouve lorsque l’ensemble de la table interne est petit. L’optimiseur construit alors une table de hachage avec les valeurs de la ou les colonne(s) de jointure de la table interne. Il réalise ensuite un parcours de la table externe, et, pour chaque ligne de celle-ci, recherche des lignes correspondantes dans la table de hachage, toujours en utilisant la ou les colonne(s) de jointure comme clé. C’est très efficace mais le coût de démarrage est lent.
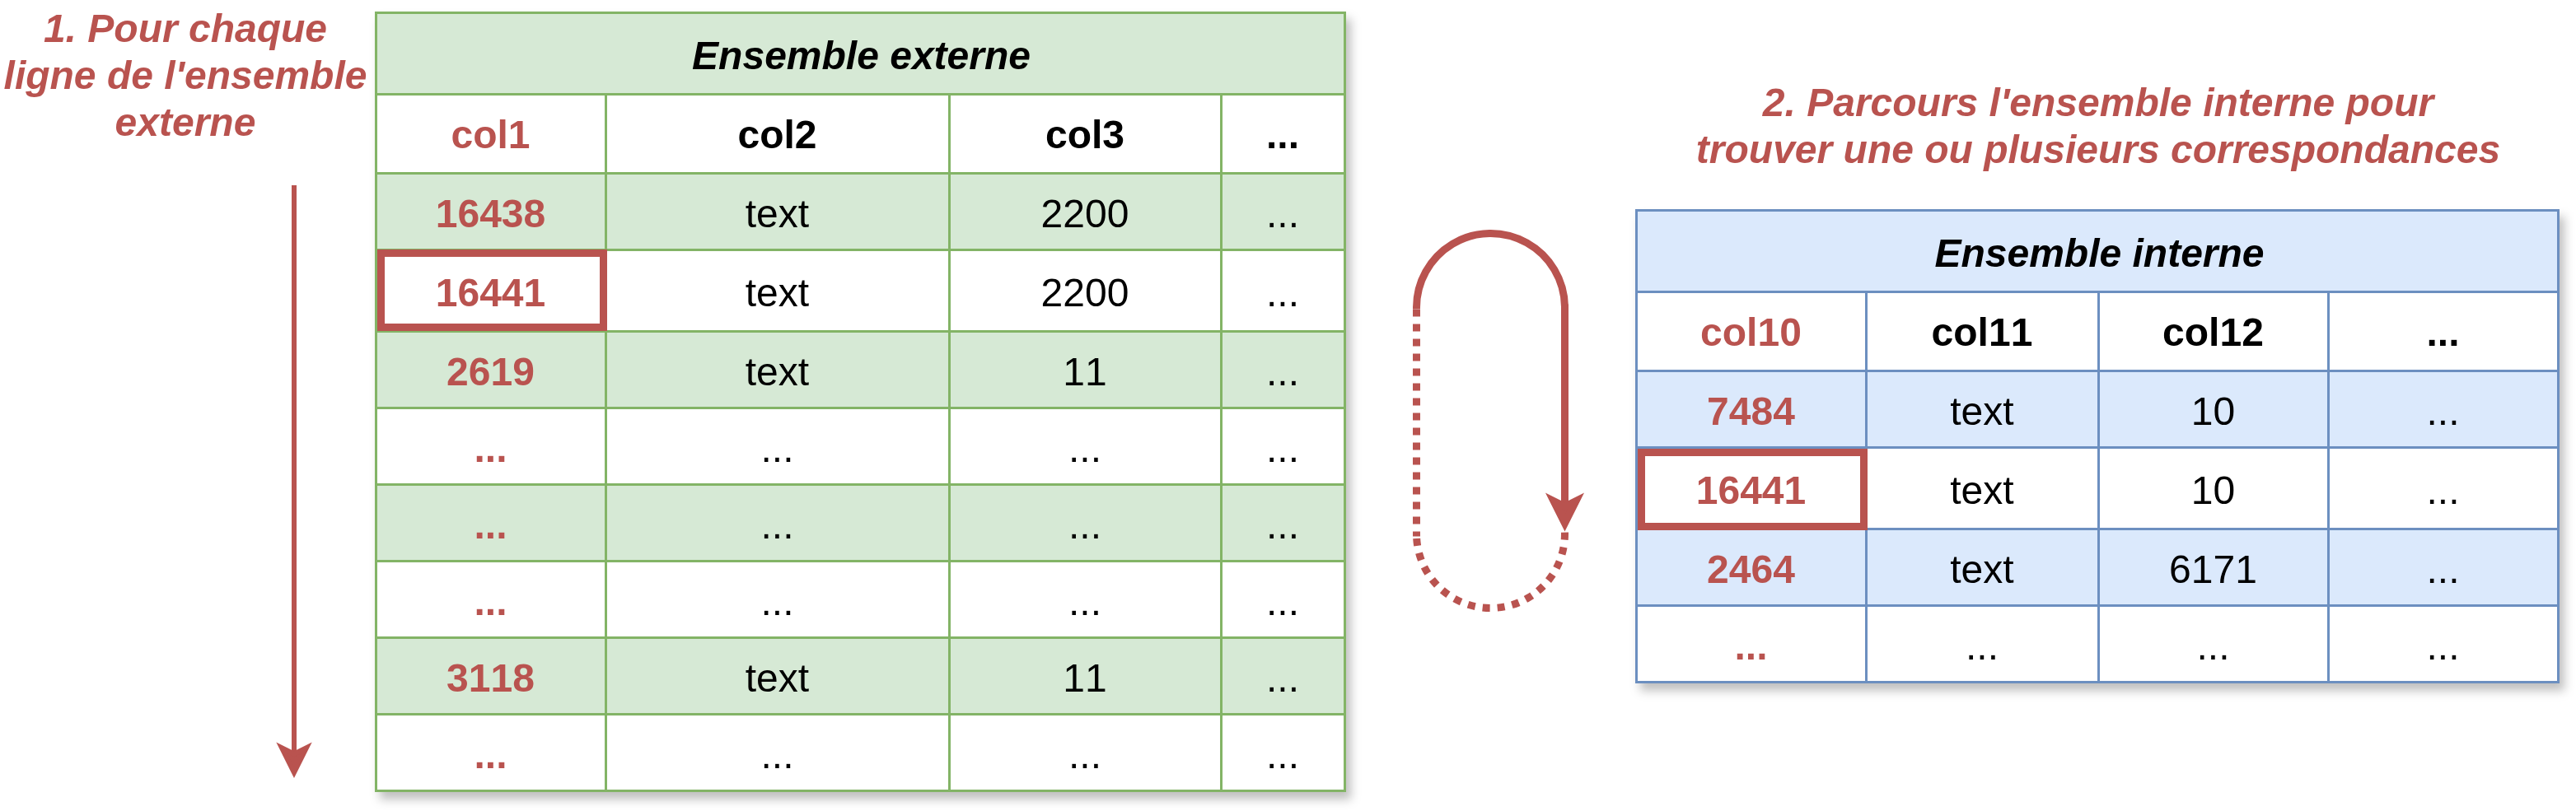
Cette opération réclame de la mémoire de tri, visible avec EXPLAIN (ANALYZE) (dans le pire des cas, ce sera un fichier temporaire).
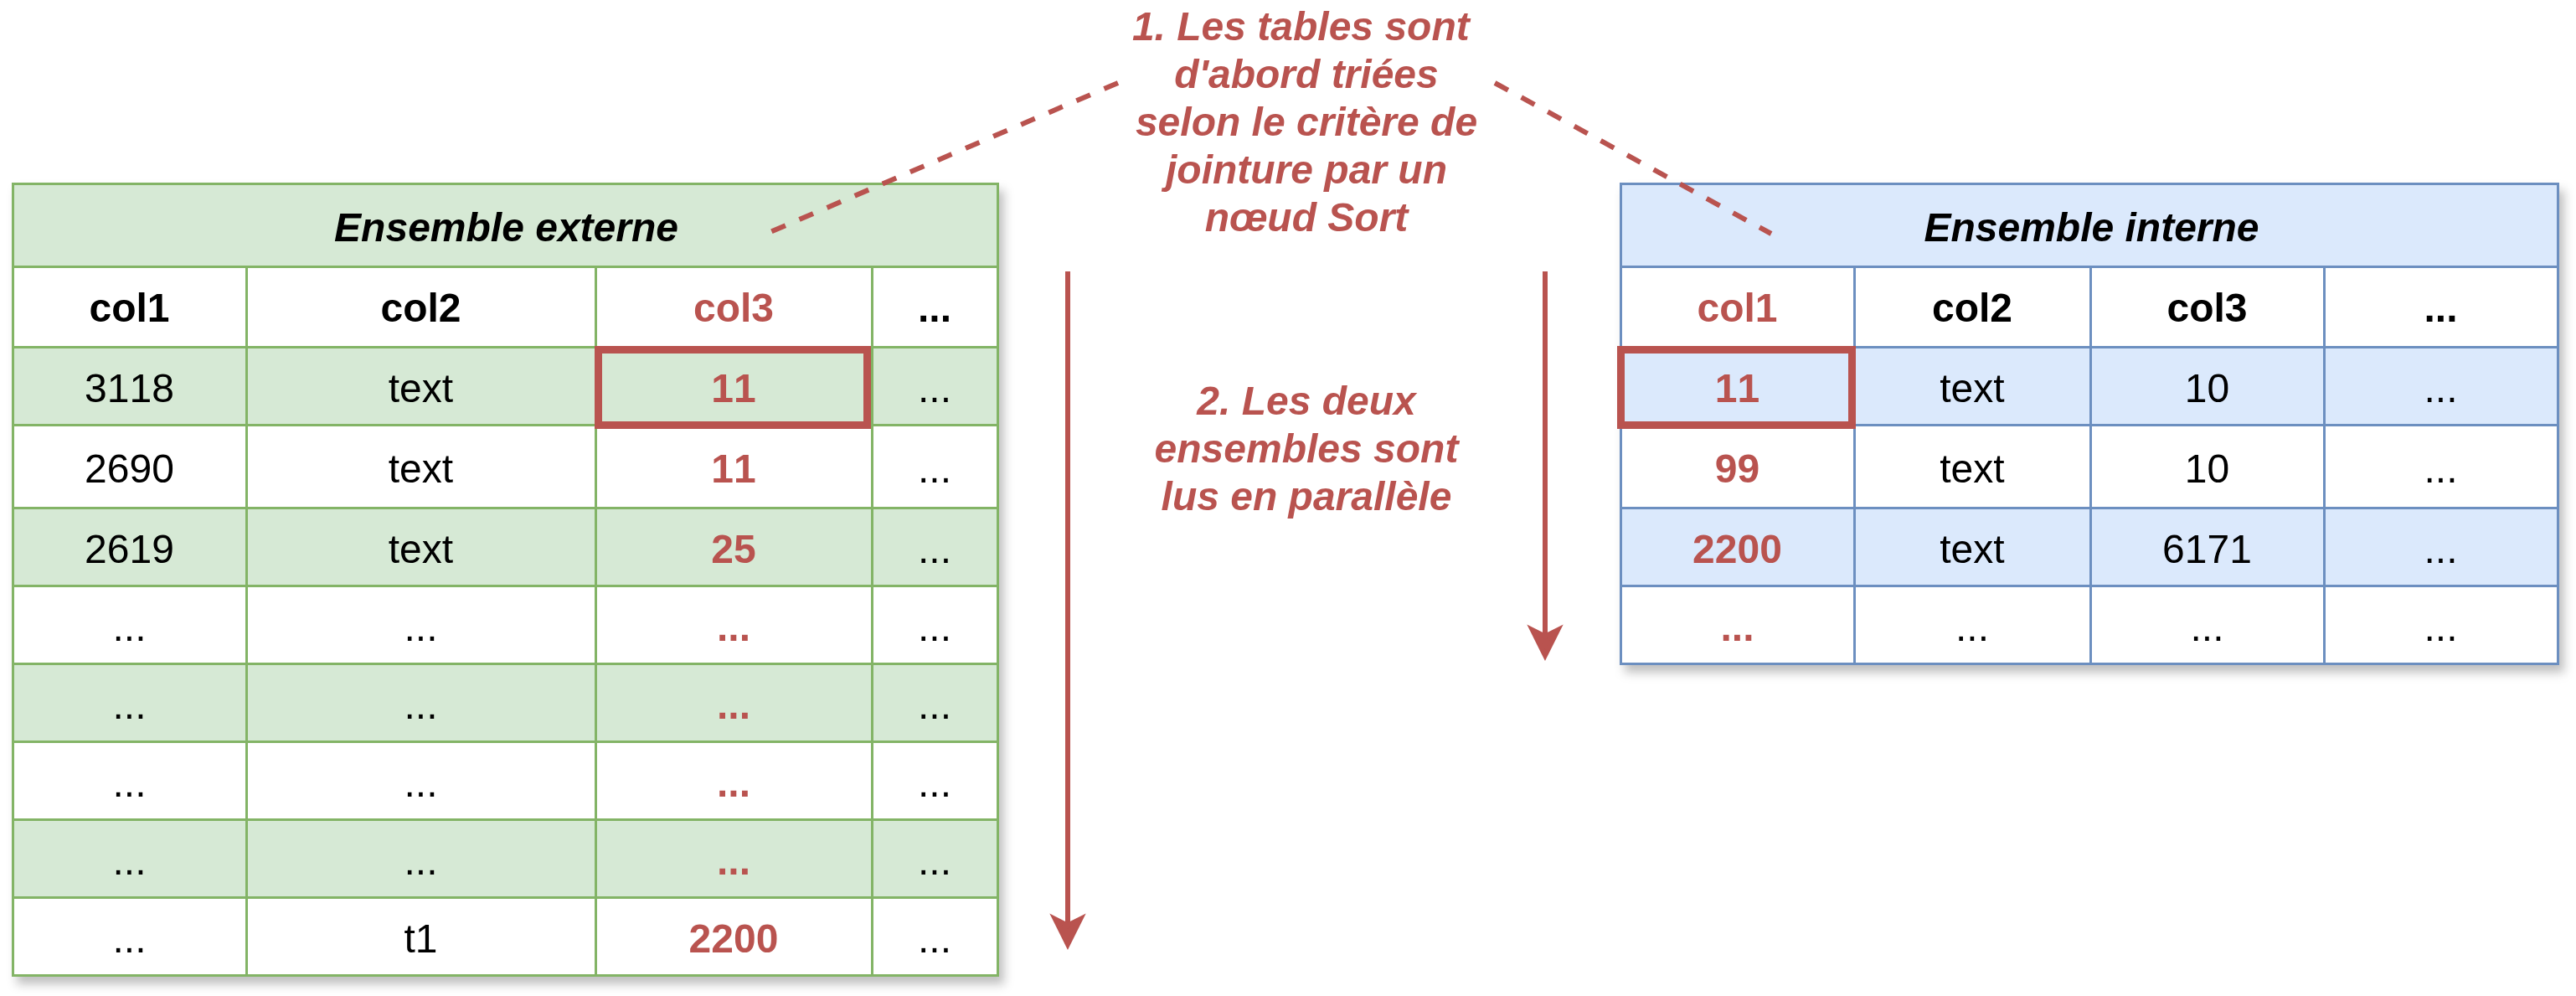
La jointure par tri-fusion, ou Merge Join, prend deux ensembles de données triés en entrée, les partcourt parallèlement, et restitue l’ensemble de données après jointure. Cette jointure est assez lourde à initialiser si PostgreSQL ne peut pas utiliser d’index, sinon elle est très efficace. Elle a l’avantage de retourner les données triées directement :
Il s’agit d’un algorithme de jointure particulièrement efficace pour traiter les volumes de données importants, surtout si les données sont pré-triées grâce à l’existence d’un index.
Les clauses EXISTS et NOT EXISTS mettent également en œuvre des algorithmes dérivés de semi et anti-jointures. En voici un exemple avec la clause EXISTS :
Un plan sensiblement identique s’obtient avec NOT EXISTS . Le nœud Hash Semi Join est remplacé par Hash Anti Join :
Ces nœuds sont parallélisables. Pour les Parallel Hash Join, la table hachée est même commune pour les différents workers 11 , et le calcul de celle-ci est réparti sur ceux-ci. Par contraste, pour les nœuds
terne peut être parallélisé, tandis que la table interne est parcourue (voire hachée) entièrement par chaque worker. Exemple (testé en version 18.3) :
11 https://write-skew.blogspot.com/2018/01/parallel-hash-for-postgresql.html
Dans ce plan, la table externe foo est lue de manière parallélisée, les trois processus se partageant son contenu. Chacun a sa version de la toute petite table interne bar , qui est hachée trois fois (les deux workers et le processus principal lisent les 100 lignes). Si bar est beaucoup plus grosse que foo , le plan bascule sur un Parallel Hash Join dont bar est cette fois la table externe :
Le Hash de foo se fait par deux processus qui ne traitent cette fois que la moitié du million de lignes, en en filtrant les ⅔ (la dernière ligne indique quasiment le tiers de 500 000). Le coût de démarrage de ce hash parallélisé est cependant assez lourd (la jointure ne commence qu’après 66 ms). Pour la même requête, PostgreSQL 10, qui ne connaît pas le Parallel Hash Join, procédait à un Hash Join classique et prenait 50 % plus longtemps. Précisons encore qu’augmenter work_mem ne change pas le plan, mais permet cas d’accélérer un peu les hachages (réduction du nombre de batches).
Nœuds de tris et de regroupements
Deux nœuds de tri :
Sort
Incremental Sort
Regroupement/agrégation :
Aggregate
Hash Aggregate
Group Aggregate
Mixed Aggregate
Partial/Finalize Aggregate
Paramètres :
enable_hashagg
work_mem & hash_mem_multiplier
Pour réaliser un tri, PostgreSQL dispose de deux nœuds : Sort et Incremental Sort. Leur efficacité va dépendre du paramètre work_mem qui va définir la quantité de mémoire que PostgreSQL pourra utiliser pour un tri.
Sort :
Si le tri ne tient pas en mémoire, l’algorithme de tri gère automatiquement le débordement sur disque (26 Mo ici) :
Cependant, un tri est coûteux. Donc si un index existe sur le champ de tri, PostgreSQL aura tendance à l’utiliser. Les données sont déjà triées dans l’index, il suffit de le parcourir pour lire les lignes dans l’ordre :
Et ce, dans n’importe quel ordre de tri :
Le choix du type d’opération de regroupement dépend non seulement des données mises en œuvres, mais elle dépend également beaucoup du paramétrage de PostgreSQL, notamment du paramètre work_mem .
Comme vu précédemment, PostgreSQL sait utiliser un index pour trier les données. Cependant, dans certains cas, il ne sait pas utiliser l’index alors qu’il pourrait le faire. Prenons un exemple.
Voici un jeu de données contenant une table à trois colonnes, et un index sur une colonne :
PostgreSQL sait utiliser l’index pour trier les données. Par exemple, voici le plan d’exécution pour un tri sur la colonne c2 (colonne indexée au niveau de l’index t1_c2_idx ) :
Incremental Sort :
Quand le tri se fait sur deux colonnes, et qu’il n’y a un index que sur la première, PostgreSQL sait utiliser l’index pour faire un premier tri des données (sur la colonne c2 d’après notre exemple), puis trier les données du résultat par rapport à la colonne c3 :
On remarque un nouveau type de nœud : Incremental Sort, qui s’occupe de re-trier les données après un renvoi de données triées, grâce au parcours d’index. Le plan distingue bien la clé déjà triée ( c2 ) et celles à trier ( c2, c3 ). L’apport en performance est déjà très intéressant, mais il devient remarquable si on utilise une clause LIMIT .
En version 16, l’Incremental Sort peut aussi servir à accélérer les DISTINCT :
Cela devrait accélérer de nombreuses requêtes qui possèdent abusivement une clause DISTINCT ajoutée par un ETL, si le premier champ du DISTINCT est par chance indexé, comme ici :
Concernant les opérations d’agrégations, on retrouve un nœud de type Aggregate lorsque la requête réalise une opération d’agrégation simple, sans regroupement :
Si l’optimiseur estime que l’opération d’agrégation tient en mémoire (paramètre work_mem ), il va utiliser un nœud de type HashAggregate :
Avant la version 13, l’inconvénient de ce nœud était que sa consommation mémoire n’était pas limitée par work_mem , il continuait malgré tout à allouer de la mémoire. Dans certains cas, heureusement très rares, l’optimiseur pouvait se tromper suffisamment pour qu’un nœud HashAggregate consomme plusieurs gigaoctets de mémoire et sature ainsi la mémoire du serveur. La version 13 a corrigé cela en utilisant le disque à partir du moment où la mémoire nécessaire dépasse la multiplication de la valeur du paramètre work_mem et celle du paramètre hash_mem_multiplier (2 par défaut à partir de la version 15, 1 auparavant). La requête est plus lente, mais la mémoire n’est pas pas saturée. Group Aggregate : Lorsque l’optimiseur estime que le volume de données à traiter ne tient pas dans work_mem ou quand il peut accéder aux données pré-triées, il utilise plutôt l’algorithme GroupAggregate :
Mixed Aggregate : Le Mixed Aggregate est très efficace pour les clauses GROUP BY GROUPING SETS ou GROUP BY CUBE grâce à l’utilisation de hashs :
Comparer avec le plan et le temps obtenus auparavant, que l’on peut retrouver avec SET enable_hashagg TO off; . Le calcul d’un agrégat peut être parallélisé. Dans ce cas, deux nœuds sont utilisés : un pour le calcul partiel de chaque processus (Partial Aggregate), et un pour le calcul final (Finalize Aggregate). Voici un exemple de plan :
Les autres nœuds
Limit
Unique ( DISTINCT )
Append ( UNION ALL ), Except, Intersect
Gather (parallélisme)
InitPlan, Subplan, etc.
Memoize (14+)
Le nœud Sort utilisera dans ce cas une méthode de tri appelée top-N heapsort qui permet d’optimiser le tri pour retourner les n premières lignes :
Les nœuds Append, Except et Intersect se rencontrent avec les opérateurs ensemblistes UNION , EXCEPT et INTERSECT . Par exemple, avec UNION ALL :
Le nœud InitPlan apparaît lorsque PostgreSQL a besoin d’exécuter une première sous-requête pour ensuite exécuter le reste de la requête. Il est assez rare :
SubPlan : Le nœud SubPlan est utilisé lorsque PostgreSQL a besoin d’exécuter une sous-requête pour filtrer les données :
Le nœud Gather n’apparaît que s’il y a du parallélisme. Il est utilisé comme nœud de rassemblement des données.
Le nœud Memoize est un cache de résultat qui permet d’optimiser les performances d’autres nœuds en mémorisant des données qui risquent d’être accédées plusieurs fois de suite. Pour le moment, ce nœud n’est utilisable que pour les données de l’ensemble interne d’un Nested Loop. D’autres types de nœuds peuvent également être trouvés dans les plans d’exécution. L’annexe décrit tous ces nœuds en détail.
Problèmes les plus courants
L’optimiseur se trompe parfois
mauvaises statistiques
écriture particulière de la requête
problèmes connus de l’optimiseur
L’optimiseur de PostgreSQL est sans doute la partie la plus complexe de PostgreSQL. Il se trompe rarement, mais certains facteurs peuvent entraîner des temps d’exécution très lents, voire catastrophiques de certaines requêtes. Les statistiques sur les données doivent être suffisamment récentes. Celles calculées par défaut portent sur un échantillon de chaque colonne séparément et c’est parfois insuffisant. Sur ce sujet, voir le module M6 - Statistiques pour le planificateur 12 .
La jointure de trop
PostgreSQL choisit l’ordre des jointures
uniquement pour les X premières tables
où X = join_collapse_limit (défaut : 8)
Les jointures supplémentaires sont ajoutées après
… souvent plans non optimaux
-> augmenter join_collapse_limit si nécessaire (12-15)
ainsi que from_collapse_limit
… attention au CPU
Algorithme GEQO ( geqo_threshold = 12 jointures)
7.8.1.1 join_collapse_limit et from_collapse_limit
En principe, le planificateur ne tient pas compte de l’ordre des tables dans la clause FROM et peut décider de commencer la requête par n’importe laquelle. Cependant, la complexité des plans d’exécution à étudier explose avec le nombre de tables et de combinaisons de jointures. À partir d’un certain nombre de tables, PostgreSQL n’en prend en compte qu’un certain nombre, et calcule un plan juste pour elles. Les tables suivantes sont jointes au premier résultat dans un deuxième temps. Le paramètre join_collapse_limit définit ce nombre de tables prises en compte dans le FROM (vision simplifiée). Par défaut, il ne vaut que 8. 12 https://dali.bo/m6_html
Si le critère de filtrage le plus utile est sur la neuvième table, au-delà donc du premier
ensemble de tables considérées, l’optimiseur n’en tiendra pas compte, et le plan peut
être catastrophique!
Il existe un paramètre très voisin, from_collapse_limit , qui définit à quelle profondeur « aplatir » les sous-requêtes, c’est-à-dire remonter les tables depuis une sous-requête dans le FROM , tant qu’on ne pas dépasse pas cette valeur. On le monte habituellement à la même valeur que join_collapse_limit , et vice-versa.
Exemple : Comme exemple de plan désastreux, à cause d’un critère de filtrage sur une table non prise en compte, voir ce plan 13 . La requête est celle-ci (base magasin 14 ) :
Le critère final (sur contacts.login ) est beaucoup plus discriminant que celui sur transporteurs.nom mais il n’est pas pris en compte car c’est la neuvième table. Monter join_collapse_limit de 8 à 9 permet de prendre ce critère en compte, et le plan est alors bien meilleur 15 . (Pour l’exemple complet, voir https://dali.bo/j2_html#requête-avec-beaucoup-de-tables-1) Une autre solution serait de remonter plus haut dans le FROM la jointure sur la table contacts . Son critère discriminant serait ainsi pris en compte dès le début. Mais il n’est pas toujours possible de modifier le code, qui d’ailleurs peut être dynamique.
Les paramètres join_collapse_limit et from_collapse_limit sont trop peu b connus, alors qu’ils peuvent améliorer radicalement les performances si vous joignez plus de huit tables.
Pour éviter de se soucier de ce problème, il est fréquent de monter les valeurs de join_collapse_limit et from_collapse_limit à 10 ou 12.
13 https://explain.dalibo.com/plan/38c13a926g221869 14 https://dali.bo/tp_magasin 15 https://explain.dalibo.com/plan/1f75cce998g1hdg8
Si vous avez de nombreuses requêtes avec beaucoup de tables et que vous montez join_collapse_limit , les temps de planification peuvent fortement augmenter,
ainsi que la consommation CPU. Ce ne sera pas forcément contrebalancé par des requêtes toutes plus rapides. Il est donc préférable de positionner ces valeurs élevées uniquement au niveau de la session, de l’écran, ou de l’utilisateur, et s’il est montré que ces
requêtes sont parfois contre-performantes.
Concrètement, pour ne changer la valeur que dans une session, utilisez SET :
ou pour un utilisateur précis, un rôle de reporting par exemple, utilisez :
Par contre, dans une base dédiée à la BI, ou un utilisateur dédié, avec peu de b requêtes, qui portent sur de nombreuses tables, il ne faut pas hésiter à monter join_collapse_limit au nombre maximal de tables susceptibles d’être rencontrées. Des coûts en planification de l’ordre de la seconde ne sont pas forcément rédhibitoires dans ce contexte.
À l’inverse, descendre join_collapse_limit à 1 permet de dicter l’ordre d’exécution au planificateur dans la clause FROM (voir l’exemple de la documentation officielle 16 ). C’est une mesure de dernier recours.
7.8.1.2 GEQO, l’optimiseur génétique
Principe du GEQO : Quand il y a beaucoup de tables, et que l’on monte join_collapse_limit , le nombre colossal de plans envisageables rend une recherche exhaustive du meilleur plan beaucoup trop lourde. PostgreSQL déclenche alors un autre mécanisme au-delà de 12 tables (valeur du paramètre geqo_threshold ) : l’optimiseur génétique GEQO 17 (GEnetic Query Optimizer).
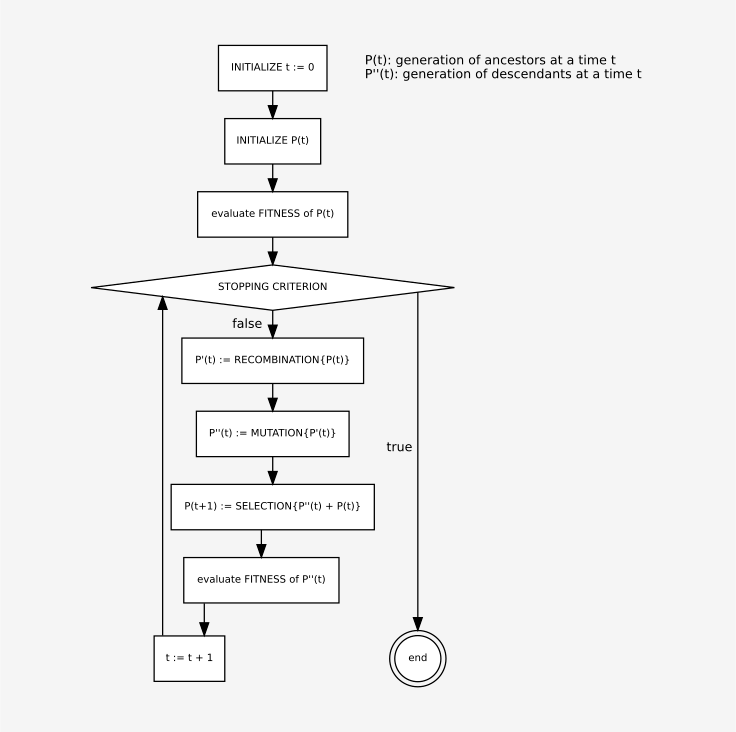
Comme tout algorithme génétique, il fonctionne par introduction de mutations aléatoires sur un état initial donné. Il permet de planifier rapidement une requête complexe, et d’obtenir un plan d’exécution dans un délai raisonnable. Ce plan là n’est pas forcément optimal, mais assez proche pour être acceptable. Le code source de PostgreSQL 18 décrit le principe, résumé aussi dans ce schéma : 16 https://docs.postgresql.fr/current/explicit-joins.html 17 https://docs.postgresql.fr/current/geqo-pg-intro.html 18 https://git.postgresql.org/gitweb/?p=postgresql.git;a=commit;h=f5bc74192d2ffb32952a06c62b3458d28ff7f98f
PostgreSQL)
Ce mécanisme est configuré par des paramètres dont les noms commencent par geqo , notamment :
geqo (par défaut à on ) permet d’activer/désactiver GEQO ;
geqo_threshold (défaut : 12) est le nombre minimum d’éléments à joindre dans un FROM
avant de déclencher le mécanisme GEQO au lieu du planificateur exhaustif;
- geqo_seed (la « graine » pour la génération aléatoire, 0 par défaut) permet de forcer la recherche d’autres plans ;
- geqo_effort (défaut : 5) influe sur d’autres paramètres, comme la taille de l’échantillon de
départ, la sélection… qui ne seront pas évoqués ici.
Il est déconseillé de toucher à ces paramètres sans savoir ce que l’on fait.
Noter que malgré l’introduction de ces mutations aléatoires, le moteur arrive tout de même à conserver un fonctionnement déterministe 19 . En effet, tant que la « graine » du générateur aléatoire ( geqo_seed ) et les autres paramètres contrôlant GEQO restent inchangés, les plans générés seront toujours les mêmes 20 , toutes choses égales par ailleurs bien sûr (statistiques, paramètres…).
Paramétrage du GEQO :
Le paramétrage par défaut convient généralement.
Surtout, il est déconseillé de désactiver geqo ou de monter geqo_threshold au-delà
de 12, sous peine d’explosion du temps de planification et de la consommation mémoire
avec de nombreuses jointures.
Pour des requêtes dépassant ce nombre de jointures, il faudra souvent monter join_collapse_limit plus ou moins haut. Le GEQO permet d’éviter que le temps de planification augmente de manière exponentielle. Noter que si join_collapse_limit est monté entre 9 et 11, le temps de planification peut fortement augmenter car le GEQO n’intervient pas. Une fois le seuil d’intervention du GEQO dépassé, la montée du temps de planification en fonction de join_collapse_limit reste beaucoup plus maîtrisée.
Si le plan sélectionné n’est pas satisfaisant, il est possible d’en explorer d’autres en changeant le paramètre geqo_seed (voir la documentation officielle 21 ). C’est surtout un moyen de voir si de meilleurs plans (avec un coût bien plus bas) peuvent être trouvés, car un SET geqo_seed = … n’est pas une mesure pérenne (les données changent et les requêtes sont souvent dynamiques). Dans l’idéal, le GEQO retombe toujours sur des plans de coûts voisins quelque soit geqo_seed .
Si ça n’est pas le cas, les plans obtenus risquent de trop varier d’un appel à l’autre. Il est alors possible de monter geqo_effort (défaut : 5) jusque 10, pour augmenter son pool de plans notamment. Le temps de planification montera au moins proportionnellement, pour un résultat normalement plus stable et plus fiable.
S’il faut en arriver là, il faut bien contrôler que le temps de planification reste tolérable. Il y a peut-être aussi besoin de vérifier la pertinence de requêtes avec des dizaines de jointures.
19 https://git.postgresql.org/gitweb/?p=postgresql.git;a=commit;h=f5bc74192d2ffb32952a06c62b3458d28ff7f98f 20 https://www.postgresql.org/docs/current/geqo-pg-intro.html#GEQO-PG-INTRO-GEN-POSSIBLE-PLANS 21 https://www.postgresql.org/docs/current/geqo-pg-intro.html#GEQO-PG-INTRO-GEN-POSSIBLE-PLANS
Prédicats et statistiques
L’optimiseur n’a pas de statistiques sur le résultat de la fonction extract
Il estime la sélectivité du prédicat à 0,5 % …
CREATE STATISTIC
Lorsque les valeurs des colonnes sont transformées par un calcul ou par une fonction, l’optimiseur n’a aucun moyen de connaître la sélectivité d’un prédicat. Il utilise donc une estimation codée en dur dans le code de l’optimiseur : 0,5 % du nombre de lignes de la table. Dans la requête suivante, l’optimiseur estime alors que la requête va ramener 2495 lignes :
Ces 2495 lignes correspondent à 0,5 % de la table employes_big . Nous avons vu qu’il est préférable de réécrire la requête de manière à pouvoir utiliser les statistiques existantes sur la colonne, mais ce n’est pas toujours aisé ou même possible. Dans ce cas, on peut se rabattre sur l’ordre CREATE STATISTICS . Nous avons vu plus haut qu’il permet de calculer des statistiques sur des résultats d’expressions (ne pas oublier ANALYZE ).
Les estimations du plan sont désormais correctes :
Avant PostgreSQL 14, il est nécessaire de créer un index fonctionnel sur l’expression pour que des statistiques soient calculées.
Les problèmes avec LIKE
PostgreSQL peut utiliser un index dans ce cas
MAIS si l’encodage n’est pas C
déclarer l’index avec une classe d’opérateur
varchar_pattern_ops / text_pattern_ops , etc.
- Outils pour LIKE
'%mot%':- pg_trgm
- Full Text Search
Il existe cependant une spécificité à PostgreSQL : dans le cas d’une recherche avec préfixe, il peut utiliser directement un index sur la colonne si l’encodage est « C ». Or le collationnement par défaut d’une base est presque toujours en_US.UTF-8 ou fr_FR.UTF-8 , selon les choix à l’installation de l’OS ou de PostgreSQL :
| Nom | Propriétaire | Encodage | Collationnement | Type caract. | … |
|---|---|---|---|---|---|
| pgbench | postgres | UTF8 | en_US.UTF-8 | en_US.UTF-8 | |
| postgres | postgres | UTF8 | en_US.UTF-8 | en_US.UTF-8 | |
| template0 | postgres | UTF8 | en_US.UTF-8 | en_US.UTF-8 | … |
| template1 | postgres | UTF8 | en_US.UTF-8 | en_US.UTF-8 | … |
| textes_10 | postgres | UTF8 | en_US.UTF-8 | en_US.UTF-8 |
Il faut alors utiliser une classe d’opérateur lors de la création de l’index. Cela donnera par exemple :
Ce n’est qu’à cette condition qu’un LIKE ‘mot%’ pourra utiliser l’index. Par contre, l’opérateur varchar_pattern_ops ne permet pas de trier ( ORDER BY notamment), faute de collation, il faudra donc peut-être indexer deux fois la colonne. Un encodage C (purement anglophone) ne nécessite pas l’ajout d’une classe d’opérateurs varchar_pattern_ops .
Pour les recherches à l’intérieur d’un texte ( LIKE ‘%mot%’ ), il existe deux autres options :
- pg_trgm est une extension permettant de faire des recherches de type par trigramme et un
index GIN ou GiST;
- la Full Text Search est une fonctionnalité extrêmement puissante, mais avec une syntaxe différente.
DELETE lent
DELETE lent
- Généralement un problème de clé étrangère
Parfois, un DELETE peut prendre beaucoup de temps à s’exécuter. Cela peut être dû à un grand nombre de lignes à supprimer. Cela peut aussi être dû à la vérification des contraintes étrangères.
Dans l’exemple ci-dessus, le DELETE met 38 minutes à s’exécuter (2 312 835 ms), pour ne supprimer aucune ligne. En fait, c’est la vérification de la contrainte fk_nonbatia21descrsuf_lota30descrlot qui prend pratiquement tout le temps. C’est d’ailleurs pour cette raison qu’il est recommandé de positionner des index sur les clés étrangères, car cet index permet d’accélérer la recherche liée à la contrainte.
Attention donc aux contraintes de clés étrangères pour les instructions DML !
Dédoublonnage
DISTINCT est souvent utilisé pour dédoublonner les lignes
souvent utilisé de manière abusive
tri !!
barrière à l’optimisation
Penser à :
DISTINCT ON
GROUP BY
Une clé primaire permet de dédoublonner efficacement
Un DISTINCT est une opération coûteuse à cause du tri nécessaire. Il est fréquent de le voir ajouté abusivement, « par prudence » ou pour compenser un bug de jointure. De plus il constitue une « barrière à l’optimisation » s’il s’agit d’une partie de requête.
Si le résultat contient telles quelles les clés primaires de toutes les tables jointes, le b DISTINCT est mathématiquement inutile ! PostgreSQL ne sait malheureusement pas repérer tout seul ce genre de cas.
Quand le dédoublonnage est justifié, il faut savoir qu’il y a deux alternatives principales au DISTINCT . Leurs efficacités relatives sont très dépendantes du paramétrage mémoire ( work_mem ) ou des volumétries, ou encore de la présence d’index permettant d’éviter le tri.
Un GROUP BY des colonnes retournées est fastidieux à coder, mais donne parfois un plan efficace. Cette astuce était plus fréquemment utile avant PostgreSQL 13.
Une autre possibilité est d’utiliser la syntaxe DISTINCT ON (champs) , qui renvoie la première
ligne rencontrée sur une clé fournie (documentation 22 ). Exemples (sous PostgreSQL 15.2, configuration par défaut sur une petite configuration, cache chaud) : Il s’agit ici d’afficher la liste des membres des différents services.
- Plan avec DISTINCT : notez le tri sur disque.
matricule, nom, prenom, fonction, manager, date_embauche, num_service, nom_service, localisation, departement 22 https://docs.postgresql.fr/current/sql-select.html#SQL-DISTINCT
- Réécriture avec GROUP BY : il n’y a pas de gain en temps dans ce cas précis, mais il n’y a plus de
tri sur disque, car l’index sur la clé primaire est utilisé. Noter que PostgreSQL est assez malin pour repérer les clés primaire (ici matricule et num_service ). Il évite alors d’inclure dans les données à regrouper ces clés, et tous les champs de la première table.
Hits: 499011 Misses: 4 Evictions: 0 Overflows: 0 Memory Usage: 1kB
- Si l’on monte work_mem de 4 à 100 Mo, les deux versions basculent sur ce plan, ici plus efficace,
qui n’utilise plus l’index, mais ne trie qu’en mémoire, avec la même astuce que ci-dessus.
- La technique la plus propre consiste à indiquer quel est le critère fonctionnel pour dédupliquer.
Ici, la structure des tables impose qu’il n’y ait qu’un service par matricule, ce n’est pas évident en regardant la requête. Les index suffisent à ramener une ligne de service pour chacune d’ employes_big .
- Le plus propre et performant reste tout de même de remarquer que les deux clés primaires
sont dans le résultat, et que le DISTINCT est inutile. La jointure peut se faire de manière plus classique.
Si les DISTINCT sont courants et critiques dans votre application, notez que le nœud est parallélisable depuis PostgreSQL 15.
Index inutilisés
Statistiques pas à jour/peu précises/oubliées
Trop de lignes retournées
Ordre des colonnes de l’index (B-tree)
Index trop gros
Prédicat avec transformation
- Opérateur non supporté par l’index
Paramètres
random_page_cost
effective_cache_size
Il est relativement fréquent de créer soigneusement un index, et que PostgreSQL ne daigne pas l’utiliser. Il peut y avoir plusieurs raisons à cela. Problème de statistiques :
Les statistiques de la table peuvent être périmées ou imprécises, pour les causes vues plus haut. Un index fonctionnel possède ses propres statistiques : il faut donc penser à lancer ANALYZE après sa création. De même après un CREATE STATISTICS . Nombre de lignes trouvées dans l’index : Il faut se rappeler que PostgreSQL a tendance à ne pas utiliser un index s’il doit chercher trop de lignes (ou plutôt de blocs), dans l’index comme dans la table ensuite. Par contre, il utilise facilement par un index qui permet d’éviter des tris ou s’il est couvrant, et pas trop gros. La dispersion des lignes rencontrées dans la table est un facteur également pris en compte. Colonnes d’un index B-tree : Avant PostgreSQL 18, un index B-tree multicolonnes est inutilisable, en tout cas beaucoup moins performant, si les premiers champs ne sont pas fournis. L’ordre des colonnes a son importance. À partir de PostgreSQL 18, un index peut être utilisé relativement efficacement pour une recherche même si la première colonne n’est pas dans le critère de recherche, à condition qu’il n’y ait pas trop de valeurs différentes dans cette première colonne (index skip scan). PostgreSQL fait alors autant de recherches dans l’index qu’il y a de valeurs dans cette première colonne. Par contre, un tri exige toujours la présence de la ou des premières colonnes de l’index. Taille d’un index : PostgreSQL tient compte de la taille des index. Un petit index peut être préféré à un index multicolonnes auquel on a ajouté trop de champs pour qu’il soit couvrant. Problèmes de prédicats : Dans d’autres cas, les prédicats d’une requête ne permettent pas à l’optimiseur de choisir un index pour répondre à une requête. C’est le cas lorsque le prédicat inclut une transformation de la valeur d’une colonne. L’exemple suivant est assez naïf, mais assez représentatif et démontre bien le problème :
Avec une telle construction, l’optimiseur ne saura pas tirer partie d’un quelconque index, à moins d’avoir créé un index fonctionnel sur date_embauche + interval ‘1 month’ , mais cet index est largement contre-productif par rapport à une réécriture de la requête. Ce genre de problème se rencontre plus souvent avec des prédicats sur des dates :
ou encore plus fréquemment rencontré :
Opérateurs non-supportés : Les index B-tree supportent la plupart des opérateurs généraux sur les variables scalaires (entiers, chaînes, dates, mais pas les types composés comme les géométries, hstore…), mais pas la différence ( <> ou != ). Par nature, il n’est pas possible d’utiliser un index pour déterminer toutes les valeurs
sauf une. Mais ce type de construction est parfois utilisé pour exclure les valeurs les plus fréquentes d’une colonne. Dans ce cas, il est possible d’utiliser un index partiel qui, en plus, sera très petit car il n’indexera qu’une faible quantité de données par rapport à la totalité de la table :
La création d’un index partiel permet d’en tirer partie :
Paramétrage de PostgreSQL
Plusieurs paramètres de PostgreSQL influencent l’optimiseur sur l’utilisation ou non d’un index :
- random_page_cost : indique à PostgreSQL la vitesse d’un accès aléatoire par rapport à un
accès séquentiel ( seq_page_cost ) ;
- effective_cache_size : indique à PostgreSQL une estimation de la taille du cache disque du
système.
Le paramètre random_page_cost a une grande influence sur l’utilisation des index en général. Il indique à PostgreSQL le coût d’un accès disque aléatoire. Il est à comparer au paramètre seq_page_cost qui indique à PostgreSQL le coût d’un accès disque séquentiel. Ces coûts d’accès sont purement arbitraires et n’ont aucune réalité physique.
Dans sa configuration par défaut, PostgreSQL estime qu’un accès aléatoire est 4 fois plus coûteux qu’un accès séquentiel. Les accès aux index étant par nature aléatoires alors que les parcours de table sont par nature séquentiels, modifier ce paramètre revient à favoriser l’un par rapport à l’autre. Cette valeur est bonne dans la plupart des cas. Mais si le serveur de bases de données dispose d’un système disque rapide, c’est-à-dire une bonne carte RAID et plusieurs disques SAS rapides en RAID10, ou du SSD, il est possible de baisser ce paramètre à 3 voire 2 ou 1.
Pour aller plus loin, n’hésitez pas à consulter cet article de blog 23
23 https://www.depesz.com/index.php/2010/09/09/why-is-my-index-not-being-used/
Écriture du SQL
NOT IN avec une sous-requête
remplacer par NOT EXISTS
UNION entraîne un tri systématique
préférer UNION ALL
Sous-requête dans le SELECT
utiliser LATERAL
La façon dont une requête SQL est écrite peut aussi avoir un effet négatif sur les performances. Il n’est pas possible d’écrire tous les cas possibles, mais certaines formes d’écritures reviennent souvent. La clause NOT IN n’est pas performante lorsqu’elle est utilisée avec une sous-requête. L’optimiseur ne parvient pas à exécuter ce type de requête efficacement.
Il est nécessaire de la réécrire avec la clause NOT EXISTS , par exemple :
Absence de hints
Certains regrettent l’absence de hints
C’est la politique du projet :
vouloir ne signifie pas avoir besoin
PostgreSQL est un projet libre qui a le luxe de se défaire de la pression du marché
cela permet d’être plus facilement et rapidement mis au courant des problèmes de l’optimiseur
Ne pensez pas être plus intelligent que le planificateur
Mais il ne peut faire qu’avec ce qu’il a
L’absence de la notion de hints, qui permettent au DBA de forcer l’optimiseur à choisir des plans d’exécution jugés pourtant trop coûteux, est voulue. Elle a même été intégrée dans la liste des fonctionnalités dont la communauté ne voulait pas
(« Features We Do Not Want 24 »). L’absence des hints est très bien expliquée dans un billet de Josh Berkus, ancien membre de la Core Team de PostgreSQL 25 : Le fait que certains DBA demandent cette fonctionnalité ne veut pas dire qu’ils ont réellement besoin de cette fonctionnalité. Parfois ce sont de mauvaises habitudes d’une époque révolue, où les optimiseurs étaient parfaitement stupides. Ajoutons à cela que les SGBD courants étant des projets commerciaux, ils sont forcément plus poussés à accéder aux demandes des clients, même si ces demandes ne se justifient pas, ou sont le résultat de pressions de pur court terme. Le fait que PostgreSQL soit un projet libre permet justement aux développeurs du projet de choisir les fonctionnalités implémentées suivant leurs idées, et non pas la pression du marché. Selon le wiki sur le sujet 26 , l’avis de la communauté PostgreSQL est que les hints, du moins tels qu’ils sont implémentés ailleurs, mènent à une plus grande complexité du code applicatif, donc à des problèmes de maintenabilité, interfèrent avec les mises à jour, risquent d’être contre-productifs au fur et à mesure que vos tables grossissent, et sont généralement inutiles. Sur le long terme, il vaut mieux rapporter un problème rencontré avec l’optimiseur pour qu’il soit définitivement corrigé. L’absence de hints permet d’être plus facilement et rapidement mis au courant des problèmes de l’optimiseur. Sur le long terme, cela est meilleur pour le projet comme pour les utilisateurs. Cela a notamment mené à améliorer l’optimiseur et le recueil des statistiques. L’accumulation de hints dans un système a tendance à poser problème lors de l’évolution des besoins, de la volumétrie ou après des mises à jour. Si le plan d’exécution généré n’est pas optimal, il est préférable de chercher à comprendre d’où vient l’erreur. Il est rare que l’optimiseur se trompe : en général c’est lui qui a raison. Mais il ne peut faire qu’avec les statistiques à sa disposition, le modèle qu’il voit, les index que vous avez créés. Nous avons vu dans ce module quelles pouvaient être les causes entraînant des erreurs de plan :mauvaise écriture de requête;
modèle de données pas optimal;
manque d’index adéquats (et PostgreSQL en possède une grande variété);
statistiques pas à jour ;
statistiques pas assez fines ;
colonnes corrélées;
paramétrage de la mémoire;
paramétrage de la profondeur de recherche de l’optimiseur;
…
Ajoutons qu’il existe des outils comme PoWA 27 pour vous aider à optimiser des requêtes.
24 https://wiki.postgresql.org/wiki/Not_Worth_Doing#Features_We_Do_Not_Want 25 https://it.toolbox.com/blogs/josh-berkus/why-postgresql-doesnt-have-query-hints-020411 26 https://wiki.postgresql.org/wiki/OptimizerHintsDiscussion 27 https://powa.readthedocs.io/en/latest/
Outils d’optimisation
auto_explain
pg_hint_plan
HypoPG
auto_explain
Tracer les plans des requêtes lentes automatiquement
Contrib officielle
Mise en place globale (traces) :
globale :
Principe : L’outil auto_explain est habituellement activé quand on a le sentiment qu’une requête devient subitement lente à certains moments, et qu’on suspecte que son plan diffère entre deux exécutions. Elle permet de tracer dans les journaux applicatifs, voire dans la console, le plan de la requête dès qu’elle dépasse une durée configurée. C’est une « contrib » officielle de PostgreSQL (et non une extension). Tracer systématiquement le plan d’exécution d’une requête fréquente prend de la place, et est assez coûteux. C’est donc un outil à utiliser parcimonieusement, qui par défaut ne trace rien (paramètre auto_explain.log_min_duration à -1). Activation et utilisation dans une session : Pour utiliser auto_explain dans la session en cours, il faut activer quelques options similaires à celles d’ EXPLAIN :
Les plans se retrouvent dans les traces de l’instance. Pour les afficher aussi dans la session en cours, il faut descendre le niveau des messages affichés à LOG (le défaut de auto_explain ) :
Ensuite, lancer la requête à analyser : le plan apparaît suivi du résultat de la requête.
Autres paramètres :
L’outil a d’autres options, qui reprennent souvent les paramètres habituels d’ EXPLAIN . Leurs valeurs par défaut sont les suivantes :
| name | setting |
|---|---|
| auto_explain.log_analyze | on |
| auto_explain.log_buffers | off |
| auto_explain.log_format | text |
| auto_explain.log_level | log |
| auto_explain.log_min_duration | 0 |
| auto_explain.log_nested_statements | off |
| auto_explain.log_parameter_max_length | -1 |
| auto_explain.log_settings | off |
| auto_explain.log_timing | on |
| auto_explain.log_triggers | off |
| auto_explain.log_verbose | off |
| auto_explain.log_wal | off |
| auto_explain.sample_rate | 1 |
Voir la documentation 28 pour ce qui n’est pas traité ici.
Utilisation au niveau global et précautions :
Pour utiliser auto_explain globalement, il faut charger la bibliothèque au démarrage dans le fichier postgresql.conf via le paramètre shared_preload_libraries .
Après un redémarrage de l’instance, il est possible de configurer les paramètres de capture des plans d’exécution par base de données. Dans l’exemple ci-dessous, l’ensemble des requêtes sont tracées sur la base de données bench , qui est utilisée par pgbench .
Attention! L’activation des traces complètes sur une base de données avec un fort volume de requêtes, et/ou des requêtes aux plans complexes, peut faire gonfler énormément les traces ( postgresql.log ). N’activez donc auto_explain que de manière limitée.
Pour ne tracer qu’un échantillonnage des requêtes, déclarer par exemple : b ALTER DATABASE bench SET auto_explain.sample_rate = 0.01 ;
28 https://docs.postgresql.fr/current/auto-explain.html#AUTO-EXPLAIN-CONFIGURATION-PARAMETERS
Un autre problème, rare mais déjà rencontré, est l’activation simultanée du paramètre
track_io_timing , alors que le test avec pg_test_timing indique que c’est problématique. L’impact sur les performances peut être sévère.
pg_test_timing 29 est livré avec PostgreSQL et mesure les performances de l’horloge système. Si le temps de mesure renvoyé sur la deuxième ligne n’est que de quelques dizaines de nanosecondes, la machine est suffisamment rapide pour que track_io_timing renvoie des résultats précis et sans ralentir la requête. C’est le cas sur presque toutes les machines et systèmes d’exploitation actuels, mais il y a parfois des surprises, par exemple dans certaines machines virtuelles ou selon la source de l’horloge système. Sinon, éviter d’activer track_io_timing sur un serveur de production. Sur une machine de test ou de formation, ce n’est pas un problème. Exemple de résultat : Un petit benchmark pgbench est lancé :
Les plans d’exécution de l’ensemble des requêtes exécutées apparaissent alors dans les traces de l’instance.
Utilisation pour des fonctions : auto_explain est aussi un moyen de suivre les plans au sein de fonctions. Par défaut, un plan n’indique que les compteurs de blocs hit, read, temp… de l’appel global à la fonction. Par exemple, on veut le plan à l’exécution de cette fonction en PL/pgSQL, qui récupère le solde le plus élevé dans la table pgbench_accounts :
29 https://docs.postgresql.fr/current/pgtesttiming.html
Un EXPLAIN ANALYZE ne permet pas d’obtenir le plan de la requête de la fonction, car il est masqué au sein d’un nœud Result :
(Exception : certaines fonctions très simples en SQL, et non PL/pgSQL, peuvent être intégrées dans la requête appelante et n’ont pas de plan propre.) Par défaut, auto_explain ne va pas capturer plus d’information que la commande EXPLAIN ANALYZE . Le fichier log de l’instance capture le même plan lorsque la fonction est exécutée :
Le paramètre auto_explain.log_nested_statements permet de tracer les plans des requêtes à l’intérieur des fonctions, de préférence uniquement dans la ou les sessions concernées :
Les deux plans (celui de la requête de la fonction, puis de la fonction) sont alors visibles dans les traces de l’instance :
Utilisation avec pgBadger : pgBadger est capable de lire les plans tracés par auto_explain , de les intégrer à son rapport et d’inclure un lien vers explain.depesz.com 30 pour une version plus lisible.
Extension pg_hint_plan
Pour :
forcer l’utilisation d’un nœud entre deux tables
imposer une valeur de paramètre
appliquer automatiquement ces hints à des requêtes
Cette extension existe depuis longtemps. Elle est à présent présente dans les paquets du PGDG, par exemple :
Le code est sur le dépôt Github 31 . Voir aussi cet article 32 .
Comme avec toute extension en C, un bug est susceptible de provoquer un plantage complet du serveur!
Extension HypoPG
Extension PostgreSQL
Création d’index hypothétiques pour tester leur intérêt
avant de les créer pour de vrai
Limitations : surtout B-Tree, statistiques
30 https://explain.depesz.com/ 31 https://github.com/ossc-db/pg_hint_plan 32 https://docs.yugabyte.com/latest/explore/query-1-performance/pg-hint-plan/
Cette extension est disponible sur GitHub 33 et dans les paquets du PGDG. Il existe trois fonctions principales et une vue :
hypopg_create_index() pour créer un index hypothétique;
hypopg_drop_index() pour supprimer un index hypothétique particulier ou hypopg_reset()
pour tous les supprimer ;
- hypopg_list_indexes pour les lister.
Un index hypothétique n’existe que dans la session, ni en mémoire ni sur le disque, mais le planificateur le prendra en compte dans un EXPLAIN simple (évidemment pas un EXPLAIN ANALYZE ). En quittant la session, tous les index hypothétiques restants et créés sur cette session sont supprimés. L’exemple suivant est basé sur la base dont le script peut être téléchargé sur https://dali.bo/tp_employes_services.
| indexrelid | indexname |
|---|---|
| 24591 | <24591>btree_employes_big_prenom |
| indexrelid | indexname | nspname | relname | amname |
|---|---|---|---|---|
| 24591 | <24591>btree_employes_big_prenom | public | employes_big | btree |
33 https://github.com/HypoPG/hypopg
Le cas idéal d’utilisation est l’index B-Tree sur une colonne. Un index fonctionnel est possible, mais, faute de statistiques disponibles avant la création réelle de l’index, les estimations peuvent être fausses. Les autres types d’index sont moins bien ou non supportées.
Conclusion
Planificateur très avancé
Ne pensez pas être plus intelligent que lui
Il faut bien comprendre son fonctionnement
Questions
Quiz
Travaux pratiques
La version en ligne des solutions de ces TP est disponible sur https://dali.bo/j2_solutions.
Préambule
Tous les TP se basent sur la configuration par défaut de PostgreSQL, sauf précision contraire.
Préciser \timing dans psql pour afficher les temps d’exécution de la recherche.
Pour rendre les plans plus lisibles, désactiver le JIT et le parallélisme :
- Afin d’éviter tout effet dû au cache, autant du plan que des pages de données, nous utilisons
parfois une sous-requête avec un résultat non déterministe (fonction random() ).
- Pour mettre en évidence les effets de cache, lancer plusieurs fois les requêtes. Dans psql , il
est possible de les rappeler avec \g , ou la touche flèche haut du clavier.
Ce TP utilise notamment la base cave. Son schéma est le suivant :
Si vous ne l’avez pas déjà, la base cave (dump de 2,6 Mo, pour 71 Mo sur le disque au final) peut être téléchargée et restaurée ainsi :
Les valeurs (taille, temps d’exécution) varieront à cause de plusieurs critères :
les machines sont différentes;
le jeu de données peut avoir partiellement changé depuis la rédaction du TP ;
Optimisation d’une requête (partie 1)
But : Optimisation de requête
La requête suivante vise à récupérer un état des stocks pour une année prise au hasard :
Exécuter la requête telle quelle et noter le plan et le temps d’exécution.
Créer un index sur la colonne stock.annee .
Exécuter la requête juste après la création de l’index.
Rafraîchir les statistiques sur stock .
Exécuter à nouveau la requête.
Interdire à PostgreSQL les parcours de table avec enable_seqscan dans la session.
Exécuter à nouveau la requête.
Réautoriser les Seq Scan.
Relancer la première requête; chercher s’il y a un écart entre les nombres de lignes attendues
et réellement ramenées.
Quel est l’étape problématique?
Tenter de réécrire la requête pour l’optimiser en déplaçant la sélection de l’année dans la
clause WHERE .
Quel est le nouveau plan ?
Les estimations sont-elles meilleures?
Le temps d’exécution est-il meilleur ?
Optimisation d’une requête (partie 2)
But : Optimisation de requête
L’exercice précédent nous a amené à cette requête :
Cette écriture n’est pas optimale.
Vérifier la pertinence de la dernière jointure sur appellation .
Modifier la requête. Y a-t-il un impact sur le plan ?
Tester avec une année précise (par exemple 1990).
L’index sur stock.annee est-il utilisé ?
Quelle est la différence avec le filtrage sur le résultat de la sous-requête?
Comment adapter la requête pour utiliser l’index?
Requête avec beaucoup de tables
But : Optimiser une requête avec beaucoup de tables
- Importer la base magasin si elle n’est pas déjà chargée.
Si vous ne l’avez pas déjà, la base magasin (dump de 96 Mo, pour 667 Mo sur le disque au final) peut être téléchargée et restaurée comme suit dans une nouvelle base magasin :
Les données sont dans deux schémas, magasin et facturation. Penser au search_path . Pour ce TP, figer les paramètres suivants :
- Pour calculer le chiffre d’affaires gagné grâce au contact nommé Brahem Beatty via le transporteur « Royal Air Drone », tester cette requête et afficher son plan :
- Comment améliorer le temps d’exécution SANS modifier la requête ni ajouter d’index? (Il est
évident et connu que le modèle de données est insuffisamment indexé, mais ce n’est pas le problème.)
- À l’inverse, sans modifier de paramètre, comment modifier la requête pour qu’elle s’exécute
plus rapidement?
Travaux pratiques (solutions)
Préambule
Tous les TP se basent sur la configuration par défaut de PostgreSQL, sauf précision contraire.
Préciser \timing dans psql pour afficher les temps d’exécution de la recherche.
Pour rendre les plans plus lisibles, désactiver le JIT et le parallélisme :
- Afin d’éviter tout effet dû au cache, autant du plan que des pages de données, nous utilisons
parfois une sous-requête avec un résultat non déterministe (fonction random() ).
- Pour mettre en évidence les effets de cache, lancer plusieurs fois les requêtes. Dans psql , il
est possible de les rappeler avec \g , ou la touche flèche haut du clavier.
Ce TP utilise notamment la base cave. Son schéma est le suivant :
Si vous ne l’avez pas déjà, la base cave (dump de 2,6 Mo, pour 71 Mo sur le disque au final) peut être téléchargée et restaurée ainsi :
Les valeurs (taille, temps d’exécution) varieront à cause de plusieurs critères :
les machines sont différentes;
le jeu de données peut avoir partiellement changé depuis la rédaction du TP ;
Optimisation d’une requête (partie 1)
- Exécuter la requête telle quelle et noter le plan et le temps d’exécution.
L’exécution de la requête donne le plan suivant. Le temps comme le plan peuvent varier en fonction de la version exacte de PostgreSQL, de la machine utilisée, de son activité :
Créer un index sur la colonne stock.annee .
Exécuter la requête juste après la création de l’index.
Instinctivement, on s’attend à ce qu’un index sur stock.annee soit utile, puisque l’on sélectionne uniquement là-dessus :
Cependant, le plan ne change pas si l’on relance la requête ci-dessus. La raison est simple : au moment de la construction du plan, la valeur de l’année est inconnue. L’index est donc inutilisable.
Rafraîchir les statistiques sur stock .
Exécuter à nouveau la requête.
Peut-être ANALYZE a-t-il été oublié ? Dans l’idéal, un VACUUM ANALYZE est même préférable pour favoriser les Index Only Scan .
Mais cela n’a pas d’influence sur le plan. En fait, le premier plan ci-dessus montre que les statistiques sont déjà correctement estimées.
Interdire à PostgreSQL les parcours de table avec enable_seqscan dans la session.
Exécuter à nouveau la requête.
Nous remarquons que le temps d’exécution explose :
Le plan renvoyé peut être analysé graphiquement avec explain.dalibo.com 34 .
34 https://explain.dalibo.com/
- Réautoriser les Seq Scan.
- Relancer la première requête; chercher s’il y a un écart entre les nombres de lignes attendues
et réellement ramenées.
- Quel est l’étape problématique?
Avec COSTS ON (qui est activé par défaut), les estimations attendues sont affichées, où l’on peut comparer ligne par ligne aux nombres réellement ramenés.
L’estimation du nombre de lignes renvoyé par la requête est parfaite. Est-ce le cas pour tous les nœuds en-dessous? D’abord on note que les lignes à regrouper étaient 4 fois plus nombreuses que prévues :
Cela ne veut pas dire que les statistiques sur les tables v ou a sont fausses, car les nœuds précédents ont déjà opéré des jointures et filtrages. Si on tente de descendre au nœud le plus profond qui montre un problème d’estimation, on trouve ceci :
Il s’agit de la jointure hash entre stock et annee sur une sélection aléatoire de l’année. PostgreSQL s’attend à 4303 lignes, et en retrouve 16 886, 4 fois plus. Il ne s’agit pas d’un problème dans l’estimation de stock même, car il s’attend correctement à y balayer 860 592 lignes (il s’agit bien du nombre de lignes vivantes total de la table qui vont alimenter la jointure avec annee ) :
La seconde partie du hash (le SELECT sur annee ) est constitué d’un bucket correctement estimé à 1 ligne depuis le résultat de la sous-requête :
Il y a donc un problème dans l’estimation du nombre de lignes ramenées par la jointure sur l’année choisie au hasard.
- Tenter de réécrire la requête pour l’optimiser en déplaçant la sélection de l’année dans la
clause WHERE .
Quel est le nouveau plan ?
Les estimations sont-elles meilleures?
Le temps d’exécution est-il meilleur ?
Il y a une jointure en moins, ce qui est toujours appréciable. Nous pouvons faire cette réécriture parce que la requête SELECT round(random()*50)+1950 AS annee ne ramène qu’un seul enregistrement. Le nouveau plan est :
Sur la machine testée, le temps d’exécution est réduit d’un tiers. Pourtant, le plan n’est que très peu différent, et les estimations ne sont pas meilleures (ce qui semble logique, PostgreSQL n’ayant pas plus d’informations sur la valeur exacte de l’année qui sera calculée). La différence avec l’ancien plan est cette partie :
Le nouveau plan comprend le calcul de la variable (InitPlan 1).col1 (tout en haut) puis un parcours complet de stock et un filtrage au fur et à mesure des lignes sur annee = (InitPlan 1).col1 . Il ne s’agit plus là d’une jointure par hash. Toute la construction d’une table de hachage sur la table stock est supprimée. PostgreSQL sait de manière absolue qu’il n’y aura qu’une seule valeur ramenée par sous-requête, gràce à = . Ce n’était pas évident pour lui car le résultat des fonctions forme un peu une « boîte noire ». Si on remplace le = par IN , on retombe sur le plan original. Noter toutefois que la différence totale de coût au niveau de la requête est faible. Que peut-on conclure de cet exercice?
l’optimiseur n’est pas tenu d’utiliser un index;
se croire plus malin que l’optimiseur est souvent contre-productif ( SET enable_seqscan TO off
n’a pas mené au résultat espéré);
il vaut toujours mieux être explicite dans ce qu’on demande dans une requête;
il vaut mieux séparer jointure et filtrage.
Il reste un mystère qui sera couvert par un exercice suivant : pourquoi l’index sur stock.annee n’est-il pas utilisé?
Optimisation d’une requête (partie 2)
Vérifier la pertinence de la dernière jointure sur appellation .
Modifier la requête. Y a-t-il un impact sur le plan ?
On peut se demander si la jointure externe ( LEFT JOIN ) est fondée :
Cela se traduit par « récupérer tous les tuples de la table vin , et pour chaque correspondance dans appellation , la récupérer, si elle existe ».
La description de la table vin est :
| Colonne | Type | … | NULL-able | Par défaut |
|---|---|---|---|---|
| id | integer | not null | nextval(‘vin_id_seq’::regclass) | |
| recoltant_id | integer | |||
| appellation_id | integer | not null | ||
| type_vin_id | integer | not null |
Index : “vin_pkey” PRIMARY KEY, btree (id) Contraintes de clés étrangères : “vin_appellation_id_fkey” FOREIGN KEY (appellation_id) REFERENCES appellation(id) ON DELETE CASCADE “vin_recoltant_id_fkey” FOREIGN KEY (recoltant_id) REFERENCES recoltant(id) ON DELETE CASCADE “vin_type_vin_id_fkey” FOREIGN KEY (type_vin_id) REFERENCES type_vin(id) ON DELETE CASCADE Référencé par : TABLE “stock” CONSTRAINT “stock_vin_id_fkey” FOREIGN KEY (vin_id) REFERENCES vin(id) ON DELETE CASCADE
appellation_id est NOT NULL : il y a forcément une valeur, qui est forcément dans appellation . De plus, la contrainte vin_appellation_id_fkey signifie qu’on a la certitude que pour chaque vin.appellation.id , il existe une ligne correspondante dans appellation .
À titre de vérification, deux COUNT(*) du résultat, une fois en INNER JOIN et une fois en LEFT JOIN montrent un résultat identique :
On peut donc réécrire la requête sans la jointure externe, qui n’est pas fausse mais est généralement bien moins efficace qu’une jointure interne :
Quant au plan, il est identique au plan précédent. Cela n’est pas étonnant : il n’y a aucun filtrage sur appellation et c’est une petite table, donc intuitivement on peut se dire que PostgreSQL fera la jointure une fois les autres opérations effectuées, sur le minimum de lignes. D’autre part, PostgreSQL est depuis longtemps capable de transformer un LEFT JOIN inutile en INNER JOIN quand la contrainte est là. Si on observe attentivement le plan, on constate qu’on a toujours le parcours séquentiel de la table stock , qui est notre plus grosse table. Pourquoi a-t-il lieu ?
Tester avec une année précise (par exemple 1990).
L’index sur stock.annee est-il utilisé ?
Quelle est la différence avec le filtrage sur le résultat de la sous-requête?
Comment adapter la requête pour utiliser l’index?
Si on fige l’année, on constate que l’index sur stock.annee est bien utilisé, avec un temps d’exécution bien plus réduit :
La partie qui diffère de l’ancien plan est celle-ci :
Quand précédemment on avait un parcours et un filtrage :
Le nombre de lignes estimées et obtenues sont pourtant les mêmes. Pourquoi PostgreSQL utilise-til l’index pour filtrer sur 1950 et pas pour (InitPlan 1).col1 ? Le filtre en fait diffère, le premier est (annee = 1950) (compatible avec un index), l’autre est ((annee)::double precision = (InitPlan 1).col1) , qui contient une conversion de int en double precision ! Et dans ce cas, l’index est inutilisable (comme à chaque fois qu’il y a une opération sur la colonne indexée). La conversion a lieu parce que la fonction round() retourne un nombre à virgule flottante. La somme d’un nombre à virgule flottante et d’un entier est évidemment un nombre à virgule flottante. Si on veut que la fonction round() retourne un entier, il faut forcer explicitement sa conversion, via CAST(xxx as int) ou ::int .
Le phénomène peut s’observer sur la requête avec 1950 en comparant annee = 1950 + 1.0 : l’index ne sera plus utilisé.
Réécrivons encore une fois cette requête en homogénéisant les types :
Voici son plan :
En effet, la comparaison entre annee et la valeur aléatoire se ferait à chaque ligne séparément, avec un résultat complètement faux. Pour choisir une année au hasard, il faut donc encapsuler le calcul dans une sous-requête, dont le résultat ramènera une seule ligne de manière garantie.
Requête avec beaucoup de tables
- Importer la base magasin si elle n’est pas déjà chargée.
Si vous ne l’avez pas déjà, la base magasin (dump de 96 Mo, pour 667 Mo sur le disque au final) peut être téléchargée et restaurée comme suit dans une nouvelle base magasin :
Les données sont dans deux schémas, magasin et facturation. Penser au search_path . Pour ce TP, figer les paramètres suivants :
- Pour calculer le chiffre d’affaires gagné grâce au contact nommé Brahem Beatty via le transporteur « Royal Air Drone », tester cette requête et afficher son plan :
Cette requête a le plan suivant (la version complète est sur https://explain.dalibo.com/plan/38c13a926g221869) :
Le plan se résume ainsi : un premier filtre se fait sur le transporteur demandé (1 ligne retournée sur les 4 transporteurs). Puis toutes les jointures s’enchaînent, de manière peu efficace : toutes les tables sont parcourues intégralement. Enfin, les 422 709 lignes obtenues sont jointes à la table contacts , laquelle a été filtrée sur la personne (Beatty Brahem) demandée (1 ligne sur 110 005). Pourtant, en regardant les données, on sait que le critère sur contact est de loin le plus discriminant : on s’attend à ce qu’il soit le premier pris en compte. Le plan complet montre que les estimations de volumétrie sont pourtant correctes.
- Comment améliorer le temps d’exécution SANS modifier la requête ni ajouter d’index? (Il est
évident et connu que le modèle de données est insuffisamment indexé, mais ce n’est pas le problème.)
Il y a 9 tables. Avec autant de tables, il faut se rappeler de l’existence du paramètre join_collapse_limit . Vérifions que la valeur est celle par défaut, et testons la valeur juste au-dessus :
(Le plan complet est sur https://explain.dalibo.com/plan/1f75cce998g1hdg8).
Ce plan est 6 fois plus rapide. La différence essentielle tient dans le filtre effectué en premier : cette fois, c’est sur contacts . Puis toute la chaîne des jointures est à nouveau remontée, avec beaucoup moins de lignes qu’auparavant. C’est donc plus rapide, et les Nested Loops et Index Scans deviennent rentables. L’agrégat ne se fait plus que sur 4 lignes. Alors qu’avec join_collapse_limit par défaut, PostgreSQL ignorait le critère de filtrage vraiment discriminant sur la dernière table, la valeur join_collapse_limit lui permet d’étudier les plans incluant contacts , et de filtrer plus tôt. Noter que le temps de planification a doublé, mais reste dérisoire (2 ms). (Ce n’est pas toujours aussi innocent.)
- À l’inverse, sans modifier de paramètre, comment modifier la requête pour qu’elle s’exécute
plus rapidement?
Si l’on a accès au code de la requête, il est possible de la modifier afin que la table la plus discriminante figure dans les 8 premières tables.
join_collapse_limit
Requête légèrement modifiée :
La version complète du plan suivant est sur https://explain.dalibo.com/plan/9c916761d6f35541 :
Le plan redevient très voisin du précédent, et le temps d’exécution est voisin. L’inefficacité majeure est en tout cas corrigée. La conclusion de cette exercice est que, lorsque c’est possible, il vaut mieux mettre dans les premières jointures les tables portant les critères les plus discriminants. Ce n’est pas toujours possible, et on peut alors augmenter join_collapse_limit (et souvent from_collapse_limit en même temps), de préférence uniquement dans la session, pour éviter d’augmenter le temps de planification et la consommation de CPU globalement. Dans le cas où des requêtes contenant de nombreuses jointures sont générées dynamiquement, qu’elles sont fréquentes, et si le temps de planification est ridicule par rapport au gain de l’exécution, alors il est envisageable de monter globalement join_collapse_limit .
Travaux pratiques et solutions
Les pages de travaux pratiques et leurs solutions sont conservées dans le manuel complet, pages PDF 393-415.
Pour poursuivre la lecture, voir le chapitre suivant. Pour revenir au chapitre précédent, voir le chapitre précédent.