8 SQL : Ce qu’il ne faut pas faire
SQL : Ce qu’il ne faut pas faire
Des mauvaises pratiques
Modélisation
Écriture de requêtes
Conception de l’application
Cette partie présente différents problèmes fréquemment rencontrés et leurs solutions. Elles ont trait aussi bien à des problèmes courants qu’à des mauvaises pratiques.
Problèmes de modélisation
Rappels sur le modèle relationnel
Formes normales
Atomicité!
Que veut dire « relationnel »?
PostgreSQL est un SGBD-R, un système de gestion de bases de données relationnel
Le schéma est d’une importance capitale
« Relationnel » n’est pas « relation entre tables »
Les tables SONT les relations (entre attributs)
Contrairement à une idée assez fréquemment répandue, le terme relationnel ne désigne pas le fait que les tables soient liées entre elles. Les « tables » SONT les relations. On fait référence ici à l’algèbre relationnelle, inventée en 1970 par Edgar Frank Codd. Les bases de données dites relationnelles n’implémentent habituellement pas exactement cet algèbre, mais en sont très proches. Le langage SQL, entre autres, ne respecte pas l’algèbre relationnelle. Le sujet étant vaste et complexe, il ne sera pas abordé ici. Si vous voulez approfondir le sujet, le livre Introduction aux bases de données de Chris J. Date, est un des meilleurs ouvrages sur l’algèbre relationnelle et les déficiences du langage SQL à ce sujet.
Quelques rappels sur le modèle relationnel
Le but est de modéliser un ensemble de faits
Le modèle relationnel a été introduit à l’époque des bases de données hiérarchiques
pointeur : incohérence à terme
formalisme : relations, modélisation évitant les incohérences suite à modification
formes normales
Un modèle n’est qu’un modèle : il ne traduit pas la réalité, simplement ce qu’on
souhaite en représenter
- Identifier rapidement les problèmes les plus évidents
Le modèle relationnel est apparu suite à un constat : les bases de données de l’époque (hiérarchiques) reposaient sur la notion de pointeur. Une mise à jour pouvait donc facilement casser le modèle : doublons simples, données pointant sur du « vide », doublons incohérents entre eux, etc. Le modèle relationnel a donc été proposé pour remédier à tous ces problèmes. Un système relationnel repose sur le concept de relation (table en SQL). Une relation est un ensemble de faits. Chaque fait est identifié par un identifiant (clé naturelle). Le fait lie cet identifiant à un certain nombre d’attributs. Une relation ne peut donc pas avoir de doublon. La modélisation relationnelle étant un vaste sujet en soi, nous n’allons pas tout détailler ici, mais plutôt rappeler les points les plus importants.
Formes normales
Il existe une définition mathématique précise de chacune des 7 formes normales.
La troisième forme normale peut toujours être atteinte
- La forme suivante (forme normale de Boyce-Codd, ou FNBC) ne peut pas toujours
être atteinte
La cible est donc habituellement la 3FN
Chris Date :
« Chaque attribut dépend de la clé, de TOUTE la clé, et QUE de la clé »
« The key, the whole key, nothing but the key »
Une relation (table) est en troisième forme normale si tous les attributs (colonnes) dépendent de la clé (primaire), de toute la clé (pas d’un sous-ensemble de ses colonnes), et de rien d’autre que de la clé (une colonne supplémentaire). Si vos tables vérifient déjà ces trois points, votre modélisation est probablement assez bonne. Voir l’article wikipedia 1 présentant l’ensemble des formes normales.
1 https://fr.wikipedia.org/wiki/Forme_normale_(bases_de_donn%C3%A9es_relationnelles)
Atomicité
Un attribut (colonne) doit être atomique :
Modifier l’attribut sans en toucher un autre
Donnée correcte (délicat!)
Recherche efficace : accédé en entier dans une clause WHERE
Non respect = violation de la première forme normale
L’exemple suivant utilise une table voiture . Si vous n’avez pas déjà une base voitures, les deux tables voitures et voitures_ecv peuvent être téléchargées installées comme suit :
Ne pas oublier d’effectuer un VACUUM ANALYZE .
Atomicité - mauvais exemple
Immatriculation Modèle Caractéristiques
NH-415-DG twingo 4 roues motrices,toit ouvrant, climatisation EO-538-WR clio boite automatique,abs,climatisation
Cette modélisation viole la première forme normale (atomicité des attributs). Si on recherche toutes les voitures qui ont l’ABS, on va devoir utiliser une clause WHERE de ce type :
ce qui sera évidemment très inefficace. Par ailleurs, on n’a évidemment aucun contrôle sur ce qui est mis dans le champ caractéristiques , ce qui est la garantie de données incohérentes au bout de quelques jours (heures?) d’utilisation. Par exemple, rien n’empêche d’ajouter une ligne avec des caractéristiques similaires légèrement différentes, comme « ABS », « boîte automatique ». Ce modèle ne permet donc pas d’assurer la cohérence des données.
Atomicité - propositions
- Champs dédiés :
| Column | Type | Description |
|---|---|---|
| immatriculation | text | Clé primaire |
| modele | text | |
| couleur | color | Couleur vehicule (bleu,rouge,vert) |
| abs | boolean | Option anti-blocage des roues |
| type_roue | boolean | tole/aluminium |
| motricite | boolean | 2 roues motrices / 4 roues motrices |
Plusieurs valeurs : contrainte CHECK /enum/table de référence
Beaucoup de champs : clé/valeur (plusieurs formes possibles)
Une alternative plus fiable est de rajouter des colonnes boolean quatre_roues_motrices , boolean abs , varchar couleur . C’est ce qui est à privilégier si le nombre de caractéristiques est fixe et pas trop important. Dans le cas où un simple booléen ne suffit pas, un champ avec une contrainte est possible. Il y a plusieurs méthodes :
- une contrainte simple :
- un type « énumération 2 » :
(Les énumérations ne sont pas adaptées à des modifications fréquentes et nécessitent parfois un transtypage vers du text ).
- une table de référence avec contrainte, c’est le plus flexible :
Ce modèle facilite les recherches et assure la cohérence. L’indexation est facilitée, et les performances ne sont pas dégradées, bien au contraire. Dans le cas où le nombre de propriétés n’est pas aussi bien défini qu’ici, ou est grand, même un modèle clé-valeur dans une associée vaut mieux que l’accumulation de propriétés dans un champ texte. Même une simple table des caractéristiques est plus flexible (voir le TP). 2 https://docs.postgresql.fr/current/datatype-enum.html
Un modèle clé/valeur existe sous plusieurs variantes (table associée, champs hstore ou JSON…) et a ses propres inconvénients, mais il offre au moins plus de flexibilité et de possibilités d’indexation ou de validation des données. Ce sujet est traité plus loin.
Contraintes absentes
Parfois (souvent?) ignorées pour diverses raisons :
faux gains de performance
flexibilité du modèle de données
compatibilité avec d’autres SGBD (MySQL/MyISAM…)
commodité de développement
Les contraintes d’intégrité et notamment les clés étrangères sont parfois absentes des modèles de données. Les problématiques de performance et de flexibilité sont souvent mises en avant, alors que les contraintes sont justement une aide pour l’optimisation de requêtes par le planificateur, mais surtout une garantie contre de très coûteuses corruption de données logiques. L’absence de contraintes a souvent des conséquences catastrophiques.
Conséquences de l’absence de contraintes
Conséquences
problèmes d’intégrité des données
fonctions de vérification de cohérence des données
Les contraintes sont utiles à l’optimiseur :
déterminent l’unicité des valeurs
éradiquent des lectures de tables inutiles sur des LEFT JOIN
utilisent les contraintes CHECK pour exclure une partition
De plus, l’absence de contraintes va également entraîner des problèmes d’intégrité des données. Il est par exemple très compliqué de se prémunir efficacement contre une race condition 3 en l’absence de clé étrangère. Imaginez le scénario suivant :
la transaction x1 s’assure que la donnée est présente dans la table t1 ;
la transaction x2 supprime la donnée précédente dans la table t1 ;
la transaction x1 insère une ligne dans la table t2 faisant référence à la ligne de t1 qu’elle pense
encore présente. Ce cas est très facilement gérable pour un moteur de base de donnée si une clé étrangère existe. Redévelopper ces mêmes contrôles dans la couche applicative sera toujours plus coûteux en terme de performance, voire impossible à faire dans certains cas sans passer par la base de donnée elle-même (multiples serveurs applicatifs accédant à la même base de donnée). 3 Situation où deux sessions ou plus modifient des données en tables au même moment.
Il peut s’ensuivre des calculs d’agrégats faux et des problèmes applicatifs de toute sorte. Souvent, plutôt que de corriger le modèle de données, des fonctions de vérification de la cohérence des données seront mises en place, entraînant ainsi un travail supplémentaire pour trouver et corriger les incohérences. Lorsque ces problèmes d’intégrité seront détectés, il s’en suivra également la création de procédures de vérification de cohérence des données qui vont aussi alourdir les développements, entraînant ainsi un travail supplémentaire pour trouver et corriger les incohérences. Ce qui a été gagné d’un côté est perdu de l’autre, mais sous une forme différente. De plus, les contraintes d’intégrité sont des informations qui garantissent non seulement la cohérence des données mais qui vont également influencer l’optimiseur dans ses choix de plans d’exécution. Parmi les informations utilisées par l’optimiseur, les contraintes d’unicité permettent de déterminer sans difficulté la répartition des valeurs stockées dans une colonne : chaque valeur est simplement unique. L’utilisation des index sur ces colonnes sera donc probablement favorisée. Les contraintes d’intégrité permettent également à l’optimiseur de pouvoir éliminer des jointures inutiles avec un
tures sur certaines partitions seulement, et donc d’exclure les partitions inutiles.
Suspension des contraintes le temps d’une transaction
Solution :
- contraintes DEFERRABLE !
Parfois, les clés étrangères sont supprimées simplement parce que des transactions sont en erreur car des données sont insérées dans une table fille sans avoir alimenté la table mère. Des identifiants de clés étrangères de la table fille sont absents de la table mère, entraînant l’arrêt en erreur de la transaction. Il est possible de contourner cela en différant la vérification des contraintes d’intégrité à la fin de la transaction Une contrainte DEFERRABLE associée à un SET CONSTRAINT … DEFERRED n’est vérifiée que lors du
ou insérer temporairement des données incohérentes. Ce qui compte est que la situation soit saine à la fin de la transaction, quand les données seront enregistrées et deviendront visibles par les autres sessions. L’exemple ci-dessous montre l’utilisation de la vérification des contraintes d’intégrité en fin de transaction.
ADD CONSTRAINT fk_mere_fille FOREIGN KEY (mere_id) REFERENCES mere (id) MATCH FULL
La transaction insère d’abord les données dans la table fille, puis ensuite dans la table mère :
Sans le SET CONSTRAINTS ALL DEFERRED , le premier ordre serait tombé en erreur.
Stockage Entité-Clé-Valeur
Entité-Attribut-Valeur (ou Entité-Clé-Valeur)
Quel but ?
flexibilité du modèle de données
adapter sans délai ni surcoût le modèle de données
Conséquences :
création d’une table : identifiant / nom_attribut / valeur
requêtes abominables et coûteuses
Le modèle relationnel a été critiqué depuis sa création pour son manque de souplesse pour ajouter de nouveaux attributs ou pour proposer plusieurs attributs sans pour autant nécessiter de redévelopper l’application. La solution souvent retenue est d’utiliser une table « à tout faire » entité-attribut-valeur qui est associée à une autre table de la base de données. Techniquement, une telle table comporte trois colonnes. La première est un identifiant généré qui permet de référencer la table mère. Les deux autres colonnes stockent le nom de l’attribut représenté et la valeur représentée. Ainsi, pour reprendre l’exemple des informations de contacts pour un individu, une table personnes permet de stocker un identifiant de personne. Une table personne_attributs permet d’associer des données à un identifiant de personne. Le type de données de la colonne est souvent prévu largement pour faire tenir tout type d’informations, mais sous forme textuelle. Les données ne peuvent donc pas être validées.
Un tel modèle peut sembler souple mais pose plusieurs problèmes. Le premier concerne l’intégrité des données. Il n’est pas possible de garantir la présence d’un attribut comme on le ferait avec une contrainte NOT NULL . Si l’on souhaite stocker des données dans un autre format qu’une chaîne de caractère, pour bénéficier des contrôles de la base de données sur ce type, la seule solution est de
créer autant de colonnes d’attributs qu’il y a de types de données à représenter. Ces colonnes ne permettront pas d’utiliser des contraintes CHECK pour garantir la cohérence des valeurs stockées avec ce qui est attendu, car les attributs peuvent stocker n’importe quelle donnée.
Stockage Entité-Clé-Valeur : exemple
Comment lister tous les DBA ?
id_pers nom_attr val_attr
1 nom Prunelle 1 prenom Léon 1 telephone 0123456789 1 fonction dba
Stockage Entité-Clé-Valeur : requête associée
Les requêtes SQL qui permettent de récupérer les données requises dans l’application sont également particulièrement lourdes à écrire et à maintenir, à moins de récupérer les données attribut par attribut.
Des problèmes de performances vont donc très rapidement se poser. Cette représentation des données entraîne souvent l’effondrement des performances d’une base de données relationnelle. Les requêtes sont difficilement optimisables et nécessitent de réaliser beaucoup d’entrées-sorties disque, car les données sont éparpillées un peu partout dans la table.
Stockage Entité-Clé-Valeur, hstore, JSON
Solutions :
revenir sur la conception du modèle de données
utiliser un type de données plus adapté : hstore , jsonb
On économise jointures et place disque.
Lorsque de telles solutions sont déployées pour stocker des données transactionnelles, il vaut mieux revenir à un modèle de données traditionnel qui permet de typer correctement les données, de mettre en place les contraintes d’intégrité adéquates et d’écrire des requêtes SQL efficaces. Dans d’autres cas où le nombre de champs est vraiment élevé et variable, il vaut mieux utiliser un type de données de PostgreSQL qui est approprié, comme hstore qui permet de stocker des données sous la forme clé->valeur . On conserve ainsi l’intégrité des données (on n’a qu’une ligne par personne), on évite de très nombreuses jointures source d’erreurs et de ralentissements, et même de la place disque. De plus, ce type de données peut être indexé pour garantir de bons temps de réponses des requêtes qui nécessitent des recherches sur certaines clés ou certaines valeurs. Voici l’exemple précédent revu avec l’extension hstore :
| id | attributs |
|---|---|
| 1 | “nom”=>“Prunelle”, “prenom”=>“Léon” |
| 2 | “nom”=>“Lagaffe”, “prenom”=>“Gaston” |
| 3 | “nom”=>“DeMaesmaker” |
| id | prenom |
|---|---|
| 1 | Léon |
| 2 | Gaston |
| 3 |
| id | nom |
|---|---|
| 1 | Prunelle |
| 2 | Lagaffe |
| 3 | DeMaesmaker |
Le principe du JSON est similaire.
Attributs multicolonnes
Pourquoi
stocker plusieurs attributs pour une même ligne
exemple : les différents numéros de téléphone d’une personne
Pratique courante
ex : telephone_1 , telephone_2
Conséquences
et s’il faut rajouter encore une colonne?
maîtrise de l’unicité des valeurs?
requêtes complexes à maintenir
Solutions
créer une table dépendante
ou un type tableau
Dans certains cas, le modèle de données doit être étendu pour pouvoir stocker des données complémentaires. Un exemple typique est une table qui stocke les informations pour contacter une personne. Une table personnes ou contacts possède une colonne telephone qui permet de stocker le numéro de téléphone d’une personne. Or, une personne peut disposer de plusieurs numéros. Le premier réflexe est souvent de créer une seconde colonne telephone_2 pour stocker un numéro de téléphone complémentaire. S’en suit une colonne telephone_3 voire telephone_4 en fonction des besoins. Dans de tels cas, les requêtes deviennent plus complexes à maintenir et il est difficile de garantir l’unicité des valeurs stockées pour une personne car l’écriture des contraintes d’intégrité devient de plus en plus complexe au fur et à mesure que l’on ajoute une colonne pour stocker un numéro. La solution la plus pérenne pour gérer ce cas de figure est de créer une table de dépendance qui est dédiée au stockage des numéros de téléphone. Ainsi, la table personnes ne portera plus de colonnes telephone , mais une table telephones portera un identifiant référençant une personne et un numéro de téléphone. Ainsi, si une personne dispose de trois, quatre… numéros de téléphone, la table telephones comportera autant de lignes qu’il y a de numéros pour une personne.
Les différents numéros de téléphone seront obtenus par jointure entre la table personnes et la table telephones . L’application se chargera de l’affichage.
Ci-dessous, un exemple d’implémentation du problème où une table telephones dans laquelle plusieurs numéros seront stockés sur plusieurs lignes plutôt que dans plusieurs colonnes.
L’unicité des valeurs sera garantie à l’aide d’une contrainte d’unicité posée sur l’identifiant per_id et le numéro de téléphone. Une autre solution consiste à utiliser un tableau pour représenter cette information. D’un point de vue conceptuel, le lien entre une personne et son ou ses numéros de téléphone est plus une « composition » qu’une réelle « relation » : le numéro de téléphone ne nous intéresse pas en tant que tel, mais uniquement en tant que détail d’une personne. On n’accédera jamais à un numéro de téléphone séparément : la table telephones donnée plus haut n’a pas de clé « naturelle », un simple rattachement à la table personnes par l’identifiant de la personne. Sans même parler de partitionnement, on gagnerait donc en performances en stockant directement les numéros de téléphone dans la table personnes , ce qui est parfaitement faisable sous PostgreSQL :
| per_id | nom | pnom | numero |
|---|---|---|---|
| 1 | Simpson | Omer | {0607080910} |
| per_id | nom | pnom | numero |
|---|---|---|---|
| 1 | Simpson | Omer | {0607080910,0102030420} |
| per_id | nom | pnom | numero |
|---|
| Colonne 1 | Colonne 2 | Colonne 3 | Colonne 4 |
|---|---|---|---|
| 1 | Simpson | Omer | 0607080910 |
| 1 | Simpson | Omer | 0102030420 |
Nombreuses lignes de peu de colonnes
Énormément de lignes, peu de colonnes
Cas typique : séries temporelles
Volumétrie augmentée par les entêtes
Regrouper les valeurs dans un ARRAY ou un type composite
Partitionner
Certaines applications, typiquement celles récupérant des données temporelles, stockent peu de colonnes (parfois juste date, capteur, valeur…) mais énormément de lignes. Dans le modèle MVCC de PostgreSQL, chaque ligne utilise au bas mot 23 octets pour stocker xmin , xmax et les autres informations de maintenance de la ligne. On peut donc se retrouver avec un overhead représentant la majorité de la table. Cela peut avoir un fort impact sur la volumétrie :
Il est parfois possible de regrouper les valeurs sur une même ligne au sein d’un ARRAY , ici pour chaque seconde :
Dans cet exemple, on économise la plupart des entêtes de ligne, mais aussi les données redondantes (la date), et le coût de l’alignement des champs. Avec suffisamment de valeurs à stocker, une partie des données peut même se retrouver compressée dans la partie TOAST de la table. La récupération des données se fait de manière à peine moins simple :
L’indexation des valeurs à l’intérieur du tableau nécessite un index GIN :
Évidemment cette technique est à réserver aux cas où les données mises en tableau sont insérées et mises à jour ensemble. Le maniement des tableaux est détaillé dans la documentation officielle 4 . Tout cela est détaillé et mesuré dans ce billet de Julien Rouhaud 5 . Il évoque aussi le cas de structures plus complexes : au lieu d’un hstore ou d’un ARRAY , on peut utiliser un type qui regroupe les différentes valeurs. Une autre option, complémentaire, est le partitionnement. Il peut être géré manuellement (tables générées par l’applicatif, par date et/ou par source de données…) ou profiter des deux modes de partitionnement de PostgreSQL. Il n’affectera pas la volumétrie totale mais permet de gérer des partitions plus maniables. Il a aussi l’intérêt de ne pas nécessiter de modification du code pour lire les données.
4 https://www.postgresql.org/docs/current/static/arrays.html 5 https://rjuju.github.io/postgresql/2016/09/16/minimizing-tuple-overhead.html
Tables aux très nombreuses colonnes
Tables à plusieurs dizaines, voire centaines de colonnes :
Les entités sont certainement trop grosses dans la modélisation
Il y a probablement dépendance entre certaines colonnes (Only the key)
On accède à beaucoup d’attributs inutiles (tout est stocké au même endroit)
Il arrive régulièrement de rencontrer des tables ayant énormément de colonnes (souvent à NULL d’ailleurs). Cela signifie qu’on modélise une entité ayant tous ces attributs (centaines d’attributs). Il est très possible que cette entité soit en fait composée de « sous-entités », qu’on pourrait modéliser séparément. On peut évidemment trouver des cas particuliers contraires, mais une table de ce type reste un bon indice. Surtout si vous trouvez dans les dernières colonnes des attributs comme attribut_supplementaire_1 …
Choix d’un type numérique
Pour : représenter des valeurs décimales
Pratique courante :
real ou double ( float )
money
… erreurs d’arrondis!
Solution :
numeric pour les calculs précis (financiers notamment)
Certaines applications scientifiques se contentent de types flottants standards, car ils permettent d’encoder des valeurs plus importantes que les types entiers standards. En pratique, les types float(x) correspondent aux types real ou double precision de PostgreSQL.
Néanmoins, les types flottants sont peu précis, notamment pour les applications financières où une erreur d’arrondi n’est pas tolérable. Par exemple :
Le type numeric est alors généralement conseillé. Sa valeur est exacte et les calculs sont justes.
numeric (sans autre indication de précision) autorise même un calcul exact sans arrondi avec des ordres de grandeur très différents; comme SELECT 1e9999 + 1e-9999 ; . Paradoxalement, le type money n’est pas adapté aux montants financiers : sa manipulation implique de convertir en numeric pour éviter des erreurs d’arrondis. Autant utiliser directement numeric : si l’on ne mentionne pas la précision, elle est exacte.
Le type numeric paye sa précision par un stockage parfois plus important et par des calculs plus lents que ceux des types natifs comme les intX et les floatX . Pour plus de détails, voir la documentation officielle :
types à virgule flottante 6 ;
type monétaire 7 ;
type à prévision arbitraire 8 .
6 https://docs.postgresql.fr/current/datatype-numeric.html#DATATYPE-FLOAT 7 https://docs.postgresql.fr/current/datatype-money.html 8 https://docs.postgresql.fr/current/datatype-numeric.html#DATATYPE-NUMERIC-DECIMAL
Colonne de type variable
Plus rarement, on rencontre aussi :
Une colonne de type varchar contenant
quelquefois un entier
quelquefois une date
un NULL
une chaîne autre
etc.
À éviter comme la peste!
Plusieurs sens = plusieurs champs
On rencontre parfois ce genre de choses :
Immatriculation Camion Numero de tournee
TP-108-AX 12 TF-112-IR ANNULÉE
avec bien sûr une table tournée décrivant la tournée elle-même, avec une clé technique numérique. Cela pose un gros problème de modélisation : la colonne a un type de contenu qui dépend de l’information qu’elle contient. On va aussi avoir un problème de performance en joignant cette chaîne à la clé numérique de la table tournée . Le moteur n’aura que deux choix : convertir la chaîne en numérique, avec une exception à la clé en essayant de convertir « ANNULÉE », ou bien (ce qu’il fera) convertir le numérique de la table tournee en chaîne. Cette dernière méthode rendra l’accès à l’identifiant de tournée par index impossible. D’où un parcours complet (Seq Scan) de la table tournée à chaque accès et des performances qui décroissent au fur et à mesure que la table grossit. La solution est une supplémentaire (un booléen tournee_ok par exemple). Un autre classique est le champ date stocké au format texte. Le format correct de cette date ne peut être garanti par la base, ce qui mène systématiquement à des erreurs de conversion si un humain est impliqué. Dans un environnement international où l’on mélange DD-MM-YYYY et MM-DD-YYYY, un rattrapage manuel est même illusoire. Les calculs de date sont évidemment impossibles.
Problèmes courants d’écriture de requêtes
Utilisation de NULL
Ordre implicite des colonnes
Requêtes spaghetti
Moteur de recherche avec LIKE
Le langage SQL est généralement méconnu, ce qui amène à l’écriture de requêtes peu performantes, voire peu pérennes.
NULL
NULL signifie habituellement :
Valeur non renseignée
Valeur inconnue
Absence d’information
Une table remplie de NULL est habituellement signe d’un problème de modélisation.
NOT NULL recommandé
Une table qui contient majoritairement des valeurs NULL contient bien peu de faits utilisables. La plupart du temps, c’est une table dans laquelle on stocke beaucoup de choses n’ayant que peu de rapport entre elles, les champs étant renseignés suivant le type de chaque « chose ». C’est donc le plus souvent un signe de mauvaise modélisation. Cette table aurait certainement dû être éclatée en plusieurs tables, chacune représentant une des relations qu’on veut modéliser. Il est donc recommandé que tous les attributs d’une table portent une contrainte NOT NULL . Quelques colonnes peuvent ne pas porter ce type de contraintes, mais elles doivent être une exception. En effet, le comportement de la base de données est souvent source de problèmes lorsqu’une valeur NULL entre en jeu. Par exemple, la concaténation d’une chaîne de caractères avec une valeur NULL retourne une valeur NULL , car elle est propagée dans les calculs. D’autres types de problèmes apparaissent également pour les prédicats. Il faut avoir à l’esprit cette citation de Chris Date :
« La valeur NULL telle qu’elle est implémentée dans SQL peut poser plus de problèmes qu’elle n’en résout. Son comportement est parfois étrange et est source de nombreuses erreurs et de confusions. »
Il ne ne s’agit pas de remplacer ce NULL par des valeurs « magiques » (par exemple -1 pour « Non renseigné » , cela ne ferait que complexifier le code) mais de se demander si NULL a une vraie signification.
Ordre implicite des colonnes
Objectif
s’économiser d’écrire la liste des colonnes dans une requête
Problèmes
si l’ordre des colonnes change, les résultats changent
résultats faux
données corrompues
Solutions
nommer les colonnes impliquées
Le langage SQL permet de s’appuyer sur l’ordre physique des colonnes d’une table. Or, faire confiance à la base de données pour conserver cet ordre physique peut entraîner de graves problèmes applicatifs en cas de changements. Dans le meilleur des cas, l’application ne fonctionnera plus, ce qui permet d’éviter les corruptions de données silencieuses, où une colonne prend des valeurs destinées normalement à être stockées dans une autre colonne. Si l’application continue de fonctionner, elle va générer des résultats faux et des incohérences d’affichage. Par exemple, l’ordre des colonnes peut changer notamment lorsque certains ETL sont utilisés pour modifier le type d’une colonne varchar(10) en varchar(11) . Par exemple, pour la colonne username , l’ETL Kettle génère les ordres suivants :
Il génère des ordres SQL inutiles et consommateurs d’entrées/sorties disques car il doit générer des ordres SQL compris par tous les SGBD du marché. Or, tous les SGBD ne permettent pas de changer le type d’une colonne aussi simplement que dans PostgreSQL. PostgreSQL, lui, ne permet pas de changer l’ordre d’apparition des colonnes. C’est pourquoi il est préférable de lister explicitement les colonnes dans les ordres INSERT et
Exemples Exemple de modification du schéma pouvant entraîner des problèmes d’insertion si les colonnes ne sont pas listées explicitement :
| id | col1 | col2 |
|---|---|---|
| 1 | XX | 10 |
| id | col2 | col1 |
|---|---|---|
| 1 | 10 | XX |
| 2 | 10 | XXX |
L’utilisation de SELECT * à la place d’une liste explicite est une erreur similaire. Le nombre de colonnes peut brutalement varier. De plus, toutes les colonnes sont rarement utilisées dans un tel cas, ce qui provoque un gaspillage de ressources.
Code spaghetti
Le problème est similaire à tout autre langage :
Code spaghetti pour le SQL
Écriture d’une requête à partir d’une autre requête
Ou évolution d’une requête au fil du temps avec des ajouts
Non optimisable
Vite ingérable
Ne pas la patcher!
Ne pas hésiter à reprendre la requête à zéro, en repensant sa sémantique
Souvent, un changement de spécification est un changement de sens, au niveau relationnel, de la requête
Un exemple (sous Oracle) :
Codelec.libelle AS Codelec_40_2, Codelec.niveau1 AS Codelec_40_3, Codelec.niveau2 AS Codelec_40_4, Codelec.niveau3 AS Codelec_40_5, Codelec.niveau4 AS Codelec_40_6, PerimetreActivite.code AS PerimetreActivite_41_0, DonneesPersonnalisablesCodelec.gestionreftech AS DonneesPersonnalisab_42_0, ClassificationArticleInterne.id AS ClassificationArticl_43_0, ClassificationArticleInterne.niveau1 AS ClassificationArticl_43_2, DossierCommercial.id AS DossierCommercial_52_0, DossierCommercial.codefourndc AS DossierCommercial_52_1, DossierCommercial.anneedc AS DossierCommercial_52_3, DossierCommercial.codeclassdc AS DossierCommercial_52_4, DossierCommercial.numversiondc AS DossierCommercial_52_5, DossierCommercial.indice AS DossierCommercial_52_6, DossierCommercial.code_ss_classement AS DossierCommercial_52_7, OrigineNegociation.code AS OrigineNegociation_53_0, MotifBlocageInformation.libellelong AS MotifBlocageInformat_54_3, ArbreLogistique.id AS ArbreLogistique_63_1, ArbreLogistique.codesap AS ArbreLogistique_63_5, Fournisseur.code AS Fournisseur_66_0, Fournisseur.nom AS Fournisseur_66_2, Filiere.code AS Filiere_67_0, Filiere.nom AS Filiere_67_2, ValorisationAchat.val_ach_patc AS Valorisation_74_3, LienPrixVente.code AS LienPrixVente_76_0, LienPrixVente.datem AS LienPrixVente_76_1, LienGratuite.code AS LienGratuite_78_0, LienGratuite.datem AS LienGratuite_78_1, LienCoordonnable.code AS LienCoordonnable_79_0, LienCoordonnable.datem AS LienCoordonnable_79_1, LienStatistique.code AS LienStatistique_81_0, LienStatistique.datem AS LienStatistique_81_1
index_clerecherche
ClassificationArticleInterne.id left join da_artdeno ArticleDenormalise
SEARCHMC.rn = 1 AND ( ValorisationAchat.id IS NULL OR ValorisationAchat.date_debut_achat = (
Comprendre un tel monstre implique souvent de l’imprimer pour acquérir une vision globale et prendre des notes :
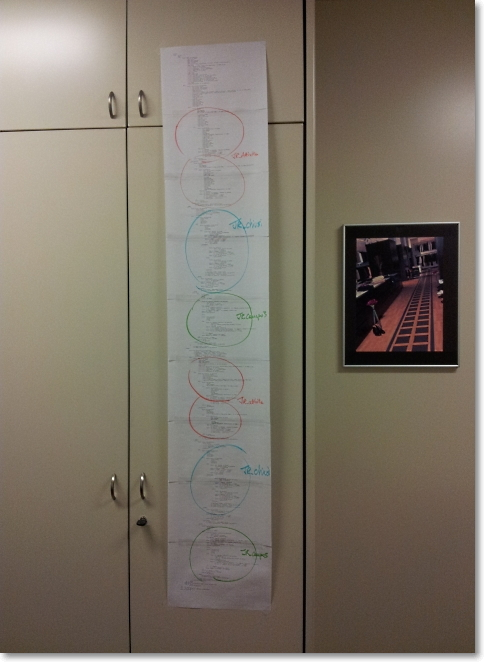
Ce code a été généré initialement par Hibernate, puis édité plusieurs fois à la main.
Recherche textuelle
Objectif
ajouter un moteur de recherche à l’application
Pratique courante
utiliser l’opérateur LIKE
Problèmes
requiert des index spécialisés
recherche uniquement le terme exact
Solutions
pg_trgm
Full Text Search
Les bases de données qui stockent des données textuelles ont souvent pour but de permettre des recherches sur ces données textuelles. La première solution envisagée lorsque le besoin se fait sentir est d’utiliser l’opérateur LIKE . Il permet en effet de réaliser des recherches de motif sur une colonne stockant des données textuelles. C’est une solution simple et qui peut s’avérer simpliste dans de nombreux cas. Tout d’abord, les recherches de type LIKE ‘%motif%’ ne peuvent généralement pas tirer partie d’un index btree normal. Cela étant dit, l’extension pg_trgm permet d’optimiser ces recherches à l’aide d’un index GiST ou GIN. Elle fait partie des extensions standard et ne nécessite pas d’adaptation du code. Exemples L’exemple ci-dessous montre l’utilisation du module pg_trgm pour accélérer une recherche avec LIKE ‘%motif%’ :
Mais cette solution n’offre pas la même souplesse que la recherche plein texte, en anglais Full Text Search, de PostgreSQL. Elle est cependant plus complexe à mettre en œuvre et possède une syntaxe spécifique.
Conclusion
La base est là pour vous aider
Le modèle relationnel doit être compris et appliqué
Avant de contourner un problème, chercher s’il n’existe pas une fonctionnalité
dédiée
Quiz
Travaux pratiques
La version en ligne des solutions de ces TP est disponible sur https://dali.bo/s65_solutions. Ce TP utilise les tables voitures et voitures_ecv .
Si vous n’avez pas déjà une base voitures, les deux tables voitures et voitures_ecv peuvent être téléchargées installées comme suit :
Ne pas oublier d’effectuer un VACUUM ANALYZE .
Normalisation de schéma
But : Normaliser un schéma de données.
La table voitures viole la première forme normale (attribut répétitif, non atomique). De plus elle n’a pas de clé primaire.
Renommer la table en voitures_orig . \ Ne pas la supprimer (nous en aurons besoin plus tard).
Écrire des requêtes permettant d’éclater cette table en trois tables : \ voitures , caracteristiques et caracteristiques_voitures . \ (La fonction regexp_split_to_table permettra de séparer les champs de caractéristiques.)
Mettre en place les contraintes d’intégrité : clé primaire sur chaque table, et clés étrangères. \ Ne pas prévoir encore d’index supplémentaire. \ Attention : la table de départ contient des immatriculations en doublon!
Tenter d’insérer une Clio avec les caractéristiques « ABS » (majusucules) et « phares LED ».
Comparer les performances entre les deux modèles pour une recherche des voitures ayant un toit ouvrant.
Les plans sont-ils les mêmes si la caractéristique recherchée n’existe pas?
Indexer la colonne de clé étrangère caracteristiques_voitures.carateristique et voir ce que devient le plan de la dernière requête.
Rechercher une voitures possédant les 3 options ABS, toit ouvrant et 4 roues motrices, et voir le plan.
Entité-clé-valeur
But : Manipuler des données au format entité/clé/valeur.
Une autre version de la table voiture existe aussi dans cette base au format « entité/clé/valeur » c’est la table voitures_ecv . Sa clé primaire est entite (immatriculation) / cle (caractéristique). En pratique il n’y a que des booléens.
Afficher toutes les caractéristiques d’une voiture au hasard (par exemple ZY-745-KT).
Trouver toutes les caractéristiques de toutes les voitures ayant un toit ouvrant dans voitures_ecv . Trier par immatriculation. Quel est le plan d’exécution?
hstore est une extension qui permet de stocker des clés/valeur dans un champ. Sa documentation est sur le site du projet 9 .
Installer l’extension hstore . \ Convertir cette table pour qu’elle utilise une ligne par immatriculation, avec les caractéristiques dans un champ hstore . \ Une méthode simple est de récupérer les lignes d’une même immatriculation avec la fonction array_agg puis de convertir simplement en champ hstore .
Rechercher la voiture précédente.
Insérer une voiture avec les caractéristiques couleur=>vert et phares=>LED .
Définir un index de type GiST sur ce champ hstore . \ Retrouver la voiture insérée par ses caractéristiques. 9 https://docs.postgresql.fr/current/hstore.html
Indexation de champs tableau
But : Indexer un champ tableau pour améliorer les performances.
Il est possible, si on peut réécrire la requête, d’obtenir de bonnes performances avec la première table voitures_orig . En effet, PostgreSQL sait indexer des tableaux et des fonctions. Il saurait donc indexer un tableau résultat d’une fonction sur le champ caracteristiques .
Trouver cette fonction dans la documentation de PostgreSQL (chercher dans les fonctions de découpage de chaîne de caractères).
Définir un index fonctionnel sur le résultat de cette fonction, de type GIN.
Rechercher toutes les voitures avec toit ouvrant et voir le plan.
Pagination et index
But : Effectuer une requête avec pagination
La pagination est une fonctionnalité que l’on retrouve de plus en plus souvent, surtout depuis que les applications web ont pris une place prépondérante. Nous allons utiliser une version simplifiée d’une table de forum. Si vous ne l’avez pas déjà, la table posts (dump de 358 Mo, 758 Mo sur disque) peut être téléchargée et restaurée ainsi :
Ne pas oublier d’effectuer ensuite un VACUUM ANALYZE . Nous voulons afficher le plus rapidement possible les messages (posts) associés à un article : les 10 premiers, puis du 11 au 20, etc. Nous allons examiner les différentes stratégies possibles. La table contient 5 000 articles de 1000 posts, d’au plus 200 signes. La description de la table est :
| Colonne | Type | Collationnement | NULL-able | Par défaut |
|---|---|---|---|---|
| id_article | integer | |||
| id_post | integer | |||
| ts | timestamp with time zone | |||
| message | text |
Index : “posts_ts_idx” btree (ts)
Pour la clarté des plans, désactiver le JIT et le parallélisme dans votre session :
Écrire une requête permettant de récupérer les 10 premiers posts de l’article d’ id_article = 12 , triés dans l’ordre de id_post . Il n’y a pas d’index, la requête va être très lente.
Créer un index permettant d’améliorer cette requête.
Utiliser les clauses LIMIT et OFFSET pour récupérer les 10 posts suivants. Puis du post 901 au 921. Que constate-t-on sur le plan d’exécution?
Trouver une réécriture de la requête pour trouver directement les posts 901 à 911 une fois connu le post 900 récupéré au travers de la pagination.
Clauses WHERE et pièges
But : Mise en évidence de cas piégeux dans les clauses WHERE.
Nous utilisons toujours la table posts . Nous allons maintenant manipuler le champ ts , de type timestamp . Ce champ est indexé.
La requête
retourne tous les enregistrements de février 2013. Examiner son plan d’exécution. Où est le problème?
Réécrire la clause WHERE avec une inégalité de dates pour utiliser l’index sur ts .
Plus compliqué : retourner tous les posts ayant eu lieu un dimanche, en 2013, en passant par un index et en une seule requête. (Indice : il est possible de générer la liste de tous les dimanches de l’année 2013 avec : generate_series(‘2013-01-06 00:00:00’,‘2014-01-01 00:00:00’, INTERVAL ‘7 days’) )
On cherche un article à peu près au tiers de la liste avec la requête suivante. Pourquoi est-elle si lente?
Travaux pratiques (solutions)
Normalisation de schéma
Renommer la table en voitures_orig . \ Ne pas la supprimer (nous en aurons besoin plus tard).
Écrire des requêtes permettant d’éclater cette table en trois tables : \ voitures , caracteristiques et caracteristiques_voitures . \ (La fonction regexp_split_to_table permettra de séparer les champs de caractéristiques.)
| Schéma | Nom | Type | Propriétaire | … | Taille | … |
|---|---|---|---|---|---|---|
| public | caracteristiques | table | postgres | 48 kB | ||
| public | caracteristiques_voitures | table | postgres | 3208 kB | ||
| public | voitures | table | postgres | 5160 kB | ||
| public | voitures_ecv | table | postgres | 3336 kB | ||
| public | voitures_orig | table | postgres | 5736 kB |
Mettre en place les contraintes d’intégrité : clé primaire sur chaque table, et clés étrangères. \ Ne pas prévoir encore d’index supplémentaire. \ Attention : la table de départ contient des immatriculations en doublon!
Sur caracteristiques_voitures , la clé primaire comprend les deux colonnes, et donc interdit qu’une même caractéristique soit présente deux fois sur la même voiture :
Clé étrangère de cette table vers les deux autres tables :
Tenter d’insérer une Clio avec les caractéristiques « ABS » (majusucules) et « phares LED ».
En toute rigueur il faut le faire dans une transaction :
Évidemment, cela échoue :
En cas d’erreur, c’est exactement ce que l’on veut. Pour que l’insertion fonctionne, il faut corriger la casse de « ABS » et déclarer la nouvelle propriété :
Comparer les performances entre les deux modèles pour une recherche des voitures ayant un toit ouvrant.
La version la plus simple est :
Plus rigoureusement ( [[:>:]] et [[:<:]] indiquent des frontières de mots.), on préférera :
Toute la table a été parcourue, 91 642 lignes ont été rejetées, 8358 retenues (~8 %). Les estimations statistiques sont correctes. NB : pour la lisibilité, les plans n’utilisent pas l’option BUFFERS d’ EXPLAIN . Si on l’active, on pourra vérifier que tous les accès se font bien dans le cache de PostgreSQL ( shared hits ). Avec le nouveau schéma on peut écrire la requête simplement avec une simple jointure :
Il n’y a pas doublement de lignes si une caractéristique est en double car la clé primaire l’interdit. Sans cette contrainte, une autre écriture serait nécessaire :
Dans les deux cas, on obtient ce plan 10 :
10 https://explain.dalibo.com/plan/lz
Le temps d’exécution est ici plus court malgré un parcours complet de voitures . PostgreSQL prévoit correctement qu’il ramènera 10 % de cette table, ce qui n’est pas si discriminant et justifie fréquemment un Seq Scan , surtout que voitures est petite. caracteristiques_voitures est aussi parcourue entièrement : faute d’index, il n’y a pas d’autre moyen.
Les plans sont-ils les mêmes si la caractéristique recherchée n’existe pas?
Si on cherche une option rare ou n’existant pas, le plan change 11 :
Avec un seul résultat attendu, ce qui est beaucoup plus discriminant, l’utilisation de l’index sur voitures devient pertinente.
Avec l’ancien schéma, on doit toujours lire la table voitures_orig en entier.
Indexer la colonne de clé étrangère caracteristiques_voitures.carateristique et voir ce que devient le plan de la dernière requête. 11 https://explain.dalibo.com/plan/Hij
Le plan d’exécution 12 devient foudroyant, puisque la table caracteristiques_voitures n’est plus intégralement lue :
Avec voitures_orig , il existerait aussi des méthodes d’indexation mais elles sont plus lourdes (index GIN…).
Rechercher une voitures possédant les 3 options ABS, toit ouvrant et 4 roues motrices, et voir le plan.
Si on recherche plusieurs options en même temps, l’optimiseur peut améliorer les choses en prenant en compte la fréquence de chaque option pour restreindre plus efficacement les recherches. Le plan devient 13 :
12 https://explain.dalibo.com/plan/577 13 https://explain.dalibo.com/plan/O0H
Ce plan parcoure deux index, joins leurs résultats, fait de même avec le résultat de l’index pour la 3è caractéristique, puis opère la jointure finale avec la table principale par l’index sur immatriculation (un plan complet indiquerait une estimation de 56 lignes de résultat, même si le résultat final est de 461 lignes). Mais les problématiques de performances ne sont pas le plus important dans ce cas. Ce qu’on gagne réellement, c’est la garantie que les caractéristiques ne seront que celles existant dans la table caractéristique , ce qui évite d’avoir à réparer la base plus tard.
Entité-clé-valeur
Afficher toutes les caractéristiques d’une voiture au hasard (par exemple ZY-745-KT).
| entite | cle | valeur |
|---|---|---|
| ZY-745-KT | climatisation | t |
| ZY-745-KT | jantes aluminium | t |
| ZY-745-KT | regulateur de vitesse | t |
| ZY-745-KT | toit ouvrant | t |
Trouver toutes les caractéristiques de toutes les voitures ayant un toit ouvrant dans voitures_ecv . Trier par immatriculation. Quel est le plan d’exécution?
Autrement dit : on sélectionne toutes les voitures avec un toit ouvrant, et l’on veut toutes les caractéristiques de ces voitures. Cela nécessite d’appeler deux fois la table.
Là encore une jointure de la table avec elle-même sur entite serait possible, mais serait dangereuse dans les cas où il y a énormément de propriétés. On préférera encore la version avec EXISTS , et PostgreSQL en fera spontanément une jointure 14 :
Installer l’extension hstore . \ Convertir cette table pour qu’elle utilise une ligne par immatriculation, avec les caractéristiques dans un champ hstore . \ Une méthode simple est de récupérer les lignes d’une même immatriculation avec la fonction array_agg puis de convertir simplement en champ hstore .
hstore est normalement présente sur toutes les installations (ou alors l’administrateur a négligé d’installer le paquet contrib ). Il suffit donc d’une déclaration.
14 https://explain.dalibo.com/plan/nn2
Rechercher la voiture précédente.
| Colonne 1 | Colonne 2 |
|---|---|
| immatriculation | ZY-745-KT |
| caracteristiques | “toit ouvrant”=>“true”, “climatisation”=>“true”, |
| “jantes aluminium”=>“true”, “regulateur de vitesse”=>“true” |
L’accès à une caractéristique se fait ainsi (attention aux espaces) :
Insérer une voiture avec les caractéristiques couleur=>vert et phares=>LED .
Définir un index de type GiST sur ce champ hstore . \ Retrouver la voiture insérée par ses caractéristiques.
Les index B-tree classiques sont inadaptés aux types complexes, on préfère donc un index GiST :
L’opérateur @> signifie « contient » :
Indexation de champs tableau
Trouver cette fonction dans la documentation de PostgreSQL (chercher dans les fonctions de découpage de chaîne de caractères).
La fonction est regexp_split_to_array (sa documentation est sur https://docs.postgresql.fr/15/functions-matching.html) :
| immatriculation | modele | regexp_split_to_array |
|---|---|---|
| WW-649-AI | twingo | {“regulateur de vitesse”} |
| QZ-533-JD | clio | {“4 roues motrices”,“jantes aluminium”} |
| YY-854-LE | megane | {climatisation} |
| QD-761-QV | twingo | {""} |
| LV-277-QC | megane | {abs,“jantes aluminium”} |
| ZI-003-BQ | kangoo | {“boite automatique”,climatisation} |
| WT-817-IK | megane | {""} |
| JK-791-XB | megane | {""} |
| WW-019-EK | megane | {""} |
| BZ-544-OS | twingo | {""} |
La syntaxe {} est la représentation texte d’un tableau.
Définir un index fonctionnel sur le résultat de cette fonction, de type GIN.
Rechercher toutes les voitures avec toit ouvrant et voir le plan.
Noter que les estimations de statistiques sont plus délicates sur un résultat de fonction.
Pagination et index
Écrire une requête permettant de récupérer les 10 premiers posts de l’article d’ id_article = 12 , triés dans l’ordre de id_post . Il n’y a pas d’index, la requête va être très lente.
Le plan 15 est un parcours complet de la table, rejetant 4 999 000 lignes et en gardant 1000 lignes, suivi d’un tri :
Créer un index permettant d’améliorer cette requête.
Un index sur id_article améliorerait déjà les choses. Mais comme on trie sur id_post , il est intéressant de rajouter aussi cette colonne dans l’index :
Testons cet index :
Le plan 16 devient :
15 https://explain.dalibo.com/plan/xEs 16 https://explain.dalibo.com/plan/Fgy
C’est beaucoup plus rapide : l’index trouve tout de suite les lignes de l’article cherché, et retourne les enregistrements directement triés par id_post . On évite de parcourir toute la table, et il n’y a même pas d’étape de tri (qui serait certes très rapide sur 10 lignes).
Utiliser les clauses LIMIT et OFFSET pour récupérer les 10 posts suivants. Puis du post 901 au 921. Que constate-t-on sur le plan d’exécution?
Les posts 11 à 20 se trouvent rapidement :
Tout va bien. La requête est à peine plus coûteuse. Noter que l’index a ramené 20 lignes et non 10. À partir du post 900 :
Le plan 17 reste similaire :
17 https://explain.dalibo.com/plan/V05
Cette requête est 4 fois plus lente. Si une exécution unitaire ne pose pas encore problème, des demandes très répétées poseraient problème. Noter que l’index ramène 910 lignes ! Dans notre exemple idéalisée, les posts sont bien rangés ensemble, et souvent présents dans les mêmes blocs. C’est très différent dans une table qui beaucoup vécu.
Trouver une réécriture de la requête pour trouver directement les posts 901 à 911 une fois connu le post 900 récupéré au travers de la pagination.
Pour se mettre dans la condition du test, récupérons l’enregistrement 900 :
| id_article | id_post |
|---|---|
| 12 | 12900 |
(La valeur retournée peut différer sur une autre base.) Il suffit donc de récupérer les 10 articles pour lesquels id_article = 12 et id_post > 12900 :
Nous sommes de retour à des temps d’exécution très faibles. Ajouter la condition sur le id_post permet de limiter à la source le nombre de lignes à récupérer. L’index n’en renvoie bien que 10.
L’avantage de cette technique par rapport à l’offset est que le temps d’une requête ne variera que l’on chercher la première ou la millième page. L’inconvénient est qu’il faut mémoriser l’ id_post où l’on s’est arrêté sur la page précédente.
Clauses WHERE et pièges
Nous allons maintenant manipuler le champ ts (de type timestamp ) de la table posts .
La requête
retourne tous les enregistrements de février 2013. Examiner son plan d’exécution. Où est le problème?
Le plan 18 est un parcours complet de la table :
C’est normal : PostgreSQL ne peut pas deviner que to_char(ts,‘YYYYMM’)=‘201302’ veut dire « toutes les dates du mois de février 2013 ». Une fonction est pour lui une boîte noire, et il ne voit pas le lien entre le résultat attendu et les données qu’il va lire. Ceci est une des causes les plus habituelles de ralentissement de requêtes : une fonction est appliquée à une colonne, ce qui rend le filtre incompatible avec l’utilisation d’un index.
Réécrire la clause WHERE avec une inégalité de dates pour utiliser l’index sur ts .
C’est à nous d’indiquer une clause WHERE au moteur qu’il puisse directement appliquer sur notre date :
18 https://explain.dalibo.com/plan/ATT
Le plan 19 montre que l’index est maintenant utilisable :
Noter la conversion automatique du critère en timestamp with time zone .
Plus compliqué : retourner tous les posts ayant eu lieu un dimanche, en 2013, en passant par un index et en une seule requête. (Indice : il est possible de générer la liste de tous les dimanches de l’année 2013 avec : generate_series(‘2013-01-06 00:00:00’,‘2014-01-01 00:00:00’, INTERVAL ‘7 days’) )
Construisons cette requête morceau par morceau. Listons tous les dimanches de 2013 (le premier dimanche est le 6 janvier) :
S’il faut calculer le premier dimanche de l’année, cela peut se faire ainsi :
19 https://explain.dalibo.com/plan/GDY
| debut | fin |
|---|---|
| 2013-01-06 00:00:00+01 | 2013-01-07 00:00:00+01 |
| 2013-01-13 00:00:00+01 | 2013-01-14 00:00:00+01 |
| Colonne 1 | Colonne 2 |
|---|---|
| 2013-12-29 00:00:00+01 | 2013-12-30 00:00:00+01 |
Il ne nous reste plus qu’à joindre ces deux ensembles. Comme clause de jointure, on teste la présence de la date du post dans un des intervalles des dimanches :
Le plan 20 devient :
PostgreSQL génère les 52 lignes d’intervalles (noter qu’il ne sait pas estimer le résultat de cette fonction), puis fait 52 appels à l’index (noter le loops=52 ). C’est efficace. Attention : des inéqui-jointures entraînent forcément des nested loops (pour chaque ligne d’une table, on va chercher les lignes d’une autre table). Sur de grands volumes, ce ne peut pas être efficace. Ici, tout va bien parce que la liste des dimanches est raisonnablement courte.
On cherche un article à peu près au tiers de la liste avec la requête suivante. Pourquoi est-elle si lente?
20 https://explain.dalibo.com/plan/nN5
Le plan 21 est :
Ce plan indique une recherche du numéro d’article maximal (il est dans l’index; noter que PostgreSQL restreint à une valeur non vide), puis il calcule la valeur correspondant au tiers et la met dans $1 . Tout ceci est rapide. La partie lente est le Seq Scan pour retrouver cette valeur, avec un filtre et non par l’index. Le problème est visible sur le filtre même :
(id_article)::numeric signifie que tous les id_article (des entiers) sont convertis en numeric pour ensuite être comparés au résultat (InitPlan 2).col1 . Or une conversion est une fonction, ce qui rend l’index inutilisable. En fait, notre problème est que (InitPlan 2).col1 n’est pas un entier!
| Column | Type |
|---|---|
| ?column? | numeric |
La conversion du critère en int peut se faire à plusieurs endroits. Par exemple :
21 https://explain.dalibo.com/plan/6GI
Et l’index est donc utilisable immédiatement :
Si l’on avait fait le calcul avec / 3 au lieu de * 0.333 , on n’aurait pas eu le problème, car la division de deux entiers donne un entier. Attention donc à la cohérence des types dans vos critères. Le problème peut se rencontrer même en joignant des int et des bigint !
Travaux pratiques et solutions
Les pages de travaux pratiques et leurs solutions sont conservées dans le manuel complet, pages PDF 458-479.
Pour poursuivre la lecture, voir le chapitre suivant. Pour revenir au chapitre précédent, voir le chapitre précédent.