2 Patroni : Architecture
Patroni : Architecture
Note :
Au menu
- Patroni
- Réplication PostgreSQL
- DCS
Note :
Ce module est une introduction à Patroni. Il permet de découvrir quels sont ses pré-requis, les différents éléments nécessaires, leur rôle et leurs interactions.
Les prochains chapitres abordent Patroni lui-même, son rapport avec la réplication PostgreSQL et sa dépendance à un DCS.
Patroni
- Un démon
patronipar instance PostgreSQL - Les démons patroni coopèrent entre eux
- Chaque démon administre son instance PostgreSQL locale
- et impose de passer par lui
Note :
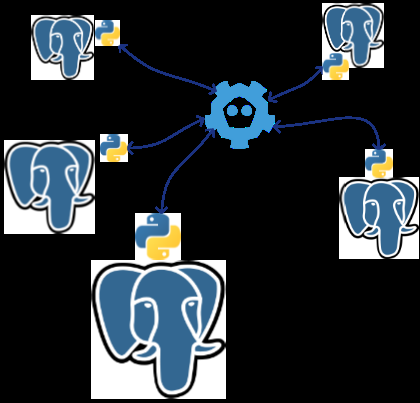
Patroni est un gestionnaire de cluster PostgreSQL, capable d’en assurer la haute disponibilité de service. Il maintient l’agrégat en condition opérationnelle, le supervise et provoque une bascule automatique en cas d’incident.
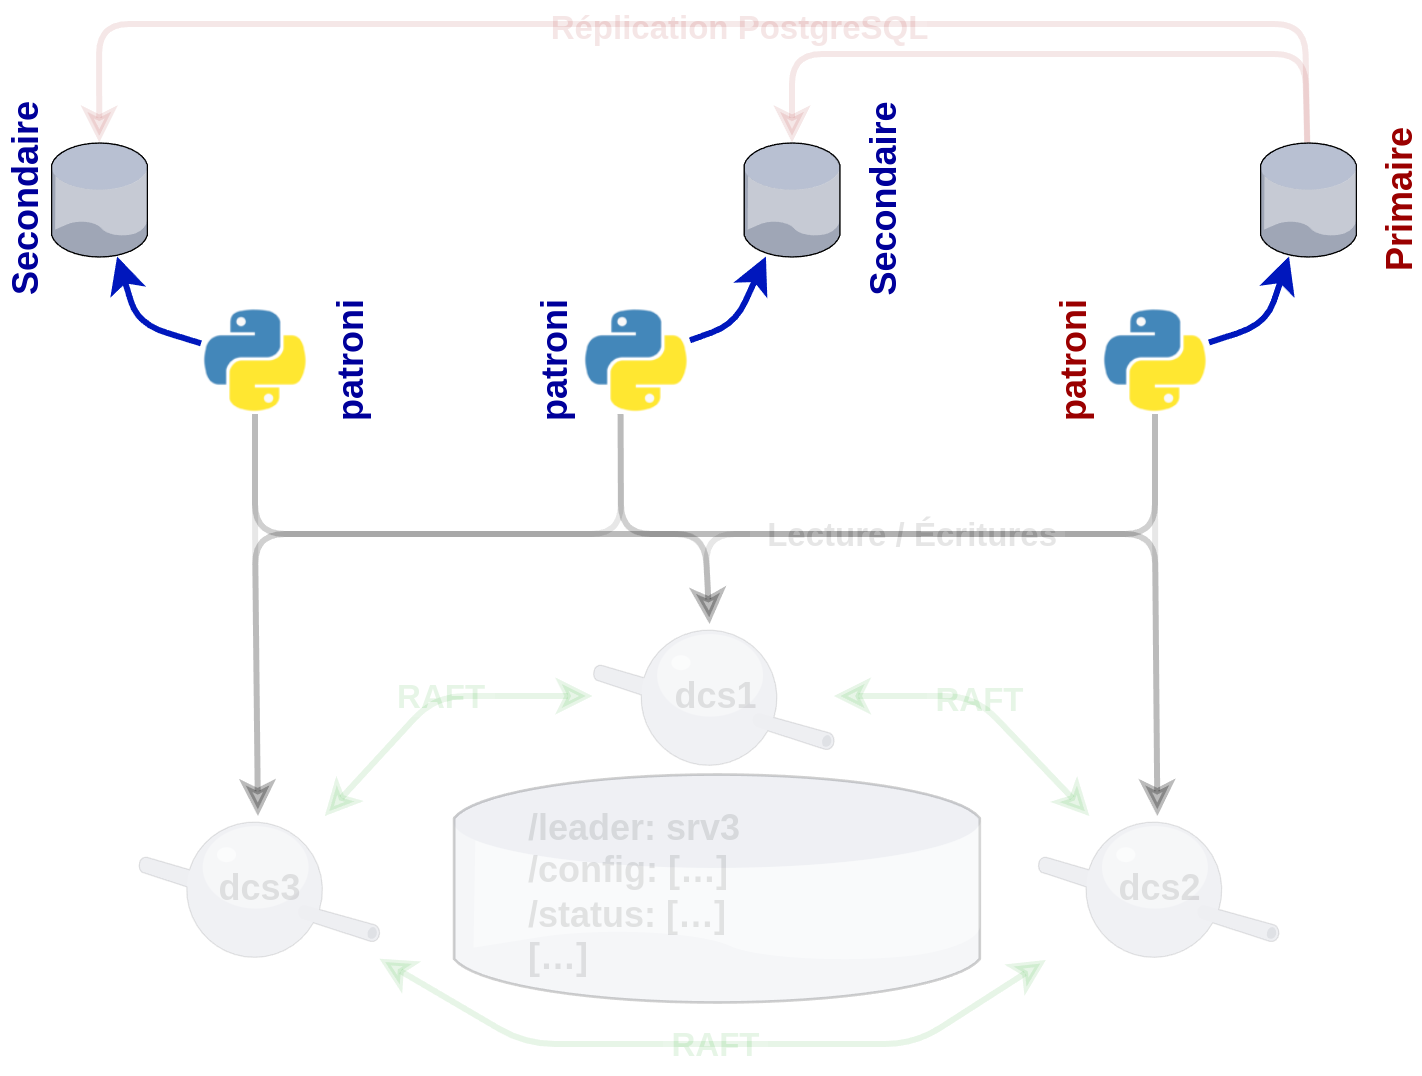
Patroni est en réalité lui-même un agrégat : chaque instance PostgreSQL du cluster est contrôlée par son propre démon patroni, écrit en python. Tous ces démons surveillent les évènements au sein de l’agrégat et coopèrent pour maintenir le service disponible.
Chaque démon patroni a la responsabilité de créer, configurer, démarrer, superviser, arrêter, promouvoir ou rétrograder son instance locale, en fonction des évènements détectés au sein du cluster.
L’application des modifications de la configuration de PostgreSQL est effectuée par Patroni qui se charge de la répercuter sur tous les nœuds.
Attention :
Le démarrage et l’arrêt du service PostgreSQL sur chaque nœud ne doivent plus être gérés par le système et doivent être désactivés. Toutes les actions de maintenances (arrêt, démarrage, rechargement de configuration, promotion) doivent être faites en utilisant Patroni plutôt que les moyens traditionnels (pg_ctl, systemctl, etc).
Réplication PostgreSQL
Patroni configure la réplication physique entre les instances pour :
- assurer la réplication des données
- en mode synchrone et/ou asynchrone
- aussi en cascade
- maintenir la réplication après bascule
Note :
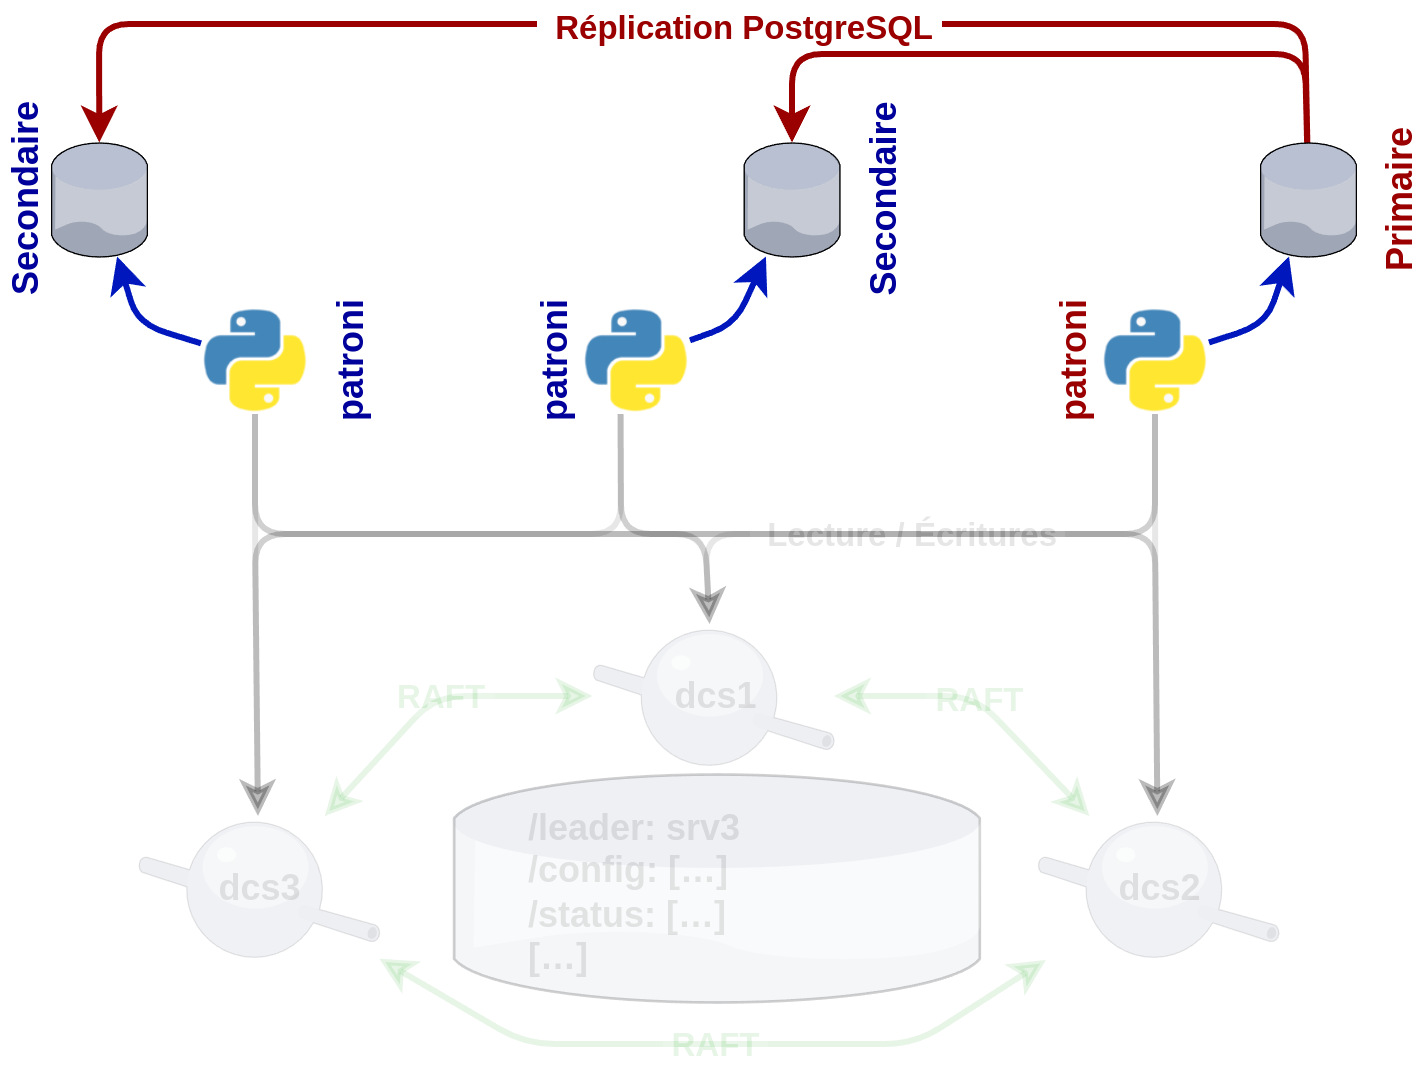
Patroni se base sur la réplication physique native de PostgreSQL pour assurer la haute disponibilité des données. Maîtrisant la création et configuration des instances, il est capable d’assurer automatiquement la mise en œuvre de cette réplication.
Patroni configure et maintient cette réplication physique en mode synchrone ou asynchrone, avec ou sans cascade de réplication, en fonction de la configuration demandée.
Suite à une bascule, il reconfigure automatiquement les secondaires afin que ceux-ci se reconnectent au nouveau primaire.
Optionnellement, il est aussi capable de resynchroniser un ancien primaire en tant que secondaire suite à un incident.
Pour effectuer ces différentes opérations, il s’appuie sur des outils fournis avec PostgreSQL comme pg_basebackup et pg_rewind pour construire ou reconstruire une instance secondaire. Mais cette capacité est encore étendue grâce à la possibilité d’utiliser des outils de la communauté comme barman, pgbackrest ou wal-g.
DCS
- Stockage distribué par consensus
- écritures distribuées et atomiques
- source de vérité de l’agrégat
- hautement disponible
Note :
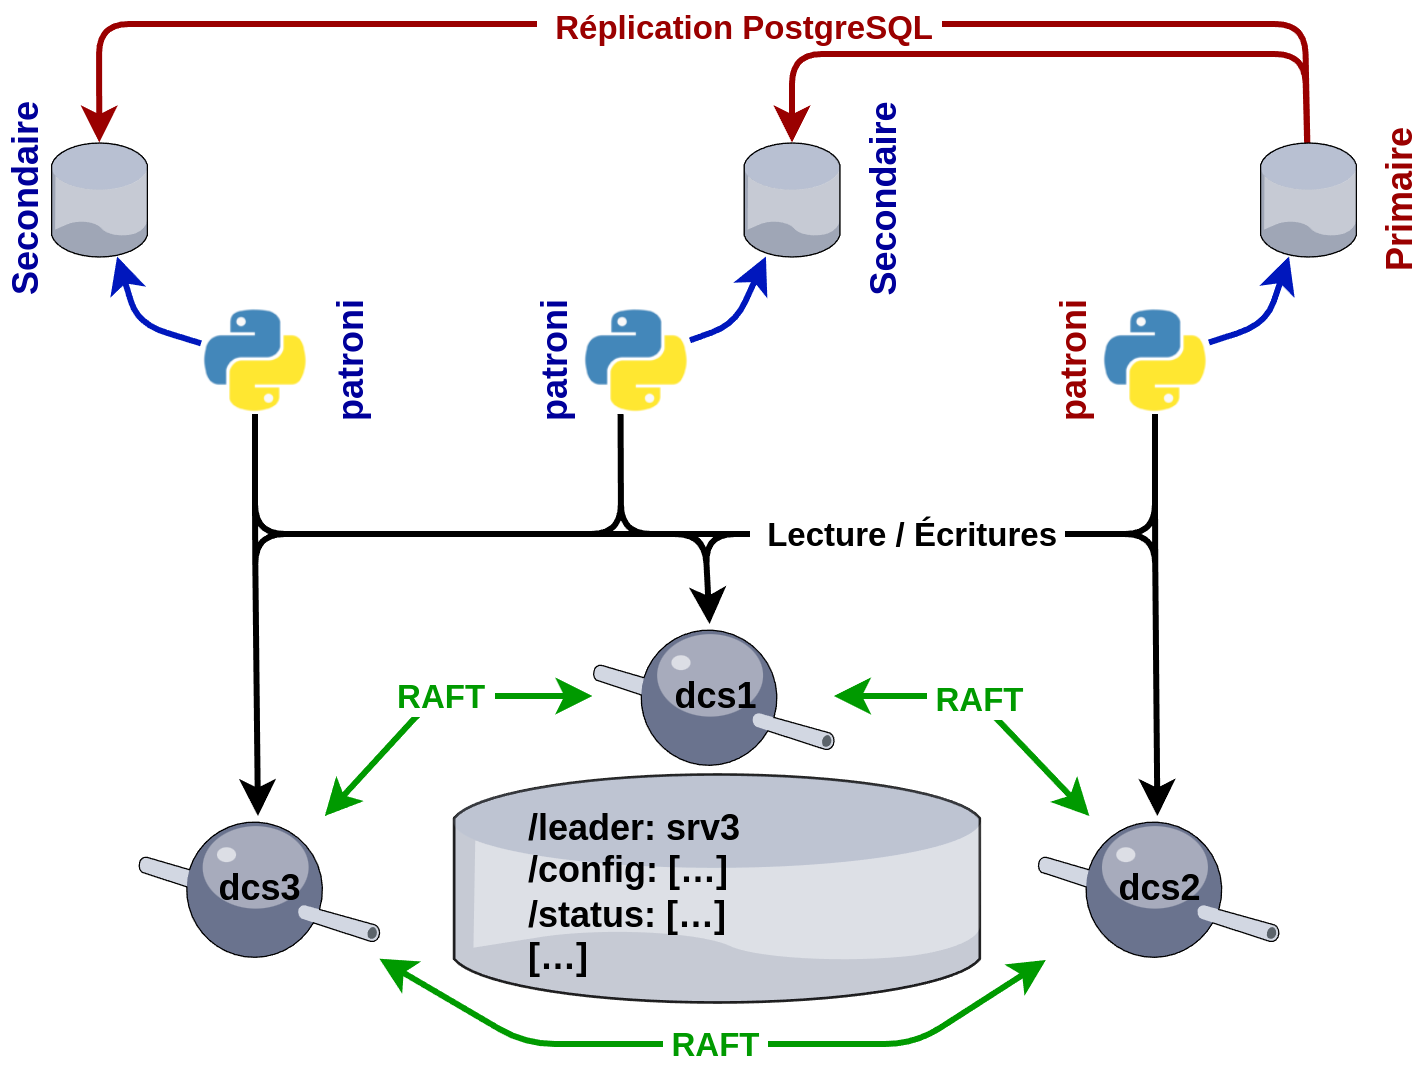
Les démons patroni s’appuient sur un stockage de données distribué (DCS, Distributed Consensus Store (ou parfois Distributed Configuration Store)) pour partager l’état des nœuds et leur configuration au sein du cluster.
Par exemple les processus Patroni y écrivent lequel d’entre eux est le leader, pouvant héberger l’instance primaire PostgreSQL. Ils reposent sur les fonctionnalités du DCS qui assurent des écritures atomiques et homogènes au sein du cluster, empêchant toute race condition et donc que les démons patroni ne voient des valeurs différentes.
Le DCS est la « source de vérité » du cluster, le notaire arbitrant de façon fiable et officielle le leader du cluster. Les processus patroni lui font entièrement confiance et respectent scrupuleusement les informations qu’ils y trouvent.
À tel point que par défaut, si le leader Patroni ne peut plus joindre le DCS, il rétrograde immédiatement son instance locale en secondaire. Si cette opération échoue ou est trop longue, il est même capable de déclencher un reset du serveur.
Le but étant la haute disponibilité, le DCS ne doit pas devenir un SPoF (single point of failure). Il doit donc lui aussi être déployé en agrégat afin d’assurer une tolérance aux pannes et une disponibilité maximale du service.
Patroni supporte plusieurs DCS différents, s’adaptant ainsi au mieux à l’environnement dans lequel il est déployé. En voici une liste à titre indicatif : etcd (v2 ou v3), Consul, Zookeeper, Exhibitor et Kubernetes.
Deux grappes de serveurs
Note :
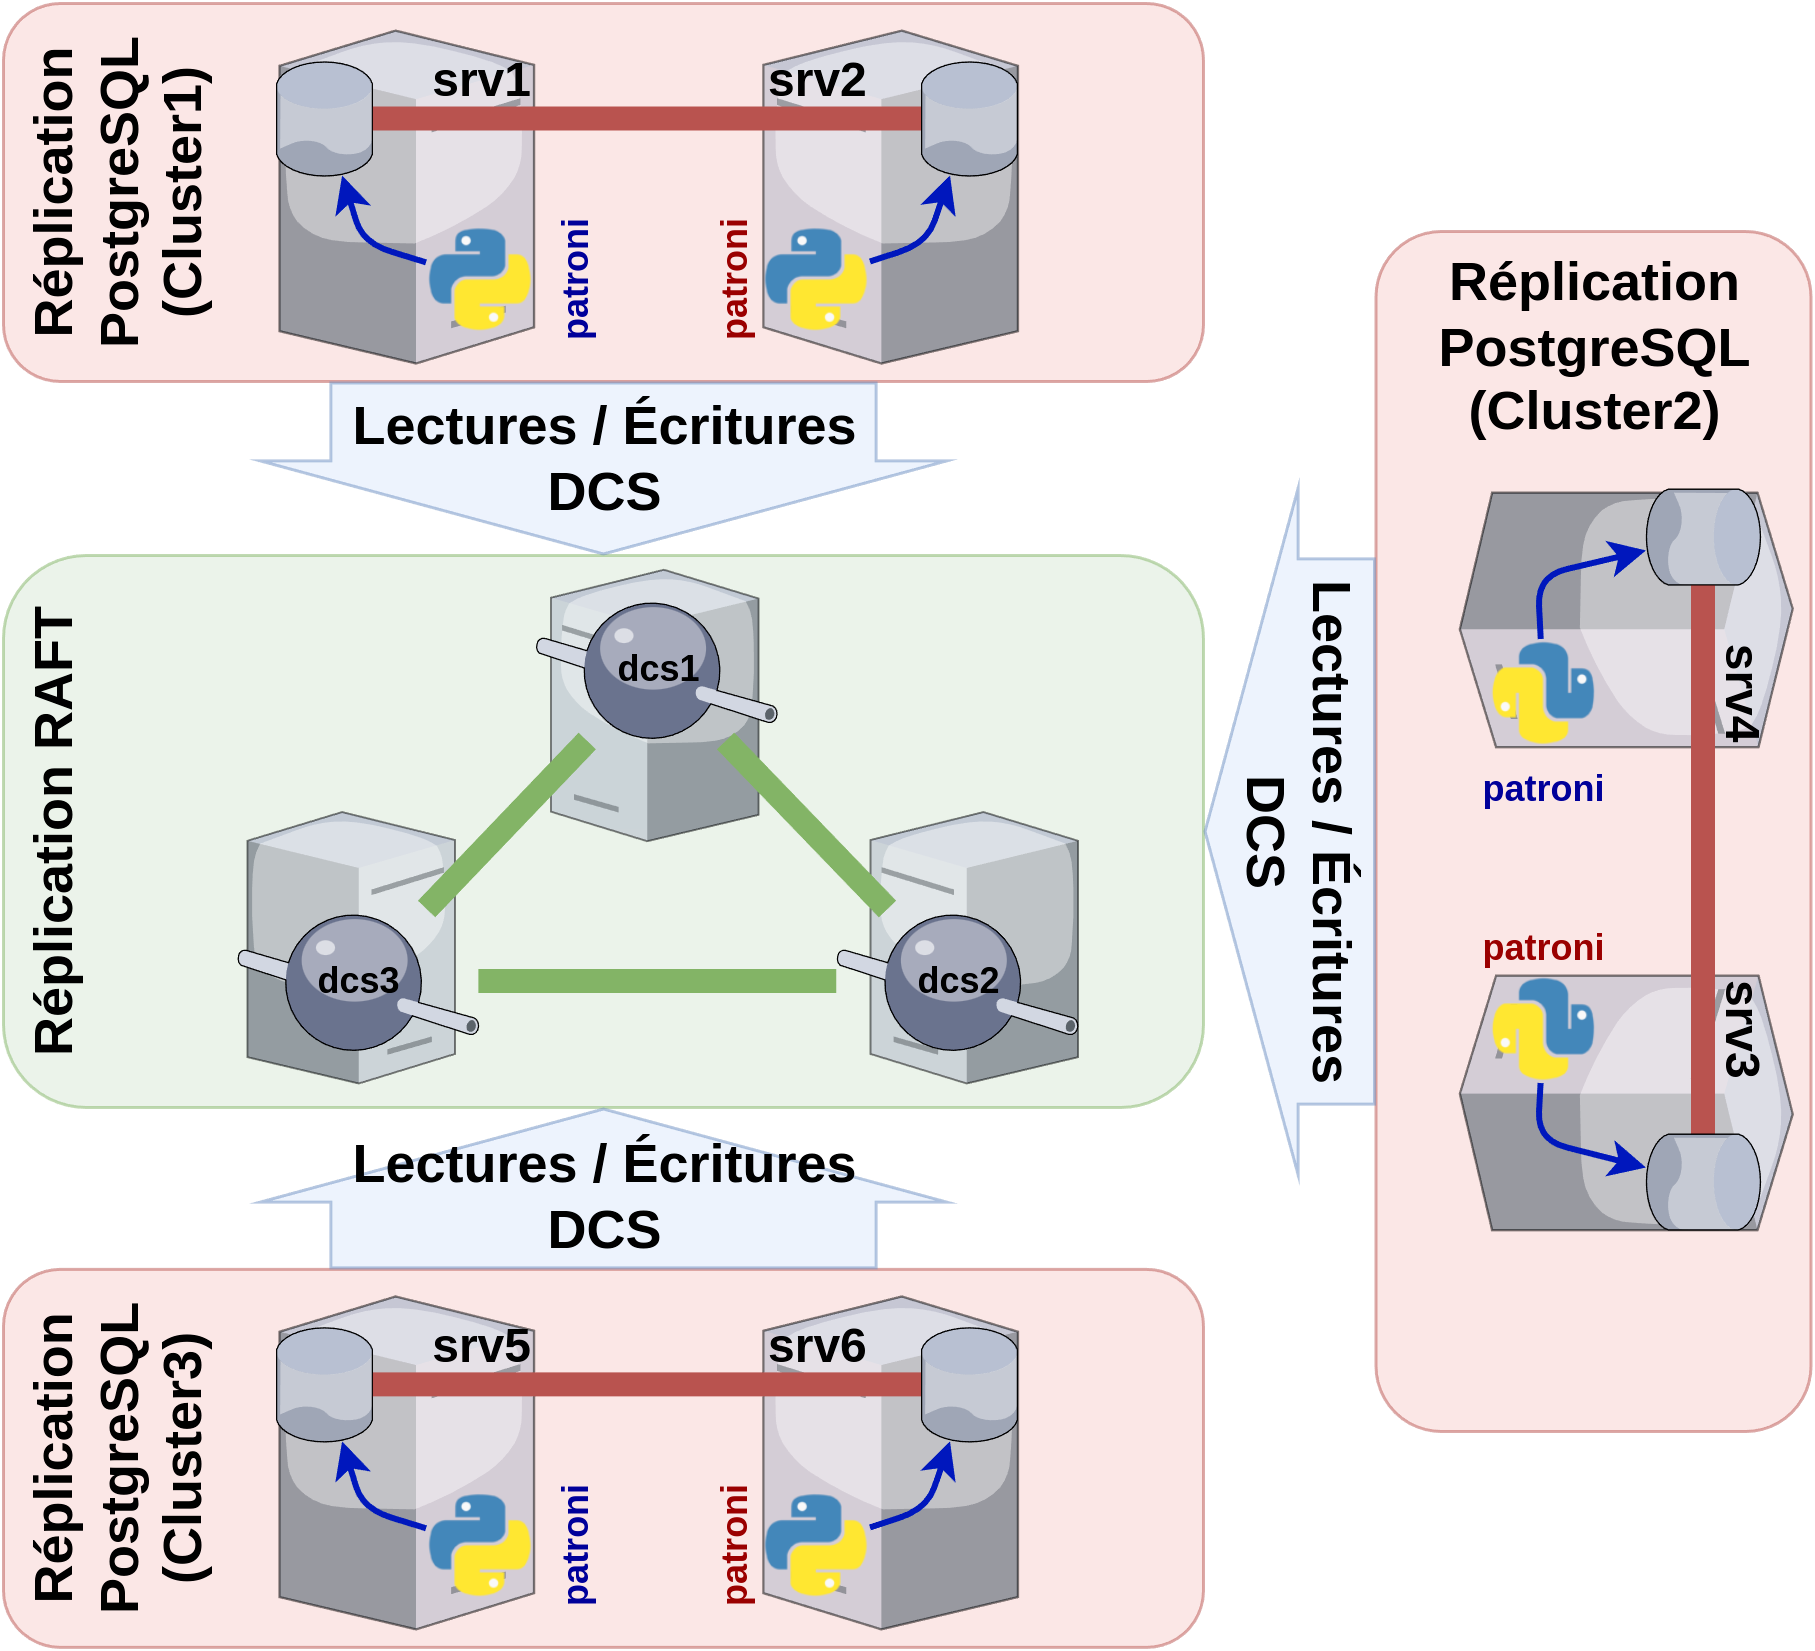
Ce schéma présente les deux types d’agrégats :
- un unique agrégat de trois serveurs minimum héberge les démons DCS ;
- plusieurs agrégats PostgreSQL indépendants hébergent les démons patroni et leur instance PostgreSQL respective (2 instances minimum).
Conseil :
Un cluster Patroni/PostgreSQL est client du cluster DCS. Un même cluster DCS peut gérer plusieurs clusters Patroni/PostgreSQL différents.
Ces clusters ont des outils, procédures et maintenances différentes qu’il faut comprendre en détail, documenter et superviser. Différents modules de formation abordent chacun des services de cette architecture :
- un module de rappel concernant la réplication de PostgreSQL ;
- un module dédié au DCS etcd ;
- un module dédié à Patroni lui-même.
Questions
- C’est le moment !
Note :
Quiz
Note :
Pour poursuivre, consultez le chapitre 3.
Pour revenir au chapitre précédent, consultez le chapitre 1.