1 Configuration du système et de l’instance
La première illustration de ce chapitre est la Figure 1-1.
1/ Configuration du système et de l’instance
1.1 INTRODUCTION
- L’optimisation doit porter sur les différents composants
- le serveur qui héberge le SGBDR : le matériel, la distribution, le noyau, les systèmes de fichiers
- le moteur de la base de données : postgresql.conf
- la base de données : l’organisation des fichiers de PostgreSQL
- l’application en elle-même : le schéma et les requêtes
Pour qu’une optimisation soit réussie, il faut absolument tenir compte de tous les éléments ayant une responsabilité dans les performances. Cela commence avec le matériel. Il ne sert à rien d’améliorer la configuration du serveur PostgreSQL ou les requêtes si, physiquement, le serveur ne peut tenir la charge, que cela soit la cause des processeurs, de la mémoire, du disque ou du réseau. Le matériel est donc un point important à vérifier dans chaque tentative d’optimisation. De même, le système d’exploitation est pour beaucoup dans les performances de PostgreSQL: son choix et sa configuration ne doivent pas être laissés au hasard. La configuration du moteur a aussi son importance et cette partie permettra de faire la liste des paramètres importants dans le seul cadre des performances. Même l’organisation des fichiers dans les partitions des systèmes disques a un intérêt. L’optimisation (aussi appelée tuning) doit donc être réalisée sur tous ces éléments à la fois pour être optimale!
1.1.1 Menu
- Quelques considérations générales sur l’optimisation
- Choix et configuration du matériel
- Choix et configuration du système d’exploitation
- Configuration du serveur de bases de données
- Outils
1.1.2 Considérations générales - 1
- Deux points déterminants :
- vision globale du système d’information
- compréhension de l’utilisation de la base
Il est très difficile d’optimiser un serveur de bases de données sans savoir comment ce dernier va être utilisé. Par exemple, le nombre de requêtes à exécuter simultanément et leur complexité est un
excellent indicateur pour mieux apprécier le nombre de cœurs à placer sur un serveur. Il est donc important de connaître la façon dont les applications travaillent avec les bases. Cela permet de mieux comprendre si le matériel est adéquat, s’il faut changer telle ou telle configuration, etc. Cela permet aussi de mieux configurer son système de supervision.
1.1.3 Considérations générales - 2
- L’optimisation n’est pas un processus unique
- il s’agit au contraire d’un processus itératif
- La base doit être surveillée régulièrement!
- nécessité d’installer des outils de supervision
Après avoir installé le serveur et l’avoir optimisé du mieux possible, la configuration optimale réalisée à ce moment ne sera bonne que pendant un certain temps. Si le service gagne en popularité, le nombre d’utilisateurs peut augmenter. La base va de toute façon grossir. Autrement dit, les conditions initiales vont changer. Un serveur optimisé pour 10 utilisateurs en concurrence ne le sera plus pour 50 utilisateurs en concurrence. La configuration d’une base de 10 Go n’est pas la même que celle d’une base de 1 To. Cette évolution doit donc être surveillée à travers un système de supervision et métrologie approprié et compris. Lorsqu’un utilisateur se plaint d’une impression de lenteur sur le système, ces informations collectées rendent souvent la tâche d’inspection plus rapide. Ainsi, l’identification du ou des paramètres à modifier, ou plus généralement des actions à réaliser pour corriger le problème, est plus aisée et repose sur une vision fiable et réelle de l’activité de l’instance. Le plus important est donc de bien comprendre qu’un SGBD ne s’optimise pas qu’une seule fois, mais que ce travail d’optimisation sera à faire plusieurs fois au fur et à mesure de la vie du serveur. À une échelle beaucoup plus petite, un travail d’optimisation sur une requête peut forcer à changer la configuration d’un paramètre. Cette modification peut faire gagner énormément sur cette requête… mais faire perdre encore plus sur les autres. Là aussi, tout travail d’optimisation doit être fait prudemment et ses effets surveillés sur une période représentative pour s’assurer que cette amélioration ne s’accompagne pas de quelques gros inconvénients.
1.2 MATÉRIEL
- Performances très liées aux possibilités du matériel et de l’OS
- 4 composants essentiels
- les processeurs
- la mémoire
- les disques
- le système disque (RAID, SAN)
PostgreSQL est un système qui se base fortement sur le matériel et le système d’exploitation. Il est donc important que ces deux composants soient bien choisis et bien configurés pour que PostgreSQL fonctionne de façon optimale pour les performances. Au niveau du matériel, les composants essentiels sont:
- les processeurs (CPU) ;
- la mémoire (RAM);
- les disques ;
- le système disque (carte RAID, baie SAN, etc.).
1.2.1 CPU
- Trois critères importants
- nombre de cœurs
- fréquence
- cache
- Privilégier
- le nombre de cœurs si le nombre de sessions parallèles est important
- ou la fréquence si les requêtes sont complexes
- 64 bits
PostgreSQL est un système multiprocessus. Chaque connexion d’un client est gérée par un processus, responsable de l’exécution des requêtes et du renvoi des données au client. Ces processus ne sont pas multithreadés. Par conséquent, chaque requête exécutée est généralement traitée par un seul processus, sur un cœur de processeur. Mais dans certains cas, d’autres processus peuvent intervenir sur la même requête pour utiliser d’autres cœurs. Lorsque la requête est en lecture seule (et dans quelques rares cas en écriture) et que la parallélisation est activée, ce processus peut être aidé le temps de l’exécution de certains nœuds par un ou plusieurs processus appelés workers. Les détails figurent plus loin.
Parallélisation mise à part, plus vous voulez pouvoir exécuter de requêtes en simultané, plus vous devez avoir de processeurs (ou plus exactement de cœurs). On considère habituellement qu’un cœur peut traiter de 1 à 20 requêtes simultanément. Cela dépend notamment beaucoup des requêtes, de leur complexité, de la quantité de données manipulée et retournée, etc. Il est donc essentiel de connaître le nombre de requêtes traitées simultanément pour le nombre d’utilisateurs connectés.
S’il s’agit d’une instance pour une application web, il y a de fortes chances que le nombre de requêtes (simples) en parallèle soit assez élevé. Dans ce contexte, il faut prévoir un grand nombre de cœurs ou de processeurs. Par contre, sur un entrepôt de données, il y a généralement peu d’utilisateurs, mais des requêtes complexes et gourmandes en ressources, sur de gros jeux de données, mais ces requêtes sont, à priori, facilement parallélisables. Il est alors possible d’opter pour des processeurs avec une fréquence plus élevée (qui ont souvent moins de cœurs), mais plus le système aura de cœurs, plus sa capacité à pouvoir paralléliser les requêtes qui s’y prêtent sera élevé. Ainsi, la fréquence (et donc la puissance) des processeurs est un point important à considérer. Il peut faire la différence pour des requêtes complexes: temps de planification réduit, calculs plus rapides donc plus de requêtes exécutées sur une période de temps donnée.
Généralement, un système utilisé pour des calculs (financiers, scientifiques, géographiques) a intérêt à avoir des processeurs à fréquence élevée.
Le cache processeur est une mémoire généralement petite, mais excessivement rapide et située au plus près du processeur. Il en existe plusieurs niveaux. Tous les processeurs ont un cache de niveau L2, certains ont même un cache de niveau L3. Plus cette mémoire est importante, plus le processeur peut conserver de données utiles et éviter des allers-retours en mémoire RAM coûteux en temps. Le gain en performance pouvant être important, le mieux est de privilégier les processeurs avec beaucoup de cache.
Le choix processeur se fait donc suivant le type d’utilisation du serveur:
- une majorité de petites requêtes en très grande quantité : privilégier le nombre de cœurs;
- une majorité de grosses requêtes en très petite quantité : privilégier la fréquence du processeur.
Dans tous les cas, choisissez la version des processeurs avec le plus de mémoire cache embarquée.
La question 32 bits/64 bits ne se pose plus: il n’existe pratiquement plus que du 64 bits. De plus, les processeurs 64 bits sont naturellement plus performants pour traiter des données sur 8 octets ( bigint, double precision, numeric, timestamps, etc.) qui tiennent dans un registre mémoire.
Il existe une autre question qui ne se pose plus tellement: vaut-il mieux Intel ou AMD? cela a très peu d’importance. AMD a une grande maîtrise des systèmes multicœurs, et Intel est souvent puissant et optimisé sur les échanges avec la mémoire. Cela pourrait être des raisons de les sélectionner, mais la différence devient de plus en plus négligeable de nos jours.
1.2.2 RAM
- Essentielle pour un serveur de bases de données
- Plus il y en a, mieux c’est
- moins d’accès disque
- Pour le système comme pour PostgreSQL
Toute opération sur les données doit se faire en mémoire. Il est donc nécessaire qu’une bonne partie de la base tienne en mémoire, ou tout du moins la partie active. La partie passive est rarement présente en mémoire, car généralement composée de données historiques qui sont peu ou pas lues et jamais modifiées. Un cache disque permet de limiter les accès en lecture et écriture vers les disques. L’optimisation des accès aux disques est ainsi intimement liée à la quantité de mémoire physique disponible. Par conséquent, plus il y a de mémoire, mieux c’est. Cela permet de donner un cache disque plus important à PostgreSQL, tout en laissant de la place en mémoire aux sessions pour traiter les données (faire des calculs de hachage par exemple). Il est à noter que, même avec l’apparition des disques SSD, l’accès à une donnée en mémoire est bien plus rapide qu’une donnée sur disque. Nous aborderons ce point dans le chapitre consacré aux disques.
1.2.3 Disques
Technologie Temps d’accès Débit en lecture approx.
| RAM | ~ 1 ns | ~ 25 Go/s |
|---|---|---|
| NVMe | ~ 10 μs | ~ 10 Go/s |
| SSD (SATA) | ~ 100 μs | ~ 550 Mo/s |
| HDD SAS 15ktpm | ~ 1 ms | ~ 100 Mo/s |
| HDD SATA | ~ 5 ms | ~ 100 Mo/s |
| NAS/SAN | ?? | ?? |
Les chiffres ci-dessus ne sont que des ordres de grandeurs: la technologie évolue constamment et les valeurs maximum montent sans cesse. Il existe actuellement plusieurs types de disques:
- disques magnétiques SATA, dont la principale qualité est d’être peu chers, mais surtout disponibles en très gros volume;
- disques magnétiques SAS : rapides, fiables, mais chers;
- disques SSD : très rapides en temps d’accès, dont les prix ont chuté;
- NVMe : disques SSD très rapides (ils n’utilisent plus la norme SATA), ils se généralisent ces dernières années.
Les disques ont deux caractéristiques principales: le débit (throughput) et la latence, ou temps d’accès. Les temps d’accès sont très importants pour une base de données. Ils conditionnent les performances des accès aléatoires, c’est-à-dire de blocs isolés, notamment lors de l’utilisation d’index. Ils sont également très importants lors de la synchronisation sur disque. Le débit en lecture, lui, influe sur la rapidité de parcours des tables de façon séquentielle (bloc par bloc, de proche en proche). Le débit en écriture est bien sûr important, selon l’utilisation. Dans le tableau ci-dessous, il est flagrant que la mémoire est imbattable, y compris face aux disques SSD, avec un facteur 10 000 en performance de temps d’accès entre les deux! À l’autre bout de l’échelle se trouvent les disques magnétiques avec interface SATA. Leur faible performance en temps d’accès ne doit pas pour autant les disqualifier: leur prix est imbattable pour les gros volumes, et il reste possible de prendre un grand nombre de disques pour avoir de bonnes performances. Cependant, la fiabilité des disques SATA impose de les considérer comme des consommables et de toujours avoir des disques de secours prêts à remplacer une défaillance. Il existe plusieurs classes de disques SATA, et il est crucial de privilégier ceux conçus pour un usage en datacenter. Par exemple, les disques SATA de classe Desktop ont souvent un délai (timeout) supérieur à 30 secondes lors de clusters défectueux nécessitant une réallocation. Cela peut entraîner une instabilité du système (disques marqués hors ligne plus fréquemment, pannes…). Il est donc essentiel de vérifier la classe des disques utilisés et de choisir exclusivement des modèles spécifiquement labellisés Enterprise-class. Il est préconisé de se tourner vers des disques SAS (Serial Attached SCSI). De par leur conception matérielle différente, les disques SAS offrent des temps d’accès plus bas et une fiabilité supérieure, par rapport aux disques SATA. Le protocole de communication est aussi différent. Les disques SAS sont spécialement adaptés pour fonctionner 24 h/24, et ont un MTBF (temps moyen entre pannes) nettement plus élevé. Ils s’imposent comme un choix privilégié pour les systèmes de gestion de bases de données. Mais si le budget ne le permet pas, des disques SATA (de classe Enterprise) en plus grand nombre, au sein d’une solution RAID matérielle, permettent d’en gommer les défauts. Dans tous les cas, le nombre de disques est un critère important, car il permet de créer des groupes RAID efficaces ou de placer les fichiers de PostgreSQL à des endroits différents suivant leur utilisation. Par exemple les journaux de transactions sur un système disque, les tables sur un autre et les index sur un dernier. Le gros intérêt des disques SSD (et encore plus NVMe) est un temps d’accès très rapide. Ils se démarquent des disques magnétiques par une durée d’accès à une page aléatoire très rapide, se rapprochant de celle d’une donnée contiguë (ou séquentielle). C’est parfait pour accéder à des index. Et aujourd’hui, la qualité et la fiabilité des SSD, par rapport aux disques magnétiques, ne sont plus des critères discriminants. Les disques SSD tendent donc à devenir la norme pour les bases de données quand les performances comptent. Sur le marché du SSD, il existe plusieurs technologies (SLC, eMLC, iSLC, QLC…). Certaines auront de meilleures performances en lecture, d’autres en écriture, d’autres encore une meilleure durée de vie
en écriture, ou un prix plus bas. Il est donc important de bien lire la documentation technique des disques avant leur achat.
Les disques NVMe 1 sont une évolution des SSD, et des protocoles associés, permettant d’exploiter à fond le parallélisme des lectures et écritures. Le débit peut dépasser les 10 Go/s. À l’inverse, l’interface SATA troisième génération 2 n’a qu’un débit théorique de 6 Gbit/s, soit environ 750 Mo/s; et le SAS-4 3. sature à 22,5 Gbit/s (environ 2 Go/s). Ces interfaces conviennent encore pour des disques physiques, mais brident n’importe quel SSD au niveau du bus de données.
Tous les disques ne se valent pas, il y a des gammes pour « grand public » et des gammes « entreprise ». Choisissez toujours des disques de la gamme entreprise qui ont une meilleure durabilité et fournissent des fonctionnalités Comme pour les disques mécaniques, les unités de stockage mémoire (SSD, NVMe…) se déclinent en plusieurs classes: celles destinées au grand public et aux stations de travail, et celles conçues pour les environnements professionnels (serveurs). Il est indispensable de toujours privilégier les disques de classe « Entreprise », qui offrent une meilleure durabilité et intègrent des fonctionnalités indispensables pour un usage serveur (comme des fonctionnalités SMART avancées). Des disques bas de gamme mais rapides peuvent servir à stocker des données volatiles, comme les fichiers temporaires pour le tri et le hachage, ainsi que les tables et index temporaires.
Il est possible de configurer le système d’exploitation pour optimiser l’utilisation des SSD. Sous Linux, vérifier que les disques SSD NVMe et SSD rapides sont bien configurés ainsi:
Les stockages réseau sont très courants, mais leurs performances peuvent grandement varier, en débit comme en latence, en foncton de la technologie des disques, de celle du réseau, du protocole, et de l’activité des autres machines qui partagent la baie.
1 https://en.m.wikipedia.org/wiki/NVM_Express 2 https://sata-io.org/developers/sata-naming-guidelines 3 https://en.wikipedia.org/wiki/Serial_Attached_SCSI#History
1.2.4 RAID
- Pour un SGBD :
- RAID 1 : système, journaux de transactions
- RAID 10 : fichiers de données
- RAID 5 déconseillé pour les bases de données (écritures)
- RAID soft déconseillé!
- Qualité des cartes!
- Cache :
- en lecture : toujours
- en écriture : si batterie présente & supervisée
Il existe différents niveaux de RAID 4. Le plus connu est le RAID 5, qui autorise de perdre un des disques sans interrompre le service, au prix d’une perte de capacité plus faible que le RAID 1 (disques redondants en miroir). Cependant, le RAID 5 est plutôt déconseillé pour les bases de données (PostgreSQL comme les autres) en raison de mauvaises performances en écriture, en temps normal et encore plus lors de la reconstruction d’un disque. Pour les performances en écriture, il est généralement préférable de se baser sur du RAID 10, soit deux grappes de disques en RAID 1 (en miroir) agrégés dans un RAID 0: c’est tout aussi intéressant en termes de fiabilité, mais avec de bien meilleures performances en lecture et écriture. En contrepartie, à volumétrie égale, il nécessite plus de disques et est donc beaucoup plus cher que le RAID 5. Pour réduire le budget, il peut être envisageable de choisir des disques SATA en RAID 10. Cela dit, un RAID 5 peut très bien fonctionner pour votre application. Le plus important est d’obtenir un RAID fiable avec de nombreux disques, surtout s’ils sont magnétiques. Lors du choix du RAID, il est impératif de suivre les recommandations du constructeur par rapport à la compatibilité de la taille des disques et aux performances des différents modes de RAID. En effet, certains constructeurs déconseillent tel ou tel niveau de RAID par rapport à la capacité des disques; par exemple, suivant l’algorithme implémenté, certains constructeurs conseilleront un RAID 6 plutôt qu’un RAID 5 si la capacité du disque dépasse une certaine taille. Ceci est justifié par exemple par une reconstruction plus rapide. Lors de l’utilisation d’un RAID, il est important de prévoir un disque de hot spare. Il permet au système de reconstruire le RAID automatiquement et sans intervention humaine. Cela réduit la période pendant laquelle la grappe RAID est dans un mode dégradé. Il est à noter que le système et les journaux de transactions n’ont pas besoin de RAID 10. Il y a peu de lectures, ils peuvent se satisfaire d’un simple RAID 1. Le RAID 0 (simple addition de disques pour maximiser l’espace, sans aucune redondance) est évidemment à proscrire. Les cartes RAID ne sont pas toutes aussi performantes et fiables. Les cartes intégrées aux cartes mères sont généralement de très mauvaise qualité. Il ne faut jamais transiger sur la qualité de la 4 https://fr.wikipedia.org/wiki/RAID_(informatique)
carte RAID. La majorité des cartes RAID offre maintenant un système de cache de données en mémoire. Ce cache peut être simplement en lecture ou en lecture/écriture. En lecture, il faut évidemment toujours l’activer. Par contre, la carte RAID doit posséder une batterie (ou équivalent) pour utiliser le cache en écriture: les données du cache ne doivent pas disparaître en cas de coupure de courant. Ceci est obligatoire pour des raisons de fiabilité du service. La majorité des cartes RAID permettent de superviser l’état de la batterie et désactivent le cache en écriture par mesure de sécurité si la batterie est défaillante. Pensez donc à toujours superviser l’état de vos contrôleurs RAID et de vos disques. Le RAID soft, intégré à l’OS, qui gère directement les disques, a l’avantage d’un coût nul. Il est cependant déconseillé sur un serveur de production: les performances peuvent souffrir du partage du CPU avec les applications, surtout en RAID 5; une reconstruction d’un disque passe par le CPU et ralentit énormément la machine; et surtout la fiabilité est impactée par l’impossibilité de rajouter une batterie.
1.2.5 SAN
- Pouvoir sélectionner les disques dans un groupe RAID
- Attention au cache
- toujours activer le cache en lecture
- activer le cache en écriture que si batterie présente
- Attention au système de fichiers
- NFS : risques de corruptions et problèmes de performance
- Point noir fréquent : latence réseau!
Les SAN sont très appréciés en entreprise. Ils permettent de fournir le stockage pour plusieurs machines de manière fiable. Bien configurés, ils permettent d’atteindre de bonnes performances. Il est cependant important de comprendre les problèmes qu’ils peuvent poser. Certains SAN ne permettent pas de sélectionner les disques placés dans un volume logique. Ils peuvent placer différentes partitions du même disque dans plusieurs volumes logiques. C’est un problème quand il devient impossible de dire si deux volumes logiques utilisent les mêmes disques. En effet, PostgreSQL permet de répartir des objets (tables ou index) sur plusieurs tablespaces différents. Cela n’a un intérêt en termes de performances que s’il s’agit bien de disques physiquement différents. De même, certaines grappes de disques (eg. RAID GROUP) accueillent trop de volumes logiques pour de multiples serveurs (virtualisés ou non). Les performances des différents volumes dépendent alors directement de l’activité des autres serveurs connectés aux mêmes grappes. Les SAN utilisent des systèmes de cache. L’avertissement concernant les cartes RAID et leur batterie vaut aussi pour les SAN qui proposent un cache en écriture.
Le débit n’est pas tout! Les SAN ne sont pas attachés directement au serveur. L’accès aux données accusera donc en plus une pénalité due à la latence réseau! L’architecture et les équipements choisis doivent donc prévoir de multiples chemins entre serveur et baie, pour mener à une latence la plus faible possible, surtout pour la partition des journaux de transaction.
Ces différentes considérations et problématiques (et beaucoup d’autres) font de la gestion de baies SAN un métier à part entière. Il faut y consacrer du temps de mise en œuvre, de configuration et de supervision important. En contrepartie de cette complexité et de leurs coûts, les SAN apportent beaucoup en fonctionnalités (snapshots, réplication, virtualisation…), en performances et en souplesse. Dans un registre moins coûteux, la tentation est grande d’utiliser un simple NAS 5, avec par exemple un accès NFS aux partitions. Il faut l’éviter, pour des raisons de performance et de fiabilité. Utilisez plutôt iSCSI, peu performant, mais plus fiable et moins complexe.
1.2.6 Virtualisation (1/2)
- Masque les ressources physiques au système
- plus difficile d’optimiser les performances
- Propose généralement des fonctionnalités d’overcommit
- grandes difficultés à trouver la cause du problème du point de vue de la VM
- dédier les ressources aux VM PostgreSQL
- En pause tant que l’hyperviseur ne dispose pas de l’ensemble des vCPU alloués à la machine virtuelle (steal time)
- Mutualise les disques = problèmes de performances
- préférer attachement direct au SAN
- disques de PostgreSQL en Thick Provisionning
- éviter les snapshots de VM (selon la technologie)
L’utilisation de machines virtuelles n’est pas recommandée avec PostgreSQL si les performances sont critiques. En effet, les autres machines virtuelles peuvent accaparer des ressources. De plus, la couche de virtualisation cache totalement les ressources physiques au système, ce qui rend l’investigation et l’optimisation des performances beaucoup plus difficiles qu’avec des serveurs physiques dédiés.
Il est néanmoins possible, et très courant, d’utiliser des machines virtuelles avec PostgreSQL. Leur configuration doit alors être orientée vers la stabilité des performances. Cette configuration est complexe et difficile à suivre dans le temps. Les différentes parties de la plate-forme (virtualisation, système et bases de données) sont généralement administrées par des équipes techniques différentes, 5 https://fr.wikipedia.org/wiki/Serveur_de_stockage_en_r%C3%A9seau
ce qui rend le diagnostic et la résolution de problèmes de performances plus difficiles. Les outils de supervision de chacun sont séparés et les informations plus difficiles à corréler. Une configuration performante à un moment peut se dégrader dans le temps avec la montée en charge d’autres machines que PostgreSQL. Mémoire: Les solutions de virtualisation proposent généralement des fonctionnalités d’overcommit: les ressources allouées ne sont pas réservées à la machine virtuelle, la somme des ressources de l’ensemble des machines virtuelles peut donc être supérieure aux capacités du matériel. Dans ce cas, les machines peuvent ne pas disposer des ressources qu’elles croient avoir en cas de forte charge. Cette fonctionnalité est bien plus dangereuse avec PostgreSQL car la configuration du serveur est basée sur la mémoire disponible sur la VM. Si PostgreSQL utilise de la mémoire alors qu’elle se trouve en swap sur l’hyperviseur, les performances seront médiocres, et l’administrateur de bases de données aura de grandes difficultés à trouver la cause du problème du point de vue de la VM.
Par conséquent, il est fortement conseillé de dédier un minimum de ressources aux VM PostgreSQL, et de superviser constamment l’overcommit du côté de l’hyperviseur pour éviter ce trashing.
CPU: Il est généralement conseillé d’utiliser au moins 4 cœurs physiques. En fonction de la complexité des requêtes, du volume de données, de la puissance du CPU, un cœur physique sert en moyenne de 1 à 20 requêtes simultanées, voire plus. L’ordonnancement des cœurs par les hyperviseurs a pour conséquence qu’une machine virtuelle est en « pause » tant que l’hyperviseur ne dispose pas de l’ensemble des vCPU alloués à la machine virtuelle pour la faire tourner. Dans le cas d’une configuration contenant des machines avec très peu de vCPU et d’une autre avec un nombre de vCPU plus important, la VM avec beaucoup de vCPU risque de bénéficier de moins de cycles processeurs lors des périodes de forte charge. Ainsi, les petites VM sont plus faciles à ordonnancer que les grosses, et une perte de puissance due à l’ordonnancement est possible dans ce cas. Cet effet, appelé Steal Time dans différents outils système ( top, sysstat …), se mesure en temps processeur où la VM a un processus en attente d’exécution, mais où l’hyperviseur utilise ce temps processeur pour une autre tâche.
C’est pourquoi il faut veiller à configurer les VM pour éviter ce phénomène, avec un nombre de vCPU inférieurs au nombre de cœurs physiques réel sur l’hyperviseur, et superviser le steal.
Disques: Le point le plus négatif de la virtualisation de serveurs de bases de données concerne la performance des disques. La mutualisation des disques pose généralement des problèmes de performances car les disques sont utilisés pour des profils d’I/O généralement différents. Le RAID 5 est réputé offrir le
meilleur rapport performance/coût… sauf pour les bases de données, qui effectuent de nombreux accès aléatoires. De ce fait, le RAID 10 est préconisé car il est plus performant sur les accès aléatoires en écriture pour un nombre de disques équivalent. Avec la virtualisation, peu de disques, mais de grande capacité, sont généralement prévus sur les hyperviseurs; or cela implique un coût supérieur pour l’utilisation de RAID 10 et des performances inférieures sur les SGBD qui tirent de meilleures performances des disques lorsqu’ils sont nombreux. Enfin, les solutions de virtualisation effectuent souvent du Thin Provisioning sur les disques pour minimiser les pertes d’espace. Pour cela, les blocs sont alloués et initialisés à la demande, ce qui apporte une latence au niveau de l’écriture des journaux de transaction (in fine, cela détermine le nombre maximum de commits en écriture par seconde possible).
Il est donc recommandé de configurer les disques de PostgreSQL en Thick Provisionning. b Il est assez courant de procéder à des « sauvegardes » par snapshot de la machine virtuelle. (C’est très pratique, mais rappelons que ce n’est pas une protection contre la perte totale de l’hyperviseur.) La présence de snapshots peut causer des soucis de performance en lecture/écriture, car l’hyperviseur doit alors consulter plusieurs fichiers différentiels pour reconstituer l’état du disque. Le souci est connu au moins sur VMWare. C’est à vérifier avec d’autres technologies.
Éviter les snapshots sur les bases critiques. b Enfin, dans le cas de disques virtualisés, bien veiller à ce que l’hyperviseur respecte les appels de synchronisation des caches disques (appel système sync ).
De préférence, dans la mesure du possible, éviter donc de passer par la couche de virtualisation pour les disques et préférez des attachements SAN, plus sûrs et performants.
1.2.7 Virtualisation (2/2)
- Éviter le time drift : même source NTP sur les VM et l’ESXi
- Utiliser les adaptateurs réseau paravirtualisés de type VMXNET3
- Utiliser l’adaptateur paravirtualisé PVSCSI pour les disques dédiés aux partitions PostgreSQL
- Si architecture matérielle NUMA :
- dimensionner la mémoire de chaque VM pour qu’elle ne dépasse pas le volume de mémoire physique au sein d’un groupe NUMA
Horloge: Il est aussi recommandé d’utiliser la même source NTP sur les OS invité (VM) et l’hôte ESXi afin d’éviter l’effet dit de time drifts. Il faut être attentif à ce problème des tops d’horloge. Si une VM manque des tops d’horloges sous une forte charge ou autre raison, elle va percevoir le temps qui passe comme étant plus lent qu’il ne l’est réellement. Par exemple, un OS invité avec un top d’horloge à 1 ms attendra 1000 tops d’horloge pour une simple seconde. Si 100 tops d’horloge sont perdus, alors 1100 tops d’horloge seront délivrés avant que la VM ne considère qu’une seconde soit passée. C’est ce qu’on appelle le time drift. Paravirtualisation: Il est recommandé d’utiliser le contrôleur vSCSI VMware Paravirtual (aka PVSCSI). Ce contrôleur est intégré à la virtualisation et a été conçu pour supporter de très hautes bandes passantes avec un coût minimal, c’est le driver le plus performant. De même, pour le driver réseau, il faut privilégier l’adaptateur réseau paravirtualisé de type VMXNET3 pour avoir les meilleures performances. NUMA: Un aspect très important de la configuration de la mémoire des machines virtuelles est l’accès mémoire non uniforme (NUMA). Cet accès permet d’accélérer l’accès mémoire en partitionnant la mémoire physique de telle sorte que chaque socket dispose de sa propre mémoire. Par exemple, avec un système à 2 sockets et 128 Go de RAM, chaque socket ou nœud possède 64 Go de mémoire physique. Si une VM est configurée pour utiliser 80 Go de RAM, le système doit utiliser la mémoire d’un autre nœud. Le franchissement de la limite NUMA peut donc réduire les performances. Une bonne pratique consiste à limiter les VM aux ressources d’un seul nœud NUMA.
1.3 SYSTÈME D’EXPLOITATION
- Quel système choisir ?
- Quelle configuration réaliser?
Le choix du système d’exploitation n’est pas anodin. Les développeurs de PostgreSQL ont fait le choix de bien segmenter les rôles entre le système et le SGBD. Ainsi, PostgreSQL requiert que le système travaille de concert avec lui dans la gestion des accès disques, l’ordonnancement, etc. PostgreSQL est principalement développé sur et pour Linux. Il fonctionne aussi sur d’autres systèmes, mais n’aura pas forcément les mêmes performances. De plus, la configuration du système et sa fiabilité jouent un grand rôle dans les performances et la robustesse de l’ensemble. Il est donc nécessaire de bien maîtriser ces points-là pour avancer dans l’optimisation.
1.3.1 Choix du système d’exploitation
- PostgreSQL fonctionne sur différents systèmes
- principalement développé et testé sous Linux
- *BSD, macOS, Windows, Solaris, etc.
- Windows intéressant pour les postes des développeurs
- mais moins performant que Linux
- outillage : préférer WSL au PG natif
PostgreSQL est écrit pour être le plus portable possible. Un grand nombre de choix dans son architecture a été fait en fonction de cette portabilité. La liste des plate-formes officiellement supportées 6 ) comprend donc Linux, FreeBSD, OpenBSD, macOS, Windows, Solaris, etc. Cette portabilité est vérifiée en permanence avec la ferme de construction (BuildFarm 7 ), qui comprend même de vieilles versions de ces systèmes sur différentes architectures avec plusieurs compilateurs. Sous Linux: Cela étant dit, il est malgré tout principalement développé sous Linux et la majorité des utilisateurs, et surtout des développeurs, travaillent aussi avec Linux. Ce système est probablement le plus ouvert de tous, permettant ainsi une meilleure compréhension de ses mécaniques internes et ainsi une meilleure interaction. Ainsi, Linux est certainement le système le plus fonctionnel et performant avec PostgreSQL. La distribution Linux a généralement peu d’importance en ce qui concerne les performances. Les deux distributions les plus fréquemment utilisées sont Red Hat (et ses dérivés comme Rocky Linux) et Debian (et ses dérivés, notamment Ubuntu). Sauf exception, nous ne traiterons plus ici que de Linux. 6 https://www.postgresql.org/docs/current/supported-platforms.html 7 https://buildfarm.postgresql.org/cgi-bin/show_status.pl
Sous Windows: Un autre système souvent utilisé est Windows. PostgreSQL est beaucoup moins performant lorsqu’il est installé sur ce dernier que sur Linux. Cela est principalement dû à sa gestion assez mauvaise de la mémoire partagée. Cela a pour conséquence qu’il est difficile d’avoir un cache disque important pour PostgreSQL sous Windows. Un autre problème connu avec les instances PostgreSQL sous Windows est lié à l’architecture multiprocessus, où chaque connexion à l’instance crée un processus. Par exemple, avant Windows 2016, plus de 125 connexions simultanées pouvaient mener à l’épuisement de la Desktop Heap Memory, réduite pour les services non interactifs, et à de surprenants problèmes de mémoire (message Out of memory dans les traces PostgreSQL et/ou les événements de Windows). Pour les détails, voir la KB295902 de Microsoft 8, cet article Technet 9 et le wiki PostgreSQL 10. Toujours sous Windows, il est fortement recommandé de laisser le paramètre update_process_title à off (c’est le défaut sous Windows, pas sous Linux). Le nom des processus ne sera plus dynamique, mais cela est trop lourd sous Windows. Le wiki ci-dessus pointe d’autres particularités et problèmes. De nombreux outils et extensions n’ont pas été adaptés à la version native pour Windows de PostgreSQL. Comme alternative, PostgreSQL peut aussi s’installer au sein d’une instance WSL2: PostgreSQL tourne alors dans une machine virtuelle Linux facile à installer, et les paquets du PGDG sont accessibles. Références:
- Formation DBA1 : Installation sous Windows 11
- PostgreSQL sur Windows et WSL 12
1.3.2 Choix du noyau
- Choisir la version la plus récente du noyau car
- plus stable
- plus compatible avec le matériel
- plus de fonctionnalités
- plus de performances
- Utiliser la version de la distribution Linux
- ne pas le compiler soi-même
8 http://support.microsoft.com/kb/184802 9 https://techcommunity.microsoft.com/t5/ask-the-performance-team/sessions-desktops-and-windows-stations/bap/372473 10 https://wiki.postgresql.org/wiki/Running_%26_Installing_PostgreSQL_On_Native_Windows#I_cannot_run_with_more_than_about_125_connections_at_once.2C_despite_having_capable_hardware 11 https://dali.bo/b_html#installation-sous-windows 12 https://kb.dalibo.com/installation/plateformes/windows/postgresql_wsl/
Il est préférable de ne pas fonctionner avec une très ancienne version du noyau Linux. Les dernières versions sont les plus stables, les plus performantes, les plus compatibles avec les derniers matériels. Ce sont aussi celles qui proposent le plus de fonctionnalités intéressantes, comme la gestion complète du système de fichiers ext4, les control groups, une supervision avancée (avec perf et bpf ), etc.
Le mieux est d’utiliser la version proposée par votre distribution Linux et de mettre à jour le noyau quand cela s’avère possible. Le compiler vous-même peut dans certains cas vous apporter un plus en termes de performances. Mais ce plus est difficilement quantifiable et est assorti d’un gros inconvénient: avoir à gérer soi-même les mises à jour, la recompilation en cas d’oubli d’un pilote, etc.
1.3.3 Configuration du noyau
- À configurer :
- cache disque système
- swap
- overcommit
- huge pages
- affinité entre cœurs et mémoire
- scheduler
Le noyau, comme tout logiciel, est configurable. Certaines configurations sont particulièrement importantes pour PostgreSQL.
1.3.4 Contrôle du cache disque système
- Lissage de l’écriture des dirty pages
- Encore utile malgré les paramètres PostgreSQL *_flush_after
Les dirty pages sont des pages du cache disque de Linux modifiées en mémoire mais non synchronisées sur disque. Elles peuvent s’accumuler en mémoire dans les cas où l’écriture sur disque n’est pas forcée par PostgreSQL, ce qui reste le cas général. Leur gestion s’effectue à travers les paramètres noyau vm.dirty_ratio, vm.dirty_background_ratio, vm.dirty_bytes et
vm.dirty_background_bytes. Le but est d’éviter que les pages dirty s’accumulent et soient écrites en même temps, et donc de lisser l’écriture de ce cache. vm.dirty_background_bytes (en octets) ou vm.dirty_background_ratio (en pourcentage de la RAM) définissent la quantité de pages mémoire modifiées forçant le noyau à commencer l’écriture des données du cache système dans un thread en tâche de fond. Ce processus est léger et est à encourager. Si ce processus n’est pas assez rapide et que la quantité définie par vm.dirty_bytes ou vm.dirty_ratio est atteinte, les processus écrivent eux-mêmes les données du cache sur disque afin de les libérer. Ce comportement est à éviter. En effet, le processus en tâche de fond est seul à écrire alors que dans le second cas, plusieurs processus tentent de vider le cache système en même temps. Cela peut entraîner un encombrement de la bande passante des disques dans les situations de forte charge en écriture, surtout s’il y a beaucoup de synchronisations sur disque de données modifiées en cache, comme des appels à fsync. Celui-ci est également utilisé par PostgreSQL lors des checkpoints, ce qui peut provoquer des latences supplémentaires à ces moments-là. Autrefois, sur les versions de PostgreSQL précédant la 9.6, pour réduire les conséquences de ce phénomène, il était systématiquement conseillé d’abaisser vm.dirty_ratio à 10 (pour 10 %) et vm.dirty_background_ratio à 5. Ainsi, lors de fortes charges en écriture, le noyau reporte plus fréquemment son cache disque sur l’espace de stockage, mais pour une volumétrie plus faible, et l’encombrement de la bande passante vers les disques est moins long si ceux-ci ne sont pas capables d’absorber ces écritures rapidement. À l’inverse, plus ces valeurs sont basses, plus les synchronisations sont fréquentes, plus la durée des opérations VACUUM et REINDEX, qui déclenchent beaucoup d’écritures sur disque, augmente.
En première intention, sur un serveur moderne, nous recommandons:
- vm.dirty_bytes=1073741824 (1 Go)
- vm.dirty_background_bytes=536870912 (512 Mo)
Les paramètres en pourcentages fonctionnent également, mais il faut les calculer. Paramètres en octets et paramètres en pourcentage ne peuvent être utilisés en même temps, le dernier modifié met l’autre à zéro. On peut ensuite tester des valeurs en fonction des capacités de la machine (débit en écriture et caches disques divers) et de la charge réelle. Depuis la version 9.6, ces options semblent moins nécessaires grâce à ces paramètres propres à PostgreSQL:
- bgwriter_flush_after (512 ko par défaut) : lorsque plus de bgwriter_flush_after octets sont écrits sur disque par le background writer, le moteur tente de forcer la synchronisation sur
disque;
- backend_flush_after (désactivé par défaut) : force la synchronisation sur disque lorsqu’un processus a écrit plus de backend_flush_after octets; il est préférable d’éviter ce comportement, c’est pourquoi la valeur par défaut est 0 (désactivation);
- wal_writer_flush_after (1 Mo par défaut) : quantité de données à partir de laquelle le wal writer synchronise les blocs sur disque ;
- checkpoint_flush_after (256 ko par défaut) : lorsque plus de checkpoint_flush_after octets sont écrits sur disque lors d’un checkpoint, le moteur tente de forcer la synchronisation
sur disque. Mais ces derniers paramètres ne concernent que les processus de PostgreSQL. Or l’instance PostgreSQL n’est pas seule à écrire de gros fichiers (exports pg_dump, processus d’archivage, copies de fichiers…). Le paramétrage de vm.dirty_bytes / vm.dirty_background_bytes conserve donc un intérêt. Référence:
- documentation du kernel Linux 13
- Low write performance on Linux servers with large RAM 14 (support SUSE)
1.3.5 Configuration du swap
La mémoire sert de cache au disque, pas l’inverse!
- Swap réduit
- pour les processus d’arrière-plan ou tmpfs
- 2-4 Go
- et à décourager, sans l’empêcher
PostgreSQL utilise une partie de la mémoire du serveur pour son propre cache. Il profite aussi du cache de Linux. Les processus de PostgreSQL ne consomment eux-mêmes que peu de RAM, ou ne l’utilisent que pour les besoins d’une requête avant de rendre cette mémoire. De plus, PostgreSQL peut travailler sur disque pour éviter de consommer trop de mémoire. Enfin, aucun outil ou logiciel consommateur de RAM n’est censé fonctionner sur un serveur de base de données. En principe, un gros swap n’a donc pas d’utilité sur un serveur PostgreSQL. Avoir trop de swap a même tendance à aggraver la situation dans un contexte où la mémoire devient rare, par exemple avec une requête qui en réclame trop: le système finit par s’effondrer à force de swapper et déswapper. (La configuration de la surréservation ci-dessous évitera ce souci.) Un petit swap reste utile pour y stocker des processus « oubliés » comme il peut en traîner sur un serveur, des démons inactifs, le contenu de systèmes de fichiers tmpfs (classiquement, /var/run ) ou 13 https://www.kernel.org/doc/html/latest/admin-guide/sysctl/vm.html#:~:text=dirty%20memory 14 https://www.suse.com/support/kb/doc/?id=000017857
encore les journaux de systemd-journald selon la configuration de celui-ci. Il peut arriver exceptionnellement que des processus backend de PostgreSQL occupent beaucoup de mémoire tout en étant très longtemps inactifs, ce qui est à éviter. Un plus gros swap pourrait alors compenser.
À l’inverse, ne pas avoir du tout de swap peut mener à un gaspillage de RAM, et à un autre problème: l’administrateur n’a pas d’indice d’une surconsommation de mémoire.
Le paramètre vm.swappiness contrôle le comportement du noyau vis-à-vis de l’utilisation du swap. Plus ce pourcentage est élevé, plus le système a tendance à swapper facilement. Un système hébergeant une base de données ne doit swapper qu’en dernière extrémité. La valeur par défaut (30 ou 60 suivant les distributions) doit donc être abaissée très bas, généralement à 10, pour éviter l’utilisation du swap dans la majorité des cas:
Il ne faut pas descendre à 0, ce qui désactiverait complètement le swap.
1.3.6 Configuration de la surréservation mémoire
Le noyau peut autoriser trop de réservation mémoire.
- Si saturation :
- kill -9 du processus par l’OOM killer
- et donc redémarrage
- purge du cache
- Désactiver sur serveur dédié :
Danger de l’overcommit:
Certaines applications réservent (commit) auprès du noyau plus de mémoire que nécessaire. Plusieurs optimisations noyau permettent aussi d’économiser de l’espace mémoire. Ainsi, par défaut, le noyau Linux s’autorise à réserver aux processus plus de mémoire qu’il n’en dispose réellement, le risque de réellement utiliser cette mémoire étant faible. On appelle ce comportement l’Overcommit Memory. Ce peut être intéressant dans certains cas d’utilisation, mais peut devenir dangereux dans le cadre d’un serveur PostgreSQL dédié, qui va réellement allouer (utiliser) toute la mémoire qu’il réservera. Typiquement, cela arrive lors de tris en mémoire trop gros, ou trop nombreux au même moment.
Quand le noyau arrive réellement à court de mémoire, il décide de tuer certains processus en fonction de leur impact sur le système (mécanisme de l’Out Of Memory Killer). Il est alors fort probable que ce soit un processus PostgreSQL qui soit tué. Il y a un risque de corruption de la mémoire partagée, donc par précaution toutes les transactions en cours sont annulées, et toute l’instance redémarre. Une perte de données est parfois possible en fonction de la configuration de PostgreSQL. Une corruption est par contre plutôt exclue. De plus, le cache disque aura été purgé à cause de la consommation mémoire. Pire: le swap aura pu être rempli, entraînant un ralentissement général (swap storm) avant le redémarrage de l’instance.
Configuration de vm.overcommit_memory et vm.overcommit_ratio: Il est possible de parer à ces problèmes grâce aux paramètres kernel vm.overcommit_memory et vm.overcommit_ratio du fichier /etc/sysctl.conf (ou d’un fichier dans /etc/sysctl.conf.d/ ). Cela suppose que le serveur est dédié exclusivement à PostgreSQL, car d’autres applications ont besoin d’un overcommit laxiste. Le swap devra avoir été découragé comme évoqué ci-dessus. Pour désactiver complètement l’overcommit memory:
La taille maximum de mémoire réservable par les applications se calcule alors grâce à la formule suivante:
Ce CommitLimit ne doit pas dépasser 80 % de la RAM physiquement présente pour en préserver 20 % pour l’OS et son cache. vm.overcommit_ratio est un pourcentage, entre 0 et 100. Or, sa valeur par défaut vm.overcommit_ratio est 50: sur un système avec 32 Go de mémoire et 2 Go de swap, nous n’aurions alors que 32×50/100+2 = 18 Go de mémoire allouable! Il faut donc monter cette valeur:
nous obtenons 32×75/100+2 = 26 Go de mémoire utilisable par les applications sur les 32 Go disponibles. 6 Go serviront pour le cache et l’OS (bien sûr, ce pourra être plus quand les processus PostgreSQL utiliseront moins de mémoire). Les valeurs typiques de vm.overcommit_ratio, sur des machines correctement dotées en RAM, et avec un swap de 2 Go au plus, vont de 70 à 80 (toujours en vue de réserver 20 % de RAM au cache disque, ce pourrait être un peu moins). (Alternativement, il existe un paramètre exprimé en kilooctets, vm.overcommit_kbytes, mais il faut penser à l’adapter lors d’un ajout de RAM). La prise en compte des fichiers de configuration modifiés se fait avec:
Exemple: Une machine de 16 Go de RAM, 1,6 Go de swap possède cette configuration:
Extrait de la configuration mémoire résultante:
-/+ buffers/cache: 2653 13433
dalibo@srv-psql-02:~$ cat /proc/meminfo MemTotal: 16473548 kB MemFree: 178432 kB
… SwapTotal: 1740796 kB SwapFree: 1740696 kB …
Committed_AS: 6436004 kB …
Le CommitLimit atteint 15 Go, laissant au cache et l’OS une portion très réduite, mais évitant au moins un crash de l’instance. Ici, Committed_AS (valeur totale réservée à ce moment), est très en deça. Avec des huge pages: Les choses se compliquent si l’on paramètre des huge pages (voir plus bas). Exemple de saturation mémoire: Avec la désactivation de la surallocation, l’instance ne plantera plus par défaut de mémoire. Les requêtes demandant trop de mémoire se verront refuser par le noyau une nouvelle réservation, et elles tomberont simplement en erreur. Cela peut se tester ainsi:
– DANGEREUX! Tri de 250 Go en RAM!
ORDER BY i DESC;
Si le paramétrage ci-dessus a été appliqué, on obtiendra ceci dans la session:
postgres-# ORDER BY i DESC;
DETAIL: Failed on request of size 23 in memory context “ExecutorState”.
(les traces seront plus verbeuses). La session et l’instance fonctionnent ensuite normalement. Sans paramétrage, ce serait plus brutal:
server closed the connection unexpectedly This probably means the server terminated abnormally before or while processing the request.
et les traces indiqueraient ceci avant le redémarrage:
Noter qu’une requête qui tombe en erreur n’est pas forcément celle qui a consommé le plus de mémoire; elle est juste celle qui a atteint la première le CommitLimit. Pour plus de détails:
1.3.7 Huge pages
Pages mémoire de 2 Mo au lieu de 4 ko:
- Évite un gaspillage mémoire
- shared buffers non swappés
- PostgreSQL :
- Dimensionner pour les shared buffers :
- Voir /proc/meminfo
Principe des huge pages: Les systèmes d’exploitation utilisent un système de mémoire virtuelle: chaque contexte d’exécution (comme un processus) utilise un plan d’adressage virtuel, et c’est le processeur qui s’occupe de réaliser la correspondance entre l’adressage virtuel et l’adressage réel. Chaque processus fournit donc la correspondance entre les deux plans d’adressage, dans ce qu’on appelle une « table de pagination ». Les processeurs modernes permettent d’utiliser plusieurs tailles de page mémoire simultanément. Pour les processeurs Intel/AMD, les tailles de page possibles sont 4 ko, 2 Mo et 1 Go. Les pages de 4 ko sont les plus souples, car offrant une granularité plus fine. C’est donc la configuration par défaut sous Linux. Toutefois, pour des grandes zones mémoire contiguës, il est plus économique d’utiliser des tailles de pages plus élevées. Par exemple, il faudra 262 144 entrées pour 1 Go de mémoire avec des pages de 4 ko, contre 512 entrées pour des pages de 2 Mo. Or, chaque processus PostgreSQL dispose de sa propre table de pagination, qui va gonfler au fur et à mesure que ce processus va accéder à différents blocs des shared buffers: pour des shared buffers de
8 Go, chaque processus peut gaspiller 16 Mo si les pages font 4 ko, contre une centaine de ko pour des pages de 2 Mo. Une ligne de /proc/meminfo indique la mémoire utilisée par les TLB:
PageTables: 1193040 kB
Sur des petites configurations (quelques Go de RAM et peu de connexions), cela n’a pas beaucoup d’importance. Sinon, cette mémoire pourrait être utilisée à meilleur escient ( work_mem par exemple, ou tout simplement du cache système). Un autre intérêt des huge pages est qu’elles ne risquent pas de finir dans le swap si le système est mal configuré. Nous allons donc prévoir des huge pages pour toute la mémoire partagée de l’instance. Paramétrer PostgreSQL pour les huge pages: Dans postgresql.conf, le défaut convient:
PostgreSQL se rabattra sur des pages de 4 ko si le système n’arrive pas à fournir les pages de 2 Mo. C’est d’ailleurs ce qui se passe sur beaucoup d’instances avec la configuration système par défaut. (À partir de la version 14, il est possible de surcharger la configuration système de la taille des huge pages avec le paramètre huge_page_size. Par défaut, PostgreSQL utilise la valeur du système d’exploitation.) Paramétrer les huge pages au niveau noyau: On se limitera ici aux huge pages les plus courantes, celles de 2 Mo (à vérifier sur la ligne Hugepagesize de /proc/meminfo ).
Dans /etc/sysctl.d/, définir le nombre de huge pages vm.nr_overcommit_hugepages: La valeur de ce paramètre s’exprime en pages de la taille de huge page par défaut. Il doit être suffisamment grand pour contenir les shared buffers et les autres zones mémoire partagées (tableau de verrous, etc.). Compter 10 % de plus que ce qui est défini pour shared_buffers devrait être suffisant. Il n’est pas interdit de mettre des valeurs supérieures, puisque Linux crée les huge pages à la volée à concurrence de vm.nr_overcommit_hugepages (et les détruira à l’extinction de PostgreSQL). Prévoir large évite de recalculer le nombre de pages si l’on modifie le paramétrage de la mémoire partagée de PostgreSQL (d’autres paramètres que shared_buffers ou max_connections entrent en compte).
Une alternative est le paramètre vm.nr_hugepages, qui crée des pages statiques (et leur utilisation est obligatoire pour des pages de 1 Go). Ces pages sont créées une fois pour toutes par Linux, et cette mémoire est gaspillée si PostgreSQL échoue à l’utiliser. En conséquence, si shared_buffers vaut 8 Go:
À partir de la version 15, le paramètre shared_memory_size permet de connaître la taille complète de mémoire partagée allouée (un peu supérieure à shared_buffers en pratique). Dans le cadre de l’utilisation des Huge Pages, il est possible de consulter le paramètre shared_memory_size_in_huge_pages pour connaître le nombre de pages mémoires nécessaires (mais on ne peut savoir ici si elles sont utilisées):
Liste des paramètres de configuration
| Paramètre | Valeur |
|---|---|
| shared_buffers | 8GB |
| shared_memory_size | 8479MB |
| shared_memory_size_in_huge_pages | 4240 |
…
NB: Sur un système hébergeant plusieurs instances, il faut additionner toutes les zones mémoire de toutes les instances. Enfin, si l’on a paramétré la surallocation mémoire comme décrit ci-dessus, son calcul change, car les huge pages n’entrent pas dans la CommitLimit. On a alors:
Les valeurs de vm.overcommit_ratio sont alors typiquement entre 60 et 72 (avec ¼ de RAM pour la mémoire partagée et pour préserver 20% du cache de Linux). Vérifier la prise en compte des huge pages: /proc/meminfo indique les pages réservées et utilisées.
Si les huge pages nécessaires ne sont pas toutes disponibles pour y placer les shared buffers, (mauvais paramétrage, changement de paramétrage sans ajustement des paramètres système, fragmentation mémoire…) PostgreSQL peut démarrer mais n’utilisera aucune_huge page_. Des huge pages dynamiques ne seront simplement pas créées, mais des huge pages statiques inutilisées bloqueront alors inutilement la mémoire!
Pour interdire le démarrage dans ce cas, utiliser ce paramétrage:
Cela permet d’éviter un mode dégradé pas évident à détecter. On peut aussi vouloir démarrer tout en supervisant le problème potentiel. À partir de PostgreSQL 17, SHOW huge_pages_status doit renvoyer on ou off selon que PostgreSQL utilise bien les huge pages ou non. Un outil pratique de Linux, mais optionnel, pour gérer les huge pages est hugeadm. Pour plus de détails:
- Documentation officielle : Linux Huge Pages 15
1.3.8 Transparent Huge pages
- « Huge Pages » dynamiques
- À désactiver :
- /proc/meminfo/AnonHugePages
Dans /proc/meminfo, la ligne AnonHugePages indique des huge pages allouées par le mécanisme de Transparent Huge Pages: le noyau Linux a détecté une allocation contiguë de mémoire et l’a convertie en huge pages, indépendamment du mécanisme décrit plus haut. Hélas, les THP ne s’appliquent pas à la mémoire partagée de PostgreSQL. Les THP sont même contreproductives sur une base de données, à cause de la latence engendrée par la réorganisation par le système d’exploitation. Comme les THP sont activées par défaut, il faut les désactiver au boot via /etc/crontab:
@reboot root echo never > /sys/kernel/mm/transparent_hugepage/enabled @reboot root echo never > /sys/kernel/mm/transparent_hugepage/defrag
ou encore dans la configuration de grub:
Dans /proc/meminfo, la ligne AnonHugePages doit donc valoir 0.
1.3.9 Configuration de l’affinité processeur / mémoire
- Pour architecture NUMA (multisocket)
- Chaque socket travaille plus efficacement avec une zone mémoire allouée
- Peut pénaliser le cache disque système
- vm.zone_reclaim_mode : passer à 0
15 https://doc.postgresql.fr/current/kernel-resources.html#LINUX-HUGE-PAGES
Attention, ne pas confondre multicœur et multisocket! Chaque processeur physique occupe un socket et peut contenir plusieurs cœurs. Le nombre de processeurs physiques peut être trouvé grâce au nombre d’identifiants dans le label physical id du fichier /proc/cpuinfo. Par exemple, sur un serveur bi-processeur:
2
Plus simplement, si la commande lscpu est présente, cette information est représentée par le champ “CPU socket(s)”:
Cœur(s) par socket: 2 Socket(s): 1
Sur une architecture NUMA (Non Uniform Memory Access), il existe une notion de distance entre les sockets processeurs et les « zones » mémoire (bancs de mémoire). La zone mémoire la plus proche d’un socket est alors définie comme sa zone « locale ». Il est plus coûteux pour les cœurs d’un processeur d’accéder aux zones mémoire distantes, ce qui implique des temps d’accès plus importants, et des débits plus faibles. Le noyau Linux détecte ce type d’architecture au démarrage. Si le coût d’accès à une zone distante est trop important, il décide d’optimiser le travail en mémoire depuis chaque socket, privilégiant plus ou moins fortement les allocations et accès dans la zone de mémoire locale. Le paramètre vm.zone_reclaim_mode est alors supérieur à 0. Les processus étant exécutés sur un cœur processeur donné, ces derniers héritent de cette affinité processeur/zone mémoire. Le processus préfère alors libérer de l’espace dans sa zone mémoire locale si nécessaire plutôt que d’utiliser un espace mémoire distant libre, sapant par là même le travail de cache. Si ce type d’optimisation peut être utile dans certains cas, il ne l’est pas dans un contexte de serveur de base de données où tout y est fait pour que les accès aux fichiers de données soient réalisés en mémoire, au travers des caches disque PostgreSQL ou système. Or, comme on l’a vu, les mécanismes du cache disque système sont impactés par les optimisations de vm.zone_reclaim_mode. Cette optimisation peut alors aboutir à une sous-utilisation de la mémoire, pénalisant notamment le cache avec un ratio d’accès moins important côté système. De plus, elles peuvent provoquer des variations aléatoires des performances en fonction du socket où un processus serveur est exécuté et des zones mémoire qu’il utilise. Ainsi, sur des architectures multisockets, il est conseillé de désactiver ce paramètre en positionnant vm.zone_reclaim_mode à 0.
Pour illustrer les conséquences de cela, un test avec pg_dump sur une architecture NUMA montre les performances suivantes:
- avec zone_reclaim_mode à 1, durée : 20 h, CPU utilisé par le COPY : 3 à 5 %
- avec zone_reclaim_mode à 0, durée : 2 h, CPU utilisé par le COPY : 95 à 100 %
Le problème a été diagnostiqué à l’aide de l’outil système perf. Ce dernier a permis de mettre en évidence que la fonction find_busiest_group représentait le gros de l’activité du serveur. Dans le noyau Linux, cette fonction est utilisée en environnement multiprocesseur pour équilibrer la charge entre les différents processeurs.
Pour plus de détails, voir:
- Linux memory zone reclaim 16
- MySQL “swap insanity” problem 17
1.3.10 Configuration de l’ordonnanceur
- Réduire la propension du kernel à migrer les processus
- kernel.sched_migration_cost_ns = 5000000 (×10) (si kernel < 5.13)
- echo 5000000 > /sys/kernel/debug/sched/migration_cost_ns (kernel > 5.13)
- Désactiver le regroupement par session TTY
- kernel.sched_autogroup_enabled = 0
L’ordonnanceur de tâches de Linux est en charge de distribuer les ressources aux différents processus de manière équitable. Lorsqu’un processus est en exécution depuis plus de kernel.sched_migration_cost_ns, celui-ci peut être migré afin de laisser la place à un autre processus. Lorsque de nombreux processus demandent des ressources, la gestion de l’ordonnancement et la migration des processus peuvent devenir pénalisantes. Il est donc recommandé d’augmenter significativement cette valeur. Par exemple en la passant de 0,5 à 5 ms (5 000 000 ns). À partir de Linux 5.13, ce paramètre est remplacé par /sys/kernel/debug/sched/migration_cost_ns. Sur Rocky Linux 9 ou Debian 12, il faudra donc prévoir dans /etc/crontab:
@reboot echo 5000000 > /sys/kernel/debug/sched/migration_cost_ns
Sur les versions précédentes de ces distributions, ce sera dans /etc/sysctl.conf.d/:
Par ailleurs, l’ordonnanceur regroupe les processus par session (TTY) afin d’avoir un meilleur temps de réponse « perçu », notamment sur une machine de bureau. Dans le cas de PostgreSQL, l’ensemble des processus sont lancés par une seule session TTY. Ces derniers seraient alors dans un même groupe et pourraient être privés de ressources (allouées pour d’autres sessions). Sans regroupement de processus:
[proc PG. 1 | proc PG. 2 | proc PG. 3 | procPG. 4 | proc. 5 | proc. 6]
Avec regroupement de processus:
[proc PG. 1, 2, 3, 4 | proc. 5 | proc. 6 ]
Pour désactiver ce comportement, paramétrer dans /etc/sysctl.conf.d/:
16 https://www.postgresql.org/message-id/500616CB.3070408@2ndQuadrant.com 17 https://blog.jcole.us/2010/09/28/mysql-swap-insanity-and-the-numa-architecture/
1.3.11 Comment les configurer
- Outil
- sysctl
- Fichier de configuration
- /etc/sysctl.conf
- /etc/sysctl.d/*conf
Tous les paramètres expliqués ci-dessus sont à placer dans le fichier /etc/sysctl.conf ou dans le répertoire /etc/sysctl.d/ (où tout fichier ayant l’extension.conf est lu et pris en compte). Il est ainsi préconisé d’y créer un ou plusieurs fichiers pour vos configurations spécifiques afin que ces dernières ne soient pas accidentellement écrasées lors d’une mise à jour système par exemple. À chaque redémarrage du serveur, Linux va récupérer le paramétrage et l’appliquer. Il est possible d’appliquer vos modifications sans redémarrer tout le système grâce à la commande suivante:
de consulter les valeurs avec:
et de modifier un paramètre précis (jusqu’au prochain redémarrage):
1.3.12 Choix du système de fichiers
- Windows :
- NTFS
- Linux :
- ext4, XFS
- LVM pour la flexibilité
- Solaris :
- ZFS
- Utiliser celui préconisé par votre système d’exploitation/distribution
Quel que soit le système d’exploitation, les systèmes de fichiers ne manquent pas. Linux en est la preuve avec pas moins d’une dizaine de systèmes de fichiers. Le choix peut paraître compliqué mais il se révèle fort simple: il est préférable d’utiliser le système de fichiers préconisé par votre distribution Linux. Ce système est à la base de tous les tests des développeurs de la distribution: il a donc plus de
chances d’avoir moins de bugs, tout en proposant plus de performances. Les instances de production PostgreSQL utilisent de fait soit ext4, soit XFS, qui sont donc les systèmes de fichiers recommandés. En 2016, un benchmark sur Linux de Tomas Vondra 18 de différents systèmes de fichiers montrait que ext4 et XFS ont des performantes équivalentes. Autrefois réservé à Solaris, ZFS est un système très intéressant grâce à son panel fonctionnel et son mécanisme de Copy On Write permettant de faire une copie des fichiers sans arrêter PostgreSQL (snapshot). OpenZFS 19, son portage sous Linux/FreeBSD, entre autres, est un système de fichiers proposant un panel impressionnant de fonctionnalités (dont: checksum, compression, gestion de snapshot), les performances en écriture sont cependant bien moins bonnes qu’avec ext4 ou XFS. De plus, il est plus complexe à mettre en place et à administrer. Btrfs 20 est relativement répandu et bien intégré à Linux, et offre une partie des fonctionnalités de ZFS; mais il est également peu performant avec PostgreSQL. LVM 21 permet de rassembler plusieurs partitions dans un même Volume Group, puis d’y tailler des partitions (Logical Volumes) qui seront autant de points de montage. LVM permet de changer les tailles des LV à volonté, d’ajouter ou supprimer des disques physiques à volonté dans les VG, ce qui simplifie l’administration au niveau PostgreSQL… De nos jours, l’impact en performance est négligeable pour la flexibilité apportée. Si l’on utilise les snapshots de LVM, il faudra vérifier l’impact sur les performances. LVM peut même gérer le RAID mais, dans l’idéal, il est préférable qu’une bonne carte RAID s’en charge en dessous. NFS peut sembler intéressant, vu ses fonctionnalités: facilité de mise en œuvre, administration centralisée du stockage, mutualisation des espaces. Cependant, ce système de fichiers est source de nombreux problèmes avec PostgreSQL. Si la base tient en mémoire et que les latences possibles ne sont pas importantes, on peut éventuellement utiliser NFS. Il faut la garantie que les opérations sont synchrones. Si ce n’est pas le cas, une panne sur la baie peut entraîner une corruption des données. Au minimum, l’option sync doit être présente côté serveur et les options hard, proto=tcp, noac et nointr doivent être présentes côté client. Si vous souhaitez en apprendre plus sur le sujet des options pour NFS, un article détaillé est disponible dans la base de connaissances Dalibo 22, et la documentation de PostgreSQL à partir de la version 12 23. Par contre, NFS est totalement déconseillé dans les environnements critiques avec PostgreSQL. Greg Smith, contributeur très connu, spécialisé dans l’optimisation de PostgreSQL, parle plus longuement des soucis de NFS avec PostgreSQL 24. En fait, il y a des dizaines d’exemples de gens ayant eu des problèmes avec NFS. Les problèmes de performance sont quasi-systématiques, et ceux de fiabilité fréquents, et compliqués à diagnostiquer (comme illustré dans ce mail 25, où le problème venait du noyau Linux). Sous Windows, la question ne se pose pas: NTFS est le seul système de fichiers assez stable. L’installeur fourni par EnterpriseDB dispose d’une protection qui empêche l’installation d’une instance 18 https://fr.slideshare.net/fuzzycz/postgresql-na-ext4-xfs-btrfs-a-zfs-fosdem-pgday-2016 19 https://en.wikipedia.org/wiki/OpenZFS 20 https://en.wikipedia.org/wiki/Btrfs 21 https://fr.wikipedia.org/wiki/Gestion_par_volumes_logiques 22 https://dali.bo/kb_nfs 23 https://docs.postgresql.fr/current/creating-cluster.html#CREATING-CLUSTER-NFS 24 https://www.postgresql.org/message-id/4D2285CF.3050304@2ndquadrant.com 25 https://www.postgresql.org/message-id/4D40DDB7.1010000@credativ.com
PostgreSQL sur une partition VFAT.
1.3.13 Configuration du système de fichiers
- Quelques options à connaître :
- noatime , nodiratime
- attention avec les autres optimisations
- Permet de gagner un peu en performance
Quel que soit le système de fichiers choisi, il est possible de le configurer lors du montage, via le fichier /etc/fstab.
Certaines options sont intéressantes en termes de performances. Ainsi, noatime évite l’écriture de l’horodatage du dernier accès au fichier. nodiratime fait de même au niveau du répertoire. Depuis plusieurs années maintenant, nodiratime est inclus dans noatime. Soyez très prudent avec les conseils d’optimisations du système de fichiers que l’on peut rencontrer. Les options data=writeback et nobarrier sont souvent citées comme optimisation potentielle, mais le mode writeback de journalisation des ext3 et ext4 est à éviter. Effectivement, dans certains cas rares, en cas d’interruption brutale, certains fichiers peuvent conserver des blocs fantômes ayant été normalement supprimés juste avant le crash. L’option nobarrier peut être utilisée, mais avec précaution. Cette dernière peut apporter une différence significative en termes de performance, mais elle met en péril vos données en cas de coupure soudaine où les caches disques, RAID ou baies sont alors perdus. Cette option ne peut être utilisée qu’à la seule condition que tous ces différents caches soient sécurisés par une batterie.
1.3.14 Configuration de l’antivirus
Ni antivirus, ni IDS
PostgreSQL s’appuie sur le système d’exploitation et, s’attend à ce qu’il effectue rigoureusement les opérations qu’il lui demande (notamment pour l’écriture de fichiers et l’intégrité des données). Les antivirus et autres systèmes de détection d’intrusion (IDS 26 ) fonctionnent dans des couches très basses du système. L’interaction avec PostgreSQL mène régulièrement à des problèmes de performance voire de corruption. 26 https://fr.wikipedia.org/wiki/Syst%C3%A8me_de_d%C3%A9tection_d%27intrusion
Nous déconseillons fortement d’installer un antivirus ou un logiciel de détection d’intrusions sur un serveur PostgreSQL. Si vous devez absolument en installer un, il faut impérativement exclure de son analyse tous les répertoires, fichiers et processus de PostgreSQL. En cas de souci de performance sans cause évidente, pensez à faire un test avec l’antivirus désactivé.
1.4 SERVEUR DE BASES DE DONNÉES
- Version
- Configuration
- Emplacement des fichiers
Après avoir vu le matériel et le système d’exploitation, il est temps de passer au serveur de bases de données. Lors d’une optimisation, il est important de vérifier trois points essentiels:
- la version de PostgreSQL;
- sa configuration (uniquement le fichier postgresql.conf );
- et l’emplacement des fichiers (journaux de transactions, tables, index, statistiques).
1.4.1 Version
- Chaque nouvelle version majeure a des améliorations de performance
- mettre à jour est un bon moyen pour gagner en performances
- Ne pas compiler
Il est généralement conseillé de passer à une version majeure plus récente qu’à partir du moment où les fonctionnalités proposées sont suffisamment intéressantes. C’est un bon conseil en soi mais il faut aussi se rappeler qu’un gros travail est fait pour améliorer le planificateur. Ces améliorations peuvent être une raison suffisante pour changer de version majeure. Voici quelques exemples frappants:
- La version 9.0 dispose d’une optimisation du planificateur lui permettant de supprimer une jointure LEFT JOIN si elle est inutile pour l’obtention du résultat. C’est une optimisation particulièrement bienvenue pour tous les utilisateurs d’ORM.
- La version 9.1 dispose du SSI (Serializable Snapshot Isolation). Il s’agit d’une implémentation très performante du mode d’isolation sérialisée. Ce mode permet d’éviter l’utilisation des SELECT FOR UPDATE .
- La version 9.2 dispose d’un grand nombre d’améliorations du planificateur et des processus postgres qui en font une version exceptionnelle pour les performances, notamment les parcours d’index seuls.
- La version 9.6 propose la parallélisation de l’exécution de certaines requêtes; le nombre de nœuds concernés augmente à chaque nouvelle version.
- Le partitionnement déclaratif (introduit en version 10) peut mener à manipuler beaucoup de tables-partitions. Le planificateur gère cela de mieux en mieux dans les dernières versions.
- La version 13 résout de nombreux problèmes liés à des consommations de mémoire excessives avec les hash joins, et introduit aussi l’Incremental Sort.
- Les versions 16 et 17 réduisent sensiblement la consommation des VACUUM .
- La version 18 intègre les I/O asynchrones, et accélère notablement les lectures. Les index sont mieux utilisés grâce aux index skip scan.
Compiler soi-même PostgreSQL ne permet pas de gagner réellement en performance. La recompilation permet cependant de modifier certains paramètres codés en dur dans le code. Même s’il peut y avoir un gain, ce dernier ne peut être que mineur et difficilement identifiable. Ce gain doit être mis en balance avec la lourdeur de maintenance d’une version recompilée de PostgreSQL dans un environnement de production.
1.4.2 Configuration - mémoire partagée
- shared_buffers = …
- 25 % de la RAM en première intention
- généralement acceptable
- max 40 %
- complémentaire du cache OS
- wal_buffers
- automatique, 16 Mo en pratique
- peut être monté si beaucoup d’écritures
Ces quatre paramètres concernent tous la quantité de mémoire que PostgreSQL utilisera pour ses différentes opérations. shared_buffers: shared_buffers permet de configurer la taille du cache disque de PostgreSQL. Chaque fois qu’un utilisateur veut extraire des données d’une table (par une requête SELECT ) ou modifier les données d’une table (par exemple avec une requête UPDATE ), PostgreSQL doit d’abord lire les lignes impliquées et les mettre dans son cache disque. Cette lecture prend du temps. Si ces lignes sont déjà dans le cache, l’opération de lecture n’est plus utile, ce qui permet de renvoyer plus rapidement les données à l’utilisateur. Ce cache est en mémoire partagée, et donc commun à tous les processus PostgreSQL. Généralement, il faut lui donner une grande taille, tout en conservant malgré tout la majorité de la mémoire pour le cache disque du système, à priori plus efficace pour de grosses quantités de données. La documentation officielle 27 conseille ceci pour dimensionner shared_buffers:
Un bon point de départ est 25 % de la mémoire vive totale. Ne pas dépasser 40 %, car le cache du système d’exploitation est aussi utilisé. 27 https://docs.postgresql.fr/current/runtime-config-resource.html#RUNTIME-CONFIG-RESOURCE-MEMORY
Sur une machine dédiée de 32 Go de RAM, cela donne donc:
Le défaut de 128 Mo n’est donc pas adapté à un serveur sur une machine récente.
Suivant les cas, une valeur inférieure ou supérieure à 25 % sera encore meilleure pour les performances, mais il faudra tester avec votre charge (en lecture, en écriture, et avec le bon nombre de clients).
Le cache système limite la plupart du temps l’impact d’un mauvais paramétrage de shared_buffers, et il est moins grave de sous-dimensionner un peu shared_buffers que de le sur-dimensionner.
Attention: une valeur élevée de shared_buffers (au-delà de 8 Go) nécessite de paramétrer finement le système d’exploitation (Huge Pages notamment) et d’autres paramètres liés aux journaux et checkpoints comme max_wal_size. Il faut aussi s’assurer qu’il restera de la mémoire pour le reste des opérations (tri…) et donc adapter work_mem.
Modifier shared_buffers impose de redémarrer l’instance. Á wal_buffers:
PostgreSQL dispose d’un autre cache disque. Ce dernier concerne les journaux de transactions. Plus cette mémoire est importante, plus les transactions seront conservées en mémoire avant le COMMIT. À partir du moment où le COMMIT d’une transaction arrive, toutes les modifications effectuées dans ce cache par cette transaction sont enregistrées dans le fichier du journal de transactions.
La valeur par défaut de wal_buffers est de -1, ce qui correspond à un calcul automatique au démarrage de PostgreSQL. Avec les tailles de shared_buffers actuelles, il vaut généralement 16 Mo (la taille par défaut d’un segment du journal de transaction).
Avec de nombreuses transactions en écriture ou des écritures lourdes, il peut valoir le coup de monter ce paramètre à 32 ou 64 Mo.
1.4.3 Configuration - mémoire des processus
- work_mem
- par nœud d’exécution
- le temps du nœud
- valeur très dépendante de la charge et des requêtes
- fichiers temporaires vs saturation RAM
- × hash_mem_multiplier
- jointures & agrégats par hash
- maintenance_work_mem
- indexation, VACUUM
Les processus de PostgreSQL ont accès à la mémoire partagée, définie principalement par shared_buffers, mais ils ont aussi leur mémoire propre. Cette mémoire n’est utilisable que par le processus l’ayant allouée.
- Le paramètre le plus important est work_mem , qui définit la taille maximale de la mémoire de travail que peut utiliser un processus dans un nœud de requête, en particulier pour des tris
( ORDER BY ), certaines agrégations (par hash), certaines jointures (hash join notamment), des déduplications ( DISTINCT ), des CTE matérialisées ( WITH … AS … )…
- Autre paramètre capital, maintenance_work_mem définit la mémoire utilisable pour les opérations de maintenance lourdes : VACUUM , CREATE INDEX , REINDEX , ajouts de clé étrangère…
Cette mémoire liée au processus est rendue immédiatement après la fin de l’ordre concerné.
- Il existe aussi logical_decoding_work_mem (défaut : 64 Mo), utilisable pour chacun des flux de réplication logique (s’il y en a, ils sont rarement nombreux).
Opérations de maintenance & maintenance_work_mem: maintenance_work_mem peut être monté à 256 Mo à 1 Go, voire plus sur les machines récentes, car il concerne des opérations lourdes (indexation, nettoyage des index par VACUUM …). Leurs consommations de RAM s’additionnent, mais en pratique ces opérations sont rarement exécutées plusieurs fois simultanément. Monter au-delà de 1 Go n’a d’intérêt que pour la création ou la réindexation de très gros index. autovacuum_work_mem est la mémoire que s’autorise à prendre l’autovacuum pour les nettoyages d’index, et ce pour chaque worker de l’autovacuum (3 maximum par défaut). Par défaut, ce paramètre reprend maintenance_work_mem, et est généralement laissé tel quel. Paramétrage de work_mem: Configurer work_mem est plus compliqué.
Si work_mem est trop bas, beaucoup d’opérations ne s’effectueront pas en RAM. Par exemple, si une jointure par hachage impose d’utiliser 100 Mo en mémoire, mais que work_mem vaut 10 Mo, PostgreSQL écrira des dizaines de mégaoctets sur disque à chaque appel de la jointure. Par contre, si work_mem vaut 120 Mo, aucune écriture n’aura lieu sur disque, ce qui accélérera généralement la requête et réduira les I/O.
Trop de fichiers temporaires peuvent ralentir les opérations, voire saturer le disque. Supervisez leur présence. Mais il est illusoire de vouloir éviter tous les fichiers temporaires des grosses requêtes en montant work_mem à une valeur déraisonnable.
Un work_mem trop bas peut aussi contraindre le planificateur à choisir des plans d’exécution moins optimaux.
Si work_mem est trop haut, et que trop de requêtes le consomment simultanément, le danger est de saturer la RAM. Il n’existe en effet pas de limite à la consommation des sessions de PostgreSQL, ni globalement ni par session! Or le paramétrage de l’overcommit sous Linux est par défaut très permissif, et le noyau ne bloque rien. La première conséquence de la saturation de mémoire est l’assèchement du cache système (complémentaire de celui de PostgreSQL), et la dégradation des performances. Puis le système se met à swapper, avec à la clé un ralentissement général et durable. Enfin le noyau, à court de mémoire, est amené à tuer un processus de PostgreSQL. Cela mène à l’arrêt de l’instance, ou plus fréquemment à son redémarrage brutal avec coupure de toutes les connexions et requêtes en cours.
Toutefois, si l’administrateur désactive l’overcommit, Linux refuse d’allouer une RAM qu’il n’a pas, et la requête tombe en erreur. Le cache système est préservé, et PostgreSQL ne tombe pas.
(Pour la mise en place de l’overcommit sous Linux, voir le module J1 28, ou la base de connaissance Dalibo 29.) Suivant la complexité des requêtes, il est possible qu’un processus utilise plusieurs fois work_mem (par exemple si une requête fait une jointure et un tri, ou qu’un nœud est parallélisé). À l’inverse, beaucoup de requêtes ne nécessitent aucune mémoire de travail. La valeur de work_mem dépend donc beaucoup de la mémoire disponible, des requêtes et du nombre de connexions actives. Si le nombre de requêtes simultanées est important, work_mem devra être faible. Avec peu de requêtes simultanées, work_mem pourra être augmenté sans risque. 28 https://dali.bo/j1_html#configuration-de-la-surr%C3%A9servation-m%C3%A9moire 29 https://dali.bo/kb_overcommit
Il n’y a pas de formule de calcul miracle. Une première estimation courante, bien que très conservatrice, peut être:
On obtient alors, sur un serveur dédié avec 16 Go de RAM et 200 connexions autorisées:
Mais max_connections est fréquemment surdimensionné, et beaucoup de sessions sont inactives. work_mem est alors sous-dimensionné.
Plus finement, Christophe Pettus propose en première intention 30:
Soit, pour une machine dédiée avec 16 Go de RAM, donc 4 Go de shared buffers, et 200 connections:
Dans l’idéal, si l’on a le temps pour une étude, il faudra vérifier les requêtes générant la plupart des fichiers (optimisation, indexation…). Puis on peut monter progressivement et prudemment work_mem jusqu’à voir disparaître l’essentiel des fichiers temporaires dans les traces, à condition de rester loin de saturer la RAM lors des pics de charge.
En pratique, le défaut de 4 Mo est très conservateur, souvent insuffisant. Généralement, la valeur varie entre 10 et 100 Mo.
Au-delà de 100 Mo, il y a souvent un problème ailleurs: des tris sur de trop gros volumes de données, une mémoire insuffisante, un manque d’index (utilisés pour les tris), etc. Des valeurs vraiment grandes ne sont valables que sur des systèmes d’infocentre. Augmenter globalement la valeur du work_mem peut parfois mener à une consommation excessive de mémoire. Il est possible de ne la modifier que le temps d’une session pour les besoins d’une requête ou d’un traitement particulier:
hash_mem_multiplier: hash_mem_multiplier est un paramètre multiplicateur, qui peut s’appliquer à certaines opérations (le hachage, lors de jointures ou agrégations). Par défaut, il vaut 1 en versions 13 et 14, et 2 à partir de la 15. Le seuil de consommation fixé par work_mem est alors multiplié d’autant. Lors d’un hachage, l’optimiseur considère donc qu’il peut utiliser la mémoire jusqu’à hauteur de work_mem × 30 https://thebuild.com/blog/2023/03/13/everything-you-know-about-setting-work_mem-is-wrong/
hash_mem_multiplier et sinon il se rabat sur le disque. L’exécuteur comptabilise la mémoire utilisée, et en cas d’erreur d’estimation conduisant à un dépassement de cette limite de consommation de mémoire, le hachage est terminé sur le disque.
L’existence de hash_mem_multiplier permet de donner plus de RAM à ces opérations sans augmenter globalement work_mem. Il peut lui aussi être modifié dans une session.
1.4.4 Configuration - disques
- Des paramètres sont liés aux tablespaces
- io_combine_limit (v17)
- io_max_combine_limit (v18)
- 128 ko
- Lectures disques asynchrones (v18)
- io_method
- io_workers
PostgreSQL possède des paramètres liés aux disques. Ils peuvent se paramétrer globalement ou au niveau des tablespaces, nous les verrons à ce moment.
Depuis PostgreSQL 17 existe io_combine_limit qui permet de réduire le nombre d’appels système en regroupant les blocs demandés. En version 17 ne sont ainsi concernés que les parcours séquentiels, ANALYZE et l’extension pg_prewarm. Il est déconseillé de modifier ce paramètre sans tests sérieux préalables. La version 18 permet d’imposer aux utilisateurs une limite haute, configurable par un superutilisateur. Il faut pour cela configurer le paramètre io_max_combine_limit. Le défaut est là aussi de 128 ko.
À partir de la version 18, PostgreSQL propose de la lecture asynchrone. Pour cela, le paramètre io_method doit être configuré à la valeur worker (valeur par défaut) ou io_uring. Pour la méthode worker, les lectures asynchrones sont exécutées par des processus io worker, dont le nombre est configurable par le paramètre io_workers (3 par défaut). La méthode sync permet de revenir au comportement des versions antérieures à la 18.
Les premiers retours d’expérience suggèrent que la méthode par défaut, worker est à privilégier. Le gain en performances est net surtout pour les nœuds bitmap scan ou seq scan, ou encore des CREATE INDEX, mais pas pour les nœuds index scans. Des tests de Thomas Vondra en juin 31 et juillet 2025 32 suggèrent que la valeur par défaut de io_workers est conservatrice. Une valeur plus élevée est à tester et peut améliorer les performances.
31 https://www.postgresql.org/message-id/e6db33f3-50de-43d3-9d9f-747c3b376e80%40vondra.me 32 https://www.postgresql.org/message-id/21674729-87b9-4bdc-9f36-13f8072b550d%40vondra.me
1.4.5 Configuration - planificateur
- effective_cache_size
- somme des caches
- ~⅔ RAM
- random_page_cost
- 4 (défaut) pour disques magnétiques
- proche de 1 pour SSD
Le planificateur dispose de nombreux paramètres de configuration. Les deux principaux sont effective_cache_size et random_page_cost.
effective_cache_size: Il permet d’indiquer la taille totale du cache disque disponible pour une requête. Pour le configurer, il faut prendre en compte le cache de PostgreSQL ( shared_buffers ) et celui du système d’exploitation. Ce n’est donc pas une mémoire que PostgreSQL va allouer, mais plutôt une simple indication de ce qui est disponible. Le planificateur se base sur ce paramètre pour évaluer les chances de trouver des pages de données en mémoire. Une valeur plus importante aura tendance à faire en sorte que le planificateur privilégie l’utilisation des index, alors qu’une valeur plus petite aura l’effet inverse.
Généralement, on positionne effective_cache_size à ⅔ de la mémoire sur un serveur dédié à une instance PostgreSQL, voire aux trois quarts.
Une meilleure estimation est possible en parcourant les statistiques du système d’exploitation. Sur les systèmes Unix, ajoutez les nombres buffers+cached provenant des outils top ou free. Par exemple, sur une machine avec 2 Go de mémoire, il est possible d’avoir ceci:
total used free shared buffers cached
-/+ buffers/cache: 736800 1329352
Soit 789 116 Kio, résultat de l’addition de 190 580 (colonne buffers ) et 598 536 (colonne cached ). Il faut ensuite ajouter shared_buffers à cette valeur. Sur Windows, voir la partie « System Cache » dans l’onglet « Performance » du gestionnaire des tâches. random_page_cost: Le paramètre random_page_cost permet de faire appréhender au planificateur le fait qu’une lecture aléatoire (autrement dit avec déplacement de la tête de lecture) est autrement plus coûteuse qu’une lecture séquentielle. Par défaut, random_page_cost vaut 4, la lecture aléatoire d’un bloc donné a
donc un coût 4 fois plus important que s’il était lu au sein d’une lecture séquentielle avec de nombreux autres blocs. Ce n’est qu’une estimation, qui n’a pas à voir directement avec la vitesse des disques et prend aussi en compte l’effet du cache, et elle est plutôt adaptée aux disques magnétiques.
Si random_page_cost est revu à la baisse, les parcours aléatoires deviennent moins coûteux et, par conséquent, les parcours d’index sont plus facilement sélectionnés. Avec des disques magnétiques rapides, il ne faut pas hésiter à descendre un peu cette valeur (entre 2 et 3 par exemple). Si les données tiennent entièrement en cache ou sont stockées sur des disques SSD directement attachés, on descend souvent à 1,1. Il ne faut pas descendre en-dessous de seq_page_cost qui définit le coût pour une lecture séquentielle, et vaut 1,0. À l’inverse, un stockage réseau sur des SSD mais avec une grosse latence pourrait justifier de remonter la valeur de random_page_cost.
1.4.6 Configuration - parallélisation : principe
- Par défaut : 1 requête = 1 processus
- Grosses tables : parallel workers en complément
- Nombreux nœuds parallélisables
Par défaut, une requête possède un seul processus dédié sur le serveur, qui par défaut n’utilise qu’un seul cœur. Pour répartir la charge des grosses requêtes sur plusieurs cœurs, un processus PostgreSQL peut se faire aider d’autres processus durant l’exécution de certains nœuds.
Les parallel workers se répartissent les lignes issues, par exemple, d’un parcours. Un nœud est dédié à la récupération des résultats (gather). Il est opéré par le processus principal qui peut, s’il n’a rien à faire, participer au traitement réalisé par les parallel workers.
La parallélisation peut se faire sur différentes parties d’une requête, comme un parcours de table ou d’index, une jointure ou un calcul d’agrégat.
La mise en place de la parallélisation a un coût. En conséquence, la parallélisation n’est possible sur un parcours que si la table ou l’index est suffisamment volumineux.
Le coût du transfert des lignes est aussi pris en compte. En conséquence, ce même parcours de table ou d’index ne sera pas forcément parallélisé s’il n’y a pas une clause de filtrage, par exemple.
En pratique, cette parallélisation n’a d’intérêt que si les performances sont contraintes d’abord par le CPU, et non par les disques.
1.4.7 Configuration - parallélisation : paramètres
- Nombre de parallel workers :
- max_parallel_workers_per_gather (défaut : 2)
- max_parallel_workers (8)
- max_worker_processes (8)
- Taille minimale des tables/index :
- min_parallel_table_scan_size (8 Mo)
- min_parallel_index_scan_size (512 ko)
- Indexation et VACUUM :
- max_parallel_maintenance_workers (2)
Paramètre principaux: Le nombre maximum de processus utilisables pour un nœud d’exécution dépend de la valeur du paramètre max_parallel_workers_per_gather (à 2 par défaut). Ils ne seront lancés que si la requête le nécessite. Si plusieurs processus veulent paralléliser l’exécution de leur requête au même moment, le nombre total de workers parallèles simultanés ne pourra pas dépasser la valeur du paramètre max_parallel_workers (8 par défaut).
Ce nombre ne peut lui-même dépasser la valeur du paramètre max_worker_processes, nombre de processus d’arrière-plan. (Avant PostgreSQL 10, le paramètre max_parallel_workers n’existait pas et la limite se basait sur max_worker_processes.)
Impact de la volumétrie: Le volume déclencheur dépend pour les tables de la valeur du paramètre min_parallel_table_scan_size (8 Mo par défaut) et de celle de min_parallel_index_scan_size (512 ko par défaut) pour les index. Ces paramètres sont rarement modifiés. Le moteur détermine ensuite ainsi le nombre de workers à lancer:
- Taille de la relation = T
- min_parallel_table_scan_size = S (dans le cas d’une table)
- si T < S : pas de worker
- si T ≥ S : on utilise 1 worker en plus du processus principal
- si T ≥ S×3 : 2 workers en plus du processus principal
- si T ≥ S×3×3 : 3 workers en plus du processus principal
- si T ≥ S×3×3×3 : 4 workers en plus du processus principal
- etc.
Si le processus ne peut lancer tous les workers qu’il a prévu, il poursuit sans message d’erreur avec ceux qu’il peut lancer.
Le coût induit par la mise en place du parallélisme est défini par parallel_setup_cost (1000 par défaut, rarement modifié). Il faut se rappeler que le processus principal traite lui aussi des lignes, comme ses parallel workers. Il pourrait donc devenir un goulet d’étranglement. Le paramètre parallel_leader_participation peut alors être passé à off afin qu’il ne s’occupe plus que de récupérer et traiter le résultat des workers. Exemple: Le parcours suivant sur une table de 13 Go demande 7 parallel workers (mention Planned). Cela est possible car on a monté max_parallel_workers_per_gather au moins à 7. Seuls 4 parallel workers ont été accordés: le seuil de max_parallel_workers a dû être dépassé à cause d’autres requêtes. On note 5 boucles (loops) car le processus principal participe aussi au parcours. EXPLAIN (ANALYZE, COSTS OFF)
L’option VERBOSE donne plus de détails:
Mémoire: Les processus parallélisés sont susceptibles d’utiliser chacun l’équivalent des ressources mémoire d’un processus.
Concrètement, chaque parallel worker d’un nœud consommant de la mémoire est susceptible d’utiliser la quantité définie par work_mem. La parallélisation peut donc augmenter le besoin en mémoire.
Paramétrage:
Le défaut de max_worker_processes est 8. Ne descendez pas plus bas, car les background workers sont de plus en plus utilisés par les nouvelles fonctionnalités de PostgreSQL et les extensions tierces, et modifier ce paramètre implique de redémarrer. Sur les machines modernes, il peut être monté assez haut (bien au-delà du nombre de cœurs).
Les autres paramètres peuvent être modifiés avec SET au sein d’une session.
Le choix de max_parallel_workers dépend du nombre de cœurs. Le défaut de 8 est trop bas pour la plupart des machines récentes. La valeur de max_parallel_workers_per_gather dépend du type des grosses requêtes et du nombre de requêtes tournant simultanément. Les petites requêtes (OLTP) profiteront rarement du parallélisme. Des configurations assez agressives sur de grosses configurations vont bien au-delà du nombre de cœurs 33.
Cependant, il ne sert à rien de trop paralléliser si les disques ne suivent pas, ou si le nombre de cœurs est réduit. Et si ces paramètres sont trop hauts, il y a un risque que les grosses requêtes saturent les CPU au détriment des plus petites et d’autres processus.
Par contre, si le paramétrage est trop prudent, les CPU seront sous-utilisés. De nombreuses requêtes candidates au parallélisme peuvent se retrouver privées de worker, ce qui mènera à des plans suboptimaux. Là encore, la supervision et l’expérimentation prudente sont nécessaires.
Création et maintenance d’index:
La création d’un index B-tree peut être parallélisée. Le paramètre max_parallel_maintenance_workers, par défaut à 2, indique le nombre de workers utilisables lors de la création d’un index, mais aussi de son nettoyage lors d’un VACUUM. Le gain de temps peut être appréciable. Cette opération étant assez rare, le paramètre peut être monté assez haut. Les limites de max_worker_processes et max_parallel_workers s’appliquent là encore.
Contrairement au cas de work_mem qui peut être alloué par chaque worker lors d’un tri, maintenance_work_mem est allouée une seule fois et partagé entre les différents workers.
Référence:
La documentation a un chapitre entier sur le sujet du parallélisme 34.
33 https://thebuild.com/blog/2023/02/08/xtreme-postgresql/ 34 https://docs.postgresql.fr/current/parallel-query.html
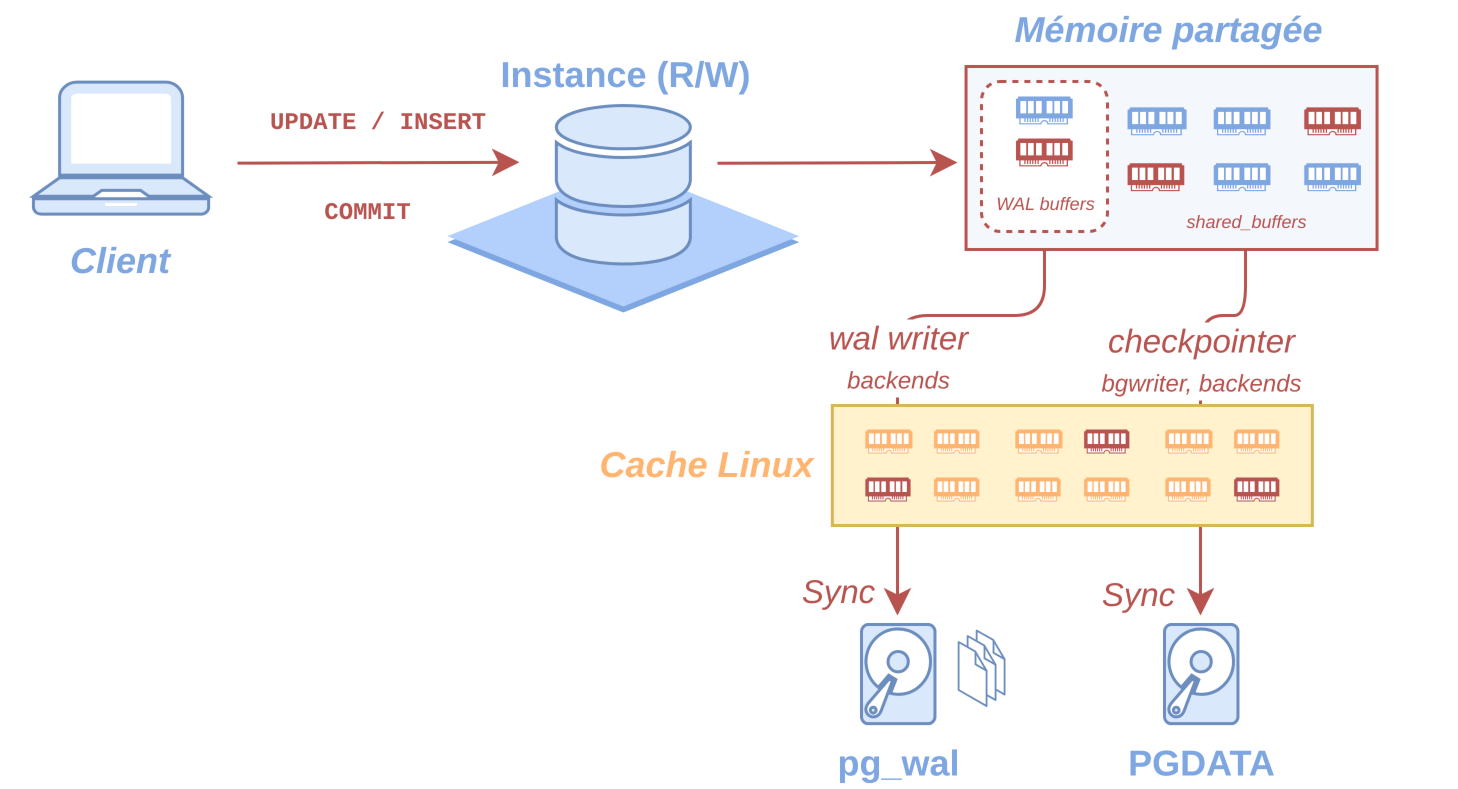
1.4.8 Rappels sur la journalisation (1)
1.4.9 Rappels sur la journalisation (2)
- Write Ahead Logs (WAL)
- Chaque donnée est écrite 2 fois sur le disque !
- Avantages :
- sécurité infaillible (après COMMIT ), intégrité, durabilité
- écriture séquentielle rapide, et un seul sync sur le WAL
- fichiers de données écrits en asynchrone
- sauvegarde PITR et réplication fiables
Le paramétrage lié à la journalisation nécessite de rappeler son principe. Les journaux de transactions (appelés souvent WAL) sont une garantie contre les pertes de données. Il s’agit d’une technique standard de journalisation appliquée à toutes les transactions, pour garantir l’intégrité (la base reste cohérente quoiqu’il arrive) et la durabilité (ce qui est validé ne sera pas perdu). Ainsi lors d’une modification de donnée, l’écriture au niveau du disque se fait généralement en deux temps:
- écriture des modifications dans le journal de transactions, avec écriture forcée sur disque (« synchronisation ») lors d’un COMMIT ;
- écriture dans le fichier de données bien plus tard, lors d’un « checkpoint ».
Ainsi en cas de crash:
- PostgreSQL redémarre;
- il vérifie s’il reste des données non intégrées aux fichiers de données dans les journaux (mode recovery);
- si c’est le cas, ces données sont recopiées dans les fichiers de données afin de retrouver un état stable et cohérent;
- PostgreSQL peut alors s’ouvrir sans perte des transactions validées lors du crash (une transaction interrompue, et donc jamais validée, est perdue).
Les écritures dans le journal se font de façon séquentielle, donc sans grand déplacement de la tête d’écriture (sur un disque dur classique, c’est l’opération la plus coûteuse). De plus, comme nous n’écrivons que dans un seul fichier de transactions, la synchronisation sur disque, lors d’un COMMIT, peut se faire sur ce seul fichier, si le système de fichiers le supporte. Concrètement, ces journaux sont des fichiers de 16 Mo par défaut, avec des noms comme 0000000100000026000000AF, dans le répertoire pg_wal/ de l’instance PostgreSQL (répertoire souvent sur une partition dédiée).
L’écriture définitive dans les fichiers de données est asynchrone, et généralement lissée, ce qui est meilleur pour les performances qu’une écriture immédiate. Cette opération est appelée « checkpoint » et périodique (5 minutes par défaut, ou plus). Divers paramètres et fonctionnalités peuvent altérer ce comportement par défaut, par exemple pour des raisons de performances. À côté de la sécurité et des performances, le mécanisme des journaux de transactions est aussi utilisé pour des fonctionnalités très intéressantes, comme le PITR et la réplication physique, basés sur le rejeu des informations stockées dans ces journaux. Pour plus d’informations:
- PostgreSQL et ses journaux de transactions 35 , Guillaume Lelarge, GNU/Linux Magazine n°108 (septembre 2008), encore d’actualité pour l’essentiel.
1.4.10 Configuration - WAL
- fsync ( on !)
- moins dangereux : synchronous_commit
- Souvent montés ensemble avec de grosses écritures :
- checkpoint_timeout (5 min, ou plus)
- max_wal_size (1 Go)
- min_wal_size (80 Mo)
fsync est le paramètre qui assure que les données sont bien écrites physiquement sur le disque (synchronisation). En effet, PostgreSQL écrit dans ses fichiers via des appels système au noyau; et celui-ci, pour des raisons de performances, conserve dans un premier temps les données dans un cache. En cas de coupure de courant, si ce cache n’est pas vidé sur disque, il est possible que des données enregistrées par un COMMIT implicite ou explicite n’aient pas atteint le disque et soient donc perdues une fois le serveur redémarré; ou, pire, que des données aient été modifiées dans des fichiers de données, sans avoir été auparavant écrites dans le journal. Cela entraînera des incohérences dans les fichiers de données au redémarrage. Il est donc essentiel que les données enregistrées dans les journaux de transactions soient non seulement écrites, mais que le noyau soit forcé de les écrire réellement sur disque. Cette opération s’appelle fsync, et est activée par défaut ( on ).
Il est donc obligatoire en production de conserver fsync à on. C’est essentiel pour éviter des corruptions, même si cela impacte très négativement les performances en écriture en cas de nombreuses transactions.
Pour accélérer de très gros imports ou restaurations, on peut le passer exceptionnellement à off, et l’on n’oubliera pas de revenir à on ensuite.
synchronous_commit: Dans le cas de nombreuses petites transactions dont on peut accepter de perdre les toutes dernières en cas de crash (par exemple l’insertion de données de capteurs), le paramétrage qui suit dans la session peut énormément accélérer les insertions, avec en cas de crash une petite perte de données, mais pas de corruption:
Pour les détails, voir: https://dali.bo/m3_html#:~:text=synchronous_commit Étaler les checkpoints: Chaque bloc modifié dans le cache disque de PostgreSQL doit être écrit sur disque au bout d’un certain temps, au cours d’une opération périodique nommée checkpoint. La périodicité par défaut est de 5 minutes.
Pour lisser des grosses écritures, on monte fréquemment le paramètre checkpoint_timeout à 15 minutes, voire plus.
Cette augmentation peut avoir l’intérêt de réduire la taille des journaux générés: en effet, PostgreSQL écrit un bloc modifié intégralement dans les journaux lors de sa première modification après un checkpoint et une fois que ce bloc intégral est enregistré, il n’écrit plus que des deltas du bloc correspondant aux modifications réalisées.
Pour éviter une accumulation excessive de journaux, le checkpoint peut aussi se déclencher à partir d’un seuil de volumétrie de journaux. Les paramètres concernés sont:
- max_wal_size : quantité maximale de WAL avant de forcer un checkpoint (par défaut 1 Go, mais on peut monter beaucoup plus haut) ;
- min_wal_size : quantité minimale de WAL conservés pour le recyclage (par défaut 80 Mo).
Le nom du paramètre max_wal_size peut porter à confusion: le volume de journaux dans le répertoire pg_wal/ peut dépasser largement max_wal_size en cas de forte activité ou de retard de l’archivage. max_wal_size n’est en aucun cas une valeur plafond.
Un checkpoint déclenché par atteinte du seuil max_wal_size apparaît dans postgresql.log. Si cela arrive trop fréquemment, il est conseillé d’augmenter ensemble les deux paramètres max_wal_size et checkpoint_timeout.
checkpoint_completion_target permet de lisser les écritures du checkpoint pour éviter de saturer les disques par de grosses écritures au détriment des requêtes des utilisateurs. On le monte généralement à 0.9 (soit 90 % de checkpoint_timeout, donc 4 minutes et demie par défaut). D’ailleurs, à partir de la version 14, il s’agit de la valeur par défaut.
1.4.11 Configuration - statistiques & trace
- Traces à rendre plus verbeuses ( log_* )
- Statistiques d’activité ( track_* )
- https://dali.bo/h1_slides
- Pour analyse par :
- pgBadger
- pg_stat_statements…
Il est chaudement conseillé de tracer le maximum de choses dans postgresql.log. La configuration par défaut est peu verbeuse. De nombreux paramètres sont à activer ou modifier, décrits en détail dans le module H1 - Supervision de PostgreSQL 36, en premier lieu log_temp_files, log_lock_waits, log_temp_files, log_line_prefix. log_min_duration_statement doit être aussi bas que possible mais postgresql.log peut alors devenir énorme. Il peut être mis à 0 temporairement, le temps d’un audit. Ces paramètres vous permettront de générer des rapports grâce à pgBadger 37, ou plus simplement de pouvoir analyser un souci. 36 https://dali.bo/h1_html 37 https://dali.bo/h1_html#pgbadger
D’autres paramètres sont à activer pour compléter les statistiques d’activité, comme track_functions, track_io_timing, track_io_timing (voir encore H1 - Supervision de PostgreSQL 38 ). Leur exploitation se fait entre autres avec l’extension pg_stat_statements 39.
1.4.12 Configuration - autovacuum
- Ne jamais le désactiver
- À rendre plus agressif
- autovacuum_vacuum/analyze_scale_factor (20 / 10 %), etc. (grosses tables)
- autovacuum_max_workers (3)
- et autres paramètres pour l’activer
- Ne pas hésiter à le planifier chaque nuit
- Voir https://dali.bo/m5_slides
L’autovacuum est activé par défaut et doit être laissé ainsi (paramètre autovacuum à on ). Ce processus supplémentaire coûte un peu en performances, mais il s’acquitte de deux tâches importantes pour les performances:
- recycler les lignes mortes et éviter une fragmentation importante dans les tables et index;
- mettre à jour les statistiques sur les données ( ANALYZE ).
Pour les détails, voir le module de formation dédié M5 - VACUUM & autovacuum 40. Retenons trois conseils:
- L’autovacuum ne passe pas assez souvent sur les grosses tables. Il est conseillé de le rendre plus agressif, par exemple en réduisant le seuil de déclenchement avant un VACUUM automatique ( autovacuum_vacuum_scale_factor , par défaut 20 % de lignes modifiées), ou avant
un ANALYZE automatique ( autovacuum_analyze_scale_factor, par défaut 10 %), ou leurs équivalents en nombre de lignes fixes ( autovacuum_*threshold ), sur la table.
- Il existe divers paramètres pour accélérer le travail de l’autovacuum. autovacuum_max_workers , notamment, peut être augmenté au-delà de 3 si vous avez de nombreuses tables.
- De nombreuses optimisations dépendent d’un passage fréquent de l’autovacuum. Planifier un VACUUM ANALYZE , en plus de la configuration ci-dessus, garantit qu’aucune table ne sera négligée.
38 https://dali.bo/h1_html 39 https://dali.bo/x2_html#pg_stat_statements 40 https://dali.bo/m5_html
1.4.13 Tablespaces : principe
- Espace de stockage physique d’objets
- et non logique !
- Simple répertoire (hors de PGDATA)
- lien symbolique depuis pg_tblspc
- Pour :
- répartir I/O et volumétrie
- données froides/chaudes
- tri sur disque séparé
Dans PGDATA, le sous-répertoire pg_tblspc contient les tablespaces, c’est-à-dire des espaces de stockage.
1.4.13.1 Sous Linux
Sous Linux, ce sont des liens symboliques vers un simple répertoire extérieur à PGDATA. Chaque lien symbolique a comme nom l’OID du tablespace (table système pg_tablespace ). PostgreSQL y crée un répertoire lié aux versions de PostgreSQL et du catalogue, et y place les fichiers de données.
Liste des tablespaces
| Nom | Propriétaire | Emplacement | … | Taille | … |
|---|---|---|---|---|---|
| froid | postgres | /mnt/hdd/pg | 3576 kB | ||
| pg_default | postgres | 6536 MB | |||
| pg_global | postgres | 587 kB |
/mnt/hdd/pg: PG_15_202209061
/mnt/hdd/pg/PG_15_202209061: 5
/mnt/hdd/pg/PG_15_202209061/5: 142532 142532_fsm 142532_vm
1.4.13.2 Sous Windows
Sous Windows, les liens sont à proprement parler des Reparse Points (ou Junction Points):
Liste des tablespaces
| Nom | Propriétaire | Emplacement |
|---|
| pg_default | postgres | |
|---|---|---|
| pg_global | postgres | |
| tbl1 | postgres | T:\TBL1 |
FullName LinkType Target ——– ——– —— P:\PGDATA13\pg_tblspc\105921 Junction {T:\TBL1}
Par défaut, pg_tblspc/ est vide. N’existent alors que les tablespaces pg_global (sous-répertoire global/ des objets globaux à l’instance) et pg_default (soit base/ ).
1.4.13.3 Utilité des tablespaces
Un tablespace, vu de PostgreSQL, est un espace de stockage des objets (tables et index principalement). Son rôle est purement physique, il n’a pas à être utilisé pour une séparation logique des tables (c’est le rôle des bases et des schémas), encore moins pour gérer des droits. Pour le système d’exploitation, il s’agit juste d’un répertoire, déclaré ainsi:
L’idée est de séparer physiquement les objets suivant leur utilisation. Les cas d’utilisation des tablespaces dans PostgreSQL sont:
- l’ajout d’un disque après saturation de la partition du PGDATA sans possibilité de l’étendre au niveau du système (par LVM ou dans la baie de stockage, par exemple);
- la répartition des entrées-sorties… si le SAN ou la virtualisation permet encore d’agir à ce niveau;
- et notamment la séparation des index et des tables, pour répartir les écritures;
- le déport des fichiers temporaires vers un tablespace dédié, pour la performance ou éviter qu’ils saturent le PGDATA;
- la séparation entre données froides et chaudes sur des disques de performances différentes, ou encore des index et des tables;
- les quotas : PostgreSQL ne disposant pas d’un système de quotas, dédier une partition entière d’une taille précise à un tablespace est un contournement; une transaction voulant étendre un
fichier sera alors annulée avec l’erreur cannot extend file.
Sans un réel besoin physique, il n’y a pas besoin de créer des tablespaces, et de complexifier l’administration.
Un tablespace n’est pas adapté à une séparation logique des objets. Si vous tenez à distinguer les fichiers de chaque base sans besoin physique, rappelez-vous que PostgreSQL crée déjà un sous-répertoire par base de données dans PGDATA/base/. PostgreSQL ne connaît pas de notion de tablespace en lecture seule, ni de tablespace transportable entre deux bases ou deux instances.
1.4.13.4 Emplacement des tablespaces
Il y a quelques pièges à éviter à la définition d’un tablespace:
Pour des raisons de sécurité et de fiabilité, le répertoire choisi ne doit pas être à la racine d’un point de montage. (Cela vaut aussi pour les répertoires PGDATA ou pg_wal ).
Positionnez toujours les données dans un sous-répertoire, par exemple dans /mnt/ssd/pg plutôt que directement dans le point de montage /mnt/ssd. (Voir Utilisation de systèmes de fichiers secondaires 41 dans la documentation officielle, ou le bug à l’origine de ce conseil 42.)
Surtout, le tablespace doit impérativement être placé hors de PGDATA. Certains outils poseraient problème sinon.
Si ce conseil n’est pas suivi, PostgreSQL crée le tablespace mais renvoie un avertissement:
CREATE TABLESPACE
Il est aussi déconseillé de mettre le numéro de version de PostgreSQL dans le chemin du tablespace. PostgreSQL le gère déjà à l’intérieur du tablespace. Cela évite des incohérences dans les noms des chemins si vous migrez plus tard avec pg_upgrade.
1.4.14 Tablespaces : mise en place
– déclaration
– droit pour un utilisateur
– pour toute une base
– pour une table
– pour un index (pas automatique)
Le répertoire du tablespace doit exister et les accès ouverts et restreints à l’utilisateur système sous lequel tourne l’instance (en général postgres sous Linux, Network Service sous Windows): 41 https://doc.postgresql.fr/current/creating-cluster.html#CREATING-CLUSTER-MOUNT-POINTS 42 https://bugzilla.redhat.com/show_bug.cgi?id=1247477#c1
Les ordres SQL plus haut permettent de:
- créer un tablespace simplement en indiquant son emplacement dans le système de fichiers du serveur;
- créer une base de données dont le tablespace par défaut sera celui indiqué ;
- modifier le tablespace par défaut d’une base;
- donner le droit de créer des tables dans un tablespace à un utilisateur (c’est nécessaire avant de l’utiliser) ;
- créer une table dans un tablespace;
- déplacer une table dans un tablespace;
- déplacer un index dans un tablespace.
Quelques choses à savoir:
- La table ou l’index est totalement verrouillé le temps du déplacement.
- Par défaut, les nouveaux index ne sont pas créés automatiquement dans le même tablespace que la table, mais en fonction de default_tablespace .
- Les index existants ne « suivent » pas automatiquement une table déplacée, il faut les déplacer séparément.
- Il est possible de préciser un tablespace de réindexation lors d’une réindexation ( REINDEX … TABLESPACE … ).
Les tablespaces des tables sont visibles dans la vue système pg_tables, dans \d+ sous psql, et dans pg_indexes pour les index:
SELECT schemaname, indexname, tablespace
| schemaname | indexname | tablespace |
|---|---|---|
| public | matable_idx | chaud |
| public | matable_pkey |
1.4.15 Tablespaces : configuration
- default_tablespace
- temp_tablespaces :
- tri & tables temporaires, en alternance
- protéger le PGDATA ALTER ROLE etl SET temp_tablespaces = ssd_tmp1,ssd_tmp2;
1.4.15.1 Tablespaces de données
Le paramètre default_tablespace permet d’utiliser un autre tablespace que celui par défaut dans PGDATA. En plus du postgresql.conf, il peut être défini au niveau rôle, base, ou le temps d’une session:
1.4.15.2 Tablespaces temporaires
Les fichiers temporaires générés par certains nœuds de requête (tris, hash joins, CTE matérialisées…) ainsi que les tables temporaires peuvent être déplacés vers un ou plusieurs tablespaces dédiés grâce au paramètre temp_tablespaces. Le premier intérêt est de leur dédier une partition rapide (SSD, disque local…). Un autre est de ne plus risquer de saturer la partition du PGDATA en cas de fichiers temporaires énormes dans base/pgsql_tmp/.
Ne jamais utiliser de RAM disque (comme tmpfs ) pour des tablespaces temporaires car la mémoire de la machine ne doit servir qu’aux applications et aux outils, au cache de l’OS, et aux opérations de PostgreSQL en RAM. Favorisez ces derniers en jouant sur work_mem. En cas de redémarrage, ce tablespace ne serait d’ailleurs plus utilisable. Un RAM disque est encore plus dangereux pour les tablespaces de données, bien sûr.
Il faudra ouvrir les droits aux utilisateurs ainsi:
Plusieurs tablespaces temporaires peuvent être paramétrés. Noter que la déclaration se fait sans guillemet. Chaque transaction en choisira un de façon aléatoire à la création d’un objet temporaire, puis utilisera alternativement les autres pour chaque nouveau fichier. C’est un bon moyen de lisser la charge:
- lors d’une requête, un gros fichier temporaire peut s’étaler sur plusieurs tablespaces temporaires, car il se découpe au besoin en fichiers de 1 Go, voire moins ;
- les différentes tables temporaires d’une même session se répartiront dans les différents tablespaces temporaires; par contre les différents fichiers d’une grosse table temporaire resteront ensemble dans le même tablespace (une table n’a qu’un tablespace), et ses index avec elle par
défaut.
Si un des tablespaces temporaires sature, la requête tombe en erreur immédiatement : PostgreSQL ne regarde pas si autre tablespace temporaire a de la place libre. Il vaut donc mieux regrouper les espaces disponibles dans un même système de fichiers, et n’avoir qu’un grand tablespace temporaire.
1.4.16 Tablespaces : performance
- Temps d’accès
- seq_page_cost (1)
- random_page_cost (4)
- Opérations simultanées sur le disque
- effective_io_concurrency (1) → 16
- maintenance_io_concurrency (10)
Dans le cas de disques de performances différentes, il faut adapter les paramètres concernés aux caractéristiques du tablespace si la valeur par défaut ne convient pas. Ce sont des paramètres classiques
qui ne seront pas décrits en détail ici:
- seq_page_cost (coût d’accès à un bloc pendant un parcours, défaut 1) ;
- random_page_cost (coût d’accès à un bloc isolé, défaut 4) ;
- effective_io_concurrency (nombre d’I/O simultanées, défaut 1) ;
- maintenance_io_concurrency (idem, pour une opération de maintenance, défaut 10).
effective_io_concurrency: effective_io_concurrency a pour but d’indiquer le nombre d’opérations disques possibles en même temps pour un client (prefetch). Il n’a d’intérêt que si un nœud Bitmap Scan a été choisi. Cela n’arrive qu’avec un certain nombre de lignes à récupérer, et est favorisé par une valeur importante de effective_cache_size et un peu de corrélation physique dans la table.
La valeur d’ effective_io_concurrency n’influe pas sur le choix du plan, mais sa valeur peut notablement accélérer l’exécution du Bitmap Heap Scan. Le temps de lecture peut fréquemment être divisé par 3 ou plus. Les valeurs possibles d’ effective_io_concurrency vont de 0 à 1000. En principe, sur un disque magnétique seul, la valeur 1 ou 0 peut convenir. Avec du SSD, et encore plus du NVMe, il est possible de monter à plusieurs centaines, étant donné la rapidité de ce type de disque. Trouver la bonne valeur dépend de divers paramètres liés aux caractérisques exactes des disques et de leur paramétrage noyau. Le read ahead du noyau intervient également. Le comportement de PostgreSQL sur ce point change aussi avec les versions. De plus, à partir d’un certain nombre de blocs, les I/O peuvent simplement saturer. La valeur par défaut de 1 (jusque PostgreSQL 17) a été choisie de manière très conservatrice. Les développeurs ont décidé 43 que la valeur 16 est plus intéressante, même sur de vieux disques, et que ce sera le défaut à partir de PostgreSQL 18 44, qui inclut d’autres améliorations. À l’inverse, la mauvaise latence de certains systèmes aux disques en principe performants (baies surchargées, certains stockages cloud…) peut parfois être compensée par un effective_io_concurrency plus élevé.
Il faut tester avec vos requêtes qui utilisent des Bitmap Heap Scan, et tenir compte du nombre de requêtes simultanées, mais effective_io_concurrency = 16 semble un bon point de départ, même sur une configuration modeste. Montez si vous avez de bons disques.
Une valeur excessive de effective_io_concurrency mène à un gaspillage de CPU: ne pas monter trop haut sans preuve de l’utilité, surtout sur un système très chargé.
43 https://www.postgresql.org/message-id/flat/CAAKRu_Z%2BJa-mwXebOoOERMMUMvJeRhzTjad4dSThxG0JLXESxw%40mail.gmail.com#c028f5b93307aafb9fe6d09d0cf3eeae 44 https://git.postgresql.org/gitweb/?p=postgresql.git;a=commit;h=ff79b5b2aba02d720f9b7fff644dd50ce07b8c6e
Pour les systèmes RAID matériels, selon la documentation 45, configurer ce paramètre en fonction du nombre n de disques utiles dans le RAID (n/2 s’il s’agit d’un RAID 1, n-1 s’il s’agit d’un RAID 5 ou 6, n/2 s’il s’agit d’un RAID 10). (Avant la version 13, le principe d’ effective_io_concurrency était le même, mais la valeur exacte de ce paramètre devait être 2 à 5 fois plus basse comme le précise la formule des notes de version de la version 13 46.) maintenance_io_concurrency: maintenance_io_concurrency est similaire à effective_io_concurrency, mais pour les opérations de maintenance. Celles-ci peuvent ainsi se voir accorder plus de ressources qu’une simple requête. Il faut penser à le monter aussi si on adapte effective_io_concurrency. Par exemple, un système paramétré pour des disques classiques aura comme paramètres par défaut:
et un tablespace sur un SSD voire un disque NVMe les surchargera ainsi:
1.4.17 Emplacement des journaux de transactions
- Placer les journaux sur un autre disque
- Installation : initdb –wal-dir
- Ou créer le lien symbolique
Chaque donnée modifiée est écrite une première fois dans les journaux de transactions et une deuxième fois dans les fichiers de données. Cependant, les écritures dans ces deux types de fichiers sont très différentes. Les opérations dans les journaux de transactions sont uniquement des écritures séquentielles, sur de petits fichiers (d’une taille de 16 Mo par défaut), alors que celles des fichiers de données sont des lectures et des écritures fortement aléatoires, sur des fichiers bien plus gros (au maximum 1 Go). Du fait d’une utilisation très différente, avoir un système disque pour l’un et un système disque pour l’autre permet de gagner énormément en performances. Il faut donc pouvoir les séparer. La commande initdb permet de créer une instance en positionnant le répertoire dédié aux journaux de transaction en dehors du répertoire de données. Pour cela, il faut utiliser l’option -X ou –waldir:
45 https://docs.postgresql.fr/current/runtime-config-resource.html#GUC-EFFECTIVE-IO-CONCURRENCY 46 https://docs.postgresql.fr/13/release.html
Les outils enrobant cet appel ont des options équivalentes:
- sur Debian, on peut définir l’option waldir dans /etc/postgresql-common/createcluster.conf avant d’appeler pg_createcluster , ou préciser le répertoire à l’appel ainsi :
- sur Red Hat & ses dérivés :
Un lien symbolique est créé dans le répertoire de données pour que PostgreSQL retrouve le répertoire des journaux de transactions. Si l’on souhaite modifier une instance existante, il est nécessaire d’arrêter PostgreSQL, de déplacer le répertoire des journaux de transactions, de créer un lien vers ce répertoire, et enfin de redémarrer PostgreSQL. Voici un exemple qui montre le déplacement dans /mnt/17/pgwal.
lrwxrwxrwx. 1 root root 6 Sep 18 16:07 pg_wal -> /mnt/17/pgwal
1.4.18 Emplacement des fichiers statistiques
- Avant la v15
- placer les fichiers statistiques sur un autre disque
- option stats_temp_directory
- À partir de la v15
- cela peut être intéressant pour pg_stat_statements
PostgreSQL met à disposition différents compteurs statistiques via des vues. Avant la version 15, les vues système utilisent des métriques stockées dans des fichiers de statistiques. Ces fichiers sont mis à jour par le processus stats collector. Ils sont localisés dans un répertoire pointé par le paramètre stats_temp_directory. Par défaut, les fichiers sont stockés dans le sousrépertoire pg_stat_tmp du répertoire principal des données. Habituellement, cela ne pose pas de difficultés, mais sous une forte charge, il peut apparaître une forte activité disque à cause du processus stats collector.
Lorsque le problème se pose, il est recommandé de déplacer ces fichiers en RAM avec la procédure suivante. Attention, le module pg_stat_statements, s’il est installé, sauvegarde le texte des requêtes également à cet emplacement, sans limite de taille pour la taille des requêtes. L’espace occupé par ces statistiques peut donc être très important. Le RAM disque fera donc au moins 64, voire 128 Mo, pour tenir compte de ce changement. Le point de montage employé doit être placé à l’extérieur du PGDATA. Sur Debian, Ubuntu et dérivés, cela est fait par défaut: stats_temp_directory pointe vers un répertoire dans /run, qui est un tmpfs. Sur Rocky Linux 8, la procédure est:
- création du point de montage (en tant qu’utilisateur postgres) :
- création et montage du système de fichiers :
-t tmpfs tmpfs /var/lib/pgsql/14/pg_stat_tmpfs
… tmpfs on /var/lib/pgsql/14/pg_stat_tmpfs type tmpfs (rw,nosuid,nodev,noexec,noatime,seclabel,size=262144k,mode=700,uid=26,gid=26)
- modification de la configuration PostgreSQL dans postgresql.conf :
- recharger la configuration de PostgreSQL :
stats_temp_directory ———————- /var/lib/pgsql/14/pg_stat_tmpfs
- vérifier dans postgresql.conf que le changement de paramètre a bien été pris en compte et qu’il n’y a pas d’erreur :
- ajouter au fichier /etc/fstab la ligne suivante pour que la modification survive au prochain redémarrage :
Depuis la version 15, le paramètre stats_temp_directory n’existe plus, car les informations statistiques sont conservées en mémoire partagée. À l’arrêt de l’instance, elles sont enregistrées sur disque dans le répertoire pg_stat. Comme pg_stat et pg_stat_tmp/ restent utilisés par pg_stat_statements et d’autres extensions, le principe du lien symbolique vers tmpfs reste valable en version 15.
1.5 OUTILS
- pgtune
- pgbench
Nous allons discuter de trois outils. Le premier, pgtune, est un petit script permettant d’obtenir rapidement et simplement une configuration un peu plus optimisée que celle proposée par la commande initdb.
Le second est livré avec les sources de PostgreSQL. pgbench a pour but de permettre la réalisation de benchmarks simples pour un serveur PostgreSQL.
1.5.1 pgtune
- Outil écrit en Python, par Greg Smith
- repris en Ruby par Alexey Vasiliev
- Propose quelques meilleures valeurs pour certains paramètres
- Quelques options pour indiquer des informations système
- Version web : https://pgtune.leopard.in.ua/
- Il existe également pgconfig : https://www.pgconfig.org/
Le site du projet en ruby 47 se trouve sur github. pgtune est capable de trouver la quantité de mémoire disponible sur le système. À partir de cette information et de quelques règles internes, il arrive à déduire une configuration bien meilleure que la configuration par défaut. Il est important de lui indiquer le type d’utilisation principale: Web, datawarehouse, mixed, etc. Exemple de configuration modeste: Commençons par une configuration pour une utilisation par une application web sur une petite machine avec 8 Go de RAM, 2 CPU, un stockage mécanique (HDD):
47 https://github.com/le0pard/pgtune
Dans une application web, beaucoup d’utilisateurs exécutent de petites requêtes simples, très rapides, non consommatrices. Le nombre de connexions est donc doublé par rapport à sa valeur par défaut (cela suppose qu’il n’y a pas de pooler). Le paramètre work_mem est augmenté mais raisonnablement par rapport à la mémoire totale et au nombre de connexions. Le paramètre shared_buffers se trouve comme souvent au quart de la mémoire, et le paramètre effective_cache_size est aux deux tiers, comme recommandé précédemment. Le paramètre wal_buffers est aussi augmenté, il arrive à 16 Mo. Il peut y avoir beaucoup de transactions en même temps, mais elles seront généralement peu coûteuses en écriture, d’où le fait que les paramètres min_wal_size, max_wal_size sont augmentés. mais là aussi très raisonnablement. La parallélisation est activée, sans excès.
Exemple de configuration OLTP:
Voyons maintenant avec un profil OLTP (OnLine Transaction Processing):
Une application OLTP doit gérer un plus grand nombre d’utilisateurs. Ils font autant d’opérations de lecture que d’écriture. Tout cela est transcrit dans la configuration.
Un grand nombre d’utilisateurs simultanés veut dire une valeur importante pour le paramètre max_connections (maintenant à 300, là encore s’il n’y a pas de pooler). De ce fait, le paramètre work_mem ne peut plus avoir une valeur importante: sa valeur est donc baissée tout en restant fortement au-dessus de la valeur par défaut. Comme il y aura plus d’écritures, la taille du cache des journaux de transactions ( wal_buffers ) est augmentée. Il faudra essayer de tout faire passer par les checkpoints, d’où les valeurs encore augmentées pour min_wal_size et max_wal_size. Quant à shared_buffers et effective_cache_size, ils restent aux valeurs définies ci-dessus (respectivement un quart et deux tiers de la mémoire).
Exemple pour un entrepôt de données:
Et enfin avec un profil entrepôt de données (datawarehouse) sur une machine moins modeste avec 32 Go de RAM, 8 cœurs, et un disque SSD:
Pour un entrepôt de données, il y a généralement peu d’utilisateurs à un instant t, mais ils exécutent des requêtes complexes sur une grosse volumétrie. La configuration change donc en profondeur.
Le paramètre max_connections est diminué très fortement. Cela permet d’allouer beaucoup de mémoire aux tris et hachages (paramètre work_mem à 26 Mo). shared_buffers et effective_cache_size suivent les règles habituelles.
Les entrepôts de données ont souvent des scripts d’import de données (batchs): cela nécessite de pouvoir écrire rapidement de grosses quantités de données, autrement dit une augmentation conséquente du paramètre wal_buffers et des min_wal_size / max_wal_size. Du fait de la grosse volumétrie des bases dans ce contexte, une valeur importante pour le maintenance_work_mem est essentielle pour que les créations d’index et les VACUUM se fassent rapidement. De même, la valeur du default_statistics_target est sérieusement augmentée car le nombre de lignes des tables est conséquent et nécessite un échantillon plus important pour avoir des statistiques précises sur les données des tables. random_page_cost, auparavant à sa valeur par défaut, descend à 1,1 pour tenir compte des performances d’un SSD. effective_io_concurrency est aussi adapté au SSD. Enfin, la configuration de la machine autorise une parallélisation importante, généralement bienvenue pour du décisionnel.
Évidemment, tout ceci n’est qu’une recommandation générale, et ne doit servir que de point de départ. Chaque paramètre peut être affiné. L’expérimentation permettra de se diriger vers une configuration plus personnalisée.
1.5.2 pgbench
- Outil pour réaliser rapidement des tests de performance
- Fourni dans les modules de contrib de PostgreSQL
- Travaille sur une base de test créée par l’outil
- ou sur une vraie base de données
pgbench est un outil disponible avec les modules contrib de PostgreSQL depuis de nombreuses années. Son but est de faciliter la mise en place de benchmarks simples et rapides. Des solutions plus complètes sont disponibles, mais elles sont aussi bien plus complexes. pgbench travaille soit à partir d’un schéma de base qu’il crée et alimente lui-même, soit à partir d’une base déjà existante. Dans ce dernier cas, les requêtes SQL à exécuter sont à fournir à pgbench. Il existe donc principalement deux modes d’utilisation de pgbench: le mode initialisation quand on veut utiliser le schéma et le scénario par défaut, et le mode benchmarks.
1.5.3 Types de tests avec pgbench
- On peut faire varier différents paramètres, tel que :
- le nombre de clients
- le nombre de transactions par client
- faire un test de performance en SELECT only , UPDATE only ou TPC-B
- faire un test de performance dans son contexte applicatif
- exécuter le plus de requêtes possible sur une période de temps donné
- etc.
1.5.4 Environnement de test avec pgbench
- pgbench est capable de créer son propre environnement de test
- Environnement adapté pour des tests de type TPC-B
- Permet de rapidement tester une configuration PostgreSQL
- en termes de performance
- en termes de charge
- Ou pour expérimenter/tester
La documentation complète est sur https://docs.postgresql.fr/current/pgbench.html. L’auteur
principal, Fabien Coelho, a fait une présentation complète, en français, à la PG Session #9 de 2017 48. L’option -i demande à pgbench de créer un schéma et de le peupler de données dans la base indiquée (à créer au préalable). La base ainsi créée est composée de 4 tables: pgbench_history, pgbench_tellers, pgbench_accounts et pgbench_branches. Dans ce mode, l’option -s permet alors d’indiquer un facteur d’échelle permettant de maîtriser la volumétrie de la base de donnée. Ce facteur est un multiple de 100 000 lignes dans la table pgbench_accounts. Pour que le test soit significatif, il est important que la taille de la base dépasse fortement la quantité de mémoire disponible. Une fois créée, il est possible de réaliser différents tests avec cette base de données en faisant varier plusieurs paramètres tels que le nombre de transactions, le nombre de clients, le type de requêtes (simple, étendue, préparée) ou la durée du test de charge. Exemples:
- création de la base et peuplement par pgbench :
creating tables… 100000 of 200000 tuples (50%) done (elapsed 0.08 s, remaining 0.08 s) 200000 of 200000 tuples (100%) done (elapsed 0.26 s, remaining 0.00 s) vacuum… set primary keys… done.
- benchmarks sur cette base :
starting vacuum…end. transaction type: <builtin: TPC-B (sort of)> scaling factor: 2 query mode: simple number of clients: 1 number of threads: 1 number of transactions per client: 10 number of transactions actually processed: 10/10 latency average = 2.732 ms
- nouveau test avec 10 clients et 200 transactions pour chacun :
starting vacuum…end. transaction type: <builtin: TPC-B (sort of)> scaling factor: 2 query mode: simple number of clients: 10 48 https://youtu.be/aTwh_CgRaE0
number of threads: 1 number of transactions per client: 200 number of transactions actually processed: 2000/2000 latency average = 19.716 ms
- changement de la configuration avec fsync=off , et nouveau test avec les mêmes options que précédemment :
starting vacuum…end. transaction type: <builtin: TPC-B (sort of)> scaling factor: 2 query mode: simple number of clients: 10 number of threads: 1 number of transactions per client: 200 number of transactions actually processed: 2000/2000 latency average = 2.361 ms
- toujours avec les mêmes options, mais en effectuant le test durant 10 secondes :
starting vacuum…end. transaction type: <builtin: TPC-B (sort of)> scaling factor: 2 query mode: simple number of clients: 10 number of threads: 1 duration: 10 s number of transactions actually processed: 45349 latency average = 2.207 ms
pgbench est capable de travailler avec une base de données existante. Cette fonctionnalité permet ainsi de tester les performances dans un contexte plus représentatif de la ou les bases présentes dans une instance. Il faut alors créer un ou plusieurs scripts SQL contenant les requêtes à exécuter sur la base de donnée, à appeler avec -f, éventuellement avec des poids différents. Un script peut contenir plusieurs requêtes. Toutes les requêtes du fichier seront exécutées dans leur ordre d’apparition. Si plusieurs scripts SQL sont indiqués, chaque transaction sélectionne le fichier à exécuter de façon aléatoire. Enfin, il est possible d’utiliser des variables dans vos scripts SQL afin de faire varier le groupe de données manipulé dans vos tests. Ce dernier point est essentiel afin d’éviter les effets de cache ou encore pour simuler la charge lorsqu’un sous-ensemble des données de la base est utilisé en comparaison avec la totalité de la base (en utilisant un champ de date par exemple). Par exemple, le script exécuté par défaut par pgbench pour son test TPC-B en mode requête « simple », sur sa propre base, est le suivant (extrait de la page de manuel de pgbench): \set aid random(1, 100000 *:scale) \set bid random(1, 1 *:scale)
\set tid random(1, 10 *:scale) \set delta random(-5000, 5000)
Si la base de donnée utilisée est celle fournie avec pgbench, la variable:scale sera valorisée à partir du nombre de lignes présentes dans la relation pgbench_branches. Si vous utilisez une autre base de donnée, il faut indiquer l’échelle avec l’option -s lorsque l’on exécute le test.
1.6 CONCLUSION
- PostgreSQL propose de nombreuses voies d’optimisation.
- Cela passe en priorité par un bon choix des composants matériels et par une configuration pointilleuse.
- Mais ceci ne peut se faire qu’en connaissance de l’ensemble du système, et notamment des applications utilisant les bases de l’instance.
1.6.1 Questions
N’hésitez pas, c’est le moment!
1.7 QUIZ
1.8 INSTALLATION DE POSTGRESQL DEPUIS LES PAQUETS
COMMUNAUTAIRES
L’installation est détaillée ici pour Rocky Linux 8 et 9 (similaire à Red Hat et à d’autres variantes comme Oracle Linux et Fedora), et Debian/Ubuntu. Elle ne dure que quelques minutes.
1.8.1 Sur Rocky Linux 8, 9 ou 10
ATTENTION: Red Hat, CentOS, Rocky Linux fournissent souvent par défaut des versions de PostgreSQL qui ne sont plus supportées. Ne jamais installer les packages postgresql, postgresql-client et postgresql-server! L’utilisation des dépôts du PGDG est fortement conseillée.
Installation du dépôt communautaire: Les dépôts de la communauté sont sur https://yum.postgresql.org/. Les commandes qui suivent sont inspirées de celles générées par l’assistant sur https://www.postgresql.org/download/linux/redhat/. Il n’y a guère que les informations de version qui diffèrent en fonction de:
- la version majeure de PostgreSQL (ici la 18) ;
- la distribution (ici Rocky Linux 9) ;
- l’architecture (ici x86_64, la plus courante).
Les commandes sont à lancer sous root:
Installation de PostgreSQL 18 (client, serveur, librairies, extensions):
Les outils clients et les librairies nécessaires seront automatiquement installés. Une fonctionnalité avancée optionnelle, le JIT (Just In Time compilation), nécessite un paquet séparé.
Création d’une première instance: C’est optionnel, mais il est conseillé de déclarer PGSETUP_INITDB_OPTIONS, notamment pour forcer les traces en anglais. Depuis la version 18, les sommes de contrôle sont automatiquement activées.
Ce dernier fichier permet de vérifier que tout s’est bien passé et doit finir par: Success. You can now start the database server using:
/usr/pgsql-18/bin/pg_ctl -D /var/lib/pgsql/18/data/ -l logfile start
Chemins:
Objet Chemin
Binaires /usr/pgsql-18/bin Répertoire de l’utilisateur postgres /var/lib/pgsql PGDATA par défaut /var/lib/pgsql/18/data Fichiers de configuration dans PGDATA/ Traces dans PGDATA/log
Configuration: Modifier postgresql.conf est facultatif pour un premier lancement. Commandes d’administration habituelles: Démarrage, arrêt, statut, rechargement à chaud de la configuration, redémarrage:
Test rapide de bon fonctionnement et connexion à psql:
Démarrage de l’instance au lancement du système d’exploitation:
Ouverture du firewall pour le port 5432: Voir si le firewall est actif:
Si c’est le cas, autoriser un accès extérieur:
(Rappelons que listen_addresses doit être également modifié dans postgresql.conf.) Création d’autres instances: Si des instances de versions majeures différentes doivent être installées, il faut d’abord installer les binaires pour chacune (adapter le numéro dans dnf install … ) et appeler le script d’installation de chaque version. l’instance par défaut de chaque version vivra dans un sous-répertoire numéroté de /var/lib/pgsql automatiquement créé à l’installation. Il faudra juste modifier les ports dans les postgresql.conf pour que les instances puissent tourner simultanément.
Si plusieurs instances d’une même version majeure (forcément de la même version mineure) doivent cohabiter sur le même serveur, il faut les installer dans des PGDATA différents.
- Ne pas utiliser de tiret dans le nom d’une instance (problèmes potentiels avec systemd).
- Respecter les normes et conventions de l’OS : placer les instances dans un nouveau sousrépertoire de /var/lib/pgsqsl/18/ (ou l’équivalent pour d’autres versions majeures).
Pour créer une seconde instance, nommée par exemple infocentre:
- Création du fichier service de la deuxième instance :
/etc/systemd/system/postgresql-18-infocentre.service
- Modification de ce dernier fichier avec le nouveau chemin :
Environment=PGDATA=/var/lib/pgsql/18/infocentre
- Option 1 : création d’une nouvelle instance vierge :
- Option 2 : restauration d’une sauvegarde : la procédure dépend de votre outil.
- Adaptation de /var/lib/pgsql/18/infocentre/postgresql.conf (port surtout).
- Commandes de maintenance de cette instance :
- Ouvrir le nouveau port dans le firewall au besoin.
1.8.2 Sur Debian / Ubuntu
L’installation ne varie quasiment pas selon les versions de Debian et Ubuntu. Ce qui suit a été testé sur Debian 10 à 13 et Ubuntu LTS 22.04 et 24.04. Sauf précision, tout est à effectuer en tant qu’utilisateur root. Référence: https://apt.postgresql.org/ Installation du dépôt communautaire: L’installation des dépôts du PGDG est prévue dans le paquet Debian postgresql-common:
Ce dernier ordre créera le fichier du dépôt /etc/apt/sources.list.d/pgdg.list adapté à la distribution en place. Installation de PostgreSQL 18: La méthode la plus propre consiste à modifier la configuration par défaut avant l’installation: Dans /etc/postgresql-common/createcluster.conf, paramétrer au moins les traces en anglais. Depuis la version 18, les sommes de contrôle sont automatiquement activées.
Puis installer les paquets serveur et clients et leurs dépendances:
La première instance est automatiquement créée, avec un nom ( main par défaut‘), déclarée comme service à lancer au démarrage du système, puis démarrée.
L’utilisateur système postgres peut y accéder immédiatement. Chemins:
Objet Chemin
Binaires /usr/lib/postgresql/18/bin/
Objet Chemin
Répertoire de l’utilisateur postgres /var/lib/postgresql PGDATA de l’instance par défaut /var/lib/postgresql/18/main Fichiers de configuration dans /etc/postgresql/18/main/ Traces dans /var/log/postgresql/
Configuration Modifier postgresql.conf est facultatif pour un premier essai. Démarrage/arrêt de l’instance, rechargement de configuration: Debian fournit ses propres outils, qui demandent en paramètre la version et le nom de l’instance:
Démarrage de l’instance avec le serveur: C’est en place par défaut, et modifiable dans /etc/postgresql/18/main/start.conf. Ouverture du firewall: Debian et Ubuntu n’installent pas de firewall par défaut. Statut des instances du serveur:
Test rapide de bon fonctionnement et connexion à psql:
Destruction d’une instance:
Création d’autres instances: Ce qui suit est valable pour remplacer l’instance par défaut par une autre, par exemple pour activer les sommes de contrôles (checksums) avant la version v18:
- optionnellement, /etc/postgresql-common/createcluster.conf permet de mettre en place tout d’entrée les messages en anglais, le format des traces, l’emplacement séparé pour
les journaux ou les checksums pour une version inférieure à 18:
- créer une instance :
Il est également possible de préciser certains paramètres du fichier postgresql.conf, voire les chemins des fichiers (il est conseillé de conserver les chemins par défaut):
–port=12345 \ –datadir=/PGDATA/18/infocentre \ –pgoption shared_buffers=‘8GB’ –pgoption work_mem=‘50MB’ \ – –data-checksums –waldir=/ssd/postgresql/18/infocentre/journaux
- adapter au besoin /etc/postgresql/18/infocentre/postgresql.conf ;
- démarrage :
1.8.3 Accès à l’instance depuis le serveur même (toutes distributions)
Par défaut, l’instance n’est accessible que par l’utilisateur système postgres, qui n’a pas de mot de passe. Un détour par sudo est nécessaire:
Type “help” for help.
Ce qui suit permet la connexion directement depuis un utilisateur du système: Pour des tests (pas en production!), il suffit de passer à trust le type de la connexion en local dans le pg_hba.conf:
local all postgres trust
La connexion en tant qu’utilisateur postgres (ou tout autre) n’est alors plus sécurisée:
dalibo:~$ psql -U postgres
Type “help” for help.
Une authentification par mot de passe est plus sécurisée:
- dans pg_hba.conf , paramétrer une authentification par mot de passe pour les accès depuis localhost (déjà en place sous Debian) :
host all all 127.0.0.1/32 scram-sha-256
host all all::1/128 scram-sha-256
(Ne pas oublier de recharger la configuration en cas de modification.)
- ajouter un mot de passe à l’utilisateur postgres de l’instance :
dalibo:~$ sudo -iu postgres psql
Type “help” for help.
Enter new password for user “postgres”: Enter it again:
dalibo:~$ psql -h localhost -U postgres Password for user postgres:
Type “help” for help.
- Pour se connecter sans taper le mot de passe à une instance, un fichier .pgpass dans le répertoire personnel doit contenir les informations sur cette connexion :
localhost:5432:*:postgres:motdepassetrèslong
Ce fichier doit être protégé des autres utilisateurs:
- Pour n’avoir à taper que psql , on peut définir ces variables d’environnement dans la session voire dans ~/.bashrc :
export PGUSER=postgres export PGDATABASE=postgres export PGHOST=localhost
Rappels:
- en cas de problème, consulter les traces (dans /var/lib/pgsql/18/data/log ou /var/log/postgresql/ );
- toute modification de pg_hba.conf ou postgresql.conf impliquant de recharger la configuration peut être réalisée par une de ces trois méthodes en fonction du système :
root:~# systemctl reload postgresql-18
root:~# pg_ctlcluster 18 main reload
postgres:~$ psql -c ‘SELECT pg_reload_conf()’
1.9 INTRODUCTION À PGBENCH
pgbench est un outil de test livré avec PostgreSQL. Son but est de faciliter la mise en place de benchmarks simples et rapides. Par défaut, il installe une base très simple, génère une activité plus ou moins intense et calcule le nombre de transactions par seconde et la latence. C’est ce qui sera fait ici dans cette introduction. On peut aussi lui fournir ses propres scripts.
La documentation complète est sur https://docs.postgresql.fr/current/pgbench.html. L’auteur principal, Fabien Coelho, a fait une présentation complète, en français, à la PG Session #9 de 2017 49.
1.9.1 Installation
L’outil est installé avec les paquets habituels de PostgreSQL, client ou serveur suivant la distribution. Sur les distributions à paquets RPM (RockyLinux…), l’outil n’est pas dans le chemin par défaut, il faudra fournir le chemin complet (qui ne sera pas répété ici):
/usr/pgsql-17/bin/pgbench
Il est préférable de créer un rôle non privilégié dédié, qui possédera la base de donnée:
49 https://youtu.be/aTwh_CgRaE0
Le pg_hba.conf doit éventuellement être adapté. La base par défaut s’initialise ainsi (ajouter –port et –host au besoin):
pgbench -U -d pgbench –initialize –scale=100 pgbench
–scale permet de faire varier proportionnellement la taille de la base. À 100, la base pèsera 1,5 Go, avec 10 millions de lignes dans la table principale pgbench_accounts:
pgbench@pgbench=# \d+ Liste des relations
| Schéma | Nom | Type | Propriétaire | Taille | Description |
|---|---|---|---|---|---|
| public | pg_buffercache | vue | postgres | 0 bytes | |
| public | pgbench_accounts | table | pgbench | 1281 MB | |
| public | pgbench_branches | table | pgbench | 40 kB | |
| public | pgbench_history | table | pgbench | 0 bytes | |
| public | pgbench_tellers | table | pgbench | 80 kB |
1.9.2 Générer de l’activité
Pour simuler une activité de 20 clients simultanés, répartis sur 4 processeurs, pendant 100 secondes: pgbench -U pgbench -c 20 -j 4 -T100 pgbench
Pour afficher, ajouter –debug:
À la fin, s’affichent notamment le nombre de transactions (avec et sans le temps de connexion) et la durée moyenne d’exécution du point de vue du client ( latency ):
scaling factor: 100 query mode: simple number of clients: 20 number of threads: 4 duration: 10 s number of transactions actually processed: 20433 latency average = 9.826 ms
Modifier le paramétrage est facile grâce à la variable d’environnement PGOPTIONS:
PGOPTIONS=’-c synchronous_commit=off -c commit_siblings=20’ \ pgbench -U pgbench -c 20 -j 4 -T100 pgbench 2>/dev/null
latency average = 6.992 ms
Des tests rigoureux doivent durer bien sûr beaucoup plus longtemps que 100 s, par exemple pour tenir compte des effets de cache, des checkpoints périodiques, etc.
1.10 TRAVAUX PRATIQUES
La version en ligne des solutions de ces TP est disponible sur https://dali.bo/j1_solutions.
1.10.1 Utilisation de pgbench
But: Manipuler pgbench
Créer une base pgbench sur laquelle seront effectués les premiers tests, et l’initialiser avec 13,5 millions de lignes dans la table pgbench_accounts:
/usr/pgsql-17/bin/pgbench -i -s 135 pgbench
Simuler l’utilisation de la base pgbench par 3 clients simultanés, chacun effectuant par exemple 1000 transactions:
/usr/pgsql-17/bin/pgbench -c 3 -t 1000 -n -P1 pgbench
Simuler la même chose, en ajoutant le paramètre -C pour forcer une connexion à chaque transaction. Comparer la latence et le nombre de transactions par seconde.
On veut simuler l’utilisation de la base pgbench par 3 utilisateurs effectuant 10 fois la sélection des comptes dont le solde est positif dans la table pgbench_accounts.
Créer un fichier query.sql contenant la requête suivante:
SELECT aid,bid,abalance
Lancer la commande:
/usr/pgsql-17/bin/pgbench -c 3 -t 10 -n -P1 -f query.sql pgbench
1.10.2 Influence de fsync et synchronous_commit
But: Mesurer l’impact de fsync
Positionner le paramètre fsync à off dans le fichier postgresql.conf et redémarrer PostgreSQL.
Simuler l’utilisation de la base pgbench par 3 clients simultanés, chacun effectuant par exemple 1000 transactions:
/usr/pgsql-17/bin/pgbench -c 3 -t 1000 -n -P1 pgbench
Comparer avec le premier test précédent.
Rétablir fsync à on, puis relancer PostgreSQL.
Refaire le même test avec synchronous_commit à off dans la session:
PGOPTIONS=’-c synchronous_commit=off’ \ /usr/pgsql-17/bin/pgbench -c 3 -t 1000 pgbench
1.10.3 Paramétrage de l’overcommit
Ce TP étant complexe, allez directement suivre la partie Solution.
1.11 TRAVAUX PRATIQUES (SOLUTIONS)
1.11.1 Utilisation de pgbench
Créer une base pgbench sur laquelle seront effectués les premiers tests, et l’initialiser avec 13,5 millions de lignes dans la table pgbench_accounts:
/usr/pgsql-17/bin/pgbench -i -s 135 pgbench
Noter que le nom de la base (ici en dernier paramètre) ne doit pas être précédé de -d. La base obtenue fait 2 Go. Simuler l’utilisation de la base pgbench par 3 clients simultanés, chacun effectuant par exemple 1000 transactions:
/usr/pgsql-17/bin/pgbench -c 3 -t 1000 -n -P1 pgbench
… progress: 1.0 s, 1081.9 tps, lat 2.743 ms stddev 3.450, 0 failed progress: 2.0 s, 1127.0 tps, lat 2.653 ms stddev 1.112, 0 failed … number of transactions per client: 1000 number of transactions actually processed: 3000/3000 number of failed transactions: 0 (0.000%) latency average = 2.691 ms latency stddev = 2.933 ms initial connection time = 8.860 ms
(Les chiffres peuvent bien sûr varier fortement selon la machine et la configuration.)
De vrais tests devraient être beaucoup plus longs! Á Simuler la même chose, en ajoutant le paramètre -C pour forcer une connexion à chaque transaction. Comparer la latence et le nombre de transactions par seconde.
L’exécution est ici beaucoup plus longue: /usr/pgsql-17/bin/pgbench -c 3 -t 1000 -n -P1 -C pgbench
… progress: 7.0 s, 360.8 tps, lat 6.083 ms stddev 1.569, 0 failed progress: 8.0 s, 342.4 tps, lat 6.392 ms stddev 1.943, 0 failed …
number of transactions actually processed: 3000/3000 number of failed transactions: 0 (0.000%) latency average = 6.021 ms latency stddev = 1.876 ms average connection time = 1.855 ms
La connexion systématique a diminué les performances des deux tiers. Ce serait encore pire s’il y avait un réseau entre PostgreSQL et client pgbench.
On veut simuler l’utilisation de la base pgbench par 3 utilisateurs effectuant 10 fois la sélection des comptes dont le solde est positif dans la table pgbench_accounts.
Créer un fichier query.sql contenant la requête suivante:
SELECT aid,bid,abalance
Lancer la commande:
/usr/pgsql-17/bin/pgbench -c 3 -t 10 -n -P1 -f query.sql pgbench
… latency average = 1578.937 ms latency stddev = 13.462 ms initial connection time = 5.789 ms
On voit ainsi que pgbench permet de créer ses propres requêtes de test.
1.11.2 Influence de fsync et synchronous_commit
pgbench peut servir à mesurer l’impact d’un paramètre de configuration sur les performances du système.
Positionner le paramètre fsync à off dans le fichier postgresql.conf et redémarrer PostgreSQL.
(Ne jamais faire cela en production, bien sûr.) Relancer: systemctl restart postgresql-17
Simuler l’utilisation de la base pgbench par 3 clients simultanés, chacun effectuant par exemple 1000 transactions:
/usr/pgsql-17/bin/pgbench -c 3 -t 1000 -n -P1 pgbench
Comparer avec le premier test précédent.
… latency average = 0.424 ms latency stddev = 0.173 ms initial connection time = 6.861 ms
On est sur des valeurs beaucoup plus élevés que le premier test. La synchronisation à chaque COMMIT est très coûteuse et on l’a désactivée. Mais fsync à off provoquerait une corruption en cas d’arrêt brutal et ne peut être conservé.
Rétablir fsync à on, puis relancer PostgreSQL.
Refaire le même test avec synchronous_commit à off dans la session:
PGOPTIONS=’-c synchronous_commit=off’ \ /usr/pgsql-17/bin/pgbench -c 3 -t 1000 pgbench
La variable d’environnement est un moyen de changer la configuration depuis le shell quand on ne peut changer la configuration de la session avec SET.
… latency average = 0.473 ms initial connection time = 13.312 ms
Le paramètre synchronous_commit à off « regroupe » les synchronisations, et permet de récupérer une bonne partie des performances perdues avec fsync à on, si l’application le permet: en cas d’arrêt brutal, il reste le risque de perdre jusqu’à 600 ms de données pourtant committées (mais sans risque de corruption). Cette perte de données est parfois acceptable, parfois non. Ce choix peut être opéré transaction par transaction en changeant synchronous_commit dans la session. Noter à nouveau qu’un test rigoureux devrait durer beaucoup plus longtemps, sur plus de transactions, et tenir compte des effets de cache.
1.11.3 Paramétrage de l’overcommit
Ce TP a été testé sur une machine avec 3,5 Go de RAM et pas de swap à l’origine. Adaptez à votre machine. Avec free -m, vérifiez que vous avez du swap. Si ce n’est pas le cas, créez un fichier de swap de 1 Go.
Si free -m renvoie ceci, vous n’avez pas de swap:
total used free shared buff/cache available
Comme il est conseillé d’avoir un swap minimal, le créer ainsi:
Au final nous obtenons ceci: free -m
Dans une autre session, générer de l’activité avec pgbench. (Si elle n’est pas déjà là, créer une base pgbench de taille 135 ou supérieure.) Laisser tourner indéfiniment dans cette session.
Pour créer la base pgbench au besoin:
/usr/pgsql-17/bin/pgbench pgbench -i -s 135
Pour générer de l’activité (ici 3 clients):
/usr/pgsql-17/bin/pgbench pgbench -c3 -T900 -P1 -n
pgbench (17.1) progress: 1.0 s, 322.0 tps, lat 9.070 ms stddev 5.105, 0 failed progress: 2.0 s, 315.0 tps, lat 9.511 ms stddev 3.501, 0 failed progress: 3.0 s, 311.0 tps, lat 9.582 ms stddev 10.133, 0 failed progress: 4.0 s, 349.0 tps, lat 8.647 ms stddev 3.215, 0 failed progress: 5.0 s, 325.0 tps, lat 9.199 ms stddev 4.445, 0 failed
Dans une nouvelle session, surveiller en permanence la mémoire:
while true; do sleep 1; free -m; done
total used free shared buff/cache available
En simplifiant:
- total indique les 3,5 Go de RAM;
- used correspond au système et à ce qu’utilise PostgreSQL
- dont 128 Mo de shared_buffers (valeur par défaut ici) ;
- available est la mémoire disponible, donc le cache.
Noter que la base de données (2 Go) tient dans le cache de Linux mais pas dans les shared buffers. Consulter la configuration en place de l’overcommit.
…
…
Ces valeurs sont celles par défaut sur les distributions courantes.
Dans une session psql, générer un tri en RAM bien plus gros que la mémoire disponible. Surveiller l’évolution sur la RAM et le débit des transactions de la session pgbench (attendre une minute ou deux suivant la machine).
– DANGEREUX! Tri de 250 Go en RAM!
ORDER BY i DESC;
Quels sont les symptômes dans les différentes sessions et les traces de PostgreSQL et du système?
Les symptômes sont nombreux et n’apparaissent pas systématiquement:
- l’ordre SQL précédent tombe généralement en erreur et la session est perdue :
la connexion au serveur a été coupée de façon inattendue Le serveur s’est peut-être arrêté anormalement avant ou durant le traitement de la requête. La connexion au serveur a été perdue. Tentative de réinitialisation: Échec. La connexion au serveur a été perdue. Tentative de réinitialisation: Échec.!?>
- la session pgbench ralentit fortement, et tombe généralement en erreur aussi :
… progress: 34.1 s, 1.7 tps, lat 627.322 ms stddev 0.038, 0 failed progress: 35.1 s, 0.0 tps, lat 0.000 ms stddev 0.000, 0 failed progress: 36.8 s, 0.0 tps, lat 0.000 ms stddev 0.000, 0 failed progress: 38.5 s, 0.0 tps, lat 0.000 ms stddev 0.000, 0 failed progress: 39.0 s, 5.7 tps, lat 5782.505 ms stddev 151.744, 0 failed progress: 41.5 s, 0.0 tps, lat 0.000 ms stddev 0.000, 0 failed progress: 42.0 s, 0.0 tps, lat 0.000 ms stddev 0.000, 0 failed …
DETAIL: The postmaster has commanded this server process to roll back the current transaction and exit, because another server process exited abnormally and possibly corrupted shared memory. HINT: In a moment you should be able to reconnect to the database and repeat your command. pgbench: error: client 0 aborted in command 5 (SQL) of script 0; perhaps the backend died while processing … pgbench: error: client 2 aborted in command 10 (SQL) of script 0; perhaps the backend died while processing pgbench: error: client 1 aborted in command 10 (SQL) of script 0; perhaps the backend died while processing transaction type: <builtin: TPC-B (sort of)> scaling factor: 135 query mode: simple number of clients: 3 number of threads: 1 maximum number of tries: 1 duration: 900 s number of transactions actually processed: 5432 number of failed transactions: 0 (0.000%) latency average = 58.651 ms latency stddev = 1579.195 ms initial connection time = 17.279 ms
pgbench: error: Run was aborted; the above results are incomplete.
Noter la mention « The postmaster has commanded this server process to roll back the current transaction and exit, because another server process exited abnormally and possibly corrupted shared memory ».
- free indique que la mémoire utilisable ( available ) s’est réduite, ainsi que cache , ce qui est normal car used indique que presque toute la RAM est utilisée.
total used free shared buff/cache available
Noter que le swap s’est rempli avec nos données triées, alors que nous avions demandé un tri en mémoire.
Cette opération d’écriture dans le swap indique que la mémoire est déjà saturée, et le cache déjà réduit. L’écriture va également alourdir les entrées-sorties. Un cache surdimensionné allonge encore la durée du ralentissement. Avec des disques mécaniques, c’est encore plus long.
- Dans postgresql.log :
FATAL: connection to client lost
DETAIL: Failed process was running: EXPLAIN (ANALYZE) SELECT i
FATAL: the database system is in recovery mode
…
On y lit:
- l’arrêt brutal (rien de moins que kill -9 ) du processus 21071 consommateur de RAM;
- puis un redémarrage spontané de PostgreSQL.
- Du côté du noyau :
… Adding 1048572k swap on /swapfile. Priority:-2 extents:95 across:3491508k FS postgres invoked oom-killer: gfp_mask=0x6200ca(GFP_HIGHUSER_MOVABLE), order=0,
… Mem-Info: active_anon:60815 inactive_anon:818069 isolated_anon:0 active_file:0 inactive_file:56 isolated_file:0 unevictable:0 dirty:0 writeback:0 slab_reclaimable:7732 slab_unreclaimable:10962 mapped:35416 shmem:35635 pagetables:5149 bounce:0 free:20749 free_pcp:884 free_cma:0 … … 106213 total pagecache pages 69943 pages in swap cache Swap cache stats: add 517156, delete 447213, find 7357/9783 Free swap = 0kB Total swap = 1048572kB
1047069 pages RAM 0 pages HighMem/MovableOnly 113258 pages reserved 0 pages hwpoisoned Tasks state (memory values in pages): uid tgid total_vm rss pgtables_bytes swapents oom_score_adj name
oom-kill:constraint=CONSTRAINT_NONE,nodemask=(null),cpuset=/,mems_allowed=0, global_oom,task_memcg=/system.slice/postgresql-17.service,task=postgres,
Out of memory: Killed process 21071 (postgres) total-vm:4927268kB, anon-rss:3057476kB, file-rss:4kB, shmem-rss:3700kB, UID:26 pgtables:8216kB oom_score_adj:0
On trouvera ci-dessus:
- le déclenchement de l’OOM killer ;
- la mention de la saturation du swap;
- la liste des processus : noter le 21071 (notre requête explosive) et le 17768 (le processus principal, d’ailleurs encore présent après le crash);
- à la fin le choix de Linux de tuer le processes 21071.
La cause première est l’épuisement complet de la mémoire, Linux n’ayant jamais refusé de réservation mémoire. Une fois RAM et swap épuisés, il a bien fallu éliminer un processus. Sur une machine dédiée à PostgreSQL, c’est forcément un de ses processus. Ici, le processus principal est protégé (noter ci-dessus le score de -1000, qui provient de la définition du service). Comme le processus principal était encore là, il a constaté la disparition brutale de son processus fils, et a tout redémarré par peur d’une corruption de la mémoire partagée. L’arrêt des connexions (session psql et pgbench ) est la conséquence.
Changer le paramétrage mémoire pour éviter le plantage.
La nouvelle configuration mémoire est à mettre en place ainsi:
Dans ce fichier:
Sur des machines mieux dotées en RAM et avec peu de swap, vm.overcommit_ratio vaut généralement 80.
… * Applying /etc/sysctl.conf…
Consultation de la nouvelle configuration mémoire:
MemTotal: 3735244 kB MemFree: 2598780 kB MemAvailable: 3204396 kB
Cached: 967368 kB SwapCached: 7396 kB Active: 158296 kB Inactive: 843860 kB Active(anon): 24392 kB Inactive(anon): 190468 kB Active(file): 133904 kB Inactive(file): 653392 kB Unevictable: 0 kB Mlocked: 0 kB SwapTotal: 1048572 kB SwapFree: 996324 kB Dirty: 4 kB Writeback: 0 kB AnonPages: 29708 kB Mapped: 188868 kB Shmem: 180072 kB KReclaimable: 32156 kB Slab: 74836 kB SReclaimable: 32156 kB SUnreclaim: 42680 kB KernelStack: 2576 kB PageTables: 9228 kB NFS_Unstable: 0 kB Bounce: 0 kB WritebackTmp: 0 kB
Committed_AS: 674624 kB VmallocTotal: 34359738367 kB VmallocUsed: 17640 kB VmallocChunk: 0 kB Percpu: 1888 kB HardwareCorrupted: 0 kB AnonHugePages: 2048 kB ShmemHugePages: 0 kB ShmemPmdMapped: 0 kB FileHugePages: 0 kB FilePmdMapped: 0 kB HugePages_Total: 0 HugePages_Free: 0 HugePages_Rsvd: 0
HugePages_Surp: 0 Hugepagesize: 2048 kB Hugetlb: 0 kB DirectMap4k: 156152 kB DirectMap2M: 4032512 kB DirectMap1G: 2097152 kB
On y voit notamment:
SwapCached: 7396 kB SwapTotal: 1048572 kB SwapFree: 996324 kB
Committed_AS: 679524 kB
(des écarts de quelques kilooctets sont normaux). Base inactive, il est normal que la RAM allouée ( CommittedAS ) soit basse.
Relancer la requête consommatrice de RAM en suivant à nouveau la consommation mémoire et les traces. Ne pas hésiter à tester plusieurs fois.
Le traçage de la mémoire peut se faire de plusieurs manières: while true; do sleep 1; free -m; done
total used free shared buff/cache available
while true; do sleep 1; watch -n 0.5 “grep -E ‘^(Swap|Commit)’ /proc/meminfo”;done
ou sar -rh 1
Le swap est à peu près vide, la moitié de la mémoire complètement libre. On relance l’activité pgbench:
/usr/pgsql-17/bin/pgbench pgbench -c3 -T900 -P1 -n
Sous psql:
ORDER BY i DESC;
Ce dernier ordre tombe avec cette seule erreur:
DÉTAIL: Failed on request of size 23 in memory context “ExecutorState”.
Par contre la session reste utilisable. pgbench continue de tourner normalement:
progress: 215.0 s, 242.0 tps, lat 18.192 ms stddev 64.768, 0 failed progress: 216.0 s, 223.9 tps, lat 13.435 ms stddev 8.988, 0 failed progress: 217.0 s, 252.1 tps, lat 11.852 ms stddev 4.051, 0 failed progress: 218.0 s, 251.0 tps, lat 11.960 ms stddev 4.252, 0 failed
Il est difficile de capturer des valeurs juste avant l’erreur avec un pas d’une seconde, mais par exemple /proc/meminfo contient ceci:
SwapCached: 6072 kB SwapTotal: 1048572 kB SwapFree: 981316 kB
Committed_AS: 3144000 kB
Committed_AS (mémoire consommée et swap) est alors très proche de CommitLimit.
Ou encore, free -m a retourné ceci:
total used free shared buff/cache available
ou encore avec sar -rh 1 (sortie modifiée pour l’affichage):
| kbmemfree | kbavail kbmemused | %memused kbbuffers | kbcached | kbcommit | %commit… | ||
|---|---|---|---|---|---|---|---|
| 1,0G | 3,0G | 2,6G | 71,8% | 0,0k | 2,4G | 707,2M | 15,1%… |
| 1,0G | 3,0G | 2,6G | 71,9% | 0,0k | 2,4G | 707,2M | 15,1%… |
…
| 595,7M | 2,9G | 3,0G | 83,7% | 0,0k | 2,7G | 852,0M | 18,2%… |
|---|---|---|---|---|---|---|---|
| 449,5M | 2,8G | 3,1G | 87,7% | 0,0k | 2,7G | 1004,0M | 21,5%… |
…
| kbmemfree | kbavail kbmemused | %memused kbbuffers | kbcached | kbcommit | %commit… | ||
|---|---|---|---|---|---|---|---|
| 101,9M | 1,8G | 3,5G | 97,2% | 0,0k | 2,0G | 2,0G | 43,1%… |
| 99,8M | 1,7G | 3,5G | 97,3% | 0,0k | 1,9G | 2,1G | 45,1%… |
| 105,4M | 1,6G | 3,5G | 97,1% | 0,0k | 1,8G | 2,2G | 47,3%… |
| 96,8M | 1,4G | 3,5G | 97,3% | 0,0k | 1,7G | 2,5G | 55,1%… |
| 106,0M | 1,3G | 3,5G | 97,1% | 0,0k | 1,6G | 2,6G | 57,5%… |
| 103,1M | 1,2G | 3,5G | 97,2% | 0,0k | 1,4G | 2,7G | 60,0%… |
| 103,7M | 1,1G | 3,5G | 97,2% | 0,0k | 1,3G | 2,8G | 62,4%… |
| 115,2M | 1019,1M | 3,4G | 96,8% | 0,0k | 1,2G | 3,0G | 64,8%… |
| 102,9M | 925,4M | 3,5G | 97,2% | 0,0k | 1,1G | 3,0G | 66,7%… |
Ces outils n’ont pas forcément les mêmes calculs de répartition de la mémoire, mais on peut constater dans les trois cas:
- une consommation mémoire en hausse;
- un swap à peu près inutilisé ;
- un cache disque qui n’est pas complètement vidé.
DETAIL: Failed on request of size 23 in memory context “ExecutorState”.
Noter à la fin le GrandTotal à 2,5 Go. Contrairement à la configuration par défaut, la session s’est vu refuser par le noyau la réservation de mémoire au moment où CommittedAS dépassait CommitLimit. PostgreSQL sait gérer ce genre d’erreur et a arrêté la requête, sans tout redémarrer.