6 Référence sur les nœuds d’exécution
La première illustration de ce chapitre est la Figure 6-1.
6/ Référence sur les nœuds d’exécution
6.1 INTRODUCTION
- Types de nœuds principaux
- parcours de table (Seq Scan)
- parcours d’index (Index Scan & variantes)
- jointures (Nested Loop, Merge Join, Hash Join…)
- opérateurs sur des ensembles (Append, Except, Intersect…)
- Et quelques autres :
- Sort, *Aggregate, Unique, Limit, Materialize, Memoize…
- Plusieurs variantes pour chacun
Un plan d’exécution est un arbre. Chaque nœud de l’arbre est une opération à effectuer par l’exécuteur. Le planificateur arrange les nœuds pour que le résultat final soit le bon, et qu’il soit récupéré le plus rapidement possible. Il y a plusieurs types de nœuds:
- les parcours, qui permettent de lire les données dans les tables en passant, essentiellement :
- soit par la table;
- soit par l’index;
- les jointures, qui permettent de joindre deux ensembles de données ;
- les opérateurs sur des ensembles, qui là aussi vont joindre deux ensembles ou plus ;
- et les opérations sur un seul ensemble : tri, limite, agrégat, etc.
Cet annexe a pour but d’entrer dans le détail de chaque type de nœuds, ses avantages et inconvénients. Pour chacun il existe plusieurs variantes, par exemple les variantes parallélisées des parcours ou agrégats.
6.2 LES PARCOURS
6.2.1 Principe des parcours
- Rien en entrée
- Renvoie un ensemble de données des tables
- trié ou non
- filtré ou non
- Exemples :
- parcours séquentiel d’une table, avec ou sans filtrage des enregistrements produits
- parcours via un index, avec ou sans filtrage supplémentaire
Les parcours sont les seules opérations qui lisent les données des tables, qu’elles soient standards, temporaires, non journalisées, une partition ou en fait une vue matérialisée. Des parcours sont dédiés aux lectures via un index, voire seulement dans l’index.
Les parcours ne prennent donc rien en entrée, et fournissent un ensemble de données en sortie. Cet ensemble peut être trié ou non, filtré ou non.
Il existe trois types de parcours que nous allons détailler:
- le parcours de table Seq Scan;
- le parcours d’index Index Scan, avec sa variante Index Only Scan;
- le parcours de bitmap index (Index Bitmap Scan/_Index Bitmap ;
Tous les trois pouvant recevoir des filtres supplémentaires en sortie.
6.2.2 Parcours de table
6.2.3 Seq Scan : principe
- Parcours séquentiel de la table (Sequential Scan ou Seq Scan)
- parallélisation possible (Parallel Seq Scan)
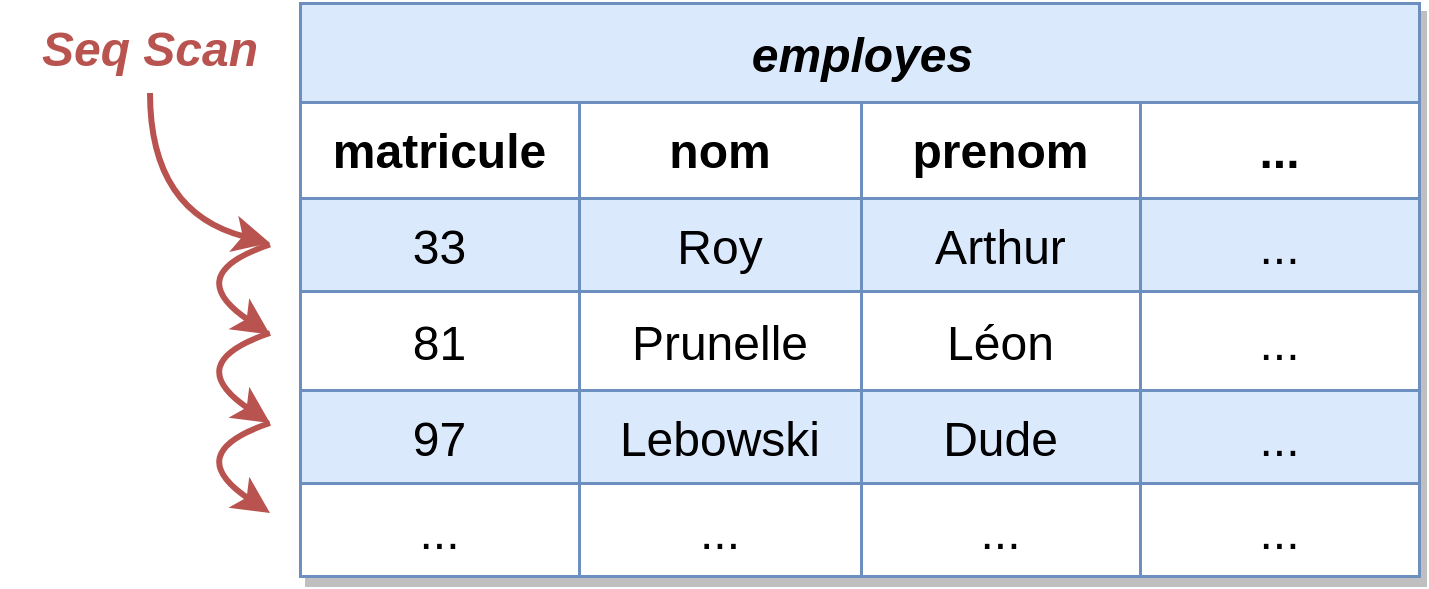
- La table est lue entièrement
- même si seulement quelques lignes satisfont la requête
- sauf avec LIMIT sans ORDER BY
- Séquentiellement, par bloc de 8 ko
Le parcours le plus simple est le parcours séquentiel. La table est lue complètement, de façon séquentielle, par bloc de 8 ko (par défaut et en général). Les données sont lues dans l’ordre physique sur disque, donc les données ne sont pas envoyées triées au nœud supérieur. Cela fonctionne dans tous les cas, car il n’y a besoin de rien de plus pour le faire: un parcours de table ne nécessite rien de plus que la table, même sans index.
D’autres SGBD connaissent le Seq Scan sous le nom de Full Table Scan 1.
1 https://en.wikipedia.org/wiki/Full_table_scan
6.2.4 Seq Scan : performances
- Idéal pour :
- petites tables
- % de retour élevé des blocs
- partitions entières
- Contre-performant pour :
- quelques lignes d’une grande table
- Optimisation : synchronize_seqscans
Le parcours de table est intéressant pour les performances dans deux cas: Très petites tables: Les très petites tables qui tiennent dans une poignée de blocs sont parcourues très vite. L’utilisation d’un index ne ferait pas gagner de temps. Nombreuses lignes retournées: Quand une partie significative d’une grosse table doit être retournée, les allers-retours entre la table et un index, et l’accès à l’index lui-même ne sont plus rentables. PostgreSQL peut alors juger qu’il vaut mieux lire toute la table et ignorer certaines lignes. La ratio de lignes ramenées à partir duquel PostgreSQL bascule entre un appel d’index et un Seq Scan dépend en bonne partie des paramètres random_page_cost et seq_page_cost. Sur un disque rotatif, les accès de blocs isolés sont beaucoup plus coûteux que sur un SSD. Il dépend aussi d’autres choses comme la corrélation physique, c’est-à-dire la relation entre la valeur de la ligne dans la table et son emplacement sur disque. En effet, récupérer une ligne implique de récupérer tout le bloc où elle se trouve. Si les statistiques montrent que la corrélation est mauvaise, les lignes satisfaisant un critère sont dispersées, et la chance de devoir lire tous les blocs plus élevée. Évidemment, si toute la table doit être lue sans filtrage, le Seq Scan demeure incontournable. Exemples: Voici quelques exemples à partir de ce jeu de tests:
Ici, nous faisons une lecture complète de la table. De ce fait, un parcours séquentiel sera plus rapide du fait de la rapidité de la lecture séquentielle des blocs:
Le coût est relatif au nombre de blocs lus, au nombre de lignes décodées et à la valeur des paramètres seq_page_cost et cpu_tuple_cost. Si un filtre est ajouté, cela aura un coût supplémentaire dû à l’application du filtre sur toutes les lignes de la table (pour trouver celles qui correspondent à ce filtre):
Ce coût supplémentaire dépend du nombre de lignes dans la table et de la valeur du paramètre cpu_operator_cost (défaut 0,0025) ou de la valeur du paramètre COST de la fonction appelée. L’exemple ci-dessus montre le coût (1693) en utilisant l’opérateur standard d’égalité. Maintenant, si on crée une fonction qui utilise cet opérateur (écrite en PL/pgSQL, elle masque l’opérateur à l’optimiseur), avec un coût forcé à 10 000, cela donne:
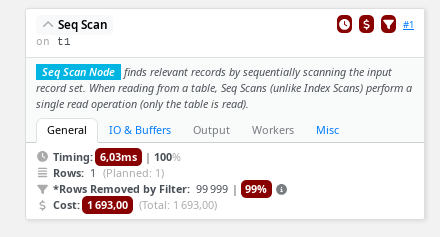
La ligne Filter indique le filtre réalisé. Le nombre de lignes indiqué par rows= est le nombre de lignes après filtrage. Pour savoir combien de lignes ne satisfont pas le prédicat de la clause WHERE, il faut exécuter la requête et donc utiliser l’option EXPLAIN:
La ligne Rows Removed by Filter indique que 99 999 lignes ont été rencontrées et ignorées. La vision graphique du plan sur explain.dalibo.com 2 affiche donc un avertissement sur ce taux élevé de rejet. Cela doit faire envisager la création d’un index. 2 https://explain.dalibo.com/plan/515gf3529g4g37d1
L’option BUFFERS permet en plus de savoir le nombre de blocs lus dans le cache (hit) et hors du cache, (read). Les 443 blocs (3,5 Mo) de la table sont ici dans le cache. Le calcul réalisé pour le coût final est le suivant :
Synchronisation des Seq Scan: Si le paramètre synchronize_seqscans est à on (et il l’est par défaut), le processus qui entame une lecture séquentielle cherche en premier lieu si un autre processus ne ferait pas une lecture séquentielle de la même table. Si c’est le cas, le second processus démarre son parcours de table à l’endroit où le premier processus est en train de lire, ce qui lui permet de profiter des données mises en cache par ce processus. L’accès au disque étant bien plus lent que l’accès mémoire, les processus restent naturellement synchronisés pour le reste du parcours de la table, et les lectures ne sont donc réalisées qu’une seule fois. Le début de la table restera à être lu indépendamment. Cette optimisation permet de diminuer le nombre de blocs lus par chaque processus en cas de lectures parallèles de la même table. Sans autre tri, l’ordre des lignes retournées peut donc différer alors que les requêtes sont identiques et simultanées. Mais aucune application ne doit supposer que les lignes sont dans un certain ordre sans ORDER BY explicite. Parcours parallélisé: Une nouvelle optimisation vient de la parallélisation apparue avec PostgreSQL 9.6. Le nœud devient un Parallel Seq Scan. Le processus responsable de la requête demande l’exécution de plusieurs processus, appelés workers, qui ont tous pour charge de lire une partie de la table et d’appliquer le filtre. Les nouveaux blocs lus depuis le disque sont enregistrés en mémoire partagée. Chaque worker travaille
sur des blocs différents. Quand il a terminé de travailler sur un bloc, il consulte la mémoire partagée pour s’attribuer d’autres blocs à traiter. Il n’y a aucune assurance que chaque worker travaillera sur le même nombre de blocs au final. Voici un exemple de plan parallélisé pour un parcours de table:
La vision graphique est sur https://explain.dalibo.com/plan/c92a611h5g4b33cg. Dans ce cas, le planificateur a prévu l’exécution de deux workers, et deux ont bien été lancés lors de l’exécution de la requête. Deux Parallel Scan apparaissent, mais le processus principal participe aussi (par défaut), d’où la mention loops=3. L’ensemble des nœuds a en moyenne lu 2304 blocs dans le cache, 2176 hors du cache. Chacun d’eux a ignoré 166 666 lignes et conservé 206 431 lignes. Une vision plus étoffée avec le détail des workers (et notamment le nombre de blocs lus par worker) peut s’obtenir avec EXPLAIN (ANALYZE,BUFFERS,VERBOSE).
Le résultat de chaque Parallel Scan est récupéré par un Partial Aggregate, qui récupère les lignes et agrège au niveau d’un worker. Chaque Partial Aggregate renvoie 1 ligne de décompte (là encore 3 fois). Au-dessus, le nœud Gather est chargé de récupérer les 3 lignes des workers. La somme des agrégats partiels est réalisée tout en haut dans un nœud Finalize Aggregate qui renvoie l’unique ligne finale de résultat.
Partitionnement: Un des intérêts du partitionnement est de favoriser les parcours complets sur un ensemble de données. Par exemple, un partitionnement par mois rendra optimales une requête agrégeant toutes les lignes d’un mois entier sans filtrage: il suffit de parcourir la partition (une table, en fait) du mois, sans index ni filtrage, et uniquement cette partition. Bien sûr, il faut choisir ce partitionnement en fonction des requêtes les plus sensibles.
6.2.5 Parcours d’index : Index Scan
6.2.6 Index Scan : principe
- Parcours « aléatoire » de l’index
- Pour chaque enregistrement correspondant à la recherche
- accès direct au bloc de la table
- vérification de la visibilité de la ligne
- renvoie des lignes triées
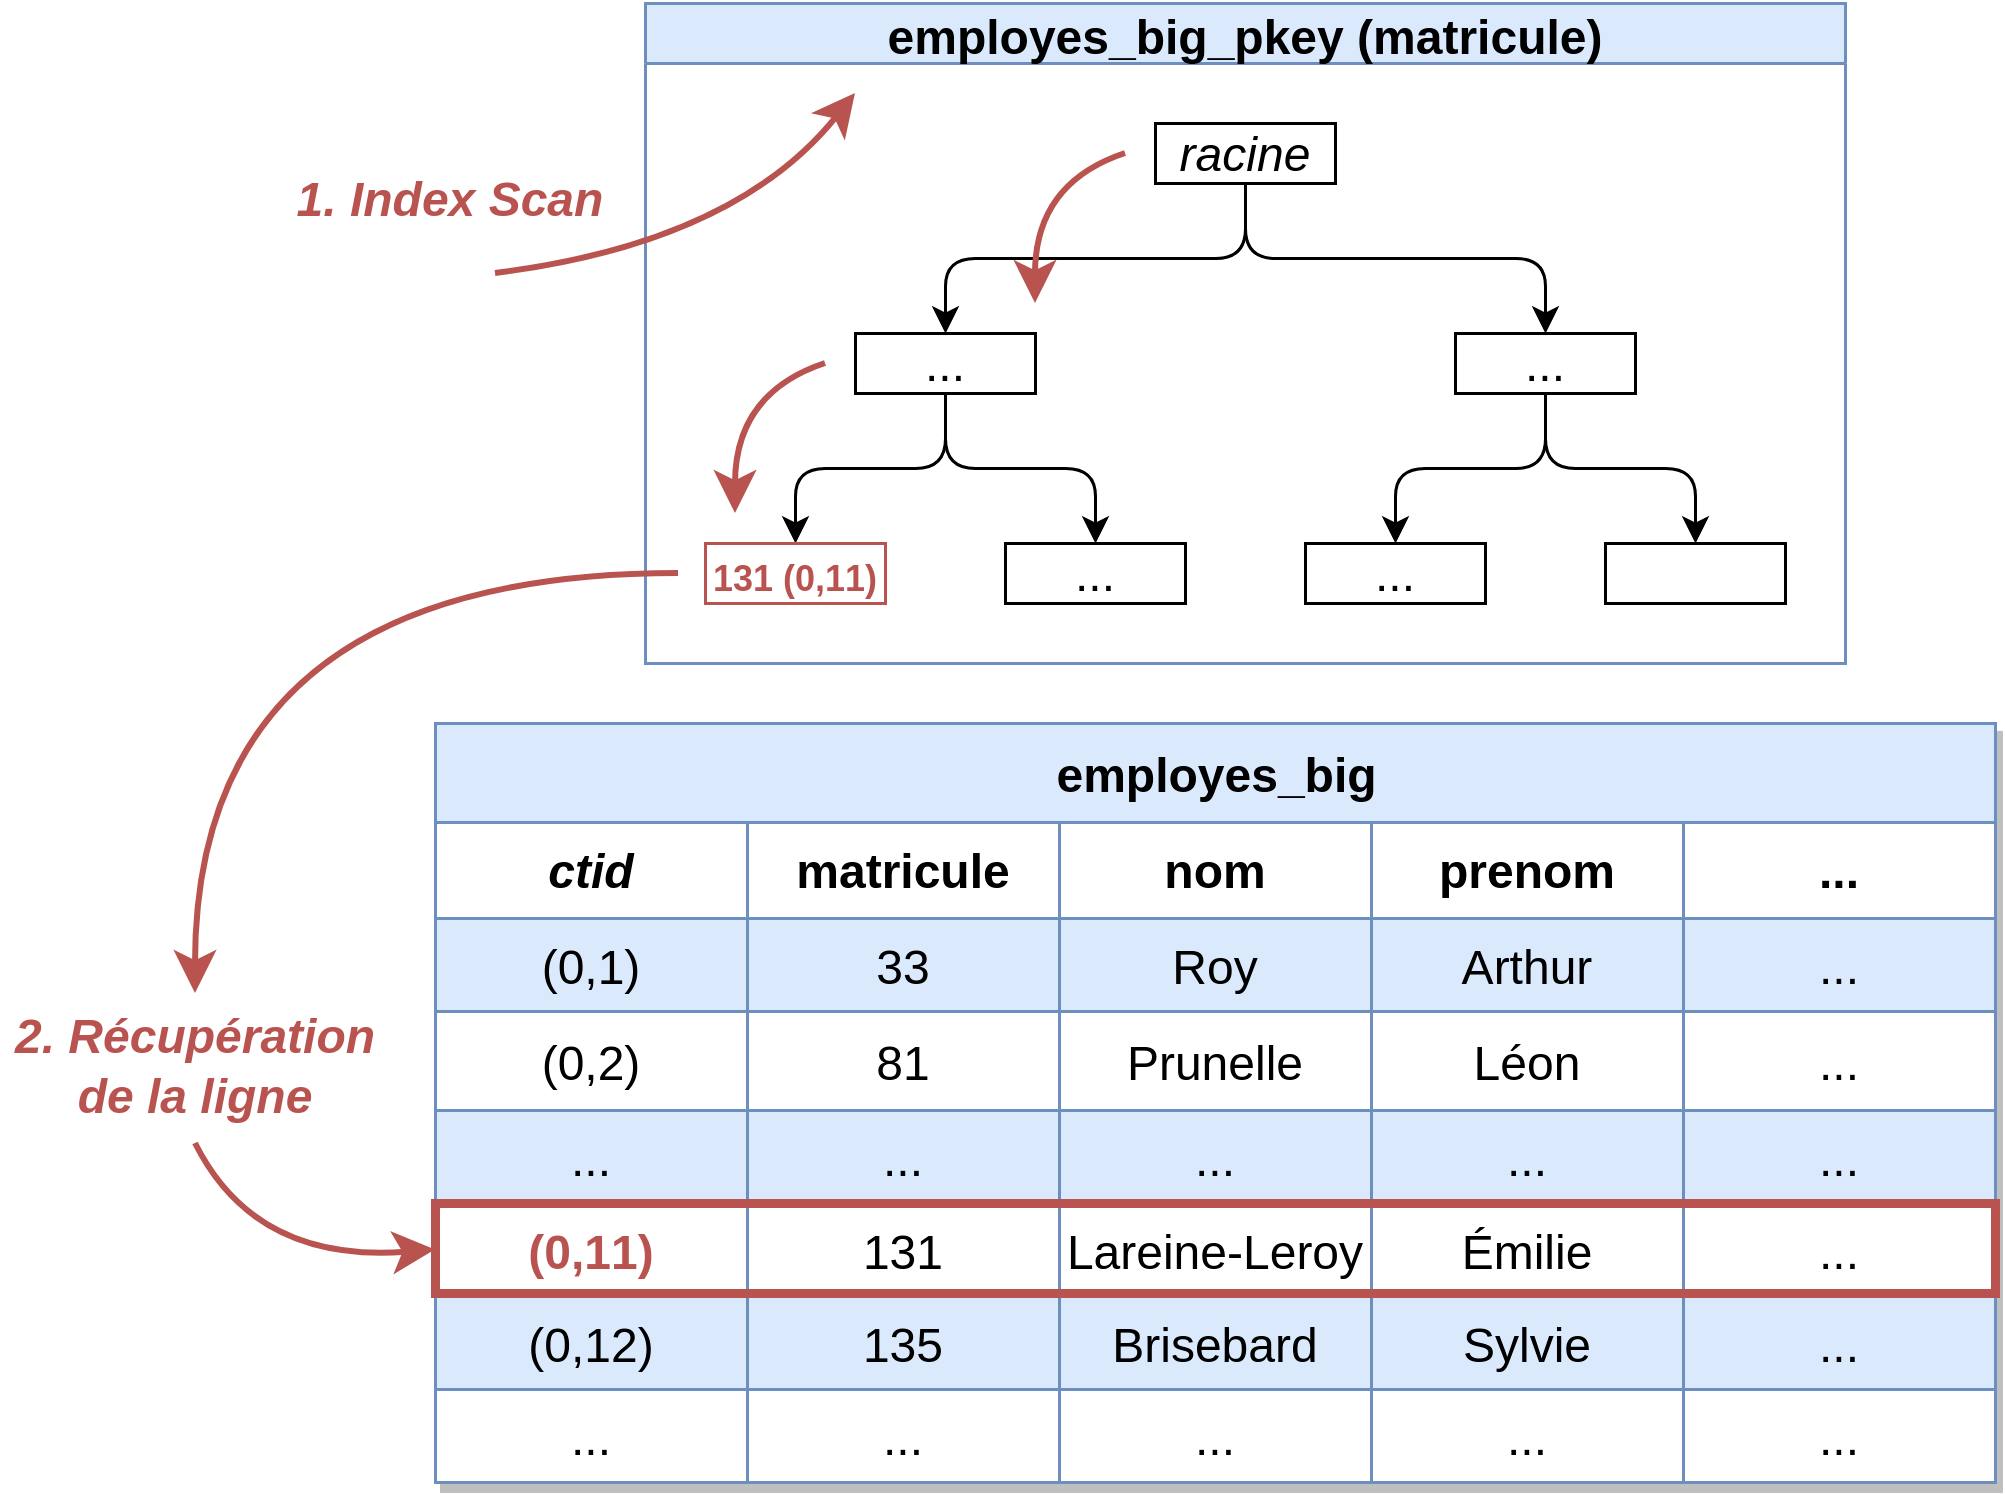
Parcourir une table prend du temps, surtout quand on cherche à ne récupérer que quelques lignes de cette table. Le but d’un index est donc d’utiliser une structure de données optimisée pour satisfaire une recherche particulière (on parle de prédicat). Sur PostgreSQL, l’index est un fichier séparé de la table. Il ne contient que les données indexées, triées, et l’emplacement des lignes où se trouvent ces données dans la table (bloc et ligne).
La donnée indexée peut être:
- le contenu d’un champ d’une table;
- le contenu de plusieurs champs, auquel cas l’ordre est important;
- le résultat d’une fonction sur ces champs.
Dans le cas de loin le plus courant, l’index est de type B-tree 3. Cette structure est un arbre. La recherche consiste à suivre la structure de l’arbre pour trouver le premier enregistrement correspondant au prédicat, puis suivre les feuilles de l’arbre jusqu’au dernier enregistrement vérifiant le prédicat. Étant donné la façon dont l’arbre est stocké sur disque, les accès concernent des blocs éparpillés, et, sur un disque rotatif, cela peut provoquer de nombreux déplacements de la tête de lecture. De plus, les enregistrements sont habituellement éparpillés dans la table, et retournés dans un ordre totalement différent de leur ordre physique par le parcours sur l’index. Cet accès à la table génère donc énormément d’accès aléatoires. Or, ce type d’activité est généralement le plus lent sur un disque magnétique. C’est pourquoi le parcours d’une large portion d’un index est très lent. PostgreSQL ne cherchera à utiliser un index que s’il suppose qu’il aura peu de lignes à récupérer.
Un autre problème des performances sur les index, spécifique à PostgreSQL, est que les informations de visibilité des lignes sont uniquement stockées dans la table. Quand une ligne est marquée comme effacée dans la table, l’index conserve un temps le pointeur vers cette ligne (il peut être nettoyé bien plus tard). Cela veut dire que, pour chaque élément de l’index correspondant au filtre, il faut lire la ligne dans la table pour vérifier qu’elle est bien visible pour la transaction en cours. Ce n’est pas vraiment un problème dans le cas général, où le but de la requête est justement de récupérer ces lignes, et les autres colonnes demandées, généralement absentes de l’index. Mais dans les cas où l’index contient déjà toute l’information pour satisfaire le filtre, l’accès à la table semble inutile. Nous verrons que l’Index Only Scan existe pour traiter ce cas précis.
Voici l’algorithme permettant un parcours d’index avec PostgreSQL:
- Pour tous les éléments de l’index :
- chercher l’élément souhaité dans l’index;
- récupérer le bloc de l’élément trouvé, puis la ligne ;
- vérifier sur la ligne qu’il est visible par la transaction;
- lire les autres colonnes nécessaires;
- filtrer les lignes trouvées en fonction des critères que l’index ne pouvait pas satisfaire.
Un Index Scan ne consiste donc pas qu’à consulter l’index, mais aussi la table, et à opérer des filtres supplémentaires sur les données récupérées dans la table.
Les autres types d’index connus de PostgreSQL (GiST, hash, GIN…) reposent généralement sur une variante de ce principe, chacun avec sa spécificité.
3 https://en.wikipedia.org/wiki/B-tree
6.2.7 Index Scan : performances
- Intéressant pour :
- les accès à peu de lignes dans la table
- les tris ( ORDER BY …)
- Non adapté à :
- récupération de trop nombreuses lignes
- Coût en maintenance
- Parallélisation (Parallel Index Scan)
- B-Tree uniquement
Un parcours d’index est donc très coûteux, principalement à cause des déplacements de la tête de lecture. Un parcours d’index n’est préférable à un parcours de table que si la recherche ne va ramener qu’un faible pourcentage de la table. Comme PostgreSQL calcule le nombre de blocs, la corrélation physique a aussi une influence. Le gain possible est très important par rapport à un parcours séquentiel de table. Par contre, un parcours d’index se révèle très lent pour lire un gros pourcentage de la table. Les accès aléatoires diminuent spectaculairement les performances sur les disques rotatifs (par défaut, le paramètre random_page_cost, lié au coût de lecture aléatoire d’une page est 4 fois supérieur à celui de la lecture séquentielle d’une page, seq_page_cost ). La situation est bien meilleure sur les disques SSD et NVMe récents mais le principe reste le même. Il est à noter que, contrairement au parcours de table, le parcours d’index renvoie toujours les données triées. C’est le seul parcours à le faire. Il permet donc d’optimiser la clause ORDER BY d’une requête, et d’éviter un tri des résultats, parfois très lourd. L’index est aussi utilisable dans le cas des tris descendants, et dans ce cas, le nœud est nommé Index Scan Backward (sens inverse). Attention, l’ ORDER BY doit être dans le même ordre que les champs de l’index pour être optimal. Cet index peut aussi favoriser l’utilisation d’autres nœuds qui savent utiliser des données triées, en premier lieu les jointures par Merge Join, ou des agrégations. Il ne faut pas oublier aussi le coût de mise à jour de l’index. Si un index n’est pas utilisé, il coûte cher en maintenance (ajout des nouvelles entrées, suppression des entrées obsolètes, place sur le disque et le cache, etc.). En général, ajouter un index reste « rentable» puisqu’il accélère les lectures, voire les écritures (sur l’index). Mais il faut vérifier que l’on n’a pas des index inutiles, en double (PostgreSQL le permet) ou redondants, et l’on n’indexera pas « à tout hasard » des champs. Enfin, il est à noter que ce type de parcours est aussi consommateur en CPU. Voici un exemple montrant les deux types de parcours et ce que cela occasionne comme lecture disque. Commençons par créer une toute petite table avec quelques données et un index:
Essayons maintenant de lire la table avec un simple parcours séquentiel:
Planning:
Nous obtenons un parcours séquentiel (Seq Scan). En effet, la table est tellement petite (elle tient dans un bloc de 8 ko) qu’utiliser l’index coûterait forcément plus cher. Grâce à l’option BUFFERS, nous savons d’ailleurs que seul un bloc a été lu à l’exécution. À titre purement expérimental, pour forcer un parcours d’index, nous allons désactiver les parcours séquentiels et réinitialiser ses statistiques:
Il existe aussi un paramètre, appelé enable_indexscan, pour désactiver les parcours d’index, à titre expérimental. Maintenant relançons la requête:
Nous avons bien un parcours d’index. Vérifions les statistiques sur l’activité: SELECT relname, heap_blks_read, heap_blks_hit, idx_blks_read, idx_blks_hit
| relname | heap_blks_read | heap_blks_hit | idx_blks_read | idx_blks_hit |
|---|---|---|---|---|
| t1 | 0 | 1 | 0 | 2 |
Deux blocs ont été lus dans l’index (colonnes idx_blks_* ) et un autre a été lu dans la table (colonnes heap_blks_* à 1). Le plus impactant est l’accès aléatoire sur l’index et la table. Ce n’est pas un souci avec peu de lignes, mais avec de gros volumes il serait bon d’avoir une lecture de l’index, puis une lecture séquentielle de la table. C’est le but du Bitmap Index Scan.
6.2.8 Index Scan et nombre de recherches
- Un même nœud peut procéder à 1 ou N recherches depuis la racine (ex : clause OR , IN )
- Visible dans le plan avec Index Searches (v18+)
Un même nœud peut procéder à plusieurs recherches, par exemple s’il y a une clause OR. Une recherche consiste à repartir de la racine de l’index et de parcourir les nœuds intermédiaire pour parvenir jusqu’aux feuilles qui contiennent les données. De nombreuses recherches sont évidemment plus préjudiciables qu’une seule. Une recherche peut ramener de nombreuses lignes. Avant la version 18, il était difficile de savoir combien de recherches pouvait effectuer PostgreSQL. Au mieux, on constatait un effet sur le nombre de blocs lus, ou le nombre de loops d’un nœud. À partir de la version 18, la ligne Index Searches indique le nombre de parcours dans l’index. Exemple:
- Une recherche implique de lire 4 blocs :
——————————————————————————- Index Scan using t1_c1_idx on t1 (actual time=0.011..0.012 rows=1.00 loops=1) Index Cond: (c1 = 5) Index Searches: 1
- Deux valeurs dans le OR mènent à deux accès à l’index séparés, pour deux fois plus de blocs lus :
EXPLAIN (ANALYZE, COSTS OFF, SUMMARY OFF)
——————————————————————————- Index Scan using t1_c1_idx on t1 (actual time=0.012..0.016 rows=2.00 loops=1) Index Cond: (c1 = ANY (’{5,100000}’::integer[])) Index Searches: 2
- Avec trois valeurs dans le OR , on pourrait s’attendre à trois recherches, mais comme les valeurs sont proches (et l’index non fragmenté), la feuille finale est la même, et PostgreSQL sait regrouper les accès : un seul suffit ici.
EXPLAIN (ANALYZE, COSTS OFF, SUMMARY OFF)
Index Scan using t1_c1_idx on t1 (actual time=0.018..0.020 rows=3.00 loops=1) Index Cond: (c1 = ANY (’{5,7,200}’::integer[])) Index Searches: 1
La recherche d’un algorithme qui limite le nombre de recherches tout en évitant de parcourir trop de feuilles inutiles a fait partie des travaux de la version 18 4.
- Une large plage de valeurs peut être ramenée en une seule recherche :
EXPLAIN (ANALYZE, COSTS OFF, SUMMARY OFF)
Index Scan using t1_c1_idx on t1 (actual time=0.006..5.879 rows=99001.00 loops=1) Index Cond: ((c1 >= 1000) AND (c1 <= 100000)) Index Searches: 1
Planning:
- Ici, il devient visible que le nœud Index Scan a procédé à un millier de recherches (une par ligne de t2 ), ce qui est cohérent avec ce qu’indique loops :
EXPLAIN (ANALYZE, COSTS OFF, SUMMARY OFF)
Nested Loop (actual time=52.650..79.041 rows=244270.00 loops=1)
4 https://git.postgresql.org/gitweb/?p=postgresql.git;a=commitdiff;h=8a510275d
Planning:
- Enfin, il devient visible ici que deux recherches suffisent pour deux plages :
EXPLAIN (ANALYZE, BUFFERS OFF, COSTS OFF, SUMMARY OFF)
6.2.9 Parcours d’un index multicolonnes
L’ordre des colonnes est capital (exception possible en v18+)
6.2.10 Parcours d’un index multicolonnes : exemple
– Index sur 2 colonnes
– critère sur la 2è colonne
- Lecture de tout l’index… voire Seq Scan
Un index B-tree multicolonnes n’est optimal que si la première colonne fait systématiquement partie des critères de recherche. En effet, les données sont triées dans l’index d’abord selon le premier champ (ici c1 ), puis selon le second ( c2 ), etc. Dans l’exemple suivant, le premier champ est une constante. CREATE TABLE demo( c1 int, c2 int, valeur int );
Cette requête sur les deux champs utilise l’index et est très rapide: EXPLAIN (ANALYZE, BUFFERS, COSTS OFF, SUMMARY OFF)
Index Scan using demo_bi on demo (actual time=0.016..0.018 rows=10 loops=1) Index Cond: ((c1 = 42) AND (c2 = 100))
I/O Timings: shared read=0.008 Planning:
Par contre, sans le premier champ indexé, PostgreSQL ne sait pas utiliser l’index et doit parcourir la table entière, pour un temps bien supérieur: EXPLAIN (ANALYZE, BUFFERS, COSTS OFF, SUMMARY OFF)
—————————————————————————- Gather (actual time=0.202..18.516 rows=10 loops=1) Workers Planned: 2 Workers Launched: 2
-> Parallel Seq Scan on demo (actual time=8.969..14.346 rows=3 loops=3) Filter: (c2 = 100) Rows Removed by Filter: 333330
Dans d’autres cas, PostgreSQL peut utiliser l’index, mais il doit le lire entièrement. Il peut aussi utiliser un nœud Bitmap Scan. Le souci concerne aussi l’utilisation des index pour des tris. Pour un exemple plus complet, voir le module J4 5. PostgreSQL 18 possède une grosse amélioration sur ce point.
6.2.11 Parcours d’un index multicolonnes : skip scan
- À partir de PostgreSQL 18
- B-tree uniquement
- Pour chaque sous-index logique selon c1
- appel sur c2
- Condition : c1 de faible cardinalité
- Intérêts
- Moins d’index dédiés à une requête
À partir de PostgreSQL 18, si le critère de recherche ne porte que sur le second champ c2, l’index est peut-être en partie utilisable. Les index skip scans. changent l’accès habituel à l’index en autant d’accès qu’il y a de valeurs de c1, comme s’il y avait autant d’index différents (« sous-index logiques »). Dans chaque sous-index, PostgreSQL peut chercher les valeurs correspondant au critère sur c2. Il n’y a pas de nœud Skip Scan dédié. Le degré de découpage est en pratique géré lors de l’exécution. S’il y a trop de valeurs de c1 (des milliers), PostgreSQL peut revenir à un parcours intégral de l’index ou de la table. Avec les skip scan, l’accès à l’index n’est pas aussi optimal qu’un index commençant par c2, mais on peut beaucoup s’en rapprocher. Cette optimisation n’a vraiment d’intérêt que si les valeurs distinctes de c1 sont assez peu nombreuses (des années, des statuts…). Au contraire, si les valeurs de c1 sont trop diverses (champ très discriminant), l’intérêt est limité, car en pratique PostgreSQL parcourra tout l’index ou presque. Cette nouvelle fonctionnalité permet donc d’économiser des index. Des requêtes non critiques peuvent se satisfaire d’un index dont elles ne filtrent pas le premier champ. On peut éviter de créer le même index multicolonnes en deux versions dans des ordres différents pour satisfaire à des requêtes 5 https://dali.bo/j4_html#index-multicolonnes
différentes: celui commençant par la colonne la moins discriminante sera peut-être suffisant pour toutes les requêtes. De même, on a couramment le dilemme suivant: faut-il créer un index pour optimiser un ORDER BY ou en créer un autre pour optimiser le critère de sélection? À présent, l’index pour le tri suffira peut-être à la sélection des lignes. Cette amélioration ne concerne que les index B-tree, qui sont les plus courants. Il arrivait que des index GIN, voire bloom, soient utilisés pour cette indexation multicolonnes 6, mais ils sont beaucoup plus lourds ou ont des limites. Exemple: Cette table contient des ID de commandes, avec un index sur (annee, num_client). Elle est triée pour améliorer la corrélation physique et rendre plus évident les changements d’utilisation des blocs.
SELECT a, trim(to_char(cl,‘00000’) ), (cl+commandes)%12
CROSS JOIN generate_series (30000,99999) cl CROSS JOIN generate_series (10,20) commandes ORDER BY a,cl,commandes;
– Ne pas oublier les statistiques
La table pèse 442 Mo, l’index sur les deux champs 165 Mo. Ce qui suit suppose une base PostgreSQL 18 avec le paramétrage par défaut, à part ceci pour simplifier les plans:
À cause de l’effet de cache en cas de répétition des requêtes, les plans peuvent différer de vos propres tests. Dans le cas idéal, avec une année et un numéro de client, récupérer une ligne via l’index ne nécessite que 4 blocs:
6 https://dali.bo/j5_html#indexation-multicolonnes-gin-gist-bloom
Pour trouver toutes les lignes d’un client pour toutes les années, PostgreSQL 18 sait utiliser l’index: seuls 47 blocs sont lus.
La ligne Index Searches est une autre amélioration de PostgreSQL 18, qui indique le nombre de recherches indépendantes dans l’index, c’est-à-dire démarrant de la racine, et pouvant potentiellement lire de nombreuses feuilles. Pour l’efficacité, il vaut mieux qu’il y en ait le moins possible. Mais il y a peu d’années indexées, et douze recherches au total est une valeur raisonnable. S’il y a deux valeurs à chercher, Index Searches trahit ici un accès à chaque année pour chacune:
Si les valeurs des clients sont très proches, une autre optimisation entre en jeu et le nombre de recherches et de blocs chute:
En effet, PostgreSQL repère la proximité des valeurs de num_client et préfère parcourir plus de feuilles finales dans l’index pour éviter les quelques blocs d’une recherche depuis la racine de la deuxième valeur. Cette requête calcule l’évolution des commandes par année et mois pour un client: EXPLAIN (ANALYZE,BUFFERS)
GROUP BY annee, mois ORDER BY annee, mois;
Planning:
La sélection des données se fait par l’index (annee, num_client) avec 12 recherches. Comme l’index est déjà trié par année, PostgreSQL peut utiliser l’ Incremental Sort, une optimisation de PostgreSQL 13, pour ne pas tout trier. Un seul index, à priori non optimal, permet donc à la requête d’être très rapide. Avec PostgreSQL 17, la requête aurait dû parcourir tout l’index et aurait duré 20 ms (60 fois plus longtemps). Exemple de recherche multicritère: Une recherche multicritère est notoirement problématique pour un index B-tree quand aucun champ n’est obligatoire. CREATE TABLE demo_multi (n int, i int, j int, k int, l int, filler char(50) default ’ ‘); – Requêtes possibles
Il est alors impossible de choisir une première colonne. Un index B-tree portant sur les quatre critères i, j, k, l est inutilisable par PostgreSQL 17 dans le cas général. (L’optimiseur utilise alors souvent un Seq Scan. On peut bien sûr définir un index sur chaque combinaison de critères, mais cela peut faire beaucoup d’index. Cet exemple d’une de nos formations 7 montre l’intérêt d’index GIN, GiST ou bloom pour une telle recherche multicritère.) Avec PostgreSQL 18, un unique index B-tree sur des combinaisons de colonnes peut redevenir intéressant dans le cas favorable où il y a très peu de valeurs différentes sur les premières colonnes de l’index, et peu de colonnes.
7 https://dali.bo/j5_html#indexation-multicolonnes-gin-gist-bloom
ORDER BY i,j,k,l;
EXPLAIN (ANALYZE, COSTS OFF)
La dernière colonne est trouvée avec 13 recherches différentes:
Cette recherche fonctionne aussi et donne lieu cette fois à un Bitmap Scan:
EXPLAIN (ANALYZE, COSTS OFF)
Bitmap Heap Scan on demo_multi (actual time=7.341..20.521 rows=111392.00 loops=1) Recheck Cond: ((j = 0) AND (k = 0)) Heap Blocks: exact=1378
Cela reste plus intéressant qu’un Seq Scan.
Au final, le B-tree redevient une option de plus à tester pour les recherches multicritères, mais tout dépend du nombre de champs, de leur sélectivité, etc.
6.2.12 Parcours d’index bitmap
6.2.13 Bitmap Scan : principe
- Bitmap Index Scan / Bitmap Heap Scan
- Réduire les allers-retours index table
- trouver les blocs de l’index
- puis lecture des blocs de la table
- Combinaison de plusieurs index en mémoire
- nœud BitmapAnd
- nœud BitmapOr
- Index B-tree, GIN, BRIN…
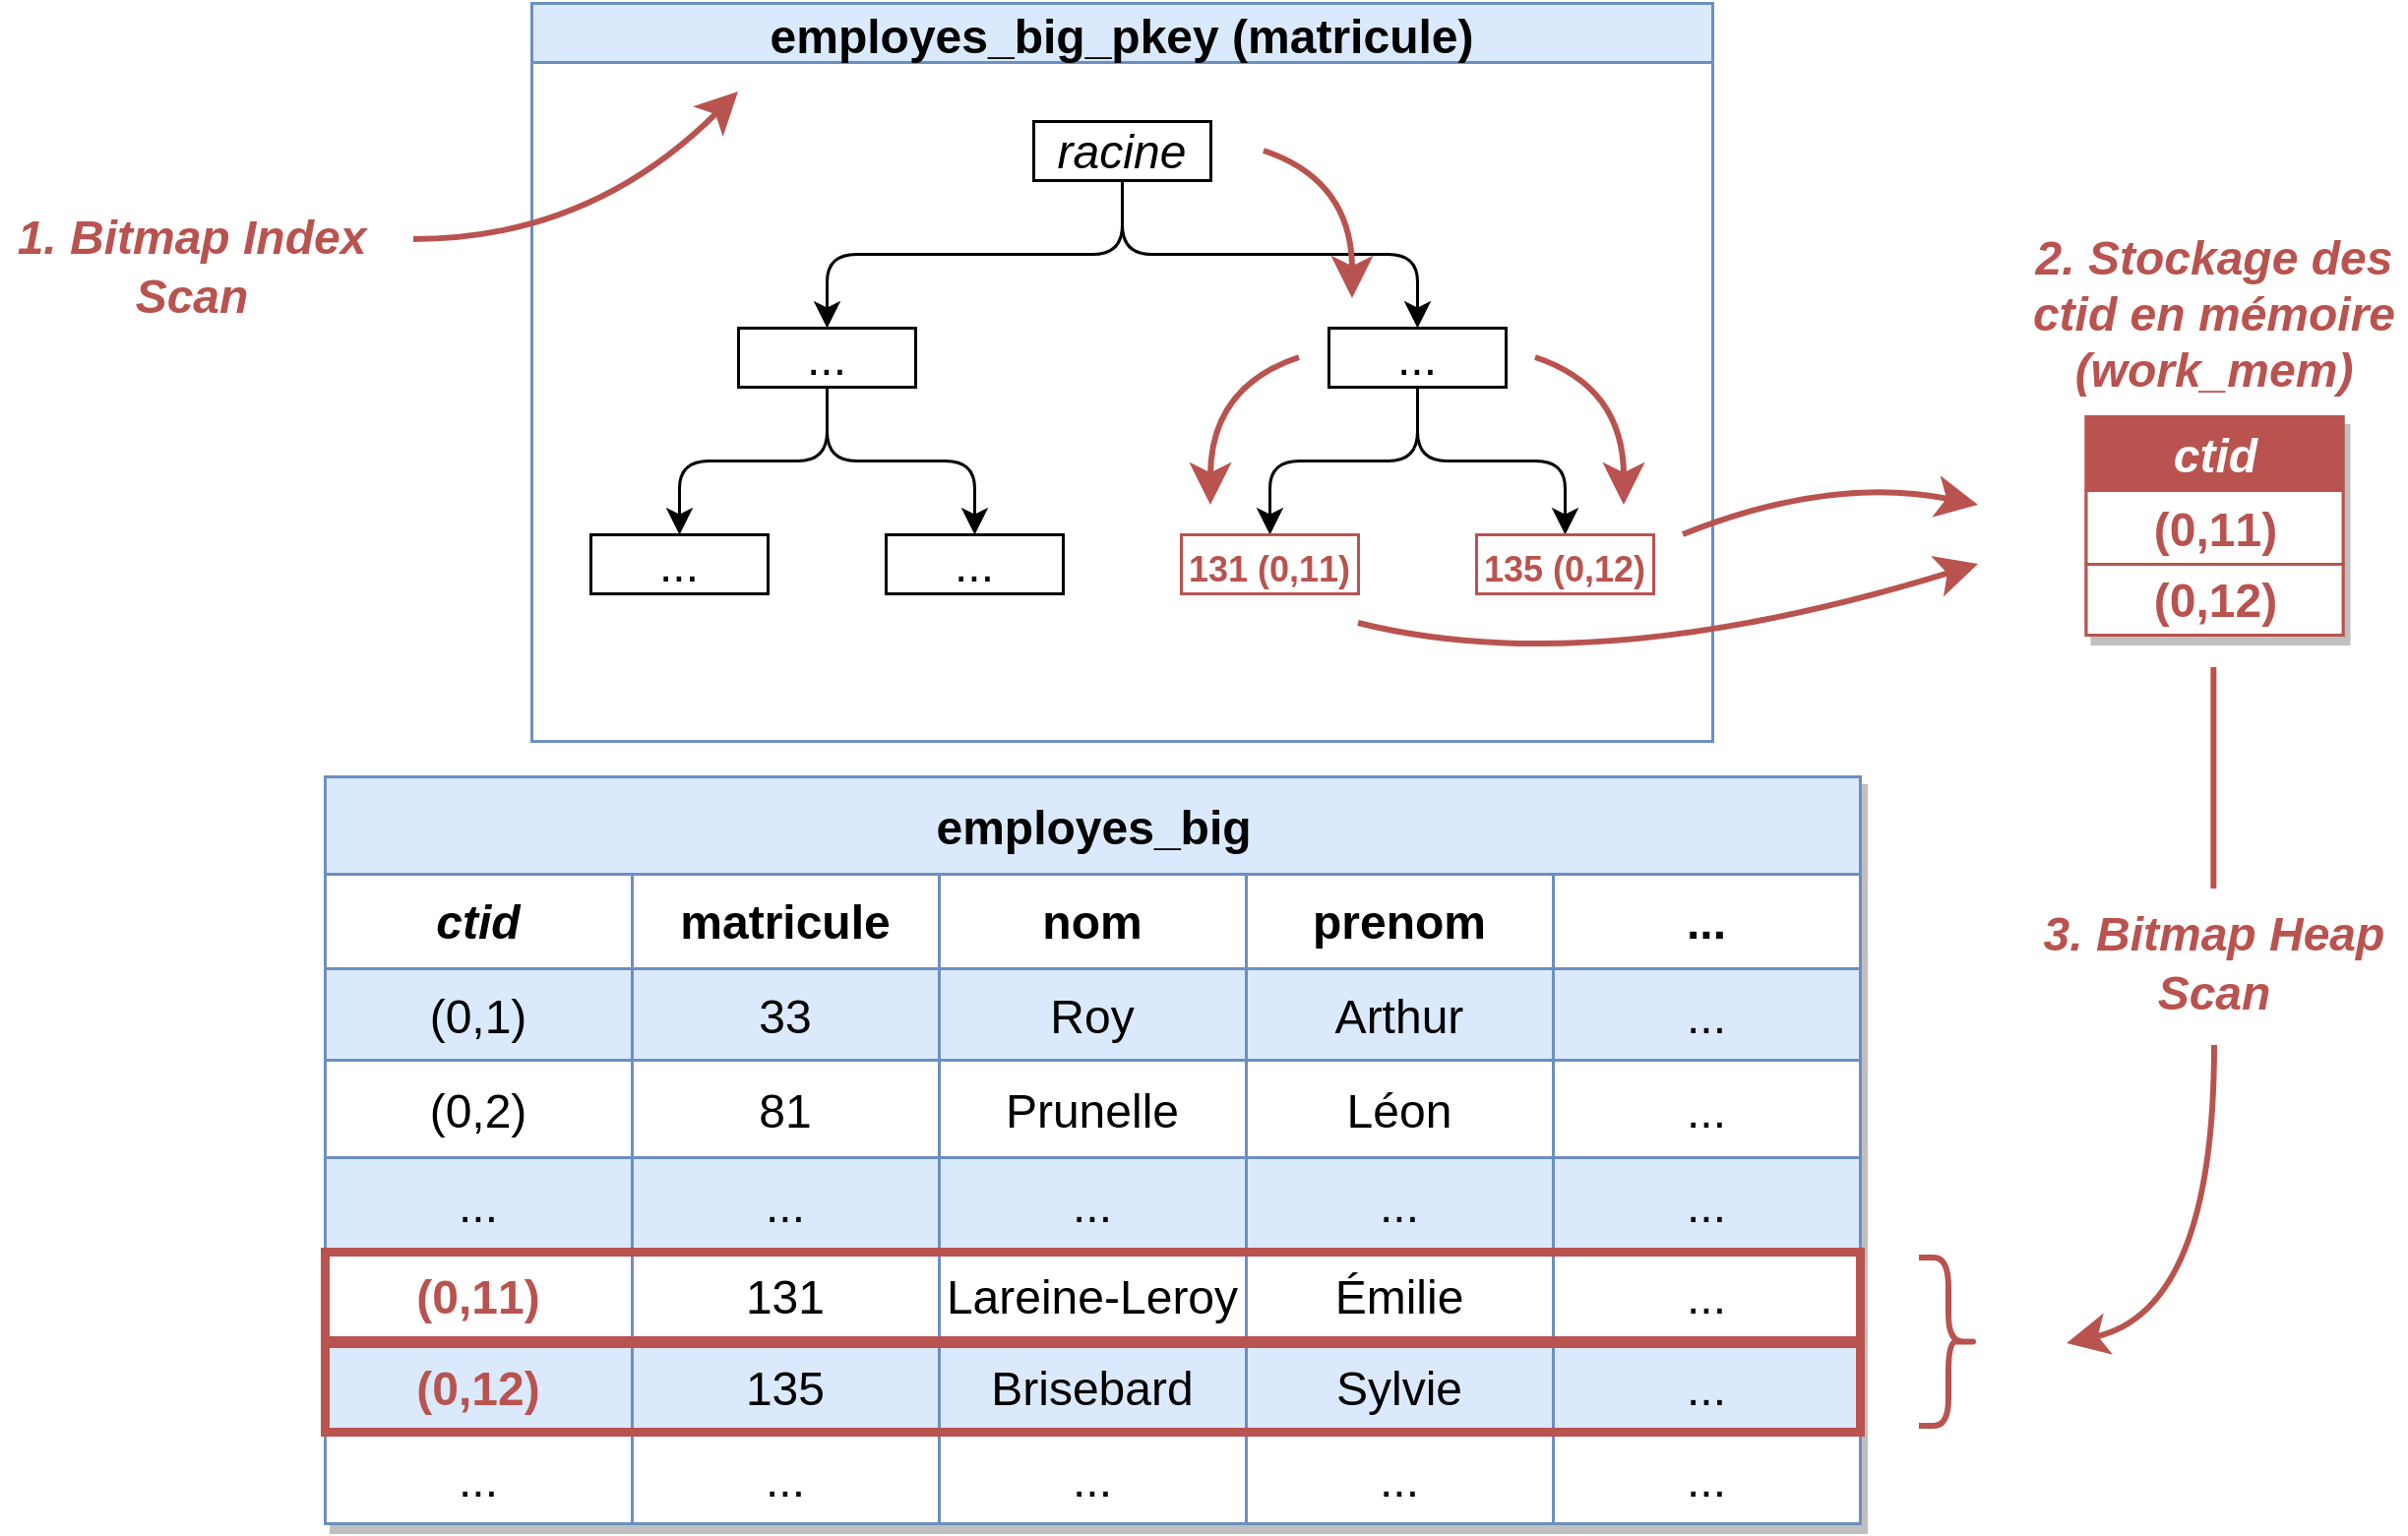
D’autres SGBD connaissent des index de type « bitmap », mais pas PostgreSQL. Celui-ci crée des structures bitmap en mémoire lorsque son utilisation a un intérêt. Cela se manifeste par le couple de nœuds Bitmap Index Scan et Bitmap Heap Scan. Le principe est de diminuer les déplacements de la tête de lecture en découplant le parcours de l’index du parcours de la table. Même avec un SSD, cette méthode évite d’aller chercher trop souvent les mêmes blocs et améliore l’utilisation du cache.
Son principe est le suivant:
- lecture en une passe de l’index (Bitmap Index Scan) ;
- récupération des TID (tuple id) en mémoire (1 bit par ligne dans le cas idéal);
- tri des blocs à parcourir dans la table dans l’ordre physique de la table (pas dans l’ordre logique de l’index);
- lecture en une passe de la partie intéressante de la table (Bitmap Heap Scan).
Les parcours d’index bitmap sont utilisables sur les B-tree bien sûr, mais aussi sur d’autres types d’index comme GIN, GiST, BRIN… C’est parfois le seul parcours disponible, certains types ayant de toute façon besoin d’une phase de recheck des lignes trouvées dans la table. Un bitmap est souvent utilisé quand il y a un grand nombre de valeurs à filtrer, notamment pour les clauses IN et ANY. Ce type d’index présente un autre gros intérêt: pouvoir combiner plusieurs index en mémoire. Les bitmaps de TID obtenus se combinent facilement avec des opérations booléennes AND et OR. Exemple: Cet exemple utilise PostgreSQL 17 dans sa configuration par défaut. La table suivante possède trois champs indexés susceptibles de servir de critères de recherche:
CREATE UNLOGGED TABLE tbt (i int GENERATED ALWAYS AS IDENTITY PRIMARY KEY, j int, k int, t text);
Lors de la recherche sur plusieurs critères, les lignes renvoyées par les Bitmap Index Scan peuvent être combinées: – pour la lisibilité des plans
EXPLAIN (ANALYZE, BUFFERS, VERBOSE, SETTINGS)
AND k = 10 AND t = ‘a’;
Filter: (tbt.t = ‘a’::text) Rows Removed by Filter: 538 Heap Blocks: exact=4
I/O Timings: shared read=0.008
Planning:
I/O Timings: shared read=0.004
Dans le plan précédent 8:
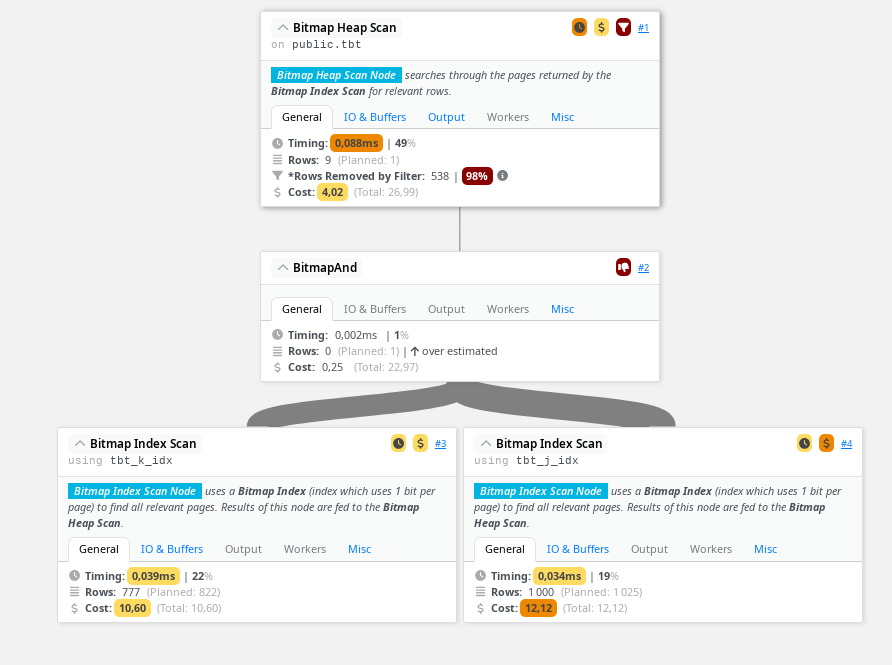
- deux Bitmap Index Scan parcourent séparément deux index, qui remontent l’un 777 lignes (toutes les lignes de la table où k vaut 10), l’autre 1000 lignes (où j vaut 8) ;
- le troisième index sur t est ignoré : il y a trop de lignes avec cette valeur (un décompte en trouverait 172 414), et surtout dispersées dans toute la table;
- un nœud BitmapAnd se charge de récupérer les résultats et de faire la combinaison logique ;
- il en résulte que seulement 4 blocs dans la table possédent des lignes correspondant aux deux critères (mention Heap Blocks);
- le Bitmap Heap Scan va dans la table lire ces 4 blocs séquentiellement, et une seule fois chacun, et trouve 547 lignes;
- la clause Recheck est toujours affichée mais, avec les B-tree, réalisée seulement lorsque le bitmap est de type lossy (voir plus bas);
- il reste à appliquer le critère non géré par les index utilisés, soit t = ‘a’ : c’est le rôle de la clause Filter, qui écarte 538 lignes et n’en garde que 9.
8 https://explain.dalibo.com/plan/a7hc82307ccac68b
Clause OR: Les index sont également utiles avec une clause OR:
EXPLAIN (ANALYZE,BUFFERS, COSTS)
OR k = 10 OR t = ‘a’;
I/O Timings: shared read=0.398 Planning:
I/O Timings: shared read=0.038
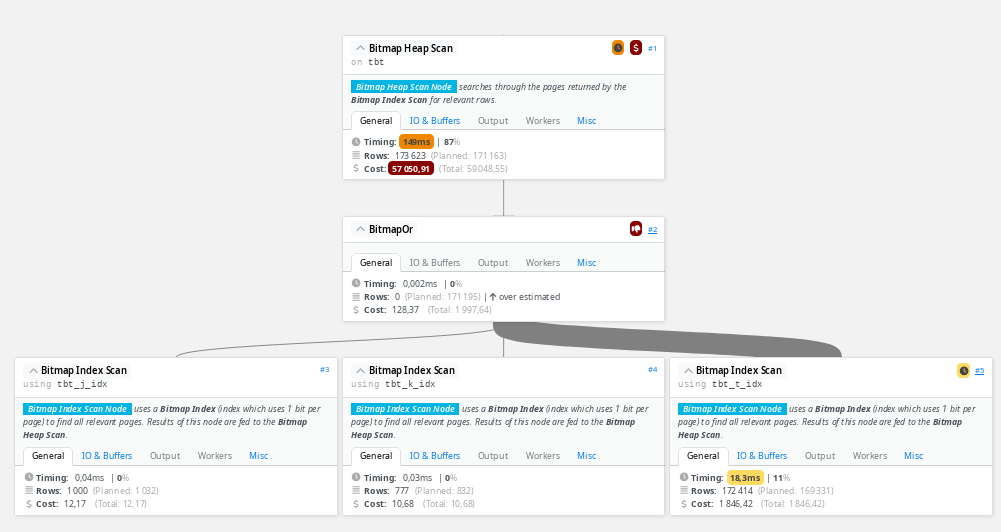
Ce plan 9 utilise cette fois les trois index.
Au final, le Bitmap Heap Scan lit quand même toute la table, qui fait 54 054 blocs! En effet, il y a des
Cependant, 98 %des comparaisons de critères sont tout de même évitées. Répéter le plan après avoir tapé ceci: 9 https://explain.dalibo.com/plan/ea7g69ec8a38cg2b
mènerait à un parcours de table séquentiel trois fois plus long. Réactiver la parallélisation donnerait un plan parallélisé encore un peu moins efficace. Ne pas oublier d’annuler ce paramétrage ensuite: RESET enable_bitmapscan;
6.2.14 Bitmap Scan : performances
- Indiqué pour :
- de nombreuses lignes
- bonne corrélation
- combinaison de critères IN , ANY
- combinaison d’index AND / OR
- Mais :
- coût de démarrage important
- pas intéressant avec LIMIT
- Parallélisation possible
- Sensible à :
- work_mem (sinon lossy)
- effective_cache_size
- effective_io_concurrency
Avec des B-tree, l’intérêt peut être énorme s’il y a une certaine corrélation des données avec l’emplacement physique. Il permet de réduire les accès aléatoires, ce qui est intéressant avec des disques qui ont un bon débit mais une mauvaise latence (disques mécaniques, baie surchargée). Le coût de démarrage est généralement important à cause de la lecture préalable de l’index et du tri des TID. Ce type de parcours est donc moins intéressant quand on recherche un coût de démarrage faible (clause LIMIT, curseur…). Un parcours d’index simple sera généralement choisi dans ce cas.
Le paramètre enable_bitmapscan permet d’activer ou de désactiver l’utilisation des parcours d’index bitmap, à titre expérimental. work_mem: Si le paramètre work_mem est trop bas, PostgreSQL n’a plus la place de stocker un bit par ligne dans son tableau, mais utilise un bit par page. La mention lossy apparaît alors sur la ligne Heap Blocks, et toutes les lignes de la page doivent être vérifiées lors de la phase Recheck. Avec la requête précédente, la performance est cette fois bien pire qu’un parcours complet:
EXPLAIN (ANALYZE,BUFFERS, COSTS)
OR k = 10 OR t = ‘a’;
I/O Timings: shared read=0.334
effective_cache_size: Les nœuds Bitmap Scan sont favorisés par une valeur importante du paramètre effective_cache_size, qui estime la quantité totale de cache disponible. effective_io_concurrency: Ce paramètre influe notablement sur la vitesse d’exécution des Bitmap Scan, entre autres. effective_io_concurrency a pour but d’indiquer le nombre d’opérations disques possibles en même temps pour un client (prefetch). Il n’a d’intérêt que si un nœud Bitmap Scan a été choisi. Cela n’arrive qu’avec un certain nombre de lignes à récupérer, et est favorisé par une valeur importante de effective_cache_size et un peu de corrélation physique dans la table.
La valeur d’ effective_io_concurrency n’influe pas sur le choix du plan, mais sa valeur peut notablement accélérer l’exécution du Bitmap Heap Scan. Le temps de lecture peut fréquemment être divisé par 3 ou plus. Les valeurs possibles d’ effective_io_concurrency vont de 0 à 1000. En principe, sur un disque magnétique seul, la valeur 1 ou 0 peut convenir. Avec du SSD, et encore plus du NVMe, il est possible de monter à plusieurs centaines, étant donné la rapidité de ce type de disque. Trouver la bonne valeur dépend de divers paramètres liés aux caractérisques exactes des disques et de leur paramétrage noyau.
Le read ahead du noyau intervient également. Le comportement de PostgreSQL sur ce point change aussi avec les versions. De plus, à partir d’un certain nombre de blocs, les I/O peuvent simplement saturer.
La valeur par défaut de 1 (jusque PostgreSQL 17) a été choisie de manière très conservatrice. Les développeurs ont décidé 10 que la valeur 16 est plus intéressante, même sur de vieux disques, et que ce sera le défaut à partir de PostgreSQL 18 11, qui inclut d’autres améliorations.
À l’inverse, la mauvaise latence de certains systèmes aux disques en principe performants (baies surchargées, certains stockages cloud…) peut parfois être compensée par un effective_io_concurrency plus élevé.
Il faut tester avec vos requêtes qui utilisent des Bitmap Heap Scan, et tenir compte du nombre de requêtes simultanées, mais effective_io_concurrency = 16 semble un bon point de départ, même sur une configuration modeste. Montez si vous avez de bons disques.
Une valeur excessive de effective_io_concurrency mène à un gaspillage de CPU: ne pas monter trop haut sans preuve de l’utilité, surtout sur un système très chargé.
Pour les systèmes RAID matériels, selon la documentation 12, configurer ce paramètre en fonction du nombre n de disques utiles dans le RAID (n/2 s’il s’agit d’un RAID 1, n-1 s’il s’agit d’un RAID 5 ou 6, n/2 s’il s’agit d’un RAID 10).
(Avant la version 13, le principe d’ effective_io_concurrency était le même, mais la valeur exacte de ce paramètre devait être 2 à 5 fois plus basse comme le précise la formule des notes de version de la version 13 13.)
10 https://www.postgresql.org/message-id/flat/CAAKRu_Z%2BJa-mwXebOoOERMMUMvJeRhzTjad4dSThxG0JLXESxw%40mail.gmail.com#c028f5b93307aafb9fe6d09d0cf3eeae 11 https://git.postgresql.org/gitweb/?p=postgresql.git;a=commit;h=ff79b5b2aba02d720f9b7fff644dd50ce07b8c6e 12 https://docs.postgresql.fr/current/runtime-config-resource.html#GUC-EFFECTIVE-IO-CONCURRENCY 13 https://docs.postgresql.fr/13/release.html
6.2.15 Parcours d’index seul : Index Only Scan
- Avant 9.2 : PostgreSQL devait lire l’index + la table
- À présent : le planificateur utilise la Visibility Map
- nœud Index Only Scan
- B-tree
- GiST, SP-GiST : selon opérateur
Répétons que les informations de visibilité d’une ligne sont stockées dans la table, pas dans l’index. C’est dommage pour la requête précédente, qui affiche juste le champ de la colonne indexée: ce qui est trouvé dans l’index suffit à répondre à la requête (il n’y a que le champ qui sert au filtrage). Il y a donc potentiellement des allers-retours inutiles vers la table. Or, PostgreSQL maintient une visibility map des blocs totalement visibles, où le contrôle de visibilité est superflu. Un nœud spécifique, Index Only Scan, sait en tirer parti. Voici un exemple sous PostgreSQL 9.1 (sorti en 2010), qui n’avait pas encore d’optimisation sur ce point. Un index est créé sur deux colonnes de la table, et la requête ne porte que sur ces deux colonnes:
– Table d’un million de lignes
SELECT random()*10000000, i, i, i
– Index sur deux champs
– Sélection sur un de ces champs, affichage du deuxième
Total runtime: 438.209 ms
Si l’on reproduit la même requête en 9.2:
– Table d’un million de lignes
SELECT random()*10000000, i, i, i
– Index sur deux champs
– Sélection sur un de ces champs, affichage du deuxième
Total runtime: 10.754 ms
On a donc un facteur 40 d’accélération (ici sur une machine moderne avec SSD, mais c’est au moins aussi intéressant sur des disques magnétiques avec une latence bien supérieure). La réduction du nombre de blocs lus (44 108 contre 347) explique en bonne partie le gain en temps. En effet, seul l’index est lu à présent. PostgreSQL 17 ne fait pas mieux. Passer le enable_indexonlyscan à off désactive le nœud Index Only Scan, et revient au comportement de la 9.1.
6.2.16 Index Only Scan : performances
- Extrêmement performant
- requêtes avec peu de colonnes
- Conditions
- VACUUM fréquent
- …sinon Heap Fetches
Les nœuds Index Only Scan sont donc très intéressants pour toutes les requêtes avec peu de colonnes qui pourraient tenir dans un index. Des index dits « couvrants », contenant d’abord les colonnes de filtrage, puis celles à retourner, peuvent être créés à destination de requêtes critiques afin de favoriser l’Index Only Scan. Par contre, l’Index Only Scan est très sensible au nombre de lignes « mortes ». Si l’on modifie 10 % de la table et que l’on relance la requête avant qu’un autovacuum ait le temps de passer, le temps d’exécution devient bien moins bon:
I/O Timings: shared read=101.754 write=141.870 Planning:
I/O Timings: shared read=0.010 write=0.017
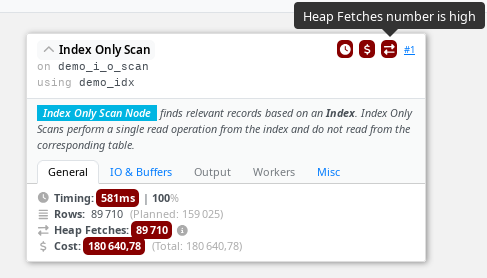
La version graphique 14 montre bien la présence de 89 710 heap fetches, c’est-à-dire de contrôles de visibility de la ligne dans la table. Cela concerne la moitié des lignes récupérées.
Certes, les lignes retournées ne sont pas celles modifiées. Mais elles sont mélangées (la corrélation entre a et l’emplacement physique est ici nulle) et de nombreux blocs contiennent les unes et les autres, et ne sont donc pas intégralement visibles, d’où les rechecks.
Si une requête critique dépend d’un Index Only Scan, il faut s’assurer que l’autovacuum passe très souvent, et/ou planifier des VACUUM très fréquents sur la table.
Références:
- Parcours d’index seul et index couvrants 15 dans la documentation officielle
- Article du blog A Hascker’s Diary 16 (Satoshi Nagayasu, 2011)
14 https://explain.dalibo.com/plan/1b5aa97ba934b04a 15 https://docs.postgresql.fr/current/indexes-index-only-scans.html 16 https://pgsnaga.blogspot.com/2011/10/index-only-scans-and-heap-block-reads.html
6.2.17 Autres parcours
- TID Scan
- Function Scan
- Values
- Result
Il existe d’autres parcours, bien moins fréquents ceci dit. TID Scan: TID est l’acronyme de tuple ID. C’est en quelque sorte un pointeur vers une ligne (ou ctid ). Ce type de parcours est exceptionnel en applicatif (et généralement une très mauvaise idée puisqu’il devrait seulement être utilisé en interne par PostgreSQL.
———————————————————- Tid Scan on pg_class (cost=0.00..4.01 rows=1 width=674) TID Cond: (ctid = ‘(1,1)’::tid)
Il est possible de le désactiver via le paramètre enable_tidscan. Function Scan: Un Function Scan est utilisé par les fonctions renvoyant des ensembles de lignes (appelées SRF pour Set Returning Functions). Vous pouvez écrire les vôtres mais PostgreSQL en fournit de nombreuses, par exemple generate_series():
EXPLAIN (ANALYZE,VERBOSE,BUFFERS)
I/O Timings: temp read=1.972 write=6.779 Query Identifier: -3923767323822397746
Noter que la génération de la fonction a donné lieu à l’utilisation d’un fichier temporaire. Pour l’éviter, il faut monter work_mem assez haut. Values:
table dont on spécifie les valeurs. Par exemple:
column1 ——— 1 2
Un alias permet de nommer les champs:
| c1 | c2 |
|---|---|
| a | 1 |
| c | 3 |
Le planificateur utilise un nœud spécial appelé Values Scan pour indiquer un parcours sur cette clause: EXPLAIN SELECT *
————————————————————– Values Scan on “VALUES” (cost=0.00..0.04 rows=3 width=36)
Result: Enfin, le nœud Result n’est pas à proprement parler un nœud de type parcours. Il y ressemble dans le fait qu’il ne prend aucun ensemble de données en entrée et en renvoie un en sortie. Son but est de renvoyer un ensemble de données suite à un calcul. Par exemple:
—————————————— Result (cost=0.00..0.01 rows=1 width=4)
6.3 JOINTURES
- Prend 2 ensembles de données en entrée
- inner (interne)
- outer (externe)
- Et renvoie un seul ensemble de données
- Nested Loop, Merge Join, Hash Join
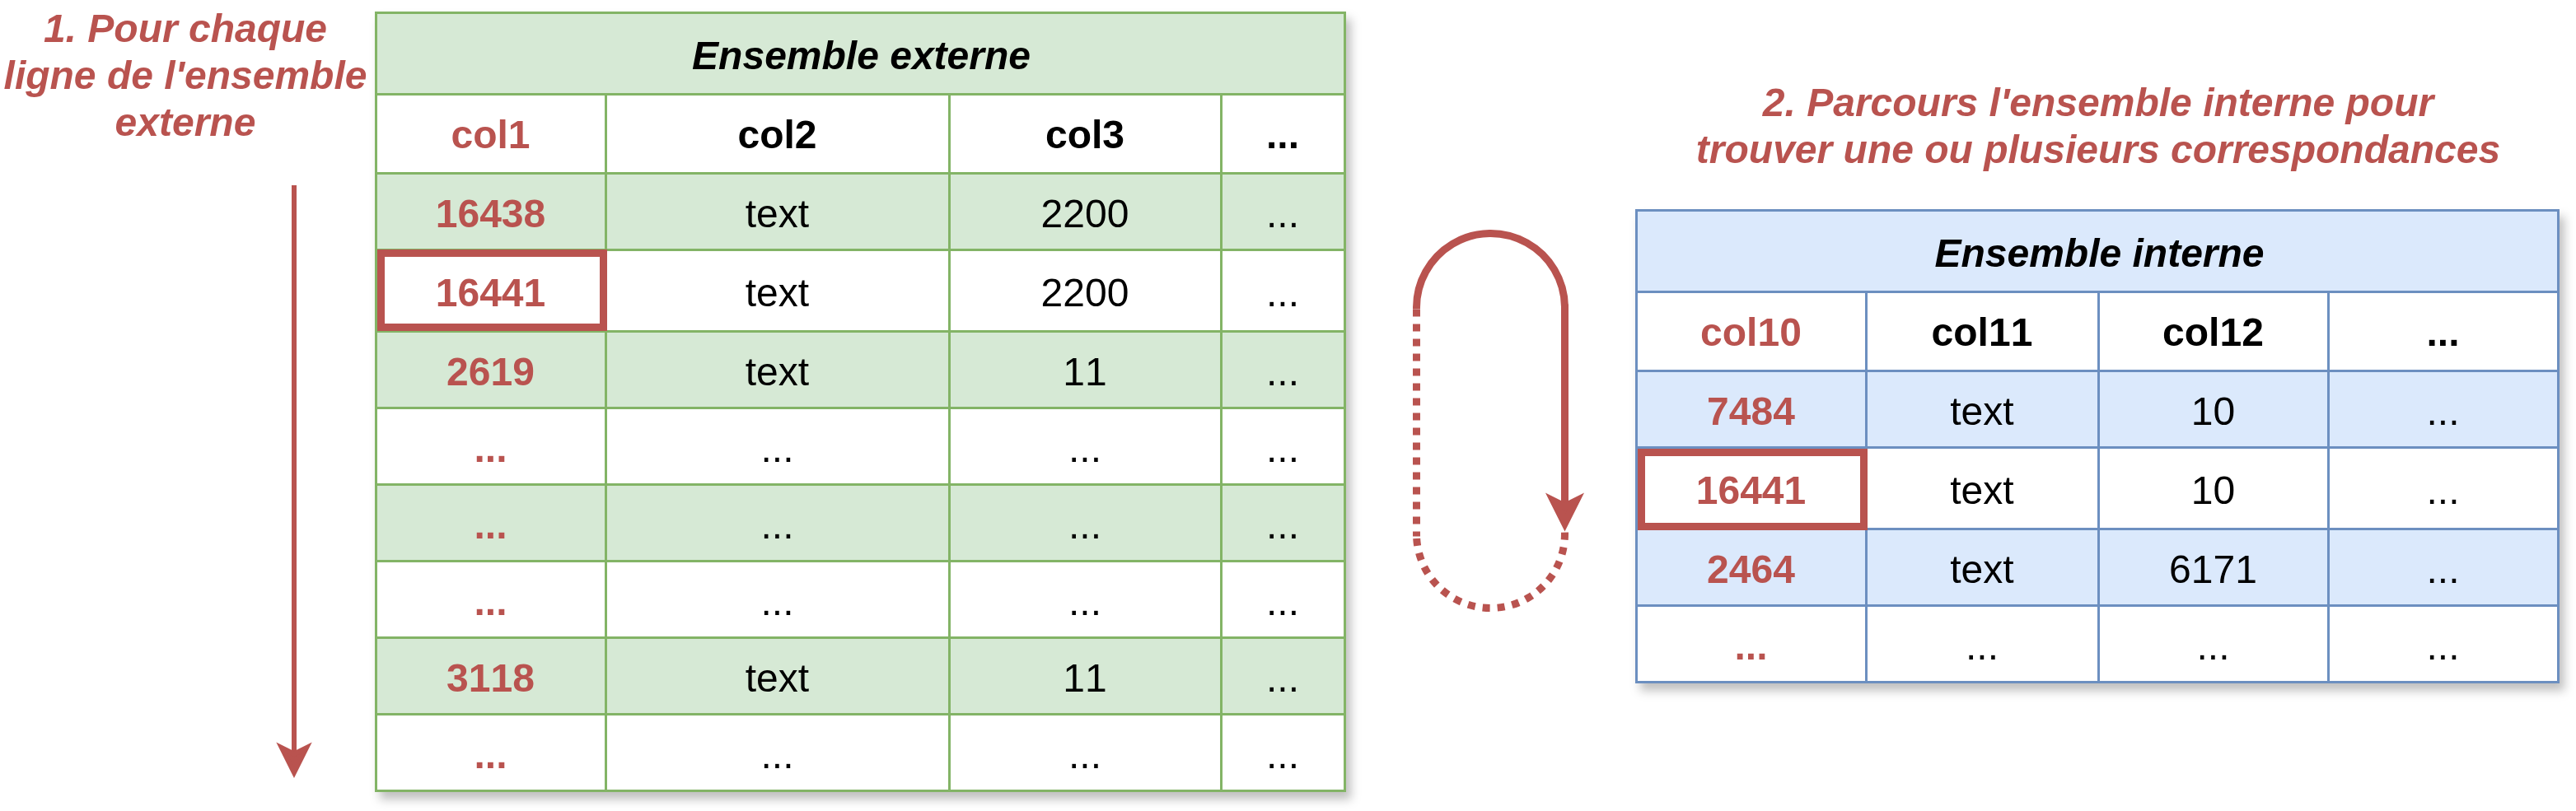
Le but d’une jointure est de grouper deux ensembles de données pour n’en produire qu’un seul. Une jointure se fait toujours entre deux ensembles de données, jamais plus. Dans le cas le plus simple, elle joint deux ensembles issus de parcours de table, d’index… mais aussi des ensembles issus euxmêmes de jointures, agrégats, etc.
L’un des ensembles est appelé ensemble interne (inner set), l’autre est appelé ensemble externe (outer set).
Le planificateur de PostgreSQL est capable de traiter les jointures grâce à trois nœuds:
- Nested Loop, une boucle imbriquée ;
- Merge Join, un parcours des deux ensembles triés ;
- Hash Join, une jointure par tests des données hachées.
Ils possèdent des variantes, notamment leurs versions parallélisées.
6.3.1 Nested Loops
6.3.2 Nested Loops : principe
« Boucles imbriquées »
- Ensemble externe parcouru une fois
- Pour chaque ligne :
- chercher les lignes dans la relation interne selon la condition de jointure
- émettre ces lignes en résultat
Les boucles imbriquées, ou nested loops, sont la manière la plus simple d’opérer une jointure entre deux ensembles issus de parcours de tables, de parcours d’index, ou de n’importe quels autres nœuds. Un des deux ensembles, souvent le plus gros, est pris comme « relation externe », Il est parcouru une seule fois. Pour chacune de ses lignes, PostgreSQL recherche les lignes correspondantes à la condition de jointure dans l’autre ensemble. Cela peut être rapide (toute petite table, index pertinent…), ou très lent (parcours complet de la table sans index utilisable). Le paramètre enable_nestloop permet d’activer ou de désactiver ce type de nœud à titre expérimental. Prenons un exemple avec trois tables, dont une table de commandes, pointant vers des clients et une toute petite table de statuts de commandes. Il n’y a pas d’index, à part ceux automatiquement ajoutés sur les clés primaires des trois tables.
(1,’en cours’), (2,‘archivé’);
Exemple 1:
Cette première requête sélectionne une partie des commandes, puis opère une jointure pour obtenir le statut: EXPLAIN (ANALYZE, BUFFERS off) SELECT cid, montant, statut
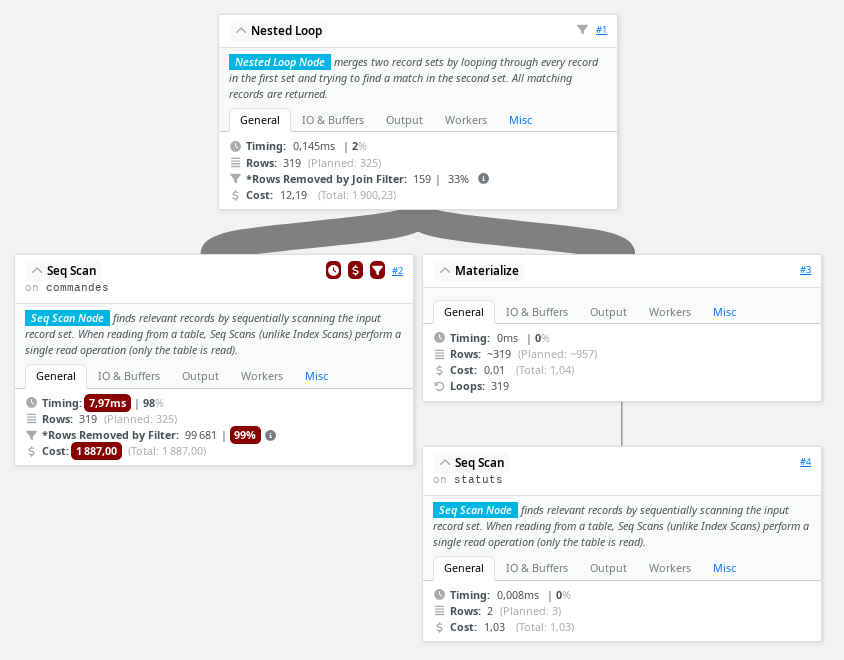
La vision graphique 17 est la suivante:
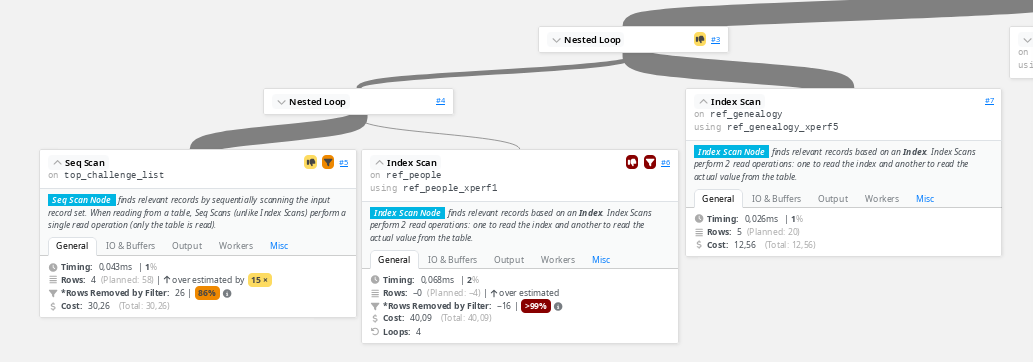
Le Seq Scan sur commandes parcourt la table une fois et trouve 319 lignes. La jointure Nested Loops prend ce résultat comme ensemble externe et appelle donc 319 fois l’ensemble interne ( loops=319 ), ramenant une ligne en moyenne à chaque fois. L’ensemble interne n’est pas directement la petite table statuts, mais une version en mémoire préalablement obtenue avec un nœud Materialize. Exemple 2: Pour les commandes de client d’identifiant 1, afficher les informations sur les clients: 17 https://explain.dalibo.com/plan/92799g98c728f5ec
EXPLAIN (ANALYZE, BUFFERS off) SELECT *
Noter que le filtre clid = 1 porte sur la condition de jointure, donc PostgreSQL peut l’appliquer aux deux Seq Scan. L’ensemble externe porte sur clients, et chaque ligne trouvée est cherchée dans commandes. C’est à première vue un peu étonnant, on s’attendrait à avoir la plus grosse table en table externe. Cependant, PostgreSQL a correctement estimé qu’il ne ramène qu’une ligne de clients, et la table commandes n’est donc parcourue qu’une fois ( loops=1 ). Dans ce cas précis, commencer par l’une ou l’autre table est jugé équivalent par PostgreSQL. Exemple 3: Il est généralement conseillé d’indexer les clés étrangères, on ajoute donc:
La requête suivante récupère les commandes d’un client identifié par son nom: EXPLAIN (ANALYZE, BUFFERS off) SELECT *
La vision graphique est sur explain.dalibo.com 18. L’ensemble externe provient de clients, après récupération d’une seule ligne. L’ensemble interne est la table commandes. Pour y trouver les lignes avec le clid nécessaire, PostgreSQL utilise un Bitmap Scan sur l’index sur clid, qu’il estime plus efficace que 1011 appels dans le même index.
6.3.3 Nested Loops : performances
- Coût proportionnel à la taille des ensembles
- Intérêts
- démarrage rapide
- pas besoin de mémoire
- marche toujours
- Inadapté à :
- grands nombre de lignes
- Index chaudement conseillé
Le coût d’un nœud Nested Loop est proportionnel à la taille des ensembles. Il est donc intéressant pour les petits ensembles, et encore plus lorsque l’ensemble interne dispose d’un index satisfaisant la condition de jointure.
En théorie, il s’agit du type de jointure le plus lent. Mais il a un gros intérêt: il n’est pas nécessaire de trier les données (comme pour un Merge Join) ou de les hacher (comme pour un Hash Join) avant de commencer à traiter les données. Le coût de démarrage est donc très faible. Il est ainsi favorisé pour un petit ensemble externe, ou une clause LIMIT. Dès que le nombre de lignes augmente, PostgreSQL bascule sur d’autres types de nœuds.
Nested Loop est aussi le seul nœud capable de traiter des jointures sur des conditions différentes de l’égalité ainsi que des jointures de type CROSS JOIN.
18 https://explain.dalibo.com/plan/h44h40ee4959fad3
6.3.4 Merge Join
6.3.5 Merge Join : principe
Jointure d’ensembles triés
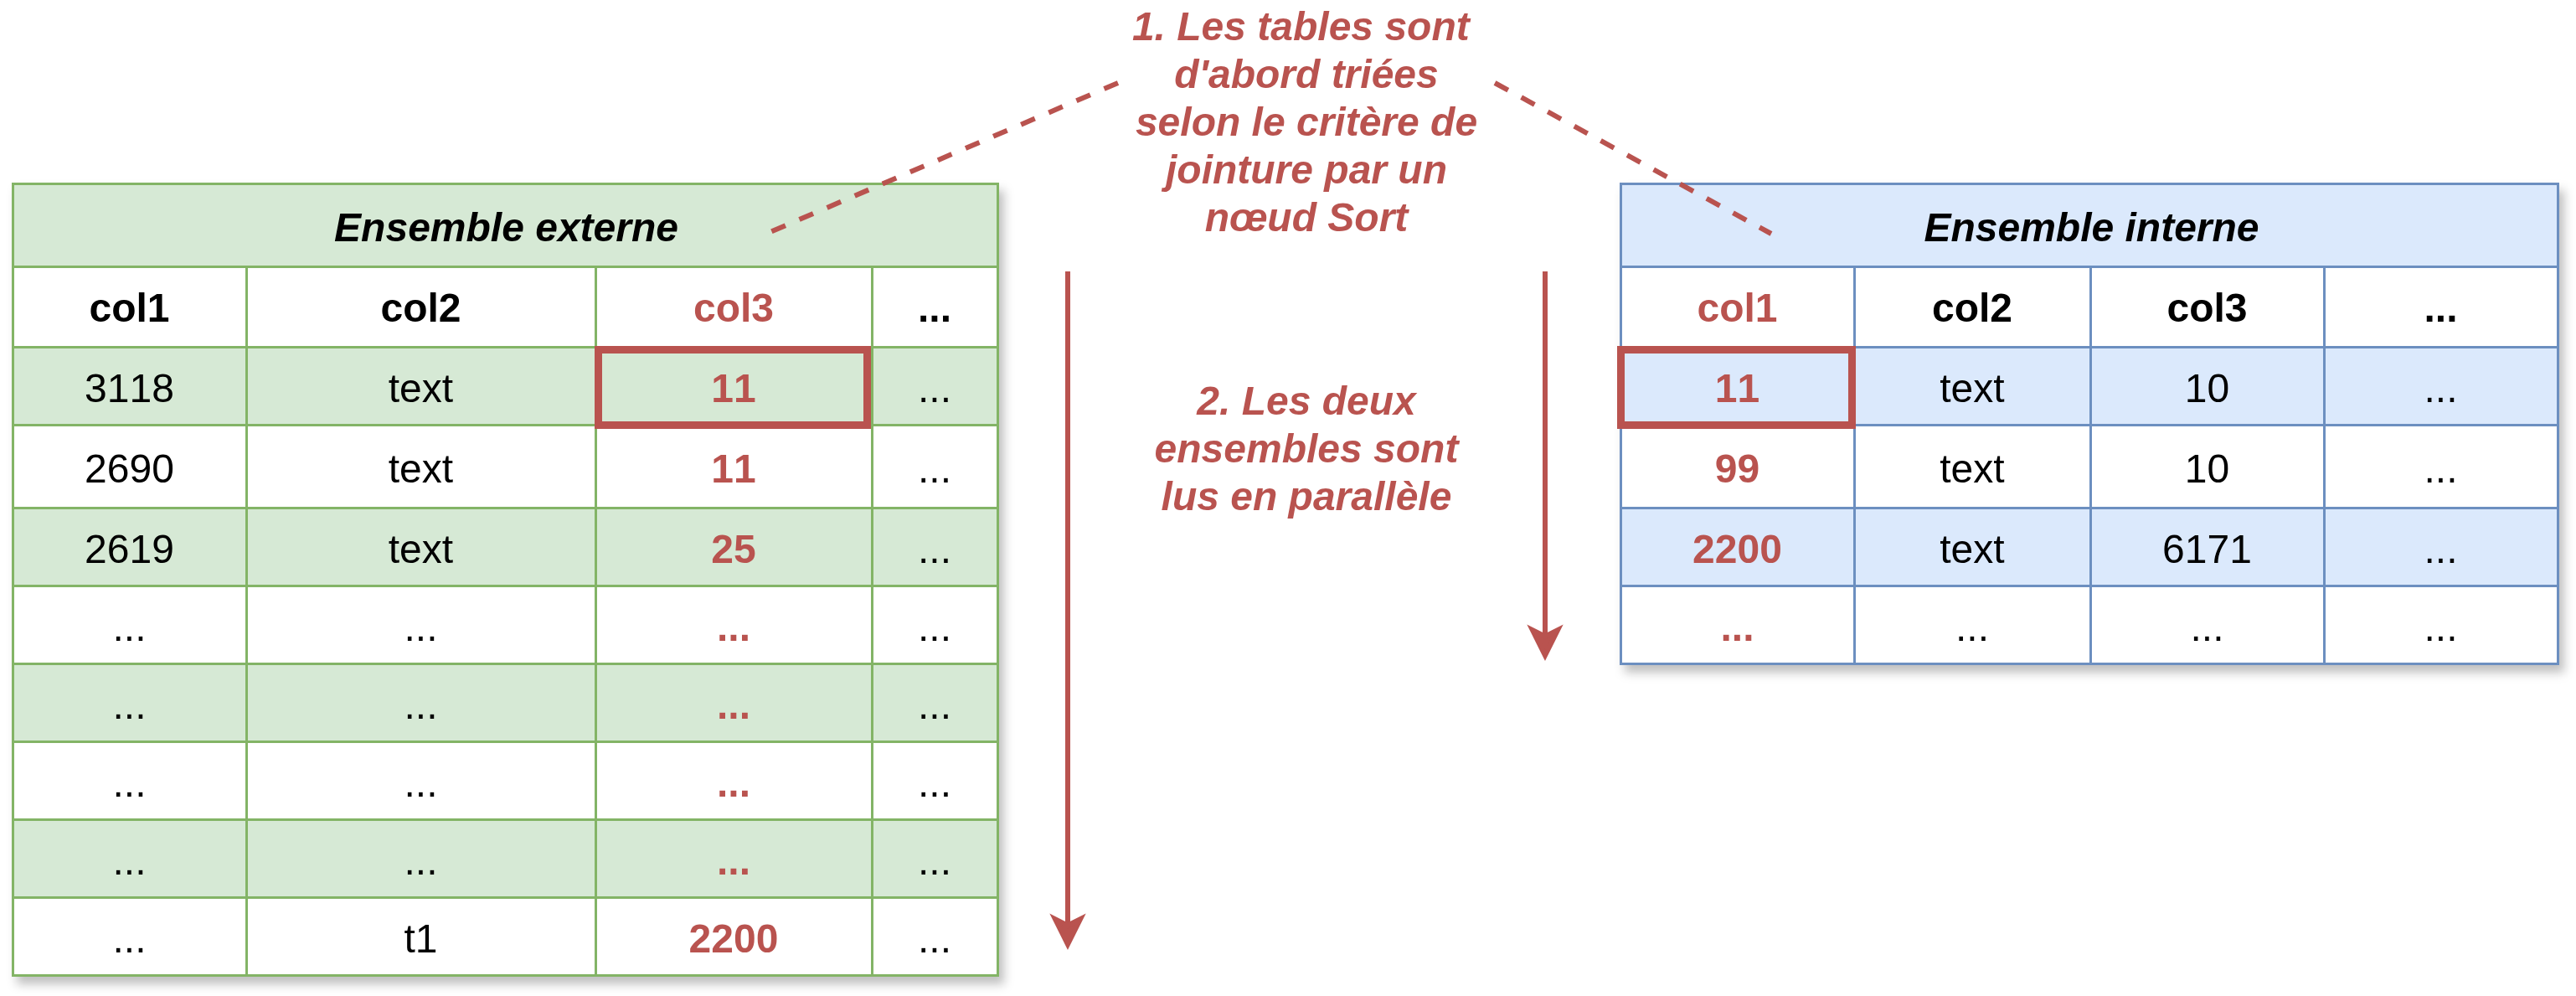
- Trier l’ensemble interne
- Trier l’ensemble externe
- Tant qu’il reste des lignes dans un des ensembles
- lire les deux ensembles en parallèle
- si condition de jointure émettre la ligne
L’algorithme est assez simple. Le prérequis est que les deux ensembles de données doivent être triés. Ils sont parcourus ensemble. Lorsque la condition de jointure est vraie, la ligne résultante est envoyée dans l’ensemble de données en sortie. Voici un exemple basé sur une jointure entre une table des billets et une table des commentaires d’une plate-forme de blog.
SELECT i, ‘2010-01-01’::date + i*interval ‘1h’, lpad(’lorem ipsum’,4000,‘x’)
SELECT i, 1+i/3, ‘2010-01-01’::date + (i/3)*interval ‘1h’, lpad(’lorem ipsum’,300,‘x’)
– Index sur clé étrangère
EXPLAIN (ANALYZE) SELECT *
ORDER BY bid;
Comme la clé primaire et la clé étrangère sont indexées, il n’y a rien à trier, le temps de démarrage est ici très rapide. L’ ORDER BY encourage l’usage du Merge Join. (Sans cela, comme la volumétrie reste modeste, PostgreSQL a souvent tendance à préférer un Hash Join.) Le paramètre enable_mergejoin permet d’ activer ou de désactiver ce type de nœud.
6.3.6 Merge Join : performances
- Intérêt
- le plus rapide sur une grosse volumétrie
- pas de besoin de mémoire (si tri déjà fait…)
- Limites
- uniquement les égalités
- besoin de données triées (Sort ou index)
- Produit un résultat trié
Contrairement au Nested Loop, le Merge Join ne lit qu’une fois chaque ligne. Il n’a pas besoin de mémoire et peut démarrer rapidement une fois les données triées. Sur de gros volumes, il est optimal. Les données étant triées en entrées, elles reviennent triées. Cela peut avoir son avantage dans certains cas, comme l’économie d’un tri pour un ORDER BY.
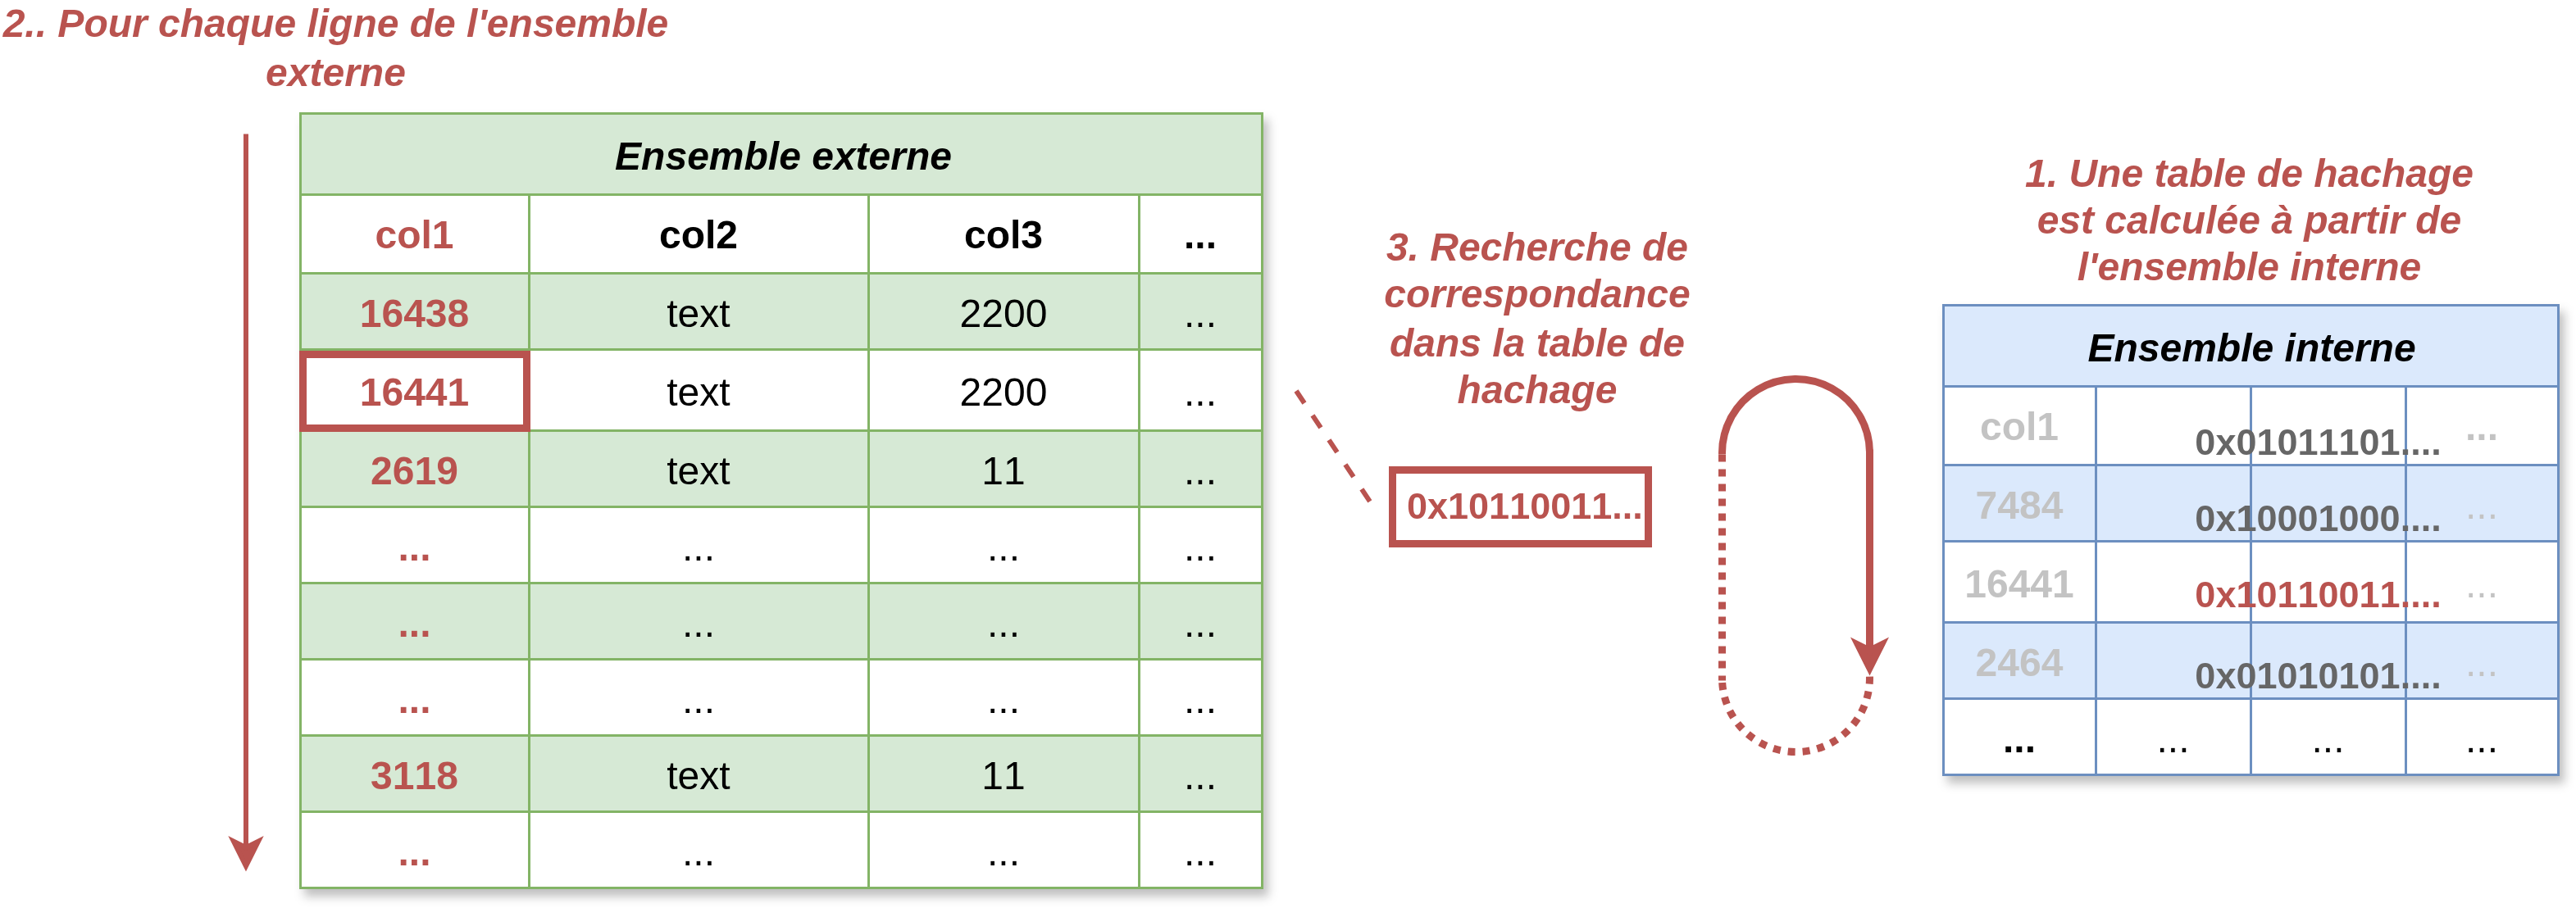
Son gros inconvénient est justement que les données en entrée doivent être triées. PostgreSQL peut alors décider de précéder le Merge Join d’un nœud de tri Sort. Or, trier beaucoup de données est coûteux et peut prendre du temps, consommer de la RAM ou du disque. Le coût de démarrage peut devenir alors rédhibitoire pour des requêtes avec un LIMIT par exemple. L’idéal est que le Merge Join s’appuie sur un index pour accélérer l’opération de tri (on verra alors forcément un Index Scan). Un autre inconvénient est que le Merge Join ne fonctionne que pour des conditions d’égalité, ce qui représente tout de même l’essentiel des clés de jointures.
6.3.7 Hash Join
6.3.8 Hash Join : principe
Jointure par hachage
- Hacher les lignes de l’ensemble interne
- Pour chaque ligne de l’ensemble externe
- hacher la ligne lue
- comparer ce hachage aux lignes hachées de l’ensemble interne
- si correspondance : émettre la ligne
À partir d’une certaine volumétrie, les Nested Loops et les Index Scan peuvent devenir trop lents. Le Hash Join cherche à supprimer ce problème en créant une table de hachage de la table interne, à priori la plus petite. Sa première étape est le hachage de chaque clé de jointure de la table interne, ce qui consomme du CPU, puis le stockage de cette table de hachage, ce qui consomme de la mémoire, voire du disque. Ensuite, en simplifiant, le nœud Hash Join parcourt la table externe, hache chaque clé de jointure l’une après l’autre et va trouver le ou les enregistrements de la table interne correspondant à la valeur hachée. PostgreSQL vérifie enfin d’éventuels prédicats supplémentaires à vérifier.
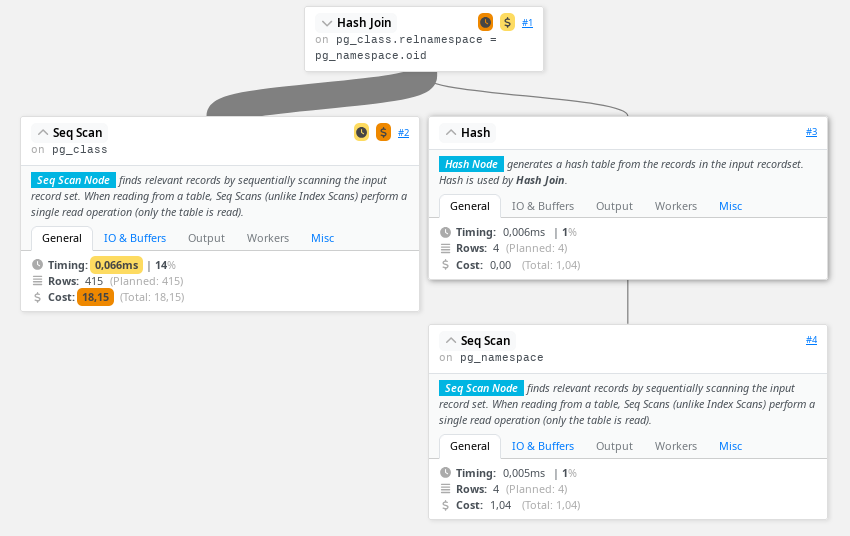
Voici un exemple de Hash Join sur des tables système d’une base de données vide de toute donnée utilisateur:
Graphiquement, cela donne ceci 19:
19 https://explain.dalibo.com/plan/d5g8652b89825c76
La table pg_namespace (la plus petite des deux) est parcourue et hachée, ce qui occupe 9 ko. Puis la table pg_class est parcourue, et le hachage de chacune de ses lignes est comparé au contenu de la table interne hachée. Le paramètre enable_hashjoin permet d’ activer ou de désactiver ce type de nœud.
6.3.9 Hash Join : performances
- Avantages :
- idéal pour joindre une grande table à une petite
- Limites :
- uniquement conditions avec égalité
- coût de démarrage important
- mémoire, volumétrie!
- sensible aux mauvaises estimations
- Paramétrage mémoire :
- work_mem × hash_mem_multiplier
- Parallélisable
Ce type de nœud est très rapide à condition d’avoir suffisamment de mémoire pour stocker le résultat du hachage de l’ensemble interne. Si une des tables est relativement petite, ce hash tient en mémoire, c’est optimal. Il y a cependant plusieurs limites. D’abord, le coût de démarrage peut se révéler important à cause du hachage de la table interne. Ce nœud a des chances de ne pas être utilisé s’il y a une clause LIMIT après la jointure.
Un Hash Join consomme CPU et mémoire pour créer la table de hachage. Au-delà il peut utiliser des fichiers temporaires sur disque, ce qui ralentit la jointure. Le paramétrage de la mémoire utilisable est donc primordial:
- work_mem est le premier paramètre qui limite cette mémoire, et le défaut est généralement augmenté;
- hash_mem_multiplier est un facteur multiplicateur de work_mem pour les nœuds utilisant un hachage, par défaut 2 depuis PostgreSQL 15 (1 avant), qui permet de ne pas gonfler work_mem de manière plus générale.
Ces deux paramètres peuvent bien sûr être modifiés dans une session ou une transaction. Pour réduire la mémoire de hachage, il est conseillé de diminuer le nombre de colonnes récupérées. C’est une raison supplémentaire d’éviter les SELECT * aveugles.
Si la mémoire est insuffisante et qu’il faut utiliser des fichiers temporaires, l’algorithme travaille par groupe de lignes (batch). Cette version améliorée de l’algorithme partitionne la table interne. Pour
des détails, voir la page Wikipédia de l’algorithme Grace hash join 20 et celle de la variante qu’utilise PostgreSQL, l’Hybrid hash Join 21.
Un Hash Join peut être très lent si l’estimation de la taille des ensembles est mauvaise (ensemble interne beaucoup plus gros que prévu, notamment). De plus, avant PostgreSQL 14, un autre bug était lié à ces mauvaises estimations: la mémoire réellement consommée n’était pas limitée, work_mem ne jouant qu’à la planification, ce qui pouvait aller jusqu’à la saturation mémoire.
Le hachage de l’ensemble interne d’un Hash Join peut être parallélisé. Accessoirement, les données retournées par un Hash Join ne sont pas triées. Exemple: Deux classiques tables d’entête et de détails, de 0,9 et 1,5 Go, sont jointes entre elles:
Le plan précédent 22 montre un Hash Join, où la table des entêtes, la plus petite, est la table interne. 643 Mo de fichiers temporaires ( temp written=82241 ) sont utilisés. L’algorithme a utilisé 8 batchs consommant chacun 122 Mo de mémoire (ligne Buckets ), soit moins que la limite work_mem × hash_mem_multiplier (2 × 100 Mo). Cette dernière information donne aussi une idée approximative de la mémoire nécessaire qui serait utile pour tout stocker en mémoire (8×122 Mo, presque 1 Go). Avec un work_mem × hash_mem_multiplier moitié plus bas, on aurait 16 batchs moitié plus petits 23, chacun ne consommant que 61 Mo environ. Si le serveur a assez de mémoire à ce moment, on peut augmenter la mémoire autorisée un peu audelà de 1 Go. Ce peut être ainsi:
ou ainsi:
La différence peut être importante si le paramétrage n’est pas limité à la session. Le hash peut alors s’effectuer complètement en RAM en un seul batch, et est un peu plus rapide: 22 https://explain.dalibo.com/plan/gb3h15dc20g35d76 23 https://explain.dalibo.com/plan/9376bd15aad7bb29#raw
I/O Timings: shared read=114.738
Avec moins de champs, la consommation mémoire peut grandement se réduire: EXPLAIN (ANALYZE,BUFFERS) SELECT b
…
6.4 OPÉRATIONS ENSEMBLISTES
- Entrée : un ou plusieurs ensembles de données
- Sortie : un ensemble de données
- Souvent des requêtes sur des tables partitionnées ou héritées
- Exemples typiques
- Append et MergeAppend
- Intersect
- Except
Ce type de nœuds prend un ou plusieurs ensembles de données en entrée et renvoie un seul ensemble de données. Cela concerne surtout les requêtes visant des tables partitionnées ou héritées.
6.4.1 Append
- Entrée :
- plusieurs ensembles de données
- Sortie :
- non triée, non dédupliquée
- Utilisation :
- partitionnement, tables héritées
- UNION ALL et des UNION
- NB : UNION sans ALL élimine les doublons (lourd!)
- Parallélisable
Un nœud Append a pour but de concaténer plusieurs ensembles de données pour n’en faire qu’un, non trié. Ce type de nœud est utilisé dans les requêtes concaténant explicitement des tables (clause UNION ) ou implicitement (requêtes sur une table mère d’un héritage ou une table partitionnée).
Dans une base de données créée avec pgbench -i -s 10 –partitions=10, la table pgbench_accounts est partitionnée (voir au besoin le module V0 - Partitionnement déclaratif (introduction) 24 ) Accéder à cette table donne ce plan:
————————————— Append -> Seq Scan on pgbench_accounts_1 -> Seq Scan on pgbench_accounts_2 24 https://dali.bo/v0_html
-> Seq Scan on pgbench_accounts_3 -> Seq Scan on pgbench_accounts_4 -> Seq Scan on pgbench_accounts_5 -> Seq Scan on pgbench_accounts_6 -> Seq Scan on pgbench_accounts_7 -> Seq Scan on pgbench_accounts_8 -> Seq Scan on pgbench_accounts_9 -> Seq Scan on pgbench_accounts_10
Les nœuds sont exécutés les uns après les autres, et les résultats renvoyés les uns à la suite des autres, sans tri ni déduplication. Les nœuds ne sont pas forcément identiques. Dans la requête suivante qui utilise UNION ALL, le planificateur récupère des valeurs de deux tables, dont la deuxième est partitionnée. Pour celle-ci il utilise un autre noeud Append, qui se limite aux deux partitions utiles pour la requête, avec un nœud différent sur chacune: EXPLAIN (COSTS OFF)
UNION ALL
——————————————————- Append -> Seq Scan on pgbench_branches -> Seq Scan on pgbench_accounts_1 pgbench_accounts Filter: (aid < 100000)
UNION ALL récupère toutes les lignes des deux ensembles de données, même en cas de doublon. Pour n’avoir que des lignes distinctes, il est possible d’utiliser UNION sans la clause ALL mais cela entraîne une déduplication des données, ce qui est souvent coûteux: EXPLAIN (COSTS OFF)
UNION
L’utilisation involontaire de UNION au lieu de UNION ALL est un problème de performance très fréquent!
Les nœuds enfants d’un nœud Append sont parallélisables.
Paramètres dans le cas des tables partitionnées ou héritées: Le paramètre enable_partition_pruning permet d’activer l’élagage des partitions. Il peut prendre deux valeurs on (le défaut) ou off. Avec le partitionnement par héritage (qui n’est plus guère utilisé, voir le chapitre de formation ici 25 ), le paramètre constraint_exclusion permet d’éviter de parcourir les tables filles qui ne peuvent pas accueillir les données qui nous intéressent.
6.4.2 MergeAppend
- Append avec optimisation du tri
- Sortie triée
- Utilisation :
- UNION ALL , partitionnement/héritage
- avec parcours triés
- idéal avec LIMIT
Le nœud MergeAppend est une optimisation de Append apparue avec PostgreSQL 9.1, spécifiquement conçue pour le partitionnement. Elle optimise les requêtes effectuant un tri sur un UNION ALL, soit explicite, soit induit par partitionnement ou héritage. Considérons la requête suivante qui concatène deux champs dans deux tables et trie sur un champ indexé:
– Les dates des deux table sont entremêlées
SELECT ‘2020-01-01’::timestamptz + i*interval ‘6min’, random()
SELECT ‘2020-01-01’::timestamptz + i*interval ‘10min’, random()
EXPLAIN (COSTS OFF)
UNION ALL
ORDER BY d;
———————————————– 25 https://dali.bo/v1_html#partitionnement-par-h%C3%A9ritage
Merge Append Sort Key: liste1.d -> Index Scan using liste1_d_idx on liste1 -> Index Scan using liste2_d_idx on liste2
Il n’y a aucun tri, PostgreSQL déroule les deux index en parallèle bien que les dates soient entremêlées. Pour voir d’où provient chaque ligne, utiliser le champ système tableoid:
ORDER BY d LIMIT 5;
| tableoid | d | v |
|---|---|---|
| liste1 | 2020-01-01 00:06:00+01 | 0.3217132313176123 |
| liste2 | 2020-01-01 00:10:00+01 | 0.4255801913539963 |
| liste1 | 2020-01-01 00:12:00+01 | 0.29396898755013123 |
| liste1 | 2020-01-01 00:18:00+01 | 0.3339045666755862 |
| liste2 | 2020-01-01 00:20:00+01 | 0.1439201886655812 |
MergeAppend est encore plus intéressant avec une clause LIMIT.
Évidemment, sans les index, on aurait un Merge suivi d’un Sort global.
6.4.3 Nœuds ensemblistes
- Nœud HashSetOp Except
- EXCEPT et EXCEPT ALL
- Nœud HashSetOp Intersect
- INTERSECT et INTERSECT ALL
La clause UNION permet de concaténer deux ensembles de données. À l’inverse, les clauses EXCEPT et INTERSECT permettent de supprimer une partie de deux ensembles de données.
Voici un exemple basé sur EXCEPT, pour trouver les espaces de noms (schémas) non utilisés par des relations:
EXCEPT
HashSetOp Except (cost=0.00..30.29 rows=31 width=8) -> Append (cost=0.00..28.90 rows=556 width=8) -> Subquery Scan on “SELECT 1” (cost=0.00..1.62 rows=31 width=8)
-> Seq Scan on pg_namespace (cost=0.00..1.31 rows=31 width=4) -> Subquery Scan on “SELECT 2” (cost=0.00..24.50 rows=525 width=8) -> Seq Scan on pg_class (cost=0.00..19.25 rows=525 width=4)
Le résultat peut donner par exemple ceci, suivant l’historique de la base: oid —————— pg_toast_temp_40 pg_temp_47 pg_toast_temp_43 pg_toast_temp_5 …
Avec INTERSECT, on peut trouver les schémas utilisés dans les deux tables:
INTERSECT
——————————————– HashSetOp Intersect -> Append -> Subquery Scan on “SELECT 2” -> Seq Scan on pg_class -> Subquery Scan on “SELECT 1” -> Seq Scan on pg_namespace
Et vous obtiendrez au moins ceci: oid ——————– pg_toast public information_schema pg_catalog
Comme pour UNION, préférer les variantes EXCEPT ALL et INTERSECT ALL si des doublons dans le résultat ne sont pas gênants ou s’ils sont logiquement impossibles.
6.5 TRIS
- Entrée :
- un ensemble de données
- Renvoie :
- un ensemble trié
- Nœuds
- Sort,
- Incremental Sort
6.5.1 Sort
- Utilisé pour le ORDER BY
- mais aussi DISTINCT , GROUP BY , UNION
- souvent avant une jointure Merge Join
- Gros délai de démarrage
- Plusieurs méthodes :
- quicksort (en mémoire)
- top-N heapsort (en mémoire, si LIMIT )
- external merge (sur disque)
Le nœud Sort peut servir aux ORDER BY, mais aussi à d’autres nœuds, parfois en préalable à leur exécution, comme des GROUP BY des DISTINCT, ou des jointures Merge Join…
PostgreSQL peut faire un tri de plusieurs façons. Le choix dépend principalement de work_mem. S’il faut tout trier et qu’il calcule que la quantité de mémoire sera inférieure à ce que le paramètre work_mem indique, alors il trie en mémoire (quicksort). S’il ne faut pas tout trier car il y a un LIMIT, et que la mémoire suffit toujours, top N-heapsort sera utilisé, toujours en mémoire. Si PostgreSQL estime que work_mem est insuffisant, il procède à un tri sur disque (merge disk), ce qui est généralement beaucoup plus lent. Voici quelques exemples dans une base pgbench de taille 100: Tri en mémoire: EXPLAIN (ANALYZE)
ORDER BY bbalance;
——————————————————————————- Sort (cost=5.32..5.57 rows=100 width=8) (actual time=0.024..0.028 rows=100 loops=1) Sort Key: bbalance
Il n’y a ici que 100 petites lignes à trier, 27 ko en RAM ont suffit. Tri en mémoire avec LIMIT: On bascule sur un nœud top N heapsort un peu moins consommateur:
EXPLAIN (ANALYZE)
ORDER BY bbalance LIMIT 3;
Tri sur disque:
Cette fois, trier 10 millions de lignes n’a pas tenu dans le petit work_mem, PostgreSQL a créé un fichier temporaire de 176 Mo sur le disque. Noter que le nœud Sort peut se paralléliser (ici sur 5 processus), le gain de temps est appréciable:
EXPLAIN (ANALYZE)
Tri sur disque évité grâce à une clause LIMIT: Un LIMIT 5 à la requête précédente refait basculer vers un top-N heapsort en RAM, car il n’y a pas besoin de beaucoup de RAM pour garder en mémoire les 5 premières pendant que la table est lue: EXPLAIN (ANALYZE,BUFFERS) SELECT aid
ORDER BY abalance LIMIT 5;
Par contre, une valeur excessive de LIMIT, ou une clause OFFSET élevée fera rebasculer le plan vers un tri sur disque.
Tri par index: Le tri le plus rapide est celui qu’on ne fait pas. Si un index existe sur les champs concernés (dans le bon ordre), le travail est déjà fait, et PostgreSQL sait utiliser cet index. Au lieu du Sort, apparaît alors un Index Scan, (voire un Index Only Scan dans le cas les plus favorable):
EXPLAIN (ANALYZE)
ORDER BY aid;
Si une requête doit renvoyer de nombreuses lignes triées, peut-être vaut-il la peine de rajouter un index pour accélérer ce tri.
Paramètres: À titre expérimental, le paramètre enable_sort sert à décourager fortement l’utilisation d’un tri. Dans ce cas, le planificateur tend encore plus à utiliser un index, qui retourne les données déjà triées, même si cela implique de passer par un nœud moins optimal par ailleurs. Augmenter la valeur du paramètre work_mem aura l’effet inverse: favoriser un tri plutôt que l’utilisation d’un index.
6.5.2 Incremental Sort
- Pour tri multicolonnes,
- déjà partiellement triées
- Idéal quand un index existe sur les premières colonnes du tri
- ORDER BY , GROUP BY , UNION
- DISTINCT (v16)
- jointures de type Merge Join
- Délai de démarrage réduit
- Moins de mémoire
Lorsqu’un tri est réalisé sur plusieurs champs, et que la ou les premiers champs sont déjà triées (par un index ou un autre nœud), PostgreSQL évite de faire un tri complet et ne trie que les derniers, ce qui peut notablement accélérer et réduire la consommation mémoire. CREATE TABLE demo_is (i int PRIMARY KEY, j int, k int, filler char(40) default ’ ‘);
Ce tri utilise l’index existant sur j pour un Incremental Sort, avec une consommation mémoire maximale de 27 ko: EXPLAIN (ANALYZE) SELECT *
ORDER BY j,k;
Si l’on inverse les champs à trier, PostgreSQL repère que k possède très peu de valeurs différentes et est dispersé dans la table, et donc que trier sur j sera lourd. Il revient alors au classique Sort sur toute la table.
Le tri se fait sur disque, monter work_mem pourrait se révéler utile. PostgreSQL ne sait malheureusement pas repérer qu’un tri supplémentaire est inutile quand le premier champ est unique (ici la clé primaire):
Le DISTINCT utilise parfois un tri pour dédupliquer, et il peut profiter de l’Incremental Sort depuis PostgreSQL 16:
Passer le paramètre enable_incremental_sort à off permet de décourager fortement le tri incrémental, auquel cas il sera sans doute remplacé par un tri classique.
6.6 AGRÉGATS
- Entrée :
- un ensemble de données
- Renvoie :
- un ensemble trié
- Nœuds
- Aggregate
- HashAggregate
- GroupAggregate
- MixedAggregate
6.6.1 Aggregate
- Pour un seul résultat
- SELECT max(…), count(*), sum(…)…
- plusieurs agrégats au besoin
- Penser aux index pour accélérer
- count(*)
- max/min
Il existe plusieurs façons de réaliser un agrégat:
- l’agrégat standard;
- l’agrégat par tri des données ;
- et l’agrégat par hachage.
Les deux derniers sont utilisés quand la clause SELECT contient des colonnes en plus de la fonction d’agrégat. Les exemples suivants utilisent une base pgbench. Pour un seul résultat COUNT(*), nous aurons ce plan d’exécution:
———————————————————————— Aggregate (cost=2.25..2.26 rows=1 width=8) -> Seq Scan on pgbench_branches (cost=0.00..2.00 rows=100 width=0)
La table est toute petite, donc PostgreSQL a considéré que le plus simple était de la parcourir entièrement.
Souvent le nœud Aggregate se reposera sur l’index de la clé primaire, généralement beaucoup plus petit, et il peut même utiliser un Index Only Scan dans le cas d’un simple count(*).
L’Aggregate se parallélise, ici toujours pour parcourir un index: RESET max_parallel_workers_per_gather;
EXPLAIN (COSTS OFF)
Pour une somme, l’utilisation d’un index est en principe possible de la même manière, mais on indexe plus rarement des indicateurs qui servent aux sommes, et un Seq Scan ou Parallel Seq Scan sera plus fréquent: EXPLAIN (COSTS OFF)
——————————————————— Finalize Aggregate -> Gather Workers Planned: 2 -> Partial Aggregate -> Parallel Seq Scan on pgbench_accounts
Il faut savoir que plusieurs agrégats peuvent être calculés dans un seul nœud Aggregate: EXPLAIN (COSTS OFF) SELECT sum(abalance), max(abalance), min(abalance)
——————————————————— Finalize Aggregate -> Gather Workers Planned: 2 -> Partial Aggregate -> Parallel Seq Scan on pgbench_accounts
Pour les max et les min, il est également possible de passer par un index existant. Comme il est trié, il suffit d’aller chercher ses valeurs extrêmes, ce qui est très rapide. Si, là encore, un indicateur est rarement indexé, c’est assez fréquent pour des dates d’événements. Le plan suivant récupère les deux extrémités de la clé primaire par son index: EXPLAIN (ANALYZE,COSTS OFF,BUFFERS) SELECT min(aid), max(aid)
———————————————————————- Result (actual time=0.101..0.104 rows=1 loops=1)
InitPlan 1 -> Limit (actual time=0.074..0.076 rows=1 loops=1)
InitPlan 2 -> Limit (actual time=0.017..0.017 rows=1 loops=1)
Enfin, un décompte de valeurs distinctes est notoirement beaucoup plus lourd. Il implique souvent un tri: EXPLAIN (ANALYZE,COSTS OFF,BUFFERS)
-> Sort (actual time=117.658..160.773 rows=1000000 loops=1) Sort Key: bid Sort Method: external merge Disk: 11768kB
Planning:
Là encore, un index peut accélérer le plan, car il contient toutes les valeurs triées, il suffit de parcourir l’index intégralement et de compter:
EXPLAIN (ANALYZE)
6.6.2 HashAggregate
- Hachage de chaque n-uplet de regroupement
- Accès direct à chaque n-uplet pour appliquer la fonction d’agrégat
- Typiquement : GROUP BY
- Mémoire :
- work_mem × hash_mem_multiplier
Le HashAggregate apparaît quand le regroupement se fait avec d’autres champs, donc en premier lieu avec un GROUP BY:
EXPLAIN (ANALYZE) SELECT bid, sum(abalance)
GROUP BY bid;
Le hachage occupe de la place en mémoire. Le plan n’est choisi que si PostgreSQL estime que si la table de hachage générée tient dans la mémoire autorisée, c’est-à-dire work_mem × hash_mem_multiplier, comme pour les Hash Join (voir cette partie plus haut pour ce paramètres). En cas de souci d’estimation, au pire, PostgreSQL écrit sur disque. Par exemple, une erreur d’estimation a lieu à cause d’un regroupement sur un champ calculé, notoirement impossible à estimer:
EXPLAIN (ANALYZE,BUFFERS)
GROUP BY aid/100;
I/O Timings: shared read=2.706
Ici, elle est dans le bon sens (moins de lignes que prévu). Si l’on veut améliorer ces statistiques, et que le critère de regroupement est assez simple (plus exactement une fonction immutable) il y a deux moyens:
- créer un index sur sa valeur, qui ne sera vraiment utile que pour ses statistiques :
- ou créer un objet statistique, qui par expérience est moins précis :
On retrouve alors une bonne estimation (ici avec l’index), qui ne change cependant pas le plan:
SELECT aid/100, sum(abalance)
GROUP BY aid/100;
——————————————————————————– HashAggregate (cost=33894.00..34019.05 rows=10004 width=12) Group Key: (aid / 100) -> Seq Scan on pgbench_accounts (cost=0.00..28894.00 rows=1000000 width=8)
Le HashAggregate peut se retrouver aussi avec des clauses de regroupement avancé comme les GROUPING SETS:
EXPLAIN (COSTS OFF) SELECT piece,region,sum(quantite)
GROUP BY GROUPING SETS (piece,region);
————————- HashAggregate
Hash Key: piece Hash Key: region -> Seq Scan on stock
Le paramètre enable_hashagg permet d’activer et de désactiver l’utilisation des HashAggregate.
6.6.3 GroupAggregate
- Pré-requis :
- données déjà triées : Sort ou index
- Parcours des données
- regroupement du groupe précédent arrivé à une donnée différente
- GROUPING SETS , ROLLUP , CUBE …
Un GroupAggregate a besoin en entrée de données triées selon le regroupement demandé. Son principe est de faire le regroupement par partie, une fois terminé le balayage. Avec cette table d’exemple: CREATE TABLE stats (id serial PRIMARY KEY, annee int NOT NULL, dateachat date NOT NULL, codeproduit char(4) NOT NULL, typeclient int, typeproduit int, qte int );
SELECT 2000+a, ‘2000-01-01’::date+ainterval'1 year’+dinterval ‘1 day’, c, p, p+c, pca/10000+j+d
generate_series(3000,9000,1000) c, generate_series(1,365,5) d, generate_series (1,200) j, generate_series (3,8) p
La requête suivante utilise un GROUP BY sur deux champs:
GROUP BY annee, typeclient;
———————————————————————- GroupAggregate (cost=137581.65..156029.00 rows=25 width=40) Group Key: annee, typeclient -> Sort (cost=137581.65..139887.54 rows=922355 width=16) Sort Key: annee, typeclient, dateachat -> Seq Scan on stats (cost=0.00..30435.50 rows=922355 width=16) Filter: (annee > 2022)
Le tri est bien sûr une opération lourde. En fait il est nécessaire au count(distinct), on le voit d’ailleurs dans Sort Key. Sans ce count distinct, le jeu de données est assez petit pour qu’un HashAggregate en mémoire suffise. Un nouvel index permet au GroupAggregate d’éviter le tri:
GROUP BY annee, typeclient;
I/O Timings: shared read=1.288 write=0.354 Planning:
6.6.4 MixedAggregate
- Pour plusieurs niveaux d’agrégation
- Utilise des tables de hachage
- Typiquement : ROLLUP , CUBE
Un MixedAggregate se rencontre quand il y a plusieurs niveau d’agrégation, par exemple quand on utilise des fonctionnalités OLAP comme ROLLUP ou CUBE (voir au besoin le module S70 - Analyse de données 26 ). Ce nœud utilise des tables de hachage. Exemple:
SELECT typeclient, typeproduit, sum(qte)
GROUP BY CUBE (typeclient, typeproduit);
——————————————————————— MixedAggregate (cost=0.00..34479.66 rows=216 width=16) Hash Key: typeclient, typeproduit Hash Key: typeclient Hash Key: typeproduit Group Key: () -> Seq Scan on stats (cost=0.00..30435.50 rows=202100 width=12) Filter: (annee = 2021)
6.7 AUTRES NŒUDS
- Exemples typiques
- Unique
- Limit
- InitPlan, SubPlan
6.7.1 Unique
- Pour DISTINCT
- Entrée : données déjà triées
- Renvoie : la donnée précédente une fois arrivé à une donnée différente
- Résultat trié
- Souvent remplacé par un agrégat
Le nœud Unique permet de ne conserver que les lignes différentes d’un résultat. Les données doivent être préalablement triées, et c’est souvent cette opération qui est trop lourde. Rappelons que l’ajout de clauses DISTINCT inutiles est un souci de performance fréquent. En voici un exemple, où la table est parcourue puis triée: EXPLAIN (COSTS OFF)
————————————————————— Unique -> Gather Merge Workers Planned: 2 -> Sort Sort Key: bid -> HashAggregate Group Key: bid -> Parallel Seq Scan on pgbench_accounts
Là aussi, un index aide à accélérer ce type de nœud:
EXPLAIN (COSTS OFF)
————————————————————— Unique -> Gather Merge
Pour opérer un DISTINCT, l’optimiseur préfère souvent un agrégat à un nœud Unique: EXPLAIN (COSTS OFF)
———————————————————————- HashAggregate Group Key: (aid / 100) -> Index Only Scan using pgbench_accounts_pkey on pgbench_accounts
L’opérateur ne sait pas non plus identifier un champ dont l’unicité est garantie dans la requête. Dans l’exemple suivant, aid est la clé primaire, il n’y a pas de jointure, le nœud Unique est ici: EXPLAIN (COSTS OFF)
———————————————————————– Unique -> Index Only Scan using pgbench_accounts_pkey on pgbench_accounts
6.7.2 Limit
- Limite le nombre de résultats renvoyés
- LIMIT et OFFSET
- Peut modifier complètement le plan
- favorise les nœuds au coût de démarrage réduit (Seq Scan, Nested Loop)
Un nœud Limit arrête l’émission des lignes une fois le seuil demandé. L’ajout de LIMIT modifie profondément le plan, car PostgreSQL cherche alors à obtenir le plus vite possible les premières lignes demandées, et non à optimiser la récupération d’un grand nombre de lignes. PostgreSQL favorise alors les nœuds à faible coût de démarrage comme Seq Scan ou Nested Loops, OFFSET permet de parcourir un certain nombre de valeurs sans les renvoyer avant de commencer l’affichage. L’utilisation habituelle est la présentation de résultats page par page. Cependant, ces résultats seront quand même lus. Attention, l’utilisation d’une valeur élevée pour OFFSET est une mauvaise pratique. Ce plan ne contient pas de LIMIT. Comme il y a 10 millions de lignes à lire et à joindre, PostgreSQL décide d’un Hash Join:
INNER JOIN pgbench_branches USING (bid);
————————————————————— Hash Join (cost=3.25..291298.76 rows=9999844 width=457) Hash Cond: (pgbench_accounts.bid = pgbench_branches.bid) -> Seq Scan on pgbench_accounts (cost=0.00..263933.44 rows=9999844 width=97) -> Hash (cost=2.00..2.00 rows=100 width=364) -> Seq Scan on pgbench_branches (cost=0.00..2.00 rows=100 width=364)
L’ajout de LIMIT 5 fait basculer le plan vers un Nested Loop dont le coût de démarrage est nul:
INNER JOIN pgbench_branches USING (bid) LIMIT 5;
Attention, avec LIMIT, la lecture des plan se complique. Dans le plan suivant, les valeurs estimées peuvent porter sur l’intégralité de la table et non sur ce qui doit être réellement récupérées: EXPLAIN (ANALYZE)
INNER JOIN pgbench_branches USING (bid) LIMIT 5 OFFSET 20;
Le Seq Scan et le Nested Loops affichent 9 999 844 lignes dans leur estimation alors que 25 lignes (20 d’offset et 5 affichées) sont récupérées par l’un et l’autre.
6.7.3 Memoize
- Cache de résultat
- Utilisable par la table interne des Nested Loop
- Utile si :
- peu de valeurs distinctes dans l’ensemble interne
- beaucoup de valeurs dans l’ensemble externe
- peu de correspondance entre les deux ensembles
- Paramètres : work_mem × hash_mem_multiplier
- Sensible à ndistinct
Apparu avec PostgreSQL 14, le nœud Memoize est un cache de résultat qui permet d’optimiser les performances d’autres nœuds en mémorisant des données qui risquent d’être accédées plusieurs fois de suite. Pour le moment, ce nœud n’est utilisable que pour les données de l’ensemble interne d’un Nested Loop généré par une jointure classique ou LATERAL. Le cas idéal pour cette optimisation concerne des jointures où de large portions des lignes de l’ensemble interne de la jointure n’ont pas de correspondance dans l’ensemble externe. Dans ce genre de cas, un Hash Join serait moins efficace car il devrait calculer la clé de hachage de valeurs qui ne seront jamais utilisées; et le Merge Join devrait ignorer un grand nombre de lignes dans son parcours de la table interne. L’intérêt du cache de résultat augmente lorsqu’il y a peu de valeurs distinctes dans l’ensemble interne et que le nombre de valeurs dans l’ensemble externe est grand, ce qui provoque beaucoup de boucles. Ce nœud est donc très sensible aux statistiques sur le nombre de valeurs distinctes ( ndistinct ). Cette fonctionnalité utilise une table de hachage pour stocker les résultats. Cette table est dimensionnée grâce aux paramètres work_mem et hash_mem_multiplier. Si le cache se remplit, les valeurs les plus anciennes sont exclues du cache. Exemple:
EXPLAIN (TIMING off, COSTS off, SUMMARY off, ANALYZE)
—————————————————————————— Nested Loop (actual rows=2850000 loops=1) -> Seq Scan on t2 (actual rows=3000000 loops=1) -> Memoize (actual rows=1 loops=3000000)
Cache Key: t2.k Cache Mode: logical Hits: 2999980 Misses: 20 Evictions: 0 Overflows: 0 Memory Usage: 3kB -> Index Scan using t1_j_idx on t1 (actual rows=1 loops=20) Index Cond: (j = t2.k)
Il n’y a que 20 valeurs différentes pour t2.k, le cache ne fait donc que 3 ko. Il a permis 2 999 980 accès au cache, et seulement 20 valeurs ont dû être cherchées dans l’index ( loops=20 ). Aucune valeur n’a été exclue du cache ( Evictions: 0 ). En désactivant ce nœud, on bascule sur un Hash Join:
EXPLAIN (TIMING off, COSTS off, SUMMARY off, ANALYZE)
——————————————————- Hash Join (actual rows=2850000 loops=1) Hash Cond: (t2.k = t1.j) -> Seq Scan on t2 (actual rows=3000000 loops=1) -> Hash (actual rows=400000 loops=1) Buckets: 262144 Batches: 4 Memory Usage: 5956kB -> Seq Scan on t1 (actual rows=400000 loops=1)
6.8 CONCLUSION
- De nombreux nœuds
- Qu’il faut apprendre
- Expérimentez!
Le nombre de nœuds est important mais il faut apprendre à les distinguer, connaître leur points forts et faibles, et ce qui les (dé)favorise. La théorie ne remplace pas l’expérience acquise en essayant de comprendre des plans de requêtes, et en testant des modifications.
6.8.1 Questions
EXPLAIN (VERBOSE)