1 Techniques d'indexation
1/ Techniques d’indexation
Ce chapitre reprend l’intégralité des pages PDF 13-84 du manuel complet PERF2, y compris les énoncés de travaux pratiques et les solutions.
Photo de Maksym Kaharlytskyi, Unsplash licence
1.1 Introduction
- Qu’est-ce qu’un index ?
- Comment indexer une base ?
- Les index B-tree dans PostgreSQL
1.1.1 Objectifs
- Comprendre ce qu’est un index
- Maîtriser le processus de création d’index
- Connaître les différents types d’index B-tree et leurs cas d’usages
1.1.2 Introduction aux index
- Uniquement destinés à l’optimisation
- À gérer d’abord par le développeur
- SQL Performance Explained (Markus Winand)
- Use the index, Luke : https://use-the-index-luke.com (id.)
Les index ne sont pas des objets qui font partie de la théorie relationnelle. Ils sont des objets physiques qui permettent d’accélérer l’accès aux données. Et comme ils ne sont que des moyens d’optimisation des accès, les index ne font pas non plus partie de la norme SQL. C’est d’ailleurs pour cette raison que la syntaxe de création d’index est si différente d’une base de données à une autre.
La création des index est à la charge du développeur ou du DBA, leur création n’est pas automatique, sauf exception.
Pour Markus Winand, c’est d’abord au développeur de poser les index, car c’est lui qui sait comment ses données sont utilisées. Un DBA d’exploitation n’a pas cette connaissance, mais il connaît généralement mieux les différents types d’index et leurs subtilités, et voit comment les requêtes réagissent en production. Développeur et DBA sont complémentaires dans l’analyse d’un problème de performance.
Le site de Markus Winand, Use the index, Luke, propose une version en ligne de son livre SQL Performance Explained, centré sur les index B-tree (les plus courants). Une version française est par ailleurs disponible sous le titre SQL : au cœur des performances.
1.1.3 Utilités d’un index
- Un index permet de :
- trouver un enregistrement dans une table directement
- récupérer une série d’enregistrements dans une table
- voire tout récupérer dans l’index (Index Only Scan)
- Un index facilite :
- certains tris
- certains agrégats
- Obligatoires et automatique pour clés primaires & unicité
- conseillé pour clés étrangères (FK)
Les index ne changent pas le résultat d’une requête, mais l’accélèrent. L’index permet de pointer l’endroit de la table où se trouve une donnée, pour y accéder directement. Parfois c’est toute une plage de l’index, voire sa totalité, qui sera lue, ce qui est généralement plus rapide que lire toute la table.
Le cas le plus favorable est l’Index Only Scan : toutes les données nécessaires sont contenues dans l’index, lui seul sera lu et PostgreSQL ne lira pas la table elle-même.
PostgreSQL propose différentes formes d’index :
- index classique sur une seule colonne d’une table ;
- index composite sur plusieurs colonnes d’une table ;
- index partiel, en restreignant les données indexées avec une clause
WHERE; - index fonctionnel, en indexant le résultat d’une fonction appliquée à une ou plusieurs colonnes d’une table ;
- index couvrants, contenant plus de champs que nécessaire au filtrage, pour ne pas avoir besoin de lire la table, et obtenir un Index Only Scan.
La création des index est à la charge du développeur. Seules exceptions : ceux créés automatiquement quand on déclare des contraintes de clé primaire ou d’unicité. La création est alors automatique.
Les contraintes de clé étrangère imposent qu’il existe déjà une clé primaire sur la table pointée, mais ne crée pas d’index sur la table portant la clé.
1.1.4 Index et lectures
Un index améliore les SELECT
- Sans index :
- Avec index :
L’index est une structure de données qui permet d’accéder rapidement à l’information recherchée. À l’image de l’index d’un livre, pour retrouver un thème rapidement, on préférera utiliser l’index du livre plutôt que lire l’intégralité du livre jusqu’à trouver le passage qui nous intéresse. Dans une base de données, l’index a un rôle équivalent. Plutôt que de lire une table dans son intégralité, la base de données utilisera l’index pour ne lire qu’une faible portion de la table pour retrouver les données recherchées.
Pour la requête d’exemple (avec une table de 20 millions de lignes), on remarque que l’optimiseur n’utilise pas le même chemin selon que l’index soit présent ou non. Sans index, PostgreSQL réalise un parcours séquentiel de la table :
Lorsqu’il est présent, PostgreSQL l’utilise car l’optimiseur estime que son parcours ne récupérera qu’une seule ligne sur les 20 millions que compte la table :
Mais l’index n’accélère pas seulement la simple lecture de données, il permet également d’accélérer les tris et les agrégations, comme le montre l’exemple suivant sur un tri :
1.1.5 Index : inconvénients
- L’index n’est pas gratuit !
- Ralentit les écritures
- maintenance
- Place disque
- Compromis à trouver
La présence d’un index ralentit les écritures sur une table. En effet, il faut non seulement ajouter ou modifier les données dans la table, mais il faut également maintenir le ou les index de cette table.
Les index dégradent surtout les temps de réponse des insertions. Les mises à jour et les suppressions (UPDATE et DELETE) tirent en général parti des index pour retrouver les lignes concernées par les modifications. Le coût de maintenance de l’index est secondaire par rapport au coût de l’accès aux données.
Soit une table test2 telle que :
La table est chargée avec pour seul index présent celui sur la clé primaire :
Un index supplémentaire est créé sur une colonne de type entier :
Un index supplémentaire est encore créé, mais cette fois sur une colonne de type texte :
On peut comparer ces temps à l’insertion dans une table similaire dépourvue d’index :
La table test2 a été vidée préalablement pour chaque test.
Enfin, la place disque utilisée par ces index n’est pas négligeable :
Pour ces raisons, on ne posera pas des index systématiquement avant de se demander s’ils seront utilisés. L’idéal est d’étudier les plans de ses requêtes et de chercher à optimiser.
1.1.6 Index : contraintes pratiques à la création
- Lourd…
- Si fragmentation :
- Paramètres :
maintenance_work_mem(sinon : fichier temporaire !)max_parallel_maintenance_workers
Création d’un index :
Bien sûr, la durée de création de l’index dépend fortement de la taille de la table. PostgreSQL va lire toutes les lignes et trier les valeurs rencontrées. Ce peut être lourd et impliquer la création de fichiers temporaires.
Si l’on utilise la syntaxe classique, toutes les écritures sur la table sont bloquées (mises en attente) pendant la durée de la création de l’index (verrou ShareLock). Les lectures restent possibles, mais cette contrainte est parfois rédhibitoire pour les grosses tables.
Clause CONCURRENTLY :
Ajouter le mot clé CONCURRENTLY permet de rendre la table accessible en écriture. Malheureusement, cela nécessite au minimum deux parcours de la table, et donc alourdit et ralentit la construction de l’index. Dans quelques cas défavorables (entre autres l’interruption de la création de l’index), la création échoue et l’index existe mais est invalide :
L’index est inutilisable et doit être supprimé et recréé, ou bien réindexé. Pour les détails, voir la documentation officielle.
Une supervision peut détecter des index invalides avec cette requête, qui ne doit jamais rien ramener :
Réindexation :
Comme les tables, les index sont soumis à la fragmentation. Celle-ci peut cependant monter assez haut sans grande conséquence pour les performances. De plus, le nettoyage des index est une des étapes des opérations de VACUUM.
Une reconstruction de l’index est automatique lors d’un VACUUM FULL de la table.
Certaines charges provoquent une fragmentation assez élevée, typiquement les tables gérant des files d’attente. Une réindexation reconstruit totalement l’index. Voici quelques variantes de l’ordre :
Il existe là aussi une clause CONCURRENTLY :
(En cas d’échec, on trouvera là aussi des index invalides, suffixés avec _ccnew, à côté des index préexistants toujours fonctionnels et que PostgreSQL n’a pas détruits.)
Paramètres :
La rapidité de création d’un index dépend essentiellement de la mémoire accordée, définie dans maintenance_work_mem. Si elle ne suffit pas, le tri se fera dans des fichiers temporaires plus lents. Sur les serveurs modernes, le défaut de 64 Mo est ridicule, et on peut monter aisément à :
Attention de ne pas saturer la mémoire en cas de création simultanée de nombreux gros index (lors d’une restauration avec pg_restore notamment).
Si le serveur est bien doté en CPU, la parallélisation de la création d’index peut apporter un gain en temps appréciable. La valeur par défaut est :
et devrait même être baissée sur les plus petites configurations.
1.1.7 Types d’index dans PostgreSQL
- Défaut : B-tree classique (équilibré)
UNIQUE(préférer la contrainte)- Mais aussi multicolonnes, fonctionnel, partiel, couvrant
- Index spécialisés : hash, GiST, GIN, BRIN, HNSW….
Par défaut un CREATE INDEX créera un index de type B-tree, de loin le plus courant. Il est stocké sous forme d’arbre équilibré, avec de nombreux avantages :
- les performances se dégradent peu avec la taille de l’arbre (les temps de recherche sont en $\mathcal{O}(\log n)$, donc fonction du logarithme du nombre d’enregistrements dans l’index) ;
- l’accès concurrent est excellent, avec très peu de contention entre processus qui insèrent simultanément.
Toutefois les B-tree ne permettent de répondre qu’à des questions très simples, portant sur la colonne indexée, et uniquement sur des opérateurs courants (égalité, comparaison). Cela couvre tout de même la majorité des cas.
Contrainte d’unicité et index :
Un index peut être déclaré UNIQUE pour provoquer une erreur en cas d’insertion de doublons. Mais on préférera généralement déclarer une contrainte d’unicité (notion fonctionnelle), qui techniquement, entraînera la création d’un index.
Par exemple, sur cette table personne :
on peut créer un index unique :
La contrainte d’unicité est alors implicite. La suppression de l’index se fait sans bruit :
Définissons une contrainte d’unicité sur la colonne plutôt qu’un index :
Un index est également créé. La contrainte empêche sa suppression :
Le principe est le même pour les clés primaires.
Indexation avancée :
Il faut aussi savoir que PostgreSQL permet de créer des index B-tree :
- sur plusieurs colonnes ;
- sur des résultats de fonction ;
- sur une partie des valeurs indexées ;
- intégrant des champs non indexés mais souvent récupérés avec les champs indexés (index couvrants).
D’autres types d’index que B-tree existent, destinés à certains types de données ou certains cas d’optimisation précis.
1.2 Fonctionnement d’un index
1.2.1 Structure d’un index
- Structure associant des clés (termes) à des localisations (pages)
- Structure de données spécialisée, plusieurs types
- Séparée de la table
- Analogies :
- fiches en carton des bibliothèques avant l’informatique (B-tree)
- index d’un livre technique (GIN)
Les fiches en carton des anciennes bibliothèques sont un bon équivalent du type d’index le plus courant utilisé par les bases de données en général et PostgreSQL en particulier : le B-tree.
Lorsque l’on recherche des ouvrages dans la bibliothèque, il est possible de parcourir l’intégralité du bâtiment pour chercher les livres qui nous intéressent. Ceci prend énormément de temps. La bibliothèque peut être triée, mais ce tri ne permet pas forcément de trouver facilement le livre. Ce type de recherche trouve son analogie sous la forme du parcours complet d’une table (Seq Scan).
Une deuxième méthode pour localiser l’ouvrage consiste à utiliser un index. Sur fiche carton ou sous forme informatique, cet index associe par exemple le nom d’auteur à un ensemble de références (emplacements dans les rayonnages) où celui-ci est présent. Ainsi, pour trouver les œuvres de Proust avec l’index en carton, il suffit de parcourir les fiches, dont l’intégralité tient devant l’utilisateur. La fiche indique des références dans plusieurs rayons et il faudra aller se déplacer pour trouver les œuvres, en allant directement aux bons rayons.
Dans une base de données, le fonctionnement d’un index est très similaire. En effet, comme dans une bibliothèque, l’index est une structure de données à part, qui n’est pas strictement nécessaire à l’exploitation des informations, et qui est principalement utilisée pour la recherche dans l’ensemble de données. Cette structure de données possède un coût de maintenance, dans les deux cas : toute modification des données entraîne des modifications de l’index afin de le maintenir à jour. Et un index qui n’est pas à jour peut provoquer de gros problèmes. Dans le doute, on peut jeter l’index et le recréer de zéro sans problème d’intégrité des données originales.
Il peut y avoir plusieurs index suivant les besoins. L’index trié par auteur ne permet pas de trouver un livre dont on ne connaît que le titre (sauf à lire toutes les fiches). Il faut alors un autre index classé par titre.
Pour filer l’analogie : un index peut être multicolonnes (les fiches en carton triées par auteur le sont car elles contiennent le titre, et pas que la référence dans les rayons). L’index peut répondre à une demande à lui seul : il suffit pour compter le nombre de livres de Marcel Proust (c’est le principe des Index Only Scans). Une fiche d’un index peut contenir des informations supplémentaires (dates de publication, éditeur…) pour faciliter d’autres recherches sans aller dans les rayons (index « couvrant »).
Dans la réalité comme dans une base de données, il y a un dilemme quand il faut récupérer de très nombreuses données : soit aller chercher de nombreux livres un par un dans les rayons, soit balayer tous les livres systématiquement dans l’ordre où ils viennent pour éviter trop d’allers-retours.
Autres types d’index non informatiques similaires au B-tree :
- les tables décennales de l’État civil, qui pointent vers un endroit précis des registres des actes de naissance, mariage ou décès d’une commune ;
- l’index d’un catalogue papier.
L’index d’un livre technique ou d’un livre de recettes cible des parties des données et non les données elles-mêmes (comme le titre). Il s’approche plus d’un autre type d’index, le GIN, qui existe aussi dans PostgreSQL.
Un annuaire téléphonique papier présente les données sous un mode strictement ordonné. Cette intégration entre table et index n’a pas d’équivalent sous PostgreSQL mais existe dans d’autres moteurs de bases de données.
1.2.2 Un index n’est pas magique
- Un index ne résout pas tout
- Importance de la conception du schéma de données
- Importance de l’écriture de requêtes SQL correctes
Bien souvent, la création d’index est vue comme le remède à tous les maux de performance subis par une application. Il ne faut pas perdre de vue que les facteurs principaux affectant les performances vont être liés à la conception du schéma de données, et à l’écriture des requêtes SQL.
Pour prendre un exemple caricatural, un schéma EAV (Entity-Attribute-Value, ou entité-clé-valeur) ne pourra jamais être performant, de part sa conception. Bien sûr, dans certains cas, une méthodologie pertinente d’indexation permettra d’améliorer un peu les performances, mais le problème réside là dans la conception même du schéma. Il est donc important dans cette phase de considérer la manière dont le modèle va influer sur les méthodes d’accès aux données, et les implications sur les performances.
De même, l’écriture des requêtes elles-mêmes conditionnera en grande partie les performances observées sur l’application. Par exemple, la mauvaise pratique (souvent mise en œuvre accidentellement via un ORM) dite du « N+1 » ne pourra être corrigée par une indexation correcte : celle-ci consiste à récupérer une collection d’enregistrement (une requête) puis d’effectuer une requête pour chaque enregistrement afin de récupérer les enregistrements liés (N requêtes). Dans ce type de cas, une jointure est bien plus performante. Ce type de comportement doit encore une fois être connu de l’équipe de développement, car il est plutôt difficile à détecter par une équipe d’exploitation.
De manière générale, avant d’envisager la création d’index supplémentaires, il convient de s’interroger sur les possibilités de réécriture des requêtes, voire du schéma.
1.2.3 Index B-tree
- Type d’index le plus courant
- et le plus simple
- Utilisable pour les contraintes d’unicité
- Supporte les opérateurs :
<,<=,=,>=,> - Supporte le tri
- Ne peut pas indexer des colonnes de plus de 2,6 ko
L’index B-tree est le plus simple conceptuellement parlant. Sans entrer dans les détails, un index B-tree est par définition équilibré : ainsi, quelle que soit la valeur recherchée, le coût est le même lors du parcours d’index. Ceci ne veut pas dire que toute requête impliquant l’index mettra le même temps ! En effet, si chaque clé n’est présente qu’une fois dans l’index, celle-ci peut être associée à une multitude de valeurs, qui devront alors être cherchées dans la table.
L’algorithme utilisé par PostgreSQL pour ce type d’index suppose que chaque page peut contenir au moins trois valeurs. Par conséquent, chaque valeur ne peut excéder un peu moins d’1⁄3 de bloc, soit environ 2,6 ko. La valeur en question correspond donc à la totalité des données de toutes les colonnes de l’index pour une seule ligne. Si l’on tente de créer ou maintenir un index sur une table ne satisfaisant pas ces prérequis, une erreur sera renvoyée, et la création de l’index (ou l’insertion/mise à jour de la ligne) échouera. Ces champs sont souvent des longs textes ou des champs composés dont on cherchera plutôt des parties, et un index B-tree n’est de toute façon pas adapté. Si un index de type B-tree est tout de même nécessaire sur les colonnes en question, pour des recherches sur l’intégralité de la ligne, les index de type hash sont plus adaptés (mais ils ne supportent que l’opérateur =).
1.2.4 Exemple de structure d’un index B-tree
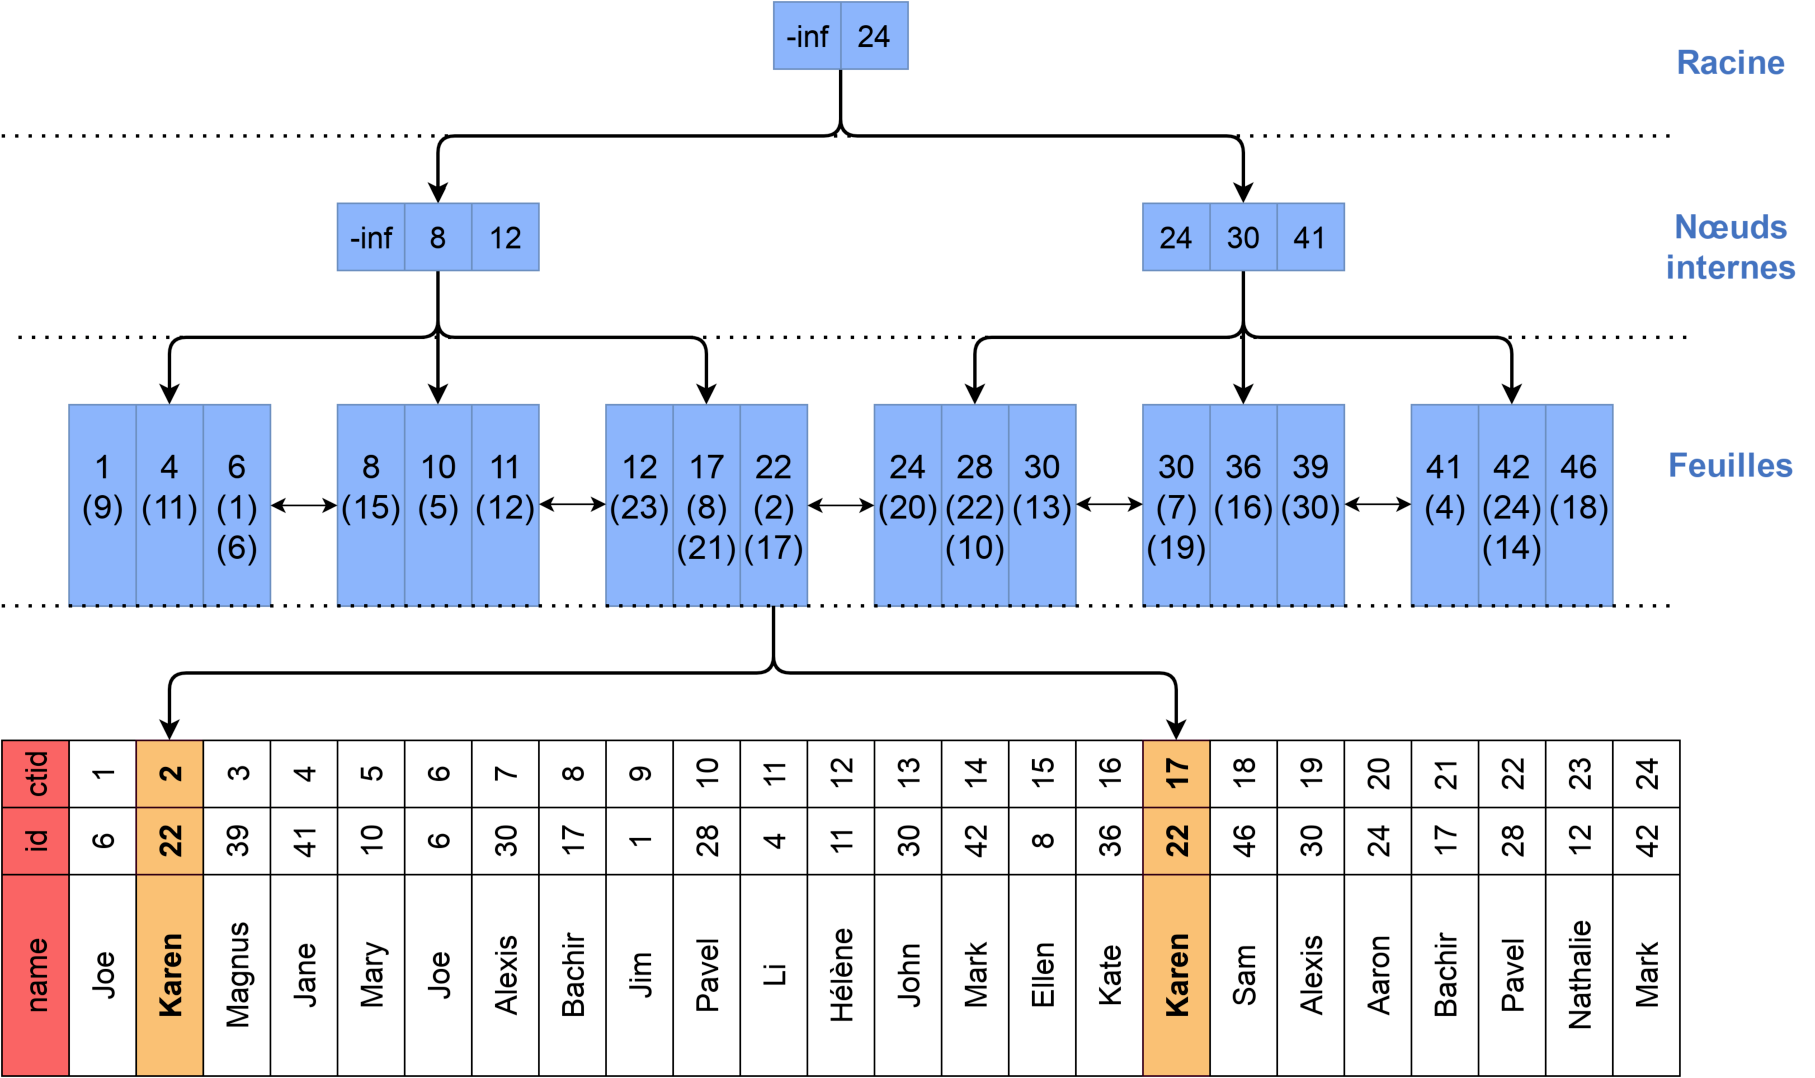
SELECT name FROM ma_table WHERE id = 22
Ce schéma présente une vue très simplifiée d’une table (en blanc, avec ses champs id et name) et d’un index B-tree sur id (en bleu), tel que le créerait :
Un index B-tree peut contenir trois types de nœuds :
- la racine : elle est unique c’est la base de l’arbre ;
- des nœuds internes : il peut y en avoir plusieurs niveaux ;
- des feuilles : elles contiennent :
- les valeurs indexées (triées !) ;
- les valeurs incluses (si applicable) ;
- les positions physiques (
ctid), ici entre parenthèses et sous forme abrégée, car la forme réelle est (numéro de bloc, position de la ligne dans le bloc) ; - l’adresse de la feuille précédente et de la feuille suivante.
La racine et les nœuds internes contiennent des enregistrements qui décrivent la valeur minimale de chaque bloc du niveau inférieur et leur adresse (ctid).
Lors de la création de l’index, il ne contient qu’une feuille. Lorsque cette feuille se remplit, elle se divise en deux et un nœud racine est créé au-dessus. Les feuilles se remplissent ensuite progressivement et se séparent en deux quand elles sont pleines. Ce processus remplit progressivement la racine. Lorsque la racine est pleine, elle se divise en deux nœuds internes, et une nouvelle racine est crée au-dessus. Ce processus permet de garder un arbre équilibré.
Recherchons le résultat de :
en passant par l’index.
- En parcourant la racine, on cherche un enregistrement dont la valeur est strictement supérieure à la valeur que l’on recherche. Ici, 22 est plus petit que 24 : on explore donc le nœud de gauche.
- Ce nœud référence trois nœuds inférieurs (ici des feuilles). On compare de nouveau la valeur recherchée aux différentes valeurs (triées) du nœud : pour chaque intervalle de valeur, il existe un pointeur vers un autre nœud de l’arbre. Ici, 22 est plus grand que 12, on explore donc le nœud de droite au niveau inférieur.
- Un arbre B-tree peut bien évidemment avoir une profondeur plus grande, auquel cas l’étape précédente est répétée.
- Une fois arrivé sur une feuille, il suffit de la parcourir pour récupérer l’ensemble des positions physiques des lignes correspondants au critère. Ici, la feuille nous indique qu’à la valeur 22 correspondent deux lignes aux positions 2 et 17. Lorsque la valeur recherchée est supérieure ou égale à la plus grande valeur du bloc, PostgreSQL va également lire le bloc suivant. Ce cas de figure peut se produire si PostgreSQL a divisé une feuille en deux avant ou même pendant la recherche que nous exécutons. Ce serait par exemple le cas si on cherchait la valeur 30.
- Pour trouver les valeurs de
name, il faut aller chercher dans la table même les lignes aux positions trouvées dans l’index. D’autre part, les informations de visibilité des lignes doivent aussi être trouvées dans la table. (Il existe des cas où la recherche peut éviter cette dernière étape : ce sont les Index Only Scan.)
Même en parcourant les deux structures de données, si la valeur recherchée représente une assez petite fraction des lignes totales, le nombre d’accès disques sera donc fortement réduit. En revanche, au lieu d’effectuer des accès séquentiels (pour lesquels les disques durs classiques sont relativement performants), il faudra effectuer des accès aléatoires, en sautant d’une position sur le disque à une autre. Le choix est fait par l’optimiseur.
Supposons désormais que nous souhaitions exécuter une requête sans filtre, mais exigeant un tri, du type :
L’index peut nous aider à répondre à cette requête. En effet, toutes les feuilles sont liées entre elles, et permettent ainsi un parcours ordonné. Il nous suffit donc de localiser la première feuille (la plus à gauche), et pour chaque clé, récupérer les lignes correspondantes. Une fois les clés de la feuille traitées, il suffit de suivre le pointeur vers la feuille suivante et de recommencer.
L’alternative consisterait à parcourir l’ensemble de la table, et trier toutes les lignes afin de les obtenir dans le bon ordre. Un tel tri peut être très coûteux, en mémoire comme en temps CPU. D’ailleurs, de tels tris débordent très souvent sur disque (via des fichiers temporaires) afin de ne pas garder l’intégralité des données en mémoire.
Pour les requêtes utilisant des opérateurs d’inégalité, on voit bien comment l’index peut là aussi être utilisé. Par exemple, pour la requête suivante :
Il suffit d’utiliser la propriété de tri de l’index pour parcourir les feuilles, en partant de la borne inférieure, jusqu’à la borne supérieure.
Dernière remarque : ce schéma ne montre qu’une entrée d’index pour 22, bien qu’il pointe vers deux lignes. PostgreSQL sait dédupliquer les entrées pour économiser de la place.
1.2.5 Index multicolonnes
- Possibilité d’indexer plusieurs colonnes :
- Ordre des colonnes primordial
- accès direct aux premières colonnes de l’index
- pour les autres, PostgreSQL lira tout l’index ou ignorera l’index
Il est possible de créer un index sur plusieurs colonnes. Il faut néanmoins être conscient des requêtes supportées par un tel index. Admettons que l’on crée une table d’un million de lignes avec un index sur trois champs :
L’index est optimal pour répondre aux requêtes portant sur les premières colonnes de l’index :
Et encore plus quand l’index permet de répondre intégralement au contenu de la requête :
Mais si les premières colonnes de l’index ne sont pas spécifiées, alors l’index devra être parcouru en grande partie.
Cela reste plus intéressant que parcourir toute la table, surtout si l’index est petit et contient toutes les données du SELECT. Mais le comportement dépend alors de nombreux paramètres, comme les statistiques, les estimations du nombre de lignes ramenées et les valeurs relatives de seq_page_cost et random_page_cost :
Noter que tout l’index a été lu.
Mais pour limiter les aller-retours entre index et table, PostgreSQL peut aussi décider d’ignorer l’index et de parcourir directement la table :
Concernant les range scans (requêtes impliquant des opérateurs d’inégalité, tels que <, <=, >=, >), celles-ci pourront être satisfaites par l’index de manière quasi optimale si les opérateurs d’inégalité sont appliqués sur la dernière colonne requêtée, et de manière sub-optimale s’ils portent sur les premières colonnes.
Cet index pourra être utilisé pour répondre aux requêtes suivantes de manière optimale :
Il pourra aussi être utilisé, mais de manière bien moins efficace, pour les requêtes suivantes, qui bénéficieraient d’un index sur un ordre alternatif des colonnes :
Le plan de cette dernière requête est :
Les index multicolonnes peuvent aussi être utilisés pour le tri comme dans les exemples suivants. Il n’y a pas besoin de trier (ce peut être très coûteux) puisque les données de l’index sont triées. Ici le cas est optimal puisque l’index contient toutes les données nécessaires :
Le plan de cette dernière requête est :
Il est donc nécessaire d’avoir une bonne connaissance de l’application (ou de passer du temps à observer les requêtes consommatrices) pour déterminer comment créer des index multicolonnes pertinents pour un nombre maximum de requêtes.
1.2.6 Nœuds des index
- Index Scan
- Bitmap Scan
- Index Only Scan
- idéal pour les performances
- et les variantes parallélisées
L’optimiseur a le choix entre plusieurs parcours pour utiliser un index, principalement suivant la quantité d’enregistrements à récupérer :
Index Scan
Un Index Scan est optimal quand il y a peu d’enregistrements à récupérer. Noter qu’il comprend l’accès à l’index et celui à la table ensuite.
Bitmap Scan
Le Bitmap Scan est utile quand il y a plus de lignes, ou quand on veut lire plusieurs index d’une même table pour satisfaire plusieurs conditions de filtre.
Il se décompose en deux nœuds : un Bitmap Index Scan qui récupère des blocs d’index, et un Bitmap Heap Scan qui va chercher les blocs dans la table.
Typiquement, ce nœud servira pour des recherches de plages de valeurs ou de grandes quantités de lignes.
Conseil.
Une bonne corrélation des données avec leur emplacement physique favorise un Index Scan par rapport à un Bitmap Scan, et un Bitmap Scan par rapport à un Seq Scan. Une estimation de cette corrélation est consultable, pour chaque colonne de chaque table, dans la vue
pg_stats, champcorrelation(des valeurs proches de -1 ou 1 indiquent une bonne corrélation).
Index Only Scan
L’Index Only Scan est utile quand les champs de la requête correspondent aux colonnes de l’index. Ce nœud permet d’éviter la lecture de tout ou partie de la table et est donc très performant.
Autre intérêt de l’Index Only Scan : les enregistrements cherchés sont contigus dans l’index (puisqu’il est trié), et le nombre d’accès disque est bien plus faible. Il est tout à fait possible d’obtenir dans des cas extrêmes des gains de l’ordre d’un facteur 10 000.
Si peu de champs de la table sont impliqués dans la requête, il faut penser à viser un Index Only Scan.
Parallélisation
Chacun de ses nœuds a une version parallélisable si l’index est assez grand et que l’optimiseur pense que paralléliser est utile. Il apparaît alors un nœud Gather pour rassembler les résultats des différents workers.
1.3 Méthodologie de création d’index
- On indexe pour une requête
- ou idéalement une collection de requêtes
- Et pas « une table »
La première chose à garder en tête est que l’on indexe pas le schéma de données, c’est-à-dire les tables, mais en fonction de la charge de travail supportée par la base, c’est-à-dire les requêtes. En effet, comme nous l’avons vu précédemment, tout index superflu a un coût global pour la base de données, notamment pour les opérations DML.
1.3.1 L’index ? Quel index ?
- Identifier les requêtes nécessitant un index
- Créer les index permettant de répondre à ces requêtes
- Valider le fonctionnement, en rejouant la requête avec :
La méthodologie elle-même est assez simple. Selon le principe qu’un index sert à une (ou des) requête(s), la première chose à faire consiste à identifier celle(s)-ci. L’équipe de développement est dans une position idéale pour réaliser ce travail : elle seule peut connaître le fonctionnement global de l’application, et donc les colonnes qui vont être utilisées, ensemble ou non, comme cible de filtres ou de tris. Au delà de la connaissance de l’application, il est possible d’utiliser des outils tels que pgBadger, pg_stat_statements et PoWA pour identifier les requêtes particulièrement consommatrices, et qui pourraient donc potentiellement nécessiter un index. Ces outils seront présentés plus loin dans cette formation.
Une fois les requêtes identifiées, il est nécessaire de trouver les index permettant d’améliorer celles-ci. Ils peuvent être utilisés pour les opérations de filtrage (clause WHERE), de tri (clauses ORDER BY, GROUP BY) ou de jointures. Idéalement, l’étude portera sur l’ensemble des requêtes, afin notamment de pouvoir décider d’index multicolonnes pertinents pour le plus grand nombre de requêtes, et éviter ainsi de créer des index redondants.
1.3.2 Index et clés étrangères
- Indexation des colonnes faisant référence à une autre
- Performances des DML
- Performances des jointures
De manière générale, l’ensemble des colonnes étant la source d’une clé étrangère devraient être indexées, et ce pour deux raisons.
La première concerne les jointures. Généralement, lorsque deux tables sont liées par des clés étrangères, il existe au moins certaines requêtes dans l’application joignant ces tables. La colonne « cible » de la clé étrangère est nécessairement indexée, c’est un prérequis dû à la contrainte unique nécessaire à celle-ci. Il est donc possible de la parcourir de manière triée.
La colonne source devrait être indexée elle aussi : en effet, il est alors possible de la parcourir de manière ordonnée, et donc de réaliser la jointure selon l’algorithme Merge Join (comme vu lors du module sur les plans d’exécution), et donc d’être beaucoup plus rapide. Un tel index accélérera de la même manière les Nested Loop, en permettant de parcourir l’index une fois par ligne de la relation externe au lieu de parcourir l’intégralité de la table.
De la même manière, pour les DML sur la table cible, cet index sera d’une grande aide : pour chaque ligne modifiée ou supprimée, il convient de vérifier, soit pour interdire soit pour « cascader » la modification, la présence de lignes faisant référence à celle touchée.
S’il n’y a qu’une règle à suivre aveuglément ou presque, c’est bien celle-ci : les colonnes faisant partie d’une clé étrangère doivent être indexées !
Deux exceptions : les champs ayant une cardinalité très faible et homogène (par exemple, un champ homme/femme dans une population équilibrée) ; et ceux dont on constate l’inutilité après un certain temps, par des valeurs à zéro dans pg_stat_user_indexes.
1.4 Index inutilisé
C’est souvent tout à fait normal
- Utiliser l’index est-il rentable ?
- La requête est-elle compatible ?
- Bug de l’optimiseur : rare
C’est l’optimiseur SQL qui choisit si un index doit ou non être utilisé. Il est tout à fait possible que PostgreSQL décide qu’utiliser un index donné n’en vaut pas la peine par rapport à d’autres chemins. Il faut aussi savoir identifier les cas où l’index ne peut pas être utilisé.
L’optimiseur possède forcément quelques limitations. Certaines sont un compromis par rapport au temps que prendrait la recherche systématique de toutes les optimisations imaginables. Il y aussi le problème des estimations de volumétries, qui sont d’autant plus difficiles que la requête est complexe.
Quant à un vrai bug, si le cas peut être reproduit, il doit être remonté aux développeurs de PostgreSQL. D’expérience, c’est rarissime.
1.4.1 Index utilisable mais non utilisé
- L’optimiseur pense qu’il n’est pas rentable
- sélectivité trop faible
- meilleur chemin pour remplir d’autres critères
- index redondant
- Index Only Scan nécessite un
VACUUMfréquent
- Les estimations de volumétries doivent être assez bonnes !
- statistiques récentes, précises
Il existe plusieurs raisons pour que PostgreSQL néglige un index.
Sélectivité trop faible, trop de lignes :
Comme vu précédemment, le parcours d’un index implique à la fois des lectures sur l’index, et des lectures sur la table. Au contraire d’une lecture séquentielle de la table (Seq Scan), l’accès aux données via l’index nécessite des lectures aléatoires. Ainsi, si l’optimiseur estime que la requête nécessitera de parcourir une grande partie de la table, il peut décider de ne pas utiliser l’index : l’utilisation de celui-ci serait alors trop coûteux.
Autrement dit, l’index n’est pas assez discriminant pour que ce soit la peine de faire des allers-retours entre lui et la table. Le seuil dépend entre autres des volumétries de la table et de l’index et du rapport entre les paramètres random_page_cost et seq_page_cost (respectivement 4 et 1 pour un disque dur classique peu rapide, et souvent 1 et 1 pour du SSD, voire moins).
Il y a un meilleur chemin :
Un index sur un champ n’est qu’un chemin parmi d’autres, en aucun cas une obligation, et une requête contient souvent plusieurs critères sur des tables différentes. Par exemple, un index sur un filtre peut être ignoré si un autre index permet d’éviter un tri coûteux, ou si l’optimiseur juge que faire une jointure avant de filtrer le résultat est plus performant.
Index redondant :
Il existe un autre index doublant la fonctionnalité de celui considéré. PostgreSQL favorise naturellement un index plus petit, plus rapide à parcourir. À l’inverse, un index plus complet peut favoriser plusieurs filtres, des tris, devenir couvrant…
VACUUM trop ancien :
Dans le cas précis des Index Only Scan, si la table n’a pas été récemment nettoyée, il y aura trop d’allers-retours avec la table pour vérifier les informations de visibilité (heap fetches). Un VACUUM permet de mettre à jour la Visibility Map pour éviter cela.
Statistiques périmées :
Il peut arriver que l’optimiseur se trompe quand il ignore un index. Des statistiques périmées sont une cause fréquente. Pour les rafraîchir :
Si cela résout le problème, ce peut être un indice que l’autovacuum ne passe pas assez souvent (voir pg_stat_user_tables.last_autoanalyze). Il faudra peut-être ajuster les paramètres autovacuum_analyze_scale_factor ou autovacuum_analyze_threshold sur les tables.
Statistiques pas assez fines :
Les statistiques sur les données peuvent être trop imprécises. Le défaut est un histogramme de 100 valeurs, basé sur 300 fois plus de lignes. Pour les grosses tables, augmenter l’échantillonnage sur les champs aux valeurs peu homogènes est possible :
La valeur 500 n’est qu’un exemple. Monter beaucoup plus haut peut pénaliser les temps de planification. Ce sera d’autant plus vrai si on applique cette nouvelle valeur globalement, donc à tous les champs de toutes les tables (ce qui est certes le plus facile).
Estimations de volumétries trompeuses :
Par exemple, une clause WHERE sur deux colonnes corrélées (ville et code postal par exemple), mène à une sous-estimation de la volumétrie résultante par l’optimiseur, car celui-ci ignore le lien entre les deux champs. Vous pouvez demander à PostgreSQL de calculer cette corrélation avec l’ordre CREATE STATISTICS (voir le module de formation J2 ou la documentation officielle).
Compatibilité :
Il faut toujours s’assurer que la requête est écrite correctement et permet l’utilisation de l’index.
Un index peut être inutilisable à cause d’une fonction plus ou moins explicite, ou encore d’un mauvais typage. Il arrive que le critère de filtrage ne peut remonter sur la table indexée à cause d’un CTE matérialisé (explicitement ou non), d’un DISTINCT, ou d’une vue complexe.
Nous allons voir quelques problèmes classiques.
1.4.2 Index inutilisable à cause d’une fonction
- Pas le bon type (
CASTplus ou moins explicite)
- Utilisation de fonctions, comme :
Voici quelques exemples d’index incompatible avec la clause WHERE :
Mauvais type :
Cela peut paraître contre-intuitif, mais certains transtypages ne permettent pas de garantir que les résultats d’un opérateur (par exemple l’égalité) seront les mêmes si les arguments sont convertis dans un type ou dans l’autre. Cela dépend des types et du sens de conversion. Dans les exemples suivants, le champ client_id est de type bigint. PostgreSQL réussit souvent à convertir, mais ce n’est pas toujours parfait.
De même, les conversions entre date et timestamp/timestamptz se passent généralement bien.
Autres exemples :
- Dans une jointure, si les deux champs joints n’ont pas le même type, il est possible que de simples index ne soient pas utilisables, ou un seul d’entre eux. Il faudra corriger l’incohérence, ou créer des index fonctionnels incluant le transtypage.
- Un index B-tree sur un tableau ou un JSON ne peut servir pour une recherche sur un de ses éléments. Il faudra s’orienter vers un index plus spécialisé, par exemple GIN ou GiST.
Utilisation de fonction :
Si une fonction est appliquée sur la colonne à indexer, comme dans cet exemple classique :
alors PostgreSQL n’utilisera pas l’index sur ma_date. Il faut réécrire la requête ainsi :
Dans l’exemple suivant, on cherche les commandes dont la date tronquée au mois correspond au 1er janvier, c’est-à-dire aux commandes dont la date est entre le 1er et le 31 janvier. Pour un humain, la logique est évidente, mais l’optimiseur n’en a pas connaissance.
Il faut plutôt écrire :
Dans certains cas, la réécriture est impossible (fonction complexe, code non modifiable…). Nous verrons qu’un index fonctionnel peut parfois être la solution.
Ces exemples semblent évidents, mais il peut être plus compliqué de trouver dans l’urgence la cause du problème dans une grande requête d’un schéma mal connu.
1.4.3 Index inutilisable à cause d’un LIKE ‘…%’
- Solution :
Si vous avez un index « normal » sur une chaîne texte, certaines recherches de type LIKE n’utiliseront pas l’index. En effet, il faut bien garder à l’esprit qu’un index est basé sur un opérateur précis. Ceci est généralement indiqué correctement dans la documentation, mais pas forcément très intuitif.
Si un opérateur non supporté pour le critère de tri est utilisé, l’index ne servira à rien :
Nous verrons qu’il existe d’autre classes d’opérateurs, permettant d’indexer correctement la requête précédente, et que varchar_pattern_ops est l’opérateur permettant d’indexer la requête précédente.
1.4.4 Index inutilisable car invalide
CREATE INDEX ... CONCURRENTLYpeut échouer
Dans le cas où un index a été construit avec la clause CONCURRENTLY, nous avons vu qu’il peut arriver que l’opération échoue et l’index existe mais reste invalide, et donc inutilisable. Le problème ne se pose pas pour un échec de REINDEX ... CONCURRENTLY, car l’ancienne version de l’index est toujours là et utilisable.
1.5 Indexation B-tree avancée
De nombreuses possibilités d’indexation avancée :
- Index partiels
- Index fonctionnels
- Index couvrants
- Classes d’opérateur
1.5.1 Index partiels
- N’indexe qu’une partie des données :
- Ne sert que si la clause est logiquement équivalente !
- ou partie de la clause (inégalités,
IN)
- ou partie de la clause (inégalités,
- Intérêt : index beaucoup plus petit
Un index partiel est un index ne couvrant qu’une partie des enregistrements. Ainsi, l’index est beaucoup plus petit. En contrepartie, il ne pourra être utilisé que si sa condition est définie dans la requête.
Pour prendre un exemple simple, imaginons un système de « queue », dans lequel des événements sont entrés, et qui disposent d’une colonne traite indiquant si oui ou non l’événement a été traité. Dans le fonctionnement normal de l’application, la plupart des requêtes ne s’intéressent qu’aux événements non traités :
Typiquement, différents applicatifs vont être intéressés par des événements d’un certain type, mais les événements déjà traités ne sont quasiment jamais accédés, du moins via leur état (une requête portant sur traite IS true sera exceptionnelle et ramènera l’essentiel de la table : un index est inutile).
Ainsi, on peut souhaiter indexer le type d’événement, mais uniquement pour les événements non traités :
Si on recherche les événements dont le type est « FACTURATION », sans plus de précision, l’index ne peut évidemment pas être utilisé :
En revanche, si la condition sur l’état de l’événement est précisée, l’index sera utilisé :
Sur ce jeu de données, on peut comparer la taille de deux index, partiels ou non :
Un index composé sur (is_traite,type) serait efficace, mais inutilement gros.
Clauses de requête et clause d’index :
Attention.
Attention ! Les clauses de l’index et du
WHEREdoivent être logiquement équivalentes ! (et de préférence identiques)
Par exemple, dans les requêtes précédentes, un critère traite IS FALSE à la place de NOT traite n’utilise pas l’index (en effet, il ne s’agit pas du même critère à cause de NULL : NULL = false renvoie NULL, mais NULL IS false renvoie false).
Par contre, des conditions mathématiquement plus restreintes que l’index permettent son utilisation :
Mais cet index partiel ne sera pas utilisé pour un critère précédant 2015.
De la même manière, si un index partiel contient une liste de valeurs, IN ()ou NOT IN (), il est en principe utilisable :
1.5.2 Index partiels : cas d’usage
- Données chaudes et froides
- Index dédié à une requête avec une condition fixe
Le cas typique d’utilisation d’un index partiel est celui de l’exemple précédent : une application avec des données chaudes, fréquemment accédées et traitées, et des données froides, qui sont plus destinées à de l’historisation ou de l’archivage. Par exemple, un système de vente en ligne aura probablement intérêt à disposer d’index sur les commandes dont l’état est différent de clôturé : en effet, un tel système effectuera probablement des requêtes fréquemment sur les commandes qui sont en cours de traitement, en attente d’expédition, en cours de livraison mais très peu sur des commandes déjà livrées, qui ne serviront alors plus qu’à de l’analyse statistique.
De manière générale, tout système est susceptible de bénéficier des index partiels s’il doit gérer des données à état dont seul un sous-ensemble de ces états est activement exploité par les requêtes à optimiser. Par exemple, toujours sur cette même table, des requêtes visant à faire des statistiques sur les expéditions pourraient tirer parti de cet index :
Nous avons mentionné précédemment qu’un index est destiné à satisfaire une requête ou un ensemble de requêtes. Donc, si une requête présente fréquemment des critères de ce type :
alors il peut être intéressant de créer un index partiel pour les lignes satisfaisant le critère :
Ces critères sont généralement très liés au fonctionnel de l’application : du point de vue de l’exploitation, il est souvent difficile d’identifier des requêtes dont une valeur est toujours fixe. Encore une fois, l’appropriation des techniques d’indexation par l’équipe de développement permet d’améliorer grandement les performances de l’application.
1.5.3 Index partiels : utilisation
- Éviter les index de type :
- Préférer :
En général, un index partiel doit indexer une colonne différente de celle qui est filtrée (et donc connue). Ainsi, dans l’exemple précédent, la colonne indexée (type) n’est pas celle de la clause WHERE. On pose un critère, mais on s’intéresse aux types d’événements ramenés. Un autre index partiel pourrait porter sur id WHERE NOT traite pour simplement récupérer une liste des identifiants non traités de tous types.
L’intérêt est d’obtenir un index très ciblé et compact, et aussi d’économiser la place disque et la charge CPU de maintenance. Il faut tout de même que les index partiels soient notablement plus petits que les index « génériques » (au moins de moitié). Avec des index partiels spécialisés, il est possible de « précalculer » certaines requêtes critiques en intégrant leurs critères de recherche exacts.
1.5.4 Index fonctionnels : principe
- Un index sur
aest inutilisable pour :
- Indexer le résultat de la fonction :
À partir du moment où une clause WHERE applique une fonction sur une colonne, un index sur la colonne ne permet plus un accès à l’enregistrement.
C’est comme demander à un dictionnaire Anglais vers Français : « Quels sont les mots dont la traduction en français est ‘fenêtre’ ? ». Le tri du dictionnaire ne correspond pas à la question posée. Il nous faudrait un index non plus sur les mots anglais, mais sur leur traduction en français.
C’est exactement ce que font les index fonctionnels : ils indexent le résultat d’une fonction appliquée à l’enregistrement.
L’exemple classique est l’indexation insensible à la casse : on crée un index sur UPPER (ou LOWER) de la chaîne à indexer, et on recherche les mots convertis à la casse souhaitée.
1.5.5 Index fonctionnels : conditions
- Critère identique à la fonction dans l’index
- Fonction impérativement
IMMUTABLE!- délicat avec les conversions de dates/heures
- Ne pas espérer d’Index Only Scan
Il est facile de créer involontairement des critères comportant des fonctions, notamment avec des conversions de type ou des manipulations de dates. Il a été vu plus haut qu’il vaut mieux placer la transformation du côté de la constante. Par exemple, la requête suivante retourne toutes les commandes de l’année 2011, mais la fonction extract est appliquée à la colonne date_commande (type date) et l’index est inutilisable.
L’optimiseur ne peut donc pas utiliser un index :
En réécrivant le prédicat, l’index est bien utilisé :
C’est la solution la plus propre.
Mais dans d’autres cas, une telle réécriture de la requête sera impossible ou très délicate. On peut alors créer un index fonctionnel, dont la définition doit être strictement celle du WHERE :
Ceci fonctionne si date_commande est de type date ou timestamp without timezone.
Fonction immutable :
Cependant, n’importe quelle fonction d’indexation n’est pas utilisable, ou pas pour tous les types. La fonction d’indexation doit être notée IMMUTABLE : cette propriété indique à PostgreSQL que la fonction retournera toujours le même résultat quand elle est appelée avec les mêmes arguments.
En d’autres termes : le résultat de la fonction ne doit dépendre :
- ni du contenu de la base (pas de
SELECTdonc) ; - ni de la configuration, ni de l’environnement (variables d’environnement, paramètres de session, fuseau horaire, formatage…) ;
- ni du temps (
now()ouclock_timestamp()sont interdits, et indirectement les calculs d’âge) ; - ni d’une autre fonction non-déterministe (comme
random()) ou plus généralement non immutable.
Sans ces restrictions, l’endroit dans lequel la donnée est insérée dans l’index serait potentiellement différent à chaque exécution, ce qui est évidemment incompatible avec la notion d’indexation.
Fonction immutable pour un index fonctionnel sur l’année :
Pour revenir à l’exemple précédent : pour calculer l’année, on peut aussi imaginer un index avec la fonction to_char, une autre fonction hélas fréquemment utilisée pour les conversions de date. Au moment de la création d’un tel index, PostgreSQL renvoie l’erreur suivante :
En effet, to_char() n’est pas immutable, juste « stable » et cela dans toutes ses variantes :
magasin=# \df+ to_char
                                    Liste des fonctions
...  Nom   |...résultat|  Type de données des paramètres  |...|Volatibilité|...
+--------+---------+----------------------------------+-+------------+-
...to_char | text    | bigint, text                     | | stable     |...
...to_char | text    | double precision, text           | | stable     |...
...to_char | text    | integer, text                    | | stable     |...
...to_char | text    | interval, text                   | | stable     |...
...to_char | text    | numeric, text                    | | stable     |...
...to_char | text    | real, text                       | | stable     |...
...to_char | text    | timestamp without time zone, text| | stable     |...
...to_char | text    | timestamp with time zone, text   | | stable     |...
(8 lignes)
La raison est que to_char accepte des paramètres de formatage qui dépendent de la session (nom du mois, virgule ou point décimal…). Ce n’est pas une très bonne fonction pour convertir une date ou heure en nombre.
La fonction extract, elle, est bien immutable quand il s’agit de convertir commande.date_commande de date vers une année, comme dans l’exemple plus haut.
De même, extract est immutable avec une entrée de type timestamp without time zone.
Les choses se compliquent si l’on manipule des heures avec fuseau horaire. En effet, il est conseillé de toujours privilégier la variante timestamp with time zone. Cette fois, l’index fonctionnel basé avec extract va poser problème :
En effet la fonction extract n’est pas immutable pour le type timestamp with time zone :
Pour certains timestamps autour du Nouvel An, l’année retournée dépend du fuseau horaire. Le problème se poserait bien sûr aussi si l’on extrayait les jours ou les mois.
Il est possible de « tricher » en figeant le fuseau horaire dans une fonction pour obtenir un type intermédiaire timestamp without time zone, qui ne posera pas de problème :
Ce contournement impose de modifier le critère de la requête. Tant qu’on y est, il peut être plus clair d’enrober l’appel dans une fonction que l’on définira immutable.
Le nom de la fonction est aussi une indication pour les utilisateurs dans d’autres fuseaux.
Certes, on a ici modifié le code de la requête, mais il est parfois possible de contourner ce problème en passant par des vues qui masquent la fonction.
Signalons enfin la fonction date_part : c’est une alternative possible à extract, avec les mêmes soucis et contournement.
À partir de PostgreSQL 16, une autre possibilité existe avec date_trunc car la variante avec timestamp without time zoneest devenue immutable :
Fonction immutable & unaccent :
Il est courant de faire une recherche sur un champ texte « nettoyé », c’est-à-dire débarrassé de ses accents, et généralement converti en minuscule ou majuscules. L’extension unaccent fournie avec PostgreSQL est alors fréquemment utilisée. La fonction du même nom fait un peu plus que supprimer les accents et caractères diacritiques :
Indexer lower (unaccent (nom_champ)) est à première vue impossible car unaccent() est une fonction stable, pas immutable. En effet, elle dépend d’un dictionnaire qui peut être changé par l’utilisateur.
Il est cependant possible de figer le dictionnaire, nommé aussi unaccent, en le fournissant en premier paramètre de la fonction unaccent(). Pour se faciliter la vie, on enrobe tout cela dans une fonction que l’on déclare immutable et que l’on peut indexer :
Noter que le paramètre fixe nettoie ('Ä') a été exécuté avant la planification et donne a dans la requête.
Le fichier unaccent.rules fourni avec PostgreSQL change à chaque version majeure notamment suite aux évolutions d’Unicode.
Attention.
Comme lors de tout changement de comportement de la fonction sous-jacente, l’index doit donc être reconstruit à chaque migration.
change à chaque version majeure
Index Only Scan & index fonctionnel :
Obtenir un Index Only Scan est une optimisation importante pour les requêtes critiques avec peu de champs sur la table.
Attention.
Hélas, en raison d’une limitation du planificateur, les index fonctionnels ne peuvent servir qu’à la sélection de lignes et ne permettent pas d’Index Only Scan.
Par exemple, on aurait pu espérer un Index Only Scan ici :
Il ne faut pas lire le plan trop vite. Un Index Only Scan peut apparaître si le champ paramètre de la fonction est aussi indexé, alors que l’index sur le résultat de la fonction est ignoré. Ci-dessous, l’index sur date_commande est intégralement parcouru :
Comme lors d’un Seq Scan, on a alors un recalcul pour chaque valeur de date_commande, ce qui peut être très consommateur.
Comme solution, il est possible de sacrifier un peu d’espace disque pour une colonne générée stockée et son index. Une colonne générée stockée est mise à jour en même temps que le(s) champ(s) source. Elle s’indexe et s’utilise comme une colonne normale :
L’Index Only Scan apparaît bien ici.
Avec un champ JSON, où la fonction champ->>'attribut' est couramment utilisée, cette astuce peut être très utile.
1.5.6 Index fonctionnels : maintenance
- Ne pas oublier
ANALYZEaprès création d’un index fonctionnel- les statistiques peuvent même être l’intérêt majeur
- La fonction ne doit jamais tomber en erreur
- Si modification de la fonction
- réindexation
Statistiques :
Après la création de l’index fonctionnel, un ANALYZE nom_table est conseillé : en effet, l’optimiseur ne peut utiliser les statistiques déjà connues pour le résultat d’une fonction. Par contre, PostgreSQL peut créer des statistiques sur le résultat de la fonction pour chaque ligne. Ces statistiques seront visibles dans la vue système pg_stats (tablename contient le nom de l’index, et non celui de la table !).
Ces statistiques à jour sont d’ailleurs un des intêrêts de l’index fonctionnel, même si l’index lui-même est superflu. Dans ce cas, on pourra utiliser CREATE STATISTICS sur l’expression pour ne pas avoir à créer et maintenir un index entier.
Avertissements :
Prudence.
La fonction ne doit jamais tomber en erreur ! Il ne faut pas tester l’index qu’avec les données en place, mais aussi avec toutes celles susceptibles de se trouver dans le champ concerné. Sinon, il y aura des refus d’insertion ou de mise à jour. Des
ANALYZEouVACUUMpourraient aussi échouer, avec de gros problèmes sur le long terme.
Prudence.
Si le contenu de la fonction est modifié avec
CREATE OR REPLACE FUNCTION, il faudra impérativement réindexer, car PostgreSQL ne le fera pas automatiquement. Sans cela, les résultats des requêtes différeront selon qu’elles utiliseront ou non l’index !
1.5.7 Index couvrants : principe
Les index couvrants :
- répondent à la clause
WHERE - puis ajoutent toutes les colonnes pour la requête :
- But : obtenir un Index Only Scan
Exemple d’index couvrant
Un index couvrant (covering index) cherche à favoriser le nœud d’accès le plus rapide, l’Index Only Scan : l’index doit contenir non seulement les champs servant de critères de recherche, mais aussi tous les champs résultats. Ainsi, il n’y a plus besoin d’interroger la table.
Pour optimiser la requête suivante, un premier index peut porter sur le critère de recherche type_client, ce qui fonctionnera.
Le nœud Index Scan ne précise pas d’où viennent les 909 blocs lus. En fait, une bonne partie provient de la table (précisons que l’index ne fait que 87 blocs). En effet, PostgreSQL doit aller chercher la valeur de client_id dans la table même. Rappelons que l’index ne contient que la valeur et un identifiant d’emplacement physique.
Si l’on ajoute en dernière colonne de l’index le champ client_id, PostgreSQL n’a en principe plus besoin d’aller chercher la valeur du champ résultat dans la table. Le nombre de blocs lus chute alors drastiquement, ce qui est toujours une bonne chose :
Clause INCLUDE
Un index couvrant peut aussi être déclaré avec la clause INCLUDE pour le même résultat :
L’intérêt principal de la clause INCLUDE est de pouvoir se greffer sur des index uniques ou de clés primaires ou étrangères, pour économiser la création et la maintenance d’un index supplémentaire. Accessoirement, aucun CPU n’est gaspillé à trier les champs du INCLUDE. En pratique, cette clause est peu utilisée.
1.5.8 Index couvrants : limites
- D’abord les critères, puis les champs
- L’index devient souvent trop gros
VACUUMfréquent nécessaire !- Pas tous les types d’index
Taille de l’index
L’index doit commencer par les champs servant à la sélection. Les champs liés au résultat doivent être les derniers, ou dans la clause INCLUDE.
Il faut garder à l’esprit que l’ajout de colonnes à un index (avec ou sans clause INCLUDE) augmente sa taille, et qu’elle peut vite devenir rédhibitoire pour le planificateur. Un index couvrant n’est donc utile qu’avec très peu de colonnes dans le résultat.
Ajouter des champs peut avoir un impact sur les performances des requêtes qui n’utilisent pas les colonnes supplémentaires. Il peut donc être nécessaire d’avoir plusieurs index dont les champs se recouvrent pour répondre efficacement à des requêtes différentes.
La taille des enregistrements avec les colonnes incluses ne doit pas dépasser 2,6 ko : au-delà, les insertions ou mises à jour échouent.
La déduplication de l’index n’est pas active sur les index avec INCLUDE, ce qui a un impact supplémentaire sur la taille de l’index, sur le disque et en cache. Ça n’a pas d’importance si l’index principal contient surtout des valeurs différentes (clé primaire…), mais, s’il y a peu de valeurs différentes, il est dommage de perdre l’intérêt de la déduplication. Le planificateur peut là aussi ignorer un index trop gros.
Index couvrant & VACUUM
Dans les plans ci-dessus, la mention Heap Fetches: 0 indique que le nœud n’a pas eu à aller dans la table vérifier que la ligne trouvée est bien vivante. En effet, les informations de visibilité d’une ligne ne figurent pas dans l’index, mais dans la table. Celle-ci possède une visibility map qui désigne les blocs sans ligne morte, où la vérification est inutile. Elle est mise à jour lors d’un VACUUM.
Sur une table active, les Heap Fetches peuvent devenir nombreux et annihiler l’intérêt de l’Index Only Scan.
Attention.
Un
VACUUMfréquent est donc nécessaire pour garantir que la visibility map de la table est à jour, et pour que les Heap Fetches soient très peu nombreux.
Pour rendre l’autovacuum plus agressif sur une table, consulter le module M5 - VACUUM & autovacuum.
Types d’index pouvant être couvrants
Enfin, les méthodes d’accès aux index doivent inclure le support de cette fonctionnalité. C’est le cas pour le B-tree, le GiST et le SP-GiST.
1.5.9 Classes d’opérateurs
Un index utilise des opérateurs de comparaison
Texte : différentes collations = différents tris… complexes
- Index inutilisable sur :
Solution : opérateur
varchar_pattern_ops:- force le tri caractère par caractère, sans la collation
- Plus généralement :
- nombreux autres opérateurs pour d’autres types d’index
Un opérateur sert à indiquer à PostgreSQL comment il doit manipuler un certain type de données. Il y a beaucoup d’opérateurs par défaut, mais il est parfois possible d’en prendre un autre.
Pour l’indexation, il est notamment possible d’utiliser un jeu « alternatif » d’opérateurs de comparaison.
Le cas d’utilisation le plus fréquent dans PostgreSQL est la comparaison de chaîne LIKE 'chaine%'. L’indexation texte « classique » utilise la collation par défaut de la base (en France, généralement fr_FR.UTF-8 ou en_US.UTF-8) ou la collation de la colonne de la table si elle diffère. Cette collation contient des notions de tri. Les règles sont différentes pour chaque collation. Et ces règles sont complexes.
Par exemple, le ß allemand se place entre ss et t (et ce, même en français). En danois, le tri est très particulier car le å et le aa apparaissent après le z.
Il faut être conscient que cela a une influence sur le résultat d’un filtrage :
Il serait donc très complexe de réécrire le LIKE en un BETWEEN, comme le font habituellement tous les SGBD. Certes, en ASCII, ce critère
peut être réécrit ainsi :
mais un tri linguistique est bien plus complexe. Même si l’index est dans la bonne collation, il n’est alors pas facilement utilisable :
La classe d’opérateurs varchar_pattern_ops sert à changer ce comportement :
Ce nouvel index est alors construit sur la comparaison brute des valeurs octales de tous les caractères qu’elle contient. Il devient alors trivial pour l’optimiseur de faire la réécriture :
Cela convient pour un LIKE 'critère%', car le début est fixe, et l’ordre de tri n’influe pas sur le résultat. (Par contre cela ne permet toujours pas d’indexer LIKE %critère%.) Noter la clause Filter qui filtre en deuxième intention ce qui a pu être trouvé dans l’index.
Il existe quelques autres cas d’utilisation d’opclass alternatives, notamment pour utiliser d’autres types d’index que B-tree. Deux exemples :
- indexation d’un JSON (type
jsonb) par un index GIN :
- indexation de trigrammes de textes avec le module
pg_trgmet des index GiST :
Pour plus de détails à ce sujet, se référer à la section correspondant aux classes d’opérateurs.
Conseil.
Ne mettez pas systématiquement
varchar_pattern_opsdans tous les index de chaînes de caractère. Cet opérateur est adapté auLIKE 'critère%mais ne servira pas pour un tri sur la chaîne (ORDER BY). Selon les requêtes et volumétries, les deux index peuvent être nécessaires.
1.6 Conclusion
- Responsabilité de l’indexation
- Compréhension des mécanismes
- Différents types d’index, différentes stratégies
L’indexation d’une base de données est souvent un sujet qui est traité trop tard dans le cycle de l’application. Lorsque celle-ci est gérée à l’étape du développement, il est possible de bénéficier de l’expérience et de la connaissance des développeurs. La maîtrise de cette compétence est donc idéalement transverse entre le développement et l’exploitation.
Le fonctionnement d’un index B-tree est somme toute assez simple, mais il est important de bien l’appréhender pour comprendre les enjeux d’une bonne stratégie d’indexation.
PostgreSQL fournit aussi d’autres types d’index moins utilisés, mais très précieux dans certaines situations : BRIN, GIN, GiST, etc.
1.7 Quiz
1.8 Installation de PostgreSQL depuis les paquets communautaires
L’installation est détaillée ici pour Rocky Linux 8 et 9 (similaire à Red Hat et à d’autres variantes comme Oracle Linux et Fedora), et Debian/Ubuntu.
Elle ne dure que quelques minutes.
Sur Rocky Linux 8, 9 ou 10
Attention.
ATTENTION : Red Hat, CentOS, Rocky Linux fournissent souvent par défaut des versions de PostgreSQL qui ne sont plus supportées. Ne jamais installer les packages
postgresql,postgresql-clientetpostgresql-server! L’utilisation des dépôts du PGDG est fortement conseillée.
Installation du dépôt communautaire :
Les dépôts de la communauté sont sur https://yum.postgresql.org/. Les commandes qui suivent sont inspirées de celles générées par l’assistant sur https://www.postgresql.org/download/linux/redhat/. Il n’y a guère que les informations de version qui diffèrent en fonction de :
- la version majeure de PostgreSQL (ici la 18) ;
- la distribution (ici Rocky Linux 9) ;
- l’architecture (ici x86_64, la plus courante).
Les commandes sont à lancer sous root :
Installation de PostgreSQL 18 (client, serveur, librairies, extensions) :
Les outils clients et les librairies nécessaires seront automatiquement installés.
Une fonctionnalité avancée optionnelle, le JIT (Just In Time compilation), nécessite un paquet séparé.
Création d’une première instance :
C’est optionnel, mais il est conseillé de déclarer PGSETUP_INITDB_OPTIONS, notamment pour forcer les traces en anglais. Depuis la version 18, les sommes de contrôle sont automatiquement activées.
Ce dernier fichier permet de vérifier que tout s’est bien passé et doit finir par :
Chemins :
| Objet | Chemin |
|---|---|
| Binaires | /usr/pgsql-18/bin |
| Répertoire de l’utilisateur postgres | /var/lib/pgsql |
PGDATA par défaut | /var/lib/pgsql/18/data |
| Fichiers de configuration | dans PGDATA/ |
| Traces | dans PGDATA/log |
Configuration :
Modifier postgresql.conf est facultatif pour un premier lancement.
Commandes d’administration habituelles :
Démarrage, arrêt, statut, rechargement à chaud de la configuration, redémarrage :
Test rapide de bon fonctionnement et connexion à psql :
Démarrage de l’instance au lancement du système d’exploitation :
Ouverture du firewall pour le port 5432 :
Voir si le firewall est actif :
Si c’est le cas, autoriser un accès extérieur :
(Rappelons que listen_addresses doit être également modifié dans postgresql.conf.)
Création d’autres instances :
Si des instances de versions majeures différentes doivent être installées, il faut d’abord installer les binaires pour chacune (adapter le numéro dans dnf install ...) et appeler le script d’installation de chaque version. l’instance par défaut de chaque version vivra dans un sous-répertoire numéroté de /var/lib/pgsql automatiquement créé à l’installation. Il faudra juste modifier les ports dans les postgresql.conf pour que les instances puissent tourner simultanément.
Si plusieurs instances d’une même version majeure (forcément de la même version mineure) doivent cohabiter sur le même serveur, il faut les installer dans des PGDATA différents.
- Ne pas utiliser de tiret dans le nom d’une instance (problèmes potentiels avec systemd).
- Respecter les normes et conventions de l’OS : placer les instances dans un nouveau sous-répertoire de
/var/lib/pgsqsl/18/(ou l’équivalent pour d’autres versions majeures).
Pour créer une seconde instance, nommée par exemple infocentre :
- Création du fichier service de la deuxième instance :
- Modification de ce dernier fichier avec le nouveau chemin :
- Option 1 : création d’une nouvelle instance vierge :
Option 2 : restauration d’une sauvegarde : la procédure dépend de votre outil.
Adaptation de
/var/lib/pgsql/18/infocentre/postgresql.conf(port surtout).Commandes de maintenance de cette instance :
- Ouvrir le nouveau port dans le firewall au besoin.
Sur Debian / Ubuntu
L’installation ne varie quasiment pas selon les versions de Debian et Ubuntu. Ce qui suit a été testé sur Debian 10 à 13 et Ubuntu LTS 22.04 et 24.04.
Sauf précision, tout est à effectuer en tant qu’utilisateur root.
Référence : https://apt.postgresql.org/
Installation du dépôt communautaire :
L’installation des dépôts du PGDG est prévue dans le paquet Debian postgresql-common :
Ce dernier ordre créera le fichier du dépôt /etc/apt/sources.list.d/pgdg.list adapté à la distribution en place.
Installation de PostgreSQL 18 :
La méthode la plus propre consiste à modifier la configuration par défaut avant l’installation :
Dans /etc/postgresql-common/createcluster.conf, paramétrer au moins les traces en anglais. Depuis la version 18, les sommes de contrôle sont automatiquement activées.
Puis installer les paquets serveur et clients et leurs dépendances :
La première instance est automatiquement créée, avec un nom (main par défaut`), déclarée comme service à lancer au démarrage du système, puis démarrée.
L’utilisateur système postgres peut y accéder immédiatement.
Chemins :
| Objet | Chemin |
|---|---|
| Binaires | /usr/lib/postgresql/18/bin/ |
| Répertoire de l’utilisateur postgres | /var/lib/postgresql |
| PGDATA de l’instance par défaut | /var/lib/postgresql/18/main |
| Fichiers de configuration | dans /etc/postgresql/18/main/ |
| Traces | dans /var/log/postgresql/ |
Configuration
Modifier postgresql.conf est facultatif pour un premier essai.
Démarrage/arrêt de l’instance, rechargement de configuration :
Debian fournit ses propres outils, qui demandent en paramètre la version et le nom de l’instance :
Démarrage de l’instance avec le serveur :
C’est en place par défaut, et modifiable dans /etc/postgresql/18/main/start.conf.
Ouverture du firewall :
Debian et Ubuntu n’installent pas de firewall par défaut.
Statut des instances du serveur :
Test rapide de bon fonctionnement et connexion à psql :
Destruction d’une instance :
Création d’autres instances :
Ce qui suit est valable pour remplacer l’instance par défaut par une autre, par exemple pour activer les sommes de contrôles (checksums) avant la version v18 :
- optionnellement,
/etc/postgresql-common/createcluster.confpermet de mettre en place tout d’entrée les messages en anglais, le format des traces, l’emplacement séparé pour les journaux ou les checksums pour une version inférieure à 18 :
- créer une instance :
Il est également possible de préciser certains paramètres du fichier postgresql.conf, voire les chemins des fichiers (il est conseillé de conserver les chemins par défaut) :
adapter au besoin
/etc/postgresql/18/infocentre/postgresql.conf;démarrage :
Accès à l’instance depuis le serveur même (toutes distributions)
Par défaut, l’instance n’est accessible que par l’utilisateur système postgres, qui n’a pas de mot de passe. Un détour par sudo est nécessaire :
Ce qui suit permet la connexion directement depuis un utilisateur du système :
Pour des tests (pas en production !), il suffit de passer à trust le type de la connexion en local dans le pg_hba.conf :
La connexion en tant qu’utilisateur postgres (ou tout autre) n’est alors plus sécurisée :
Une authentification par mot de passe est plus sécurisée :
- dans
pg_hba.conf, paramétrer une authentification par mot de passe pour les accès depuislocalhost(déjà en place sous Debian) :
(Ne pas oublier de recharger la configuration en cas de modification.)
- ajouter un mot de passe à l’utilisateur
postgresde l’instance :
- Pour se connecter sans taper le mot de passe à une instance, un fichier
.pgpassdans le répertoire personnel doit contenir les informations sur cette connexion :
Ce fichier doit être protégé des autres utilisateurs :
- Pour n’avoir à taper que
psql, on peut définir ces variables d’environnement dans la session voire dans~/.bashrc:
Rappels :
- en cas de problème, consulter les traces (dans
/var/lib/pgsql/18/data/logou/var/log/postgresql/) ; - toute modification de
pg_hba.confoupostgresql.confimpliquant de recharger la configuration peut être réalisée par une de ces trois méthodes en fonction du système :
1.9 Travaux pratiques
Les corrigés détaillés sont disponibles dans la section Travaux pratiques (solutions).
La version en ligne des solutions de ces TP est disponible sur https://dali.bo/j4_solutions.
Tous les TP se basent sur la configuration par défaut de PostgreSQL, sauf précision contraire.
Cette série de question utilise la base magasin. Si vous ne l’avez pas déjà, la base magasin (dump de 96 Mo, pour 667 Mo sur le disque au final) peut être téléchargée et restaurée comme suit dans une nouvelle base magasin :
Les données sont dans deux schémas, magasin et facturation. Penser au search_path.
Pour ce TP, figer les paramètres suivants :
1.9.1 Index « simples »
But : Mettre en avant un cas d’usage d’un index « simple »
Considérons le cas d’usage d’une recherche de commandes par date. Le besoin fonctionnel est le suivant : renvoyer l’intégralité des commandes passées au mois de janvier 2014.
Créer la requête affichant l’intégralité des commandes passées au mois de janvier 2014.
Afficher le plan de la requête , en utilisant
EXPLAIN (ANALYZE, BUFFERS). Que constate-t-on ?
Nous souhaitons désormais afficher les résultats à l’utilisateur par ordre de date croissante.
Réécrire la requête par ordre de date croissante. Afficher de nouveau son plan. Que constate-t-on ?
Maintenant, nous allons essayer d’optimiser ces deux requêtes.
Créer un index permettant de répondre à ces requêtes.
Afficher de nouveau le plan des deux requêtes. Que constate-t-on ?
Maintenant, étudions l’impact des index pour une opération de jointure. Le besoin fonctionnel est désormais de lister toutes les commandes associées à un client (admettons, dont le client_id vaut 3), avec les informations du client lui-même.
Écrire la requête affichant
commandes.numero_commandeetclients.type_clientpourclient_id = 3. Afficher son plan. Que constate-t-on ?
Créer un index pour accélérer cette requête.
Afficher de nouveau son plan. Que constate-t-on ?
1.9.2 Sélectivité
But : Comprendre la sélectivité des index.
Écrire une requête renvoyant l’intégralité des clients qui sont du type entreprise (‘E’), une autre pour l’intégralité des clients qui sont du type particulier (‘P’).
Ajouter un index sur la colonne
type_client, et rejouer les requêtes précédentes.
Afficher leurs plans d’exécution. Que se passe-t-il ? Pourquoi ?
1.9.3 Index partiels
But : Mettre en avant un cas d’usage d’un index partiel
Sur la base fournie pour les TPs, les lots non livrés sont constamment requêtés. Notamment, un système d’alerte est mis en place afin d’assurer un suivi qualité sur les lots expédié depuis plus de 3 jours (selon la date d’expédition), mais non réceptionné (date de réception à NULL).
Écrire la requête correspondant à ce besoin fonctionnel (il est normal qu’elle ne retourne rien).
Afficher le plan d’exécution.
Quel index partiel peut-on créer pour optimiser ?
Afficher le nouveau plan d’exécution et vérifier l’utilisation du nouvel index.
1.9.4 Index fonctionnels
But : Cas d’usage d’un index fonctionnel
Pour répondre aux exigences de stockage, l’application a besoin de pouvoir trouver rapidement les produits dont le volume est compris entre certaines bornes (nous négligeons ici le facteur de forme, qui est problématique dans le cadre d’un véritable stockage en entrepôt !).
Écrire une requête permettant de renvoyer l’ensemble des produits (table
magasin.produits) dont le volume ne dépasse pas 1 litre (les unités de longueur sont en mm, 1 litre = 1 000 000 mm3).
Quel index permet d’optimiser cette requête ? (Utiliser une fonction est possible, mais pas obligatoire.)
1.9.5 Cas d’index non utilisés
But : Mettre en avant des cas d’index inutilisés
Un développeur cherche à récupérer les commandes dont le numéro d’expédition est 190774 avec cette requête :
Afficher le plan de la requête.
Créer un index pour améliorer son exécution.
L’index est-il utilisé ? Quel est le problème ?
Écrire une requête pour obtenir les commandes dont la quantité est comprise entre 1 et 8 produits.
Créer un index pour améliorer l’exécution de cette requête.
Pourquoi celui-ci n’est-il pas utilisé ? (Conseil : regarder la vue
pg_stats)
Faire le test avec les commandes dont la quantité est comprise entre 1 et 4 produits.
1.10 Travaux pratiques (solutions)
Tout d’abord, nous positionnons le search_path pour chercher les objets des schémas magasin et facturation :
Index « simples »
Considérons le cas d’usage d’une recherche de commandes par date. Le besoin fonctionnel est le suivant : renvoyer l’intégralité des commandes passées au mois de janvier 2014.
Créer la requête affichant l’intégralité des commandes passées au mois de janvier 2014.
Pour renvoyer l’ensemble de ces produits, la requête est très simple :
Afficher le plan de la requête , en utilisant
EXPLAIN (ANALYZE, BUFFERS). Que constate-t-on ?
Le plan de celle-ci est le suivant :
Réécrire la requête par ordre de date croissante. Afficher de nouveau son plan. Que constate-t-on ?
Ajoutons la clause ORDER BY :
On constate ici que lors du parcours séquentiel, 980 854 lignes ont été lues, puis écartées car ne correspondant pas au prédicat, nous laissant ainsi avec un total de 19 146 lignes. Les valeurs précises peuvent changer, les données étant générées aléatoirement. De plus, le tri a été réalisé en mémoire. On constate de plus que 10 200 blocs ont été parcourus, ici depuis le cache, mais ils auraient pu l’être depuis le disque.
Créer un index permettant de répondre à ces requêtes.
Création de l’index :
Afficher de nouveau le plan des deux requêtes. Que constate-t-on ?
Le temps d’exécution a été réduit considérablement : la requête est 7 fois plus rapide. On constate notamment que seuls 221 blocs ont été parcourus.
Pour la requête avec la clause ORDER BY, nous obtenons le plan d’exécution suivant :
Celui-ci est identique ! En effet, l’index permettant un parcours trié, l’opération de tri est ici « gratuite ».
Écrire la requête affichant
commandes.numero_commandeetclients.type_clientpourclient_id = 3. Afficher son plan. Que constate-t-on ?
Créer un index pour accélérer cette requête.
Afficher de nouveau son plan. Que constate-t-on ?
On constate ici un temps d’exécution divisé par 400 : en effet, on ne lit plus que 13 blocs pour la commande (3 pour l’index, 10 pour les données) au lieu de 10 200.
Sélectivité
Écrire une requête renvoyant l’intégralité des clients qui sont du type entreprise (‘E’), une autre pour l’intégralité des clients qui sont du type particulier (‘P’).
Les requêtes :
Ajouter un index sur la colonne
type_client, et rejouer les requêtes précédentes.
Pour créer l’index :
Afficher leurs plans d’exécution. Que se passe-t-il ? Pourquoi ?
Les plans d’éxécution :
L’optimiseur sait estimer, à partir des statistiques (consultables via la vue pg_stats), qu’il y a approximativement 89 000 clients particuliers, contre 8 000 clients entreprise.
Dans le premier cas, la majorité de la table sera parcourue, et renvoyée : il n’y a aucun intérêt à utiliser l’index.
Dans l’autre, le nombre de lignes étant plus faible, l’index est bel et bien utilisé (via un Bitmap Scan, ici).
Index partiels
Sur la base fournie pour les TPs, les lots non livrés sont constamment requêtés. Notamment, un système d’alerte est mis en place afin d’assurer un suivi qualité sur les lots expédié depuis plus de 3 jours (selon la date d’expédition), mais non réceptionné (date de réception à NULL).
Écrire la requête correspondant à ce besoin fonctionnel (il est normal qu’elle ne retourne rien).
La requête est la suivante :
Afficher le plan d’exécution.
Le plans (ci-dessous avec ANALYZE) opère un Seq Scan parallélisé, lit et rejette toutes les lignes, ce qui est évidemment lourd :
Quel index partiel peut-on créer pour optimiser ?
On peut optimiser ces requêtes sur les critères de recherche à l’aide des index partiels suivants :
Afficher le nouveau plan d’exécution et vérifier l’utilisation du nouvel index.
Il est intéressant de noter que seul le test sur la condition indexée (date_expedition) est présent dans le plan : la condition date_reception IS NULL est implicitement validée par l’index partiel.
Attention, il peut être tentant d’utiliser une formulation de la sorte pour ces requêtes :
D’un point de vue logique, c’est la même chose, mais l’optimiseur n’est pas capable de réécrire cette requête correctement. Ici, le nouvel index sera tout de même utilisé, le volume de lignes satisfaisant au critère étant très faible, mais il ne sera pas utilisé pour filtrer sur la date :
La ligne importante et différente ici concerne le Filter en lieu et place du Index Cond du plan précédent. Ici tout l’index partiel (certes tout petit) est lu intégralement et les lignes testées une à une.
C’est une autre illustration des points vus précédemment sur les index non utilisés.
Index fonctionnel
Ce TP utilise la base magasin.
Écrire une requête permettant de renvoyer l’ensemble des produits (table
magasin.produits) dont le volume ne dépasse pas 1 litre (les unités de longueur sont en mm, 1 litre = 1 000 000 mm3).
Concernant le volume des produits, la requête est assez simple :
Quel index permet d’optimiser cette requête ? (Utiliser une fonction est possible, mais pas obligatoire.)
L’option la plus simple est de créer l’index de cette façon, sans avoir besoin d’une fonction :
En général, il est plus propre de créer une fonction. On peut passer la ligne entière en paramètre pour éviter de fournir 3 paramètres. Il faut que cette fonction soit IMMUTABLE pour être indexable :
(Elle est même PARALLEL SAFE pour la même raison qu’elle est IMMUTABLE : elle dépend uniquement des données de la table.)
On peut ensuite indexer le résultat de cette fonction :
Il est ensuite possible d’écrire la requête de plusieurs manières, la fonction étant ici écrite en SQL et non en PL/pgSQL ou autre langage procédural :
En effet, l’optimiseur est capable de « regarder » à l’intérieur de la fonction SQL pour déterminer que les clauses sont les mêmes, ce qui n’est pas vrai pour les autres langages.
En revanche, la requête suivante, où la multiplication est faite dans un ordre différent, n’utilise pas l’index :
et c’est notamment pour cette raison qu’il est plus propre d’utiliser la fonction.
De part l’origine « relationnel-objet » de PostgreSQL, on peut même écrire la requête de la manière suivante :
Cas d’index non utilisés
Afficher le plan de la requête.
Le moteur fait un parcours séquentiel et retire la plupart des enregistrements pour n’en conserver que 6.
Créer un index pour améliorer son exécution.
L’index est-il utilisé ? Quel est le problème ?
L’index n’est pas utilisé à cause de la conversion bigint vers numeric. Il est important d’utiliser les bons types :
Sans conversion la requête est bien plus rapide. Faites également le test sans index, le Seq Scan sera également plus rapide, le moteur n’ayant pas à convertir toutes les lignes parcourues.
Écrire une requête pour obtenir les commandes dont la quantité est comprise entre 1 et 8 produits.
Créer un index pour améliorer l’exécution de cette requête.
Pourquoi celui-ci n’est-il pas utilisé ? (Conseil : regarder la vue
pg_stats)
La table pg_stats nous donne des informations de statistiques. Par exemple, pour la répartition des valeurs pour la colonne quantite:
Ces quelques lignes nous indiquent qu’il y a 10 valeurs distinctes et qu’il y a environ 10 % d’enregistrements correspondant à chaque valeur.
Avec le prédicat quantite BETWEEN 1 and 8, le moteur estime récupérer environ 80 % de la table. Il est donc bien plus coûteux de lire l’index et la table pour récupérer 80 % de la table. C’est pourquoi le moteur fait un Seq Scan qui moins coûteux.
Faire le test avec les commandes dont la quantité est comprise entre 1 et 4 produits.
Cette fois, la sélectivité est différente et le nombre d’enregistrements moins élevé. Le moteur passe donc par un parcours d’index.
Cet exemple montre qu’on indexe selon une requête et non selon une table.
Source : manuel complet PDF, révision 26.09, pages PDF 13-84. Les énoncés de TP et les solutions proviennent de la version complète.