Index GIN, GiST, BRIN, hash, bloom, indexation de motifs et outils d’analyse.
PERF2
2/ Indexation avancée
Ce chapitre reprend l’intégralité des pages PDF 85-142 du manuel complet PERF2, y compris les énoncés de travaux pratiques et les solutions. Les rappels du chapitre 1 sont accessibles dans Fonctionnement d’un index.
Figure 2-1Figure 2-1 - Indexation avancée.
2.1 Index Avancés
De nombreuses fonctionnalités d’indexation sont disponibles dans PostgreSQL :
Index B-tree
multicolonnes
fonctionnels
partiels
couvrants
Classes d’opérateurs
Indexation GIN, GiST, BRIN, hash, bloom
Indexation de motifs
Indexation multicolonnes
PostgreSQL fournit de nombreux types d’index, afin de répondre à des problématiques de recherches complexes.
2.2 Index B-tree (rappels)
Index B-tree fonctionnel, multicolonnes, partiel, couvrant :
requête cible :
Exemple 2-1Exemple 2-1 de code ou de sortie extrait du manuel PERF2.
Rappelons que l’index classique est créé comme ceci :
Exemple 2-3Exemple 2-3 de code ou de sortie extrait du manuel PERF2.
CREATEINDEXmon_indexONma_table(ma_colonne);
B-tree (en arbre équilibré) est le type d’index le plus fréquemment utilisé.
Toutes les fonctionnalités vues précédemment peuvent être utilisées simultanément.
Il est parfois tentant de créer des index très spécialisés pour des requêtes, comme dans l’exemple ci-dessus, et c’est possible pour des requêtes vraiment critiques. Mais il ne faut surtout pas perdre de vue qu’un index est une structure lourde à mettre à jour, comparativement à une table. Une table avec un seul index est environ 3 fois plus lente qu’une table nue, et chaque index ajoute le même surcoût. Il est donc souvent plus judicieux d’avoir des index pouvant répondre à plusieurs requêtes différentes, et de ne pas trop les spécialiser. Il faut trouver un juste compromis entre le gain à la lecture et le surcoût à la mise à jour. Une base de BI contiendra généralement beaucoup plus d’index qu’une base opérationnelle.
2.3 Index GIN
Un autre type d’index
Définition
Utilisation avec des données non structurées
Utilisation avec des données scalaires
Création
Mise à jour
Les index B-tree sont les plus utilisés, mais PostgreSQL propose d’autres types d’index. Le type GIN est l’un des plus connus.
2.3.1 GIN : définition & données non structurées
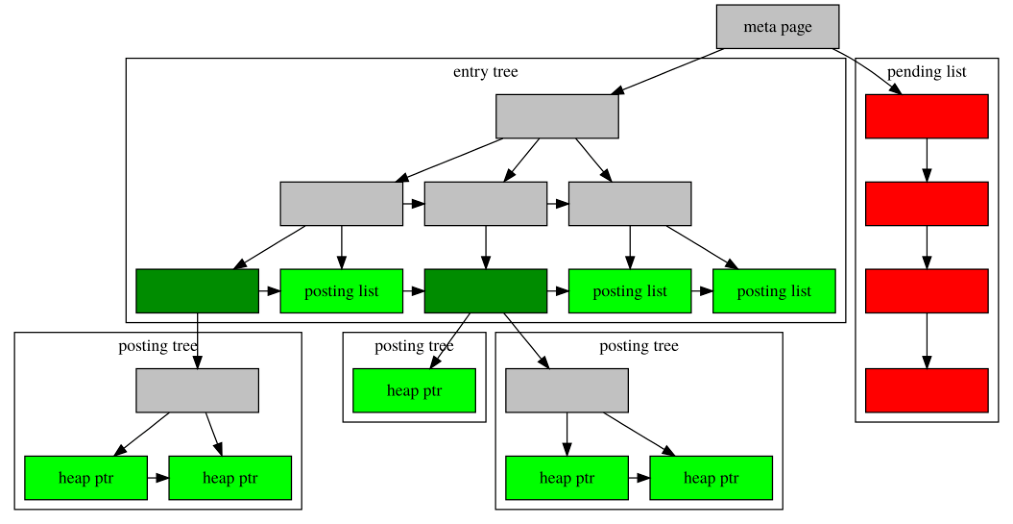
Figure 2-2Figure 2-2 - Schéma des index GIN, documentation officielle de PostgreSQL, licence PostgreSQL.
GIN : Generalized Inverted iNdex
Index inversé généralisé
les champs sont décomposés en éléments (par API)
l’index associe une valeur à la liste de ses adresses
Pour chaque entrée du tableau
liste d’adresses où le trouver
Utilisation principale : données non scalaires
tableaux, listes, non structurées…
Un index inversé est une structure classique, utilisée le plus souvent dans l’indexation Full Text. Le principe est de décomposer un document en sous-structures, et ce sont ces éléments qui seront indexées. Par exemple, un document sera décomposé en la liste de ses mots, et chaque mot sera une clé de l’index. Cette clé fournira la liste des documents contenant ce mot. C’est l’inverse d’un index B-tree classique, qui va lister chacune des occurrences d’une valeur et y associer sa localisation.
Par analogie : dans un livre de cuisine, un index classique permettrait de chercher « Crêpes au caramel à l’armagnac » et « Sauce caramel et beurre salé », alors qu’un index GIN contiendrait « caramel », « crêpes », « armagnac », « sauce », « beurre »…
Pour plus de détails sur la structure elle-même, cet article Wikipédia est une lecture conseillée.
Dans l’implémentation de PostgreSQL, un index GIN est construit autour d’un index B-tree des éléments indexés, et à chacun est associé soit une simple liste de pointeurs vers la table (posting list) pour les petites listes, soit un pointeur vers un arbre B-tree contenant ces pointeurs (posting tree). La pending list est une optimisation des écritures (voir plus bas).
Les index GIN de PostgreSQL sont « généralisés », car ils sont capables d’indexer n’importe quel type de données, à partir du moment où on leur fournit les différentes fonctions d’API permettant le découpage et le stockage des différents items composant la donnée à indexer. En pratique, ce sont les opérateurs indiqués à la création de l’index, parfois implicites, qui contiendront la logique nécessaire.
Les index GIN sont des structures lentes à la mise à jour. Par contre, elles sont extrêmement efficaces pour les interrogations multicritères, ce qui les rend très appropriées pour l’indexation Full Text, des champs jsonb…
2.3.2 GIN et les tableaux
Quels tableaux contiennent une valeur donnée ?
Opérateurs : @>, <@, =, &&, ?, ?|, ?&
Exemple 2-4Exemple 2-4 de code ou de sortie extrait du manuel PERF2.
SELECT*FROMmatableWHEREa@>ARRAY[42];
Exemple 2-5Exemple 2-5 de code ou de sortie extrait du manuel PERF2.
CREATEINDEXONtabloUSINGgin(a);
Champs concaténés : transformer en tableaux
Exemple 2-6Exemple 2-6 de code ou de sortie extrait du manuel PERF2.
Comme premier exemple d’indexation d’un champ structuré, prenons une table listant des voitures, dont un champ caracteristiques contient une liste d’attributs séparés par des virgules. Ceci ne respecte bien entendu pas la première forme normale.
Cette liste peut être transformée facilement en tableau avec regexp_split_to_array. Des opérateurs de manipulation peuvent alors être utilisés, comme : @> (contient), <@ (contenu par), && (a des éléments en communs). Par exemple, pour chercher les voitures possédant deux caractéristiques données, la requête est :
Exemple 2-8Exemple 2-8 de code ou de sortie extrait du manuel PERF2.
Un index B-tree classique permet de rechercher un tableau identique à un autre, mais pas de chercher un tableau qui contient une valeur scalaire à l’intérieur du tableau :
Exemple 2-11Exemple 2-11 de code ou de sortie extrait du manuel PERF2.
                   QUERY PLAN
-------------------------------------------------
 Bitmap Heap Scan on tablo
   Recheck Cond: (a = '{42,43}'::integer[])
   ->  Bitmap Index Scan on tablo_a_idx
         Index Cond: (a = '{42,43}'::integer[])
Tableau 2-4Tableau ou sortie 2-4 extraite du manuel PERF2.Exemple 2-12Exemple 2-12 de code ou de sortie extrait du manuel PERF2.
SELECT*FROMtabloWHEREa@>ARRAY[42];
 i  |    a
----+---------
 41 | {41,42}
 42 | {42,43}
Tableau 2-5Tableau ou sortie 2-5 extraite du manuel PERF2.Exemple 2-13Exemple 2-13 de code ou de sortie extrait du manuel PERF2.
                          QUERY PLAN
--------------------------------------------------------------
 Seq Scan on tablo (actual time=0.023..19.322 rows=2 loops=1)
   Filter: (a @> '{42}'::integer[])
   Rows Removed by Filter: 99998
   Buffers: shared hit=834
 Planning:
   Buffers: shared hit=6 dirtied=1
 Planning Time: 0.107 ms
 Execution Time: 19.337 ms
Tableau 2-6Tableau ou sortie 2-6 extraite du manuel PERF2.
L’indexation GIN permet de chercher des valeurs figurant à l’intérieur des champs indexés :
Exemple 2-14Exemple 2-14 de code ou de sortie extrait du manuel PERF2.
CREATEINDEXONtabloUSINGgin(a);
pour un résultat beaucoup plus efficace :
 Bitmap Heap Scan on tablo (actual time=0.010..0.010 rows=2 loops=1)
   Recheck Cond: (a @> '{42}'::integer[])
   Heap Blocks: exact=1
   Buffers: shared hit=5
   ->  Bitmap Index Scan on tablo_a_idx1 (actual time=0.007..0.007 rows=2 loops=1)
         Index Cond: (a @> '{42}'::integer[])
         Buffers: shared hit=4
 Planning:
   Buffers: shared hit=23
 Planning Time: 0.121 ms
 Execution Time: 0.023 ms
Tableau 2-7Tableau ou sortie 2-7 extraite du manuel PERF2.
2.3.3 GIN pour les JSON et les textes
JSON :
opérateur jsonb_path_ops ou jsonb_ops
Indexation de trigrammes
extensions pg_trgm (opérateur dédié gin_trgm_ops)
Recherche Full Text
indexe les vecteurs
Le principe est le même pour des JSON, s’ils sont bien stockés dans un champ de type jsonb. Les recherches de l’existence d’une clé à la racine du document ou tableau JSON sont réalisées avec les opérateurs ?, ?| et ?&.
Exemple 2-15Exemple 2-15 de code ou de sortie extrait du manuel PERF2.
          x          | b existe | c existe
---------------------+----------+----------
 {"b": {"c": "ccc"}} | t        | f
Tableau 2-8Tableau ou sortie 2-8 extraite du manuel PERF2.
Les recherches sur la présence d’une valeur dans un document JSON avec les opérateurs @>, @? ou @@ peuvent être réalisées avec la classe d’opérateur par défaut (json_ops), mais aussi la classe d’opérateur jsonb_path_ops, donc au choix :
Exemple 2-16Exemple 2-16 de code ou de sortie extrait du manuel PERF2.
La classe jsonb_path_ops est plus performante pour ce genre de recherche et génère des index plus compacts lorsque les clés apparaissent fréquemment dans les données. Par contre, elle ne permet pas d’effectuer efficacement des recherches de structure JSON vide du type : { "a" : {} }. Dans ce dernier cas, PostgreSQL devra faire, au mieux, un parcours de l’index complet, au pire un parcours séquentiel de la table. Le choix de la meilleure classe pour l’index dépend fortement de la typologie des données.
L’extension fournit un opérateur dédié pour l’indexation (voir plus loin).
La recherche Full Text est généralement couplée à un index GIN pour indexer les tsvector (voir le module S80).
2.3.4 GIN & données scalaires
Données scalaires aussi possibles
avec l’extension btree_gin
GIN compresse quand les données se répètent
alternative à bitmap !
Grâce à l’extension btree_gin, fournie avec PostgreSQL, l’indexation GIN peut aussi s’appliquer aux scalaires. Il est ainsi possible d’indexer un ensemble de colonnes, par exemple d’entiers ou de textes (voir exemple plus loin). Cela peut servir dans les cas où une requête multicritères peut porter sur de nombreux champs différents, dont aucun n’est obligatoire. Un index B-tree est là moins adapté, voire inutilisable.
Un autre cas d’utilisation traditionnel est celui des index dits bitmap. Les index bitmap sont très compacts, mais ne permettent d’indexer que peu de valeurs différentes. Un index bitmap est une structure utilisant 1 bit par enregistrement pour chaque valeur indexable. Par exemple, on peut définir un index bitmap sur le sexe : deux valeurs seulement (voire quatre si on autorise NULL ou non-binaire) sont possibles. Indexer un enregistrement nécessitera donc un ou deux bits. Le défaut des index bitmap est que l’ajout de nouvelles valeurs est très peu performant car l’index nécessite d’importantes réécritures à chaque ajout. De plus, l’ajout de données provoque une dégradation des performances puisque la taille par enregistrement devient bien plus grosse.
Les index GIN permettent un fonctionnement sensiblement équivalent au bitmap : chaque valeur indexable contient la liste des enregistrements répondant au critère, et cette liste a l’intérêt d’être compressée. Par exemple, sur une base créée avec pgbench, de taille 100, avec les options par défaut :
Exemple 2-19Exemple 2-19 de code ou de sortie extrait du manuel PERF2.
                               QUERY PLAN
-------------------------------------------------------------------------------
 Bitmap Heap Scan on pgbench_accounts (actual time=7.505..19.931 rows=100000 loops=1)
   Recheck Cond: (bid = 5)
   Heap Blocks: exact=1640
   Buffers: shared hit=1657
   ->  Bitmap Index Scan on pgbench_accounts_gin_idx (actual time=7.245..7.245 rows=100000 loops=1)
         Index Cond: (bid = 5)
         Buffers: shared hit=17
 Planning:
   Buffers: shared hit=2
 Planning Time: 0.080 ms
 Execution Time: 24.090 ms
Tableau 2-9Tableau ou sortie 2-9 extraite du manuel PERF2.
Dans ce cas précis qui renvoie de nombreuses lignes, l’utilisation du GIN est même aussi efficace que le B-tree ci-dessous, car l’index GIN est mieux compressé et a besoin de lire moins de blocs :
Exemple 2-20Exemple 2-20 de code ou de sortie extrait du manuel PERF2.
                               QUERY PLAN
-------------------------------------------------------------------------------
 Index Scan using pgbench_accounts_btree_idx on pgbench_accounts (actual time=0.008..19.138 rows=100000 loops=1)
   Index Cond: (bid = 5)
   Buffers: shared hit=1728
 Planning:
   Buffers: shared hit=18
 Planning Time: 0.117 ms
 Execution Time: 23.369 ms
Tableau 2-10Tableau ou sortie 2-10 extraite du manuel PERF2.
L’index GIN est en effet environ 5 fois plus compact que le B-tree dans cet exemple simple, avec 100 valeurs distinctes de bid :
pgbench_300=# \di+ pgbench_accounts_*
                   Liste des relations
 Schéma |            Nom             | ... | Méthode d'accès | Taille | Description
--------+----------------------------+---+-----------------+--------+-------------
 public | pgbench_accounts_bid_idx   | ... | btree           | 66 MB  |
 public | pgbench_accounts_gin_idx   | ... | gin             | 12 MB  |
Tableau 2-11Tableau ou sortie 2-11 extraite du manuel PERF2.
Ce ne serait pas le cas avec des valeurs toutes différentes. (Avant la version 13, la différence de taille était encore plus importante car les index B-tree ne disposaient pas encore de la déduplication des clés.)
Avant de déployer un index GIN, il faut vérifier l’impact du GIN sur les performances en insertions et mises à jour et l’impact sur les requêtes.
2.3.5 GIN : création et mise à jour
Création lourde
maintenance_work_mem élevé
mais parallélisation possible (v18+)
Mise à jour lente
d’où l’option fastupdate
… à désactiver si temps de réponse instable !
Les index GIN sont lourds à créer et à mettre à jour. Une valeur élevée de maintenance_work_mem est conseillée.
À partir de PostgreSQL 18, la création d’un index GIN peut être parallélisée. Comme cet index est intéressant surtout sur de grosses tables, la durée est sérieusement réduite. Le nombre de processus parallèles est réglé par max_parallel_maintenance_workers. Dans les versions précédentes, un seul processeur est malheureusement utilisable lors de la création.
L’option fastupdate permet une mise à jour bien plus rapide. Elle est activée par défaut. PostgreSQL stocke alors les mises à jour de l’index dans une pending list qui est intégrée en bloc, notamment lors d’un VACUUM. Sa taille peut être modifiée par le paramètre gin_pending_list_limit, par défaut à 4 Mo, et au besoin surchargeable sur chaque index.
L’inconvénient de cette technique est que le temps de réponse de l’index devient instable : certaines recherches peuvent être très rapides et d’autres très lentes. Le seul moyen d’accélérer ces recherches est de désactiver fastupdate. Cela permet en plus d’éviter la double écriture dans les journaux de transactions. Mais il y a un impact : les mises à jour de l’index sont bien plus lentes.
Il faut donc faire un choix. Si l’on conserve l’option fastupdate, il faut surveiller la fréquence de passage de l’autovacuum. L’appel manuel à la fonction gin_clean_pending_list() est une autre option.
Indexation non plus des valeurs mais de la véracité de prédicats
Moins performants que B-tree (moins sélectifs)
Moins lourds que GIN
Initialement, les index GiST sont un produit de la recherche de l’université de Berkeley. L’idée fondamentale est de pouvoir indexer non plus les valeurs dans l’arbre B-tree, mais plutôt la véracité d’un prédicat : « ce prédicat est vrai sur telle sous-branche ». On dispose donc d’une API permettant au type de données d’informer le moteur GiST d’informations comme : « quel est le résultat de la fusion de tel et tel prédicat » (pour pouvoir déterminer le prédicat du nœud parent), quel est le surcoût d’ajout de tel prédicat dans telle ou telle partie de l’arbre, comment réaliser un split (découpage) d’une page d’index, déterminer la distance entre deux prédicats, etc.
Tout ceci est très virtuel, et rarement re-développé par les utilisateurs. Par contre, certaines extensions et outils intégrés utilisent ce mécanisme.
Il faut retenir qu’un index GiST est moins performant qu’un B-tree si ce dernier est possible.
L’utilisation se recoupant en partie avec les index GIN, il faut noter que :
les index GiST ont moins tendance à se fragmenter que les GIN, même si cela dépend énormément du type de mises à jour ;
les index GiST sont moins lourds à maintenir ;
mais généralement moins performants.
2.4.1 GiST : cas d’usage
Le GiST indexe à peu près n’importe quoi
géométries (PostGIS)
intervalles, adresses IP, FTS…
D’autres usages recouvrent en partie ceux de GIN.
Un index GiST permet d’indexer n’importe quoi, quelle que soit la dimension, le type, tant qu’on peut utiliser des prédicats sur ce type.
Il est disponible pour les types natifs suivants :
géométriques (box, circle, point, poly) : le projet PostGIS utilise les index GiST massivement, pour répondre efficacement à des questions complexes telles que « quelles sont les routes qui coupent le Rhône ? », « quelles sont les villes adjacentes à Toulouse ? », « quels sont les restaurants situés à moins de 3 km de la Nationale 12 ? » ;
range (d’int, de timestamp…) ;
adresses IP/CIDR.
Full Text Search.
Une partie des cas d’utilisation des index GiST recouvre ceux des index GIN. Nous verrons que les index GiST sont notamment utilisés par :
les contraintes d’exclusion ;
les recherches multicolonnes ;
l’extension pg_trgm (dans ce cas, GiST est moins efficace que GIN pour la recherche exacte, mais permet de rapidement trouver les N enregistrements les plus proches d’une chaîne donnée, sans tri, et est plus compact).
Les index GiST et SP-GiST supportent les requêtes de type K-plus proche voisins, et permettent donc de répondre extrêmement rapidement à des requêtes telles que :
quels sont les dix restaurants les plus proches d’un point particulier ?
quels sont les 5 mots ressemblant le plus à « éphélant » ? afin de proposer des corrections à un utilisateur ayant commis une faute de frappe (par exemple).
Une convention veut que l’opérateur distance soit généralement nommé « <-> », mais rien n’impose ce choix.
On peut prendre l’exemple d’indexation ci-dessus, avec le type natif point :
Exemple 2-23Exemple 2-23 de code ou de sortie extrait du manuel PERF2.
Une contrainte UNIQUE avec un index B-tree permet de s’assurer qu’il n’existe pas de valeur strictement identique. Elle ne permet pas d’interdire le chevauchement (même partiel) d’enregistrements de type intervalle, ou géométrique.
Une contrainte d’exclusion s’apparente à une contrainte d’unicité, mais pour des intervalles de valeurs. Le principe est d’identifier les chevauchements entre deux lignes pour prévenir l’insertion d’un doublon sur un intervalle commun.
Une contrainte d’exclusion s’appuie sur des index de type GiST ou SP-Gist, et surtout des opérateurs autres que l’égalité, ce qui permet de couvrir des cas que les contraintes d’unicité habituelles ne savent pas traiter.
L’exemple suivante implémente la contrainte que deux objets de type circle (cercle) ne se chevauchent pas. Or ce type ne s’indexe qu’avec du GiST, et il faut utiliser l’opérateur de recouvrement && :
Exemple 2-26Exemple 2-26 de code ou de sortie extrait du manuel PERF2.
Il n’est pas possible de créer ainsi une vraie clé unique, primaire ou étrangère sur une contrainte d’exclusion
Les versions de PostgreSQL antérieures à la 18 ne supportent pas encore les clés temporelles (voir plus bas). Les contraintes d’exclusion permettent de répondre au besoin. Dans la table suivante, deux lignes ne pourront exister avec la même salle et deux périodes de temps qui se chevauchent :
Exemple 2-27Exemple 2-27 de code ou de sortie extrait du manuel PERF2.
L’extension btree_gist permet d’utiliser l’opérateur = avec un index GiST, ce qui nous permet d’utiliser = dans une contrainte d’exclusion.
Il est quasiment impossible d’obtenir la même fonctionnalité sans contrainte d’exclusion, à part en verrouillant intégralement la table, ou en utilisant le mode d’isolation serializable, qui a des implications plus profondes sur le fonctionnement de l’application.
Enfin, précisons que les contraintes d’exclusion supportent toutes les fonctionnalités avancées que l’on est en droit d’attendre d’un système comme PostgreSQL : mode différé (deferred), application de la contrainte à un sous-ensemble de la table (permet une clause WHERE), ou utilisation de fonctions/expressions en place de références de colonnes.
2.4.4 GiST et clés temporelles
Éviter le chevauchement d’intervalles (range)
Exemple 2-28Exemple 2-28 de code ou de sortie extrait du manuel PERF2.
CREATETABLEreservations(salletext,professeurtext,periodetstzrange,-- période
UNIQUE(salle,periodeWITHOUTOVERLAPS));
Performances : extension btree_gist
Avant PG18 : utiliser les clauses d’exclusion
Les clés temporelles apparues avec PostgreSQL 18 permettent d’éviter que des intervalles de temps se chevauchent. Ce souci est assez courant dans les réservations de ressources ou pour gestions de dates de validité de lignes.
Un index de type GiST est obligatoire, et nécessite l’extension btree_gist, livrée avec PostgreSQL :
Dans l’exemple suivant, la période est gérée dans un type intervalle avec des bornes de type timestamp with time zone.
Exemple 2-29Exemple 2-29 de code ou de sortie extrait du manuel PERF2.
CREATEEXTENSIONIFNOTEXISTSbtree_gist;CREATETABLEreservations(salletext,professeurtext,periodetstzrange-- période des cours
);
Pour une même salle, les réservations ne doivent pas se recouvrir. Une clé primaire peut donc porter sur la salle et la période :
Exemple 2-30Exemple 2-30 de code ou de sortie extrait du manuel PERF2.
Tableau 2-16Tableau ou sortie 2-16 extraite du manuel PERF2.
Une clé unique ou primaire permet de créer une clé étrangère pointant dessus. Cette table gère les inscriptions des élèves aux cours. Ceux-ci ne peuvent s’inscrire que pendant les périodes qui existent, ou une fraction du cours, et pas assister à plusieurs cours en même temps. Noter le mot-clé PERIOD nécessaire dans la définition.
Exemple 2-33Exemple 2-33 de code ou de sortie extrait du manuel PERF2.
\d eleves

                    Table « public.eleves »
 Colonne |   Type    | Collationnement | NULL-able | Par défaut
---------+-----------+-----------------+-----------+------------
 eleve   | text      |                 | not null  |
 salle   | text      |                 |           |
 periode | tstzrange |                 | not null  |
Index :
    "eleves_pkey" PRIMARY KEY (eleve, periode WITHOUT OVERLAPS)
Contraintes de clés étrangères :
    "eleves_salle_periode_fkey" FOREIGN KEY (salle, PERIOD periode) REFERENCES reservations(salle, PERIOD periode)
Tableau 2-17Tableau ou sortie 2-17 extraite du manuel PERF2.
Deux inscriptions au même cours réussissent :
Exemple 2-34Exemple 2-34 de code ou de sortie extrait du manuel PERF2.
Tableau 2-20Tableau ou sortie 2-20 extraite du manuel PERF2.
Pour gérer ce dernier cas avec plusieurs intervalles disjoints, on pourrait même utiliser des types multirange. Une clé temporelle fonctionne aussi avec eux. Pour cela, remplacer tstzrange par tstzmultirange dans les deux tables, et utiliser une syntaxe comme :
Exemple 2-37Exemple 2-37 de code ou de sortie extrait du manuel PERF2.
                        indexdef
----------------------------------------------------------
 CREATE UNIQUE INDEX periodes_ne_se_recouvrent_pas
   ON public.reservations USING gist (salle, periode)
 CREATE UNIQUE INDEX eleves_pkey
   ON public.eleves USING gist (eleve, periode)
Tableau 2-21Tableau ou sortie 2-21 extraite du manuel PERF2.
2.5 GIN, GiST & pg_trgm
Indexation des recherches LIKE '%critère%'
Similarité basée sur des trigrammes
Exemple 2-39Exemple 2-39 de code ou de sortie extrait du manuel PERF2.
Une fois les trigrammes indexés, on peut réaliser de la recherche floue, ou utiliser des clauses LIKE malgré la présence de jokers (%) n’importe où dans la chaîne. À l’inverse, les indexations simples, de type B-tree, ne permettent des recherches efficaces que dans un cas particulier : si le seul joker de la chaîne est à la fin de celle ci (LIKE 'hello%' par exemple). Contrairement à la Full Text Search, la recherche par trigrammes ne réclame aucune modification des requêtes.
Exemple 2-43Exemple 2-43 de code ou de sortie extrait du manuel PERF2.
CREATEEXTENSIONpg_trgm;CREATETABLEtest_trgm(text_datatext);INSERTINTOtest_trgm(text_data)VALUES('hello'),('hello everybody'),('helo young man'),('hallo!'),('HELLO !');INSERTINTOtest_trgmSELECT'hola'FROMgenerate_series(1,1000);CREATEINDEXtest_trgm_idxONtest_trgmUSINGgist(text_datagist_trgm_ops);SELECTtext_dataFROMtest_trgmWHEREtext_datalike'%hello%';
Exemple 2-44Exemple 2-44 de code ou de sortie extrait du manuel PERF2.
    text_data
-----------------
 hello
 hello everybody
Cette dernière requête passe par l’index test_trgm_idx, malgré le % initial :
Exemple 2-45Exemple 2-45 de code ou de sortie extrait du manuel PERF2.
Exemple 2-46Exemple 2-46 de code ou de sortie extrait du manuel PERF2.
QUERY PLAN
----------------------------------------------------------------------------
Index Scan using test_trgm_gist_idx on test_trgm
(cost=0.41..0.63 rows=1width=8)(actual time=0.174..0.204 rows=2loops=1) Index Cond: (text_data ~~ '%hello%'::text) Rows Removed by Index Recheck: 1 Planning time: 0.202 ms
Execution time: 0.250 ms
On peut aussi utiliser un index GIN (comme pour le Full Text Search). Les index GIN ont l’avantage d’être plus efficaces pour les recherches exhaustives. Mais l’indexation pour la recherche des k éléments les plus proches (on parle de recherche k-NN) n’est disponible qu’avec les index GiST .
Exemple 2-47Exemple 2-47 de code ou de sortie extrait du manuel PERF2.
Ce premier jeu de données utilisera des données qui se répètent beaucoup (de basse cardinalité) et les requêtes ramèneront de nombreuses lignes :
Exemple 2-49Exemple 2-49 de code ou de sortie extrait du manuel PERF2.
-- Deux tables au contenu identique indexées avec GIN ou GiST
CREATETABLEdemo_gist(nint,iint,jint,kint,lint,fillerchar(50)default' ');CREATETABLEdemo_gin(nint,iint,jint,kint,lint,fillerchar(50)default' ');CREATEINDEXdemo_gist_idxONdemo_gistUSINGgist(i,j,k,l);CREATEINDEXdemo_gin_idxONdemo_ginUSINGgin(i,j,k,l);INSERTINTOdemo_gistSELECTn,mod(n,37)ASi,mod(n,53)ASj,mod(n,97)ASk,mod(n,229)ASlFROMgenerate_series(1,1000000)n;INSERTINTOdemo_ginSELECTn,mod(n,37)ASi,mod(n,53)ASj,mod(n,97)ASk,mod(n,229)ASlFROMgenerate_series(1,1000000)n;-- Valeurs distinctes
SELECTattname,n_distinct,correlationfrompg_statswheretablename='demo_gin'ANDattname!='filler';
 attname | n_distinct |  correlation
---------+------------+----------------
 n       |         -1 |              1
 i       |         37 |    0.025049716
 j       |         53 |    0.010017116
 k       |         97 |        0.01591
 l       |        229 | -0.00013099467
Tableau 2-22Tableau ou sortie 2-22 extraite du manuel PERF2.
Même en ne fournissant pas la première colonne des index, les index GIN et GiST sont utilisables :
Exemple 2-50Exemple 2-50 de code ou de sortie extrait du manuel PERF2.
Bitmap Heap Scan on demo_gin (actual time=0.436..0.491 rows=83 loops=1)
   Recheck Cond: ((j = 17) AND (l = 17))
   Heap Blocks: exact=83
   Buffers: shared hit=100
   ->  Bitmap Index Scan on demo_gin_i_j_k_l_idx (actual time=0.427..0.427 rows=83 loops=1)
         Index Cond: ((j = 17) AND (l = 17))
         Buffers: shared hit=17
 Planning:
   Buffers: shared hit=1
 Planning Time: 0.031 ms
 Execution Time: 0.503 ms
Tableau 2-24Tableau ou sortie 2-24 extraite du manuel PERF2.
L’index GIN est ici plus efficace car le nombre de blocs d’index balayés est plus bas. En effet, avec une basse cardinalité, la compression du GIN joue à plein. (Pour ces tables identiques de 97 Mo sous PostgreSQL 16, l’index GiST fait 62 Mo, et le GIN 19 Mo seulement.)
Si la première colonne i était systématiquement fournie à la requête, on pourrait se contenter d’un index B-tree (30 Mo ici) ; mais il serait peu efficace pour les autres requêtes. Avant PostgreSQL 18, la requête précédente donnerait souvent lieu à un Seq Scan parallélisé, bien que parfois un Bitmap Scan puisse apparaître avec des performances satisfaisantes. À partir de PostgreSQL 18, un index B-tree sur (i,j,k,l) reste utilisable même s’il manque i (index skip scan), mais il est obligé de faire à peu près autant de recherches qu’il y a de valeurs de i, ce qui n’est pas optimal.
Toujours dans ce cas précis, le temps de création de l’index GIN est aussi meilleur que le GiST d’un facteur deux au moins (et équivalent au B-tree), mais ce temps est très sensible aux valeurs de maintenance_work_mem et (à partir de PostgreSQL 18) max_parallel_maintenance_workers.
À l’inverse, le GiST est bien plus performant que le GIN dans d’autres types de requêtes comme celle-ci avec BETWEEN :
Exemple 2-52Exemple 2-52 de code ou de sortie extrait du manuel PERF2.
                               QUERY PLAN
-------------------------------------------------------------------------------
 Bitmap Heap Scan on demo_gin (actual time=68.281..69.313 rows=2059 loops=1)
   Recheck Cond: ((j >= 17) AND (j <= 21) AND (l >= 17) AND (l <= 21))
   Heap Blocks: exact=757
   Buffers: shared hit=1760
   ->  Bitmap Index Scan on demo_gin_i_j_k_l_idx (actual time=68.174..68.174 rows=2059 loops=1)
         Index Cond: ((j >= 17) AND (j <= 21) AND (l >= 17) AND (l <= 21))
         Buffers: shared hit=1003
 Planning:
   Buffers: shared hit=1
 Planning Time: 0.056 ms
 Execution Time: 69.435 ms
Tableau 2-26Tableau ou sortie 2-26 extraite du manuel PERF2.
Un index GiST permet aussi l’Index Scan et parfois l’Index Only Scan, au contraire d’un index GIN, qui se limitera toujours à un Bitmap Scan. L’intérêt varie selon les requêtes :
Exemple 2-54Exemple 2-54 de code ou de sortie extrait du manuel PERF2.
                               QUERY PLAN
-------------------------------------------------------------------------------
 Index Only Scan using demo_gist_i_j_k_l_idx on demo_gist (actual time=0.043..1.563 rows=83 loops=1)
   Index Cond: ((j = 17) AND (l = 17))
   Heap Fetches: 0
   Buffers: shared hit=352
 Planning Time: 0.024 ms
 Execution Time: 1.572 ms
Tableau 2-27Tableau ou sortie 2-27 extraite du manuel PERF2.Exemple 2-55Exemple 2-55 de code ou de sortie extrait du manuel PERF2.
                               QUERY PLAN
-------------------------------------------------------------------------------
 Bitmap Heap Scan on demo_gin (actual time=0.699..0.796 rows=83 loops=1)
   Recheck Cond: ((j = 17) AND (l = 17))
   Heap Blocks: exact=83
   Buffers: shared hit=100
   ->  Bitmap Index Scan on demo_gin_i_j_k_l_idx (actual time=0.683..0.683 rows=83 loops=1)
         Index Cond: ((j = 17) AND (l = 17))
         Buffers: shared hit=17
 Planning:
   Buffers: shared hit=1
 Planning Time: 0.069 ms
 Execution Time: 0.819 ms
Tableau 2-28Tableau ou sortie 2-28 extraite du manuel PERF2.
Si la cardinalité est élevée (les données sont toutes différentes), l’index GIN perd son avantage en taille. En effet, si l’on remplace les données précédentes par un jeu de données toutes différentes :
Exemple 2-56Exemple 2-56 de code ou de sortie extrait du manuel PERF2.
la taille de l’index GIN passe à 218 Mo (plus que la table), alors que l’index GiST ne monte qu’à 85 Mo (et un index B-tree resterait à 30 Mo). Cela ne rend pas forcément l’index GIN moins efficace dans l’absolu, mais a un effet défavorable sur le cache.
Index bloom :
Il existe encore un type d’index, rarement utilisé : l’index Bloom, qui réclame l’installation de l’extension bloom (livrée avec PostgreSQL). Cet index est basé sur les filtres bloom, de nature probabiliste. Les lignes retournées par l’index doivent être revérifiées dans la table, ce qui impose un Recheck systématique. L’index est rapide à générer, et encore plus petit que les index ci-dessus (15 Mo ici), mais cet index doit être complètement parcouru. Les performances sont donc moins bonnes qu’avec GiST ou GIN. Il est aussi limité aux entiers et chaînes de caractères, et à une recherche sur l’égalité (et donc inadapté aux critères BETWEEN et LIKE). Si ses performances suffisent, un index bloom peut être utile dans le cas où de nombreuses colonnes sont susceptibles d’être interrogées, car il évite de créer d’autres index B-tree ou GIN coûteux en place. Sur une table identique à celles ci-dessus, le plan est :
Exemple 2-57Exemple 2-57 de code ou de sortie extrait du manuel PERF2.
                               QUERY PLAN
-------------------------------------------------------------------------------
 Bitmap Heap Scan on demo_bloom (actual time=3.732..3.753 rows=1 loops=1)
   Recheck Cond: ((j = 100000017) AND (l = 300000017))
   Rows Removed by Index Recheck: 27
   Heap Blocks: exact=28
   Buffers: shared hit=1961 read=28
   ->  Bitmap Index Scan on demo_bloom_i_j_k_l_idx (actual time=3.721..3.722 rows=28 loops=1)
         Index Cond: ((j = 100000017) AND (l = 300000017))
         Buffers: shared hit=1933 read=28
 Planning Time: 0.042 ms
 Execution Time: 3.767 ms
Tableau 2-29Tableau ou sortie 2-29 extraite du manuel PERF2.
Choix du type d’index pour une indexation multicolonnes :
Les exemples ci-dessus viennent d’une instance avec la configuration par défaut de PostgreSQL. Rappelons que les paramètres effective_io_concurrency, seq_page_cost et random_page_cost (liés aux disques) et effective_cache_size (lié à la mémoire), influent fortement sur le choix d’un parcours Index Scan, Bitmap Scan ou Seq Scan quand la requête balaie beaucoup de lignes. La répartition physique des données joue aussi (sur l’efficacité du cache comme sur celle des Index Scan et Bitmap Scan.) Le type de données à indexer, leur longueur, l’opérateur… a aussi une importance.
Au final, pour une indexation multicolonnes d’une table, il faudra tester les types d’index disponibles avec la charge, le paramétrage et les requêtes réelles, des données réelles, et arbitrer en tenant compte des tailles des index (donc de l’impact sur le cache), des durées de génération, des performances pures et des performances en pratique acceptables…
2.7 Index BRIN
BRIN : Block Range INdex
Exemple 2-58Exemple 2-58 de code ou de sortie extrait du manuel PERF2.
Un index BRIN ne stocke pas les valeurs de la table, mais quelles plages de valeurs se rencontrent dans un ensemble de blocs. Cela réduit la taille de l’index et permet d’exclure un ensemble de blocs lors d’une recherche.
Exemple
Soit une table brin_demo de 2 millions de personnes, triée par âge :
Exemple 2-59Exemple 2-59 de code ou de sortie extrait du manuel PERF2.
=# \dt+ brin_demo
                              List of relations
 Schema |   Name    | Type  |  Owner   | Persistence |  Size   | Description
--------+-----------+-------+----------+-------------+---------+-------------
 public | brin_demo | table | postgres | permanent   |   69 MB |
Tableau 2-30Tableau ou sortie 2-30 extraite du manuel PERF2.
Un index BRIN va contenir une plage des valeurs pour chaque bloc. Dans notre exemple, l’index contiendra la valeur minimale et maximale de plusieurs blocs. La conséquence est que ce type d’index prend très peu de place et il peut facilement tenir en RAM (réduction des opérations des disques). Il est aussi plus rapide à construire et maintenir.
Exemple 2-60Exemple 2-60 de code ou de sortie extrait du manuel PERF2.
=# \di+ brin_demo*
                        List of relations
 Schema |         Name         | Type  | ... |    Table     | Persistence | Size  | ...
--------+----------------------+-------+---+--------------+-------------+-------+---
 public | brin_demo_brin_idx   | index |   | brin_demo    | permanent   | 48 kB |
 public | brin_demo_btree_idx  | index |   | brin_demo    | permanent   | 13 MB |
Tableau 2-31Tableau ou sortie 2-31 extraite du manuel PERF2.
On peut consulter le contenu de cet index, et constater que chacune de ses entrées liste les valeurs de age par paquet de 128 blocs (cette valeur peut se changer) :
Exemple 2-61Exemple 2-61 de code ou de sortie extrait du manuel PERF2.
 itemoffset | blknum | attnum | allnulls | hasnulls | placeholder |   value
------------+--------+--------+----------+----------+-------------+------------
          1 |      0 |      1 | f        | f        | f           | {1 .. 2}
          2 |    128 |      1 | f        | f        | f           | {2 .. 3}
          3 |    256 |      1 | f        | f        | f           | {3 .. 4}
          4 |    384 |      1 | f        | f        | f           | {4 .. 6}
          5 |    512 |      1 | f        | f        | f           | {6 .. 7}
          6 |    640 |      1 | f        | f        | f           | {7 .. 8}
          7 |    768 |      1 | f        | f        | f           | {8 .. 10}
          8 |    896 |      1 | f        | f        | f           | {10 .. 11}
          9 |   1024 |      1 | f        | f        | f           | {11 .. 12}
...
         66 |   8320 |      1 | f        | f        | f           | {85 .. 86}
         67 |   8448 |      1 | f        | f        | f           | {86 .. 88}
         68 |   8576 |      1 | f        | f        | f           | {88 .. 89}
         69 |   8704 |      1 | f        | f        | f           | {89 .. 90}
         70 |   8832 |      1 | f        | f        | f           | {90 .. 90}
Tableau 2-32Tableau ou sortie 2-32 extraite du manuel PERF2.
La colonne blknum indique le début de la tranche de blocs, et value la plage de valeurs rencontrées. Les personnes de 87 ans sont donc présentes uniquement entre les blocs 8448 à 8575, ce qui se vérifie :
Exemple 2-62Exemple 2-62 de code ou de sortie extrait du manuel PERF2.
                               QUERY PLAN
-------------------------------------------------------------------------------
 Aggregate (actual time=4.838..4.839 rows=1 loops=1)
   Buffers: shared hit=130
   ->  Bitmap Heap Scan on brin_demo (actual time=0.241..3.530 rows=22212 loops=1)
         Recheck Cond: (age = 87)
         Rows Removed by Index Recheck: 6716
         Heap Blocks: lossy=128
         Buffers: shared hit=130
         ->  Bitmap Index Scan on brin_demo_brin_idx (actual time=0.024..0.024 rows=1280 loops=1)
               Index Cond: (age = 87)
               Buffers: shared hit=2
 Planning:
   Buffers: shared hit=5
 Planning Time: 0.084 ms
 Execution Time: 4.873 ms
Tableau 2-34Tableau ou sortie 2-34 extraite du manuel PERF2.
On constate que l’index n’est consulté que sur 2 blocs. Le nœud Bitmap Index Scan renvoie les 128 blocs contenant des valeurs entre 86 et 88, et ces blocs sont récupérés dans la table (heap). 6716 lignes sont ignorées, et 22 212 conservées. Le temps de 4,8 ms est bon.
Certes, un index B-tree, bien plus gros, aurait fait encore mieux dans ce cas précis, qui est modeste. Mais plus la table est énorme, plus une requête en ramène une proportion importante, plus les aller-retours entre index et table sont pénalisants, et plus l’index BRIN devient compétitif, en plus de rester très petit.
Par contre, si la table se fragmente, même un peu, les lignes d’un même age se retrouvent réparties dans toute la table, et l’index BRIN devient bien moins efficace :
Exemple 2-64Exemple 2-64 de code ou de sortie extrait du manuel PERF2.
UPDATEbrin_demoSETage=age+0WHERErandom()>0.99;-- environ 20000 lignes
VACUUMbrin_demo;UPDATEbrin_demoSETage=age+0WHEREage>80ANDrandom()>0.90;-- environ 22175 lignes
VACUUMANALYZEbrin_demo;
Exemple 2-65Exemple 2-65 de code ou de sortie extrait du manuel PERF2.
                               QUERY PLAN
-------------------------------------------------------------------------------
 Aggregate (actual time=71.053..71.055 rows=1 loops=1)
   Buffers: shared hit=3062
   ->  Bitmap Heap Scan on brin_demo (actual time=2.451..69.851 rows=22303 loops=1)
         Recheck Cond: (age = 87)
         Rows Removed by Index Recheck: 664141
         Heap Blocks: lossy=3060
         Buffers: shared hit=3062
         ->  Bitmap Index Scan on brin_demo_brin_idx (actual time=0.084..0.084 rows=30600 loops=1)
               Index Cond: (age = 87)
               Buffers: shared hit=2
 Planning:
   Buffers: shared hit=1
 Planning Time: 0.069 ms
 Execution Time: 71.102 ms
Tableau 2-36Tableau ou sortie 2-36 extraite du manuel PERF2.
3060 blocs et 686 444 lignes, la plupart inutiles, ont été lus dans la table (en gros, un tiers de celles-ci). Cela ne devient plus très intéressant par rapport à un parcours complet de la table.
Pour rendre son intérêt à l’index, il faut reconstruire la table avec les données dans le bon ordre avec la commande CLUSTER. Hélas, c’est une opération au moins aussi lourde et bloquante qu’un VACUUM FULL. De plus, le tri de la table ne peut se faire par l’index BRIN, et il faut recréer un index B-tree au moins le temps de l’opération.
Exemple 2-67Exemple 2-67 de code ou de sortie extrait du manuel PERF2.
 itemoffset | blknum | attnum | allnulls | hasnulls | placeholder |   value
------------+--------+--------+----------+----------+-------------+------------
          1 |      0 |      1 | f        | f        | f           | {1 .. 2}
          2 |    128 |      1 | f        | f        | f           | {2 .. 3}
...
         68 |   8576 |      1 | f        | f        | f           | {88 .. 89}
         69 |   8704 |      1 | f        | f        | f           | {89 .. 90}
         70 |   8832 |      1 | f        | f        | f           | {90 .. 90}
Tableau 2-37Tableau ou sortie 2-37 extraite du manuel PERF2.
On revient alors à la situation de départ.
Utilité d’un index BRIN
Pour qu’un index BRIN soit utile, il faut donc :
que les données soit naturellement triées dans la table, et le restent (série temporelle, décisionnel avec imports réguliers…) ;
que la table soit à « insertion seule » pour conserver l’ordre physique ;
ou que l’on ait la disponibilité nécessaire pour reconstruire régulièrement la table avec CLUSTER et éviter que les performances se dégradent au fil du temps.
Sous ces conditions, les BRIN sont indiqués si l’on a des problèmes de volumétrie, ou de temps d’écritures dus aux index B-tree, ou pour éviter de partitionner une grosse table dont les requêtes ramènent une grande proportion.
Index BRIN sur clé composée
Prenons un autre exemple avec plusieurs colonnes et un type text :
Exemple 2-68Exemple 2-68 de code ou de sortie extrait du manuel PERF2.
Tableau 2-38Tableau ou sortie 2-38 extraite du manuel PERF2.
La colonne attnum correspond au numéro d’attribut du champ dans la table. L’id est bien corrélé aux numéros de bloc, contrairement à la colonne val. Ce que nous confirme bien la vue pg_stats :
Exemple 2-71Exemple 2-71 de code ou de sortie extrait du manuel PERF2.
 tablename | attname | correlation
-----------+---------+-------------
 test      | id      |           1
 test      | val     |  0.00528745
Tableau 2-39Tableau ou sortie 2-39 extraite du manuel PERF2.
Si l’on teste la requête suivante, on s’aperçoit que PostgreSQL effectue un parcours complet (Seq Scan) de façon parallélisée ou non, et n’utilise donc pas l’index BRIN. Pour comprendre pourquoi, essayons de l’y forcer :
Exemple 2-72Exemple 2-72 de code ou de sortie extrait du manuel PERF2.
                                 QUERY PLAN
----------------------------------------------------------------------------
 Bitmap Heap Scan on test  (cost=712.28..124076.96 rows=2666839 width=37) (actual time=1.460..540.250 rows=2668675 loops=1)
   Recheck Cond: ((val >= 'a87ff679a2f3e71d9181a67b7542122c'::text)
              AND (val <= 'eccbc87e4b5ce2fe28308fd9f2a7baf3'::text))
   Rows Removed by Index Recheck: 19325
   Heap Blocks: lossy=22400
   Buffers: shared hit=22409
   ->  Bitmap Index Scan on test_brin_idx  (cost=0.00..45.57 rows=2668712 width=0) (actual time=0.520..0.520 rows=224000 loops=1)
         Index Cond: ((val >= 'a87ff679a2f3e71d9181a67b7542122c'::text)
                  AND (val <= 'eccbc87e4b5ce2fe28308fd9f2a7baf3'::text))
         Buffers: shared hit=9
 Planning:
   Buffers: shared hit=18 read=2
   I/O Timings: read=0.284
 Planning Time: 0.468 ms
 Execution Time: 630.124 ms
Tableau 2-43Tableau ou sortie 2-43 extraite du manuel PERF2.
22 400 blocs sont lus dans la table, soit 175 Mo. Dans la table triée, l’index BRIN devient intéressant. Cette remarque vaut aussi si PostgreSQL préfère un Index Scan au plan précédent (notamment si random_page_cost vaut moins du 4 par défaut).
On supprime notre index BRIN et on garde l’index B-tree :
Exemple 2-76Exemple 2-76 de code ou de sortie extrait du manuel PERF2.
                          QUERY PLAN
-------------------------------------------------------------------
 Index Scan using test_btree_idx on test  (cost=0.56..94786.34 rows=2666839 width=37) (actual time=0.027..599.185 rows=2668675 loops=1)
   Index Cond: ((val >= 'a87ff679a2f3e71d9181a67b7542122c'::text)
            AND (val <= 'eccbc87e4b5ce2fe28308fd9f2a7baf3'::text))
   Buffers: shared hit=41306
 Planning:
   Buffers: shared hit=12
 Planning Time: 0.125 ms
 Execution Time: 675.624 ms
Tableau 2-44Tableau ou sortie 2-44 extraite du manuel PERF2.
La durée est ici similaire, mais le nombre de blocs lus est double, ce qui est une conséquence de la taille de l’index.
Création
À partir de PostgreSQL 17, la création d’un index BRIN peut être parallélisée. Comme cet index est intéressant surtout sur de grosses tables, la durée est sérieusement réduite. Le nombre de processus parallèles est réglé par max_parallel_maintenance_workers. Dans les versions précédentes, un seul processeur est malheureusement utilisable lors de la création.
Maintenance et consultation
Les lignes ajoutées à la table après la création de l’index ne sont pas forcément intégrées au résumé tout de suite. Il faut faire attention à ce que le VACUUM passe assez souvent. Cela dit, la maintenance d’un BRIN lors d’écritures est plus légères qu’un gros B-tree.
Pour modifier la granularité de l’index BRIN, il faut utiliser le paramètre pages_per_range à la création :
Exemple 2-77Exemple 2-77 de code ou de sortie extrait du manuel PERF2.
Les calculs de plage de valeur se feront alors par paquets de 16 blocs, ce qui est plus fin tout en conservant une volumétrie dérisoire. Sur la table brin_demo, l’index ne fait toujours que 56 ko. Par contre, la requête d’exemple parcourra un peu moins de blocs inutiles. La plage est à ajuster en fonction de la finesse des données et de leur répartition.
Pour consulter la répartition des valeurs comme nous l’avons fait plus haut, il faut utiliser pageinspect. Pour une table brin_demo dix fois plus grosse, et des plages de 16 blocs :
Exemple 2-78Exemple 2-78 de code ou de sortie extrait du manuel PERF2.
Tableau 2-45Tableau ou sortie 2-45 extraite du manuel PERF2.
On retrouve le paramètre de plages de 16 blocs, et la range map commence au bloc 5. Par ailleurs, pg_class.relpages indique 20 blocs. Nous avons donc les bornes des pages de l’index à consulter :
Exemple 2-79Exemple 2-79 de code ou de sortie extrait du manuel PERF2.
Les index hash contiennent des hachages de tout type de données. Cela leur permet d’être relativement petits, même pour des données de gros volume, et d’être une alternative aux index B-tree qui ne peuvent pas indexer des objets de plus de 2,7 ko.
Une conséquence de ce principe est qu’il est impossible de parcourir des plages de valeurs, seule l’égalité exacte à un critère peut être recherchée. Cet exemple utilise la base du projet Gutenberg :
Exemple 2-80Exemple 2-80 de code ou de sortie extrait du manuel PERF2.
EXPLAIN(ANALYZE,BUFFERS,COSTSOFF)SELECT*FROMtextes-- attention au nombre exact d'espaces
WHEREcontenu=' Maître corbeau, sur un arbre perché';
                               QUERY PLAN
-------------------------------------------------------------------------------
 Index Scan using textes_contenu_hash_idx on textes (actual time=0.049..0.050 rows=1 loops=1)
   Index Cond: (contenu = '    Maître corbeau, sur un arbre perché'::text)
   Buffers: shared hit=3
 Planning Time: 0.073 ms
 Execution Time: 0.072 ms
Tableau 2-47Tableau ou sortie 2-47 extraite du manuel PERF2.
Les index hash restent plus longs à créer que des index B-tree. La création n’est pas parallélisée. Ils ne sont plus petits qu’eux que si les champs indexés sont gros. Par exemple, dans la même table texte, de 3 Go, le nom de l’œuvre (livre) est court, mais une ligne de texte (contenu) peut faire 3 ko (ici, on a dû purger les trois lignes trop longues pour être indexées par un B-tree) :
Exemple 2-81Exemple 2-81 de code ou de sortie extrait du manuel PERF2.
taille  |                                 indexdef
--------+--------------------------------------------------------------------------
733 MB  | CREATE INDEX textes_contenu_hash_idx ON public.textes USING hash (contenu)
1383 MB | CREATE INDEX textes_contenu_idx ON public.textes USING btree (contenu varchar_pattern_ops)
1033 MB | CREATE INDEX textes_livre_hash_idx ON public.textes USING hash (livre)
155 MB  | CREATE INDEX textes_livre_idx ON public.textes USING btree (livre varchar_pattern_ops)
Tableau 2-48Tableau ou sortie 2-48 extraite du manuel PERF2.
On réservera donc les index hash à l’indexation de grands champs, éventuellement binaires, notamment dans des requêtes recherchant la présence d’un objet. Ils peuvent vous éviter de gérer vous-même un hachage du champ.
2.9 Outils
Pour identifier des requêtes
Pour identifier des prédicats et des requêtes liées
Pour valider un index
Différents outils permettent d’aider le développeur ou le DBA à identifier plus facilement les index à créer. On peut classer ceux-ci en trois groupes, selon l’étape de la méthodologie à laquelle ils s’appliquent.
Pour identifier les requêtes les plus lentes, et donc potentiellement nécessitant une réécriture ou un nouvel index, pgBadger permet d’analyser les logs une fois ceux-ci configurés pour tracer toutes les requêtes. Des exemples figurent dans notre formation DBA1.
Pour une vision cumulative, voire temps réel, de ces requêtes, l’extension pg_stat_statements, fournie avec les « contrib » de PostgreSQL, permet de garder trace des N requêtes les plus fréquemment exécutées, et calcule le temps d’exécution total de chacune d’entre elles, ainsi que les accès au cache de PostgreSQL ou au système de fichiers. Son utilisation est détaillée dans notre module X2.
Le projet PoWA exploite ces statistiques en les historisant, et en fournissant une interface web permettant de les exploiter.
2.9.2 Identifier les prédicats et des requêtes liées
Extension pg_qualstats
avec PoWa
Pour identifier les prédicats (clause WHERE ou condition de jointure à identifier en priorité), l’extension pg_qualstats permet de pousser l’analyse offerte par pg_stat_statements au niveau du prédicat lui-même. Ainsi, on peut détecter les requêtes filtrant sur les mêmes colonnes, ce qui peut aider notamment à déterminer des index multicolonnes ou des index partiels.
De même que pg_stat_statements, cette extension peut être historisée et exploitée par le biais du projet PoWA.
2.9.3 Extension HypoPG
Extension PostgreSQL
Création d’index hypothétiques pour tester leur intérêt
avant de les créer pour de vrai
Limitations : surtout B-Tree, statistiques
Cette extension est disponible sur GitHub et dans les paquets du PGDG. Il existe trois fonctions principales et une vue :
hypopg_create_index() pour créer un index hypothétique ;
hypopg_drop_index() pour supprimer un index hypothétique particulier ou hypopg_reset() pour tous les supprimer ;
hypopg_list_indexes pour les lister.
Un index hypothétique n’existe que dans la session, ni en mémoire ni sur le disque, mais le planificateur le prendra en compte dans un EXPLAIN simple (évidemment pas un EXPLAIN ANALYZE). En quittant la session, tous les index hypothétiques restants et créés sur cette session sont supprimés.
                          QUERY PLAN
-------------------------------------------------------------------
 Index Scan using <24591>btree_employes_big_prenom on employes_big
                                 (cost=0.05..4.07 rows=1 width=41)
   Index Cond: ((prenom)::text = 'Gaston'::text)
Tableau 2-51Tableau ou sortie 2-51 extraite du manuel PERF2.Exemple 2-85Exemple 2-85 de code ou de sortie extrait du manuel PERF2.
                      QUERY PLAN
----------------------------------------------------------
 Index Scan using employes_big_prenom_idx on employes_big
                        (cost=0.42..4.44 rows=1 width=41)
   Index Cond: ((prenom)::text = 'Gaston'::text)
Tableau 2-54Tableau ou sortie 2-54 extraite du manuel PERF2.
Le cas idéal d’utilisation est l’index B-Tree sur une colonne. Un index fonctionnel est possible, mais, faute de statistiques disponibles avant la création réelle de l’index, les estimations peuvent être fausses. Les autres types d’index sont moins bien ou non supportées.
2.9.4 Étude des index à créer
PoWA peut utiliser HypoPG
Le projet PoWA propose une fonctionnalité, encore rudimentaire, de suggestion d’index à créer, en se basant sur HypoPG, pour répondre à la question « Quel serait le plan d’exécution de ma requête si cet index existait ? ».
L’intégration d’HypoPG dans PoWA permet là aussi une souplesse d’utilisation, en présentant les plans espérés avec ou sans les index suggérés.
Ensuite, en ouvrant l’interface de PoWA, on peut étudier les différentes requêtes, et les suggestions d’index réalisées par l’outil. À partir de ces suggestions, on peut créer les nouveaux index, et enfin relancer le bench pour constater les améliorations de performances.
Tous les TP se basent sur la configuration par défaut de PostgreSQL, sauf précision contraire.
2.11.1 Indexation de motifs avec les varchar_patterns et pg_trgm
But : Indexer des motifs à l’aide de l’opérateur varchar_pattern_ops et de l’extension pg_trgm
Ces exercices nécessitent une base contenant une quantité de données importante.
On utilisera donc le contenu de livres issus du projet Gutenberg. Si vous ne l’avez pas déjà, la base gutenberg est disponible en deux versions : complète sur https://dali.bo/tp_gutenberg (dump de 0,5 Go, table de 21 millions de lignes dans 3 Go) ou https://dali.bo/tp_gutenberg10 pour un extrait d’un dizième. Le dump peut se restaurer par exemple dans une nouvelle base, et contient juste une table nommée textes.
Exemple 2-88Exemple 2-88 de code ou de sortie extrait du manuel PERF2.
curl -kL https://dali.bo/tp_gutenberg -o /tmp/gutenberg.dmp
createdb gutenberg
pg_restore -d gutenberg /tmp/gutenberg.dmp
# le message sur le schéma public exitant est normalerm -- /tmp/gutenberg.dmp
Pour obtenir des plans plus lisibles, on désactive JIT et parallélisme :
Exemple 2-89Exemple 2-89 de code ou de sortie extrait du manuel PERF2.
Créer un index simple sur la colonne contenu de la table.
Rechercher un enregistrement commençant par « comme disent » : l’index est-il utilisé ?
Créer un index utilisant la classe text_pattern_ops. Refaire le test.
On veut chercher les lignes finissant par « Et vivre ». Indexer reverse(contenu) et trouver les lignes.
Installer l’extension pg_trgm, puis créer un index GIN spécialisé de recherche dans les chaînes. Rechercher toutes les lignes de texte contenant « Valjean » de façon sensible à la casse, puis insensible.
Si vous avez des connaissances sur les expression rationnelles, utilisez aussi ces trigrammes pour des recherches plus avancées. Les opérateurs sont :
opérateur
fonction
~
correspondance sensible à la casse
~*
correspondance insensible à la casse
!~
non-correspondance sensible à la casse
!~*
non-correspondance insensible à la casse
Rechercher toutes les lignes contenant « Fantine » OU « Valjean » : on peut utiliser une expression rationnelle.
Rechercher toutes les lignes mentionnant à la fois « Fantine » ET « Valjean ». Une formulation d’expression rationnelle simple est « Fantine puis Valjean » ou « Valjean puis Fantine ».
2.11.2 Index GIN comme bitmap
But : Comparer l’utilisation des index B-tree et GIN
Ce TP utilise la base magasin. Si vous ne l’avez pas déjà, la base magasin (dump de 96 Mo, pour 667 Mo sur le disque au final) peut être téléchargée et restaurée comme suit dans une nouvelle base magasin :
Exemple 2-90Exemple 2-90 de code ou de sortie extrait du manuel PERF2.
createdb magasin
curl -kL https://dali.bo/tp_magasin -o /tmp/magasin.dump
pg_restore -d magasin /tmp/magasin.dump
# le message sur public préexistant est normalrm -- /tmp/magasin.dump
Les données sont dans deux schémas, magasin et facturation. Penser au search_path.
Pour ce TP, figer les paramètres suivants :
Exemple 2-91Exemple 2-91 de code ou de sortie extrait du manuel PERF2.
Installer l’extension hypopg (les paquets dépendent de votre version de PostgreSQL et de la distribution, par exemple hypopg_17 ou postgresql-17-hypopg).
Créer des index hypothétiques (y compris un partiel) et choisir un seul index.
Comparer le plan de la deuxième requête avant et après la création réelle de l’index.
Créer un index fonctionnel hypothétique pour faciliter la requête suivante :
SELECTkFROMlog10WHEREmod(j,99)=55;
Quel que soit le résultat, le créer quand même et voir s’il est utilisé.
2.12 Travaux pratiques (solutions)
Indexation de motifs avec les varchar_patterns et pg_trgm
Créer un index simple sur la colonne contenu de la table.
Exemple 2-92Exemple 2-92 de code ou de sortie extrait du manuel PERF2.
CREATEINDEXONtextes(contenu);
Il y aura une erreur si la base gutenberg est dans sa version complète, un livre de Marcel Proust dépasse la taille indexable maximale :
ERROR:  index row size 2968 exceeds maximum 2712 for index "textes_contenu_idx"
ASTUCE : Values larger than 1/3 of a buffer page cannot be indexed.
Consider a function index of an MD5 hash of the value, or use full text indexing.
Tableau 2-55Tableau ou sortie 2-55 extraite du manuel PERF2.
Pour l’exercice, on supprime ce livre avant d’indexer la colonne :
Exemple 2-93Exemple 2-93 de code ou de sortie extrait du manuel PERF2.
Rechercher un enregistrement commençant par « comme disent » : l’index est-il utilisé ?
Le plan exact peut dépendre de la version de PostgreSQL, du paramétrage exact, d’éventuelles modifications à la table. Dans beaucoup de cas, on obtiendra :
Exemple 2-94Exemple 2-94 de code ou de sortie extrait du manuel PERF2.
                            QUERY PLAN
------------------------------------------------------------------
 Index Scan using textes_contenu_idx on textes (...)
   Index Cond: (contenu ~~ 'comme disent%'::text)
   Rows Removed by Index Recheck: 110
   Buffers: shared hit=28 read=49279
   I/O Timings: read=311238.192
 Planning Time: 0.352 ms
 Execution Time: 313481.602 ms
Tableau 2-57Tableau ou sortie 2-57 extraite du manuel PERF2.
C’est un Index Scan mais il ne faut pas crier victoire : l’index est parcouru entièrement (50 000 blocs !). Il ne sert qu’à lire toutes les valeurs de contenu en lisant moins de blocs que par un Seq Scan de la table. Le choix de PostgreSQL entre lire cet index et lire la table dépend notamment du paramétrage et des tailles respectives.
Le problème est que l’index sur contenu utilise la collation C et non la collation par défaut de la base, généralement en_US.UTF-8 ou fr_FR.UTF-8. Pour contourner cette limitation, PostgreSQL fournit deux classes d’opérateurs : varchar_pattern_ops pour varchar et text_pattern_ops pour text.
Créer un index utilisant la classe text_pattern_ops. Refaire le test.
Exemple 2-96Exemple 2-96 de code ou de sortie extrait du manuel PERF2.
                            QUERY PLAN
------------------------------------------------------------------
 Index Scan using textes_contenu_idx1 on textes
                               (cost=0.56..8.58 rows=185 width=130)
                      (actual time=0.530..0.542 rows=4 loops=1)
   Index Cond: ((contenu ~>=~ 'comme disent'::text)
            AND (contenu ~<~ 'comme disenu'::text))
   Filter: (contenu ~~ 'comme disent%'::text)
   Buffers: shared hit=4 read=4
 Planning Time: 1.112 ms
 Execution Time: 0.618 ms
Tableau 2-58Tableau ou sortie 2-58 extraite du manuel PERF2.
On constate que comme l’ordre choisi est l’ordre ASCII, l’optimiseur sait qu’après « comme disent », c’est « comme disenu » qui apparaît dans l’index.
Noter que Index Cond contient le filtre utilisé pour l’index (réexprimé sous forme d’inégalités en collation C) et Filter un filtrage des résultats de l’index.
On veut chercher les lignes finissant par « Et vivre ». Indexer reverse(contenu) et trouver les lignes.
Cette recherche n’est possible avec un index B-Tree qu’en utilisant un index sur fonction :
Exemple 2-98Exemple 2-98 de code ou de sortie extrait du manuel PERF2.
                              QUERY PLAN
--------------------------------------------------------------------------
 Index Scan using textes_reverse_idx on textes
                             (cost=0.56..377770.76 rows=104728 width=123)
                         (actual time=0.083..0.098 rows=2 loops=1)
   Index Cond: ((reverse(contenu) ~>=~ 'erviv tE'::text)
            AND (reverse(contenu) ~<~ 'erviv tF'::text))
   Filter: (reverse(contenu) ~~ 'erviv tE%'::text)
 Planning Time: 1.903 ms
 Execution Time: 0.421 ms
Tableau 2-59Tableau ou sortie 2-59 extraite du manuel PERF2.
On constate que le résultat de reverse(contenu) a été directement utilisé par l’optimiseur. La requête est donc très rapide. On peut utiliser une méthode similaire pour la recherche insensible à la casse, en utiliser lower() ou upper().
Toutefois, ces méthodes ne permettent de filtrer qu’au début ou à la fin de la chaîne, ne permettent qu’une recherche sensible ou insensible à la casse, mais pas les deux simultanément, et imposent aux développeurs de préciser reverse, lower, etc. partout.
Installer l’extension pg_trgm, puis créer un index GIN spécialisé de recherche dans les chaînes. Rechercher toutes les lignes de texte contenant « Valjean » de façon sensible à la casse, puis insensible.
Pour installer l’extension pg_trgm :
Exemple 2-100Exemple 2-100 de code ou de sortie extrait du manuel PERF2.
CREATEEXTENSIONpg_trgm;
Pour créer un index GIN sur la colonne contenu :
Exemple 2-101Exemple 2-101 de code ou de sortie extrait du manuel PERF2.
                                 QUERY PLAN
---------------------------------------------------------------------------
 Bitmap Heap Scan on textes  (cost=77.01..6479.68 rows=1679 width=123)
                      (actual time=13.135..23.145 rows=1214 loops=1)
   Recheck Cond: (contenu ~~* '%Valjean%'::text)
   Heap Blocks: exact=353
   ->  Bitmap Index Scan on idx_textes_trgm
                                 (cost=0.00..76.59 rows=1679 width=0)
                       (actual time=12.779..12.779 rows=1214 loops=1)
         Index Cond: (contenu ~~* '%Valjean%'::text)
 Planning Time: 2.047 ms
 Execution Time: 23.444 ms
Tableau 2-61Tableau ou sortie 2-61 extraite du manuel PERF2.
On constate que l’index a été nettement plus long à créer, et que la recherche est plus lente. La contrepartie est évidemment que les trigrammes sont infiniment plus souples. On constate aussi que le LIKE a dû encore filtrer 1 enregistrement après le parcours de l’index : en effet l’index trigramme est insensible à la casse, il ramène donc trop d’enregistrements, et une ligne avec « VALJEAN » a dû être filtrée.
Rechercher toutes les lignes contenant « Fantine » OU « Valjean » : on peut utiliser une expression rationnelle.
Exemple 2-104Exemple 2-104 de code ou de sortie extrait du manuel PERF2.
                               QUERY PLAN
-----------------------------------------------------------------------------
 Bitmap Heap Scan on textes  (cost=141.01..6543.68 rows=1679 width=123)
                     (actual time=159.896..174.173 rows=1439 loops=1)
   Recheck Cond: (contenu ~ 'Valjean|Fantine'::text)
   Rows Removed by Index Recheck: 1569
   Heap Blocks: exact=1955
   ->  Bitmap Index Scan on idx_textes_trgm
                                 (cost=0.00..140.59 rows=1679 width=0)
                      (actual time=159.135..159.135 rows=3008 loops=1)
         Index Cond: (contenu ~ 'Valjean|Fantine'::text)
 Planning Time: 2.467 ms
 Execution Time: 174.284 ms
Tableau 2-62Tableau ou sortie 2-62 extraite du manuel PERF2.
Rechercher toutes les lignes mentionnant à la fois « Fantine » ET « Valjean ». Une formulation d’expression rationnelle simple est « Fantine puis Valjean » ou « Valjean puis Fantine ».
Exemple 2-105Exemple 2-105 de code ou de sortie extrait du manuel PERF2.
                                   QUERY PLAN
------------------------------------------------------------------------------
 Bitmap Heap Scan on textes  (cost=141.01..6543.68 rows=1679 width=123)
                       (actual time=26.825..26.897 rows=8 loops=1)
   Recheck Cond: (contenu ~ '(Valjean.*Fantine)|(Fantine.*Valjean)'::text)
   Heap Blocks: exact=6
   ->  Bitmap Index Scan on idx_textes_trgm
                                  (cost=0.00..140.59 rows=1679 width=0)
                         (actual time=26.791..26.791 rows=8 loops=1)
         Index Cond: (contenu ~ '(Valjean.*Fantine)|(Fantine.*Valjean)'::text)
 Planning Time: 5.697 ms
 Execution Time: 26.992 ms
Tableau 2-63Tableau ou sortie 2-63 extraite du manuel PERF2.
Index GIN comme bitmap
Ce TP utilise la base magasin. Si vous ne l’avez pas déjà, la base magasin (dump de 96 Mo, pour 667 Mo sur le disque au final) peut être téléchargée et restaurée comme suit dans une nouvelle base magasin :
Exemple 2-106Exemple 2-106 de code ou de sortie extrait du manuel PERF2.
createdb magasin
curl -kL https://dali.bo/tp_magasin -o /tmp/magasin.dump
pg_restore -d magasin /tmp/magasin.dump
# le message sur public préexistant est normalrm -- /tmp/magasin.dump
Les données sont dans deux schémas, magasin et facturation. Penser au search_path.
Pour ce TP, figer les paramètres suivants :
Exemple 2-107Exemple 2-107 de code ou de sortie extrait du manuel PERF2.
puis deux autres sur lignes_commandes(fournisseur_id).
Exemple 2-108Exemple 2-108 de code ou de sortie extrait du manuel PERF2.
SETsearch_pathTOmagasin;
Il est nécessaire d’utiliser l’extension btree_gin afin d’indexer des types scalaires (int…) avec un GIN, sinon vous aurez cette erreur :
Exemple 2-109Exemple 2-109 de code ou de sortie extrait du manuel PERF2.
CREATEINDEXONlignes_commandesUSINGgin(quantite);
ERROR:  data type bigint has no default operator class for access method "gin"
HINT:  You must specify an operator class for the index
    or define a default operator class for the data type.
Tableau 2-64Tableau ou sortie 2-64 extraite du manuel PERF2.Exemple 2-110Exemple 2-110 de code ou de sortie extrait du manuel PERF2.
                                 QUERY PLAN
---------------------------------------------------------------------------
 Bitmap Heap Scan on lignes_commandes  (cost=2844.76..48899.60 rows=308227 width=74)
                                       (actual time=37.904..293.243 rows=313674 loops=1)
   Recheck Cond: (quantite = 4)
   Heap Blocks: exact=42194
   Buffers: shared hit=532 read=41712 written=476
   ->  Bitmap Index Scan on lignes_commandes_quantite_gin
                                       (cost=0.00..2767.70 rows=308227 width=0)
                                       (actual time=31.164..31.165 rows=313674 loops=1)
         Index Cond: (quantite = 4)
         Buffers: shared hit=50
 Planning:
   Buffers: shared hit=13
 Planning Time: 0.198 ms
 Execution Time: 305.030 ms
Tableau 2-68Tableau ou sortie 2-68 extraite du manuel PERF2.
En cas de suppression de l’index GIN, l’index B-Tree reste utilisable. Il sera plus long à lire. Cependant, en fonction de sa taille, de celle de la table, de la valeur de random_page_cost et seq_page_cost, PostgreSQL peut décider de ne pas l’utiliser.
# \di+ ijkl*
                            Liste des relations
 Schéma |    Nom     | Type  | Propriétaire | Table | Taille | Description
--------+------------+-------+--------------+-------+--------+-------------
 public | ijkl_btree | index | postgres     | ijkl  | 188 MB |
 public | ijkl_gin   | index | postgres     | ijkl  | 30 MB  |
Tableau 2-69Tableau ou sortie 2-69 extraite du manuel PERF2.
Comparer l’utilisation pour des requêtes portant sur i,j, k & l , puis i & k, puis j & l.
Le premier critère porte idéalement sur toutes les colonnes de l’index B-tree : celui-ci est très efficace et réclame peu d’accès. Toutes les colonnes retournées font partie de l’index : on profite donc en plus d’un Index Only Scan :
Exemple 2-117Exemple 2-117 de code ou de sortie extrait du manuel PERF2.
                              QUERY PLAN
-------------------------------------------------------------------
 Index Only Scan using ijkl_btree on ijkl (... rows=1 loops=1)
   Index Cond: ((i = 10) AND (j = 20) AND (k = 30) AND (l = 40))
   Heap Fetches: 0
   Buffers: shared hit=1 read=3
 Planning Time: 0.330 ms
 Execution Time: 0.400 ms
Tableau 2-70Tableau ou sortie 2-70 extraite du manuel PERF2.
Tant que la colonne i est présente dans le critère, l’index B-tree reste avantageux même s’il doit balayer plus de blocs (582 ici !) :
Exemple 2-118Exemple 2-118 de code ou de sortie extrait du manuel PERF2.
                              QUERY PLAN
-------------------------------------------------------------------
 Index Only Scan using ijkl_btree on ijkl (... rows=2500 loops=1)
   Index Cond: ((i = 10) AND (k = 30))
   Heap Fetches: 0
   Buffers: shared hit=102 read=480 written=104
 Planning Time: 0.284 ms
 Execution Time: 29.452 ms
Tableau 2-71Tableau ou sortie 2-71 extraite du manuel PERF2.
Par contre, dès que la première colonne de l’index B-tree (i) manque, celui-ci devient beaucoup moins intéressant (quoique pas inutilisable, mais il y a des chances qu’il faille le parcourir complètement). L’index GIN devient alors intéressant par sa taille réduite :
Exemple 2-119Exemple 2-119 de code ou de sortie extrait du manuel PERF2.
Installer l’extension hypopg (les paquets dépendent de votre version de PostgreSQL et de la distribution, par exemple hypopg_17 ou postgresql-17-hypopg).
Créer des index hypothétiques (y compris un partiel) et choisir un seul index.
D’abord installer le paquet de l’extension. Sur Rocky Linux et autres dérivés Red Hat :
Exemple 2-123Exemple 2-123 de code ou de sortie extrait du manuel PERF2.
sudo dnf install hypopg_17
Sur Debian, Ubuntu et dérivés :
Exemple 2-124Exemple 2-124 de code ou de sortie extrait du manuel PERF2.
sudo apt install postgresql-17-hypopg
Puis installer l’extension dans la base concernée :
Exemple 2-125Exemple 2-125 de code ou de sortie extrait du manuel PERF2.
CREATEEXTENSIONhypopg;
Création des différents index hypothétiques qui pourraient servir :
Exemple 2-126Exemple 2-126 de code ou de sortie extrait du manuel PERF2.
SELECThypopg_create_index('CREATE INDEX ON log10 (i)');
Tableau 2-78Tableau ou sortie 2-78 extraite du manuel PERF2.Exemple 2-131Exemple 2-131 de code ou de sortie extrait du manuel PERF2.
EXPLAINSELECTi,min(j),max(j)FROMlog10GROUPBYi;
                               QUERY PLAN
-------------------------------------------------------------------------------
 Finalize GroupAggregate  (cost=1000.08..392727.62 rows=5 width=20)
   Group Key: i
   ->  Gather Merge  (cost=1000.08..392727.49 rows=10 width=20)
         Workers Planned: 2
         ->  Partial GroupAggregate  (cost=0.06..391726.32 rows=5 width=20)
               Group Key: i
               ->  Parallel Index Only Scan
                   using <78054>btree_log10_i_j on log10
                   (cost=0.06..357004.01 rows=4629634 width=12)
Tableau 2-79Tableau ou sortie 2-79 extraite du manuel PERF2.Exemple 2-132Exemple 2-132 de code ou de sortie extrait du manuel PERF2.
EXPLAINSELECTmax(j)FROMlog10WHEREi=6;
                               QUERY PLAN
-------------------------------------------------------------------------------
 Result  (cost=0.08..0.09 rows=1 width=8)
   InitPlan 1 (returns $0)
     ->  Limit  (cost=0.05..0.08 rows=1 width=8)
           ->  Index Only Scan Backward using <78056>btree_log10_j on log10
                                  (cost=0.05..31812.59 rows=969631 width=8)
                 Index Cond: (j IS NOT NULL)
Tableau 2-80Tableau ou sortie 2-80 extraite du manuel PERF2.
Les deux requêtes n’utilisent pas le même index. Le partiel (<78056>btree_log10_j) ne conviendra évidemment pas à toutes les requêtes, on voit donc ce qui se passe sans lui :
Exemple 2-133Exemple 2-133 de code ou de sortie extrait du manuel PERF2.
SELECT*FROMhypopg_drop_index(78056);hypopg_drop_index-------------------
t
Exemple 2-134Exemple 2-134 de code ou de sortie extrait du manuel PERF2.
EXPLAINSELECTmax(j)FROMlog10WHEREi=6;
                               QUERY PLAN
-------------------------------------------------------------------------------
 Result  (cost=0.10..0.11 rows=1 width=8)
   InitPlan 1 (returns $0)
     ->  Limit  (cost=0.06..0.10 rows=1 width=8)
           ->  Index Only Scan Backward using <78054>btree_log10_i_j on log10
                                       (cost=0.06..41660.68 rows=969631 width=8)
                 Index Cond: ((i = 6) AND (j IS NOT NULL))
Tableau 2-81Tableau ou sortie 2-81 extraite du manuel PERF2.
C’est presque aussi bon. L’index sur (i,j) semble donc convenir aux deux requêtes.
Comparer le plan de la deuxième requête avant et après la création réelle de l’index.
Bien sûr, un EXPLAIN (ANALYZE) négligera ces index qui n’existent pas réellement :
Exemple 2-135Exemple 2-135 de code ou de sortie extrait du manuel PERF2.
Tableau 2-82Tableau ou sortie 2-82 extraite du manuel PERF2.Exemple 2-136Exemple 2-136 de code ou de sortie extrait du manuel PERF2.
CREATEINDEXONlog10(i,j);
Et le nouveau plan est cohérent avec l’estimation d’HypoPG :
 Result  (cost=0.60..0.61 rows=1 width=8) (actual rows=1 loops=1)
   InitPlan 1 (returns $0)
     ->  Limit  (cost=0.56..0.60 rows=1 width=8) (actual rows=1 loops=1)
           ->  Index Only Scan Backward using log10_i_j_idx on log10
               (cost=0.56..34329.16 rows=969630 width=8) (actual rows=1 loops=1)
                 Index Cond: ((i = 6) AND (j IS NOT NULL))
                 Heap Fetches: 0
 Planning Time: 1.070 ms
 Execution Time: 0.239 ms
Tableau 2-83Tableau ou sortie 2-83 extraite du manuel PERF2.
Créer un index fonctionnel hypothétique pour faciliter la requête suivante :
SELECTkFROMlog10WHEREmod(j,99)=55;
Quel que soit le résultat, le créer quand même et voir s’il est utilisé.
Si on simule la présence de cet index fonctionnel :
Exemple 2-137Exemple 2-137 de code ou de sortie extrait du manuel PERF2.
SELECT*FROMhypopg_create_index('CREATE INDEX ON log10 ( mod(j,99))');EXPLAINSELECTkFROMlog10WHEREmod(j,99)=55;
Tableau 2-84Tableau ou sortie 2-84 extraite du manuel PERF2.
on constate que l’optimiseur le néglige.
Si on le crée quand même, sans oublier de mettre à jour les statistiques :
Exemple 2-138Exemple 2-138 de code ou de sortie extrait du manuel PERF2.
CREATEINDEXONlog10(mod(j,99));ANALYZElog10;
on constate qu’il est alors utilisé :
 Gather  (cost=3243.57..343783.72 rows=119630 width=4) (actual rows=112233 loops=1)
   Workers Planned: 2
   Workers Launched: 2
   ->  Parallel Bitmap Heap Scan on log10
                          (cost=2243.57..330820.72 rows=49846 width=4)
                                           (actual rows=37411 loops=3)
         Recheck Cond: (mod(j, '99'::bigint) = 55)
         Rows Removed by Index Recheck: 470869
         Heap Blocks: exact=18299 lossy=23430
         ->  Bitmap Index Scan on log10_mod_idx
                              (cost=0.00..2213.66 rows=119630 width=0)
                                          (actual rows=112233 loops=1)
               Index Cond: (mod(j, '99'::bigint) = 55)
 Planning Time: 1.216 ms
 Execution Time: 541.668 ms
Tableau 2-85Tableau ou sortie 2-85 extraite du manuel PERF2.
La différence tient à la volumétrie attendue qui a doublé après l’ANALYZE : il y a à présent des statistiques sur les résultats de la fonction qui n’étaient pas disponibles sans la création de l’index, comme on peut le constater avec :
Exemple 2-139Exemple 2-139 de code ou de sortie extrait du manuel PERF2.
SELECT*FROMpg_statsWHEREtablename='log10';
NB : on peut penser aussi à un index couvrant :
Exemple 2-140Exemple 2-140 de code ou de sortie extrait du manuel PERF2.
SELECT*FROMhypopg_create_index('CREATE INDEX ON log10 ( mod(j,99) ) INCLUDE(k)');
en fonction des requêtes réelles à optimiser.
Source : manuel complet PDF, révision 26.09, pages PDF 85-142. Les énoncés de TP et les solutions proviennent de la version complète.