4 Partitionnement sous PostgreSQL
4/ Partitionnement sous PostgreSQL
Ce chapitre reprend l’intégralité des pages PDF 205-268 du manuel complet PERF2, y compris les énoncés de travaux pratiques et les solutions.
4.1 Principe & intérêts du partitionnement
- Principes et intérêts
- Historique
- Les différents types
- applicatif
- par héritage (historique)
- déclaratif (à favoriser)
Le partitionnement est une technique consistant à scinder des grosses tables en plusieurs « partitions », d’abord pour des raisons de place et de maintenance. Dans l’idéal, la table partitionnée reste utilisable en tant que table unique, de manière plus ou moins transparente.
Un partitionnement entièrement géré par le moteur n’existe réellement que depuis la version 10 de PostgreSQL.
Jusqu’à la version 9.6, PostgreSQL ne connaissait que le partitionnement « par héritage », nettement moins flexible et performant. Bien sûr, il existe encore beaucoup d’applications qui « partitionnent » les données elles-mêmes, sans utiliser les mécanismes du moteur.
4.1.1 Pourquoi partitionner ?
- Faciliter la maintenance de gros volumes
VACUUM(FULL), réindexation, déplacements, sauvegarde logique…
- Gain en performance
- parcours complet sur de plus petites tables
- statistiques par partition plus précises
- purge par partitions entières
pg_dumpparallélisable- tablespaces différents (données froides/chaudes)
- Attention à la maintenance sur le code
Maintenir de très grosses tables peut devenir fastidieux, voire impossible. Ce genre de problème peut survenir :
VACUUM FULLtrop longs voire impossibles à cause d’un espace disque insuffisant ;- autovacuum pas assez réactif sur les grosses tables ;
- index trop gros et réindexations interminables ;
pg_dumpne sait pas paralléliser la sauvegarde d’une table volumineuse ;- purge de grandes quantité de données très longue ;
- statistiques plus assez fines (et augmenter l’échantillonnage ne suffit pas forcément) ;
- dilution des lignes actives dans la table au détriment du hit ratio et des I/O ;
- mauvaise corrélation de lignes récupérées ensembles ;
- impossibilité de séparer données actives et inactives au niveau physique (tablespaces).
Certains outils existent pour mitiger ces problèmes (index partiels, index BRIN, autovacuum plus agressif…) mais ne sont pas des solutions définitives.
Le partitionnement consiste à scinder une table en plusieurs sous-tables (partitions) elles-mêmes manipulables en tant que tables à part entière.
Maintenance
La maintenance s’effectue sur les partitions plutôt que sur l’ensemble complet des données. En particulier, un VACUUM FULL ou une réindexation peuvent s’effectuer partition par partition, ce qui permet de limiter les interruptions en production, et lisser la charge.
pg_dump peut sauvegarder les différentes partitions d’une même table en parallèle.
Le partitionnement est aussi un préalable au déplacement d’une partie des données dans un autre tablespace pour des raisons de place, ou pour déporter les parties les moins utilisées de la table vers des disques plus lents et moins chers. Cependant, il faut mettre en balance le coût de migration du modèle existant avec l’économie réalisée sur les disques.
Parcours complet de partitions
Certaines requêtes (notamment décisionnelles) ramènent tant de lignes, ou ont des critères si complexes, qu’un parcours complet de la table est souvent privilégié par l’optimiseur.
Un partitionnement, souvent par date, permet de ne parcourir qu’une ou quelques partitions au lieu de l’ensemble des données. C’est le rôle de l’optimiseur de choisir la partition (partition pruning), par exemple celle de l’année en cours, ou des mois sélectionnés.
Suppression des partitions
La suppression de données parmi un gros volume peut poser des problèmes d’accès concurrents ou de performance, par exemple dans le cas de purges. En configurant judicieusement les partitions, on peut résoudre cette problématique en supprimant une partition (ici en partitionnement déclaratif) :
ou en la détachant :
pour l’archiver (et la réattacher au besoin) ou la supprimer ultérieurement.
D’autres optimisations sont décrites dans ce billet de blog d’Adrien Nayrat : statistiques plus précises au niveau d’une partition, réduction plus simple de la fragmentation des index, jointure par rapprochement des partitions…
La principale difficulté d’un système de partitionnement consiste à partitionner avec un impact minimal sur la maintenance du code par rapport à une table classique.
4.2 Partitionnement applicatif
…ou la réinvention de la roue
4.2.1 Partitionnement applicatif
- Gestion au niveau applicatif, table par table
- Complexité pour le développeur
- Intégrité des données ?
L’application peut gérer le partitionnement elle-même, par exemple en créant des tables numérotées par mois, année… Le moteur de PostgreSQL ne voit que des tables classiques et ne peut assurer l’intégrité entre ces données.
Sur le principe, c’est très simple. Mais le développeur doit réinventer la roue :
- choix de la table dans chaque requête ;
- cohérence des schémas de données entre chaque table/partition ;
- gestion des index sur chacune… La lecture des données qui concerne plusieurs tables peut devenir délicate.
Ce modèle extrêmement fréquent est bien sûr à éviter, Ce modèle est bien sûr à éviter, mais on le rencontre encore fréquemment.
4.3 Partitionnement par héritage
Historique, ou pour un cas très spécifique
4.3.1 Partitionnement par héritage
- Table mère :
- définie normalement, peut contenir des lignes
- Tables filles :
- héritent des propriétés de la table mère
- …mais pas des contraintes, index et droits
- colonnes supplémentaires possibles
- Insertion applicative ou par trigger (lent !)
Cette technique était assez utilisée, faute de mieux, pour partitionner avant PostgreSQL 10. Des applications l’utilisant peuvent encore se rencontrer.
Principe du partitionnement par héritage :
PostgreSQL permet de créer des tables qui héritent les unes des autres. L’héritage d’une table mère transmet les propriétés suivantes à la table fille :
- les colonnes, avec le type et les valeurs par défaut ;
- les contraintes
CHECK.
Les tables filles peuvent ajouter leurs propres colonnes. Par exemple :
La table poissons possède les champs des tables dont elle hérite :
On peut créer toute une hiérarchie avec des branches parallèles, chacune avec ses colonnes propres :
On remarquera que la clé primaire manque. En effet, l’héritage ne transmet pas :
- les contraintes d’unicité et référentielles ;
- les index ;
- les droits.
Chaque table possède ses propres lignes :
Par défaut une table affiche aussi le contenu de ses tables filles et les colonnes communes :
Pour ne consulter que le contenu de la table sans ses filles :
Limites et problèmes :
En conséquence, on a bien affaire à des tables indépendantes. Rien n’empêche d’avoir des doublons entre la table mère et la table fille. Cela empêche aussi bien sûr la mise en place de clé étrangère, puisqu’une clé étrangère s’appuie sur une contrainte d’unicité de la table référencée. Lors d’une insertion, voire d’une mise à jour, le choix de la table cible se fait par l’application ou un trigger sur la table mère.
Il faut être vigilant à bien recréer les contraintes et index manquants ainsi qu’à attribuer les droits sur les objets de manière adéquate. L’une des erreurs les plus fréquentes est d’oublier de créer les contraintes, index et droits qui n’ont pas été transmis.
Ce type de partitionnement est un héritage des débuts de PostgreSQL, à l’époque de la mode des « bases de donnée objet ». Dans la pratique, dans les versions antérieures à la version 10, l’héritage était utilisé pour mettre en place le partitionnement. La maintenance des index, des contraintes et la nécessité d’un trigger pour aiguiller les insertions vers la bonne table fille, ne facilitaient pas la maintenance. Les performances en écritures étaient bien en-deçà des tables classiques ou du partitionnement déclaratif apparu ensuite.
Table partitionnée en détournant le partitionnement par héritage :
Noter qu’il reste encore à gérer les mises à jour de lignes… À cause de ce trigger, le temps d’insertion peut être allègrement multiplié par huit ou dix par rapport à une insertion dans une table normale ou dans une table avec le partitionnement déclaratif moderne.
La même table en partitionnement déclaratif par liste est :
Attention.
Si le partitionnement par héritage fonctionne toujours sur les versions récentes de PostgreSQL, il est déconseillé pour les nouveaux développements.
4.4 Partitionnement déclaratif
4.4.1 Partitionnement déclaratif
- Mise en place et administration simplifiées, intégrées au moteur
- Gestion automatique des lectures et écritures
- et rapide
- Partitions
- attacher/détacher une partition
- contrainte implicite de partitionnement
- expression possible pour la clé de partitionnement
- sous-partitions possibles
- partition par défaut
Le partitionnement déclaratif est le système à privilégier de nos jours. Apparu en version 10, il a été grandement amélioré dans les versions 11 à 13, en fonctionnalités comme en performances. Des améliorations continuent à arriver à chaque version : préférez les versions récentes de PostgreSQL. Son but est de permettre une mise en place et une administration simples des tables partitionnées. Des clauses spécialisées ont été ajoutées aux ordres SQL, comme CREATE TABLE et ALTER TABLE, pour attacher (ATTACH PARTITION) et détacher des partitions (DETACH PARTITION).
Grosse simplification par rapport à l’ancien partitionnement par héritage : il n’est pas nécessaire d’ajouter des triggers pour gérer les insertions et mises à jour. Le routage est géré de façon automatique en fonction de la définition des partitions, au besoin vers une partition par défaut, et sans pénalité notable en performances.
Contrairement au partitionnement par héritage, la table partitionnée ne contient pas elle-même de ligne, ce n’est qu’une coquille vide.
4.4.2 Partitionnement par liste
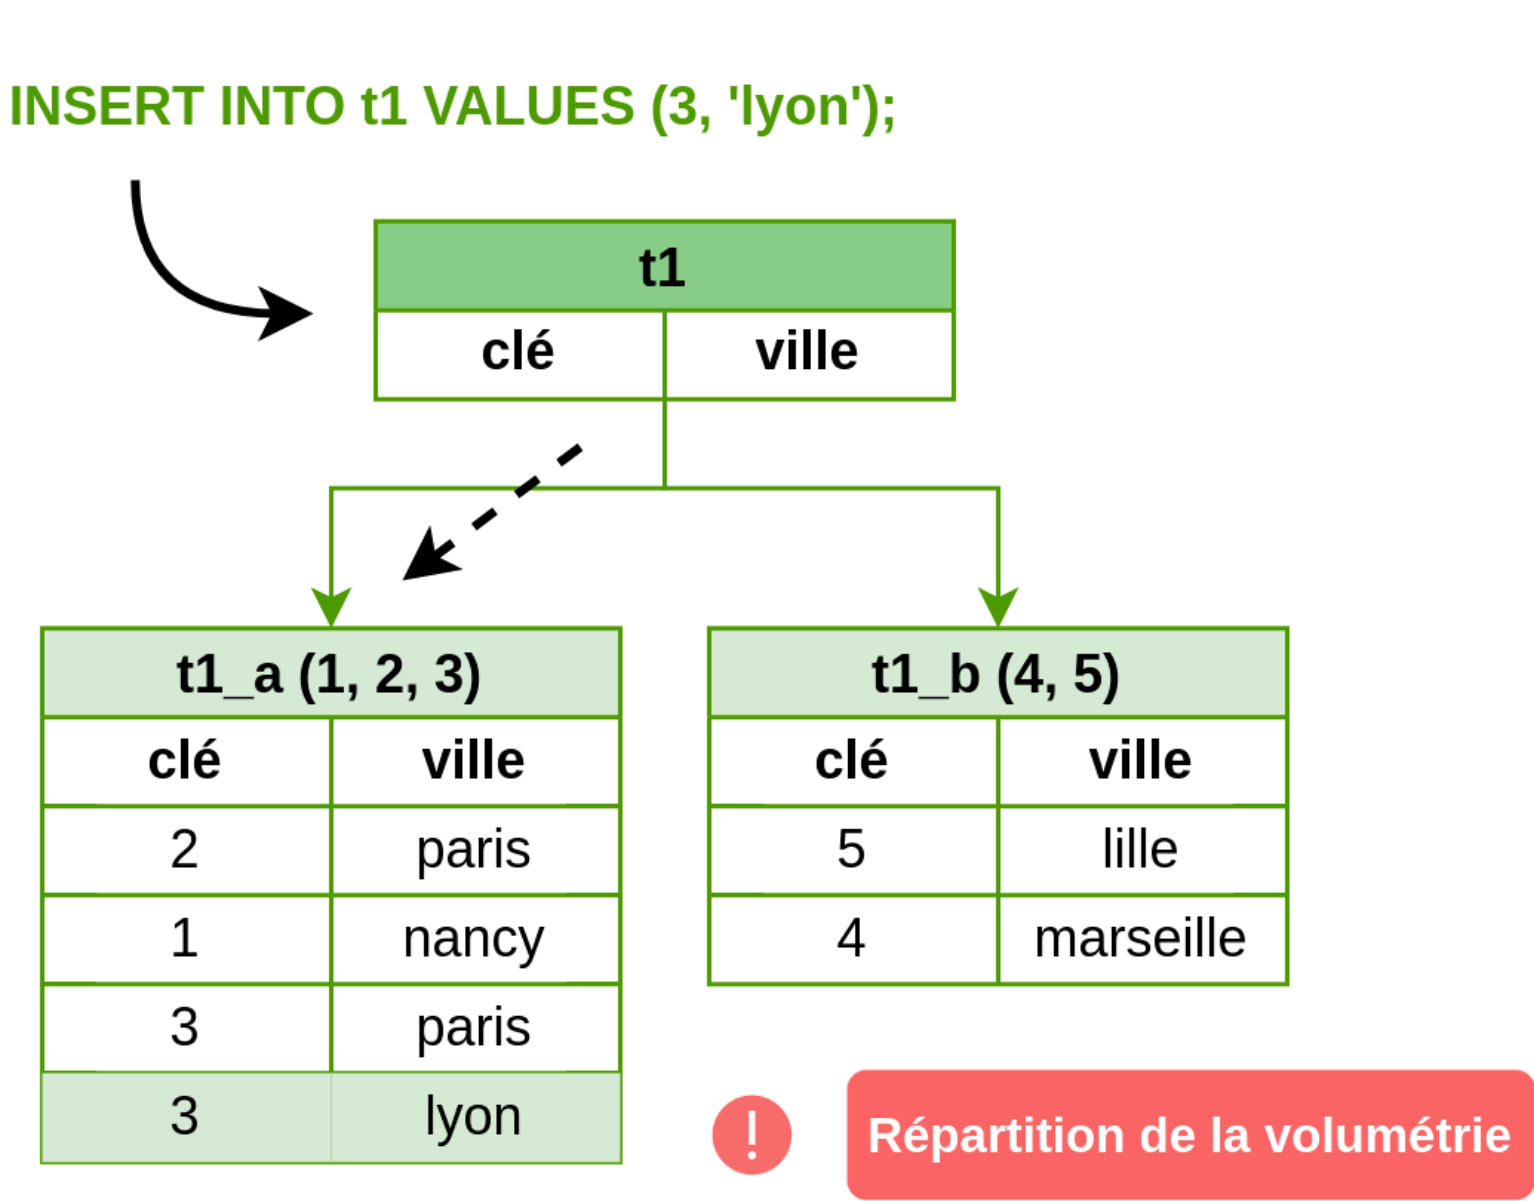
4.4.3 Partitionnement par liste : implémentation
Liste de valeurs par partition
- statut, client, pays, année ou mois…
Clé de partitionnement forcément mono-colonne
Syntaxe :
Il est possible de partitionner une table par valeurs. Ce type de partitionnement fonctionne uniquement avec une clé de partitionnement mono-colonne (on verra qu’il est possible de sous-partitionner). Il faut que le nombre de valeurs soit assez faible pour être listé explicitement. Le partitionnement par liste est adapté par exemple au partitionnement par :
- type d’un objet ;
- client final (si peu de clients) ;
- géographie : pays, entité commerciale, entrepôt… ;
- statut d’un objet, pour isoler les données froides dans leur partition ;
- année ou mois (ne pas oublier de créer régulièrement de nouvelles partitions) pour faciliter les purges.
Voici un exemple de création d’une table partitionnée par liste et de ses partitions :
Les noms des partitions sont à définir par l’utilisateur, il n’y a pas d’automatisme ni de convention particulière.
Lors de l’insertion, les données sont correctement redirigées vers leur partition, comme le montre cette requête :
Il est aussi possible d’interroger directement une partition (ici t1_a et non t1) :
Si aucune partition correspondant à la clé insérée n’est trouvée et qu’aucune partition par défaut n’est déclarée, une erreur se produit.
Si la clé de partitionnement d’une ligne est modifiée par un UPDATE, la ligne change automatiquement de partition (sauf en version 10, où ce n’est pas implémenté, et l’on obtient une erreur).
4.4.4 Partitionnement par intervalle
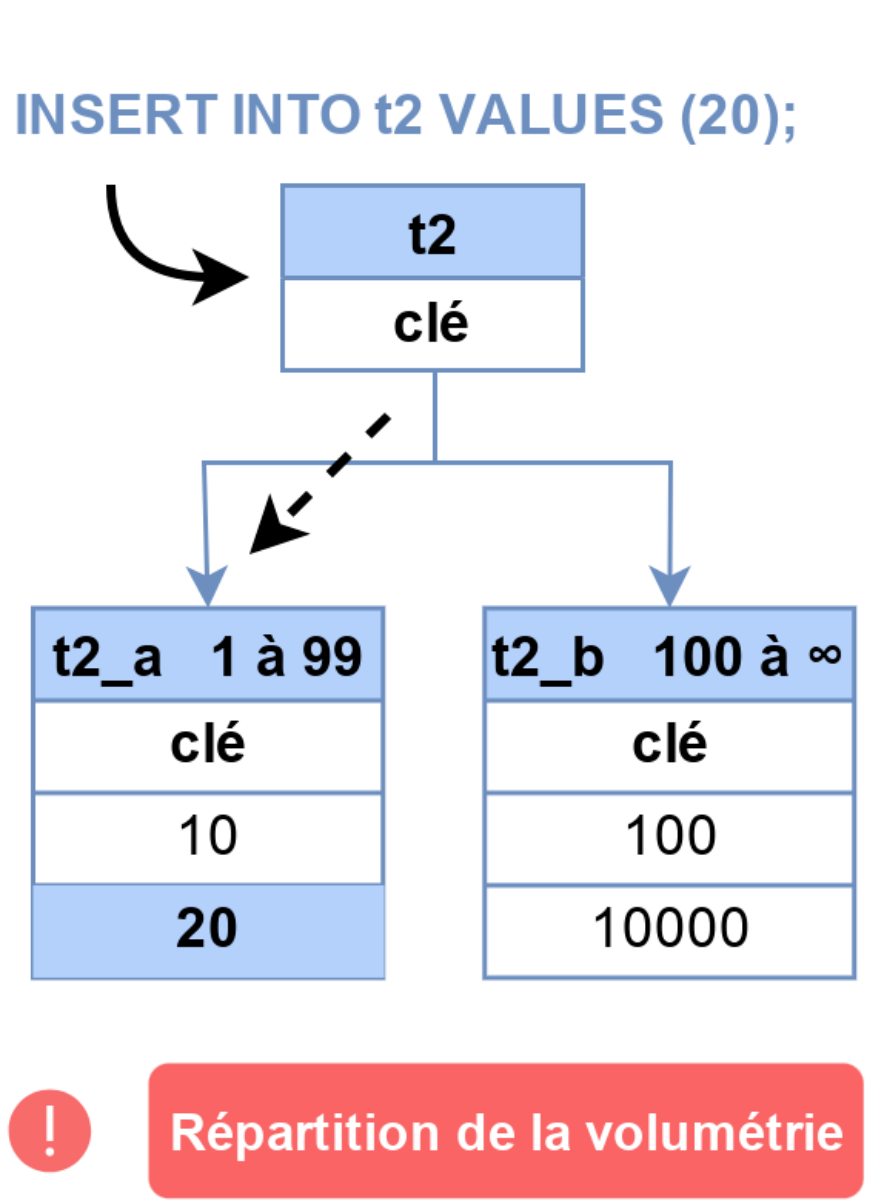
4.4.5 Partitionnement par intervalle : implémentation
- Clé de partitionnement mono- ou multicolonnes
- dates, id…
- Bornes :
- supérieure exclue
MINVALUE/MAXVALUEpour infinis
- Syntaxe :
Le partitionnement par intervalle est très courant quand il y a de nombreuses valeurs différentes de la clé de partitionnement, ou qu’elle doit être multicolonnes, par exemple :
- selon une tranche de dates, notamment pour faciliter des purges ;
- selon des plages d’identifiants d’objets : client final, produit…
Voici un exemple de création de la table partitionnée et de deux partitions :
Le MAXVALUE indique la valeur maximale du type de données : t2_2 acceptera donc tous les entiers supérieurs ou égaux à 100.
Attention.
Noter que les bornes supérieures des partitions sont exclues ! La valeur 100 ira donc dans la seconde partition.
Lors de l’insertion, les données sont redirigées vers leur partition, s’il y en a une :
La colonne système tableoid permet de connaître la partition d’où provient une ligne :
4.4.6 Partitionnement par hachage
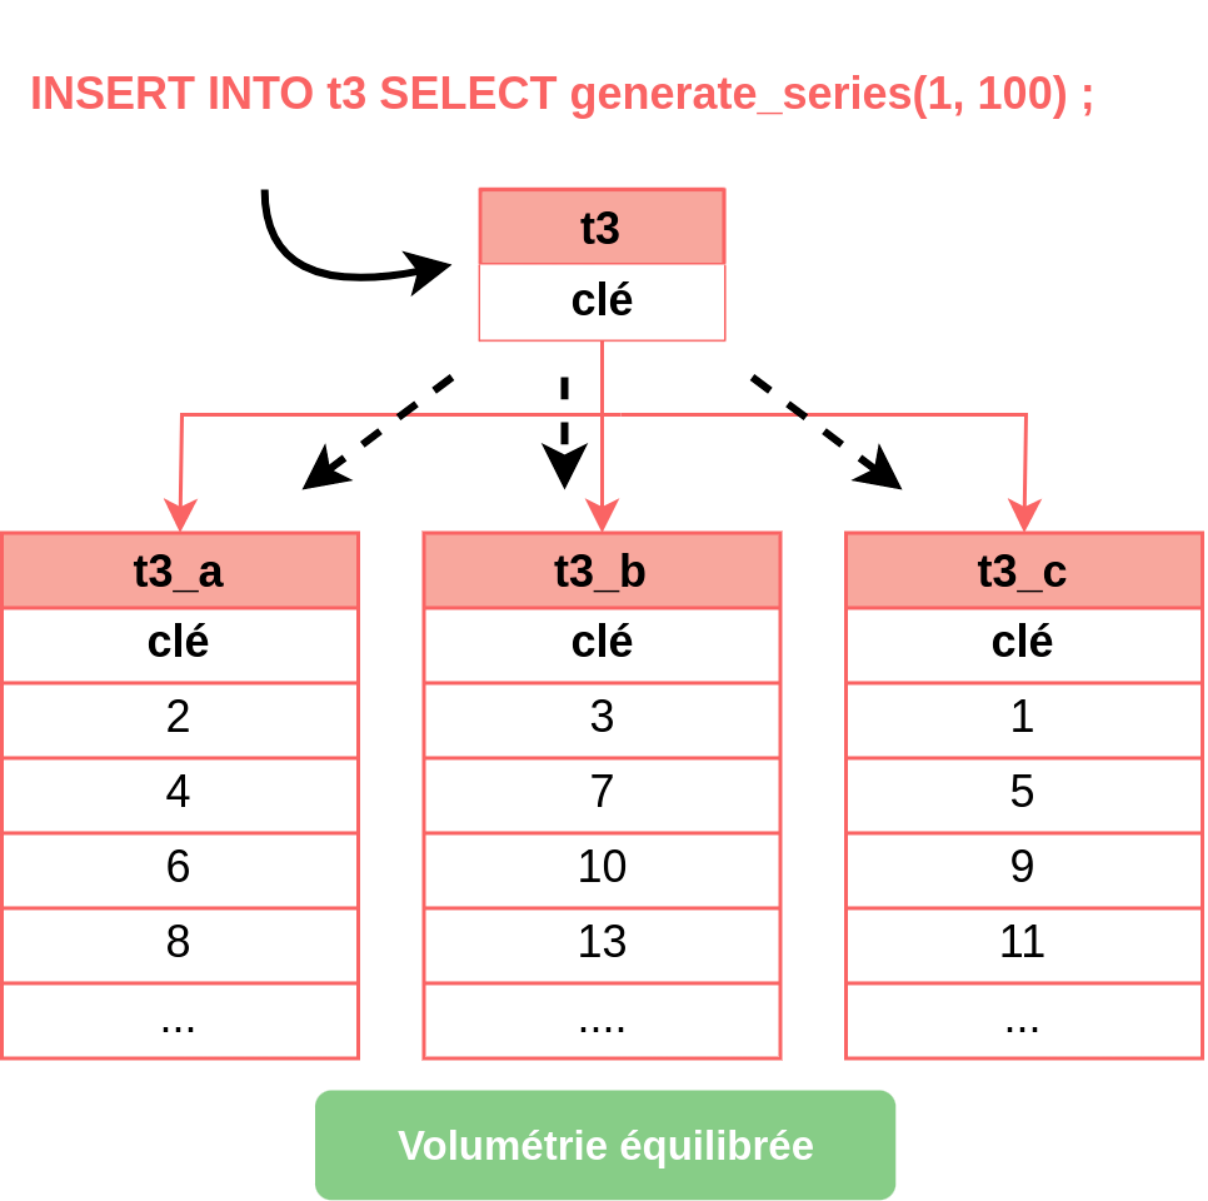
4.4.7 Partitionnement par hachage : principe
Pour une répartition uniforme des données :
Hachage de valeurs par partition
- indiquer un modulo et un reste
Clé de partitionnement mono- ou multicolonnes
Syntaxe :
Si la clé de partitionnement n’est pas évidente et que le besoin est surtout de répartir la volumétrie en partitions de tailles équivalentes, le partitionnement par hachage est adapté. Voici comment partitionner par hachage une table en trois partitions :
Une grosse insertion de données répartira les données de manière équitable entre les différentes partitions :
4.4.8 Clé de partitionnement multicolonnes
- Clé sur plusieurs colonnes :
- si partitionnement par intervalle ou hash (pas par liste)
- et si 1er champ toujours présent
- Syntaxe :
Avec le partitionnement par intervalle, il est possible de créer les partitions en utilisant plusieurs colonnes. On profitera de l’exemple ci-dessous pour montrer l’utilisation conjointe de tablespaces différents. Commençons par créer les tablespaces :
Créons maintenant la table partitionnée et deux partitions :
La borne supérieure étant exclue, la valeur (100, '2017-08-11') fera donc partie de la seconde partition. Si les valeurs sont bien comprises dans les bornes, tout va bien :
Mais si la valeur pour c1 est trop petite :
De même, si la valeur pour c3 (colonne de type date) est antérieure :
Les valeurs spéciales MINVALUE et MAXVALUE permettent de ne pas indiquer de valeur de seuil limite. Les partitions t2_0 et t2_3 pourront par exemple être déclarées comme suit et permettront d’insérer les lignes qui étaient ci-dessus en erreur.
Enfin, on peut consulter la table pg_class afin de vérifier la présence des différentes partitions :
Performances :
Si le premier champ de la clé de partitionnement n’est pas fourni, il semble que l’optimiseur ne sache pas cibler correctement les partitions. Il balaiera toutes les partitions. Ce peut être gênant si ce premier champ n’est pas systématiquement présent dans les requêtes.
Le sous-partitionnement est une alternative à étudier, également plus souple.
Il faut faire attention à ce que le nombre de combinaisons possibles ne mène pas à trop de partitions.
4.4.9 Sous-partitionnement
S’il y a deux chemins d’accès privilégiés :
- Plus souple que le partitionnement multicolonnes
Principe :
Les partitions sont des tables à part entière, qui peuvent donc être elles-mêmes partitionnées. Ce peut être utile si les requêtes alternent entre deux schémas d’accès.
Exemple :
L’exemple ci-dessus crée deux partitions selon statut (objets_123 et objets_45). La première partition est elle-même sous-partitionnée par année (objets_123_2023 et objets_123_2024). Cela permet par exemple, de faciliter la purge des données ou d’accélérer le temps de traitement si l’on requête sur une année entière. Il n’a pas été jugé nécessaire de sous-partitionner la seconde partition objets_45 (par exemple parce qu’elle est petite).
Il n’est pas obligatoire de sous-partitionner avec la même technique (liste, intervalle, hachage…) que le partitionnement de plus haut niveau.
Il n’y a pas besoin de fournir la première clé de partitionnement pour que les sous-partitions soient directement accessibles :
Fournir uniquement la première clé de partitionnement entraînera le parcours de toutes les sous-partitions concernées :
Bien sûr, l’idéal est de fournir les deux clés de partitionnement pour n’accéder qu’à une partition :
Cette fonctionnalité peut être ponctuellement utile, mais il ne faut pas en abuser en raison de la complexité supplémentaire. Toutes les clés de partitionnement devront se retrouver dans les clés primaires techniques des tables. Le nombre de partitions peut devenir très important.
Comparaison avec le partitionnement multicolonnes :
Le partitionnement multicolonnes est conceptuellement plus simple. Pour un même besoin, le nombre de partitions est identique. Mais le sous-partitionnement est plus souple :
- mélange possible des types de partitionnement (par exemple un partitionnement par liste sous-partitionné par intervalle de dates) ;
- type de sous-partitionnement différent possible selon les partitions.
4.4.10 Partition par défaut
- Pour le partitionnement par liste ou par intervalle
- Toutes les données n’allant pas dans les partitions définies iront dans la partition par défaut
- La conserver petite
Ajouter une partition par défaut permet de ne plus avoir d’erreur au cas où une partition n’est pas définie. Par exemple :
Comme la partition par défaut risque d’être parcourue intégralement à chaque ajout d’une nouvelle partition, il vaut mieux la garder de petite taille.
Un partitionnement par hachage ne peut posséder de table par défaut puisque les données sont forcément aiguillées vers une partition ou une autre.
4.4.11 Attacher une partition
- La table doit préexister
- Vérification du respect de la contrainte par les données existantes
- parcours complet de la table : lent !
- …sauf si contrainte
CHECKidentique déjà ajoutée
- Si la partition par défaut a des données qui iraient dans cette partition :
- erreur à l’ajout de la nouvelle partition
- détacher la partition par défaut
- ajouter la nouvelle partition
- déplacer les données de l’ancienne partition par défaut
- ré-attacher la partition par défaut
Ajouter une table comme partition d’une table partitionnée est possible mais cela nécessite de vérifier que la contrainte de partitionnement est valide pour toute la table attachée, et que la partition par défaut ne contient pas de données qui devraient figurer dans cette nouvelle partition. Cela résulte en un parcours complet de la table attachée, et de la partition par défaut si elle existe, ce qui sera d’autant plus lent qu’elles sont volumineuses.
Ce peut être très coûteux en disque, mais le plus gros problème est la durée du verrou sur la table partitionnée, pendant toute cette opération. Il est donc conseillé d’ajouter une contrainte CHECK adéquate avant l’ATTACH : la durée du verrou sera raccourcie d’autant. Pour que cette contrainte soit prise en compte, il faut faire attention aux bornes exactes en partitionnement par intervalle, et préciser IS NOT NULL si le champ n’est pas NOT NULL.
Si des lignes pour cette nouvelle partition figurent déjà dans la partition par défaut, des opérations supplémentaires sont à réaliser pour les déplacer. Ce n’est pas automatique.
Exemple :
4.4.12 Détacher une partition
- Simple et rapide
- Mais nécessite un verrou exclusif
- option
CONCURRENTLY
- option
Détacher une partition est beaucoup plus rapide qu’en attacher une. En effet, il n’est pas nécessaire de procéder à des vérifications sur les données des partitions.
Cependant, il reste nécessaire d’acquérir un verrou exclusif sur la table partitionnée, ce qui peut prendre du temps si des transactions sont en cours d’exécution. L’option CONCURRENTLY mitige le problème malgré quelques restrictions, notamment : pas d’utilisation dans une transaction, incompatibilité avec la présence d’une partition par défaut, et nécessité d’une commande FINALIZE si l’ordre a échoué ou été interrompu.
La partition détachée devient alors une table tout à fait classique. Elle perd la contrainte de partitionnement, mais elle conserve les autres contraintes, les index, etc. hérités de la table partitionnée originale, ou directement posés sur la table quand elle était une partition, voire posés avant que la table soit attachée comme partition à la table partitionnée.
4.4.13 Changer la définition d’une partition
- Si pas de conflit entre partitions :
- Sinon : déplacement de données manuel
Modifier la définition d’une partition n’est pas directement prévu. S’il s’agit d’élargir une partition (liste ou intervalle), sans avoir à gérer un recouvrement avec une autre partition, il est possible de détacher la partition, puis de la réattacher avec sa nouvelle définition, le tout au sein d’une partition. La re-vérification des données prendra cependant du temps. L’astuce du CHECK redondant avec la contrainte de partitionnement, posé avant le DETACH, fonctionne là aussi et réduit la durée du verrou.
S’il faut couper une partition en deux (split), ou fusionner des partitions (merge), il faudra migrer les données manuellement, si possible dans une seule transaction.
4.4.14 Supprimer une partition
Une partition étant une table, supprimer la table revient à supprimer la partition, en détruisant bien sûr les données qu’elle contient. Il n’y a pas besoin de détacher la table auparavant. L’opération est simple et rapide, mais demande un verrou exclusif.
Il est fréquent de partitionner par date pour profiter de cette facilité dans la purge des vieilles données. La durée en est énormément réduite, ainsi que les écritures de journaux puisqu’il n’y a plus de DELETE.
4.4.15 Fonctions de gestion et vues système
- Sous psql :
\dP pg_partition_tree ('logs'): liste entière des partitionspg_partition_root ('logs_2019'): racine d’une partitionpg_partition_ancestors ('logs_201901'): parents d’une partition
Voici le jeu de tests pour l’exemple qui suivra. Il illustre également l’utilisation de sous-partitions (ici sur la même clé, mais cela n’a rien d’obligatoire).
Et voici le test des différentes fonctions :
Noter les propriétés de « feuille » (leaf) et le niveau de profondeur dans le partitionnement.
Sous psql, \d affichera toutes les tables, partitions comprises, ce qui peut vite encombrer l’affichage. \dP affiche uniquement les tables et index partitionnés :
La table système pg_partitioned_table permet des requêtes plus complexes. Le champ pg_class.relpartbound contient les définitions des clés de partitionnement.
Conseil.
Pour masquer les partitions dans certains outils, il peut être intéressant de déclarer les partitions dans un schéma différent de la table principale.
Dans un cadre « multitenant » avec de nombreux schémas, et des partitions de même noms chacune dans son schéma, positionner
search_pathpermet de sélectionner implicitement la partition, facilitant la vie au développeur ou permettant de « mentir » à l’application.
4.4.16 Clé primaire et clé de partitionnement
La clé primaire doit contenir toutes les colonnes de la clé de partitionnement.
- Idem pour une contrainte unique
- Idem pour les clés étrangères vers la table partitionnée
- Pas un problème si on partitionne selon la clé
- Plus gênant si partitionnement par date, statut…
- Relâcher l’intégrité ? Séparer en deux tables ? UUID v7 ?
Clé de partitionnement incluse dans la clé primaire
Le partitionnement impose une contrainte importante sur la modélisation : la clé de partitionnement doit impérativement faire partie de la clé primaire (et des contraintes uniques).
En effet, PostgreSQL ne maintient pas d’index global couvrant toutes les partitions. Chaque index est lié à une seule partition. PostgreSQL ne peut donc garantir l’unicité d’un champ qu’au sein de chaque partition.
Dans beaucoup de cas cela ne posera pas de problème, notamment si on partitionne justement sur tout ou partie de cette clé primaire. Par exemple, avec une table partitionnée par hachage ou plage de valeurs de sa clé primaire, il n’y aura aucun impact. L’unicité reste garantie par le partitionnement et les index de chaque partition.
Conséquences du changement de clé primaire
Dans d’autres cas, c’est plus gênant. Si l’on partitionne par année, on remplace une clé primaire id par la clé (id,annee) : rien n’interdit plus à deux lignes de même id d’exister dans deux partitions par année différentes.
Le risque d’un doublon reste limité si la « vraie » clé primaire id est un identifiant géré par la base à l’insertion (serial ou IDENTITY). Mais avec des identifiants générés côté applicatif, il y a un risque d’introduire un doublon. Le problème est indépendant du type de l’identifiant (entier, UUID…).
Il peut être décidé d’accepter le risque. Rajouter des clés uniques sur l’identifiant dans chaque partition peut au moins garantir son unicité au sein de chaque partition.
Partitionner a aussi un impact sur les clés étrangères pointant vers la table partitionnée : elles doivent aussi contenir les deux colonnes (id,annee). C’est un peu plus fastidieux (surtout en cas de migration d’un existant important), et peut être le signe que la table concernée doit être partitionnée aussi.
Contournement avec une table supplémentaire
Une solution assez complexe est de créer une autre table non partitionnée avec la clé primaire réelle, et une contrainte de clé étrangère de la table partitionnée vers cette table.
Conceptuellement, cela revient à ne pas partitionner une grosse table, mais à en « sortir » la plupart des champs utilisés dans une autre table partitionnée portant une contrainte.
Il n’y aura pas forcément besoin d’utiliser une jointure supplémentaire dans les requêtes. Il faut estimer aussi la taille de la table non partitionnée portant juste les identifiants.
Exemple :
À la suppression, il ne faut pas oublier de supprimer des lignes dans les deux tables, dans le bon ordre :
(Une alternative serait de passer par un ON DELETE CASCADE sur factures_ref.)
Si l’on tient à être totalement propre pour garantir la cohérence des id entre les deux tables, une contrainte dans l’autre sens est possible. Par contre, toute suppression ou insertion impose de lever la contrainte dans la transaction.
Si l’on ne veut pas d’une contrainte deferrable ni d’un ON DELETE CASCADE, il y a aussi la possibilité d’insérer ou supprimer dans les deux tables à la fois en une seule transaction :
Enfin, une table des lignes de facture peut être déclarée ainsi avec la clé étrangère sur id :
au lieu de cette version qui doit intégrer la clé de partitionnement complète dans sa clé étrangère :
Astuce des clés primaires signifiantes
Pour éviter de créer de nouvelles colonnes, une astuce est de remplacer la clé primaire par une chaîne servant au partitionnement, finissant par l’identifiant réel. Cela donnerait par exemple des valeurs de clé comme FR00000001234 pour un partitionnement par pays, ou 2025061200001234 pour un partitionnement par date. Générer des partitions par plage de valeurs de l’identifiant est alors assez simple. Cela ne fonctionne pas si la clé de partitionnement doit évoluer (partitionnement par statut), ce ne serait plus une clé primaire.
Mais cette technique est fragile, car elle réclame un peu de développement pour générer les clés. Conceptuellement, des clés signifiantes sont à éviter, même si cela se retrouve encore dans de vieilles applications. De plus, des identifiants sous forme de chaînes de caractères deviennent souvent trop gros, avec un impact sur les performances, surtout s’il y a des jointures. Et il faut réécrire les clés étrangères vers les tables partitionnées.
Astuce des UUID v7
Pour le cas particulier, très fréquent, d’un partitionnement par date, une astuce nettement plus propre consiste à utiliser des UUID en version 7 comme identifiant de ligne.
Non seulement les UUID v7 évitent les gros soucis des UUID des versions précédentes liés au cache, mais ils contiennent leur date de génération (attention au fuseau horaire). Il est donc possible de partitionner selon des valeurs d’UUID correspondant à des dates précises. La table partitionnée conserve une clé primaire monocolonne, même s’il faut la réécrire. Dans une requête, pour réduire un accès à une partition, il faut réutiliser la fonction de conversion d’une date vers un UUID, ou d’une tranche de dates vers une tranches d’UUID, ce qui alourdit le code.
Un exemple détaillé est présenté dans un billet de Florent Jardin, inspiré entre autres notamment par ce billet de blog de Daniel Vérité.
PostgreSQL 18 devrait contenir les fonctions nécessaires pour créer des UUID, y compris pour une date précise, mais ces fonctions peuvent être installées sur les versions précédentes.
Sur les UUID et leur manipulation, voir https://dali.bo/s22_html#uuid
4.4.17 Indexation
- Propagation automatique
- Index supplémentaires par partition possibles
- Clés étrangères entre tables partitionnées
Les index sont propagés de la table mère aux partitions : tout index créé sur la table partitionnée sera automatiquement créé sur les partitions existantes. Toute nouvelle partition disposera des index de la table partitionnée. La suppression d’un index se fait sur la table partitionnée et concernera toutes les partitions. Il n’est pas possible de supprimer un tel index d’une seule partition.
Gérer des index manuellement sur certaines partitions est possible. Par exemple, on peut n’avoir besoin de certains index que sur les partitions de données récentes, et ne pas les créer sur des partitions de données d’archives.
Une clé primaire ou unique peut exister sur une table partitionnée (mais elle devra contenir toutes les colonnes de la clé de partitionnement) ; ainsi qu’une clé étrangère d’une table partitionnée vers une table normale.
Il est possible de créer une clé étrangère vers une table partitionnée de la même manière qu’entre deux tables normales. Par exemple, si les tables ventes et lignes_ventes sont toutes deux partitionnées :
4.4.18 Planification & performances
- Mettre la clé dans la requête autant que possible
- ou : cibler les partitions directement
- Temps de planification
- nombre de tables, d’index, leurs statistisques…
- max ~ 100 partitions
- À activer ?
enable_partitionwise_aggregateenable_partitionwise_join
Cibler la partition par la clé :
Si la clé de partitionnement n’est pas fournie, l’exécution concernera toutes les partitions, qu’elles soient accédées par Seq Scan ou Index Scan.
Attention.
Autant que possible, le développeur doit fournir la clé de partitionnement dans chaque requête, et le plan ciblera directement la bonne partition.
Comme avec les index, il faut vérifier que la clé est bien claire pour PostgreSQL. Si ce n’est pas le cas toutes les partitions seront lues :
alors que si PostgreSQL reconnaît la clé de partitionnement :
Partition pruning :
Dans le cas où la clé de partitionnement dépend du résultat d’un calcul, d’une sous-requête ou d’une jointure, PostgreSQL prévoit un plan concernant toutes les partitions, mais élaguera à l’exécution les appels aux partitions non concernées. Ci-dessous, seule pgbench_accounts_8 est interrogé (et ce peut être une autre partition si l’on répète la requête) :
Temps de planification :
Une limitation sérieuse du partitionnement tient au temps de planification qui augmente très vite avec le nombre de partitions, même petites. En effet, chaque partition ajoute ses statistiques et souvent plusieurs index aux tables système. Par exemple, dans le cas le plus défavorable d’une session qui démarre :
La section Planning indique le nombre de blocs qu’une session qui démarre doit mettre en cache, liés notamment aux tables systèmes et statistiques (ce phénomène est encore une raison d’éviter des sessions trop courtes). Dans cet exemple, sur la base partitionnée, il y a presque six fois plus de ces blocs, et on triple le temps de planification, qui reste raisonnable.
Conseil.
En général, on considère qu’il ne faut pas dépasser 100 partitions si l’on ne veut pas pénaliser les transactions courtes. Les dernières versions de PostgreSQL sont cependant meilleures sur ce point.
Ce problème de planification est moins gênant pour les requêtes longues (analytiques).
Pour contourner cette limite, il est possible d’utiliser directement les partitions, s’il est facile pour le développeur (ou le générateur de code…) de trouver leur nom, en plus de toujours fournir la clé. Interroger directement une partition est en effet aussi rapide à planifier qu’interroger une table monolithique :
Utiliser directement les partitions est particulièrement économe si leur nombre est grand, mais on perd alors le côté « transparent » du partitionnement, et on augmente la complexité du code applicatif.
Paramètres « partitionwise » :
Dans des cas plus complexes, notamment en cas de jointure entre tables partitionnées, le temps de planification peut exploser. Par exemple, pour la requête suivante où la table partitionnée est jointe à elle-même, le plan sur la table non partitionnée, cache de session chaud, renvoie :
Avec cent partitions, le temps de planification est ici multiplié par 50 :
Ce plan est perfectible : il récupère tout pgbench_accounts et le joint à toute la table. Il serait plus intelligent de travailler partition par partition puisque la clé de jointure est celle de partitionnement. Pour que PostgreSQL cherche à faire ce genre de chose, un paramètre doit être activé :
Les jointures se font alors entre partitions :
Le temps d’exécution passe de 1,2 à 0,2 s, ce qui justifie les quelques millisecondes perdues en plus en planification.
Un autre paramètre est à activer si des agrégations sur plusieurs partitions sont à faire :
enable_partitionwise_aggregate et enable_partitionwise_join sont désactivés par défaut à cause de leur coût en planification sur les petites requêtes, mais les activer est souvent rentable. Avec SET, cela peut se décider requête par requête.
4.4.19 Opérations de maintenance
- Tablespace par partition
- autovacuum/analyze
- sur les partitions (comme sur toute table)
VACUUM,VACUUM FULL,ANALYZE,REINDEX…- sur table mère : redescendent sur les partitions
- Statistiques pour toute la table partitionnée
ANALYZEouANALYZE ONLY(v18)
L’intérêt majeur du partitionnement est de pouvoir scinder les opérations en autant d’étapes qu’il y a de partitions.
Des données « froides » peuvent être déplacées dans un autre tablespace sur des disques moins chers, partition par partition, ce qui est impossible avec une table monolithique :
L’autovacuum et l’autoanalyze fonctionnent normalement et indépendamment sur chaque partition, comme pour des tables classiques. Ainsi ils peuvent se déclencher plus souvent sur les partitions actives, et même plus rapidement. Par rapport à une grosse table monolithique, il y a moins souvent besoin de régler l’autovacuum.
Les ordres ANALYZE et VACUUM sont généralement effectués sur une partition. Les statistiques sont calculées par partition, elles sont donc plus précises.
Reconstruire une table partitionnée avec VACUUM FULL se fait généralement partition par partition. Le partitionnement permet ainsi de résoudre les cas où le verrou sur une table monolithique est trop long, ou l’espace disque total insuffisant.
ANALYZE/ANALYZE ONLY sur la table partitionnée :
L’autovacuum ne crée pas spontanément de statistiques sur les données d’une table partitionnée dans son ensemble, mais uniquement sur les partitions isolées. Or, des statistiques sur toute la table partitionnée peuvent être utiles. Il faut les demander explicitement :
L’ordre procède à un échantillonnage réparti sur toutes les partitions. Mais l’ordre est propagé à toutes les partitions, et reprend un échantillon sur chacune d’entre elles. Si elles sont à jour, on peut gagner du temps en se limitant à l’échantillon global avec la clause ONLY (à partir de PostgreSQL 18) :
4.4.20 Sauvegardes
Sauvegarde physique : peu de différence
Avec pg_dump :
--jobs: efficace--load-via-partition-root- exclusion de partitions (v16+) :
--table-and-children--exclude-table-and-children--exclude-table-data-and-children
Grâce au partitionnement, un export par pg_dump --jobs devient efficace puisque plusieurs partitions peuvent être sauvegardées en parallèle.
La parallélisation peut être aussi un peu meilleure avec un outil de sauvegarde physique (comme pgBackRest ou Barman), qui parallélise les copies de fichiers, mais les grosses tables non partitionnées étaient de toute façon déjà découpées en fichier de 1 Go.
pg_dump a des options pour gérer l’export des tables partitionnées :
--load-via-partition-root permet de générer des ordres COPY ciblant la table mère et non la partition. Ce peut être pratique pour restaurer les données dans une base où la table est partitionnée séparément.
À partir de PostgreSQL 16, n’exporter qu’une table partitionnée se fait avec --table-and-children (et non --table/-t qui ne concernerait que la table mère). Exclure des tables partitionnées se fait avec --exclude-table-and-children (et non --exclude-table/-T). Pour exclure uniquement les données d’une table partitionnée en gardant sa structure, on utilisera --exclude-table-data-and-children. Ces trois options acceptent un motif (par exemple : pgbench_accounts_*) et peuvent être répétées dans la commande.
4.4.21 Limitations du partitionnement déclaratif et versions
- Pas de création automatique des partitions
- ni fusion/scission facile
- Planification : 100 partitions max conseillé
- Pas d’héritage multiple, schéma fixe
- sauf ajout d’index/contraintes sur chaque partition
- Partitions distantes : sans propagation d’index
- Clé de partitionnement calculée : pas vraiment possible
- (≤v16)
IDENTITY: uniquement sur la table partitionnée - PostgreSQL récent toujours conseillé
Certaines de ces limites ont été évoquées plus haut.
Limitations générales :
Une table partitionnée ne peut être convertie en table classique, ni vice-versa. (Par contre, une table classique peut être attachée comme partition, ou une partition détachée).
Les partitions ont forcément le même schéma de données que leur partition mère et héritent des contraintes et index de celle-ci. Il est interdit d’ajouter ou de retrancher de champs. L’ajout d’index ou de contraintes supplémentaires directement sur une partition est par contre possible.
Les clés de partition ne doivent évidemment pas se recouvrir.
Les contraintes ne peuvent s’exercer qu’au sein d’une même partition : les clés d’unicité doivent donc inclure toute la clé de partitionnement. Les contraintes d’exclusion ne peuvent vérifier toutes les partitions.
Il n’y a pas de notion d’héritage multiple.
Limitations liées à la création des partitions :
La création des partitions n’est pas automatisée : il faut les créer par avance manuellement ou par script planifié, ou un outil externe comme pg_partman ou pg_cron. Éventuellement prévoir une partition par défaut pour les cas qui ont pu être oubliés.
Changer les limites d’une partition n’est pas directement prévu. Il faut détacher la partition et réattacher la parition.
Il n’est pas possible de fusionner ou scinder des partitions. Il faudra déplacer les données manuellement.
Limitation sur les champs IDENTITY :
Jusque PostgreSQL 16 inclus, un champ GENERATED ALWAYS/BY DEFAULT AS IDENTITY est utilisable uniquement en insérant dans la table partitionnée, pas en insérant dans la partition. Sinon PostgreSQL se plaint que le champ est NULL. PostgreSQL 17 lève la limite.
Cependant les valeurs d’un champ IDENTITY continuent d’être générées par la séquence indépendamment des partitions, les unes à la suite des autres. Si ce champ fait partie de la clé de partitionnement, il y a aura une erreur si la valeur générée ne respecte pas la contrainte de partitionnement.
Limitations sur les clés calculées :
Il serait parfois pratique de partitionner suivant un champ calculé, par exemple par année quand on dispose d’un champ jour. Malheureusement, le moteur a des limites sur ce point :
- techniquement, une table avec
PARTITION BY LIST ((extract ('year' from jour)))fonctionne, mais PostgreSQL ne voudra pas créer de clé primaire incluant ce champ ; - une colonne générée automatiquement (clause
GENERATED ALWAYS AS ... STORED) ne peut faire partie de la clé de partitionnement ; - un trigger
BEFORE INSERTne peut modifier la partition cible d’une ligne ; - un trigger
INSTEAD OFsur une vue utilitaire peut fonctionner, mais complexifie l’interface et, comme tout trigger, pénalise les performances.
Des contournements sont possibles. La clé peut être calculée côté applicatif, même s’il s’agit juste d’appeler une fonction SQL. Le critère de partitionnement est souvent simple : un partitionnement différent peut convenir. Pour reprendre l’exemple du partitionnement par liste par année calculée à partir du jour, un partitionnement par intervalle de date serait tout aussi adapté.
Limitations liées aux performances :
Il faut éviter d’avoir trop de partitions, pour limiter les risques de dérapage du temps de planification. S’il y en a beaucoup, tenter de cibler directement les partitions qui intéressent une requête.
L’ordre CLUSTER, pour réécrire une table dans l’ordre d’un index donné, ne fonctionne pour les tables partitionnées qu’à partir de PostgreSQL 15. Il peut toutefois être exécuté manuellement table par table.
Limitations liées aux tables distantes :
Il est possible d’attacher comme partitions des tables distantes, généralement déclarées avec postgres_fdw, mais la propagation d’index ne fonctionnera pas sur ces tables. Il faudra les créer manuellement sur les instances distantes.
Limitations liées aux triggers :
Les triggers BEFORE UPDATE ... FOR EACH ROW sont possibles, mais il ne permettent pas de modifier la partition de destination.
Conseil.
Beaucoup de ces limitations dépendent des versions de PostgreSQL. Les versions à présent non supportées en avaient bien d’autres, non listées ici. Une version récente reste de toute manière préférable.
4.5 Tables distantes & sharding
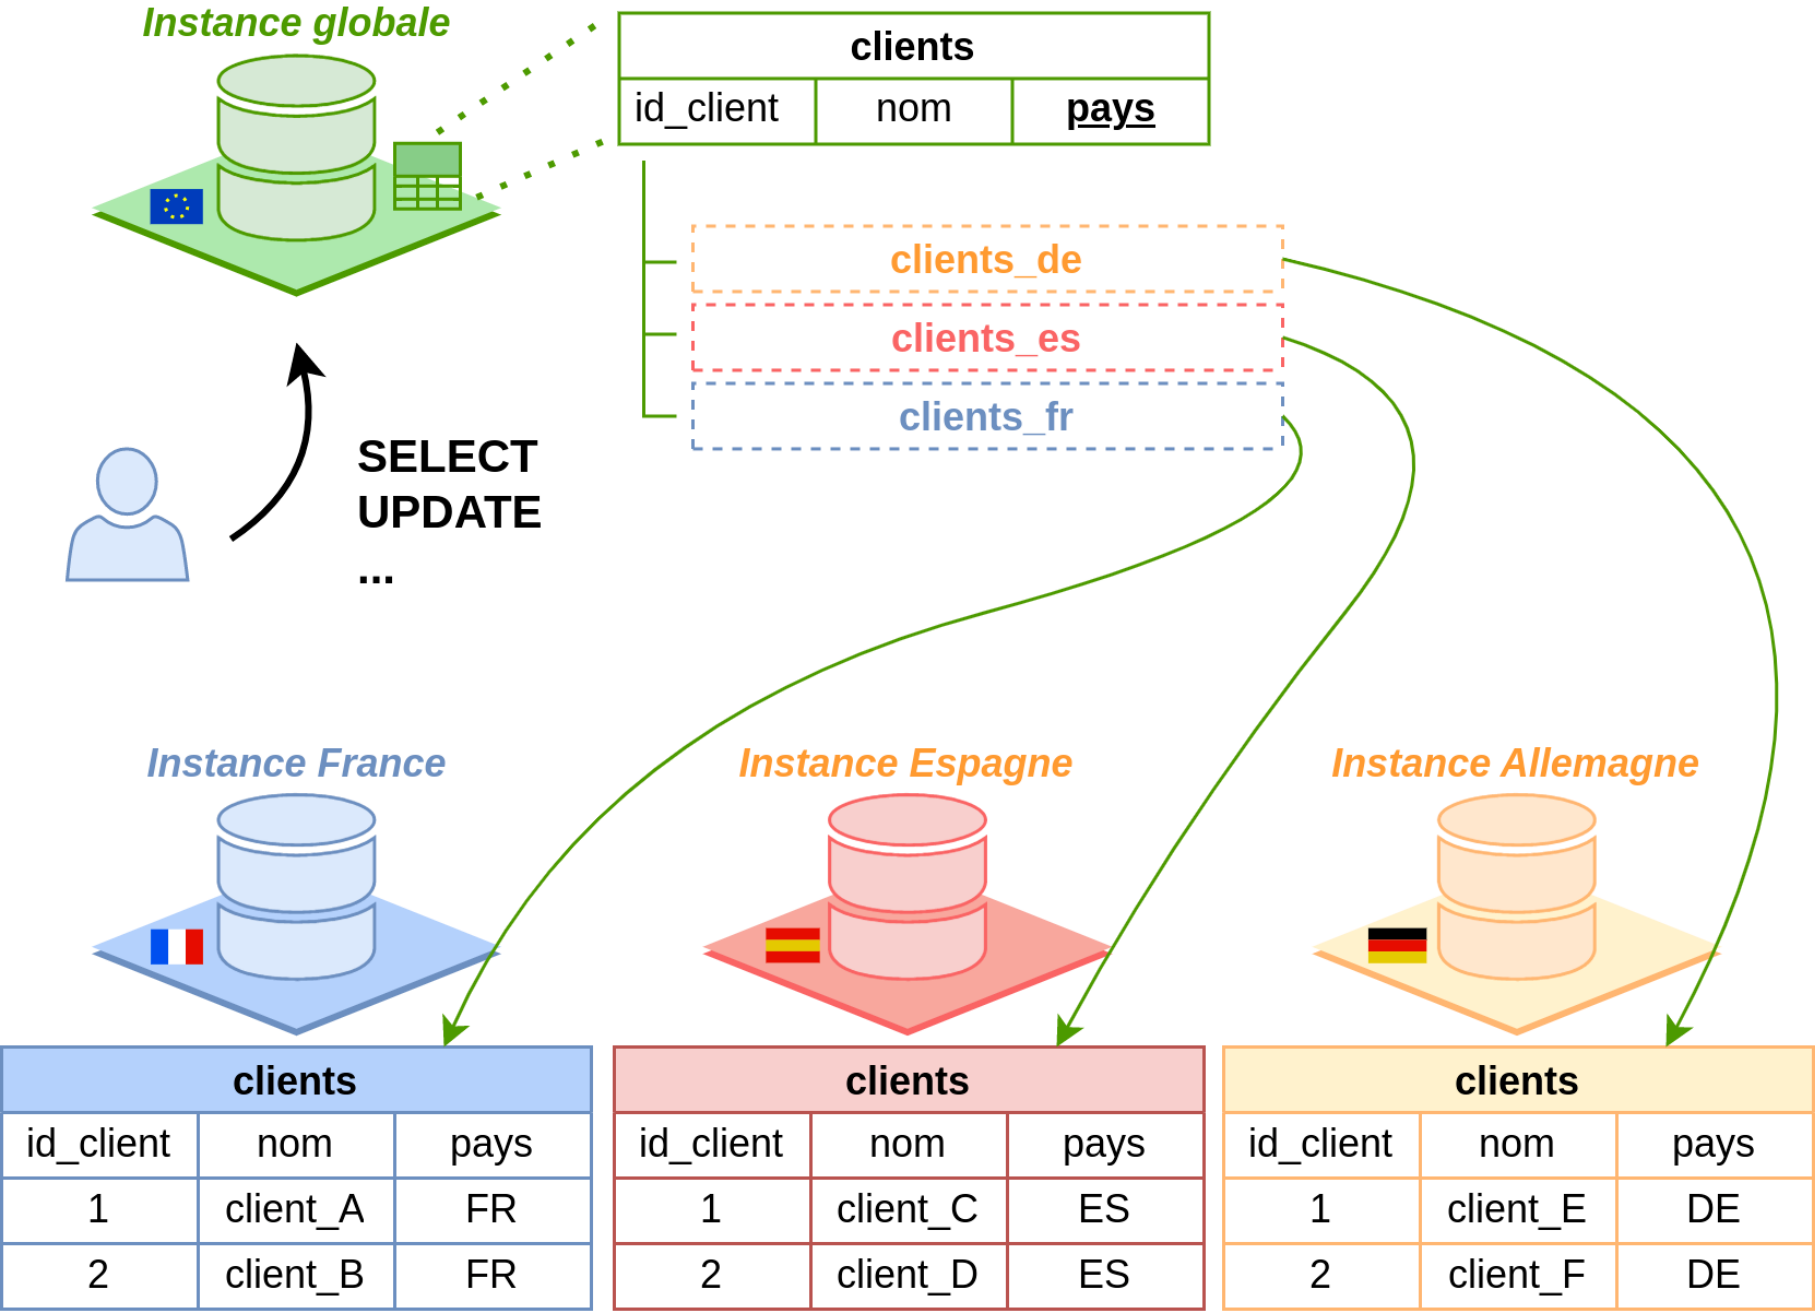
- Tables distantes comme partitions : sharding
- Interrogation simultanée asynchrone
Il est possible d’attacher comme partitions des tables distantes (situées sur d’autres serveurs), généralement déclarées avec le Foreign Data Wrapper postgres_fdw.
NB : Dans le reste de ce chapitre, nous nommerons table étrangère (foreign table dans la documentation officielle) l’objet qui sert d’interface pour accéder, depuis l’instance locale, à la table distante (remote table), qui contient réellement les données.
Par exemple, si trois instances en France, Allemagne et Espagne possèdent chacune des tables clients et commandes ne contenant que les données de leur pays, on peut créer une autre instance utilisant des tables étrangères pour accéder aux trois tables, chaque table étrangère étant une partition d’une table partitionnée de cette instance européene.
Pour les instances nationales, cette instance européenne n’est qu’un client comme un autre, qui envoie des requêtes, et ouvre parfois des curseurs (fonctionnement normal de postgres_fdw). Si le pays est précisé dans une requête, la bonne partition est ciblée, et l’instance européenne n’interroge qu’une seule instance nationale.
La maquette suivante donne une idée du fonctionnement :
Une nouveauté de PostgreSQL 14 est ici particulièrement intéressante : l’option async_capable du serveur étranger (éventuellement de la table) peut être passée à on (le défaut est off). Les nœuds Foreign Scan typiques des accès distants sont alors remplacés par des nœuds Async Foreign Scan (asynchrones), et le serveur principal interroge alors simultanément les trois serveurs qui lui renvoient les données. Dans cet extrait des traces, les ordres FETCH sont entremêlés :
Les paramètres enable_partitionwise_join et enable_partitionwise_aggregate doivent impérativement être activés dans cette configuration. L’optimiseur cherche alors à « pousser » les jointures et les agrégations au niveau du nœud (et à les calculer directement sur les serveurs distants) comme dans le plan suivant (voir la version complète) :
Conseil.
Quand on utilise les tables étrangères, il est conseillée d’utiliser
EXPLAIN (VERBOSE), pour afficher les requêtes envoyées aux serveurs distants et vérifier que le minimum de volumétrie transite sur le réseau.
Cet exemple est une version un peu primitive de sharding, à réserver aux cas où les données sont clairement séparées. L’administration d’une configuration « multimaître » peut devenir compliquée : cohérence des différents schémas et des contraintes sur chaque instance, copie des tables de référence communes, risques de recouvrement des clés primaires entre bases, gestion des indisponibilités, sauvegardes cohérentes…
Noter que l’utilisation de partitions distantes rend impossible notamment la gestion automatique des index, il faut retourner à une manipulation table par table.
4.6 Extensions & outils
- Extension pg_partman
- automatisation
- Extensions dédiées à un domaine :
- timescaledb
- citus
L’extension pg_partman, de Crunchy Data, est un complément aux systèmes de partitionnement de PostgreSQL. Elle est apparue d’abord pour automatiser le partitionnement par héritage. Elle peut être utile avec le partitionnement déclaratif, pour simplifier la maintenance d’un partitionnement sur une échelle temporelle ou de valeurs (par range).
PostgresPro proposait un outil nommé pg_pathman, à présent déprécié en faveur du partitionnement déclaratif intégré à PostgreSQL.
timescaledb est une extension spécialisée dans les séries temporelles. Basée sur le partitionnement par héritage, elle vaut surtout pour sa technique de compression et ses utilitaires. La version communautaire sur Github ne comprend pas tout ce qu’offre la version commerciale.
citus est une autre extension commerciale. Le principe est de partitionner agressivement les tables sur plusieurs instances, et d’utiliser simultanément les processeurs, disques de toutes ces instances (sharding). Citus gère la distribution des requêtes, mais pas la maintenance des instances PostgreSQL supplémentaires. L’éditeur Citusdata a été racheté par Microsoft, qui le propose à présent dans Azure. En 2022, l’entièreté du code est passée sous licence libre. Le gain de performance peut être impressionnant, mais attention : certaines requêtes se prêtent très mal au sharding.
4.7 Conclusion
Le partitionnement déclaratif a de gros avantages pour le DBA
- …mais les développeurs doivent savoir l’utiliser
- Préférer une version récente de PostgreSQL
Le partitionnement par héritage n’a plus d’utilité pour la plupart des applications.
Le partitionnement déclaratif apparu en version 10 est mûr dans les dernières versions. Il introduit une complexité supplémentaire, que les développeurs doivent maîtriser, mais peut rendre de grands services quand la volumétrie augmente.
4.8 Quiz
4.9 Travaux pratiques
Les corrigés détaillés sont disponibles dans la section Travaux pratiques (solutions).
La version en ligne des solutions de ces TP est disponible sur https://dali.bo/v1_solutions.
4.9.1 Partitionnement
But : Mettre en place le partitionnement déclaratif
Nous travaillons sur la base cave. Si vous ne l’avez pas déjà, la base cave (dump de 2,6 Mo, pour 71 Mo sur le disque au final) peut être téléchargée et restaurée ainsi :
Nous allons partitionner la table stock sur l’année.
Pour nous simplifier la vie, nous allons limiter le nombre d’années dans stock (cela nous évitera la création de 50 partitions) :
Nous n’avons maintenant que des bouteilles des années 2001 à 2005.
- Renommer
stockenstock_old.- Créer une table partitionnée
stockvide, sans index pour le moment.
- Créer les partitions de
stock, avec la contrainte d’année :stock_2001àstock_2005.
- Insérer tous les enregistrements venant de l’ancienne table
stock.
- Passer les statistiques pour être sûr des plans à partir de maintenant (nous avons modifié beaucoup d’objets).
- Vérifier la présence d’enregistrements dans
stock_2001(syntaxeSELECT ONLY).- Vérifier qu’il n’y en a aucun dans
stock.
- Vérifier qu’une requête sur
stocksur 2002 ne parcourt qu’une seule partition.
- Remettre en place les index présents dans la table
stockoriginale.- Il se peut que d’autres index ne servent à rien (ils ne seront dans ce cas pas présents dans la correction).
- Quel est le plan pour la récupération du stock des bouteilles du
vin_id1725, année 2003 ?
- Essayer de changer l’année de ce même enregistrement de
stock(la même que la précédente). Pourquoi cela échoue-t-il ?
- Supprimer les enregistrements de 2004 pour
vin_id= 1725.- Retenter la mise à jour.
- Pour vider complètement le stock de 2001, supprimer la partition
stock_2001.
- Tenter d’ajouter au stock une centaine de bouteilles de 2006.
- Pourquoi cela échoue-t-il ?
- Créer une partition par défaut pour recevoir de tels enregistrements.
- Retenter l’ajout.
- Tenter de créer la partition pour l’année 2006. Pourquoi cela échoue-t-il ?
- Pour créer la partition sur 2006, au sein d’une seule transaction :
- détacher la partition par défaut ;
- y déplacer les enregistrements mentionnés ;
- ré-attacher la partition par défaut.
4.9.2 Partitionner pendant l’activité
But : Mettre en place le partitionnement déclaratif sur une base en cours d’activité
Préparation
Créer une base pgbench vierge, de taille 10 ou plus.
NB : Pour le TP, la base sera d’échelle 10 (environ 168 Mo). Des échelles 100 ou 1000 seraient plus réalistes.
Dans une fenêtre en arrière-plan, laisser tourner un processus
pgbenchavec une activité la plus soutenue possible. Il ne doit pas tomber en erreur pendant que les tables vont être partitionnées ! Certaines opérations vont poser des verrous, le but va être de les réduire au maximum.
Pour éviter un « empilement des verrous » et ne pas bloquer trop longtemps les opérations, faire en sorte que la transaction échoue si l’obtention d’un verrou dure plus de 10 s.
Partitionnement par hash
Pour partitionner la table
pgbench_accountspar hash sur la colonneaidsans que le traitement pgbench tombe en erreur, préparer un script avec, dans une transaction :
- la création d’une table partitionnée par hash en 3 partitions au moins ;
- le transfert des données depuis
pgbench_accounts;- la substitution de la table partitionnée à la table originale.
Tester et exécuter.
Supprimer l’ancienne table
pgbench_accounts_old.
Partitionnement par valeur
pgbench doit continuer ses opérations en tâche de fond.
La table
pgbench_historyse remplit avec le temps. Elle doit être partitionnée par date (champmtime). Pour le TP, on fera 2 partitions d’une minute, et une partition par défaut. La table actuelle doit devenir une partition de la nouvelle table partitionnée.
- Écrire un script qui, dans une seule transaction, fait tout cela et substitue la table partitionnée à la table d’origine.
NB : Pour éviter de coder des dates en dur, il est possible, avec
psql, d’utiliser une variable :
Exécuter le script, attendre que les données s’insèrent dans les nouvelles partitions.
Purge
- Continuer de laisser tourner
pgbenchen arrière-plan.- Détacher et détruire la partition avec les données les plus anciennes.
Contraintes entre tables partitionnées
- Ajouter une clé étrangère entre
pgbench_accountsetpgbench_history. Voir les contraintes créées.
Si vous n’avez pas déjà eu un problème à cause du
statement_timeout, dropper la contrainte et recommencer avec une valeur plus basse. Comment contourner ?
Index global
On veut créer un index sur
pgbench_history (aid).Pour ne pas gêner les écritures, il faudra le faire de manière concurrente. Créer l’index de manière concurrente sur chaque partition, puis sur la table partitionnée.
4.10 Travaux pratiques (solutions)
Partitionnement
But : Mettre en place le partitionnement déclaratif
Pour nous simplifier la vie, nous allons limiter le nombre d’années dans stock (cela nous évitera la création de 50 partitions).
Nous n’avons maintenant que des bouteilles des années 2001 à 2005.
- Renommer
stockenstock_old.- Créer une table partitionnée
stockvide, sans index pour le moment.
- Créer les partitions de
stock, avec la contrainte d’année :stock_2001àstock_2005.
- Insérer tous les enregistrements venant de l’ancienne table
stock.
- Passer les statistiques pour être sûr des plans à partir de maintenant (nous avons modifié beaucoup d’objets).
- Vérifier la présence d’enregistrements dans
stock_2001(syntaxeSELECT ONLY).- Vérifier qu’il n’y en a aucun dans
stock.
- Vérifier qu’une requête sur
stocksur 2002 ne parcourt qu’une seule partition.
- Remettre en place les index présents dans la table
stockoriginale.- Il se peut que d’autres index ne servent à rien (ils ne seront dans ce cas pas présents dans la correction).
Les autres index ne servent à rien sur les partitions : idx_stock_annee est évidemment inutile, mais idx_stock_vin_annee aussi, puisqu’il est inclus dans l’index unique que nous venons de créer.
- Quel est le plan pour la récupération du stock des bouteilles du
vin_id1725, année 2003 ?
- Essayer de changer l’année de ce même enregistrement de
stock(la même que la précédente). Pourquoi cela échoue-t-il ?
C’est une violation de contrainte unique, qui est une erreur normale : nous avons déjà un enregistrement de stock pour ce vin pour l’année 2004.
- Supprimer les enregistrements de 2004 pour
vin_id= 1725.- Retenter la mise à jour.
- Pour vider complètement le stock de 2001, supprimer la partition
stock_2001.
- Tenter d’ajouter au stock une centaine de bouteilles de 2006.
- Pourquoi cela échoue-t-il ?
Il n’existe pas de partition définie pour l’année 2006, cela échoue donc.
- Créer une partition par défaut pour recevoir de tels enregistrements.
- Retenter l’ajout.
- Tenter de créer la partition pour l’année 2006. Pourquoi cela échoue-t-il ?
Cela échoue car des enregistrements présents dans la partition par défaut répondent à cette nouvelle contrainte de partitionnement.
- Pour créer la partition sur 2006, au sein d’une seule transaction :
- détacher la partition par défaut ;
- y déplacer les enregistrements mentionnés ;
- ré-attacher la partition par défaut.
Partitionner pendant l’activité
But : Mettre en place le partitionnement déclaratif sur une base en cours d’activité
Préparation
Créer une base pgbench vierge, de taille 10 ou plus.
Dans une fenêtre en arrière-plan, laisser tourner un processus
pgbenchavec une activité la plus soutenue possible. Il ne doit pas tomber en erreur pendant que les tables vont être partitionnées ! Certaines opérations vont poser des verrous, le but va être de les réduire au maximum.
L’activité est à ajuster en fonction de la puissance de la machine. Laisser l’affichage défiler dans une fenêtre pour bien voir les blocages.
Pour éviter un « empilement des verrous » et ne pas bloquer trop longtemps les opérations, faire en sorte que la transaction échoue si l’obtention d’un verrou dure plus de 10 s.
Un verrou en attente peut bloquer les opérations d’autres transactions venant après. On peut annuler l’opération à partir d’un certain seuil pour éviter ce phénomène :
Cela ne concerne cependant pas les opérations une fois que les verrous sont acquis. On peut garantir qu’un ordre donné ne durera pas plus d’une certaine durée :
En fonction de la rapidité de la machine et des données à déplacer, cette interruption peut être tolérable ou non.
Partitionnement par hash
Pour partitionner la table
pgbench_accountspar hash sur la colonneaidsans que le traitement pgbench tombe en erreur, préparer un script avec, dans une transaction :
- la création d’une table partitionnée par hash en 3 partitions au moins ;
- le transfert des données depuis
pgbench_accounts;- la substitution de la table partitionnée à la table originale.
Tester et exécuter.
Le champ aid n’a pas de signification, un partitionnement par hash est adéquat.
Le script peut être le suivant :
À la moindre erreur, la transaction tombe en erreur. Il faudra demander manuellement ROLLBACK.
Si la durée fixée par statement_timeout est dépassée, on aura cette erreur :
Surtout, le traitement pgbench reprend en arrière-plan. On peut alors relancer le script corrigé plus tard.
Si tout se passe bien, un \d+ renvoie ceci :
On peut vérifier rapidement que les valeurs de aid sont bien réparties entre les 3 partitions :
Après la validation du script, on voit apparaître les lignes dans les nouvelles partitions :
Supprimer l’ancienne table
pgbench_accounts_old.
Partitionnement par valeur
pgbench doit continuer ses opérations en tâche de fond.
La table
pgbench_historyse remplit avec le temps. Elle doit être partitionnée par date (champmtime). Pour le TP, on fera 2 partitions d’une minute, et une partition par défaut. La table actuelle doit devenir une partition de la nouvelle table partitionnée.
- Écrire un script qui, dans une seule transaction, fait tout cela et substitue la table partitionnée à la table d’origine.
NB : Pour éviter de coder des dates en dur, il est possible, avec
psql, d’utiliser une variable :
La « date frontière » doit être dans le futur (proche). En effet, pgbench va modifier les tables en permanence, on ne sait pas exactement à quel moment la transition aura lieu (et de toute façon on ne maîtrise pas les valeurs de mtime) : il continuera donc à écrire dans l’ancienne table, devenue partition, pendant encore quelques secondes.
Cette date est arbitrairement à 1 minute dans le futur, pour dérouler le script manuellement :
Et on peut réutiliser cette variable ainsi ;
Le script peut être celui-ci :
Exécuter le script, attendre que les données s’insèrent dans les nouvelles partitions.
Pour surveiller le contenu des tables jusqu’à la transition :
Un \d+ doit renvoyer ceci :
Purge
- Continuer de laisser tourner
pgbenchen arrière-plan.- Détacher et détruire la partition avec les données les plus anciennes.
Contraintes entre tables partitionnées
- Ajouter une clé étrangère entre
pgbench_accountsetpgbench_history. Voir les contraintes créées.
NB : les clés étrangères entre tables partitionnées ne sont pas disponibles avant PostgreSQL 12.
On voit que chaque partition porte un index comme la table mère. La contrainte est portée par chaque partition.
Si vous n’avez pas déjà eu un problème à cause du
statement_timeout, dropper la contrainte et recommencer avec une valeur plus basse. Comment contourner ?
Le statement_timeout peut être un problème :
On peut créer les contraintes séparément sur les tables. Cela permet de ne poser un verrou sur la partition active (sans doute pgbench_history_default) que pendant le strict minimum de temps (les autres partitions de pgbench_history ne sont pas utilisées).
La contrainte au niveau global sera alors posée presque instantanément :
Index global
On veut créer un index sur
pgbench_history (aid).Pour ne pas gêner les écritures, il faudra le faire de manière concurrente. Créer l’index de manière concurrente sur chaque partition, puis sur la table partitionnée.
Construire un index de manière concurrente (clause CONCURRENTLY) permet de ne pas bloquer la table en écriture pendant la création de l’index, qui peut être très longue. Mais il n’est pas possible de le faire sur la table partitionnée :
Mais on peut créer l’index sur chaque partition séparément :
S’il y a beaucoup de partitions, on peut générer dynamiquement ces ordres :
Comme lors de toute création concurrente, il faut vérifier que les index sont bien valides : la requête suivante ne doit rien retourner.
Enfin on crée l’index au niveau de la table partitionnée : il réutilise les index existants et sera donc créé presque instantanément :
Source : manuel complet PDF, révision 26.09, pages PDF 205-268. Les énoncés de TP et les solutions proviennent de la version complète.